브라질 NF-e Nota Fiscal
XML to Excel 추출
책상 위에 놓인 인쇄 문서인 DANFE에는 공급업체의 NF-e 데이터 중 10% 미만만 포함되어 있습니다. 모든 라인 항목 세금 계산, 모든 CFOP 세무 코드, 모든 NCM 제품 분류, 그리고 매입 세액 공제를 결정하는 전체 PIS/COFINS 내역은 해당 페이지에 나타나지 않습니다. 완전한 청구서는 브라질 공급업체가 이미 생성한 XML 파일이며, 귀하가 비용을 지불했지만 사용하지 않는 500개 이상의 구조화된 필드가 포함되어 있습니다.
주요 요점
- AP 팀이 Excel에 수동으로 입력하는 DANFE는 회계용이 아니라 화물 운송 중 바코드를 스캔하도록 고안된 것입니다. 여기에는 ICMS(주 판매세) 및 PIS/COFINS(연방 사회 기여금) 공제 회수액을 결정하는 모든 라인별 세금 내역을 포함하여 청구서 데이터의 90%가 누락되어 있습니다.
- 완전한 청구서(500개 이상의 기계 판독 가능 필드를 가진 NF-e XML, 브라질의 전자 청구서 형식)는 모든 거래에 이미 존재합니다. 브라질 법률에 따라 공급업체는 상품이 합법적으로 창고를 떠나기 전에 주 세무 당국인 SEFAZ에 디지털 서명하여 제출해야 하기 때문입니다.
- 브라질 ERP 현지화 모듈은 필요하지 않습니다. NF-e XML 또는 DANFE를 ImageToTable.ai에 입력하고 필요한 열을 한 번 정의하면 XPath 쿼리를 하나도 작성하지 않고도 CFOP(세무 운영 코드), NCM(제품 분류), ICMS 금액을 포함한 모든 세부 세금 정보를 Excel로 가져올 수 있습니다.
이 가이드와 다른 NF-e 콘텐츠와의 관계: 이 페이지는 방법 비교입니다. 세 가지 추출 접근 방식(ERP 모듈, XML 스크립팅, AI 추출)과 각각이 복구할 수 있는 필드를 설명합니다. 전체 기술 참조(전체 XML 필드 매핑 테이블, CST/CFOP/NCM 코드 테이블, ICMS-ST 처리, 이벤트 기반 추출(취소, CC-e, 비상))가 필요하다면 완전한 NF-e 추출 필드 매핑 가이드를 참조하십시오. NF-e가 처음이라면 Nota Fiscal Eletrônica 초보자 가이드부터 시작하십시오.
DANFE 함정: 대부분의 국제 AP 팀이 잘못된 문서를 처리하고 있는 이유
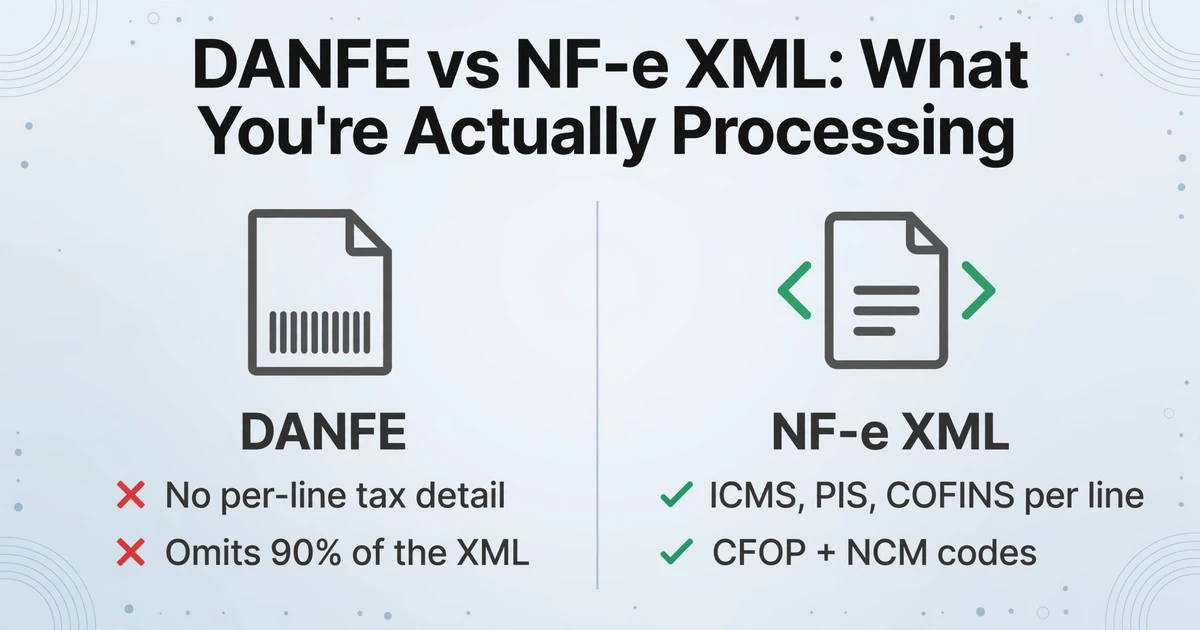
브라질 공급업체에서 화물이 도착하면 운전기사가 바코드와 오른쪽 상단에 44자리 숫자가 인쇄된 서류를 건네줍니다. 이것이 바로 DANFE — Documento Auxiliar da Nota Fiscal Eletrônica(전자 세금계산서 보조 문서) — 이며, 이름 속 '보조(auxiliary)'라는 단어는 장식이 아닙니다. DANFE는 정확히 한 가지 목적, 즉 고속도로 검문소에서 세무 당국이 바코드를 스캔하여 화물을 확인할 수 있도록 물리적 상품 운송 중에 동반하기 위해 존재합니다. 완전한 인보이스로 설계된 적이 없습니다.
그러나 브라질 상품을 수령하는 대부분의 국제 AP 팀에게 DANFE가 곧 인보이스입니다. 스캔되거나 OCR 처리되거나 ERP에 수동으로 입력됩니다. 44자리 액세스 키는 '인보이스 번호' 필드에 성실히, 44자리 모두 복사됩니다. 그리고 AP 담당자는 다음 문서로 넘어갑니다. 모든 공급업체, 모든 화물에 대해 완전한 인보이스가 이미 기계 판독 가능한 XML 형식으로 존재하며, 브라질 정부는 판매자가 이를 생성하고 ICP-Brasil 인증서로 디지털 서명한 후 상품이 합법적으로 창고를 떠나기 전에 SEFAZ(주 세무 당국)에 제출하도록 요구한다는 사실을 인지하지 못한 채 말입니다.
데이터 손실의 규모는 미미하지 않습니다. DANFE는 요약 정보 — 공급업체 이름, 구매자 이름, 날짜, 수량과 단가가 포함된 품목, 총 합계 — 만 인쇄합니다. 현재 레이아웃 버전 4.0에서 Nota Técnica 2016/002에 의해 정의된 NF-e XML은 승인 시점에 SEFAZ가 실행하는 400개 이상의 자동 검증 규칙의 적용을 받으며, 500개 이상의 구조화된 태그를 포함합니다. 두 문서의 차이는 영수증과 거래의 완전한 세무 기록의 차이입니다. 이는 귀하의 매입세액 공제, 통관 조정, 그리고 향후 5년간의 감사 추적을 결정합니다.
DANFE와 XML의 구분은 사소한 기술적 문제가 아닙니다. 브라질 공급업체 인보이스를 처리하는 모든 AP 부서에게 가장 중요한 개념이며, 직접적인 재정적 결과를 초래합니다. 팀이 DANFE에서 데이터를 입력하고 있다면, 이미 구조화되고 기계 판독 가능한 형태로 존재하는 정보의 일부만 수동으로 다시 입력하고 있는 것이며, 모든 거래에서 올바른 금액의 ICMS, IPI, PIS, COFINS를 회수하는지 결정하는 세금 세부정보를 놓치고 있는 것입니다.
NF-e XML 안에는 무엇이 들어 있을까 — 그리고 이것이 AP에 중요한 이유
NF-e XML은 단순히 꺾쇠괄호로 표현된 인보이스가 아닙니다. 이는 판매자의 전자서명이 포함된 법적 효력이 있는 세무 문서로, 400개 이상의 SEFAZ 규칙에 대해 검증되었으며, 브라질 외부의 전자송장 표준보다 훨씬 세분화된 수준으로 세금 데이터를 저장합니다. 비교하자면, 유럽의 Peppol BIS 표준은 약 100개의 요소를 사용합니다. NF-e는 그 다섯 배에 달하는 요소를 포함하며, 모든 요소는 기계가 읽을 수 있습니다.
추출 워크플로우를 설계하기 전에 무엇을 추출할지 이해해야 합니다. 다음은 모든 NF-e XML 내부의 주요 요소 그룹과 각각이 지급 계정(AP)에 중요한 이유입니다:
| XML 요소 그룹 | 포함 내용 | AP 팀에 필요한 이유 |
|---|---|---|
<ide> (식별) | 44자리 액세스 키, 문서 모델(55=NF-e), 시리즈, 번호, 발행 일시, 발행 유형, SEFAZ 승인 프로토콜 | 모든 NF-e를 전 세계적으로 고유하게 식별합니다. 프로토콜 번호는 SEFAZ 승인을 확인합니다. 액세스 키를 사용하여 언제든지 진위 여부를 검증할 수 있습니다. |
<emit> (발행자) | CNPJ(14자리 법인 세금 ID), 법인명, 상호, IBGE 시군구 코드가 포함된 전체 주소, Inscrição Estadual(주 등록 번호) | CNPJ는 공급업체 마스터 키로, 공급업체 레코드와 일치합니다. 주 등록 번호는 해당 거래를 관할하는 SEFAZ 주를 결정합니다. |
<dest> (수취인) | 귀하의 CNPJ 또는 CPF, 법인명, 주소, 주 등록 번호, ISUF(세금 대체 지표) | 세금계산서가 귀하의 올바른 브라질 법인으로 발행되었는지 확인합니다. 세금 공제 자격에 중요합니다. |
<det> (품목) | 제품 코드, 설명, NCM(8자리 메르코수르 분류), CFOP(4자리 세금 거래 코드), 수량, 단가, 품목 합계 | 각 품목에는 자체 NCM과 CFOP가 있으며, 이 두 코드는 적용 세율과 공제 자격을 결정합니다. 이 코드는 DANFE에는 표시되지 않습니다. |
<imposto> (세금) | ICMS(과세 표준, 세율, 금액, CST 과세 상황 코드, 원산지), IPI(과세 표준, 세율, 금액, CST), PIS(과세 표준, 세율, 금액, CST), COFINS(과세 표준, 세율, 금액, CST) | 품목 수준의 전체 세금 계산입니다. ICMS 세율은 원산지 및 목적지 주에 따라 다릅니다(주 간 4%, 7%, 12%, 주 내 17%~22%). PIS/COFINS는 연방 세금 공제를 결정합니다. 이 모든 정보는 DANFE에 표시되지 않습니다. |
<total> (합계) | ICMS 합계, ICMS-ST(세금 대체) 합계, IPI 합계, PIS 합계, COFINS 합계, 운임, 보험료, 할인, NF-e 총액 | 모든 세금 집계의 항목별 세부 내역입니다. ERP 세금 계정과 대사하십시오. |
<transp> (운송) | 운송업체 CNPJ, 운송 방식, 차량 번호판, 선적 부피 및 중량 | 물류 기록과의 3자 대사에 사용됩니다. 운임 금액은 ICMS 과세 표준에 영향을 미칩니다. |
<cobr> (청구) | 결제 조건, 분할 납부 일정 및 금액, 은행 정보 | AP 일정 관리에 사용됩니다. 브라질 세금계산서에는 다회 분할 결제 구조(duplicatas(분할 어음))가 자주 포함됩니다. |
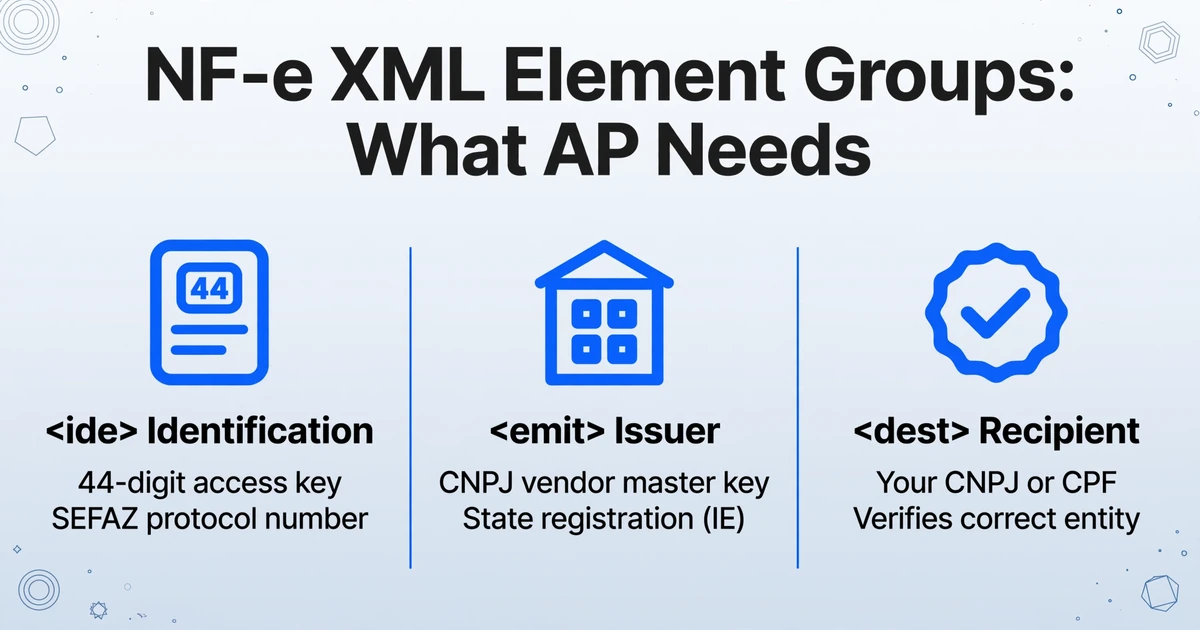
44자리 액세스 키(chave de acesso)는 NF-e의 범용 식별자입니다. 이 키에는 발행지의 주(처음 2자리, IBGE 코드 기준 — 상파울루 35, 리우데자네이루 33, 미나스제라이스 31), 발행 연월(다음 4자리), 발행자의 CNPJ(다음 14자리), 문서 모델(2자리), 시리즈(3자리), 일련번호(9자리), 발행 유형(1자리), 충돌 방지용 임의 코드(8자리), 모듈로-11 검증 숫자(1자리)가 인코딩되어 있습니다. 모든 NF-e XML에는 이 키가 <infNFe Id="NFe...> 속성에 포함되어 있으며, 이 키를 사용하여 SEFAZ에 직접 조회하여 진위 여부를 확인하거나, 취소 여부를 확인하거나, 공급업체가 DANFE만 보냈을 경우 전체 XML을 다운로드할 수 있습니다.
DANFE는 세금계산서가 아닙니다. XML이 세금계산서입니다. 브라질 세법은 서명된 XML을 거래의 법적 증빙 문서로 최소 5년간 보관하도록 요구합니다. DANFE — 일반 용지에 인쇄되고, 서명이 없으며, 데이터의 일부만 포함 — 는 상품 운송 중 물리적 검사 요건을 충족하기 위해서만 존재합니다. 귀하의 AP 팀이 DANFE에서 전표를 입력하고 있다면, 브라질 세법이 보조 자료로 간주하는 문서에 감사 추적을 구축하고 있는 것입니다.
NF-e XML 추출 워크플로 설정
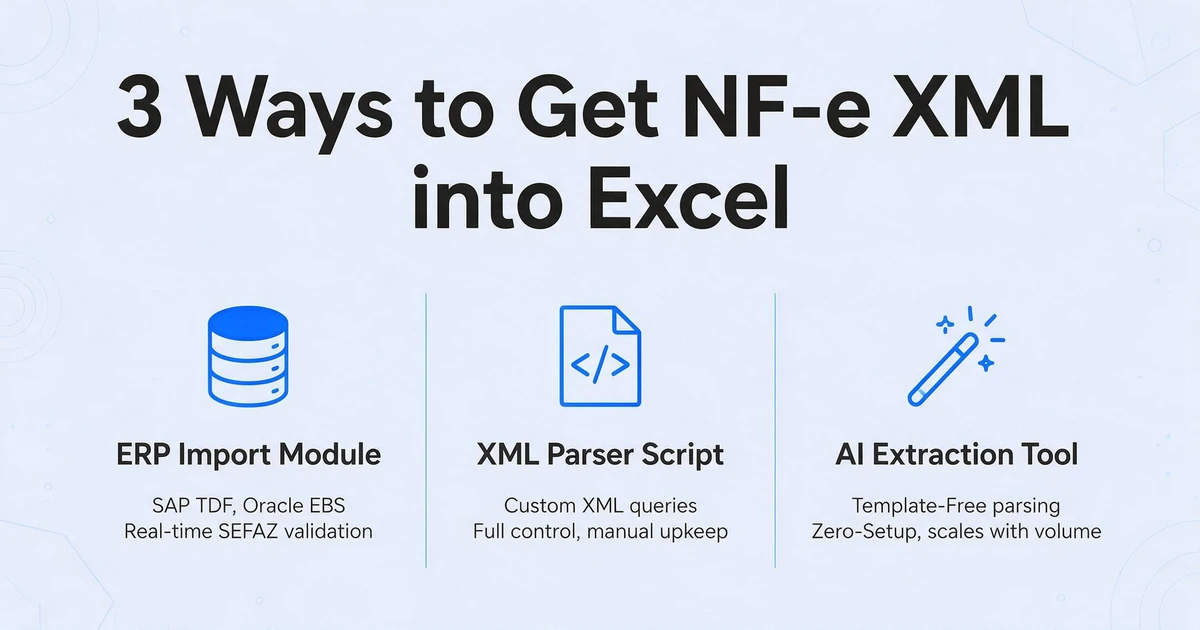
NF-e XML 데이터를 Excel 스프레드시트로 가져오는 방법에는 세 가지가 있으며, 비용과 복잡성 측면에서 매우 다른 위치에 있습니다. 어떤 방법이 적합한지는 거래량, ERP 구성, 그리고 브라질 자회사가 이미 현지화 모듈을 운영 중인지 여부에 따라 달라집니다.
방법 1: ERP 가져오기 모듈 (SAP TDF, Oracle EBS Brazil, Dynamics 365 Finance)
귀사가 브라질 현지화 모듈이 활성화된 SAP, Oracle EBS 또는 Microsoft Dynamics 365를 사용하는 경우, ERP 자체가 NF-e XML 파일을 직접 가져올 수 있습니다. SAP의 TDF(Nota Fiscal 모듈)는 트랜잭션 J1BNFE를 통해 인바운드 NF-e XML을 처리하여 각 XML 요소를 해당 SAP 테이블에 매핑합니다. Oracle EBS Brazil 현지화(12.2.6+에서 사용 가능)는 XML Generator SEFAZ 프로그램(P76B601)을 사용하여 가져옵니다. Dynamics 365 Finance는 지급 계정 > 브라질 현지화 > NF-e XML 가져오기에서 전용 가져오기 워크플로를 제공합니다.
이것은 최고 수준의 표준입니다. SEFAZ에 대해 실시간으로 검증하고, 올바른 세금 계정에 전기하며, 3자 매칭을 자동으로 처리합니다. 또한 그에 상응하는 비용이 따릅니다. SAP 및 Oracle Brazil 현지화 모듈은 별도의 라이선스 비용이 들며, 가장 최근 Fundação Getúlio Vargas(FGV, 제툴리우 바르가스 재단) 조사에 따르면 브라질 중견 시장에서 33%의 시장 점유율로 지배적인 ERP인 TOTVS는 전적으로 브라질에 초점을 맞추고 있어 국외에서는 흔하지 않습니다. 귀사의 글로벌 AP 팀에 브라질 ERP 현지화가 없다면 이 접근 방식은 사용할 수 없습니다.
방법 2: XML-Excel 변환
가장 기본적인 수준에서 NF-e XML은 XML 파일이며, 모든 XML 파일은 스프레드시트 형식으로 변환할 수 있습니다. Microsoft Excel의 내장 XML 가져오기(데이터 > 데이터 가져오기 > 파일에서 > XML에서), 온라인 변환기 또는 xml.etree.ElementTree와 같은 라이브러리를 사용하는 Python 스크립트와 같은 도구는 XML 구조를 행과 열로 평면화할 수 있습니다.
일반 XML 변환의 문제는 NF-e 스키마의 깊이입니다. 단일 NF-e XML은 각각 자체 ICMS, IPI, PIS 및 COFINS 그룹이 있는 자체 <imposto> 하위 트리를 포함하는 <det> 요소 내부에 라인 항목 데이터를 중첩합니다. 순진한 XML-CSV 변환은 이를 수백 개의 열이 있는 단일 행으로 평면화하며, 그중 많은 열이 동일한 이름을 갖습니다(모든 라인 항목에는 vProd 필드가 있고, 모든 세금 그룹에는 vBC 필드가 있음). 출력은 기술적으로 "Excel에 있지만" 상당한 정리 작업 없이는 사용할 수 없습니다.
명시적 XPath 쿼리가 있는 Python의 xml.etree 또는 lxml은 정밀한 제어를 제공합니다. 필요한 요소를 정확히 추출하여 명명된 열에 매핑할 수 있습니다. 이는 개발 리소스를 사용할 수 있는 경우 잘 작동하지만, NF-e 스키마가 업데이트될 때마다 중단되는 XPath 매핑을 유지 관리해야 합니다. 2026년 세금 개혁으로 스키마에 새로운 CBS/IBS 요소 그룹이 추가되면(아래 참조) 해당 매핑을 업데이트해야 합니다.
방법 3: AI 기반 문서 추출
세 번째 접근 방식은 ERP 현지화 비용과 XPath 스크립팅의 취약성을 모두 피할 수 있는 AI 기반 문서 추출입니다. XML을 직접 파싱하는 대신, DANFE(또는 공급업체 시스템에서 PDF로 렌더링된 NF-e XML)를 추출 도구에 업로드하고 출력 테이블에 포함할 열을 지정합니다 — "CNPJ," "Invoice Number," "ICMS Base," "ICMS Amount," "NCM Code," "CFOP" — 그러면 AI가 문서를 읽고 페이지의 어디에 나타나든 각 값을 찾아냅니다.
이 접근 방식은 때때로 맞춤 열 추출이라고도 하며, 템플릿 기반 OCR과는 다르게 작동합니다. 기존 OCR은 각 공급업체의 인보이스 레이아웃에 대한 템플릿을 정의해야 하며, 시스템에 "인보이스 번호는 항상 좌표 (x,y)에 있습니다"라고 알려야 합니다. 레이아웃이 변경되면 템플릿이 깨집니다. 반면 열 기반 추출은 의미론적 이해를 통해 작동합니다. 원하는 필드의 이름을 지정하면 AI가 필드가 의미하는 바를 이해하여 문서 어디에서든 해당 값을 찾습니다. 이는 브라질 공급업체의 DANFE 레이아웃이 매우 다양하기 때문에 NF-e 처리에 특히 중요합니다 — 표준화된 시각적 템플릿은 없고, 그 아래에 표준화된 XML 스키마만 있을 뿐입니다.
한계는 솔직히 말해, 여전히 기계가 읽을 수 있는 XML이 아닌 DANFE의 시각적 레이아웃에서 추출한다는 점입니다. DANFE에 표시된 10%의 데이터만 얻을 수 있으며, XML의 500개 이상 필드는 얻을 수 없습니다. 많은 AP 사용 사례(헤더 데이터, 라인 항목, 합계)의 경우 이는 충분하며 수동 입력보다 훨씬 빠릅니다. 그러나 XML에만 존재하는 전체 PIS/COFINS 라인별 계산, CFOP 코드 또는 CST 과세 상황 코드가 필요한 경우, DANFE에서 AI 추출로는 페이지에 인쇄되지 않은 데이터를 복구할 수 없습니다.
| 방법 | 추출 가능한 항목 | 비용 수준 | 구축 노력 | 지속적인 유지보수 |
|---|---|---|---|---|
| ERP 가져오기 모듈 | XML 필드의 100% — 전체 세금 상세, CFOP, NCM, CST, 운송, 청구 | 엔터프라이즈(라이선스 + 구현) | 높음 — 현지화 모듈 배포 필요 | 중간 — ERP 버전 업그레이드에 따른 스키마 업데이트 |
| XML-to-Excel(스크립트/변환기) | XML 필드의 100% — XPath를 작성하는 모든 요소 | 낮음(개발 시간 또는 무료 도구) | 중간 — XPath 매핑, 스키마 이해 필요 | 높음 — 스키마 변경 시 XPath 쿼리 중단; 2026 CBS/IBS 필드는 재작성 필요 |
| DANFE에서 AI 추출 | DANFE에 인쇄된 모든 항목(XML 데이터의 10%): 헤더, 라인 항목, 합계, 액세스 키 | 낮음(문서당 또는 구독) | 낮음 — 열 이름 정의, 문서 업로드 | 최소 — 유지보수할 템플릿 없음; 레이아웃 변경은 AI가 처리 |
| 수동 데이터 입력 | AP 담당자가 입력할 시간이 있는 모든 것 | 숨은 비용 — 페이지당 3분, 직원 비용 기준 자동 추출보다 약 18배 느림 | 없음 | 오류율은 볼륨에 따라 증가 |
NF-e 필드를 스프레드시트에 매핑하기: 무엇을 추출하고 왜 추출하는가
XML 파싱을 위한 XPath 쿼리를 작성하든 AI 추출을 위한 열 이름을 정의하든, 선택하는 열이 출력의 유용성을 결정합니다. 다음은 실제 XML 요소 경로를 사용하여 공급업체 검증, 3자 매칭, 세액 공제 입력이라는 세 가지 핵심 AP 워크플로우를 다루는 실용적인 필드 매핑입니다.
| 스프레드시트 열 | NF-e XML 요소 (XPath) | 용도 |
|---|---|---|
| 송장 번호 | /nfeProc/NFe/infNFe/ide/nNF | 문서 식별 |
| 접근 키 | /nfeProc/NFe/infNFe/@Id ("NFe" 뒤 44자리 숫자 추출) | SEFAZ 검증, 취소 확인, XML 조회 |
| 발행일 | /nfeProc/NFe/infNFe/ide/dhEmi (ISO 8601 날짜시간, 현지 날짜로 변환) | 예약일, 지급 조건 계산 |
| 승인일 | /nfeProc/NFe/infNFe/ide/dhSaiEnt | 실제 출하일 — 이 타임스탬프 이전에 SEFAZ 승인 |
| 공급자 CNPJ | /nfeProc/NFe/infNFe/emit/CNPJ | 공급처 마스터 매칭 (14자리 키, 서식 없음) |
| 공급자명 | /nfeProc/NFe/infNFe/emit/xNome | 공급처 확인 |
| 공급자 주 IE | /nfeProc/NFe/infNFe/emit/IE | 주 세금 등록 — ICMS 관할권 결정 |
| 라인 항목 NCM | /nfeProc/NFe/infNFe/det[n]/prod/NCM | 제품 분류 — IPI 세율 및 수입 관세 적용 여부 확인 |
| 라인 항목 CFOP | /nfeProc/NFe/infNFe/det[n]/prod/CFOP | 세무 거래 유형 — 세금 처리 및 공제 자격 결정 |
| 라인 항목 설명 | /nfeProc/NFe/infNFe/det[n]/prod/xProd | 발주 매칭 |
| 수량 | /nfeProc/NFe/infNFe/det[n]/prod/qCom | 입고 확인 |
| 단가 | /nfeProc/NFe/infNFe/det[n]/prod/vUnCom | 발주 가격 매칭 |
| 라인 합계 | /nfeProc/NFe/infNFe/det[n]/prod/vProd | 라인별 금액 확인 |
| ICMS 과세 기준 | /nfeProc/NFe/infNFe/det[n]/imposto/ICMS/*/vBC (ICMS 하위 그룹에 따라 다름) | 세액 공제 계산 — 출발지-목적지 주 쌍에 대한 ICMS 세율과 일치해야 함 |
| ICMS 세율 | /nfeProc/NFe/infNFe/det[n]/imposto/ICMS/*/pICMS | 올바른 주 세율과 대조 확인 (남부/남동부 주 간 12%, 기타 지역 7%, 수입 4%; 주 내 17%-22%) |
| ICMS 금액 | /nfeProc/NFe/infNFe/det[n]/imposto/ICMS/*/vICMS | 실제 ICMS 공제 등록 금액 |
| ICMS CST | /nfeProc/NFe/infNFe/det[n]/imposto/ICMS/*/CST | 세금 상황 — 00=과세, 40=면세, 60=기납부세 등 |
| IPI 금액 | /nfeProc/NFe/infNFe/det[n]/imposto/IPI/*/vIPI | 연방 소비세 — 산업 시설에서 공제 가능 |
| PIS 금액 | /nfeProc/NFe/infNFe/det[n]/imposto/PIS/*/vPIS | 연방 사회 기여금 — 1.65% 비누적 세율 |
| COFINS 금액 | /nfeProc/NFe/infNFe/det[n]/imposto/COFINS/*/vCOFINS | 연방 사회 기여금 — 7.6% 비누적 세율, 최대 연방 세금 항목 |
| 송장 합계 | /nfeProc/NFe/infNFe/total/ICMSTot/vNF | 순 송장 금액 — 지불해야 할 금액 |
중요한 세부 사항: ICMS 요소 경로는 과세 상황에 따라 달라집니다. NF-e 스키마는 ICMS 체계에 따라 서로 다른 XML 하위 그룹을 사용합니다 — 일반 과세 거래의 경우 ICMS00, 면세의 경우 ICMS40, 세금 대체가 적용된 기존 과세의 경우 ICMS60. 추출 로직은 이 분기 구조를 탐색해야 합니다: <ICMS> 하위에 어떤 하위 그룹이 있는지 확인한 후 해당 하위 요소를 읽어야 합니다.
추출 데이터에서 브라질 세금 복잡성 처리
데이터 추출은 첫 단계입니다. 검증이 실제 작업이 시작되는 곳이며, 세무 감사 중 표면화되는 대부분의 오류가 여기서 발생합니다. 브라질의 세금 시스템은 3개 정부 수준(연방, 주, 시)에 걸쳐 운영되며, 세율은 제품 분류, 출발지-목적지 쌍, 거래의 법적 성격에 따라 달라집니다. 다음은 모든 NF-e 데이터 추출 워크플로우에 포함되어야 하는 검증 항목입니다:
주별 쌍에 따른 ICMS 세율 검증
ICMS 세율은 균일하지 않습니다. 주 간 거래의 경우 세율은 출발지와 목적지 주에 따라 결정됩니다:
| 출발지(원산지 지역) | 도착지(목적지 지역) | 주 간 ICMS 세율 |
|---|---|---|
| 남부 및 남동부(SP, RJ, MG, RS, SC, PR, ES) | 남부 및 남동부 | 12% |
| 남부 및 남동부 | 북부, 북동부, 중서부 + Espírito Santo | 7% |
| 북부, 북동부, 중서부 | 모든 주 | 12% |
| 모든 주(외국산 함량 40% 초과 수입품) | 모든 주 | 4% |
주 내(동일 주) 거래의 경우 세율은 주에 따라 17%에서 22%까지입니다. 2024년 기준으로 Pernambuco는 20.5%, Bahia는 20.5%, Maranhão는 22%, Rio de Janeiro는 20%, São Paulo는 18%, Santa Catarina는 17%를 부과합니다. 2024년에만 11개 주에서 세율이 변경되었습니다 — Bahia는 2월 7일에 19%에서 20.5%로, Maranhão는 2월 19일에 20%에서 22%로 인상되었습니다 — 따라서 추출 검증 로직은 세금계산서를 수령하는 모든 브라질 주의 최신 세율표를 유지해야 합니다.
CFOP 코드 해석
CFOP(Código Fiscal de Operações e Prestações)은 거래의 과세 성격을 분류하는 4자리 코드입니다. SEFAZ에서 사전 정의하며 자유 텍스트가 아닙니다. 첫 번째 숫자는 이 거래가 매입인지 매출인지, 그리고 상품이 어느 주에서 왔는지를 알려줍니다.
| CFOP 접두사 | 의미 | 예시 |
|---|---|---|
| 1xxx | 매입 — 동일 주 | 1101 = 공업화 목적 구매 (동일 주) |
| 2xxx | 매입 — 타 주 | 2101 = 공업화 목적 구매 (타 주) |
| 3xxx | 매입 — 해외 (수입) | 3101 = 공업화 목적 수입 |
| 5xxx | 매출 — 동일 주 | 5101 = 회사 생산/조립 제품 판매 (동일 주) |
| 6xxx | 매출 — 타 주 | 6101 = 생산/조립 제품 판매 (타 주) |
| 7xxx | 매출 — 해외 (수출) | 7101 = 생산/조립 제품 수출 |
수취인의 경우, 매입 invoice(1xxx, 2xxx, 3xxx)의 CFOP는 ICMS 및 IPI 공제 가능 여부와 적용 규칙을 결정합니다. CFOP 1101(동일 주 공업화 목적 구매)은 일반적으로 내부 세율로 전체 ICMS 공제를 받을 수 있습니다. CFOP 1102(동일 주 재판매 목적 구매)는 다른 처리가 적용될 수 있습니다. 이는 CST(Código de Situação Tributária)와 상호 작용합니다. CST는 품목이 과세(00), 면세(40), 세금 대체(60) 또는 특별 제도에 해당하는지 여부를 지정하는 2자리 코드입니다. CFOP는 어떤 유형의 거래인지 알려주고, CST는 어떻게 과세되는지 알려줍니다. 두 가지 모두 추출하여 상호 검증해야 합니다.
NCM 분류 및 하위 영향
NCM(Nomenclatura Comum do Mercosul)은 국제 조화 시스템에 Mercosur 특정 2자리를 추가한 8자리 코드입니다. 모든 라인 항목에 표시되며, 해당 제품의 IPI 세율(TIPI 표에 게시, Receita Federal이 업데이트하는 400페이지 이상의 PDF), 수입 관세율, 그리고 결정적으로 표준 세금 계산을 대체하는 세금 혜택(감면 세율, 추정 공제 또는 면제) 자격 여부를 결정합니다.
세금 혜택 제도에 해당하는 NCM 코드는 인보이스에 표시된 표준 ICMS 또는 IPI 세율이 공제로 기록해야 하는 금액이 아닐 수 있음을 의미합니다. 추출 워크플로우는 NCM이 알려진 혜택 범주와 일치하는 모든 라인 항목을 플래그 지정하여 세무 팀이 총 세율이 정확하다고 가정하지 않고 공제 계산을 검증할 수 있도록 해야 합니다.
2026년 세제 개혁과 추출 워크플로우에 미치는 영향
브라질의 세제 개혁(헌법 개정안 132/2023을 통해 제정되고 보충법 214/2025로 규제됨)은 국가의 간접세 시스템을 근본적으로 재구성하고 있습니다. 5개의 기존 세금(PIS, COFINS, ICMS, ISS, IPI)은 점진적으로 이중 VAT 모델(연방 차원의 CBS(Contribuição sobre Bens e Serviços), 주 및 지자체 차원의 IBS(Imposto sobre Bens e Serviços), 그리고 건강이나 환경에 유해한 것으로 간주되는 상품에 대한 선별세(IS))로 대체되고 있습니다.
전환 일정은 다음과 같습니다:
| 연도 | 변경 사항 | NF-e 추출에 미치는 영향 |
|---|---|---|
| 2026 | 테스트 단계: CBS 0.9%, IBS 0.1%가 인보이스에 표시되지만 징수되지는 않습니다. 기존 및 신규 세금 필드가 모두 XML에 나타납니다. | NF-e 스키마가 기존 <ICMS>, <PIS>, <COFINS> 그룹과 함께 새로운 <CBS> 및 <IBS> 요소 그룹으로 확장됩니다. 추출 로직은 이중 스키마를 처리해야 합니다. |
| 2027 | CBS 징수가 시작되어 PIS 및 COFINS를 대체합니다. IPI 세율이 단계적으로 인하되기 시작합니다. | 추출 시 어떤 세금 필드가 재정적(실제 금전적 영향)인지 정보 제공용(여전히 존재하는 레거시 필드)인지 구분해야 합니다. |
| 2029 | IBS가 단계적으로 도입되어 주별로 ICMS 및 ISS를 대체합니다. 이중 체제: 일부 주는 레거시 ICMS 하에 있고, 다른 주는 IBS 하에 있습니다. | 주별 세율 변동 문제가 심화됩니다. 판매자의 주 전환 상태에 따라 한 인보이스는 ICMS를, 다른 인보이스는 IBS를 가질 수 있습니다. |
| 2033 | 완전 시행: ICMS, ISS, PIS, COFINS 및 IPI 폐지. CBS, IBS 및 선별세만 남습니다. | XML 스키마가 안정화됩니다. 추출 매핑을 최종 필드 세트로 통합할 수 있습니다. |
AP 팀의 즉각적인 운영 과제는 2026년부터 2033년까지의 이중 스키마 기간입니다. 이 기간 동안 NF-e XML 파일에는 기존 및 신규 세금 요소 그룹이 동시에 포함됩니다. 2026년 이전 스키마에 하드코딩된 필드 매핑(예: vICMS, vPIS, vCOFINS만 읽는 방식)을 사용하는 추출 워크플로는 새로운 CBS/IBS 필드를 자동으로 무시합니다. 이는 미래의 문제가 아니라 지금 시작됩니다. 2026년 8월 1일부터 CBS/IBS 필드 없이 제출된 NF-e XML은 SEFAZ에서 거부됩니다. 스키마 변경은 선택이 아닌 필수입니다.
XML 파싱 스크립트를 작성 중이라면 스키마 분기를 계획하세요. 문서에 존재하는 세금 그룹을 감지하고, 있는 그대로 추출한 후 일관된 출력 열 집합으로 정규화하세요. DANFE에서 AI 기반 추출을 사용하는 경우, CBS/IBS 필드가 인쇄된 표현에 나타나기 시작할 때 인식되는지 공급업체에 확인하세요.
자주 묻는 질문
DANFE만으로 전체 XML 데이터를 얻을 수 있나요?
아니요. DANFE는 XML 데이터의 90% 이상을 생략한 인쇄 요약본입니다. 운송 중 물리적 검사를 위해 설계되었으며, 재무 처리를 위한 것이 아닙니다. 전체 세금 내역, CFOP 코드, NCM 분류, CST 세금 상황 코드, 운송 세부 정보는 XML에만 존재합니다. 공급업체가 DANFE만 보냈다면 XML을 요청하세요. 법적으로 제공해야 하며, DANFE에 인쇄된 44자리 접근 키를 사용하여 SEFAZ에서 직접 검색할 수도 있습니다.
특정 인보이스에 적용되는 ICMS 세율을 어떻게 알 수 있나요?
NF-e의 ICMS 세율은 발행자의 주 등록 정보(<emit>)에서 추출한 원산지 주, 목적지 주(귀사 법인의 주, <dest>), 그리고 상품의 수입 함량이 40%를 초과하는지 여부(주 쌍과 관계없이 4% 세율 적용)에 따라 결정됩니다. XML 자체에는 판매자가 적용한 세율이 pICMS에 포함되어 있지만, 판매자가 올바르게 적용했다고 가정하지 말고 올바른 세율표와 대조하여 검증해야 합니다. 세율 오류는 일반적인 감사 지적 사항입니다.
AI가 CFOP 코드를 자동으로 올바르게 해석할 수 있나요?
CFOP 코드는 문서에서 그대로 추출됩니다. DANFE와 XML에 4자리 코드가 표시됩니다. 도구가 이 코드를 해석할 수 있는지(예: "주 내 구매(재판매용)"와 "주 간 구매(산업화용)" 구분)는 도구의 기능에 따라 다릅니다. 일부 AI 추출 도구는 참조 테이블을 사용하여 CFOP 코드를 설명에 매핑할 수 있습니다. 해석이 워크플로에 중요한 경우, 도구 제공업체에 CFOP 매핑 지원 여부를 확인하거나 Excel에서 별도의 조회 테이블을 유지하여 추출된 코드를 디코딩하세요.
당사는 브라질 ERP 로컬라이제이션이 없습니다. 그래도 NF-e 데이터를 추출할 수 있나요?
네, 가능합니다. XML 자체는 표준 형식 파일이므로 XML 파일만 있으면 모든 회사에서 구문 분석할 수 있습니다. SAP TDF나 Oracle Brazil 로컬라이제이션이 없어도 읽을 수 있습니다. Python 스크립트, 온라인 XML-to-Excel 변환기 또는 AI 추출 도구를 사용하여 데이터를 스프레드시트로 가져올 수 있습니다. ERP 로컬라이제이션 모듈은 통합(자동 전기, SEFAZ 검증, 세금 계정 매핑)을 추가하지만 추출에는 필요하지 않습니다.
NF-e 추출이 SPED 보고 요구 사항을 충족하나요?
아니요. SPED(디지털 공공 회계 시스템)는 별도 신고가 필요한 브라질의 디지털 장부 시스템입니다. 주세는 EFD-ICMS/IPI, PIS/COFINS는 EFD-Contribuições, 디지털 회계 장부는 ECD가 필요합니다. NF-e 추출은 송장 데이터를 Excel로 가져오지만 SPED 준수 파일을 생성하지는 않습니다. SPED 신고는 추출된 데이터를 특정 SPED 레이아웃 코드에 매핑하고 정부 승인 소프트웨어를 통해 제출해야 하는 별도의 워크플로로, 브라질 회계 팀 또는 세무 컴플라이언스 제공업체가 처리합니다.
이미 데이터를 추출한 후에 공급업체가 NF-e를 취소하면 어떻게 되나요?
발행자는 상품이 아직 배송되지 않은 경우 승인 후 24시간 이내에 NF-e를 취소할 수 있습니다. 취소는 동일한 44자리 접근 키에 연결된 SEFAZ 시스템에 이벤트(취소 이벤트)를 생성합니다. 해당 키에 대한 모든 조회는 취소된 상태를 반환합니다. 추출 워크플로는 특히 지급일이 임박한 송장의 경우 SEFAZ에 대해 접근 키를 주기적으로 검증하여 취소된 문서에 대한 전기를 방지해야 합니다. 2026년 개혁에 따라 과세 사건 이후 취소 시 세금의 66%에 해당하는 벌금이 부과되므로 늦은 취소 빈도가 줄어들 것으로 예상되지만, 검증은 여전히 필요한 통제 수단입니다.
여러 개의 NF-e XML 파일을 일괄 추출하려면 어떻게 해야 하나요?
XML 기반 방식은 XML 파일이 있는 디렉토리를 반복 처리하는 스크립트를 사용하여 각 파일에서 동일한 XPath 쿼리 세트를 추출하고 결과를 누적 스프레드시트에 추가합니다. DANFE PDF에서 AI 기반 추출을 사용하는 경우 일괄 처리 기능을 활용하세요. 여러 DANFE 파일을 함께 업로드하고 열 정의를 한 번만 지정하면 도구가 각 문서에서 데이터를 추출하여 단일 Excel 파일로 병합합니다. 이 방식은 혼합 형식도 처리합니다. 일부 공급업체가 DANFE PDF를 보내고 다른 공급업체가 XML을 인쇄물로 보내는 경우 일괄 처리가 동일한 과정에서 두 형식을 모두 추출합니다.
NF-e 데이터 추출의 정확도는 수동 입력과 비교하여 어떤가요?
XML 기반 추출의 경우 대상 필드에 대해 사실상 100%의 정확도를 제공합니다. 시각적 레이아웃을 해석하는 것이 아니라 기계 판독 가능 파일에서 구조화된 데이터를 읽기 때문입니다. DANFE에서 AI 기반 추출의 경우 인쇄된 텍스트 정확도는 최대 99%에 달할 수 있지만, 숫자 하나가 잘못 입력되면 키가 무효화되는 44자리 액세스 키와 같은 복잡한 필드의 정확도는 도구의 긴 숫자 문자열 처리 방식에 따라 달라집니다. 수동 입력 대비 실제 정확도 향상은 단순히 문자 수준의 정밀도가 아니라 완전성에 있습니다. 사람이 DANFE에서 데이터를 입력할 때 일반적으로 송장당 8~12개 필드를 캡처합니다. 자동화된 추출은 모든 문서에서 지정한 모든 필드를 캡처하므로, 가장 흔하고 눈에 잘 띄지 않는 수동 입력 오류인 데이터 누락을 제거합니다.
DANFE에서 스프레드시트까지
인쇄된 DANFE를 처리할 때와 NF-e XML에서 데이터를 추출할 때의 데이터 품질 차이는 점진적이지 않습니다. 10개 필드와 500개 필드의 차이입니다. 더 중요한 것은 브라질 세금 공제액을 추측하는 것과 검증하는 것의 차이라는 점입니다. 공급업체가 생성하는 모든 NF-e XML에는 환급받을 수 있는 정확한 ICMS, IPI, PIS, COFINS 금액이 포함되어 있으며, DANFE만으로 처리하는 모든 건은 그 세부 정보를 읽지 못한 채 남게 됩니다.