Brasilianische NF-e Nota Fiscal
XML-zu-Excel-Extraktion
Das gedruckte Dokument auf Ihrem Schreibtisch — die DANFE — enthält weniger als 10 % der Daten in der NF-e Ihres Lieferanten. Jede positionsbezogene Steuerberechnung, jeder CFOP-Steuercode, jede NCM-Produktklassifizierung und die vollständige PIS/COFINS-Aufschlüsselung, die Ihre Vorsteuerabzüge bestimmt: Nichts davon erscheint auf dieser Seite. Die vollständige Rechnung ist die XML-Datei, die Ihr brasilianischer Lieferant bereits erstellt hat, und sie enthält über 500 strukturierte Felder, für die Sie bezahlen, die Sie aber nicht nutzen.
Wichtige Erkenntnisse
- Die DANFE, die Ihr AP-Team manuell in Excel überträgt, wurde für die Autobahnpolizei entwickelt, um Barcodes während des Warentransports zu scannen — nicht für die Buchhaltung. Sie lässt 90 % Ihrer Rechnungsdaten aus, einschließlich aller positionsbezogenen Steueraufschlüsselungen, die Ihre ICMS- (staatliche Umsatzsteuer) und PIS/COFINS- (bundesstaatlicher Sozialbeitrag) Gutschriftwiederherstellung bestimmen.
- Die vollständige Rechnung — eine NF-e-XML (Nota Fiscal Eletrônica, Brasiliens elektronisches Rechnungsformat) mit über 500 maschinenlesbaren Feldern — existiert bereits für jede Transaktion, da das brasilianische Gesetz Ihren Lieferanten verpflichtet, sie digital zu signieren und an SEFAZ, die staatliche Steuerbehörde, zu übermitteln, bevor Waren das Lager legal verlassen dürfen.
- Sie benötigen kein brasilianisches ERP-Lokalisierungsmodul — speisen Sie die NF-e-XML oder die DANFE in ImageToTable.ai ein, definieren Sie die benötigten Spalten einmal, und erhalten Sie jedes Steuerdetail, einschließlich CFOP (Steuervorgangscodes), NCM (Produktklassifizierungen) und ICMS-Beträge, in Excel, ohne eine einzige XPath-Abfrage zu schreiben.
Wie dieser Leitfaden mit unseren anderen NF-e-Inhalten zusammenhängt: Diese Seite ist der Methodenvergleich — sie führt durch die drei Extraktionsansätze (ERP-Modul, XML-Skripting, KI-Extraktion) und die Felder, die jeder Ansatz wiederherstellen kann. Wenn Sie die vollständige technische Referenz benötigen — vollständige XML-Feldzuordnungstabellen, CST/CFOP/NCM-Codetabellen, ICMS-ST-Handhabung und ereignisgesteuerte Extraktion (Stornierung, CC-e, Notfall) — lesen Sie unseren vollständigen NF-e-Extraktions-Feldzuordnungsleitfaden. Wenn Sie neu bei NF-e sind, beginnen Sie mit dem Anfängerleitfaden zur Nota Fiscal Eletrônica.
Die DANFE-Falle: Warum die meisten internationalen AP-Teams das falsche Dokument verarbeiten
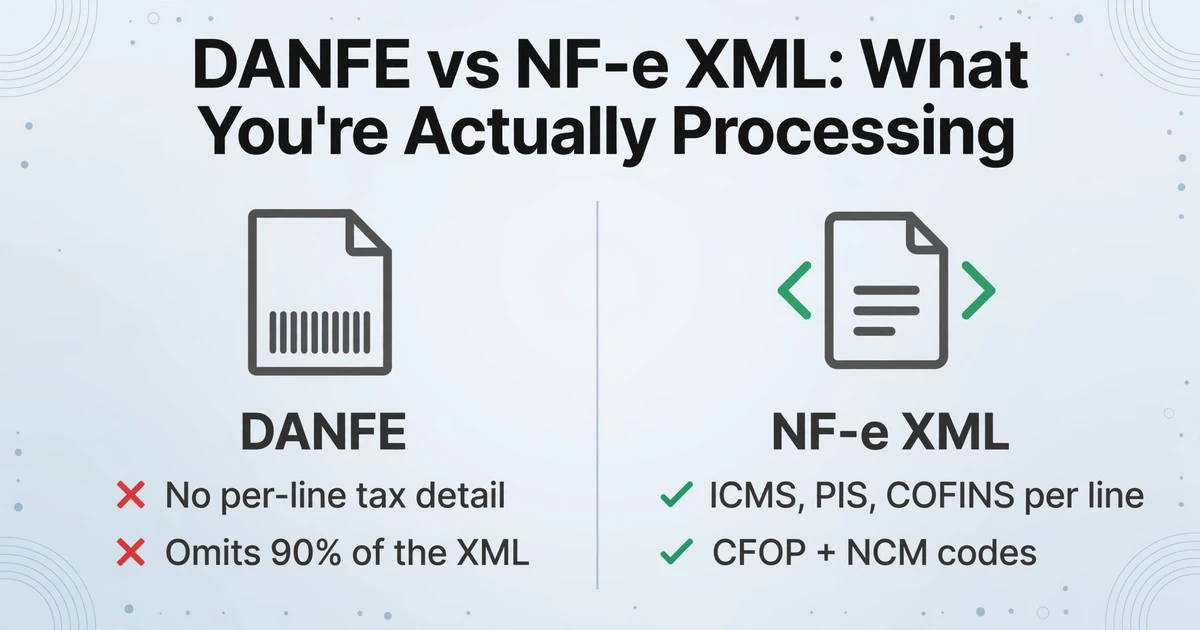
Wenn eine Lieferung von einem brasilianischen Lieferanten eintrifft, übergibt der Fahrer ein gedrucktes Dokument mit einem Barcode und einer 44-stelligen Zahl in der oberen rechten Ecke. Dies ist die DANFE — Documento Auxiliar da Nota Fiscal Eletrônica (Hilfsdokument der elektronischen Rechnung) — und das Wort „Hilfs-“ in ihrem Namen ist nicht dekorativ. Sie existiert für genau einen Zweck: physische Waren während des Transports zu begleiten, damit Steuerbehörden an Straßenkontrollpunkten den Barcode scannen und die Sendung überprüfen können. Sie wurde nie als vollständige Rechnung konzipiert.
Doch für die überwiegende Mehrheit der internationalen AP-Teams, die brasilianische Waren erhalten, ist die DANFE die Rechnung. Sie wird gescannt, per OCR erfasst oder manuell in das ERP eingegeben. Der 44-stellige Zugriffsschlüssel wird kopiert — gewissenhaft, alle 44 Stellen — in ein Feld mit der Bezeichnung „Rechnungsnummer“. Und dann wendet sich der AP-Sachbearbeiter dem nächsten Dokument zu, ohne zu wissen, dass für jeden Lieferanten und jede Sendung die vollständige Rechnung bereits in einem maschinenlesbaren XML-Format existiert, das die brasilianische Regierung vom Verkäufer verlangt: Er muss es erzeugen, mit einem ICP-Brasil-Zertifikat digital signieren und an SEFAZ (die staatliche Steuerbehörde) übermitteln, bevor die Waren das Lager legal verlassen dürfen.
Das Ausmaß des Datenverlusts ist nicht marginal. Die DANFE druckt eine komprimierte Zusammenfassung — Lieferantenname, Käufername, Datum, Positionen mit Mengen und Einzelpreisen sowie eine Gesamtsumme. Die NF-e-XML, die bei der Autorisierung von über 400 automatisierten Validierungsregeln von SEFAZ geprüft wird, enthält in der aktuellen Layoutversion 4.0, definiert durch die Nota Técnica 2016/002, mehr als 500 strukturierte Tags. Der Unterschied zwischen den beiden Dokumenten ist der Unterschied zwischen einem Kassenbon und dem vollständigen steuerlichen Datensatz einer Transaktion — einem Datensatz, der Ihre Vorsteuerabzüge, Ihren Zollabgleich und Ihren Prüfpfad für die nächsten fünf Jahre bestimmt.
Die Unterscheidung zwischen DANFE und XML ist keine nebensächliche Formalität. Sie ist das wichtigste Konzept für jede AP-Abteilung, die brasilianische Lieferantenrechnungen verarbeitet, und sie hat eine direkte finanzielle Konsequenz: Wenn Ihr Team Daten aus der DANFE erfasst, tippen Sie manuell einen Bruchteil von Informationen neu ein, die bereits in strukturierter, maschinenlesbarer Form vorliegen — und Sie verpassen die Steuerdetails, die darüber entscheiden, ob Sie bei jeder Transaktion den richtigen Betrag an ICMS, IPI, PIS und COFINS zurückerhalten.
Was in einer NF-e-XML steckt – und warum das für die Kreditorenbuchhaltung wichtig ist
Eine NF-e-XML ist nicht einfach eine Rechnung in spitzen Klammern. Es handelt sich um ein rechtlich verbindliches Steuerdokument mit der digitalen Signatur des Verkäufers, das gegen über 400 SEFAZ-Regeln validiert wurde und Steuerdaten in einer Granularität speichert, die jeden anderen E-Rechnungsstandard außerhalb Brasiliens übertrifft. Zum Vergleich: Der europäische Peppol-BIS-Standard verwendet etwa 100 Elemente. Eine NF-e enthält fünfmal so viele – und jedes Element ist maschinenlesbar.
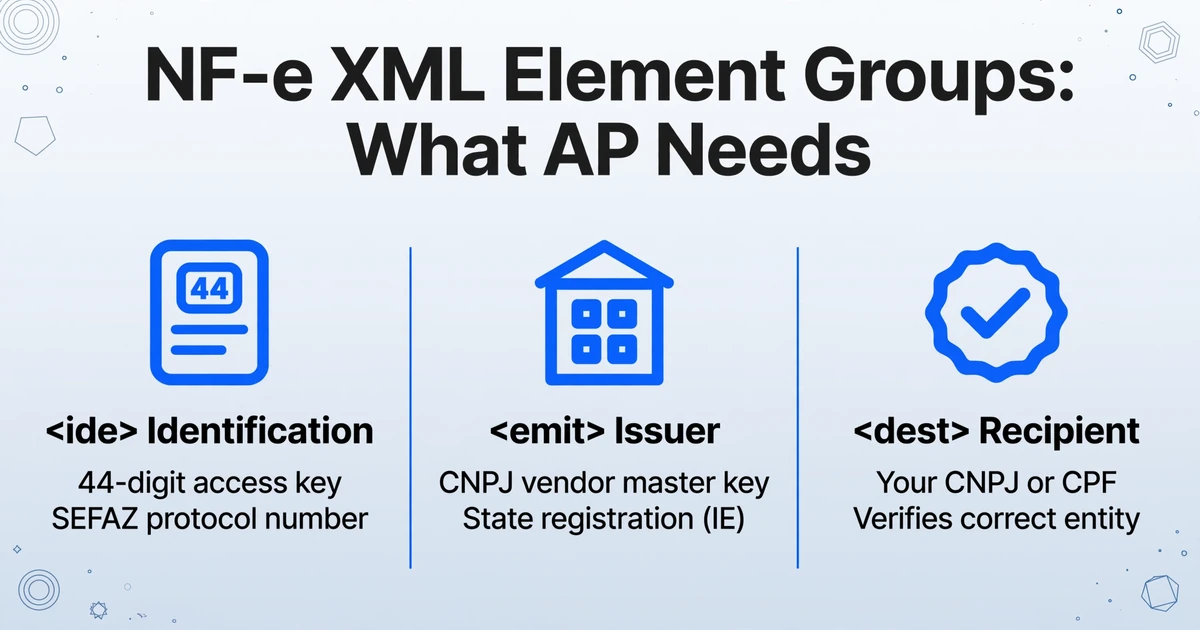
Bevor Sie einen Extraktionsworkflow entwerfen können, müssen Sie verstehen, was Sie extrahieren. Hier sind die wichtigsten Elementgruppen in jeder NF-e-XML und warum sie für die Kreditorenbuchhaltung relevant sind:
| XML-Elementgruppe | Was sie enthält | Warum die AP sie benötigt |
|---|---|---|
<ide> (Identifikation) | 44-stelliger Zugriffsschlüssel, Dokumentmodell (55=NF-e), Serie, Nummer, Ausstellungsdatum/-zeit, Emissionsart, SEFAZ-Autorisierungsprotokoll | Identifiziert jede NF-e weltweit eindeutig. Die Protokollnummer bestätigt die SEFAZ-Autorisierung. Mit dem Zugriffsschlüssel können Sie die Echtheit jederzeit überprüfen. |
<emit> (Aussteller) | CNPJ (14-stellige Unternehmenssteuernummer), Firmenname, Handelsname, vollständige Adresse mit IBGE-Gemeindecode, Inscrição Estadual (staatliche Registrierung) | Die CNPJ ist der Lieferantenstammschlüssel – sie gleicht Ihre Lieferantendatensätze ab. Die staatliche Registrierung bestimmt, welche SEFAZ-Zuständigkeit für den Vorgang zuständig ist. |
<dest> (Empfänger) | Ihre CNPJ oder CPF, Firmenname, Adresse, staatliche Registrierung, ISUF (Steuersubstitutionsindikator) | Bestätigt, dass die Rechnung an Ihre korrekte brasilianische Einheit ausgestellt wurde. Entscheidend für die Anspruchsberechtigung von Steuergutschriften. |
<det> (Positionen) | Produktcode, Beschreibung, NCM (8-stellige Mercosur-Klassifikation), CFOP (4-stelliger Steuervorgangscode), Menge, Einzelpreis, Positionssumme | Jede Position trägt ihre eigene NCM und CFOP – zwei Codes, die die anwendbaren Steuersätze und die Anspruchsberechtigung von Gutschriften bestimmen. Diese erscheinen nicht auf der DANFE. |
<imposto> (Steuern) | ICMS (Bemessungsgrundlage, Satz, Betrag, CST-Steuersituationscode, Ursprung), IPI (Basis, Satz, Betrag, CST), PIS (Basis, Satz, Betrag, CST), COFINS (Basis, Satz, Betrag, CST) | Die vollständige Steuerberechnung auf Positionsebene. Die ICMS-Sätze variieren je nach Ursprungs- und Zielstaat (4 %, 7 % oder 12 % zwischenstaatlich; 17 %–22 % intern). PIS/COFINS bestimmen die bundesstaatlichen Steuergutschriften. Nichts davon erscheint auf der DANFE. |
<total> (Summen) | ICMS-Gesamtsumme, ICMS-ST-Gesamtsumme (Steuersubstitution), IPI-Gesamtsumme, PIS-Gesamtsumme, COFINS-Gesamtsumme, Fracht, Versicherung, Rabatte, NF-e-Nettosumme | Spaltenweise Aufschlüsselung aller Steueraggregate. Gleichen Sie diese mit Ihren ERP-Steuerkonten ab. |
<transp> (Transport) | Spediteur-CNPJ, Frachtmodus, Fahrzeugkennzeichen, Sendungsvolumen und -gewicht | Drei-Wege-Abgleich mit Logistikaufzeichnungen. Frachtbeträge beeinflussen die ICMS-Bemessungsgrundlage. |
<cobr> (Abrechnung) | Zahlungsbedingungen, Ratenfälligkeiten und -beträge, Bankdaten | AP-Planung. Brasilianische Rechnungen enthalten häufig Mehrraten-Zahlungsstrukturen (duplicatas (Ratenwechsel)). |
Der 44-stellige Zugriffsschlüssel (chave de acesso) ist die universelle Kennung der NF-e. Er kodiert den Bundesstaat des Ausstellers (erste 2 Ziffern, gemäß IBGE-Code — 35 für São Paulo, 33 für Rio de Janeiro, 31 für Minas Gerais), das Ausstellungsjahr und den Monat (nächste 4), die CNPJ des Ausstellers (nächste 14), das Dokumentmodell (2), die Serie (3), die fortlaufende Nummer (9), die Emissionsart (1), einen Zufallscode zur Kollisionsvermeidung (8) und eine Modulo-11-Prüfziffer (1). Jede NF-e-XML trägt diesen Schlüssel in ihrem <infNFe Id="NFe...>-Attribut, und Sie können damit SEFAZ direkt abfragen, um die Echtheit zu verifizieren, auf Stornierungen zu prüfen oder die vollständige XML herunterzuladen, falls Ihr Anbieter nur die DANFE gesendet hat.
Die DANFE ist nicht die Rechnung. Die XML ist es. Das brasilianische Steuerrecht verlangt, dass die signierte XML mindestens fünf Jahre lang als rechtlich maßgeblicher Nachweis der Transaktion archiviert wird. Die DANFE — auf Normalpapier gedruckt, ohne Signatur, mit einem Bruchteil der Daten — existiert nur, um die Anforderung der physischen Prüfung während des Warentransports zu erfüllen. Wenn Ihr AP-Team Buchungen auf Basis der DANFE vornimmt, bauen Sie Ihren Prüfpfad auf einem Dokument auf, das das brasilianische Steuerrecht als ergänzend betrachtet.
Einrichten Ihres NF-e-XML-Extraktionsworkflows
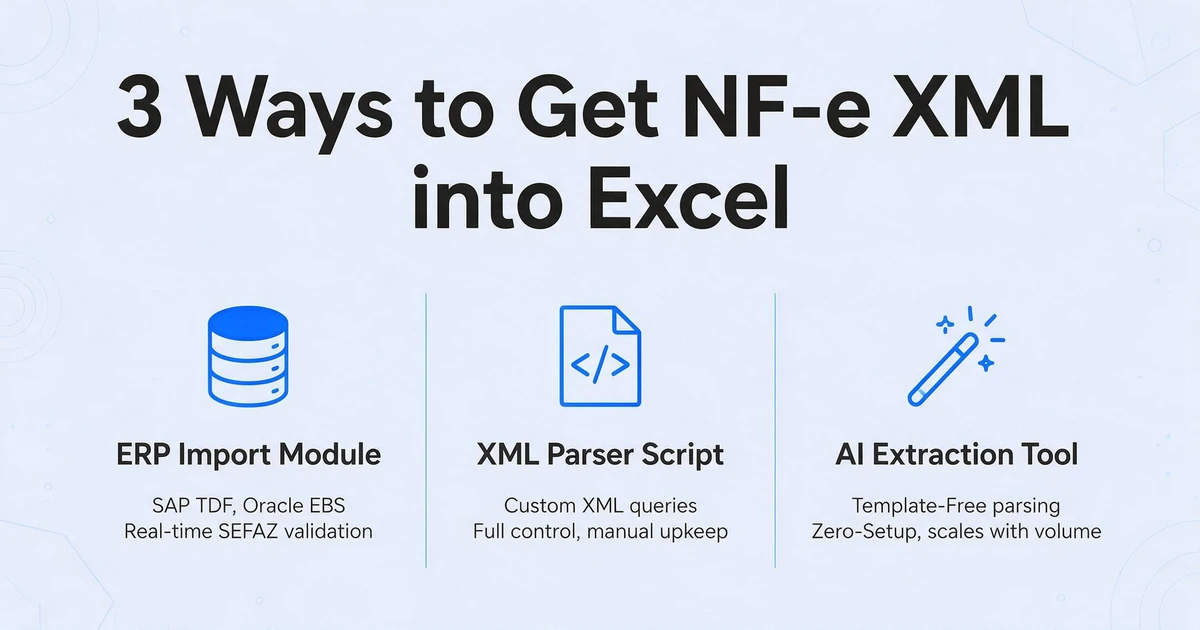
Es gibt drei verschiedene Ansätze, um NF-e-XML-Daten in eine Excel-Tabelle zu übertragen, und sie liegen an sehr unterschiedlichen Punkten des Kosten-Komplexitäts-Spektrums. Welcher für Sie geeignet ist, hängt von Ihrem Volumen, Ihrer ERP-Einrichtung und davon ab, ob Ihre brasilianische Tochtergesellschaft bereits ein Lokalisierungsmodul betreibt.
Methode 1: ERP-Importmodul (SAP TDF, Oracle EBS Brazil, Dynamics 365 Finance)
Wenn Ihr Unternehmen SAP, Oracle EBS oder Microsoft Dynamics 365 mit aktiviertem Brasilien-Lokalisierungsmodul betreibt, kann das ERP selbst NF-e-XML-Dateien direkt importieren. SAPs TDF (Nota-Fiscal-Modul) verarbeitet eingehende NF-e-XMLs über die Transaktion J1BNFE und ordnet jedes XML-Element der entsprechenden SAP-Tabelle zu. Die Oracle-EBS-Brasilien-Lokalisierung (verfügbar ab 12.2.6+) verwendet das Programm XML Generator SEFAZ (P76B601) für Importe. Dynamics 365 Finance bietet einen dedizierten Import-Workflow unter Kreditoren > Brasilianische Lokalisierung > NF-e-XML importieren.
Dies ist der Goldstandard – er validiert in Echtzeit gegen SEFAZ, bucht auf die korrekten Steuerkonten und übernimmt den Drei-Wege-Abgleich automatisch. Er hat allerdings auch seinen Preis. Die Brasilien-Lokalisierungsmodule von SAP und Oracle sind separate Lizenzkosten, und TOTVS – das dominierende ERP unter brasilianischen Mid-Market-Unternehmen mit einem Marktanteil von 33 % laut der jüngsten Umfrage der Fundação Getúlio Vargas (FGV) – ist vollständig auf Brasilien ausgerichtet und außerhalb des Landes unüblich. Wenn Ihr globales AP-Team keine brasilianische ERP-Lokalisierung hat, steht Ihnen dieser Ansatz nicht zur Verfügung.
Methode 2: XML-zu-Excel-Konvertierung
Auf einfachster Ebene ist eine NF-e-XML eine XML-Datei, und jede XML-Datei kann in ein Tabellenformat konvertiert werden. Tools wie der integrierte XML-Import von Microsoft Excel (Daten > Daten abrufen > Aus Datei > Aus XML), Online-Konverter oder Python-Skripte mit Bibliotheken wie xml.etree.ElementTree können die XML-Struktur in Zeilen und Spalten aufteilen.
Die Herausforderung bei generischer XML-Konvertierung ist die Tiefe des NF-e-Schemas. Eine einzelne NF-e-XML verschachtelt Positionsdaten in <det>-Elementen, von denen jedes seinen eigenen <imposto>-Unterbaum mit separaten ICMS-, IPI-, PIS- und COFINS-Gruppen enthält. Eine naive XML-zu-CSV-Konvertierung flacht dies zu einer einzigen Zeile mit Hunderten von Spalten ab, von denen viele identisch benannt sind (jede Position hat ein vProd-Feld, jede Steuergruppe hat ein vBC-Feld). Die Ausgabe ist technisch gesehen „in Excel“, aber ohne erhebliche Bereinigung nicht nutzbar.
Pythons xml.etree oder lxml mit expliziten XPath-Abfragen gibt Ihnen präzise Kontrolle – Sie extrahieren genau die Elemente, die Sie benötigen, und ordnen sie benannten Spalten zu. Das funktioniert gut, wenn Entwicklungsressourcen verfügbar sind, erfordert jedoch die Pflege von XPath-Zuordnungen, die brechen, sobald das NF-e-Schema aktualisiert wird. Da die Steuerreform 2026 neue CBS/IBS-Elementgruppen zum Schema hinzufügt (siehe unten), müssen diese Zuordnungen aktualisiert werden.
Methode 3: KI-gestützte Dokumentextraktion
Ein dritter Ansatz – der sowohl die Kosten einer ERP-Lokalisierung als auch die Fragilität von XPath-Skripten vermeidet – ist die KI-basierte Dokumentextraktion. Anstatt XML direkt zu parsen, laden Sie die DANFE (oder das von Ihrem Anbietersystem als PDF gerenderte NF-e-XML) in ein Extraktionstool hoch, legen fest, welche Spalten die Ausgabetabelle enthalten soll – „CNPJ", „Rechnungsnummer", „ICMS-Bemessungsgrundlage", „ICMS-Betrag", „NCM-Code", „CFOP" – und die KI liest das Dokument, um jeden Wert zu lokalisieren, unabhängig davon, wo er auf der Seite erscheint.
Dieser Ansatz – manchmal auch Benutzerdefinierte Spaltenextraktion genannt – funktioniert anders als die vorlagenbasierte OCR. Traditionelle OCR erfordert, dass Sie für jedes Lieferanten-Rechnungslayout eine Vorlage definieren und dem System mitteilen: „Die Rechnungsnummer befindet sich immer an den Koordinaten (x,y)." Wenn sich das Layout ändert, bricht die Vorlage. Die spaltenbasierte Extraktion funktioniert stattdessen durch semantisches Verständnis: Sie benennen die gewünschten Felder, und die KI lokalisiert die entsprechenden Werte überall im Dokument, indem sie versteht, was das Feld bedeutet – nicht, wo es sich befindet. Dies ist für die NF-e-Verarbeitung besonders relevant, da sich die DANFE-Layouts brasilianischer Lieferanten stark unterscheiden – es gibt keine standardisierte visuelle Vorlage, nur das darunterliegende standardisierte XML-Schema.
Die Einschränkung – und das ist eine ehrliche – besteht darin, dass Sie weiterhin aus dem visuellen Layout der DANFE extrahieren und nicht aus dem maschinenlesbaren XML. Sie erhalten die 10 % der Daten, die die DANFE anzeigt, nicht die 500+ Felder im XML. Für viele AP-Anwendungsfälle – Kopfdaten, Positionszeilen, Summen – ist dies ausreichend und deutlich schneller als die manuelle Eingabe. Wenn Sie jedoch die vollständigen PIS/COFINS-Berechnungen pro Zeile, CFOP-Codes oder CST-Steuersituationscodes benötigen, die nur im XML existieren, kann die KI-Extraktion aus der DANFE keine Daten wiederherstellen, die nicht auf der Seite gedruckt sind.
| Methode | Was Sie extrahieren können | Kostenniveau | Einrichtungsaufwand | Laufende Wartung |
|---|---|---|---|---|
| ERP-Importmodul | 100 % der XML-Felder – vollständige Steuerdetails, CFOP, NCM, CST, Transport, Abrechnung | Enterprise (Lizenz + Implementierung) | Hoch – erfordert Bereitstellung des Lokalisierungsmoduls | Mittel – Schema-Updates bei ERP-Versionsupgrades |
| XML-zu-Excel (Skript/Konverter) | 100 % der XML-Felder – jedes Element, für das Sie XPath schreiben | Niedrig (Entwicklungszeit oder kostenlose Tools) | Mittel – XPath-Zuordnung, Schema-Kenntnisse erforderlich | Hoch – XPath-Abfragen brechen bei Schemaänderungen; 2026-CBS/IBS-Felder erfordern Neuschreibungen |
| KI-Extraktion aus DANFE | Alles, was auf der DANFE gedruckt ist (10 % der XML-Daten): Kopf, Positionszeilen, Summen, Zugriffsschlüssel | Niedrig (pro Dokument oder Abonnement) | Niedrig – Spaltennamen definieren, Dokumente hochladen | Minimal – keine zu wartenden Vorlagen; Layoutänderungen werden von der KI übernommen |
| Manuelle Dateneingabe | Was auch immer der AP-Sachbearbeiter Zeit hat zu tippen | Versteckt – 3 Min./Seite zu Personalkosten, ca. 18x langsamer als automatisierte Extraktion | Keiner | Fehlerquote steigt mit dem Volumen |
NF-e-Felder Ihrer Tabelle zuordnen: Was extrahieren und warum
Ob Sie XPath-Abfragen für die XML-Analyse schreiben oder Spaltennamen für die KI-Extraktion festlegen – die Spalten, die Sie wählen, bestimmen den Nutzen der Ausgabe. Hier ist eine praktische Feldzuordnung, die die drei zentralen AP-Workflows abdeckt – Lieferantenprüfung, Drei-Wege-Abgleich und Buchung von Steuergutschriften – anhand der tatsächlichen XML-Elementpfade.
| Ihre Tabellenspalte | NF-e-XML-Element (XPath) | Verwendet für |
|---|---|---|
| Rechnungsnummer | /nfeProc/NFe/infNFe/ide/nNF | Dokumentenidentifikation |
| Zugangsschlüssel | /nfeProc/NFe/infNFe/@Id (die 44 Ziffern nach "NFe" extrahieren) | SEFAZ-Prüfung, Stornoprüfung, XML-Abruf |
| Ausstellungsdatum | /nfeProc/NFe/infNFe/ide/dhEmi (ISO 8601 Datum/Uhrzeit, in lokales Datum umwandeln) | Buchungsdatum, Zahlungsfristberechnung |
| Genehmigungsdatum | /nfeProc/NFe/infNFe/ide/dhSaiEnt | Tatsächlicher Warenversand – SEFAZ vor diesem Zeitstempel genehmigt |
| Lieferanten-CNPJ | /nfeProc/NFe/infNFe/emit/CNPJ | Lieferantenstammabgleich (14-stelliger Schlüssel, ohne Formatierung) |
| Lieferantenname | /nfeProc/NFe/infNFe/emit/xNome | Lieferantenprüfung |
| Lieferanten-Staats-IE | /nfeProc/NFe/infNFe/emit/IE | Staatliche Steuerregistrierung – bestimmt ICMS-Zuständigkeit |
| Positions-NCM | /nfeProc/NFe/infNFe/det[n]/prod/NCM | Produktklassifikation – prüft IPI-Satz und Einfuhrabgabenpflicht |
| Positions-CFOP | /nfeProc/NFe/infNFe/det[n]/prod/CFOP | Steuerlicher Vorgangstyp – bestimmt Steuerbehandlung und Vorsteuerabzugsberechtigung |
| Positionsbeschreibung | /nfeProc/NFe/infNFe/det[n]/prod/xProd | Bestellabgleich |
| Menge | /nfeProc/NFe/infNFe/det[n]/prod/qCom | Wareneingangsabstimmung |
| Einzelpreis | /nfeProc/NFe/infNFe/det[n]/prod/vUnCom | Bestellpreisabgleich |
| Positionssumme | /nfeProc/NFe/infNFe/det[n]/prod/vProd | Prüfung auf Positionsebene |
| ICMS-Besteuerungsgrundlage | /nfeProc/NFe/infNFe/det[n]/imposto/ICMS/*/vBC (variiert nach ICMS-Untergruppe) | Vorsteuerberechnung – muss dem ICMS-Satz für das Ursprungs-Ziel-Bundesstaatspaar entsprechen |
| ICMS-Satz | /nfeProc/NFe/infNFe/det[n]/imposto/ICMS/*/pICMS | Prüfung gegen den korrekten Staatssatz (12% Süd/Südost zwischenstaatlich, 7% in andere Regionen, 4% für Importe; 17%-22% intern) |
| ICMS-Betrag | /nfeProc/NFe/infNFe/det[n]/imposto/ICMS/*/vICMS | Tatsächlich zu buchende ICMS-Gutschrift |
| ICMS-CST | /nfeProc/NFe/infNFe/det[n]/imposto/ICMS/*/CST | Steuersituation – 00=besteuert, 40=befreit, 60=bereits besteuert usw. |
| IPI-Betrag | /nfeProc/NFe/infNFe/det[n]/imposto/IPI/*/vIPI | Bundesverbrauchsteuer – von Industriebetrieben als Vorsteuer abziehbar |
| PIS-Betrag | /nfeProc/NFe/infNFe/det[n]/imposto/PIS/*/vPIS | Bundesabgabe — 1,65 % nicht-kumulativer Satz |
| COFINS-Betrag | /nfeProc/NFe/infNFe/det[n]/imposto/COFINS/*/vCOFINS | Bundesabgabe — 7,6 % nicht-kumulativer Satz, größter Bundessteuerposten |
| Rechnungsbetrag | /nfeProc/NFe/infNFe/total/ICMSTot/vNF | Nettorechnungswert — der zu zahlende Betrag |
Ein entscheidendes Detail: Der ICMS-Elementpfad hängt von der Steuersituation ab. Das NF-e-Schema verwendet unterschiedliche XML-Untergruppen für verschiedene ICMS-Regelungen – ICMS00 für standardmäßig besteuerte Vorgänge, ICMS40 für steuerbefreite, ICMS60 für zuvor besteuerte mit Steuersubstitution. Ihre Extraktionslogik muss diese verzweigte Struktur berücksichtigen: Prüfen Sie, welche Untergruppe unter <ICMS> vorhanden ist, bevor Sie versuchen, deren Kindelemente zu lesen.
Brasiliens Steuerkomplexität in extrahierten Daten bewältigen
Das Extrahieren der Daten ist der erste Schritt. Die Validierung ist der Punkt, an dem die eigentliche Arbeit beginnt – und an dem die meisten Fehler entstehen, die bei einer Steuerprüfung ans Licht kommen. Brasiliens Steuersystem funktioniert auf drei Regierungsebenen (Bund, Bundesstaaten, Gemeinden) mit Sätzen, die je nach Produktklassifizierung, Ursprungs-Ziel-Paar und rechtlicher Natur des Vorgangs variieren. Hier sind die Validierungsprüfungen, die Teil jedes NF-e-Datenextraktions-Workflows sein sollten:
ICMS-Satzvalidierung nach Bundesstaat-Paar
ICMS-Sätze sind nicht einheitlich. Bei zwischenstaatlichen Transaktionen wird der Satz durch die Ursprungs- und Zielbundesstaaten bestimmt:
| Von (Ursprungsregion) | Nach (Zielregion) | Zwischenstaatlicher ICMS-Satz |
|---|---|---|
| Süden & Südosten (SP, RJ, MG, RS, SC, PR, ES) | Süden & Südosten | 12% |
| Süden & Südosten | Norden, Nordosten, Mittelwesten + Espírito Santo | 7% |
| Norden, Nordosten, Mittelwesten | Jeder Bundesstaat | 12% |
| Jeder Bundesstaat (importierte Waren mit >40% ausländischem Anteil) | Jeder Bundesstaat | 4% |
Bei internen (innerstaatlichen) Transaktionen liegen die Sätze je nach Bundesstaat zwischen 17% und 22%. Seit 2024 erhebt Pernambuco 20,5%, Bahia 20,5%, Maranhão 22%, Rio de Janeiro 20%, São Paulo 18%, Santa Catarina 17%. Diese Sätze änderten sich allein 2024 für 11 Bundesstaaten – Bahias Satz stieg am 7. Februar von 19% auf 20,5%, Maranhão am 19. Februar von 20% auf 22% – und Ihre Extraktionsvalidierungslogik muss mit der Satztabelle für jeden brasilianischen Bundesstaat, von dem Sie Rechnungen erhalten, aktuell bleiben.
CFOP-Code-Interpretation
Der CFOP (Código Fiscal de Operações e Prestações) ist ein 4-stelliger Code, der die steuerliche Art der Transaktion klassifiziert. Er wird von der SEFAZ vorgegeben – kein Freitext – und die erste Ziffer zeigt an, ob es sich um einen Wareneingang oder -ausgang handelt und aus welchem Bundesstaat die Waren stammen:
| CFOP-Präfix | Bedeutung | Beispiel |
|---|---|---|
| 1xxx | Wareneingang – innerhalb des Bundesstaates | 1101 = Einkauf zur Weiterverarbeitung (innerstaatlich) |
| 2xxx | Wareneingang – aus anderem Bundesstaat | 2101 = Einkauf zur Weiterverarbeitung (zwischenstaatlich) |
| 3xxx | Wareneingang – aus dem Ausland (Import) | 3101 = Import zur Weiterverarbeitung |
| 5xxx | Warenausgang – innerhalb des Bundesstaates | 5101 = Verkauf eigener Produkte (innerstaatlich) |
| 6xxx | Warenausgang – in anderen Bundesstaat | 6101 = Verkauf eigener Produkte (zwischenstaatlich) |
| 7xxx | Warenausgang – ins Ausland (Export) | 7101 = Export eigener Produkte |
Für den Empfänger bestimmt der CFOP auf einer Eingangsrechnung (1xxx, 2xxx oder 3xxx), ob ICMS- und IPI-Gutschriften verfügbar sind und unter welchen Regeln. Ein CFOP 1101 (innerstaatlicher Einkauf zur Weiterverarbeitung) berechtigt in der Regel zur vollen ICMS-Gutschrift zum internen Satz. Ein CFOP 1102 (innerstaatlicher Einkauf zum Weiterverkauf) kann anders behandelt werden. Dies interagiert mit dem CST (Código de Situação Tributária) – dem 2-stelligen Code, der angibt, ob der Artikel besteuert (00), befreit (40), der Steuersubstitution unterliegt (60) oder einer Sonderregelung unterfällt. Der CFOP sagt Ihnen, welche Art von Vorgang dies ist; der CST sagt Ihnen, wie er besteuert wird. Beide müssen extrahiert und kreuzvalidiert werden.
NCM-Klassifikation und ihre Auswirkungen auf die nachgelagerten Prozesse
Der NCM (Nomenclatura Comum do Mercosul) ist ein 8-stelliger Code, der auf dem internationalen Harmonisierten System basiert und um zwei Mercosur-spezifische Ziffern ergänzt wird. Er erscheint auf jeder Position und bestimmt den IPI-Satz für dieses Produkt (veröffentlicht in der TIPI-Tabelle, einem über 400-seitigen PDF, das von der Receita Federal aktualisiert wird), etwaige Einfuhrzollsätze und – entscheidend – ob das Produkt für Steuervergünstigungen (ermäßigte Sätze, angenommene Gutschriften oder Befreiungen) in Frage kommt, die die Standardsteuerberechnung außer Kraft setzen.
Ein NCM-Code, der unter ein Steuervergünstigungsregime fällt, bedeutet, dass der auf der Rechnung ausgewiesene reguläre ICMS- oder IPI-Satz möglicherweise nicht der Satz ist, den Sie als Gutschrift verbuchen. Ihr Extraktionsworkflow sollte jede Position kennzeichnen, deren NCM mit bekannten Vergünstigungskategorien übereinstimmt, damit Ihre Steuerabteilung die Gutschriftsberechnung überprüfen kann – anstatt einfach davon auszugehen, dass der Bruttosatz korrekt ist.
Die Steuerreform 2026 und was sie für Ihren Extraktionsworkflow bedeutet
Die brasilianische Steuerreform – verabschiedet durch Verfassungszusatz 132/2023 und geregelt durch Ergänzungsgesetz 214/2025 – restrukturiert das indirekte Steuersystem des Landes grundlegend. Fünf bestehende Steuern (PIS, COFINS, ICMS, ISS und IPI) werden schrittweise durch ein duales Mehrwertsteuermodell ersetzt: CBS (Contribuição sobre Bens e Serviços) auf Bundesebene und IBS (Imposto sobre Bens e Serviços) auf Staats- und Gemeindeebene, plus eine Selektivsteuer (IS) auf Waren, die als gesundheits- oder umweltschädlich gelten.
Der Übergangszeitplan ist:
| Jahr | Was passiert | Auswirkung auf die NF-e-Extraktion |
|---|---|---|
| 2026 | Testphase: CBS zu 0,9 %, IBS zu 0,1 % werden auf Rechnungen ausgewiesen, aber nicht erhoben. Sowohl alte als auch neue Steuerfelder erscheinen im XML. | NF-e-Schema erweitert um neue <CBS>- und <IBS>-Elementgruppen neben den bestehenden <ICMS>-, <PIS>-, <COFINS>-Gruppen. Die Extraktionslogik muss mit dualen Schemata umgehen. |
| 2027 | CBS-Erhebung beginnt und ersetzt PIS und COFINS. Die IPI-Sätze beginnen auszulaufen. | Die Extraktion muss unterscheiden, welche Steuerfelder fiskalisch (tatsächliche monetäre Auswirkung) vs. informatorisch (noch vorhandene Legacy-Felder) sind. |
| 2029 | IBS-Phase beginnt und ersetzt ICMS und ISS Bundesstaat für Bundesstaat. Duales Regime: einige Bundesstaaten unter Legacy-ICMS, andere unter IBS. | Das Problem der unterschiedlichen Staatssätze verschärft sich – eine Rechnung kann ICMS, eine andere IBS enthalten, abhängig vom Übergangsstatus des Verkäufers. |
| 2033 | Vollständige Umsetzung: ICMS, ISS, PIS, COFINS und IPI werden abgeschafft. Nur CBS, IBS und Selektivsteuer bleiben bestehen. | XML-Schema stabilisiert sich. Extraktionszuordnungen können auf den endgültigen Feldsatz konsolidiert werden. |
Die unmittelbare operative Herausforderung für AP-Teams ist die Doppelschema-Phase von 2026 bis 2033. In diesen Jahren enthalten NF-e-XML-Dateien gleichzeitig sowohl alte als auch neue Steuerelementgruppen. Ein Extraktionsworkflow, der Feldzuordnungen fest auf das Schema vor 2026 codiert (nur vICMS, vPIS, vCOFINS liest), ignoriert die neuen CBS/IBS-Felder stillschweigend. Dies ist kein Zukunftsproblem – es beginnt jetzt. Ab 1. August 2026 werden NF-e-XMLs ohne CBS/IBS-Felder von SEFAZ abgewiesen. Die Schemaänderung ist verpflichtend, nicht optional.
Wenn Sie XML-Parsing-Skripte schreiben, planen Sie Schema-Verzweigungen ein: Erkennen Sie, welche Steuergruppen im Dokument vorhanden sind, extrahieren Sie die jeweils vorhandenen und normalisieren Sie sie in einen konsistenten Ausgabespaltensatz. Wenn Sie KI-basierte Extraktion aus dem DANFE verwenden, klären Sie mit Ihrem Anbieter, ob CBS/IBS-Felder erkannt werden, sobald sie auf der gedruckten Darstellung erscheinen.
Häufig gestellte Fragen
Kann ich die vollständigen XML-Daten allein aus dem DANFE erhalten?
Nein. Der DANFE ist eine gedruckte Zusammenfassung, die mehr als 90 % der Daten im XML auslässt. Er wurde für die physische Inspektion während des Transports entwickelt, nicht für die Finanzverarbeitung. Die vollständigen Steueraufschlüsselungen, CFOP-Codes, NCM-Klassifikationen, CST-Steuersituationscodes und Transportdetails existieren nur im XML. Wenn Ihr Anbieter nur den DANFE gesendet hat, fordern Sie das XML an – er ist gesetzlich zur Bereitstellung verpflichtet, und Sie können es auch von SEFAZ mit dem auf dem DANFE aufgedruckten 44-stelligen Zugangsschlüssel abrufen.
Wie erfahre ich, welcher ICMS-Satz für eine bestimmte Rechnung gilt?
Der ICMS-Satz auf einer NF-e wird bestimmt durch den Ursprungsstaat (aus der staatlichen Registrierung des Ausstellers in <emit>), den Zielstaat (Staat Ihres Unternehmens in <dest>) und ob die Ware mehr als 40 % importierte Bestandteile enthält (was unabhängig vom Staatspaar den Satz von 4 % auslöst). Das XML selbst führt den vom Verkäufer angewandten Satz in pICMS, aber Sie sollten ihn anhand der korrekten Satztabelle validieren, anstatt anzunehmen, dass der Verkäufer ihn richtig angewandt hat – Satzfehler sind ein häufiger Prüfungsbefund.
Kann KI CFOP-Codes automatisch korrekt interpretieren?
CFOP-Codes werden unverändert aus dem Dokument extrahiert – die 4-stellige Nummer erscheint auf der DANFE und in der XML-Datei. Ob das Tool den Code interpretieren kann (z. B. als „Einkauf im Inland zum Weiterverkauf“ vs. „Einkauf zwischen Bundesstaaten zur Industrialisierung“), hängt von seinen Funktionen ab. Manche KI-Extraktionstools können CFOP-Codes mithilfe einer Referenztabelle ihren Beschreibungen zuordnen. Wenn die Interpretation für Ihren Workflow entscheidend ist, klären Sie mit Ihrem Tool-Anbieter, ob CFOP-Zuordnung unterstützt wird, oder pflegen Sie eine separate Nachschlagetabelle in Excel, um die extrahierten Codes zu entschlüsseln.
Unser Unternehmen hat keine brasilianische ERP-Lokalisierung. Können wir trotzdem NF-e-Daten extrahieren?
Ja. Die XML-Datei selbst hat ein Standardformat, das jedes Unternehmen mit der XML-Datei parsen kann. Sie benötigen weder SAP TDF noch Oracle Brazil-Lokalisierung, um sie zu lesen. Python-Skripte, Online-XML-zu-Excel-Konverter oder KI-Extraktionstools können die Daten alle in eine Tabelle überführen. Das ERP-Lokalisierungsmodul bietet Integration (automatische Buchung, SEFAZ-Validierung, Steuerkontenzuordnung), ist aber für die Extraktion nicht erforderlich.
Deckt die NF-e-Extraktion die SPED-Berichtsanforderungen ab?
Nein. SPED (Sistema Público de Escrituração Digital) ist Brasiliens digitales Buchhaltungssystem, das separate Meldungen erfordert – EFD-ICMS/IPI für die staatliche Steuer, EFD-Contribuições für PIS/COFINS und ECD für digitale Buchhaltungsbücher. Die NF-e-Extraktion überführt die Rechnungsdaten in Excel; sie erzeugt keine SPED-konformen Dateien. SPED-Meldungen erfordern die Zuordnung der extrahierten Daten zu den spezifischen SPED-Layout-Codes und die Übermittlung durch staatlich validierte Software – ein separater Workflow, der von Ihrem brasilianischen Buchhaltungsteam oder Steuer-Compliance-Anbieter durchgeführt wird.
Was passiert, wenn ein Lieferant eine NF-e storniert, nachdem ich die Daten bereits extrahiert habe?
Eine NF-e kann vom Aussteller innerhalb von 24 Stunden nach Autorisierung storniert werden, wenn die Ware noch nicht versandt wurde. Die Stornierung erzeugt ein Ereignis (Stornierungsereignis) im SEFAZ-System, das mit demselben 44-stelligen Zugangsschlüssel verknüpft ist. Jede Abfrage dieses Schlüssels gibt den Status „storniert“ zurück. Ihr Extraktions-Workflow sollte Zugangsschlüssel regelmäßig gegen SEFAZ validieren – insbesondere bei Rechnungen in Zahlungsnähe –, um Buchungen gegen stornierte Dokumente zu vermeiden. Nach der Reform 2026 zieht eine Stornierung nach dem steuerpflichtigen Ereignis eine Strafe von 66 % der fälligen Steuer nach sich, was die Häufigkeit verspäteter Stornierungen reduzieren sollte, aber die Überprüfung bleibt eine notwendige Kontrolle.
Wie verarbeite ich mehrere NF-e-XML-Dateien im Batch?
Bei XML-basierten Methoden verwenden Sie ein Skript, das einen Ordner mit XML-Dateien durchläuft, aus jeder Datei dieselben XPath-Abfragen extrahiert und die Ergebnisse in einer fortlaufenden Tabelle zusammenfasst. Für die KI-gestützte Extraktion aus DANFE-PDFs nutzen Sie die Stapelverarbeitung – laden Sie mehrere DANFE-Dateien gleichzeitig hoch, definieren Sie Ihre Spalten einmal, und das Tool extrahiert die Daten aus jedem Dokument und führt sie in einer einzigen Excel-Datei zusammen. Dieser Ansatz verarbeitet auch gemischte Formate: Wenn einige Lieferanten DANFE-PDFs senden und andere das XML als Ausdruck bereitstellen, extrahiert die Stapelverarbeitung beide Formate in einem Durchlauf.
Wie genau ist die NF-e-Datenextraktion im Vergleich zur manuellen Eingabe?
Bei der XML-basierten Extraktion liegt die Genauigkeit für die abgefragten Felder praktisch bei 100 % – Sie lesen strukturierte Daten aus einer maschinenlesbaren Datei, ohne ein visuelles Layout interpretieren zu müssen. Bei der KI-gestützten Extraktion aus dem DANFE kann die Genauigkeit von gedrucktem Text bis zu 99 % erreichen. Bei komplexen Feldern wie dem 44-stelligen Zugangsschlüssel, bei dem bereits eine vertauschte Ziffer den Schlüssel ungültig macht, hängt die Genauigkeit jedoch von der Verarbeitung langer Zahlenfolgen durch das Tool ab. Der tatsächliche Genauigkeitsgewinn gegenüber der manuellen Eingabe liegt nicht nur in der zeichengenauen Präzision – es geht um Vollständigkeit. Eine Person, die Daten aus einem DANFE erfasst, erfasst typischerweise 8–12 Felder pro Rechnung. Die automatisierte Extraktion erfasst jedes von Ihnen festgelegte Feld in jedem Dokument und vermeidet so die Datenauslassungen, die den häufigsten und am wenigsten sichtbaren Fehler bei der manuellen Eingabe darstellen.
Von der DANFE zur Tabellenkalkulation
Der Qualitätssprung zwischen der Verarbeitung einer gedruckten DANFE und der Extraktion aus einer NF-e-XML ist nicht inkrementell – es ist der Unterschied zwischen 10 Feldern und 500. Wichtiger noch: Es ist der Unterschied zwischen dem Raten bei Ihren brasilianischen Steuergutschriften und dem Verifizieren. Jede NF-e-XML, die Ihr Lieferant erzeugt, enthält die genauen ICMS-, IPI-, PIS- und COFINS-Beträge, die Sie zurückfordern können – und jede, die Sie nur aus der DANFE verarbeiten, lässt diese Details ungenutzt.