ブラジル事業向けNFS-eデータ抽出ガイド
(2026年版)
ブラジルには5,570の自治体があり、そのすべてが独自のサービス請求書システムを運用しています。各自治体は独自のレイアウト、2%から5%のISS税率、そしてサービス提供者が合法的に請求書を発行する前に各取引を検証する独自のウェブサービスを持っています。あなたの会社がブラジルのサービス提供者からサービスを購入している場合(サンパウロのITコンサルティング、リオの法務サービス、ベロオリゾンテのマーケティングなど)、テンプレートベースの抽出ツールでは解決できない文書断片化の問題に直面していることになります。
重要ポイント
- ブラジルの税務当局は、NFS-eのすべてのフィールドをあなたの手元に届く前に検証済みです。それなのに、あなたのチームはすべてを手入力しており、自動クロスマッチ監査を引き起こすエラーを自ら作り出しています。
- ブラジルの5,570の自治体が独自のNFS-eレイアウトを運用しているため、テンプレートベースの抽出ツールは役に立ちません。サンパウロで機能する座標が、ポルトアレグレでは機能しないからです。
- セマンティック抽出は、ページ座標ではなく意味でフィールドを読み取ります(「Prestadorとラベル付けされた14桁のCNPJを探す」など)。列名を11個定義するだけで、ImageToTable.aiがブラジルのどの自治体からでもNFS-eデータを1つのExcelファイルに抽出します。
ブラジルのサービス請求書が、他のどの請求書とも異なる理由
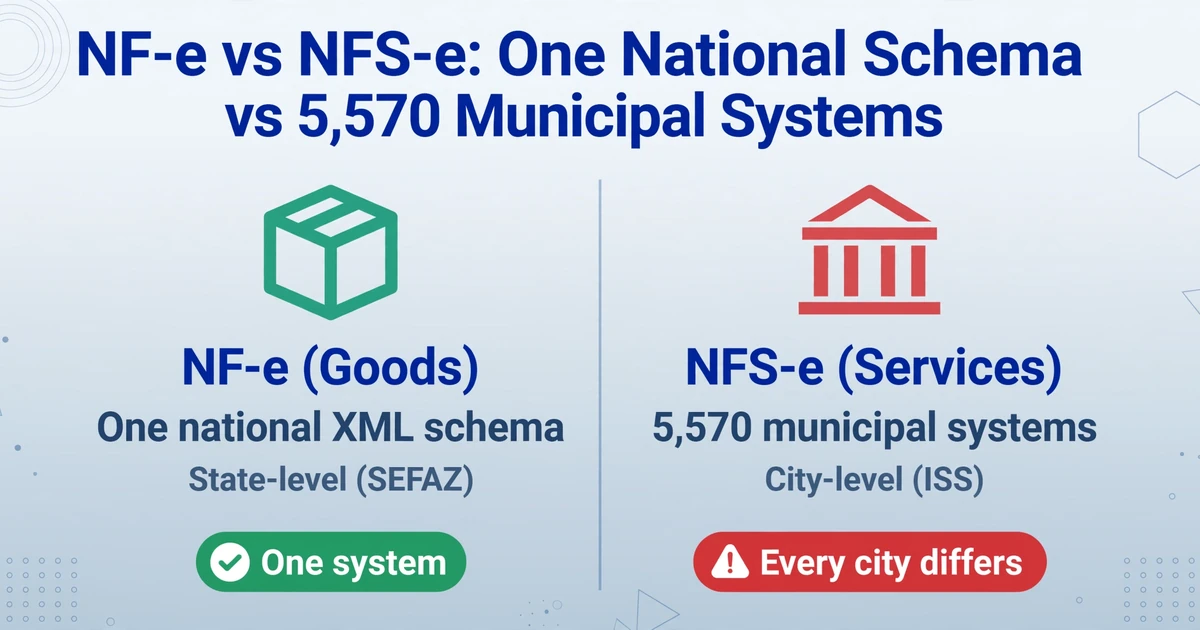
ブラジルの税務文書を扱った経験があれば、NF-e(Nota Fiscal Eletrônica)をご存じでしょう。ブラジル国内のAPチームやブラジル人サプライヤーと取引のあるチームが必ず対応する電子物品請求書です。NF-eはSEFAZ(州財務局)によって州レベルで管理され、全国統一のXMLスキーマ(レイアウトバージョン4.0)に従い、ICMS(商品流通サービス税)という州レベルの物品流通税を伴います。複雑ではありますが、単一のシステムです。
一方、サービス請求書(NFS-e(Nota Fiscal de Serviços))は市レベルで管理されます。この請求書に含まれる税金はISS(サービス税)で、税率、レイアウト、検証フロー、さらにはデジタル証明書の要件まで、都市ごとに異なる可能性があります。サンパウロには独自のNFS-eウェブサービスがあり、リオデジャネイロには別のもの、ベロオリゾンテには3つ目のものがあります。そして、他の5,567の自治体にもそれぞれ独自のシステムがあります。
これは特殊なケースではありません。これはブラジルの財政連邦主義の構造的な現実であり、連邦補完法第116号/2003年に定められています。この法律により、各自治体は独自のISS税率(2%〜5%)を設定し、独自のサービス税徴収を管理する権限を与えられています。連邦政府は国家NFS-eシステム(Sistema Nacional de NFS-e / SNNFS-e)を通じてこれを統一しようと取り組んでおり、2026年初頭時点で1,280以上の自治体が参加しています。しかし、採用は任意であり、多くの主要都市は依然として独自のシステムを運用しています。
これらの文書を受け取るチーム、つまりブラジルのマーケティング代理店やITコンサルタントからのPDFを開くAP担当者にとって、実際的な結果は次のとおりです。NFS-e文書で同じ外観のものは2つとありません。サンパウロで発行されたサービス請求書では、ISSの課税標準(Base de Cálculo)がポルトアレグレで発行されたものとは異なる位置に配置されています。サービス提供者のCNPJ(法人納税者登録番号)が、ある文書ではヘッダーに、別の文書ではサイドバーにある場合もあります。サンパウロで機能するテンプレートは、カンピーナスでは機能しません。
これが、テンプレートベースのOCR(ほとんどの文書抽出ツールが使用するアプローチ)がNFS-eで体系的に失敗する理由です。テンプレートは座標に依存しますが、自治体は座標を変更します。ブラジルのもう一つの主要な電子請求書タイプの仕組みについては、州レベルの物品請求書を扱ったNF-e XML抽出ガイドをご覧ください。
ブラジルのサービスインボイス(NFS-e)に実際に含まれるもの
サービスインボイス(Nota Fiscal de Serviços / NFS-e)からデータを抽出する前に、その内容と、各項目が会計上何を意味するかを理解する必要があります。NFS-eは単なる請求書ではありません。これは法的に必須の項目を含む税務文書であり、その値によって税務上の義務、仕入先マスタの照合、および監査証跡が決まります。
以下は、一般的なNFS-eの主要項目と、受領側にとってそれぞれが重要な理由です。
| 項目 | ポルトガル語名 | 重要ポイント |
|---|---|---|
| サービス提供者CNPJ | CNPJ do Prestador | 14桁の法人税ID。取引先マスターのキーです。SPED調整のため、仕入先記録と完全に一致させる必要があります。 |
| サービス利用者CNPJ | CNPJ do Tomador | 自社のCNPJ。請求書が正しいブラジル法人宛に発行されたことを確認します。不一致があると、税務記録上の書類が無効になります。 |
| サービスコード(LC 116) | Código de Serviço (LC 116) | 連邦サービスリストに基づく、サービスの種類を分類する数字コード。各自治体の適用ISS税率を決定します。例:コード1.01は「システム分析・開発」、コード17.19は会計サービスです。 |
| ISS課税標準 | Base de Cálculo ISS | ISSの対象となるサービス価額。請求書総額と常に一致するとは限らず、法律で認められた控除額が適用される場合があります。 |
| ISS税率 | Alíquota ISS | 自治体ごとに適用される税率。都市やサービス種類により2%~5%。サンパウロ市は一般5%、建設業2%。これにより税額計算の正否が判断できます。 |
| ISS税額 | Valor ISS | 計算されたISS。ブラジルのサービス請求書では、ISSは最終価格に含まれる情報税であり、上乗せされません。請求書は総額のうちISS相当額を報告します。 |
| 源泉徴収ISS | ISS Retido na Fonte | サービス利用者(貴社)がISSを源泉徴収し、自治体に納付する責任があるかどうか。「Sim」の場合、単なるデータ入力ではなく、税務納付義務が発生します。 |
| RPS番号 | Número RPS | 仮領収書番号。自治体が請求書を検証し最終的なNFS-e番号を発行する前に付与される一時的な識別子。正式なNFS-e番号が未入手の場合の調整に有用です。 |
| NFS-e番号 | Número NFS-e | 自治体が検証後に発行する正式な請求書番号。保管・監査における主要な書類識別子です。 |
| CNAEコード | Código CNAE | 経済活動の全国分類。提供者の登録事業活動コード。LC 116サービスコードと照合し、提供者が許可された活動に対して請求書を発行しているか確認します。 |
| サービス内容 | Discriminação dos Serviços | 提供されたサービスの自由記述。明細、サービス期間、契約参照情報などを含む場合があり、非構造的ですが、コストセンター配分や承認ルーティングに不可欠です。 |
LC 116のサービスコード一覧には40の主要カテゴリがあり、各カテゴリにはITサービス(カテゴリ1)から法務サービス(項目17.14)、エンジニアリング(カテゴリ7)、ヘルスケア(カテゴリ4)までを網羅するサブ項目が含まれています。完全な一覧は連邦補完法第116号/2003年の付属書で公開されています。受け取るすべてのNFS-eにはこれらのコードのいずれかが記載されており、そのコードがサービス提供者が適用すべきISS(サービス税)税率を直接決定します。
これらのフィールドはどれも任意ではありません。NFS-eを検証する市庁舎は、ドキュメントを承認する前にすべてのフィールドをチェックします。つまり、正確なAP処理に必要なデータはすでに存在しているのです。請求書があなたの受信箱に届く前に、政府の税務当局によって検証済みだからです。問題は、そのデータをドキュメントから取り出して、再入力せずにスプレッドシートに移せるかどうかにあります。
手動でのNFS-e入力が財務チームにもたらすコスト
請求書データの手動入力が遅いというのは標準的な認識です。実際その通りで、平均的な単一ページのドキュメントをスプレッドシートに入力するのに約3分かかります。しかしNFS-eに関しては、遅さが最も高くつく問題ではありません。最も高くつく問題は税務記録へのエラーの伝播です。
CNPJ(法人納税者登録番号)の入力ミス——14桁の文字列の中の1桁の誤り——は、ベンダーマスターの照合を失敗させ、あなたの事業体が源泉徴収義務者である場合にはISS控除を請求できなくなります。間違ったISS税率をERPに入力した場合(2%を5%と入力)、報告期間全体の税引当金が狂い、市の監査で指摘される可能性があります。「ISS Retido na Fonte = Sim」フラグの見落としは、サービス提供者ではなくあなたが法的に支払う責任を負うISSを納付しないことを意味します。
これらは仮想的なリスクではありません。ブラジルの税務当局はNFS-eの発行者と受領者の間で電子的なクロスマッチングを実施しています。あなたのサービス提供者があなたのCNPJからR$50,000を受け取ったと報告し、あなたのSPED(デジタル税務簿記システム)記録が2件の請求書の入力ミスによりR$48,000を示している場合、その不一致は自動通知——そしてその後の正式な調査——を引き起こします。
これを控えめなボリュームでも掛け合わせてみてください。ブラジルのサービス提供者を10社抱える中規模企業——ITコンサルタント、マーケティング代理店、法律事務所、会計事務所、施設管理会社、そして数人のフリーランサー——は、月に30〜50件のNFS-eドキュメントを受け取る可能性があります。1ドキュメントあたり3分で、およそ2.5時間の手動入力になります。しかし本当のコストは2.5時間ではありません。修正サイクルこそが本当のコストです。バランスが取れない照合スプレッドシート、重複を求めるサービス提供者への電話、修正された税務申告、不一致を整理するための会計手数料。
ここで「ドキュメント抽出」という言葉が具体的になります。それはタイピング時間の節約の問題ではありません。市庁舎が検証したものとあなたのERPが受け取ったものとの間のギャップを排除することこそが問題なのです。
AI抽出が自治体ごとの差異をどう処理するか — 都市別テンプレート不要
NFS-e抽出における中核的な技術課題は、書類が読みにくいことではありません。ブラジルのどの都市のサービス請求書(NFS-e(Nota Fiscal de Serviços))も、明確に印刷された、ほぼ機械生成の書類です。課題は、同じ項目が、都市によって異なる位置に、異なるラベルで記載されていることです。
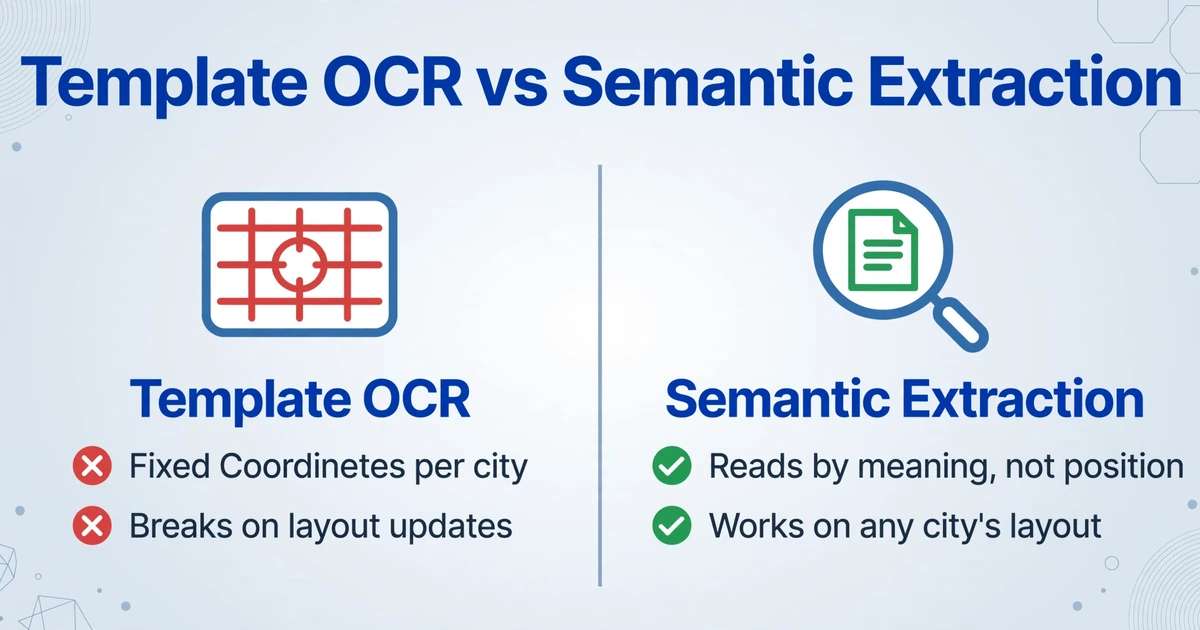
従来のテンプレートベースのOCRは、各項目に矩形領域を定義することで解決します。「CNPJ do Prestadorは座標(x=150, y=320, w=200, h=30)にある」という具合です。これは1つの自治体に対しては完璧に機能します。しかし次の自治体では破綻します。5,570都市分のテンプレートライブラリを維持することは現実的ではありません。たとえ取引先が所在する20都市分だけを維持するにしても、市庁舎がレイアウト更新をリリースすれば(サンパウロは2025年8月にNFS-eマニュアルのバージョン3.2で実際に更新しました)、その20のテンプレートはすべて壊れてしまいます。
その代替案が意味抽出です。位置で項目を探すのではなく、その意味で探すのです。抽出エンジンに「サービス提供者のCNPJが必要です」と指示すると、エンジンは書類を読み、「Prestador」の隣にある「CNPJ」とラベル付けされた14桁の数字が提供者の納税者番号であると理解します。それがページのどこにあっても関係ありません。
これはOCRとは根本的に異なります。OCRはピクセルを文字に変換します。意味抽出は、ビジョン言語モデルを搭載し、人間が書類を読むように読み取ります。ラベル、文脈、書類構造を理解するのです。サンパウロのレイアウトが「Prestador de Serviços」を左上に配置し、ポルトアレグレが中央のヘッダーに配置しても、意味エンジンは気にしません。位置を探しているのではなく、意味を探しているからです。
NFS-eにとってこれが重要な理由:自治体ごとの差異は位置の問題です。意味抽出は意味による解決策です。テンプレートベースのツールを非現実的にする5,570都市の断片化こそ、意味抽出が処理するために設計されたものです。なぜなら、レイアウトの一貫性にまったく依存しないからです。
この抽出アプローチはカスタム列抽出を使用します。出力に必要な項目名を入力するだけです。「提供者CNPJ」「サービスコード(LC 116)」「ISS額」「NFS-e番号」などと入力すると、AIはラベルの意味を理解して各値を書類上で特定します。位置ではありません。これらの列名は最終的なExcelスプレッドシートのヘッダーになるため、再フォーマットせずにそのままERPや会計システムへアップロードできます。
ステップバイステップ: NFS-eデータをExcelに抽出する
受領したNFS-e(Nota Fiscal de Serviços)ドキュメントから構造化されたスプレッドシートにデータを抽出するための実践的なワークフローをご紹介します。このプロセスは、PDF/DANFSE(サービスの印刷補助文書)または基になるXMLファイルのどちらをお持ちの場合でも機能します。
ファイルは安全に処理され、保存されることはありません。
ISS源泉徴収、複数サービスコード、バッチ処理シナリオへの対応
ほとんどのNFS-e抽出は単純です。単一の提供者、単一のサービス、標準的なフィールドです。しかし、実際の財務ワークフローでは、重要となるエッジケースに遭遇します。ここでは、手動プロセスでつまずく3つのケースを紹介します。
源泉徴収されたISS(ISS Retido na Fonte)
NFS-eに「ISS Retido na Fonte = Sim」と記載されている場合、ISSを市に納付する義務はサービス提供者からサービス利用者、つまりあなたに移ります。これはデータ入力上の注意事項ではありません。税務コンプライアンス上の対応事項です。あなたの経理チームは、(1) 抽出結果でこれらの請求書を特定し、(2) 納付すべきISS額(請求書に表示されている税率×課税標準)を計算し、(3) 期限内に正しい市の市庁舎に支払いを行う必要があります。
このステップを逃すと、ISSは誰にも支払われなかったことになります。提供者は(源泉徴収されたと申告したため)支払っておらず、あなたも(フラグを見逃したため)支払っていません。両者ともにリスクにさらされます。「ISS Retido」フィールドをはい/いいえの列として抽出し、これらの文書を自動的にフラグ付けする抽出ワークフローは、コンプライアンスリスクを並べ替え可能なスプレッドシートの列に変えます。
1枚の請求書に複数のサービスコード
1枚のNFS-eには複数の明細行を含めることができ、各行に独自のLC 116サービスコードと独自のISS税率があります。ITコンサルティング会社は「Análise e desenvolvimento de sistemas」(コード1.01、サンパウロではISS 5%)と「Suporte técnico」(コード1.07、異なる税率の可能性)を別々に請求することがあります。請求書レベルのISS合計のみを抽出すると、各行が正しく課税されたかを判断する行ごとの分類を失います。文書合計だけでなく、行項目レベルのサービスコードとISS額を抽出するように列を定義してください。
複数のサービス提供者にわたるバッチ処理
5つの異なる都市の5つの異なる提供者からNFS-e文書を受け取る場合、バッチ処理の利点はさらに大きくなります。各PDFを個別に開いてフィールドを別々のスプレッドシート行にコピーする代わりに、すべてをまとめてアップロードします。抽出エンジンはそれらを並列処理し(1ページあたり5〜10秒)、すべての提供者のデータを同じ列にまとめた1つの統合スプレッドシートを生成します。これは、自治体ごとの断片化問題への実用的な答えです。AIが文書ごとのレイアウトの違いを自動的に処理し、あなたのチームは1つの出力ファイルを扱うだけです。その断片化が存在する理由とそのコストの構造分析については、ブラジルのNFS-e処理がほとんどの財務チームが考えるよりもコストがかかる理由をご覧ください。
月50件、100件、またはそれ以上のNFS-e文書という大量のシナリオでは、Excelへのバッチ請求書抽出により、文書ごとの設定が不要になり、手動処理が文書数に比例して増える問題を解消します。
2026年税制改革:NFS-e抽出に何が変わるか
ブラジルは税制改革の最中にあり、最終的にISSとICMSを統一されたIBS(物品サービス税)に置き換え、PIS/COFINSをCBS(物品サービス税社会負担金)に置き換える予定です。移行は段階的で、2033年まで続きますが、NFS-eのレイアウトはすでに更新されています。サンパウロは2025年8月にNFS-eマニュアルのバージョン3.2を公開し、新しい税制構造のフィールドを導入しました。他の自治体も追随するでしょう。
データ抽出の観点からは、これは2つのことを意味します。第一に、現在抽出しているフィールド(ISS課税標準、ISS税率、ISS額)は、将来のNFS-e文書でIBS/CBSフィールドによって補完または置き換えられる可能性があります。第二に、移行期間中は、従来のISSフィールドと新しいIBSフィールドの両方を備えた請求書を受け取る可能性があり、照合のために両方を抽出する必要があります。
上記の抽出アプローチはこれを自然に処理します。固定フィールド位置やハードコードされたテンプレートに依存しないため、更新されたNFS-eレイアウトの新しいフィールドも既存のものと同じ方法で抽出されます。列名(例:「IBS額」)を追加すると、AIが文書上でそのフィールドを特定します。テンプレートの再設定は不要です。
ブラジルの商品請求書(ICMS、IPI、PIS、COFINSを含み、異なる規制枠組みの対象)から税データを抽出するための実践的なガイドについては、NF-e XML抽出ガイドをご覧ください。ブラジルの給与文書も処理する場合は、ホレリテ(給与明細)抽出ガイドでそのワークフローを説明しています。
FAQ:ブラジルNFS-eサービスインボイスデータ抽出
XMLがなくてもNFS-e PDFからデータを抽出できますか?
はい。PDF/DANFSEには、市区町村が検証に必要とするすべての必須税務項目が含まれています。NF-e DANFE(基礎となるXMLデータの約90%を省略)とは異なり、NFS-e印刷文書はより自己完結型です。これは、市区町村がXMLに含める内容と印刷された補助文書に表示される内容について単一の標準を共有していないためです。上記の構成表に記載されている全項目(CNPJ prestador/tomador、LC 116コード、ISS内訳、NFS-e番号、RPS番号)は通常PDFに含まれています。ただし、XMLにアクセスできる場合は、そちらを使用してください。100%の項目カバレッジが保証され、OCR関連の精度ばらつきが排除されます。
ブラジルのどの都市のNFS-e文書でも抽出は機能しますか?
セマンティック抽出は、特定の都市のレイアウトに一致させるのではなく、文書の内容を理解して項目を読み取ります。サンパウロ、リオデジャネイロ、ベロオリゾンテ、ポルトアレグレなど、どの市区町村のNFS-eでも、市区町村ごとのテンプレートを必要とせずに機能します。ただし、手書きのNFS-e文書(ほとんどが機械生成であるため稀)の抽出精度は、印刷文書やデジタル文書よりも低くなります。手書き文字認識は機能しますが、本質的に印刷テキストの読み取りよりも精度が低くなります。
源泉徴収されたISSはどうなりますか?税金納付義務はどのように処理すればよいですか?
「ISS Retido na Fonte」フィールドを専用の列として抽出します。このフィールドが「Sim」(または「Yes」)に等しいインボイスは、標準の買掛金エントリとして処理するのではなく、税務コンプライアンスワークフローにルーティングする必要があります。インボイスのISS税率とISS課税標準は納付額を示し、提供者の市区町村は納付先を示します。抽出ツールはデータを提供します。税金の納付自体は別のコンプライアンス手順であり、経理部門または税務部門が関連するプレフェイトゥーラの支払いシステムを通じて実行する必要があります。
NFS-e文書を通常の国際請求書と一緒に一括処理できますか?
はい。列定義が両方の文書タイプをカバーできるほど広い場合(例:「請求書番号」「仕入先名」「合計金額」)、ブラジルのNFS-e文書を国際請求書と同じバッチに含めることができます。抽出エンジンは各文書を個別に読み取り、見つかったフィールドを入力します。ただし、NFS-e固有のフィールド(LC 116サービスコードやISS額など)については、ブラジル以外の請求書ではそれらの列は空になりますが、これは想定どおりであり、エラーは発生しません。
2026年の税制改革はNFS-eフィールド抽出にどのように影響しますか?
改革は抽出の仕組みを変えるのではなく、将来のNFS-e文書に表示されるフィールドを変えるものです。自治体がレイアウトを更新してISSに加えて(または代わりに)IBS(物品サービス税)およびCBS(物品サービス税社会負担金)フィールドを含めるようになると、新しいフィールド名を含めるように列定義を更新する必要があります。抽出アプローチは変わりません。新しい列名を追加すれば、AIが対応する値を見つけます。2033年までの段階的な移行により、移行期間中は新旧両方の税フィールドを持つ文書を処理することになるでしょう。
この抽出アプローチを使用するにはブラジルの税務ID(CNPJ)が必要ですか?
いいえ。受領したNFS-eからのデータ抽出は文書処理タスクであり、税務申告行為ではありません。NFS-eのPDFまたはXMLからスプレッドシートにデータを抽出するためにCNPJは必要ありません。文書上のCNPJフィールドはサービス提供者とサービス利用者を識別するものであり、抽出ツールはそれらをデータポイントとして読み取り、出力列に配置します。市の税務システムとは一切連携しません。
文書ごとの手入力からバッチごとの処理へ
NFS-eは政府にとって税収を効率的にするために設計されました——そして実際にそうなっています。ブラジルで発行されるすべてのサービス請求書は、あなたに届く前に市の税務当局によって検証されるため、そのデータはすでに整合性がチェックされています。非効率なのは完全に受領側にあります。機械がすでに検証したフィールドを、都市ごとに異なる文書から、税務照合のために正確である必要があるスプレッドシートにAP担当者が再入力しているのです。
セマンティック抽出は、その方程式の受領側を変えます。フィールドはすでに存在し、すでに検証され、すでに機械可読(またはそれに近い)状態です。それらを一度のバッチでスプレッドシートに取り込むことは、ワークフローの決定であり、技術的な飛躍ではありません。次のNFS-e文書のバッチでテストしてみてください——文書あたりの時間が、手動の基準である3分から、列を一度定義して抽出を実行するだけの数秒に短縮されるかどうかを確認してください。
最初の50ページはサインアップ不要です。