80 000 lignes par an, une seule feuille de calcul
Comment traiter par lots les fichiers de mise en page SPED pour une analyse transannuelle
Une entreprise brésilienne de taille moyenne dépose environ 80 000 à 150 000 lignes de données de comptabilité numérique (Escrituração Contábil Digital, ou ECD) par an. Sur une fenêtre de comparaison de trois ans, cela représente un quart de million de lignes de codes Registro délimités par des barres verticales réparties dans trois fichiers texte distincts — chacun structuré pour la validation automatique par la Receita Federal, et non pour l'analyse humaine. Chaque ligne est un enregistrement dont vous pourriez avoir besoin : une écriture de balance de vérification, une ligne de journal ou un ajustement fiscal e-Lalur. Mais extraire les comptes spécifiques dont vous avez besoin sur plusieurs années signifie ouvrir chaque fichier, filtrer par code Registro, aligner les colonnes manuellement et assembler les résultats dans une nouvelle feuille de calcul. Ce travail se répète à chaque fois que quelqu'un pose une question transannuelle.
Cet article porte sur l'alternative : traiter plusieurs années de fichiers SPED comme un seul lot, définir vos colonnes de sortie une seule fois, et extraire uniquement les données dont vous avez besoin dans un tableau prêt pour l'analyse — que les données sources couvrent deux fichiers ECD, un fichier ECF, ou trois exercices fiscaux avec différentes versions de Leiaute. Cette approche ne nécessite pas d'analyseur pour chaque type de Registro. Elle fonctionne sur plusieurs années, sur plusieurs versions de mise en page, et au-delà de la frontière ECD↔ECF.
Pourquoi « Ouvrir un fichier à la fois » ne fonctionne pas pour l'analyse pluriannuelle
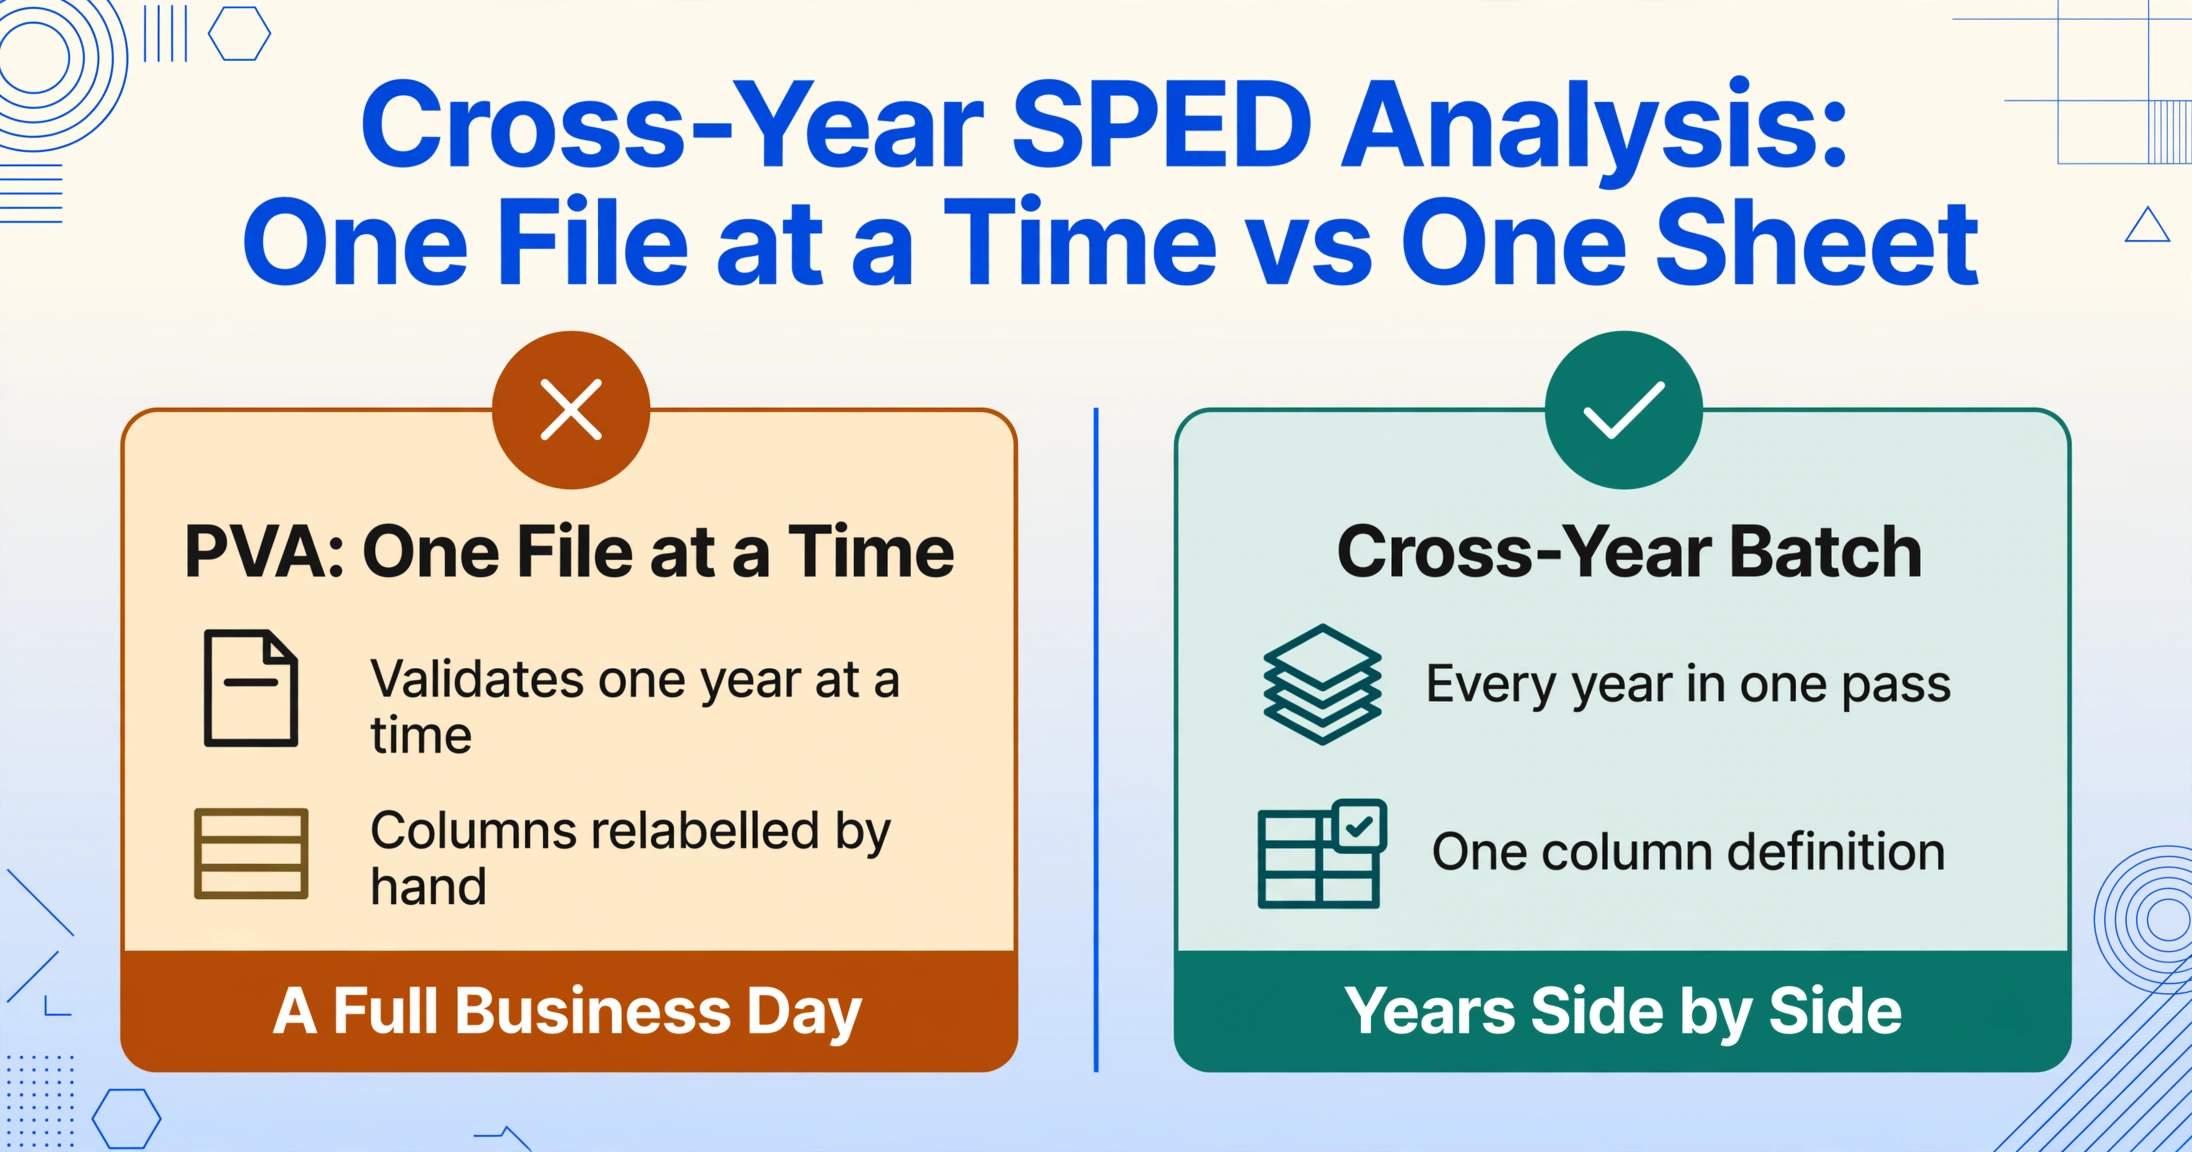
Le Système public d'écriture numérique (Sistema Público de Escrituração Digital, ou SPED) a été conçu pour donner à la Receita Federal un pipeline unique et standardisé pour recevoir les écritures comptables. Il a réussi cet objectif. Ce qu'il ne fournit pas, c'est un mécanisme intégré pour comparer les données d'une année à celles d'une autre. Chaque exercice fiscal produit son propre fichier ECD et son propre fichier d'écriture comptable fiscale numérique (Escrituração Contábil Fiscal, ou ECF). Les Programas Validadores e Assinadores (PVA) valident et transmettent des fichiers individuels. Ils n'ouvrent pas deux fichiers côte à côte.
Cela signifie que chaque analyse pluriannuelle suit la même séquence manuelle : exporter l'ECD de l'année 1 depuis le PVA, exporter l'ECD de l'année 2, ouvrir chacun dans Excel avec l'assistant d'importation de texte (délimiteur pipe), filtrer les codes Registro pertinents, renommer les colonnes (qui changent de position selon le Registro filtré), construire un tableau comparatif à partir de zéro, et répéter l'opération pour les données d'ajustement fiscal de l'ECF. Le travail n'est pas techniquement difficile — il est mécaniquement répétitif, sujet aux erreurs, et prend des heures à chaque fois.
Une équipe de contabilidade traitant trois années de données ECD sur deux régimes fiscaux (Lucro Real une année, une fusion la deuxième) pourrait facilement passer une journée complète de travail à simplement préparer les données d'entrée pour une seule question analytique.
Ce qu’une analyse SPED pluriannuelle exige réellement
Lorsqu’un contrôleur financier ou un responsable fiscal demande une comparaison pluriannuelle, il souhaite généralement l’une des vues suivantes :
« Montrez-moi le solde d’ouverture, le solde de clôture et le mouvement net de chaque compte pour les trois dernières années — côte à côte. »
Cela nécessite d’extraire le Registro C155 (balance de vérification) de chaque ECD annuel, d’aligner les codes de compte du plan comptable C050 et de construire un tableau de comparaison horizontal où chaque ligne correspond à un code de compte référentiel et où les soldes de chaque année apparaissent dans des colonnes adjacentes.
« Quelles différences permanentes dans l’e-Lalur ont considérablement évolué d’une année à l’autre ? »
Cela implique d’extraire le Registro M300 (ajustements de la partie A de l’e-Lalur) de chaque ECF annuel, de filtrer par type d’ajustement (ajouts, exclusions, compensations) et de comparer les valeurs annuelles côte à côte. Une variation de 30 % sur un type d’ajustement spécifique signale soit un changement d’activité, soit une erreur de classification méritant une enquête.
« Comment notre taux d’imposition effectif a-t-il évolué sur trois ans, et quels ajustements ont entraîné cette évolution ? »
Cela nécessite de combiner les données ECD (base du bénéfice comptable du Bloco E dans l’ECF) avec les données ECF (ajustements e-Lalur du Bloco M) sur plusieurs années — deux types de fichiers différents, deux structures de Registro différentes, une seule question analytique.
Le point commun : chaque question couvre plusieurs fichiers, plusieurs types de Registro et plusieurs années. Le goulot d’étranglement ne réside pas dans l’existence des données — elles existent, avec un niveau de détail exhaustif. Le goulot d’étranglement consiste à les restructurer, d’une organisation orientée fichiers propre à l’écosystème SPED, vers une organisation orientée questions.
Stratégie de traitement par lots : pensez en colonnes de sortie, pas en formats de fichiers
Le point clé pour traiter par lots les fichiers SPED est que la structure du Registro — bien qu'obscure — est intrinsèquement cohérente. La même disposition du Registro C155 qui contenait le bilan de l'année dernière contient celui de cette année. Les mêmes champs M300 qui décrivaient les différences permanentes de l'année dernière décrivent celles de cette année. Les changements de disposition sont rares et au niveau des champs (la transition de Leiaute 8 à 9 pour l'ECD, ou de 11 à 12 pour l'ECF), et ils ne modifient pas la relation fondamentale entre les types de Registro et les concepts comptables qu'ils représentent.
Cette cohérence signifie que vous pouvez définir votre structure de sortie une seule fois et l'appliquer sur plusieurs années. Au lieu de penser « je dois ouvrir l'ECD 2024, filtrer pour C155, mapper les champs, puis répéter pour 2025 », vous pensez « j'ai besoin des soldes de comptes pour 2024 et 2025 côte à côte » — et laissez la couche d'extraction gérer la restructuration par fichier.
Extraction de colonnes personnalisées est conçue exactement pour ce scénario. Vous nommez les colonnes souhaitées — « Code de compte », « Nom du compte », « Solde d'ouverture », « Solde de clôture » — et l'IA lit le fichier SPED pour localiser et extraire ces valeurs des enregistrements Registro pertinents, quel que soit le fichier de l'année que vous lui indiquez. La même définition de colonnes qui a produit un bilan propre à partir de l'ECD 2023 produit une structure identique à partir des fichiers ECD 2024 et 2025, car la relation sémantique entre le Registro C155 et le concept de « bilan » n'a pas changé entre les années.
L'effet pratique : traiter trois années de données ECD nécessite de définir vos colonnes une seule fois, pas trois fois. Le travail passe de « filtrer et aligner 150 000 lignes trois fois » à « pointer vers trois fichiers avec une seule définition de colonnes ».
Étape par étape : traitement par lots de plusieurs années de données ECD en un bilan pluriannuel
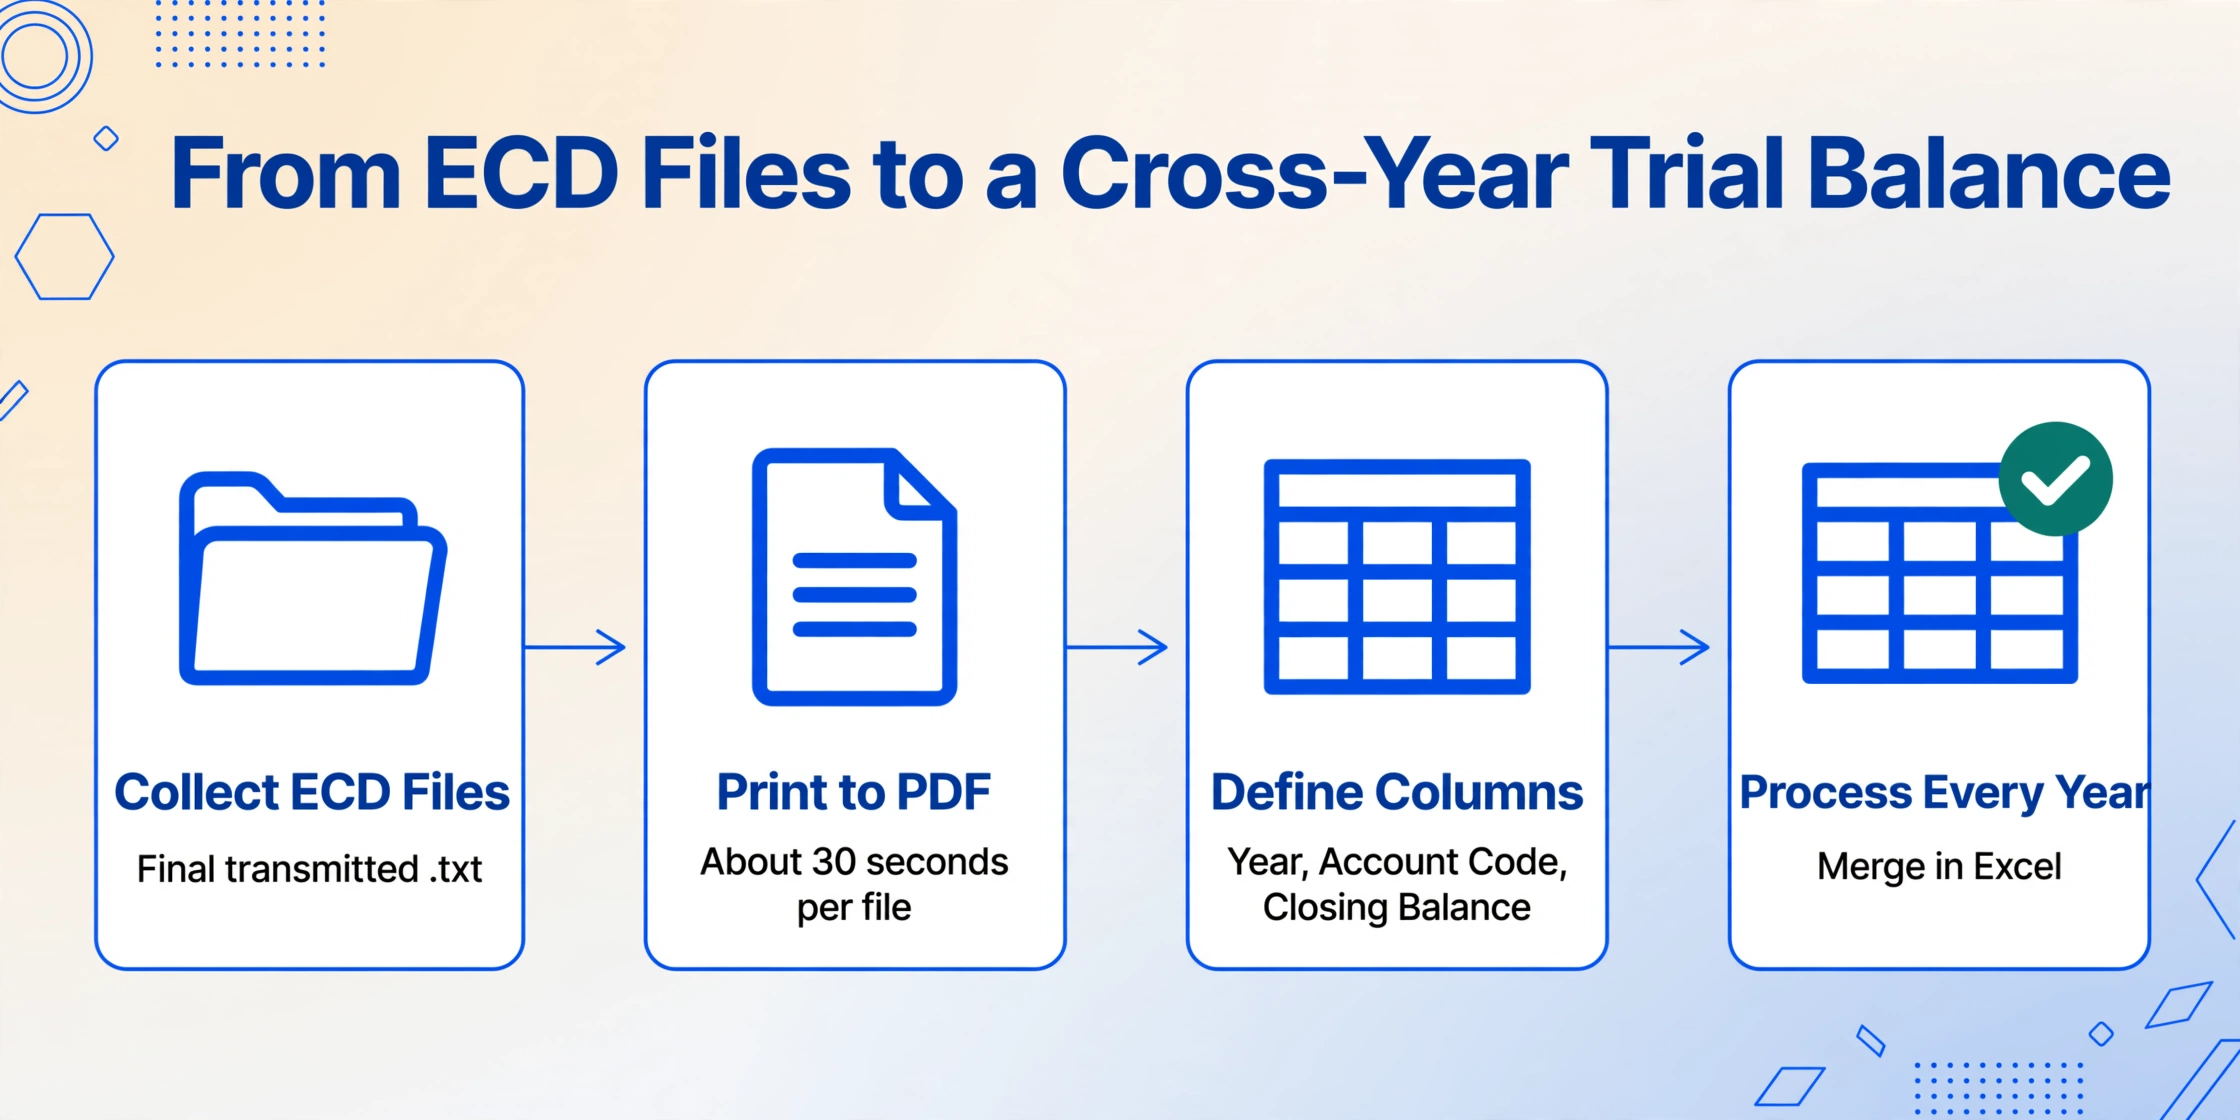
Voici le flux de travail pour transformer deux ou trois années de fichiers ECD en un tableau comparatif des comptes d'une année à l'autre. La même logique s'applique aux données ECF ou aux analyses mixtes ECD+ECF.
Exportez les fichiers .txt validés depuis votre ERP (Omie, Conta Azul, Senior, Domínio, SAP TDF, ou tout autre système que vous utilisez pour la génération SPED) ou depuis les archives PVA. Vous avez besoin de la version finale transmise — pas d'un brouillon — car le fichier transmis est celui qui correspond à ce que la Receita Federal a reçu. Stockez toutes les années dans un seul dossier.
ImageToTable.ai accepte les entrées PDF, JPG, PNG et WebP. Pour les fichiers .txt, ouvrez chaque ECD dans un visualiseur de texte ou dans le visualiseur de fichiers du PVA et imprimez en PDF. La disposition à largeur fixe du format SPED (délimiteurs pipe, colonnes alignées) est visuellement cohérente, donc un PDF préserve la structure que l'IA lit. Cette étape prend environ 30 secondes par fichier.
Configurez une définition de colonnes qui capture le bilan de vérification de n'importe quelle année de l'ECD. Vos colonnes : Année, Code de compte, Nom du compte, Solde d'ouverture, Mouvement débit, Mouvement crédit, Solde de clôture. L'ajout d'une colonne « Année » vous permet de compiler les résultats de plusieurs années dans un seul tableau. Le code de compte doit correspondre au Plan comptable de référence (Plano de Contas Referencial) du C050 pour une standardisation inter-années.
Téléchargez le PDF de l'année 1 et lancez l'extraction avec votre définition de colonnes. Répétez pour l'année 2 et l'année 3. Comme la définition de colonnes est sémantique — elle demande à l'IA de trouver « Code de compte », « Solde de clôture », etc. par le sens, et non par décalage d'octets — elle fonctionne de manière identique sur tous les fichiers, même si le PVA a exporté la disposition avec des différences de formatage mineures entre les années. Chaque exécution produit un tableau propre avec vos en-têtes.
Exportez les résultats de chaque année en .xlsx et empilez-les dans un seul fichier en utilisant la colonne « Année » pour identifier la période source de chaque ligne. Construisez votre tableau de comparaison : filtrez par code de compte et placez les soldes d'ouverture et de clôture de chaque année dans des colonnes adjacentes. Ajoutez des colonnes calculées pour la variance d'une année sur l'autre (absolue et en pourcentage) et un formatage conditionnel pour signaler les comptes dont le mouvement a dépassé un seuil, comme 20 % ou 100 000 R$.
Le cycle complet — des fichiers .txt à un tableau inter-années structuré — prend environ 30 minutes pour trois années de données, une fois la définition de colonnes enregistrée. Pour le même travail effectué entièrement dans Excel avec l'assistant d'importation de texte et l'alignement manuel, l'estimation est de trois à quatre heures avec un taux d'erreur plus élevé dû au filtrage manuel et au mappage des champs.
Si vous répétez cette analyse chaque année (en comparant chaque nouvelle année à l'année précédente dans le cadre du cycle de préparation de l'ECF), vous enregistrez la définition de colonnes comme modèle. L'année suivante, vous exécutez l'étape 4 sur le nouveau fichier uniquement et ajoutez les résultats à votre feuille de calcul pluriannuelle existante.
Extension du lot : ajout des données d'ajustement fiscal ECF
La même logique de lot s'applique aux fichiers ECF. Le Bloco M de l'ECF contient les ajustements e-Lalur qui déterminent votre obligation IRPJ et CSLL — et comparer ces ajustements d'une année sur l'autre révèle comment la planification fiscale et les différences permanentes évoluent.
Pour ajouter les données ECF à votre analyse pluriannuelle, créez une deuxième définition de colonnes ciblant les Registros M300 (e-Lalur Partie A) et M350 (e-Lacs Partie A) de l'ECF :
Année, Registro, Code de compte, Type d'ajustement (Addition/Exclusion/Compensation), Montant de l'ajustement, Numéro de processus de référence
Traitez le PDF ECF de chaque année à l'aide de cette définition, exportez et fusionnez dans votre feuille de calcul consolidée aux côtés des données de balance d'essai ECD. Vous disposez désormais d'un fichier unique dans lequel vous pouvez répondre à des questions qui franchissent la frontière ECD↔ECF — comme « la différence permanente pour l'amortissement du goodwill a-t-elle changé entre 2024 et 2025, et la provision comptable correspondante a-t-elle été correctement enregistrée dans l'ECD de chaque année ? »
Point clé : Le Bloco E de l'ECF (E010, E015) contient les comptes mappés qui relient les soldes comptables ECD aux ajustements fiscaux ECF. Les inclure dans votre lot vous donne la table de correspondance nécessaire pour retracer tout ajustement ECF jusqu'à son compte ECD d'origine — une vérification que le PVA n'effectue pas pour vous.
Que se passe-t-il lorsque la structure change
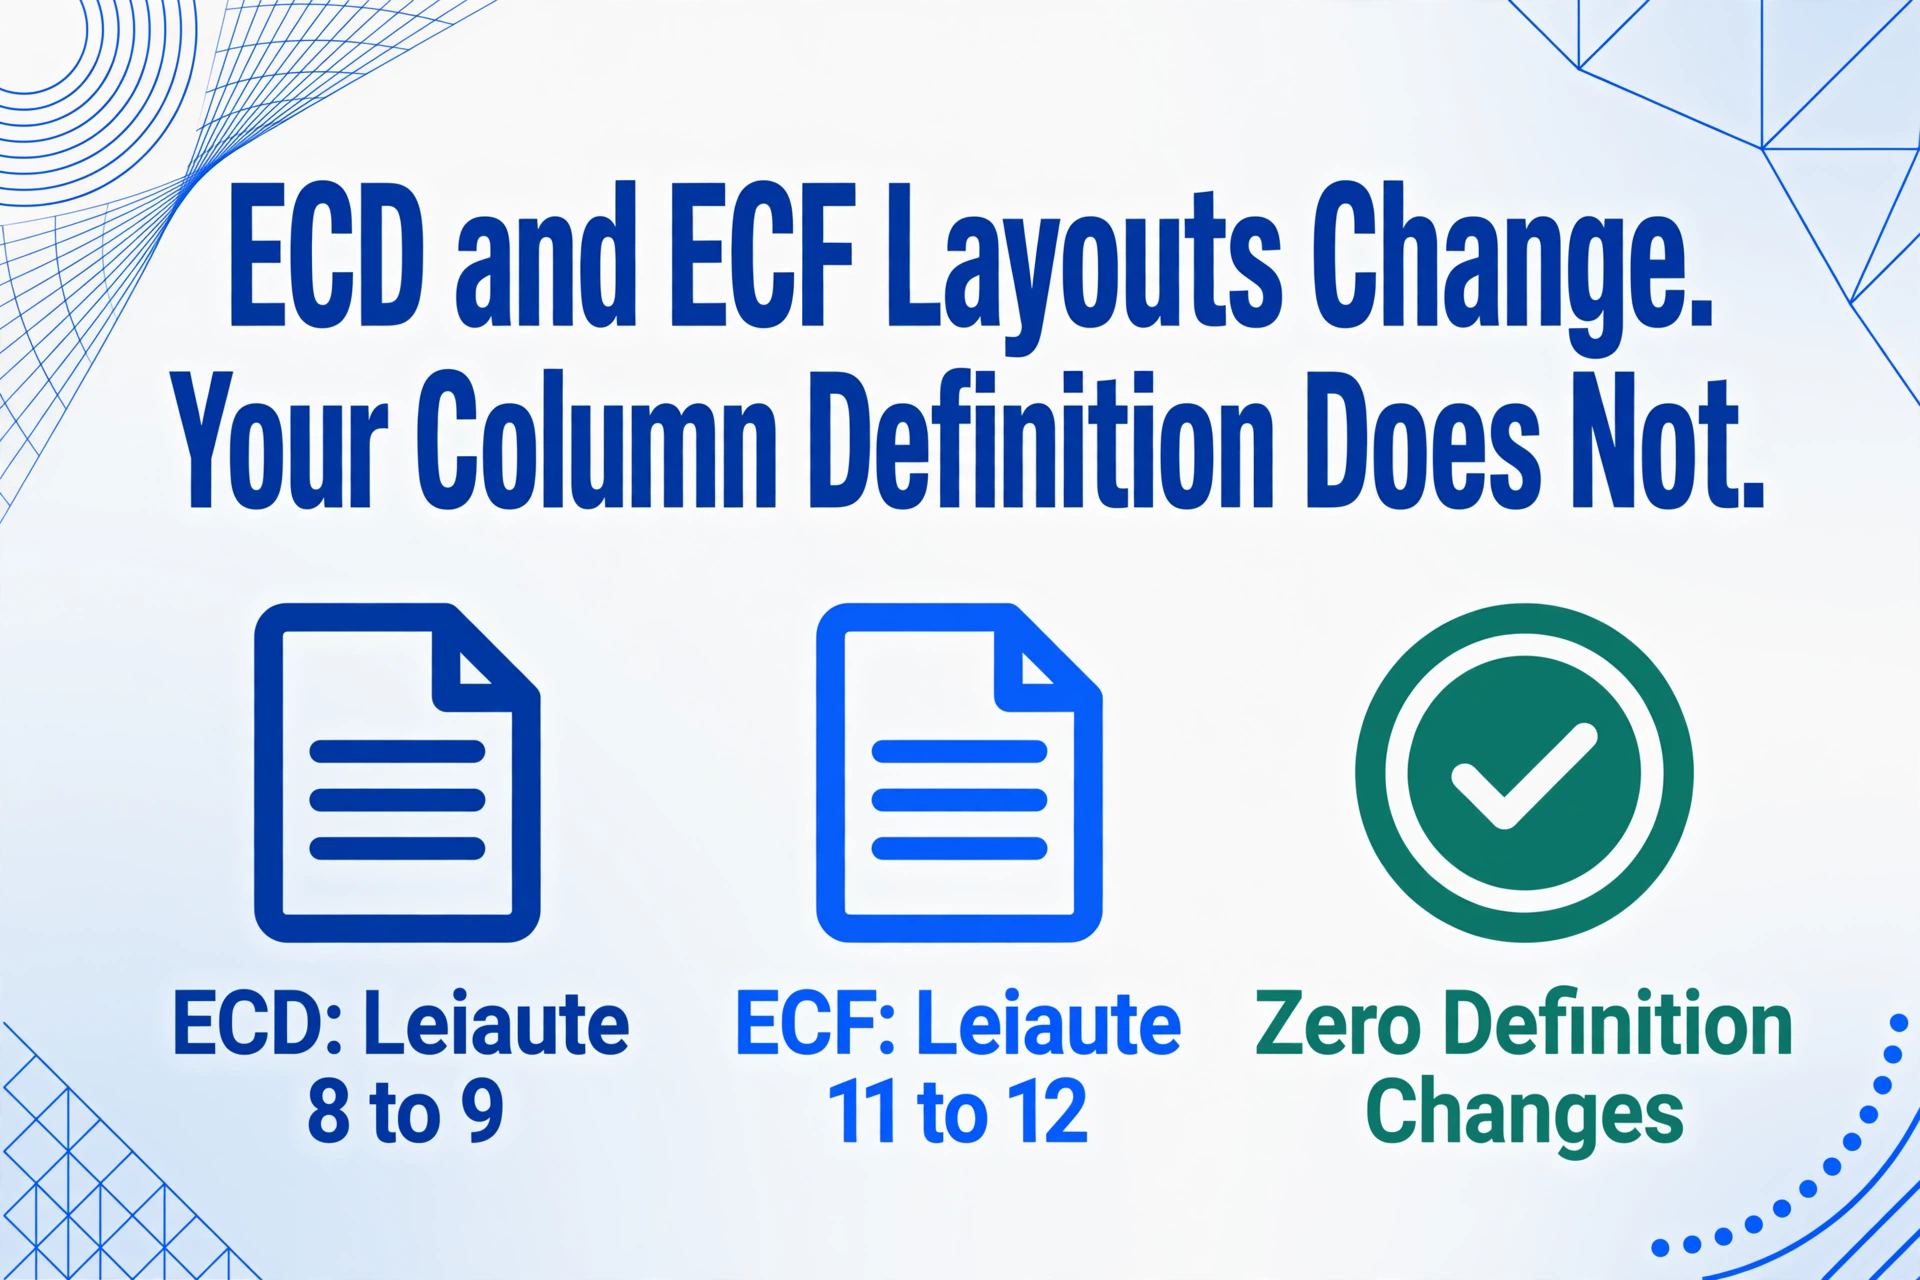
Les structures SPED brésiliennes évoluent. L'ECD est passé à Leiaute 9 en 2020 (stable depuis, avec des mises à jour au niveau des champs via les rulings ADE Cofis). L'ECF a adopté Leiaute 12 pour les déclarations de l'année civile 2025 en 2026. Lorsqu'une structure change, les analyseurs basés sur des scripts nécessitent des mises à jour de code. Une approche d'extraction sémantique gère la transition différemment : parce que l'IA lit par le sens — « ce bloc à largeur fixe décrit une entrée de balance d'essai » — plutôt que par position absolue d'octet, la même définition de colonnes fonctionne fréquemment à travers les versions de structure, tant que le code Registro et la structure conceptuelle de l'enregistrement sont préservés. En pratique, la transition de Leiaute 8 à 9 pour l'ECD et de 11 à 12 pour l'ECF n'a pas nécessité de changements de définition de colonnes pour l'extraction de la balance d'essai ou de l'e-Lalur, car les structures Registro de base (C155, M300) sont restées stables.
Questions fréquentes
Q : Puis-je traiter l'ECD et l'ECF en un seul lot ?
Chaque fichier nécessite sa propre passe d'extraction car les structures de Registro sont différentes. Cependant, les définitions de colonnes, une fois créées, peuvent être sauvegardées comme modèles et réutilisées chaque année. Le traitement de l'ECD prend une passe, l'ECF une seconde, et la consolidation se fait dans Excel après l'exportation des deux.
Q : Comment cela fonctionne-t-il pour les entreprises avec des livres départementaux (Bloco K) dans l'ECD ?
Si votre ECD inclut des enregistrements Bloco K, vous pouvez ajouter une colonne « Centre de coût » ou « Département » à votre définition. L'IA lit les balises de centre de coût de niveau K à partir du C100 de l'ECD et des Registros spécifiques au K, et les inclut dans le tableau de sortie. Cela est particulièrement utile pour l'analyse de rentabilité pluriannuelle par unité commerciale.
Q : Que faire si les codes de compte ont changé entre les années en raison d'une fusion ou d'une restructuration ?
C'est un problème de rapprochement de données, pas d'extraction. Extrayez le plan comptable C050 de l'ECD de chaque année en même temps que les données de balance de vérification. Utilisez les codes de compte de référence (du Plan comptable de référence (Plano de Contas Referencial), standardisé par la Receita Federal) comme clé de correspondance pluriannuelle, au lieu des numéros de compte internes de l'entreprise qui peuvent avoir changé.
Q : Y a-t-il une limite de taille de fichier pour le traitement par lots ?
ImageToTable.ai traite le fichier ECD sous forme de PDF ou d'un ensemble d'images de pages. Pour un fichier ECD typique (80 000 à 150 000 lignes), la version PDF fait environ 200 à 400 pages. L'outil traite page par page. Pour les très gros fichiers, vous pouvez diviser en sections par Bloco (par exemple, traiter le Bloco C en une passe, le Bloco I dans une autre) en utilisant le fractionnement PDF par plage de pages.
Q : Cette approche fonctionne-t-elle pour les entreprises en Lucro Presumido ?
Oui. Les entreprises en Lucro Presumido déposent l'ECD avec la même structure de Registro et ont le même besoin de comparaisons de comptes pluriannuelles. Le périmètre de l'ECF est plus restreint (pas d'e-Lalur avec des différences permanentes), mais l'extraction de l'ECD et l'analyse pluriannuelle de la balance de vérification fonctionnent à l'identique.
De l'obligation déclarative à l'actif analytique
Chaque soumission SPED est, d'une certaine manière, un gaspillage de potentiel analytique. Les données que votre système comptable a produites toute l'année — chaque écriture de journal, chaque solde de compte, chaque ajustement fiscal — sont restructurées dans un format optimisé pour un seul lecteur (le système de validation de la Receita Federal) et effectivement inutilisables à toute autre fin sans un travail manuel important. L'ironie, c'est qu'il s'agit du relevé financier le plus complet de l'exercice fiscal de votre entreprise, plus détaillé que n'importe quel rapport de gestion exporté par votre ERP.
Le traitement par lots change la donne. Lorsque vous pouvez extraire les balances de vérification, les ajustements fiscaux et les données de centre de coûts de plusieurs années en un seul après-midi, le fichier SPED passe d'un livrable de conformité que vous soumettez et oubliez à un ensemble de données analytiques que vous utilisez activement. Analyse des écarts d'une année sur l'autre. Suivi des tendances du taux d'imposition effectif. Courbes de tendance de rentabilité par service. Tout cela devient le résultat du même flux de travail d'extraction — et non des projets distincts nécessitant des cycles de préparation de données séparés.
La définition de colonne que vous écrivez cette année est un actif réutilisable. L'année prochaine, lorsque le nouveau fichier ECD arrivera sur votre bureau, vous l'exécuterez avec la même définition. La comparaison est prête en quelques minutes, pas en quelques heures.