発注書データ入力を自動化
テンプレート不要で、あらゆるPDFから
「発注書の自動化」を検索すると、解決済みの問題のように見える結果が並びます。承認ルーティング、予算管理、3ウェイマッチング、ERP連携を備えた調達スイート。しかし、毎朝サプライヤーのPO PDFを開き、十数件の明細行を手作業でスプレッドシートに入力している人にとって、その説明は別の建物の話です。PO自動化ベンダーの多くがカバーする工程——データがシステムに入った後に起こること——はボトルネックではありません。ボトルネックは、そもそもデータをシステムに入れるところにあります。
このページでは、PO自動化の経済性とセマンティックAI抽出アプローチについて解説します。50件のサプライヤーPDFを1つのExcelシートに変換するステップバイステップのバッチワークフローについては、POバッチ抽出からExcelへのガイドをご覧ください。フィールドごとの完全なリファレンスについては、発注書データ抽出の完全ガイドをご覧ください。
Redditのr/smallbusinessで、あるユーザーがこの問題を的確に表現していました。「注文書/PO PDFからのデータ抽出を自動化したい——ツールや方法はありますか?」ERPの話は一切なし。承認ワークフローの話もなし。あるのはPDFと、そこから何か使えるものへデータを移す必要性だけです。r/automationでも、別のユーザーが「テンプレートに頼らずに請求書や発注書のデータ抽出を自動化できた人はいますか」と質問していました——テンプレートの話題が出るのは、サプライヤーごとのフォーマットの違いこそが本当の障害であり、タイピングそのものではないからです。
重要なポイント
- CoupaやSAP AribaなどのPO自動化ツールは、データがシステムに入った後のすべてを自動化します——サプライヤーのPDFが受信トレイに届いた瞬間、あなたは自力で対応するしかありません。
- テンプレート抽出——複数サプライヤーのPOへの対策として謳われていますが——手作業を減らすのではなく、ラベルを貼り替えているだけです。30個のテンプレートの設定に5〜7.5時間かかり、サプライヤーがフォーマットを変更した瞬間に静かに壊れます。
- セマンティックAIは、「数量」が何であるかを理解することで「数量」を見つけます。サプライヤー#17がページのどこに配置するかを記憶するのではありません——列を一度定義すれば、あらゆるレイアウトの全サプライヤーのPOが、同じスプレッドシートに収まります。
PO自動化が実際に解決すること — そして解決しないこと
手動データ入力がなぜ残り続けるのかを理解するには、標準的なPO自動化の枠組みが何をカバーしているのかを見ると役立ちます。Coupa、SAP Ariba、Precoroなどのツールが自動化する典型的な購買から支払いまで(P2P)のフローは、次のようになります。
これらの各ステップはすべて、発注書データがすでにシステムに入った後に発生します。サプライヤーに発注書を発行する企業にとっては、これが正しい順序です — 発注書は社内で発生するため、システムへのデータ入力は出発点であり、解決すべき問題ではありません。
しかし、この説明では、購買ワークフローのまったく別のカテゴリが見落とされています。それは、顧客からPDF、メール、またはスキャンされた添付ファイルとして発注書を受け取る企業です。30社の異なるバイヤーから、それぞれ独自の形式で発注書を受け取るメーカー、ディストリビューター、またはサービスプロバイダーは、上流のP2P自動化では対応できないデータ入力の問題に直面します。彼らの発注書データは自社のシステムで発生するものではありません。外部から、他社の形式で届き、誰かがそれを入力しなければならないのです。
重要なポイント: PO自動化ツールはデータを取り巻くワークフローを自動化します。組織の外部から非構造化PDF形式で届くデータの入力を自動化するわけではありません。そのギャップ — サプライヤーの発注書から明細行データをスプレッドシートや注文管理システムに移す作業 — こそが、手作業の時間の大半を占めているのです。
手動発注書データ入力の実際のコストを徹底解説
調達は最もベンチマークが活用される業務機能のひとつであり、その数値は発注書の入力を経験したことがある人なら誰もが知っている事実を裏付けています。手動入力は高コストで、遅く、エラーが発生しやすいのです。APQCオープンスタンダードベンチマークデータ — 調達パフォーマンス測定で最も広く引用される独立系ソース — によると、組織は発注書1件の処理に14ドルから54ドルを費やしており、中央値は42ドルです。75パーセンタイルでは、25パーセンタイルの上位企業と比較して約4倍のコストになります。
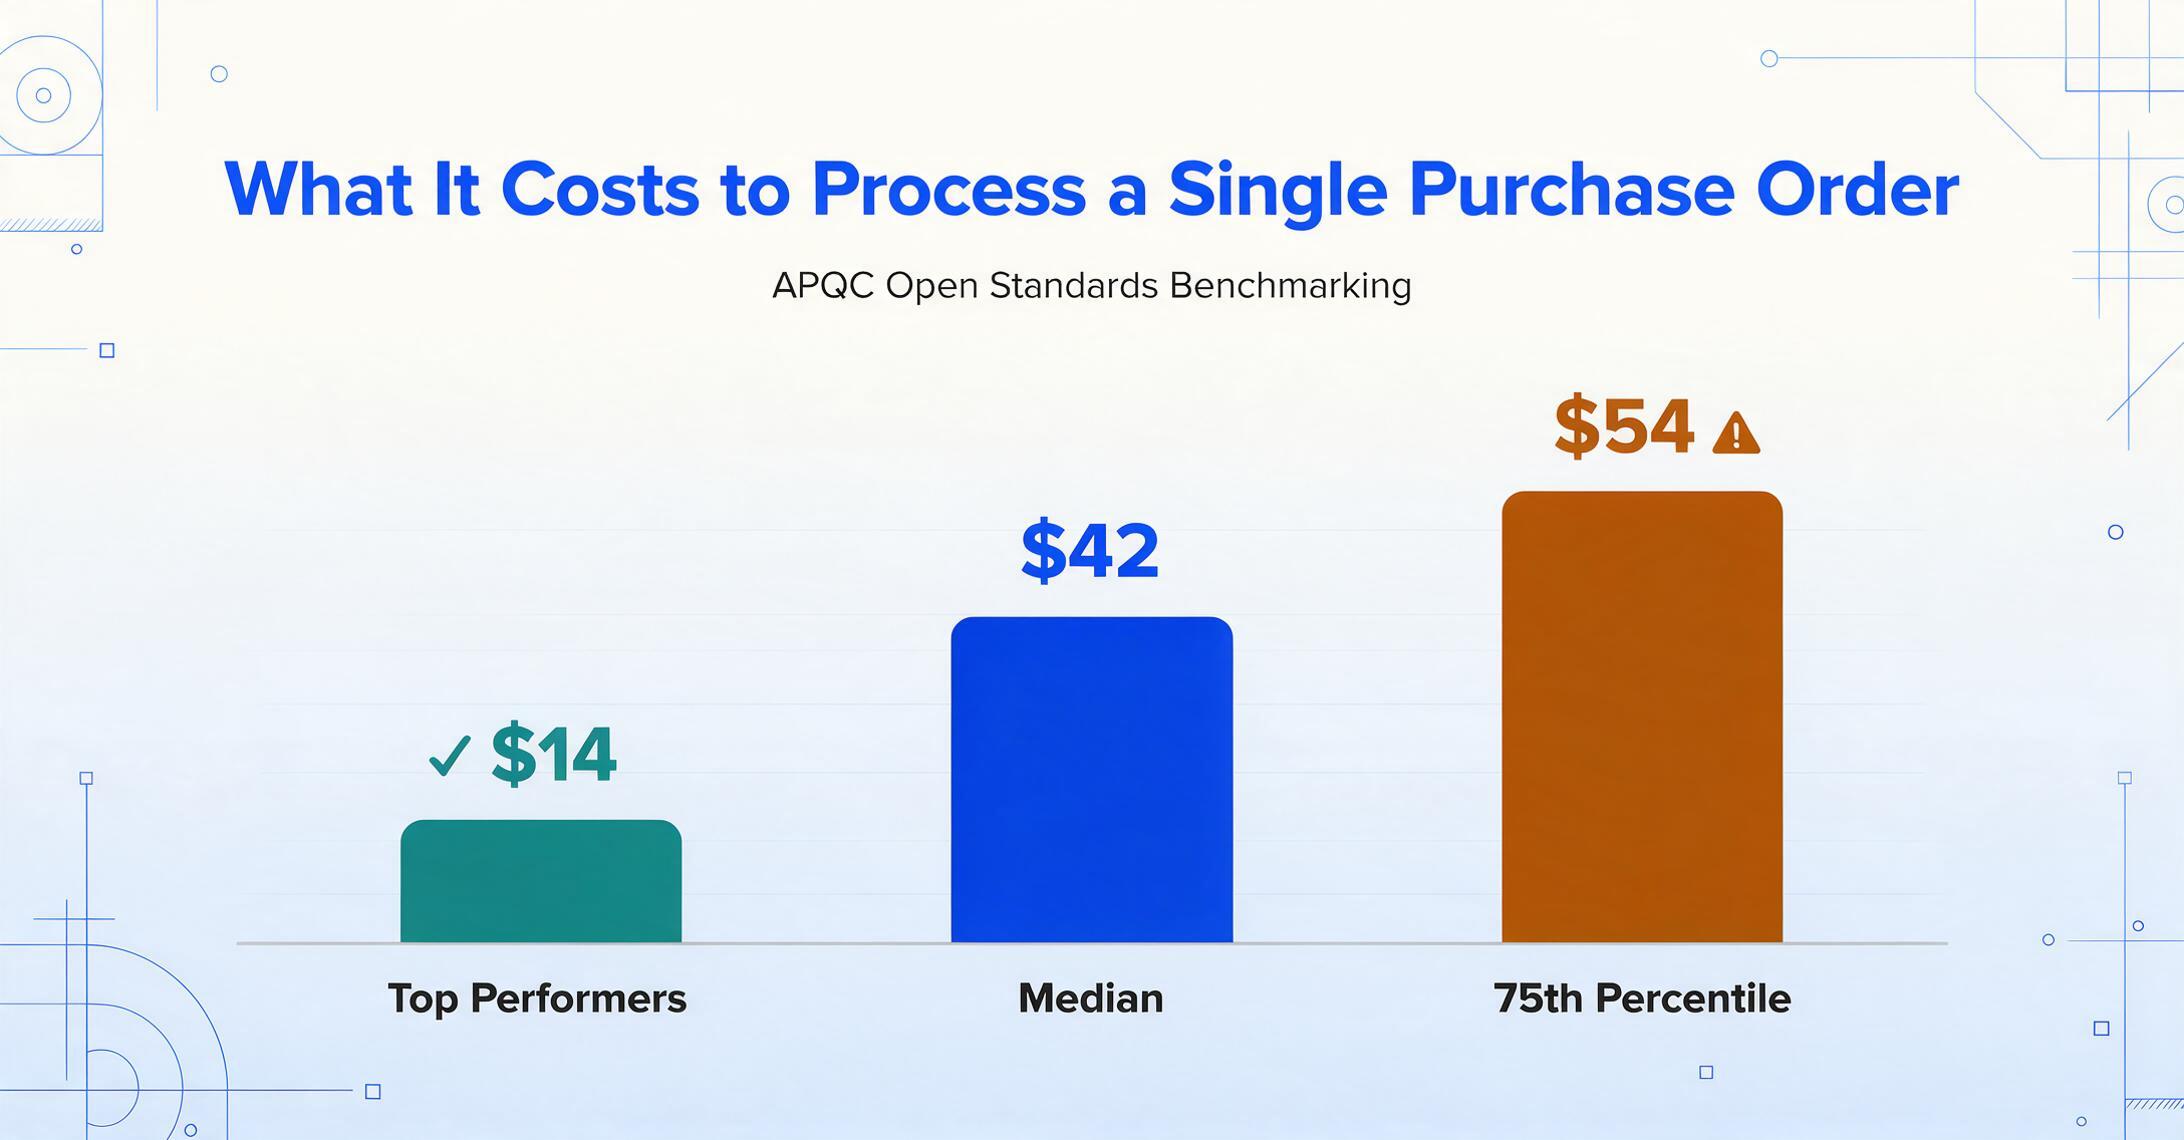
毎月1,000件の発注書を処理する企業にとって、14ドルと54ドルの差は単なる効率性の違いではありません。同じ取引に対して月額40,000ドルの運用コスト差を意味します。1年では、下位四分位と上位四分位を分けるのは約50万ドルにもなります。
APQCはまた、上位の調達組織は発注書を約1日で発行する一方、下位の組織は2倍以上の時間を要することも明らかにしています。調達プロセスを自動化している組織は、発注書のサイクルタイムを24時間で完了しますが、手動システムやスプレッドシートに依存している組織では35時間かかります。
コストの要因は時間であり、時間の要因はデータ入力です。手動の発注書処理では、担当者が各フィールド(発注書番号、ベンダー名、品目コード、数量、単価、納期)を読み取り、システムに入力します。10〜20明細行の標準的な発注書は、請求書処理のベンチマークによると8〜12分の手作業時間がかかります。その時間の大半は、戦略的な意思決定ではなく、明細行のデータ入力と検証に費やされます。
| 指標 | 手動発注書処理 | AI支援による抽出 |
|---|---|---|
| 発注書1件あたりのコスト | 14〜54ドル(APQC中央値:42ドル) | 文書1件あたり約0.07〜0.29ドル |
| 発注書1件あたりの時間 | 8〜12分(標準的な明細行の発注書) | 1ページあたり約10秒 |
| エラー率 | 入力フィールドごとに1〜3% | 全体で約1%、安定して |
| サイクルタイム(依頼→発注書発行) | 35時間以上(手動) | 24時間未満(データは即時利用可能) |
| 拡張性 | 線形:発注書が増える=スタッフの時間も増える | 発注書が増えても限界費用はほぼゼロ |
エラー率は時間コストを増幅させます。人間のデータ入力担当者が1,000件の文書に対して97%の精度で作業した場合、月に約30件のミスが発生します。それぞれに個別の調査と修正サイクルが必要です。調達業務では、1つの誤った数量や単価が過剰発注、納期遅延、請求書紛争へと連鎖する可能性があります。その30件のエラーは単なる修正作業ではなく、サプライチェーン全体に波及する運用上の摩擦の原因となるのです。
各サプライヤーが異なる形式を送る場合に、テンプレートが逆効果になる理由
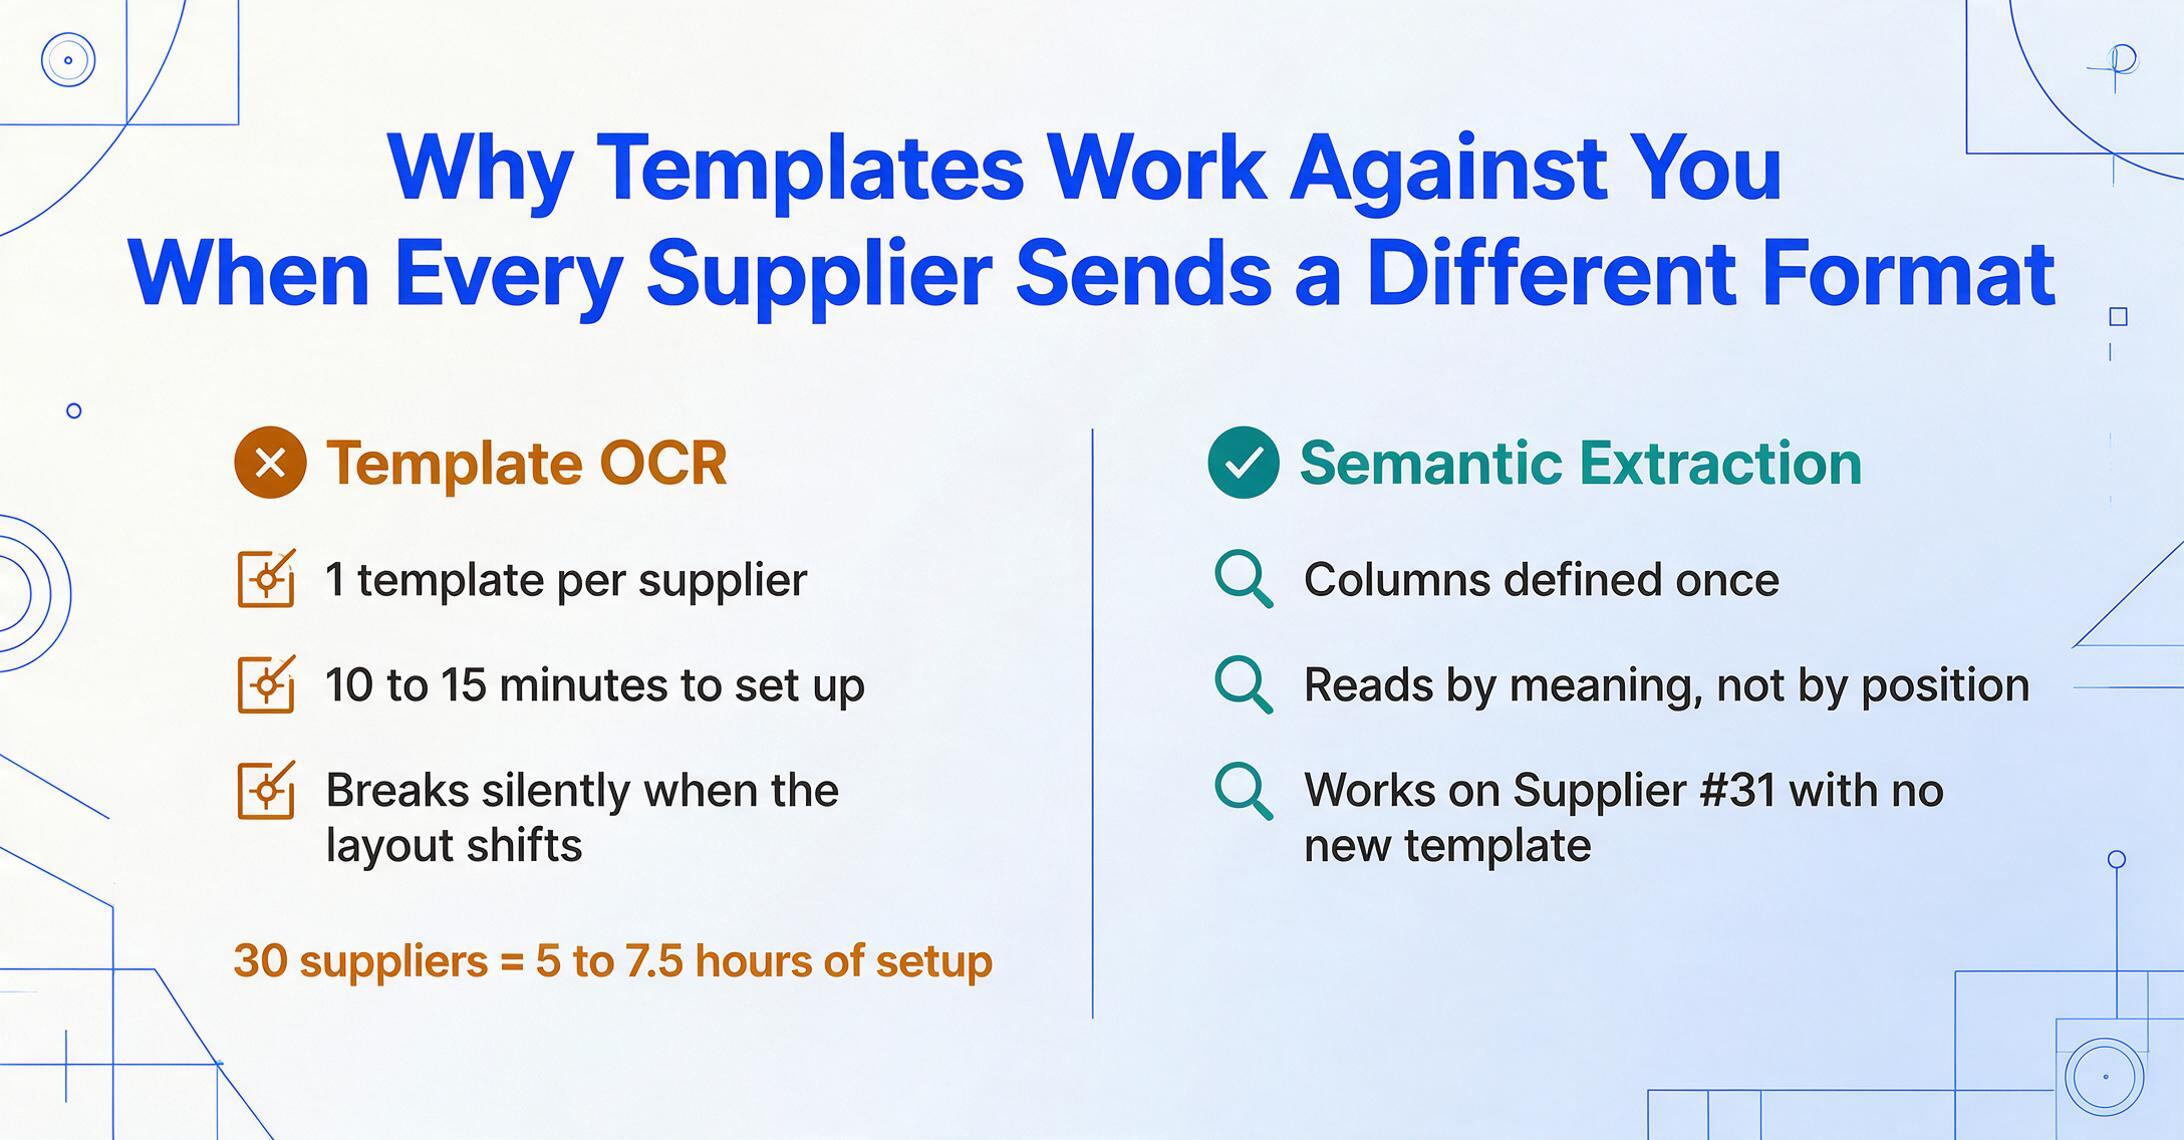
テンプレートベースの抽出は、発注書自動化で最も一般的なアプローチです。そのワークフローは直感的です。サプライヤーAのサンプル発注書をアップロードし、各フィールドの周囲にボックスを描き、ラベルを付け、保存します。同じレイアウトのサプライヤーAからの今後の発注書は自動的に処理されます。サプライヤーが30社になるまでは、これは単純明快です。
新しいサプライヤーごとに新しいテンプレートが必要になります。テンプレート設定セッション(バウンディングボックスの描画、フィールドのラベル付け、抽出の検証)には通常10〜15分かかります。30社のサプライヤーがいれば、初期のテンプレート作成に5〜7.5時間かかります。サプライヤー31社目が加わると、誰かが手を止めてテンプレート31番を作成します。また、既存の30社のサプライヤーのいずれかが発注書形式を変更した場合(ERPアップグレード、合併、新しい購買システムの導入)、テンプレートは静かに壊れ、データが欠落したときに初めて気づくことになります。
根本的な問題は、テンプレートが意味ではなく位置をコード化していることです。テンプレートは「発注書番号はページ上の座標X、Yにある」と示します。レイアウトが変わると(サプライヤー間、時間経過に伴い必ず変わります)、テンプレートは負債になります。手作業を排除したのではなく、「データ入力」から「増え続ける位置ベースのルールのライブラリを維持すること」へと性質を変えただけです。発注書形式の多様性(特に列の順序、ページ区切り、ヘッダーの繰り返しが異なる明細行テーブル)への対応は、付随的なものではなく構造的な課題です。テンプレートは、調達業務には存在しない静的な世界を前提としているのです。
現在お使いのチームがERPテンプレートインポートに依存している場合、または構築を続けるべきか検討中の場合は、ERPテンプレートインポートとAI抽出の比較をご覧ください。ギャップが広がる5つの側面、EDI 850の現実との乖離、そしてほとんどのチームが実際に必要とするハイブリッドアプローチを詳しく解説しています。
セマンティック抽出:位置ではなく意味で「数量」を見つける
ここでは根本的に異なるアプローチをご紹介します。ツールに各フィールドがページのどこにあるかを指示する代わりに、各フィールドが何を意味するかを指示する方法です。これはカスタム列抽出と呼ばれます。出力に必要な列(例:「発注書番号」「ベンダー名」「品目コード」「説明」「数量」「単価」「明細合計」)を定義すると、AIが文書内での意味的役割を理解して各値を特定します。サプライヤーAが発注書番号を右上に配置し、サプライヤーBが左上に配置しても、あるサプライヤーが数量を説明の前に記載し、別のサプライヤーが逆順で記載しても問題ありません。AIは発注書番号がどこにあるかではなく、発注書番号が何であるかを理解して値を探し出します。
これがテンプレートOCRとビジョンAIの違いです。テンプレートOCRは位置によってパターンを照合します。一方、ビジョン大規模モデル(画像を理解し、手書き文字を読み取り、文書レイアウトを推論するAIのクラス)は、人間と同じように発注書を読み取ります。つまり、文脈と意味を理解するのです。「PO #」や「Purchase Order Number」の近くに印刷された数字が発注書番号であることを認識します。「Unit Price」という見出しの下にある価格の列に単価が含まれていることを理解します。たとえその列があるサプライヤーの発注書では4番目の位置にあり、別のサプライヤーでは2番目の位置にあってもです。
入力した列名が出力スプレッドシートのヘッダーになります。「PO # / Supplier / SKU / Description / Qty / Unit Price / Total」と入力すれば、それらがエクスポートされたExcelの正確な列になります。すべてのサプライヤー、すべてのフォーマットで同様です。ベンダーごとのテンプレート作成は不要。フォーマットが変わっても再トレーニングは不要。AIが文書に適応します。ツールに文書を適応させる必要はありません。
ファイルは安全に処理され、保存されません。
PDFからスプレッドシートへ:発注書データ抽出の3ステップワークフロー
発注書データをスプレッドシートに抽出するエンドツーエンドのワークフローは、3つのステップで完了します。テンプレート設定も、トレーニングデータも、サプライヤーごとのセットアップも不要です。アップロードして、列を指定して、エクスポートするだけです。
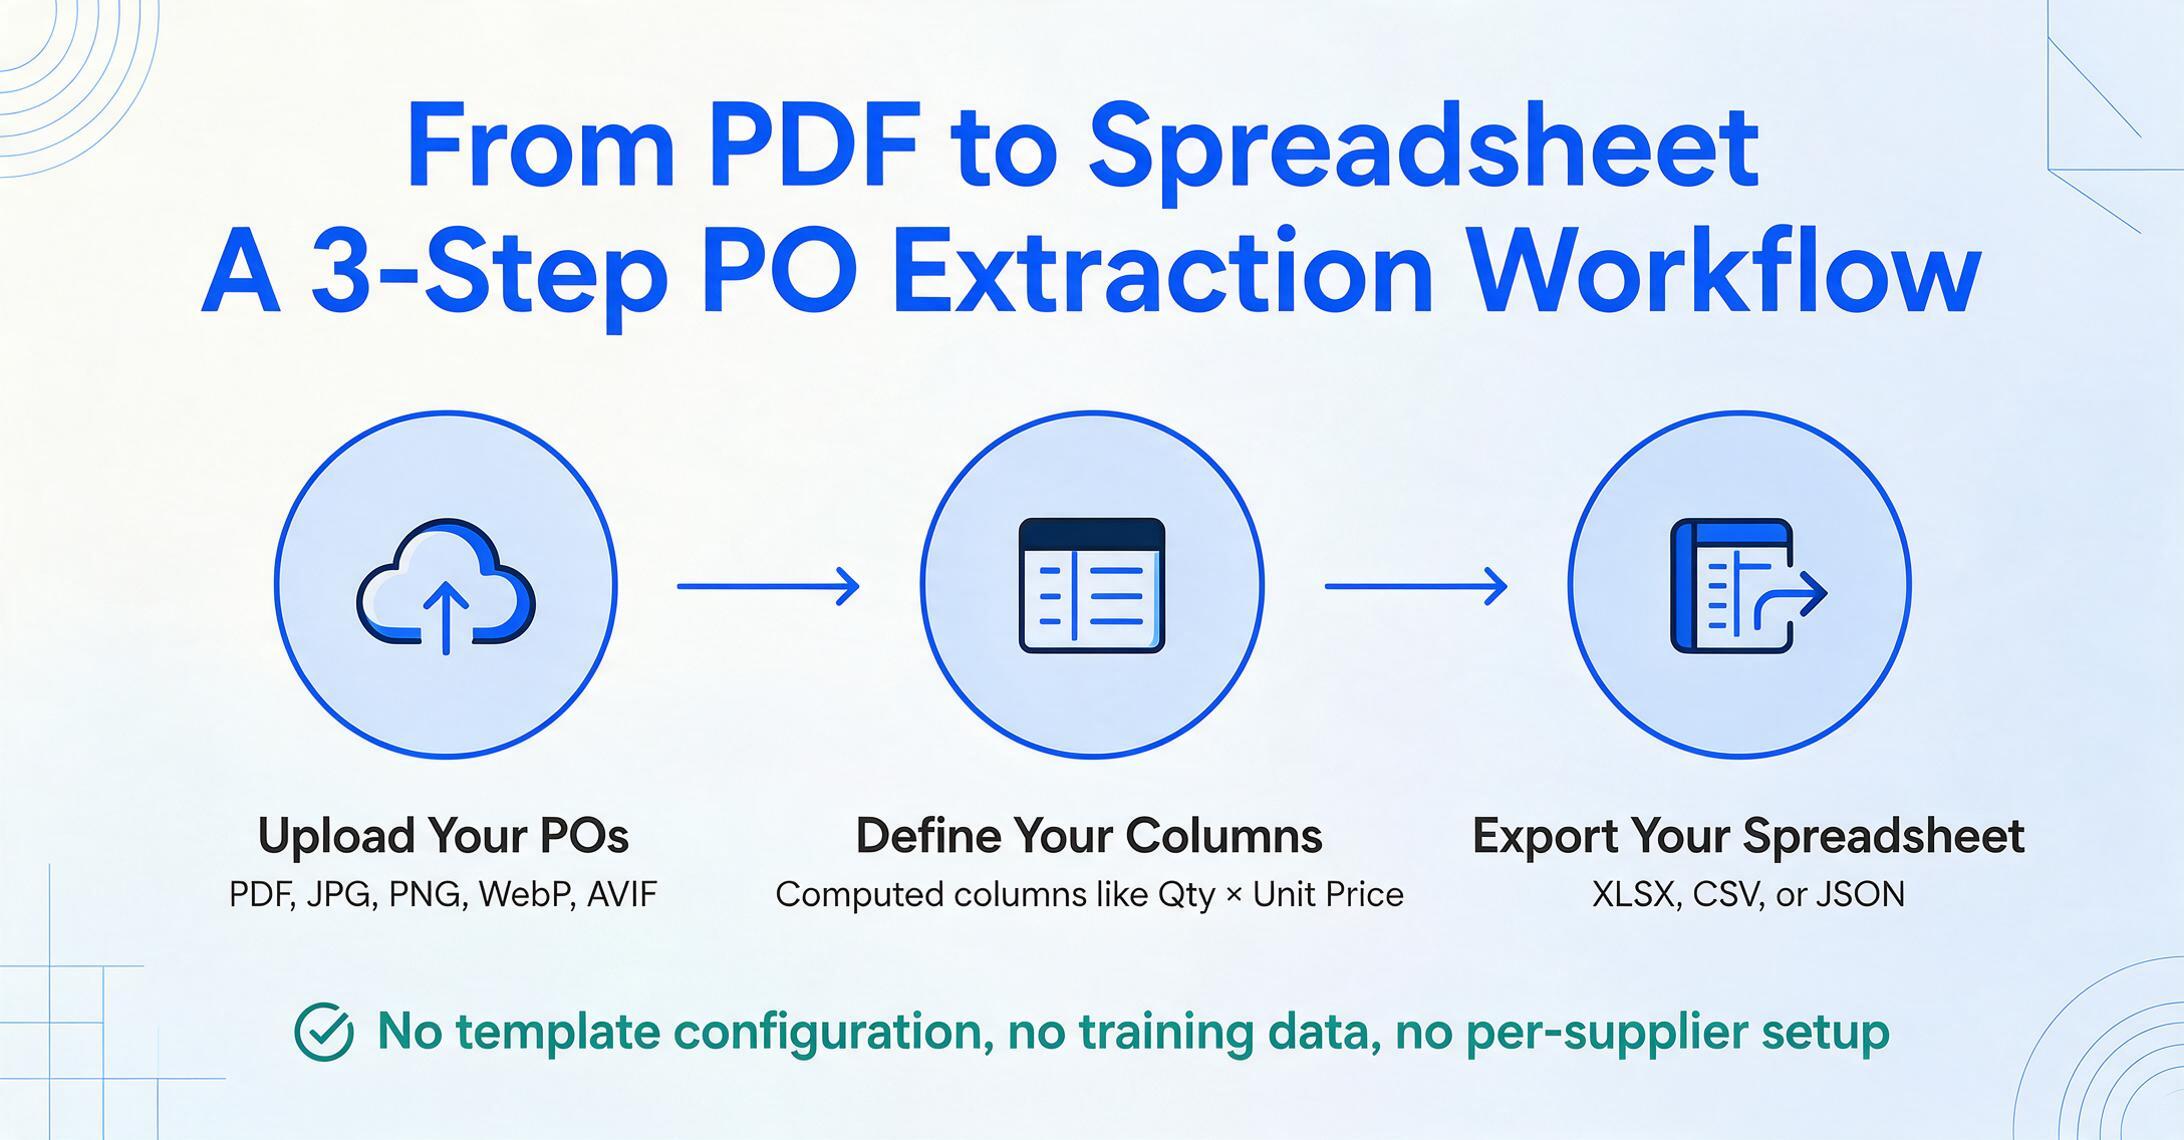
拡張価格(数量×単価)のように、抽出後に計算するのではなく、抽出中にAIに計算を実行させることができます。バッチ処理機能こそが、1件ずつ抽出する方法との違いです。各PDFを個別に開く代わりに、20件、50件、100件の発注書を一度にアップロードすると、ツールがバッチ全体を処理し、結果を1つのスプレッドシートに統合します。毎日多数のバイヤーから発注書の添付ファイルを受け取る調達チームにとって、これは各文書が手動入力の順番を待つキュー方式のボトルネックを解消します。
このツールはクロスドキュメント整合性を備えたバッチ処理にも対応しています。バイヤーAからの発注書#1034に8つの明細行があり、バイヤーBからの発注書#1035に3つの明細行がある場合、両方が同じ出力テーブルの行として表示されます。発注書に特定のデータポイントがない場合の空欄フィールドは、エラー値で埋められるのではなく、空白のまま残されます。出力は追加のスプレッドシート操作なしで分析可能な状態になっています。
これが置き換えないもの — そして置き換えるもの
セマンティックPOデータ抽出が調達テクノロジーの全体像の中でどこに位置するのか、そしてどこに位置しないのかを明確にすることが重要です。
これが行うこと: あらゆる形式の、あらゆるサプライヤーからの発注書文書から構造化データを抽出し、Excelスプレッドシートとして出力します。解決しようとしている問題が「PDFの発注書があり、その明細行をテーブルにしたい」というものであれば、これがその問題に対するツールです。サプライヤー間のフォーマットの多様性を処理し、文書をバッチ処理し、単一の結合出力を生成します — すべてテンプレートやトレーニングなしで実現します。
これが行わないこと: 発注書を承認チェーンにルーティングしません。予算管理や支出ポリシーを強制しません。サプライヤーの請求書をPOと照合しません(3ウェイマッチング — そのレイヤーも必要な場合は、Google Sheetsでマッチングパイプラインを構築するためのガイドをご覧ください)。取引をERP総勘定元帳に転記しません。また、サプライヤー関係(オンボーディング、パフォーマンススコアリング、契約追跡)を管理しません。
これらは、Coupa、SAP Ariba、Procurifyなどの完全な購買から支払いまで(P2P)プラットフォームの機能です — 購買ライフサイクル全体をオーケストレーションするエンタープライズグレードのスイートです。組織にその規模の調達ガバナンスが必要な場合、P2Pプラットフォームが適切なツールです。しかし、POデータをPDFからスプレッドシートに移すという特定のステップについては、セマンティック抽出ツールがそれらのプラットフォームが残すギャップを埋めます — 多くの場合、コストと実装の複雑さを大幅に抑えられます。
実際には、この2つは連携して機能します。卸売業者はセマンティック抽出を使用して受信した顧客のPOを構造化データに変換し、そのデータを注文管理システムや会計ソフトウェアにフィードできます。抽出ツールがフォーマットの多様性の問題を処理し、下流のシステムがフルフィルメント、請求、レポートを処理します。どちらのツールも相手の仕事をする必要はありません。
よくある質問
AI抽出は手書きの発注書でも機能しますか?
はい。Vision AIモデルは多様な手書きサンプルでトレーニングされており、活字と筆記体が混在したものを含む手書きの発注書からデータを抽出できます。手書きの精度は印刷テキストよりも低くなります(特に乱雑な筆跡や装飾の多い筆跡の場合)が、この技術は読みやすい手書き文書をうまく処理します。手書きフォームで届く可能性のある小規模サプライヤーや現場発行の発注書の場合、手書き発注書の抽出は、テンプレートOCRよりもセマンティックAIの最も強力なユースケースの1つです。テンプレートシステムは手書きでは通常まったく機能しないためです。
複数のサプライヤーからの発注書を1つのバッチで処理できますか?
はい。それが主なユースケースです。サプライヤー数、フォーマットの違い、ページ数を問わず、すべての発注書を1つのバッチにアップロードしてください。ターゲット列を一度定義すれば、AIがすべての文書からデータを抽出して統合スプレッドシートにまとめます。各文書の明細行は、バッチ名とソースファイルに紐づく行になります。そのため、すべての行を元の発注書まで遡って追跡できます。
自動発注書抽出を使用するにはERPシステムが必要ですか?
いいえ。抽出ツールは標準のExcel(XLSX)、CSV、またはJSONファイルを出力します。これらは任意のスプレッドシートアプリケーションで開くことができ、構造化データを受け付ける任意のシステムにインポートできます。ERP、会計プラットフォーム、統合設定は一切不要です。Excelファイルを開くことができれば、出力を使用できます。直接統合を希望するユーザーの場合も、抽出したデータは標準のファイルインポートでQuickBooks、Xero、NetSuite、または任意のシステムにインポートできます。
AIは複数ページにまたがる明細行をどのように処理しますか?
AIは文書全体を単一のデータソースとして扱い、個別のページとしては扱いません。ページの区切りをまたいで続く明細行は——継続ページに列ヘッダーが繰り返される場合も、繰り返されない場合も——連続したセットとして取得されます。このツールは後続ページの繰り返しヘッダーを認識し、それらを個別の明細行として抽出しません。6ページにわたって50以上の明細行がある発注書の場合、出力は手動でつなぎ合わせる必要のある断片的なページごとの抽出ではなく、1つのきれいなテーブルになります。
他のPO自動化ツールと比べて費用はどのくらいですか?
ImageToTable.aiの料金は、AIクレジット50回分で月額$9(ベーシック)、200回分で月額$19(プロ)、600回分で月額$59(マックス)から始まります。各クレジットで1ページを処理できます。一方、CoupaやSAP Aribaなどのエンタープライズ向けP2Pプラットフォームはカスタム料金で、通常は年間5万ドル台半ばから始まります。Precoroなどのミッドマーケット向けP2Pツールは、月額約$499からです。主なニーズが完全な購買から支払いまで(P2P)のガバナンスではなくPOデータ抽出である組織にとって、これは大きなコスト差を意味します。導入費用はなく、トレーニングも不要で、最低契約期間もありません。完全なP2Pスイートではなく、抽出特化型ツール同士で比較したい場合は、発注書抽出ツール7社の比較表をご覧ください。ご自身のPOで実際にお試しになりたいですか?発注書データ抽出ツールを直接ご利用ください。
発注書データ抽出の精度はどのくらいですか?
鮮明にスキャンされたPDFやデジタルPDF上の印刷された表データは、最大99%の精度を達成します。精度を低下させる要因には、低解像度のスキャン、背景ノイズが多い場合、極端な傾き、小さなフォントサイズで密集した明細行などがあります。このツールは、デジタルPDF、高品質のスキャン、スクリーンショットで最も信頼性が高くなります。数量や単価などの重要なフィールド(エラーが金銭的な影響を及ぼす可能性がある箇所)については、特に新しいサプライヤー形式を初めて使用する際は、最初の数回の抽出結果を元の文書と照合して確認することをお勧めします。これは完全に手間のかからないプロセスではありませんが、PO1件あたり8〜12分の手動入力が、数秒のAI抽出と簡単な検証パスに置き換わります。