Automatisieren Sie die Erfassung von Bestelldaten
Aus jedem PDF, ohne Vorlagen
Suchen Sie nach „Automatisierung der Bestellerfassung" und die Ergebnisse zeichnen das Bild eines gelösten Problems: Beschaffungssuiten mit Genehmigungsrouting, Budgetkontrolle, Drei-Wege-Abgleich und ERP-Synchronisierung. Aber für die Person, die jeden Morgen die Bestell-PDF eines Lieferanten öffnet und manuell ein Dutzend Positionen in eine Tabelle tippt, beschreibt dieses Bild ein anderes Gebäude. Der Schritt, den die meisten Anbieter von Bestellautomatisierung abdecken – was nach der Erfassung der Daten im System passiert – ist nicht der Engpass. Der Engpass ist, die Daten überhaupt erst ins System zu bekommen.
Diese Seite behandelt die Wirtschaftlichkeit der Bestellautomatisierung und den semantischen KI-Extraktionsansatz. Für den schrittweisen Batch-Workflow – 50 Lieferanten-PDFs in eine Excel-Tabelle verwandeln – siehe unseren Leitfaden zur Batch-Bestellextraktion nach Excel. Für die vollständige Feld-für-Feld-Referenz siehe den vollständigen Leitfaden zur Extraktion von Bestelldaten.
Ein Reddit-Nutzer in r/smallbusiness beschrieb das Problem präzise: „Ich muss die Datenextraktion aus Bestell-/PO-PDFs automatisieren – gibt es Tools oder Methoden?" Keine Erwähnung eines ERP. Keine Erwähnung von Genehmigungsworkflows. Nur PDFs und Daten, die von dort in etwas Nutzbares überführt werden müssen. In r/automation fragte ein anderer Nutzer, ob jemand „erfolgreich die Extraktion von Rechnungs- oder Bestelldaten ohne Vorlagen automatisiert" habe – die Vorlagenfrage taucht auf, weil die Formatvielfalt zwischen Lieferanten das eigentliche Hindernis ist, nicht das Tippen selbst.
Wichtigste Erkenntnisse
- Bestellautomatisierungs-Tools wie Coupa und SAP Ariba automatisieren alles nach der Datenerfassung im System – sobald die PDF eines Lieferanten in Ihrem Posteingang landet, sind Sie auf sich allein gestellt.
- Vorlagenextraktion – als Lösung für Multi-Lieferanten-Bestellungen angepriesen – reduziert die manuelle Arbeit nicht, sie benennt sie nur um: 30 Vorlagen kosten 5–7,5 Stunden Einrichtungszeit und brechen still, sobald ein Lieferant das Format ändert.
- Semantische KI findet „Menge", indem sie versteht, was eine Menge ist, nicht indem sie sich merkt, wo Lieferant #17 sie auf der Seite platziert – definieren Sie Ihre Spalten einmal, und jede Bestellung jedes Lieferanten, in jedem Layout, landet in derselben Tabelle.
Was PO-Automatisierung tatsächlich löst – und was nicht
Um zu verstehen, warum manuelle Dateneingabe weiterhin besteht, hilft es zu sehen, was die gängige PO-Automatisierungserzählung abdeckt. Der typische Procure-to-Pay-(P2P-)Ablauf, den Tools wie Coupa, SAP Ariba und Precoro automatisieren, sieht so aus:
Jeder dieser Schritte findet nach der Erfassung der Bestelldaten im System statt. Für ein Unternehmen, das Bestellungen an Lieferanten ausstellt, ist das die richtige Reihenfolge – die Bestellung entsteht intern, daher ist die Dateneingabe ins System der Ausgangspunkt, kein zu lösendes Problem.
Aber diese Beschreibung übersieht eine ganze Kategorie von Einkaufsworkflows: Unternehmen, die Bestellungen von ihren Kunden als PDFs, E-Mails oder gescannte Anhänge erhalten. Ein Hersteller, Händler oder Dienstleister, der Bestellungen von 30 verschiedenen Käufern bekommt – jede in einem eigenen Format – steht vor einem Dateneingabeproblem, das die vorgelagerte P2P-Automatisierung nie lösen sollte. Ihre Bestelldaten entstehen nicht im eigenen System. Sie kommen von außen, in einem fremden Format, und jemand muss sie abtippen.
Wichtige Erkenntnis: PO-Automatisierungstools automatisieren den Workflow rund um die Daten. Sie automatisieren nicht die Erfassung von Daten, die von außerhalb der Organisation in unstrukturierter PDF-Form eintreffen. Diese Lücke – das Übertragen von Positionsdaten aus einer Bestellung eines Lieferanten in eine Tabellenkalkulation oder ein Auftragsverwaltungssystem – ist der Bereich, in dem die meiste manuelle Arbeitszeit tatsächlich anfällt.
Die tatsächlichen Kosten manueller PO-Datenerfassung, aufgeschlüsselt
Die Beschaffung ist eine der am stärksten benchmarkten Geschäftsfunktionen, und die Zahlen beziffern, was jeder weiß, der schon einmal Bestellungen manuell erfasst hat: Manuelle Erfassung ist teuer, langsam und fehleranfällig. APQC Open Standards Benchmarking-Daten – die am häufigsten zitierte unabhängige Quelle in der Beschaffungsleistungsmessung – zeigen, dass Organisationen zwischen $14 und $54 für die Verarbeitung einer einzelnen Bestellung ausgeben, mit einem Median von $42. Beim 75. Perzentil ist das fast viermal so viel wie bei den Top-Performern im 25. Perzentil.
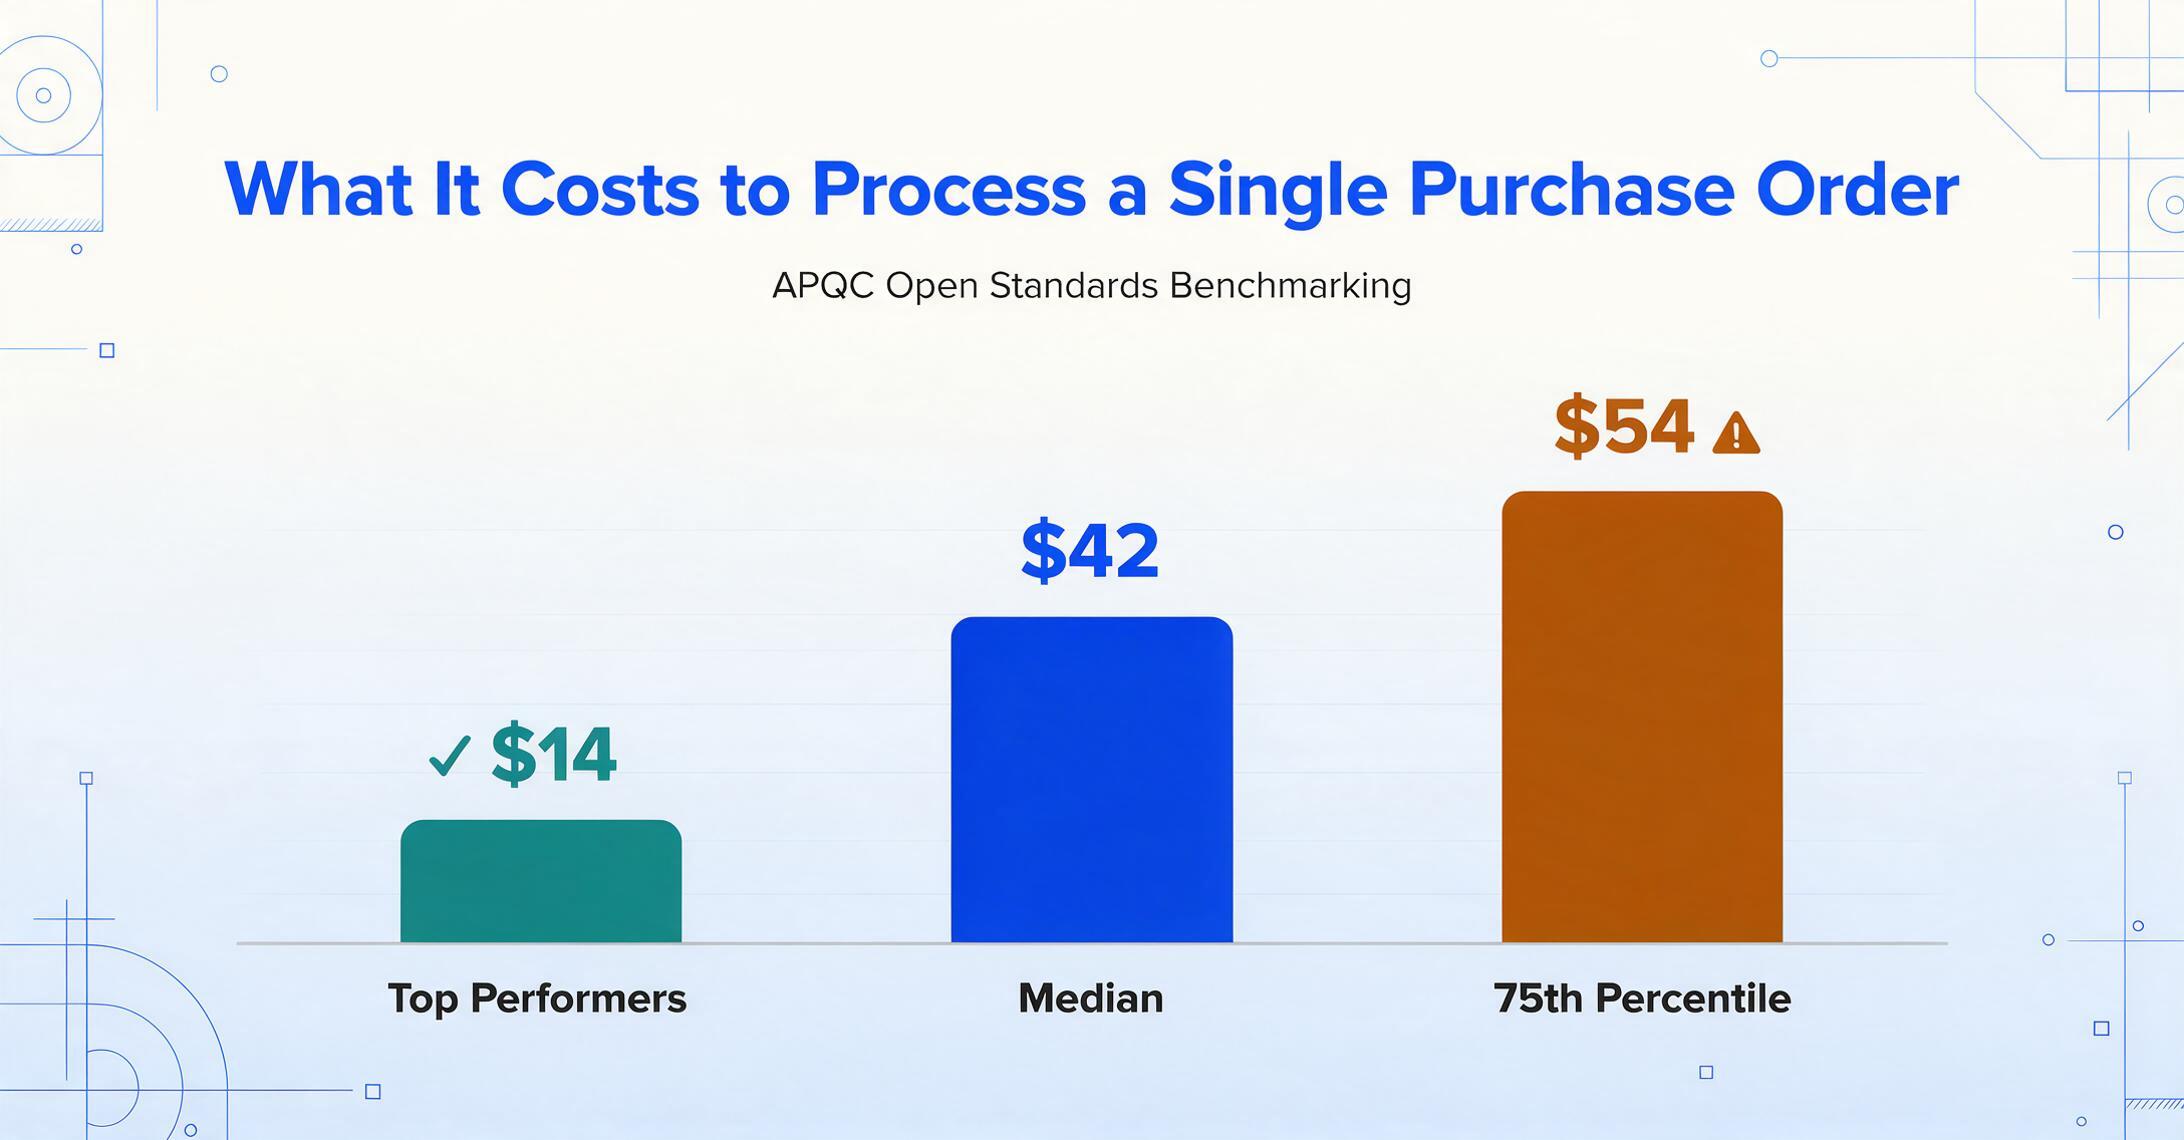
Für ein Unternehmen, das 1.000 Bestellungen pro Monat verarbeitet, stellt die Differenz zwischen $14 und $54 nicht nur Effizienz dar – sie stellt $40.000 pro Monat an Betriebskostenvarianz für denselben Transaktionssatz dar. Über ein Jahr summiert sich das auf fast eine halbe Million Dollar, die das unterste Quartil vom obersten trennt.
APQC stellte außerdem fest, dass Top-Beschaffungsorganisationen Bestellungen in etwa einem Tag ausstellen, während schwächere Performer mehr als doppelt so lange benötigen. Organisationen mit automatisierten Beschaffungsprozessen schließen PO-Durchlaufzeiten in 24 Stunden ab, gegenüber 35 Stunden bei manuellen Systemen oder Tabellenkalkulationen.
Der Kostentreiber ist Zeit, und der Zeittreiber ist Datenerfassung. Manuelle PO-Verarbeitung bedeutet, dass jemand jedes Feld liest – PO-Nummer, Lieferantenname, Artikelcodes, Mengen, Einheitspreise, Liefertermine – und sie in ein System eintippt. Eine Standard-Bestellung mit 10–20 Positionen erfordert 8 bis 12 Minuten manuelle Bearbeitungszeit, laut Rechnungsverarbeitungs-Benchmarks. Der Großteil dieser Zeit wird durch die Erfassung und Prüfung von Positionsdaten verbraucht, nicht durch strategische Entscheidungsfindung.
| Kennzahl | Manuelle PO-Verarbeitung | KI-gestützte Extraktion |
|---|---|---|
| Kosten pro Bestellung | $14–$54 (APQC-Median: $42) | ~$0,07–$0,29 pro Dokument |
| Zeit pro Bestellung | 8–12 Min. (Standard-Bestellung mit Positionen) | ~10 Sekunden pro Seite |
| Fehlerquote | 1–3% pro getipptem Feld | ~1% insgesamt, konsistent |
| Durchlaufzeit (Anfrage → Bestellung ausgestellt) | 35+ Stunden (manuell) | Unter 24 Stunden (Daten sofort verfügbar) |
| Skalierbarkeit | Linear: mehr Bestellungen = mehr Personalstunden | Nahezu null Grenzkosten pro zusätzlicher Bestellung |
Fehlerraten erhöhen den Zeitaufwand zusätzlich. Ein Datenerfasser, der bei 1.000 Dokumenten mit 97 % Genauigkeit arbeitet, macht etwa 30 Fehler pro Monat – jeder davon erfordert einen eigenen Untersuchungs- und Korrekturzyklus. Im Einkauf, wo eine einzige falsche Menge oder ein falscher Einzelpreis zu Überbestellungen, verspäteten Lieferungen oder Rechnungsstreitigkeiten führen kann, sind diese 30 Fehler nicht nur eine Aufräumaufgabe. Sie sind eine Quelle operativer Reibung, die sich über die gesamte Lieferkette multipliziert.
Warum Vorlagen gegen Sie arbeiten, wenn jeder Lieferant ein anderes Format sendet
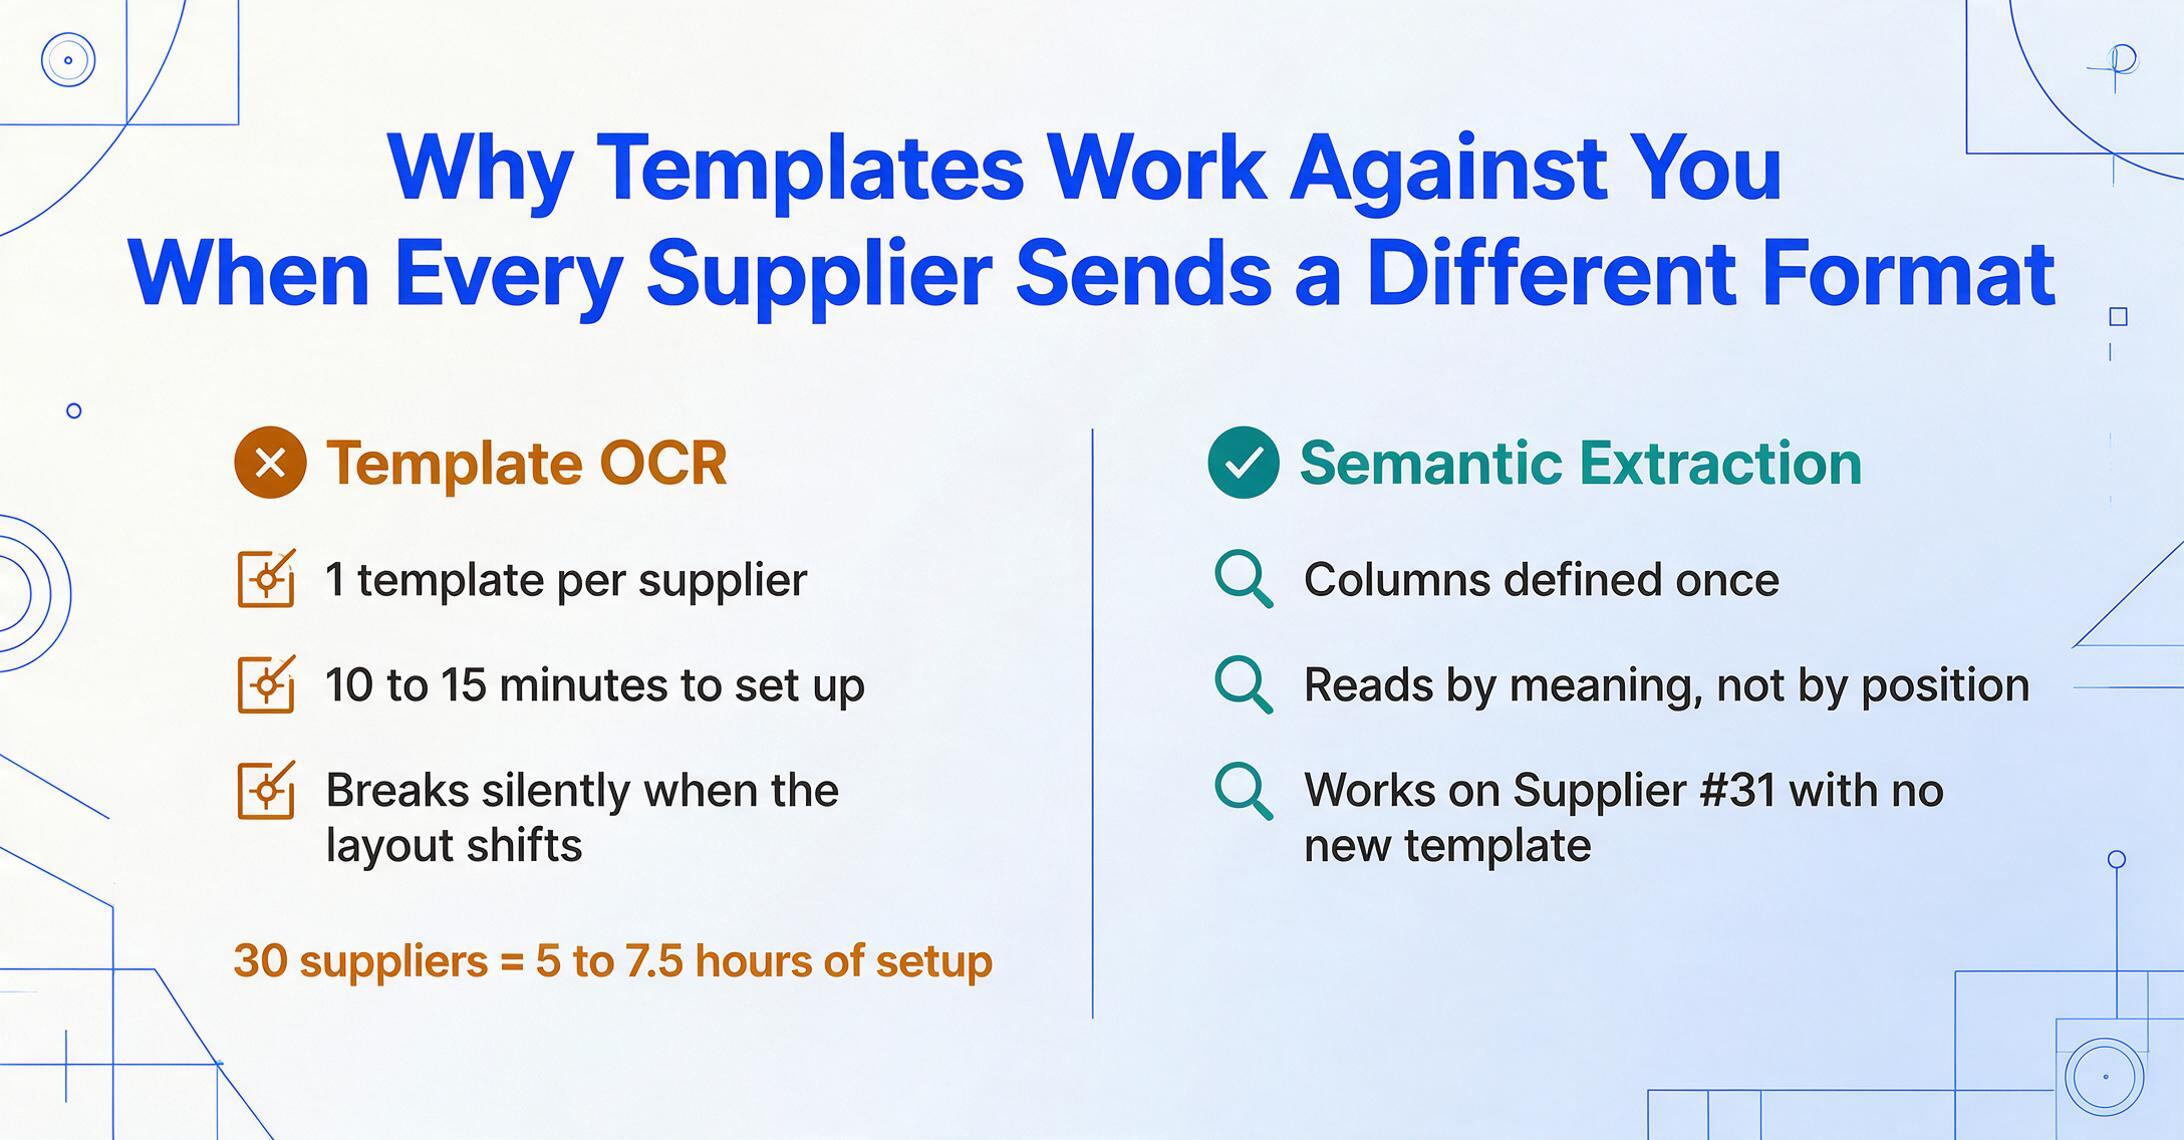
Die vorlagenbasierte Extraktion ist der gängigste Ansatz für die PO-Automatisierung. Der Ablauf ist intuitiv: Beispiel-PO von Lieferant A hochladen, Felder mit Rahmen markieren, beschriften und speichern. Zukünftige POs von Lieferant A mit demselben Layout werden automatisch verarbeitet. Das ist unkompliziert – bis Sie 30 Lieferanten haben.
Jeder neue Lieferant erfordert eine neue Vorlage. Eine Vorlageneinrichtung – Begrenzungsrahmen zeichnen, Felder beschriften, Extraktion verifizieren – dauert in der Regel 10 bis 15 Minuten. Bei 30 Lieferanten sind das 5 bis 7,5 Stunden anfänglicher Vorlagenerstellung. Wenn Lieferant Nr. 31 hinzukommt, unterbricht jemand seine Arbeit und erstellt Vorlage Nr. 31. Und wenn einer Ihrer bestehenden 30 Lieferanten sein PO-Format ändert – ein ERP-Upgrade, eine Fusion, ein neues Beschaffungssystem – bricht die Vorlage stillschweigend, und Sie merken es erst, wenn Daten fehlen.
Das zugrunde liegende Problem ist, dass Vorlagen Position statt Bedeutung kodieren. Eine Vorlage sagt: „Die PO-Nummer befindet sich an den Koordinaten X,Y auf der Seite.“ Wenn sich das Layout verschiebt – was es tun wird, über Lieferanten und Zeit hinweg – wird die Vorlage zur Belastung. Sie haben die manuelle Arbeit nicht beseitigt; Sie haben ihre Natur geändert, von „Daten eintippen“ zu „eine wachsende Bibliothek positionsbasierter Regeln pflegen“. Die Herausforderung der PO-Formatsvielfalt – insbesondere Positionszeilentabellen, die in Spaltenreihenfolge, Seitenumbrüchen und Kopfzeilenwiederholung variieren – ist strukturell, nicht nebensächlich. Vorlagen lösen eine statische Welt, die es im Einkauf nicht gibt.
Wenn Ihr Team derzeit auf ERP-Vorlagenimporten läuft – oder darüber diskutiert, ob es sie weiter ausbauen soll – zeigt unser Vergleich ERP-Vorlagenimporte vs. KI-Extraktion die fünf Dimensionen, in denen die Kluft größer wird, die EDI-850-Realitätslücke und den hybriden Ansatz, den die meisten Teams tatsächlich brauchen.
Semantische Extraktion: „Menge“ nach Bedeutung finden, nicht nach Position
Hier ist ein grundlegend anderer Ansatz: Statt dem Tool zu sagen, wo jedes Feld auf der Seite steht, sagen Sie ihm, was jedes Feld bedeutet. Das nennt man Benutzerdefinierte Spaltenextraktion — Sie definieren die Spalten, die Sie in Ihrer Ausgabe möchten (z. B. „Bestellnummer“, „Lieferantenname“, „Artikelcode“, „Beschreibung“, „Menge“, „Einzelpreis“, „Positionssumme“), und die KI findet jeden Wert, indem sie seine semantische Rolle im Dokument versteht. Es spielt keine Rolle, ob Lieferant A die Bestellnummer oben rechts platziert und Lieferant B oben links, oder ob ein Lieferant Mengen vor Beschreibungen auflistet und ein anderer umgekehrt. Die KI findet den Wert, indem sie versteht, was eine Bestellnummer ist, nicht wo sie steht.
Das ist der Unterschied zwischen Template-OCR und Vision-KI. Template-OCR gleicht Muster nach Position ab. Ein großes Vision-Modell — dieselbe Klasse von KI, die Bilder versteht, Handschrift liest und über Dokumentlayouts nachdenkt — liest eine Bestellung so, wie es ein Mensch tut: durch Verständnis von Kontext und Bedeutung. Es erkennt, dass eine Zahl neben „Bestellnr.“ oder „Bestellnummer“ die Bestellnummer ist. Es versteht, dass eine Spalte mit Preisen unter einer Überschrift „Einzelpreis“ Einzelpreise enthält, selbst wenn diese Spalte bei einem Lieferanten an Position 4 und bei einem anderen an Position 2 steht.
Die Spaltennamen, die Sie eingeben, werden zu den Kopfzeilen Ihrer Ausgabetabelle. Wenn Sie „Bestellnr. / Lieferant / SKU / Beschreibung / Menge / Einzelpreis / Summe“ eingeben, sind das die exakten Spalten in Ihrem exportierten Excel — über alle Lieferanten und Formate hinweg. Keine Vorlagenerstellung pro Anbieter. Kein Neulernen bei Formatänderungen. Die KI passt sich dem Dokument an; Sie passen das Dokument nicht an das Tool an.
Dateien werden sicher verarbeitet und nicht gespeichert.
Von PDF zur Tabelle: Ein 3-Schritte-Workflow zur Bestellnummernextraktion
Der durchgängige Workflow zur Extraktion von Bestelldaten in eine Tabelle umfasst drei Schritte. Es gibt keine Vorlagenkonfiguration, keine Trainingsdaten und kein Setup pro Lieferant – einfach hochladen, Spalten benennen und exportieren.
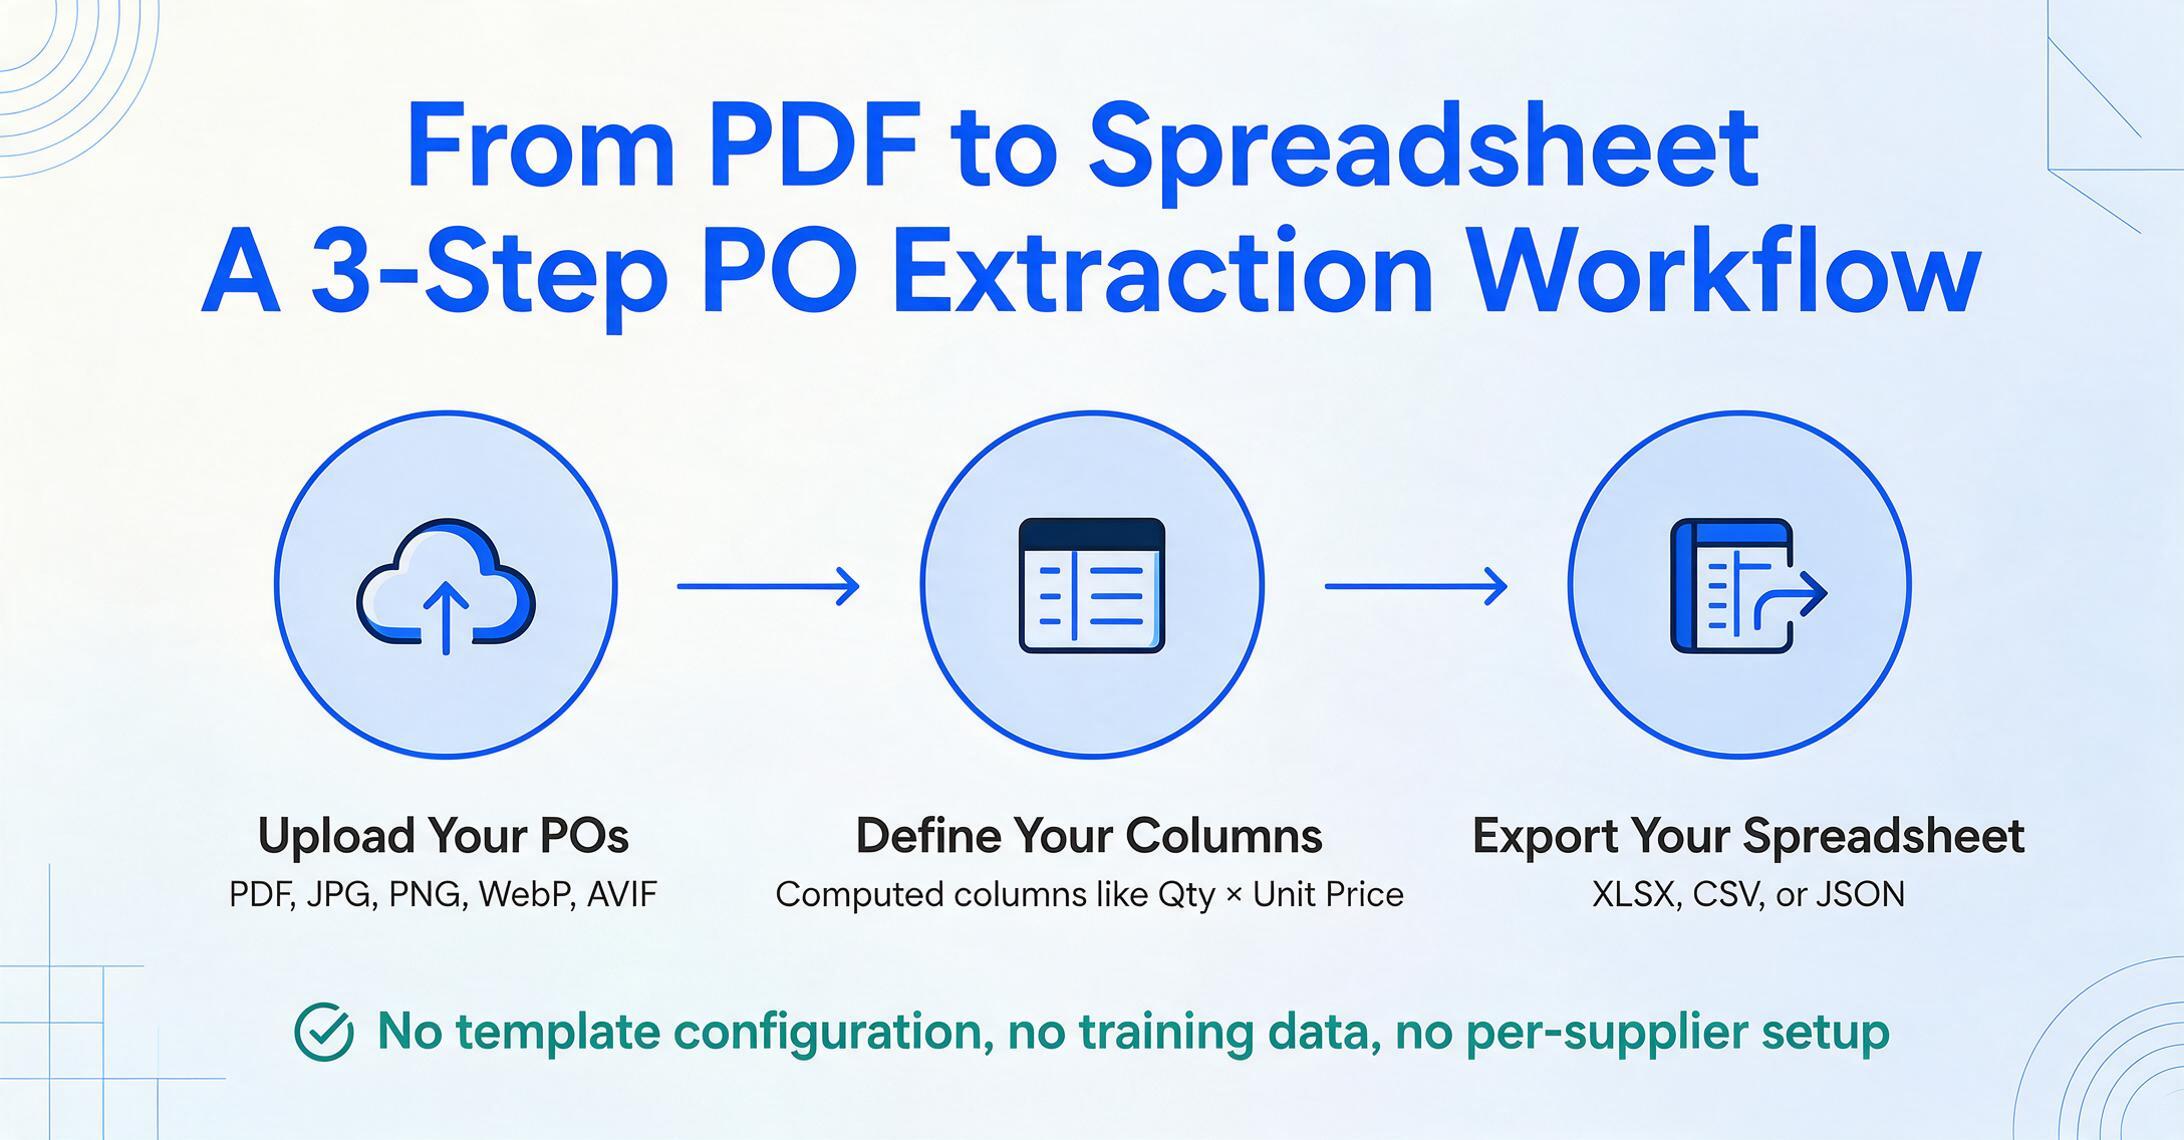
Gesamtpreis (Menge × Einzelpreis) –, damit die KI die Berechnungen während der Extraktion durchführt und nicht erst danach.Die Stapelverarbeitung ist das, was dies von der Einzeldatei-Extraktion unterscheidet. Statt jede PDF einzeln zu öffnen, laden Sie alles auf einmal hoch – 20, 50 oder 100 Bestellungen – und das Tool verarbeitet den gesamten Stapel und führt die Ergebnisse in einer einzigen Tabelle zusammen. Für ein Einkaufsteam, das täglich Bestellanhänge von Dutzenden Käufern erhält, entfällt so der Engpass der Warteschlange, bei dem jedes Dokument auf seine manuelle Erfassung warten muss.
Das Tool bietet außerdem Stapelverarbeitung mit dokumentübergreifender Konsistenz: Wenn Bestellung #1034 von Käufer A 8 Positionen enthält und Bestellung #1035 von Käufer B 3, erscheinen beide als Zeilen in derselben Ausgabetabelle. Leere Felder – wenn eine Bestellung einen bestimmten Datenpunkt nicht enthält – bleiben leer, statt mit Fehlerwerten gefüllt zu werden. Die Ausgabe ist ohne weitere Tabellenbearbeitung analysierbar.
Was das nicht ersetzt – und was es tut
Es ist wichtig, klar zu sagen, wo die semantische PO-Datenextraktion in der Beschaffungstechnologie-Landschaft einzuordnen ist – und wo nicht.
Was es tut: Es extrahiert strukturierte Daten aus Bestellbestelldokumenten in jedem Format, von jedem Lieferanten, und gibt sie als Excel-Tabelle aus. Wenn das Problem, das Sie lösen, ist „Ich habe eine PDF einer Bestellung und brauche ihre Positionen in einer Tabelle“, ist dies das Werkzeug für dieses Problem. Es bewältigt Formatvielfalt über Lieferanten, verarbeitet Dokumente in Stapeln und erzeugt eine einzige zusammengeführte Ausgabe – alles ohne Vorlagen oder Training.
Was es nicht tut: Es leitet Bestellungen nicht durch eine Genehmigungskette. Es setzt keine Budgetkontrollen oder Ausgabenrichtlinien durch. Es gleicht keine Lieferantenrechnungen mit Bestellungen ab (Drei-Wege-Abgleich – siehe unseren Leitfaden zum Aufbau einer Abgleich-Pipeline in Google Sheets, wenn Sie diese Ebene auch brauchen). Es bucht keine Transaktionen in ein ERP-Hauptbuch. Und es verwaltet nicht die Lieferantenbeziehung – Onboarding, Leistungsbewertung, Vertragsverfolgung.
Dies sind Funktionen vollständiger Procure-to-Pay-Plattformen wie Coupa, SAP Ariba und Procurify – Unternehmens-Suiten, die den gesamten Beschaffungslebenszyklus orchestrieren. Wenn Ihre Organisation diesen Umfang an Beschaffungsgovernance benötigt, ist eine P2P-Plattform das richtige Werkzeug. Aber für den spezifischen Schritt des PO-Daten von einer PDF in eine Tabelle zu bringen, füllt ein semantisches Extraktionswerkzeug die Lücke, die diese Plattformen offen lassen – oft zu einem Bruchteil der Kosten und Implementierungskomplexität.
In der Praxis können die beiden zusammenarbeiten. Ein Großhändler könnte semantische Extraktion verwenden, um eingehende Kundenbestellungen in strukturierte Daten umzuwandeln und diese Daten dann in sein Auftragsverwaltungssystem oder seine Buchhaltungssoftware einzuspeisen. Das Extraktionswerkzeug bewältigt das Formatvielfaltsproblem; die nachgelagerten Systeme übernehmen Erfüllung, Rechnungsstellung und Berichterstattung. Kein Werkzeug muss die Arbeit des anderen tun.
Häufig gestellte Fragen
Funktioniert die KI-Extraktion bei handschriftlichen Bestellungen?
Ja. Die Vision-KI-Modelle sind mit vielfältigen Handschriftproben trainiert und können Daten aus handschriftlichen Bestellungen extrahieren, einschließlich solcher mit gemischter Druckschrift und Schreibschrift. Die Genauigkeit bei Handschrift ist geringer als bei gedrucktem Text – besonders bei unleserlicher oder stark stilisierter Handschrift – aber die Technologie verarbeitet lesbare handschriftliche Dokumente gut. Für kleine Lieferanten oder vor Ort erstellte Bestellungen, die als handschriftliche Formulare eintreffen können, ist die Extraktion handschriftlicher Bestellungen einer der stärksten Anwendungsfälle für semantische KI gegenüber Template-OCR, da Templatesysteme bei Handschrift in der Regel vollständig versagen.
Kann ich Bestellungen von mehreren Lieferanten in einem Batch verarbeiten?
Ja. Das ist der Hauptanwendungsfall. Laden Sie alle Ihre Bestellungen – unabhängig von Lieferantenanzahl, Formatunterschieden oder Seitenzahl – in einen einzigen Batch hoch. Definieren Sie Ihre Zielspalten einmal, und die KI extrahiert Daten aus jedem Dokument in eine einheitliche Tabelle. Die Positionen jedes Dokuments werden als Zeilen mit Batch-Name und Quelldatei verknüpft, sodass Sie jede Zeile bis zu ihrer Ursprungsbestellung zurückverfolgen können.
Benötige ich ein ERP-System für die automatisierte Bestellungsextraktion?
Nein. Das Extraktionstool gibt Standard-Excel- (XLSX), CSV- oder JSON-Dateien aus, die in jeder Tabellenkalkulation geöffnet oder in jedes System importiert werden können, das strukturierte Daten akzeptiert. Sie benötigen kein ERP, keine Buchhaltungsplattform und keine Integrationskonfiguration. Wenn Sie eine Excel-Datei öffnen können, können Sie die Ausgabe verwenden. Für Benutzer, die eine direkte Integration wünschen, können die extrahierten Daten über Standard-Dateiimport in QuickBooks, Xero, NetSuite oder jedes andere System importiert werden.
Wie behandelt die KI Positionen, die sich über mehrere Seiten erstrecken?
Die KI behandelt das gesamte Dokument als eine einzige Datenquelle, nicht als isolierte Seiten. Positionen, die über Seitenumbrüche hinweg fortgesetzt werden – mit oder ohne wiederholte Spaltenüberschriften auf den Folgeseiten – werden als durchgehender Satz erfasst. Das Tool erkennt wiederholte Überschriften auf nachfolgenden Seiten und extrahiert sie nicht als separate Positionen. Bei Bestellungen mit 50+ Positionen über 6 Seiten ist die Ausgabe eine saubere Tabelle statt einer fragmentierten seitenweisen Extraktion, die manuell zusammengefügt werden müsste.
Was kostet es im Vergleich zu anderen PO-Automatisierungstools?
Die Preise von ImageToTable.ai beginnen bei 9 $/Monat (Basic) für 50 KI-Credits, 19 $/Monat (Pro) für 200 Credits und 59 $/Monat (Max) für 600 Credits – wobei jeder Credit eine Seite verarbeitet. Im Gegensatz dazu verwenden Enterprise-P2P-Plattformen wie Coupa und SAP Ariba individuelle Preise, die typischerweise im mittleren fünfstelligen Bereich pro Jahr beginnen. Mid-Market-P2P-Tools wie Precoro starten bei etwa 499 $/Monat. Für Organisationen, deren Hauptbedarf die PO-Datenextraktion und nicht die vollständige Procure-to-Pay-Governance ist, stellt dies einen erheblichen Kostenunterschied dar. Es gibt keine Implementierungsgebühr, keine Schulungsanforderung und keine Mindestlaufzeit. Wenn Sie dies speziell mit anderen extraktionsfokussierten Tools vergleichen möchten (nicht mit vollständigen P2P-Suiten), sehen Sie sich unseren Seitenvergleich von 7 Tools zur Bestelldatenextraktion an. Bereit, Ihre eigenen Bestellungen durchzulaufen? Nutzen Sie direkt das Tool zur Extraktion von Bestelldaten.
Wie hoch ist die Genauigkeitsrate bei der Extraktion von Bestelldaten?
Gedruckte Tabellendaten auf klar gescannten oder digitalen PDFs erreichen eine Genauigkeit von bis zu 99 %. Faktoren, die die Genauigkeit verringern, sind Scans mit niedriger Auflösung, starkes Hintergrundrauschen, extreme Schräglage und dicht gepackte Positionszeilen mit kleiner Schriftgröße. Das Tool ist am zuverlässigsten bei digitalen PDFs, hochwertigen Scans und Screenshots. Bei kritischen Feldern wie Mengen und Einheitspreisen – wo Fehler finanzielle Konsequenzen haben – ist es ratsam, die ersten Extraktionen mit dem Quelldokument zu vergleichen, insbesondere wenn Sie zum ersten Mal ein neues Lieferantenformat verwenden. Dies ist kein vollständig automatischer Prozess, aber er ersetzt 8–12 Minuten manuelles Tippen pro Bestellung durch Sekunden der KI-Extraktion plus einen schnellen Verifizierungsschritt.