Automatiza la entrada de datos de órdenes de compra
Desde cualquier PDF, sin plantillas
Busca "automatización de órdenes de compra" y los resultados pintan una imagen de un problema resuelto: suites de adquisiciones con enrutamiento de aprobaciones, control de presupuesto, conciliación de tres vías y sincronización con ERP. Pero para la persona que abre el PDF de PO de un proveedor cada mañana y teclea manualmente una docena de líneas en una hoja de cálculo, esa imagen describe un edificio diferente. El paso que la mayoría de los proveedores de automatización de PO cubren — lo que sucede después de que los datos ya están en el sistema — no es el cuello de botella. El cuello de botella es conseguir que los datos entren en el sistema en primer lugar.
Esta página cubre la economía de la automatización de PO y el enfoque de extracción con IA semántica. Para el flujo de trabajo por lotes paso a paso — convertir 50 PDFs de proveedores en una hoja de Excel — consulta nuestra guía de extracción por lotes de PO a Excel. Para la referencia completa campo por campo, consulta la guía completa de extracción de datos de órdenes de compra.
Un usuario de Reddit en r/smallbusiness describió el problema con precisión: "Necesito automatizar la extracción de datos de PDFs de pedidos/PO — ¿alguna herramienta o método?" Sin mención de un ERP. Sin mención de flujos de aprobación. Solo PDFs y datos que necesitan pasar de ellos a algo utilizable. En r/automation, otro usuario preguntó si alguien había "automatizado con éxito la extracción de datos de facturas u órdenes de compra sin depender de plantillas" — la cuestión de las plantillas surge porque la variación de formatos entre proveedores es el obstáculo real, no el acto de teclear en sí.
Conclusiones clave
- Las herramientas de automatización de PO como Coupa y SAP Ariba automatizan todo después de que los datos están en el sistema — en el momento en que el PDF de un proveedor llega a tu bandeja de entrada, estás por tu cuenta.
- La extracción con plantillas — promocionada como la solución para POs de múltiples proveedores — no reduce el trabajo manual, lo reetiqueta: 30 plantillas cuestan 5–7.5 horas de configuración y fallan silenciosamente en cuanto cualquier proveedor cambia el formato.
- La IA semántica encuentra "Cantidad" entendiendo qué es una cantidad, no memorizando dónde la pone el Proveedor #17 en la página — define tus columnas una vez, y el PO de cada proveedor, en cualquier diseño, aterriza en la misma hoja de cálculo.
Qué resuelve realmente la automatización de PO — y qué no
Para entender por qué la entrada manual de datos persiste, ayuda ver qué cubre la narrativa estándar de automatización de PO. El flujo típico de procure-to-pay (P2P) que herramientas como Coupa, SAP Ariba y Precoro automatizan se ve así:
Cada uno de estos pasos ocurre después de que los datos de la orden de compra ya están en el sistema. Para una empresa que emite PO a proveedores, esa es la secuencia correcta — la PO se origina internamente, así que la entrada de datos en el sistema es el punto de partida, no un problema a resolver.
Pero esta descripción omite una categoría completa de flujos de trabajo de compras: empresas que reciben órdenes de compra de sus clientes como PDF, correos electrónicos o archivos escaneados. Un fabricante, distribuidor o proveedor de servicios que recibe PO de 30 compradores diferentes — cada una en su propio formato — enfrenta un problema de entrada de datos que la automatización P2P upstream nunca fue diseñada para abordar. Sus datos de PO no se originan en su sistema. Llegan desde fuera, en el formato de otra persona, y alguien tiene que escribirlos.
Idea clave: Las herramientas de automatización de PO automatizan el flujo de trabajo alrededor de los datos. No automatizan la entrada de datos que llegan desde fuera de la organización en formato PDF no estructurado. Esa brecha — mover datos de líneas de artículos de una PO de proveedor a una hoja de cálculo o sistema de gestión de pedidos — es donde se gastan la mayoría de las horas manuales.
El costo real de la captura manual de datos de órdenes de compra, desglosado
La gestión de compras es una de las funciones empresariales más evaluadas con benchmarks, y las cifras cuantifican lo que cualquiera que haya tecleado órdenes de compra ya sabe: la captura manual es costosa, lenta y propensa a errores. Los datos de APQC Open Standards Benchmarking — la fuente independiente más citada en la medición del desempeño de compras — muestran que las organizaciones gastan entre $14 y $54 para procesar una sola orden de compra, con una mediana de $42. En el percentil 75, eso es casi cuatro veces más que los mejores desempeños en el percentil 25.
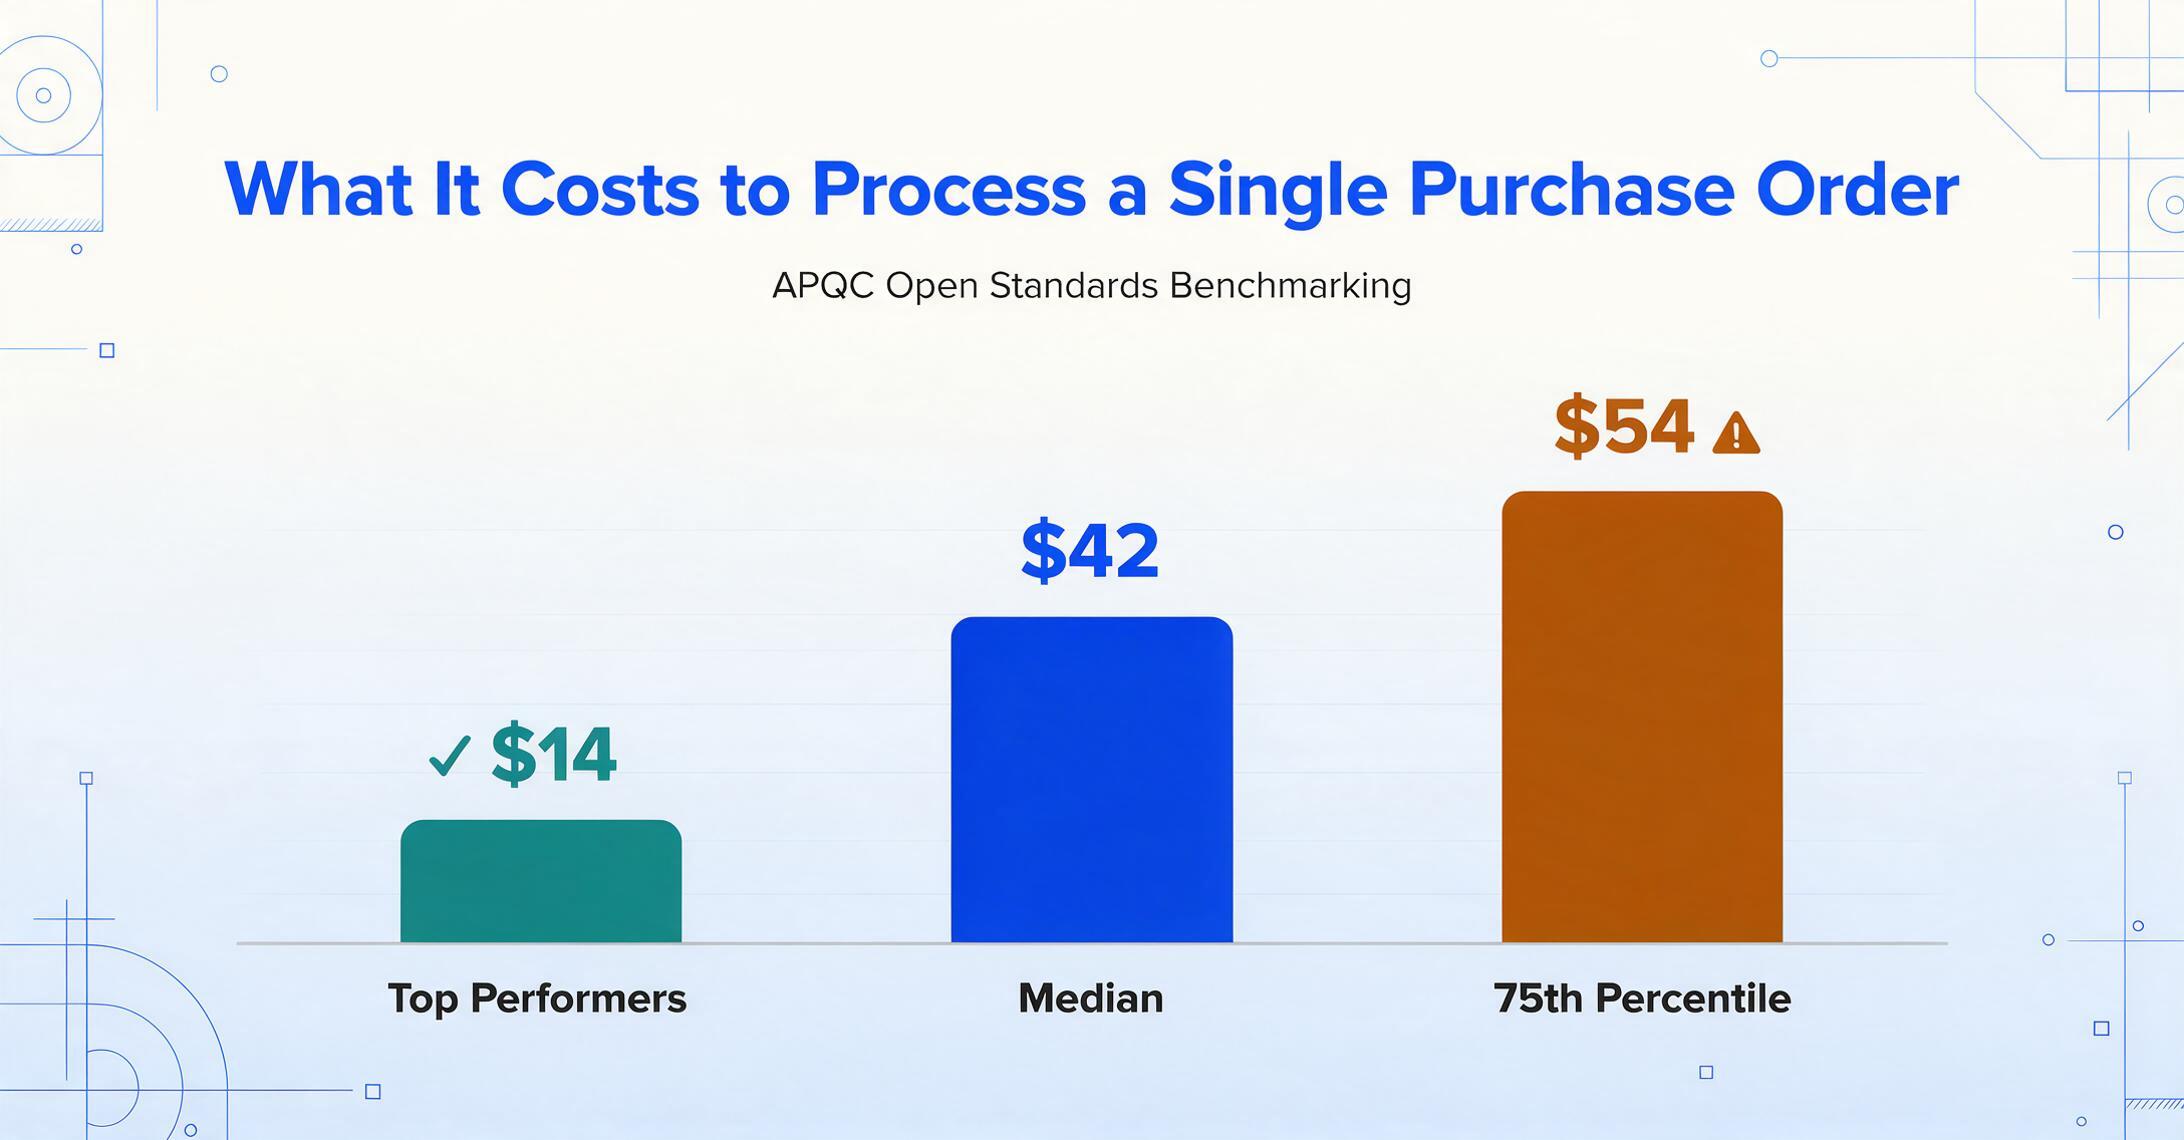
Para una empresa que procesa 1,000 órdenes de compra al mes, la brecha entre $14 y $54 no solo representa eficiencia — representa $40,000 por mes en variación de costos operativos para el mismo conjunto de transacciones. En un año, eso es casi medio millón de dólares que separa al cuartil inferior del superior.
APQC también encontró que las organizaciones de compras de mejor desempeño emiten órdenes de compra en aproximadamente un día, mientras que las de menor desempeño tardan más del doble. Las organizaciones con procesos de compras automatizados completan los tiempos de ciclo de las órdenes de compra en 24 horas, frente a las 35 horas de quienes dependen de sistemas manuales u hojas de cálculo.
El factor que impulsa el costo es el tiempo, y el factor que impulsa el tiempo es la captura de datos. El procesamiento manual de órdenes de compra significa que alguien lee cada campo — número de orden, nombre del proveedor, códigos de artículo, cantidades, precios unitarios, fechas de entrega — y los teclea en un sistema. Una orden de compra estándar con 10–20 partidas toma de 8 a 12 minutos de tiempo manual, según los benchmarks de procesamiento de facturas. La mayor parte de ese tiempo se consume en la captura y verificación de datos de las partidas, no en la toma de decisiones estratégicas.
| Métrica | Procesamiento manual de órdenes de compra | Extracción asistida por IA |
|---|---|---|
| Costo por orden de compra | $14–$54 (mediana APQC: $42) | ~$0.07–$0.29 por documento |
| Tiempo por orden de compra | 8–12 min (orden estándar con partidas) | ~10 segundos por página |
| Tasa de error | 1–3% por campo tecleado | ~1% en total, de forma consistente |
| Tiempo de ciclo (solicitud → orden emitida) | 35+ horas (manual) | Menos de 24 horas (datos disponibles de inmediato) |
| Escalabilidad | Lineal: más órdenes = más horas de personal | Costo marginal casi nulo por orden adicional |
Las tasas de error agravan el costo de tiempo. Un trabajador de entrada de datos que opera con un 97% de precisión en 1,000 documentos comete aproximadamente 30 errores al mes, cada uno requiriendo un ciclo separado de investigación y corrección. En adquisiciones, donde una sola cantidad o precio unitario incorrecto puede desencadenar pedidos excesivos, envíos retrasados o disputas de facturas, esos 30 errores no son solo una tarea de limpieza. Son una fuente de fricción operativa que se multiplica a lo largo de la cadena de suministro.
Por qué las plantillas juegan en tu contra cuando cada proveedor envía un formato diferente
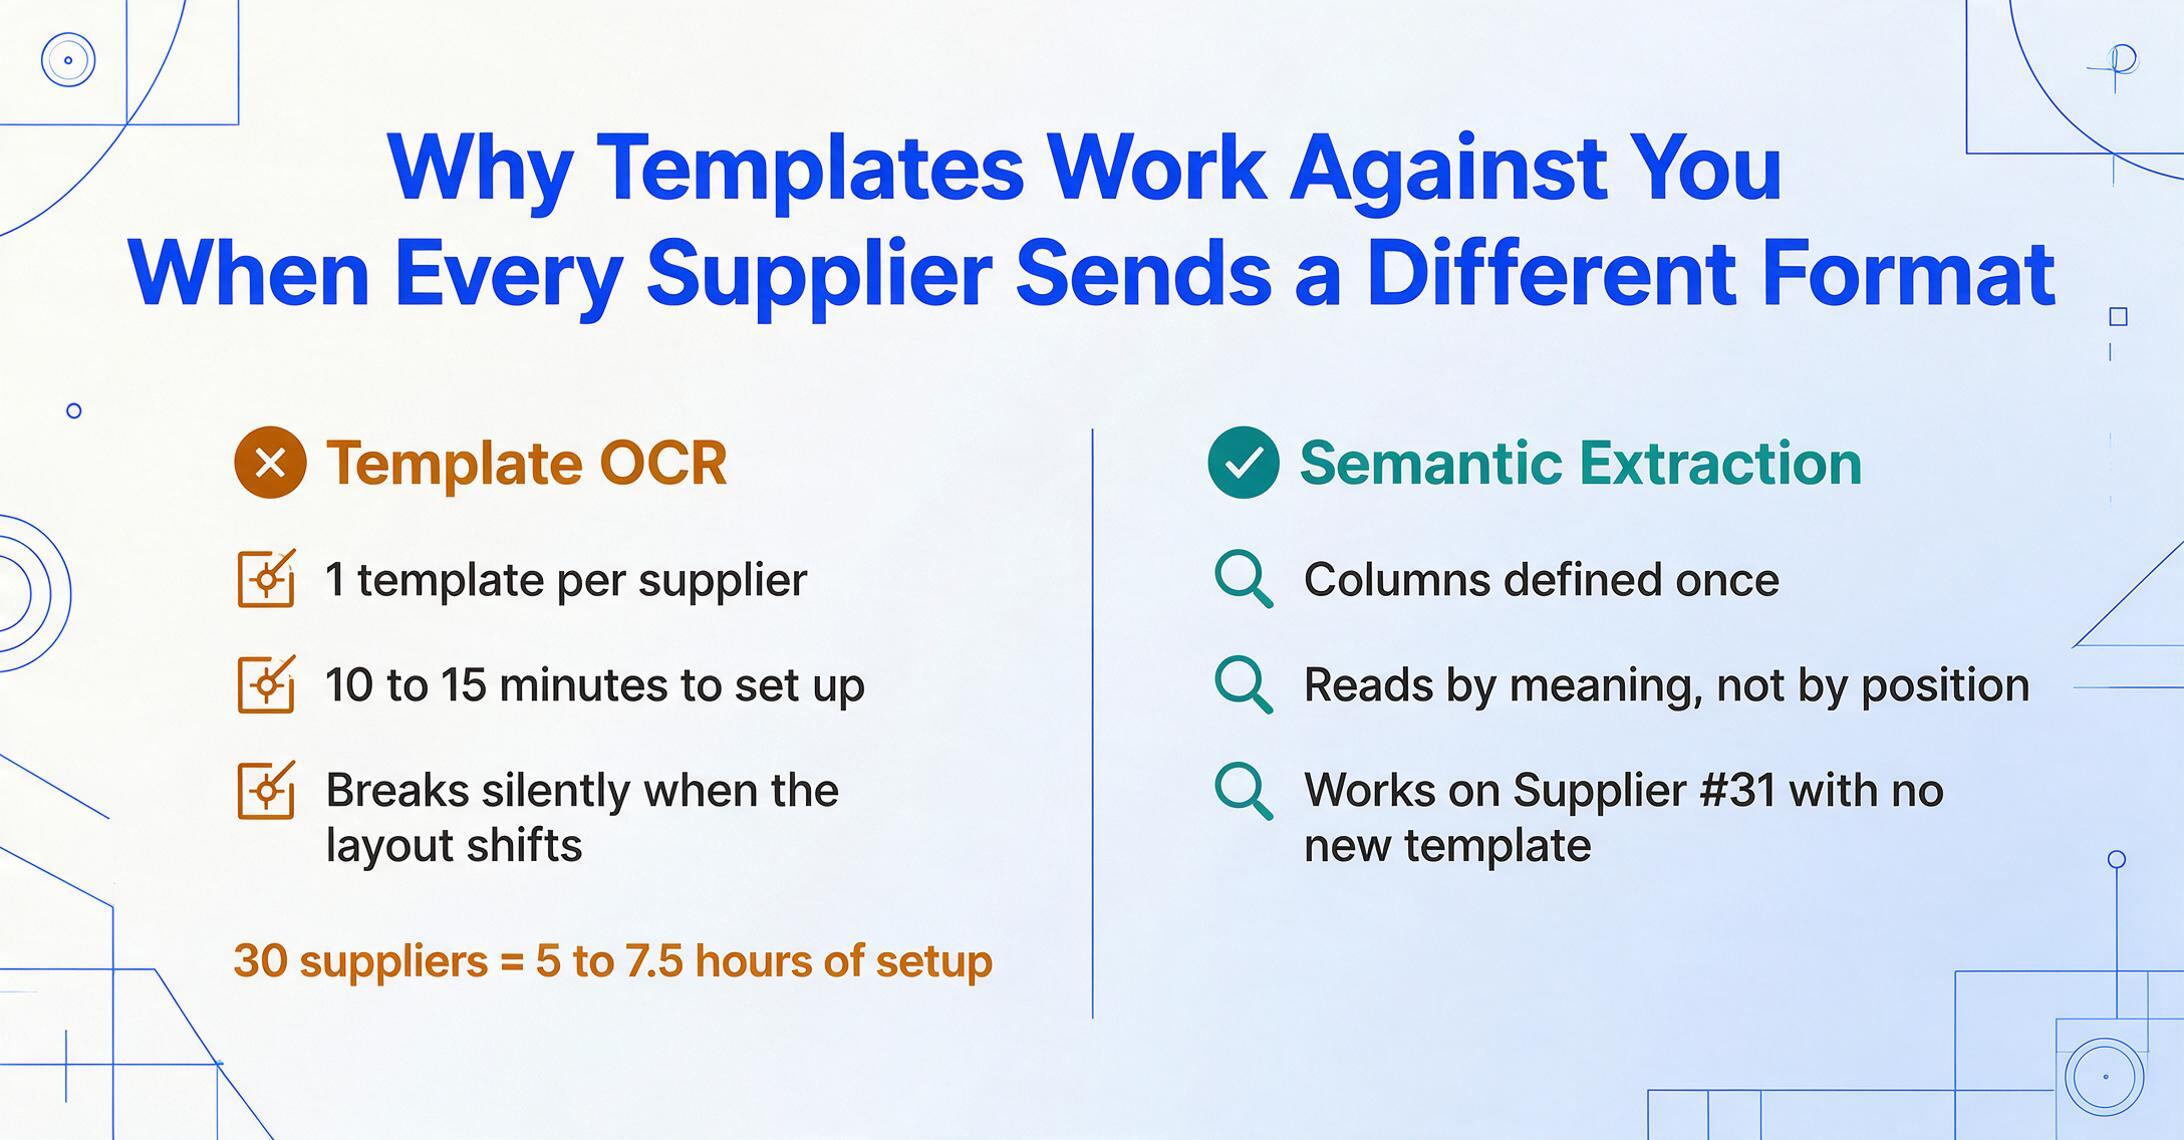
La extracción basada en plantillas es el enfoque más común para la automatización de órdenes de compra. El flujo de trabajo es intuitivo: sube una muestra de OC del Proveedor A, dibuja cuadros alrededor de cada campo, etiquétalos y guárdalos. Las futuras OC del Proveedor A con el mismo diseño se procesan automáticamente. Es sencillo, hasta que tienes 30 proveedores.
Cada nuevo proveedor requiere una nueva plantilla. Una sesión de configuración de plantilla (dibujar cuadros delimitadores, etiquetar campos, verificar la extracción) normalmente toma de 10 a 15 minutos. Con 30 proveedores, eso son de 5 a 7.5 horas de creación inicial de plantillas. Cuando el Proveedor #31 se incorpora, alguien detiene lo que está haciendo y construye la plantilla #31. Y si cualquiera de tus 30 proveedores existentes cambia su formato de OC (una actualización de ERP, una fusión, un nuevo sistema de compras), la plantilla se rompe silenciosamente y te enteras cuando los datos desaparecen.
El problema subyacente es que las plantillas codifican posición, no significado. Una plantilla dice "el número de OC está en las coordenadas X,Y de la página". Cuando el diseño cambia (lo cual ocurrirá, entre proveedores y a lo largo del tiempo), la plantilla se convierte en un pasivo. No has eliminado el trabajo manual; has cambiado su naturaleza de "escribir datos" a "mantener una biblioteca creciente de reglas basadas en posición". El desafío de la diversidad de formatos de OC (especialmente tablas de partidas que varían en orden de columnas, saltos de página y repetición de encabezados) es estructural, no incidental. Las plantillas resuelven para un mundo estático que no existe en las adquisiciones.
Si tu equipo actualmente opera con importaciones de plantillas ERP, o está debatiendo si seguir construyéndolas, nuestra comparación de importaciones de plantillas ERP vs. extracción con IA desglosa las cinco dimensiones donde la brecha se amplía, la brecha de realidad del EDI 850 y el enfoque híbrido que la mayoría de los equipos realmente necesitan.
Extracción Semántica: Encontrar la "Cantidad" por Significado, No por Posición
Aquí hay un enfoque fundamentalmente diferente: en lugar de decirle a la herramienta dónde se encuentra cada campo en la página, le dices qué significa cada campo. Esto se llama Extracción de Columnas Personalizadas — defines las columnas que deseas en tu salida (por ejemplo, "N.º de PO", "Nombre del Proveedor", "Código de Artículo", "Descripción", "Cantidad", "Precio Unitario", "Total de Línea"), y la IA localiza cada valor al comprender su rol semántico en el documento. No importa si el Proveedor A coloca el número de PO en la esquina superior derecha y el Proveedor B lo coloca en la esquina superior izquierda, o si un proveedor lista cantidades antes de las descripciones y otro hace lo contrario. La IA encuentra el valor al comprender qué es un número de orden de compra, no dónde se encuentra.
Esta es la diferencia entre el OCR con plantillas y la IA de visión. El OCR con plantillas empareja patrones por posición. Un modelo grande de visión — la misma clase de IA que comprende imágenes, lee escritura a mano y razona sobre diseños de documentos — lee una orden de compra como lo haría una persona: comprendiendo el contexto y el significado. Reconoce que un número impreso cerca de "PO #" o "Número de Orden de Compra" es el número de PO. Comprende que una columna de precios bajo un encabezado que dice "Precio Unitario" contiene precios unitarios, incluso si esa columna aparece en la posición 4 en el PO de un proveedor y en la posición 2 en el de otro.
Los nombres de columna que ingresas se convierten en los encabezados de tu hoja de cálculo de salida. Si escribes "PO # / Proveedor / SKU / Descripción / Cant. / Precio Unitario / Total," esas son las columnas exactas en tu Excel exportado — para todos los proveedores, todos los formatos. Sin creación de plantillas por proveedor. Sin reentrenamiento cuando cambian los formatos. La IA se adapta al documento; tú no adaptas el documento a la herramienta.
Los archivos se procesan de forma segura y no se almacenan.
De PDF a Hoja de Cálculo: Un Flujo de Trabajo de Extracción de OC en 3 Pasos
El flujo de trabajo de extremo a extremo para extraer datos de órdenes de compra a una hoja de cálculo consta de tres pasos. No hay configuración de plantillas, ni datos de entrenamiento, ni configuración por proveedor: solo sube, nombra tus columnas y exporta.
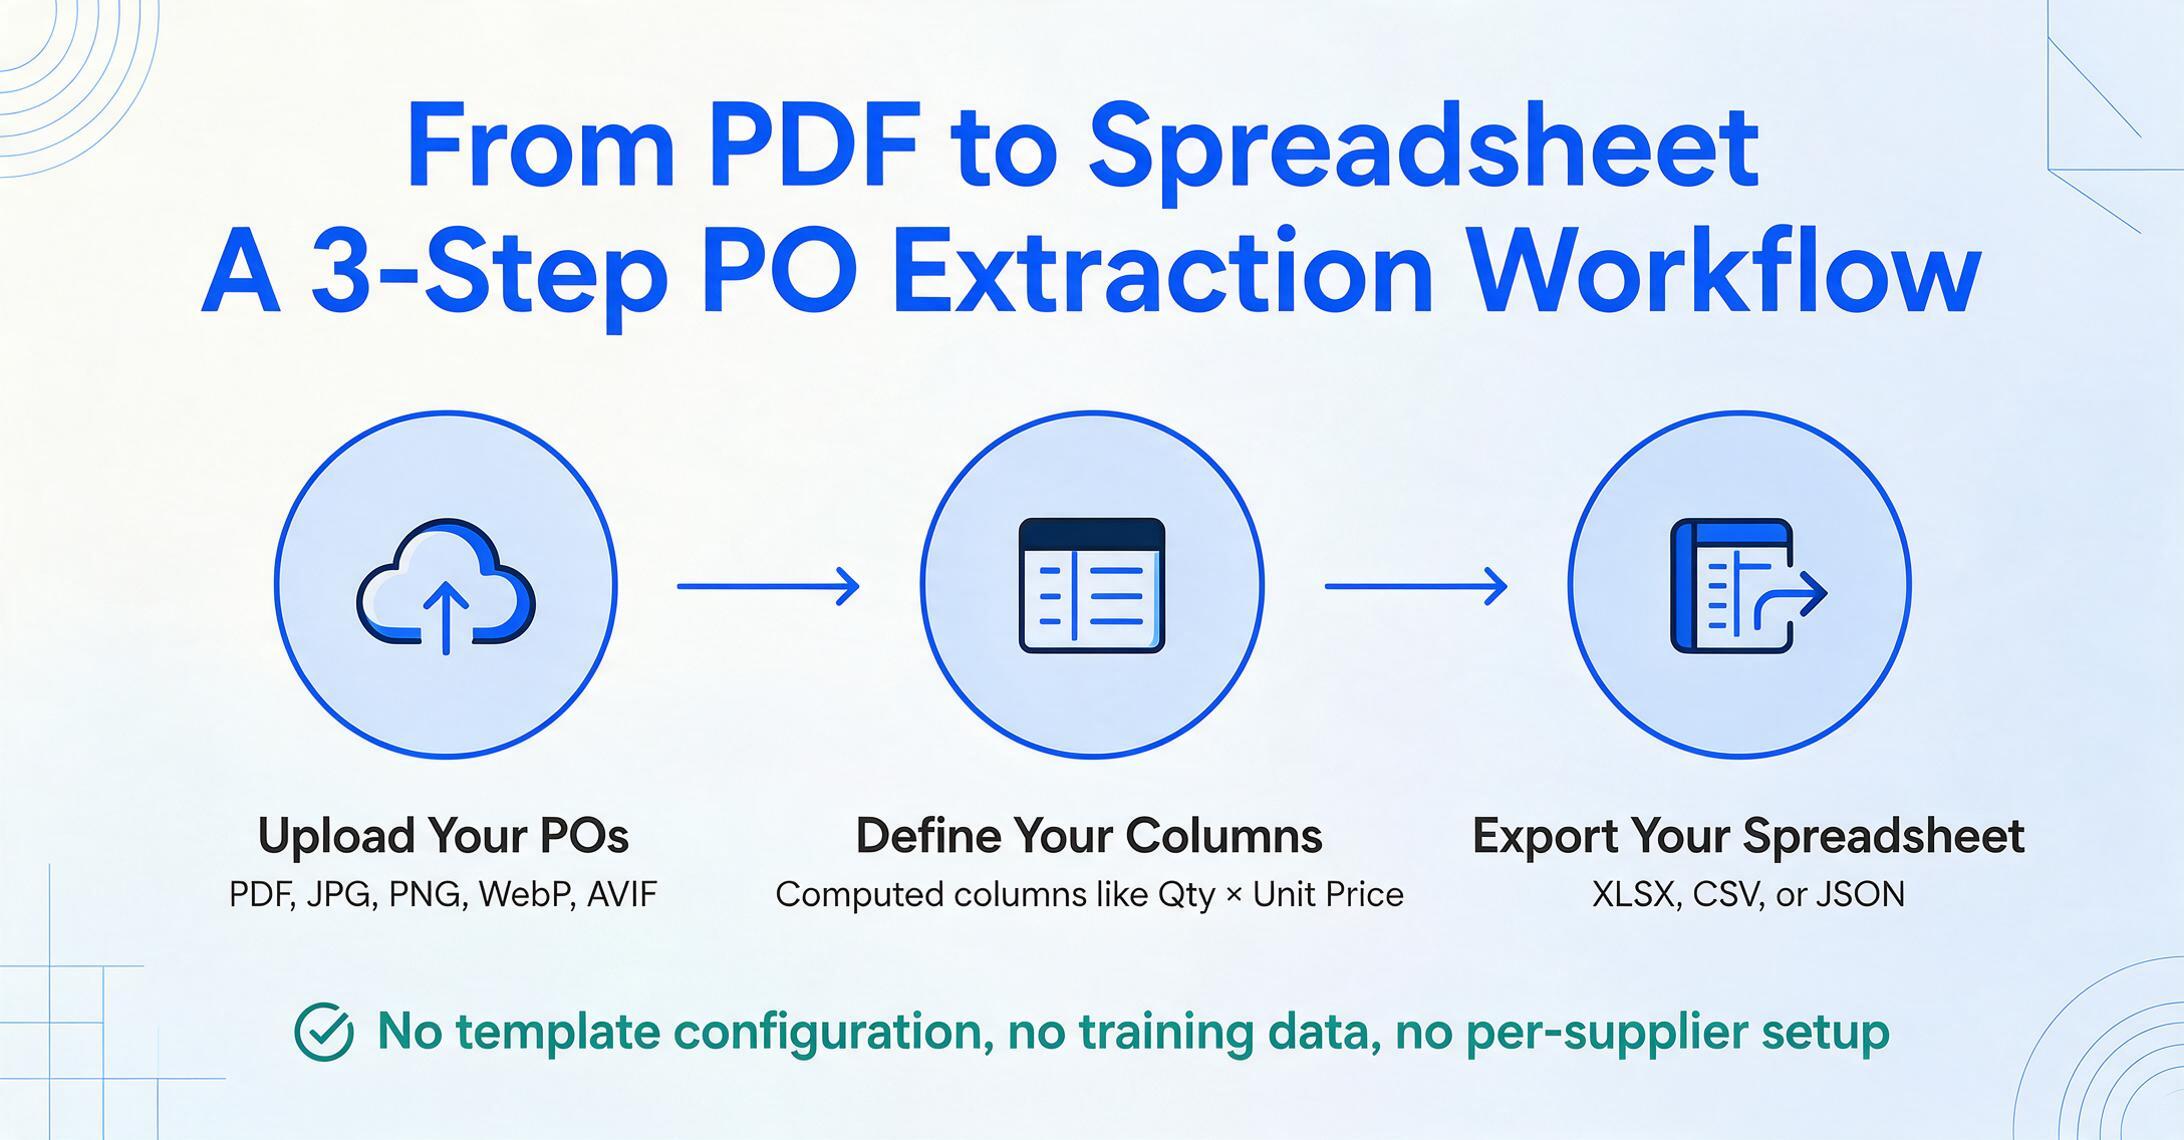
Precio Extendido (Cantidad × Precio Unitario), para que la IA realice cálculos durante la extracción en lugar de después.La capacidad de procesamiento por lotes es lo que distingue esto de la extracción de uno en uno. En lugar de abrir cada PDF individualmente, subes todo a la vez (20, 50 o 100 OC) y la herramienta procesa todo el lote, fusionando los resultados en una sola hoja de cálculo. Para un equipo de adquisiciones que recibe archivos adjuntos de OC diarios de docenas de compradores, esto elimina el cuello de botella basado en colas donde cada documento espera su turno para la entrada manual.
La herramienta también maneja procesamiento por lotes con consistencia entre documentos: si la OC n.º 1034 del Comprador A tiene 8 artículos de línea y la OC n.º 1035 del Comprador B tiene 3, ambos aparecen como filas en la misma tabla de salida. Los campos vacíos, donde una OC carece de un punto de datos particular, se dejan en blanco en lugar de llenarse con valores de error. La salida está lista para análisis sin manipulación adicional de la hoja de cálculo.
Lo que esto no reemplaza — y lo que sí hace
Es importante ser claro sobre dónde encaja la extracción semántica de datos de PO en el panorama tecnológico de adquisiciones — y dónde no.
Lo que hace: Extrae datos estructurados de documentos de órdenes de compra en cualquier formato, de cualquier proveedor, y los exporta como una hoja de cálculo de Excel. Si el problema que estás resolviendo es "tengo un PDF de una PO y necesito sus líneas en una tabla", esta es la herramienta para ese problema. Maneja la diversidad de formatos entre proveedores, procesa documentos por lotes y produce una salida combinada única — todo sin plantillas ni entrenamiento.
Lo que no hace: No enruta órdenes de compra a través de un flujo de aprobación. No aplica controles presupuestarios ni políticas de gasto. No compara facturas de proveedores con POs (conciliación a tres bandas — consulta nuestra guía para crear un pipeline de conciliación en Google Sheets si también necesitas esa capa). No registra transacciones en el libro mayor de un ERP. Y no gestiona la relación con el proveedor — incorporación, evaluación de desempeño, seguimiento de contratos.
Estas son funciones de plataformas completas de procure-to-pay como Coupa, SAP Ariba y Procurify — suites de nivel empresarial que orquestan todo el ciclo de compras. Si tu organización necesita ese alcance de gobernanza de adquisiciones, una plataforma P2P es la herramienta adecuada. Pero para el paso específico de sacar datos de PO de un PDF y llevarlos a una hoja de cálculo, una herramienta de extracción semántica llena el vacío que esas plataformas dejan abierto — a menudo a una fracción del costo y la complejidad de implementación.
En la práctica, ambas pueden trabajar juntas. Un mayorista podría usar extracción semántica para convertir POs entrantes de clientes en datos estructurados y luego alimentar esos datos a su sistema de gestión de pedidos o software contable. La herramienta de extracción maneja el problema de diversidad de formatos; los sistemas posteriores manejan cumplimiento, facturación y reportes. Ninguna herramienta necesita hacer el trabajo de la otra.
Preguntas Frecuentes
¿Funciona la extracción con IA en órdenes de compra escritas a mano?
Sí. Los modelos de IA de visión están entrenados con diversas muestras de escritura manuscrita y pueden extraer datos de órdenes de compra escritas a mano, incluidas las que combinan texto impreso y cursiva. La precisión en escritura manuscrita es menor que en texto impreso — especialmente en caligrafía descuidada o muy estilizada — pero la tecnología maneja bien documentos legibles escritos a mano. Para proveedores pequeños o órdenes de compra generadas en campo que lleguen como formularios manuscritos, extracción de órdenes de compra manuscritas es uno de los casos de uso más sólidos para IA semántica frente a OCR con plantillas, ya que los sistemas de plantillas suelen fallar por completo con la escritura a mano.
¿Puedo procesar órdenes de compra de varios proveedores en un solo lote?
Sí. Ese es el caso de uso principal. Sube todas tus órdenes de compra — sin importar la cantidad de proveedores, diferencias de formato o número de páginas — en un solo lote. Define tus columnas objetivo una vez, y la IA extrae datos de cada documento en una hoja de cálculo unificada. Los artículos de línea de cada documento se convierten en filas vinculadas al nombre del lote y al archivo de origen, para que puedas rastrear cada fila hasta su orden de compra original.
¿Necesito un sistema ERP para usar la extracción automatizada de órdenes de compra?
No. La herramienta de extracción genera archivos estándar de Excel (XLSX), CSV o JSON que se pueden abrir en cualquier aplicación de hoja de cálculo o importar a cualquier sistema que acepte datos estructurados. No necesitas un ERP, una plataforma de contabilidad ni configuración de integración. Si puedes abrir un archivo de Excel, puedes usar el resultado. Para usuarios que sí quieran integración directa, los datos extraídos se pueden importar a QuickBooks, Xero, NetSuite o cualquier sistema mediante importación de archivos estándar.
¿Cómo maneja la IA los artículos de línea que abarcan varias páginas?
La IA trata el documento completo como una sola fuente de datos, no como páginas aisladas. Los artículos de línea que continúan a través de saltos de página — con o sin encabezados de columna repetidos en las páginas de continuación — se capturan como un conjunto continuo. La herramienta reconoce encabezados repetidos en páginas posteriores y no los extrae como artículos de línea separados. Para órdenes de compra con más de 50 artículos de línea repartidos en 6 páginas, el resultado es una tabla limpia en lugar de una extracción fragmentada por página que requiera unión manual.
¿Cuánto cuesta en comparación con otras herramientas de automatización de PO?
ImageToTable.ai tiene precios desde $9/mes (Básico) por 50 créditos de IA, $19/mes (Pro) por 200 créditos y $59/mes (Max) por 600 créditos, procesando cada crédito una página. En contraste, las plataformas empresariales P2P como Coupa y SAP Ariba usan precios personalizados que suelen comenzar en el rango de cinco cifras medias anuales. Herramientas P2P de mercado medio como Precoro comienzan en aproximadamente $499/mes. Para organizaciones cuya necesidad principal es la extracción de datos de PO en lugar de una gestión completa de aprovisionamiento a pago, esto representa una diferencia de coste significativa. No hay tarifa de implementación, ni requisito de formación, ni compromiso mínimo. Si quieres comparar esto específicamente con otras herramientas centradas en extracción (no suites P2P completas), consulta nuestra comparación lado a lado de 7 herramientas de extracción de órdenes de compra. ¿Listo para probar tus propios PO? Usa la herramienta de extracción de datos de órdenes de compra directamente.
¿Cuál es la tasa de precisión en la extracción de datos de órdenes de compra?
Los datos de tablas impresas en PDFs digitales o escaneados claramente alcanzan hasta un 99% de precisión. Los factores que reducen la precisión incluyen escaneos de baja resolución, ruido de fondo intenso, inclinación extrema y líneas de artículos densamente empaquetadas con tamaños de fuente pequeños. La herramienta es más fiable en PDFs digitales, escaneos de alta calidad y capturas de pantalla. Para campos críticos como cantidades y precios unitarios — donde los errores tienen consecuencias financieras — es buena práctica verificar las primeras extracciones contra el documento fuente, especialmente al usar un nuevo formato de proveedor por primera vez. Este no es un proceso completamente automático, pero reemplaza 8–12 minutos de escritura manual por PO con segundos de extracción de IA más una rápida verificación.