Automatize o Lançamento de Dados de Pedidos de Compra
De Qualquer PDF, Sem Modelos
Pesquise por "automação de pedidos de compra" e os resultados pintam um quadro de problema resolvido: suítes de procurement com roteamento de aprovação, controle de orçamento, correspondência tripla e sincronização com ERP. Mas para quem abre o PDF do pedido de compra de um fornecedor toda manhã e digita manualmente uma dúzia de itens em uma planilha, esse quadro descreve um prédio diferente. A etapa que a maioria dos fornecedores de automação de PO cobre — o que acontece depois que os dados já estão no sistema — não é o gargalo. O gargalo é colocar os dados no sistema em primeiro lugar.
Esta página aborda a economia da automação de PO e a abordagem de extração com IA semântica. Para o fluxo de trabalho em lote passo a passo — transformando 50 PDFs de fornecedores em uma planilha Excel — veja nosso guia de extração em lote de PO para Excel. Para a referência completa campo a campo, veja o guia completo de extração de dados de pedidos de compra.
Um usuário do Reddit em r/smallbusiness descreveu o problema com precisão: "Preciso automatizar a extração de dados de PDFs de Pedidos/PO — alguma ferramenta ou método?" Sem menção a ERP. Sem menção a fluxos de aprovação. Apenas PDFs e dados que precisam sair deles para algo utilizável. Em r/automation, outro usuário perguntou se alguém já havia "automatizado com sucesso a extração de dados de faturas ou pedidos de compra sem depender de modelos" — a questão do modelo surgindo porque a variação de formato entre fornecedores é o obstáculo real, não o ato de digitar em si.
Principais Conclusões
- Ferramentas de automação de PO como Coupa e SAP Ariba automatizam tudo depois que os dados estão no sistema — no momento em que o PDF de um fornecedor chega à sua caixa de entrada, você está por conta própria.
- Extração por modelo — vendida como a solução para POs de múltiplos fornecedores — não reduz o trabalho manual, apenas o renomeia: 30 modelos custam de 5 a 7,5 horas para configurar e quebram silenciosamente no momento em que qualquer fornecedor muda o formato.
- A IA semântica encontra "Quantidade" entendendo o que é uma quantidade, não memorizando onde o Fornecedor #17 a coloca na página — defina suas colunas uma vez, e o PO de cada fornecedor, em qualquer layout, cai na mesma planilha.
O que a Automação de PO Realmente Resolve — e o que Ela Não Resolve
Para entender por que a entrada manual de dados persiste, é útil ver o que a narrativa padrão de automação de PO cobre. O fluxo típico de procure-to-pay (P2P) que ferramentas como Coupa, SAP Ariba e Precoro automatizam se parece com isto:
Cada uma dessas etapas acontece depois que os dados da ordem de compra já estão no sistema. Para uma empresa que emite POs para fornecedores, essa é a sequência correta — o PO se origina internamente, então a entrada de dados no sistema é o ponto de partida, não um problema a ser resolvido.
Mas essa descrição ignora uma categoria inteira de fluxos de trabalho de compras: empresas que recebem ordens de compra de seus clientes como PDFs, e-mails ou anexos digitalizados. Um fabricante, distribuidor ou prestador de serviços que recebe POs de 30 compradores diferentes — cada um em seu próprio formato — enfrenta um problema de entrada de dados que a automação de P2P a montante nunca foi projetada para resolver. Seus dados de PO não se originam em seu sistema. Eles chegam de fora, no formato de outra pessoa, e alguém precisa digitá-los.
Insight principal: As ferramentas de automação de PO automatizam o fluxo de trabalho em torno dos dados. Elas não automatizam a entrada de dados que chegam de fora da organização em formato PDF não estruturado. Essa lacuna — mover dados de itens de linha de um PO de fornecedor para uma planilha ou sistema de gerenciamento de pedidos — é onde a maioria das horas manuais é realmente gasta.
O Custo Real da Entrada Manual de Dados de PO, Detalhado
Compras é uma das funções empresariais mais avaliadas por benchmarks, e os números quantificam o que qualquer pessoa que já digitou ordens de compra sabe: a entrada manual é cara, lenta e propensa a erros. Dados de Benchmarking Open Standards da APQC — a fonte independente mais citada na medição de desempenho de compras — mostram que as organizações gastam entre $14 e $54 para processar uma única ordem de compra, com uma mediana de $42. No 75º percentil, isso é quase quatro vezes mais do que os melhores desempenhos no 25º percentil.
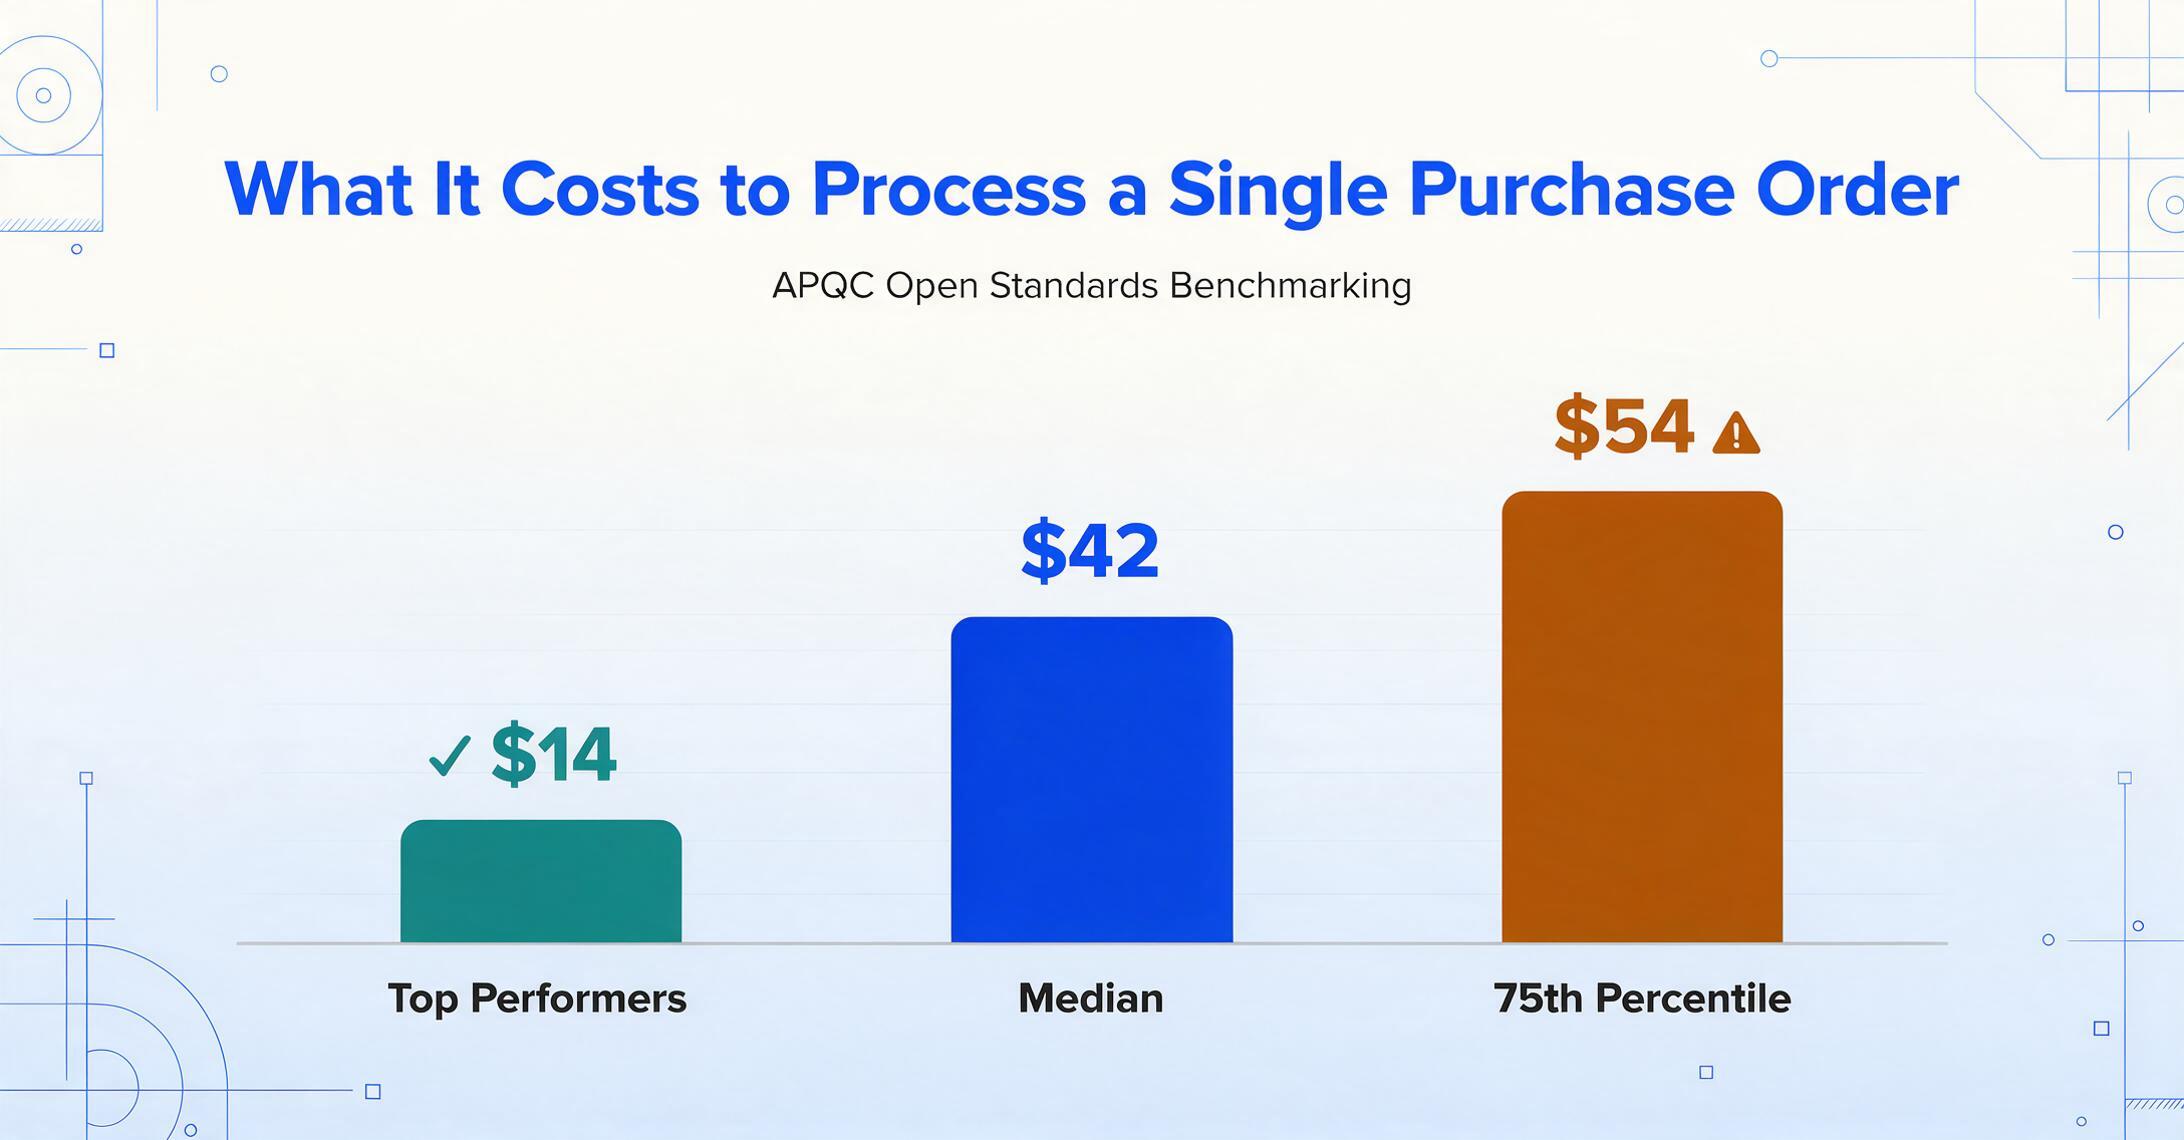
Para uma empresa que processa 1.000 POs por mês, a diferença entre $14 e $54 não representa apenas eficiência — representa $40.000 por mês em variação de custo operacional para o mesmo conjunto de transações. Em um ano, isso é quase meio milhão de dólares que separa o quartil inferior do superior.
A APQC também descobriu que as organizações de compras com melhor desempenho emitem ordens de compra em cerca de um dia, enquanto as de menor desempenho levam mais que o dobro do tempo. Organizações com processos de compras automatizados concluem o ciclo de PO em 24 horas, versus 35 horas para aquelas que dependem de sistemas manuais ou planilhas.
O que impulsiona o custo é o tempo, e o que impulsiona o tempo é a entrada de dados. O processamento manual de PO significa que alguém lê cada campo — número do PO, nome do fornecedor, códigos de item, quantidades, preços unitários, datas de entrega — e os digita em um sistema. Um PO padrão com 10–20 itens de linha leva 8 a 12 minutos de tempo de manuseio manual, de acordo com benchmarks de processamento de faturas. A maior parte desse tempo é consumida pela entrada e verificação de dados dos itens de linha, não pela tomada de decisões estratégicas.
| Métrica | Processamento Manual de PO | Extração Assistida por IA |
|---|---|---|
| Custo por PO | $14–$54 (mediana APQC: $42) | ~$0,07–$0,29 por documento |
| Tempo por PO | 8–12 min (PO padrão com itens de linha) | ~10 segundos por página |
| Taxa de erro | 1–3% por campo digitado | ~1% no total, de forma consistente |
| Tempo de ciclo (solicitação → PO emitido) | 35+ horas (manual) | Abaixo de 24 horas (dados disponíveis imediatamente) |
| Escalabilidade | Linear: mais POs = mais horas de equipe | Custo marginal quase zero por PO adicional |
Erros se acumulam e aumentam o custo de tempo. Um operador de entrada de dados com 97% de precisão em 1.000 documentos comete cerca de 30 erros por mês — cada um exigindo um ciclo separado de investigação e correção. Em compras, onde uma única quantidade ou preço unitário errado pode gerar pedidos em excesso, atrasos de envio ou disputas de fatura, esses 30 erros não são apenas uma tarefa de limpeza. São uma fonte de atrito operacional que se multiplica por toda a cadeia de suprimentos.
Por que modelos funcionam contra você quando cada fornecedor envia um formato diferente
A extração baseada em modelos é a abordagem mais comum para automatizar pedidos de compra. O fluxo é intuitivo: envie um pedido de amostra do Fornecedor A, desenhe caixas ao redor de cada campo, rotule-os e salve. Pedidos futuros do Fornecedor A com o mesmo layout são processados automaticamente. É simples — até você ter 30 fornecedores.
Cada novo fornecedor exige um novo modelo. Uma sessão de configuração de modelo — desenhar caixas delimitadoras, rotular campos, verificar a extração — normalmente leva de 10 a 15 minutos. Com 30 fornecedores, são de 5 a 7,5 horas de criação inicial de modelos. Quando o Fornecedor nº 31 entra, alguém interrompe o que está fazendo e cria o modelo nº 31. E se qualquer um dos seus 30 fornecedores existentes mudar o formato do pedido — uma atualização de ERP, uma fusão, um novo sistema de compras — o modelo quebra silenciosamente, e você descobre quando os dados desaparecem.
O problema subjacente é que modelos codificam posição, não significado. Um modelo diz "o número do pedido está nas coordenadas X,Y da página". Quando o layout muda — e vai mudar, entre fornecedores e ao longo do tempo — o modelo se torna um passivo. Você não eliminou o trabalho manual; mudou sua natureza de "digitar dados" para "manter uma biblioteca crescente de regras baseadas em posição". O desafio da diversidade de formatos de pedidos — especialmente tabelas de itens que variam na ordem das colunas, quebras de página e repetição de cabeçalhos — é estrutural, não incidental. Modelos resolvem para um mundo estático que não existe em compras.
Se sua equipe atualmente usa importações de modelos de ERP — ou está debatendo se deve continuar criando-os — nossa comparação entre importações de modelos de ERP e extração por IA detalha as cinco dimensões onde a lacuna aumenta, a diferença real do EDI 850 e a abordagem híbrida que a maioria das equipes realmente precisa.
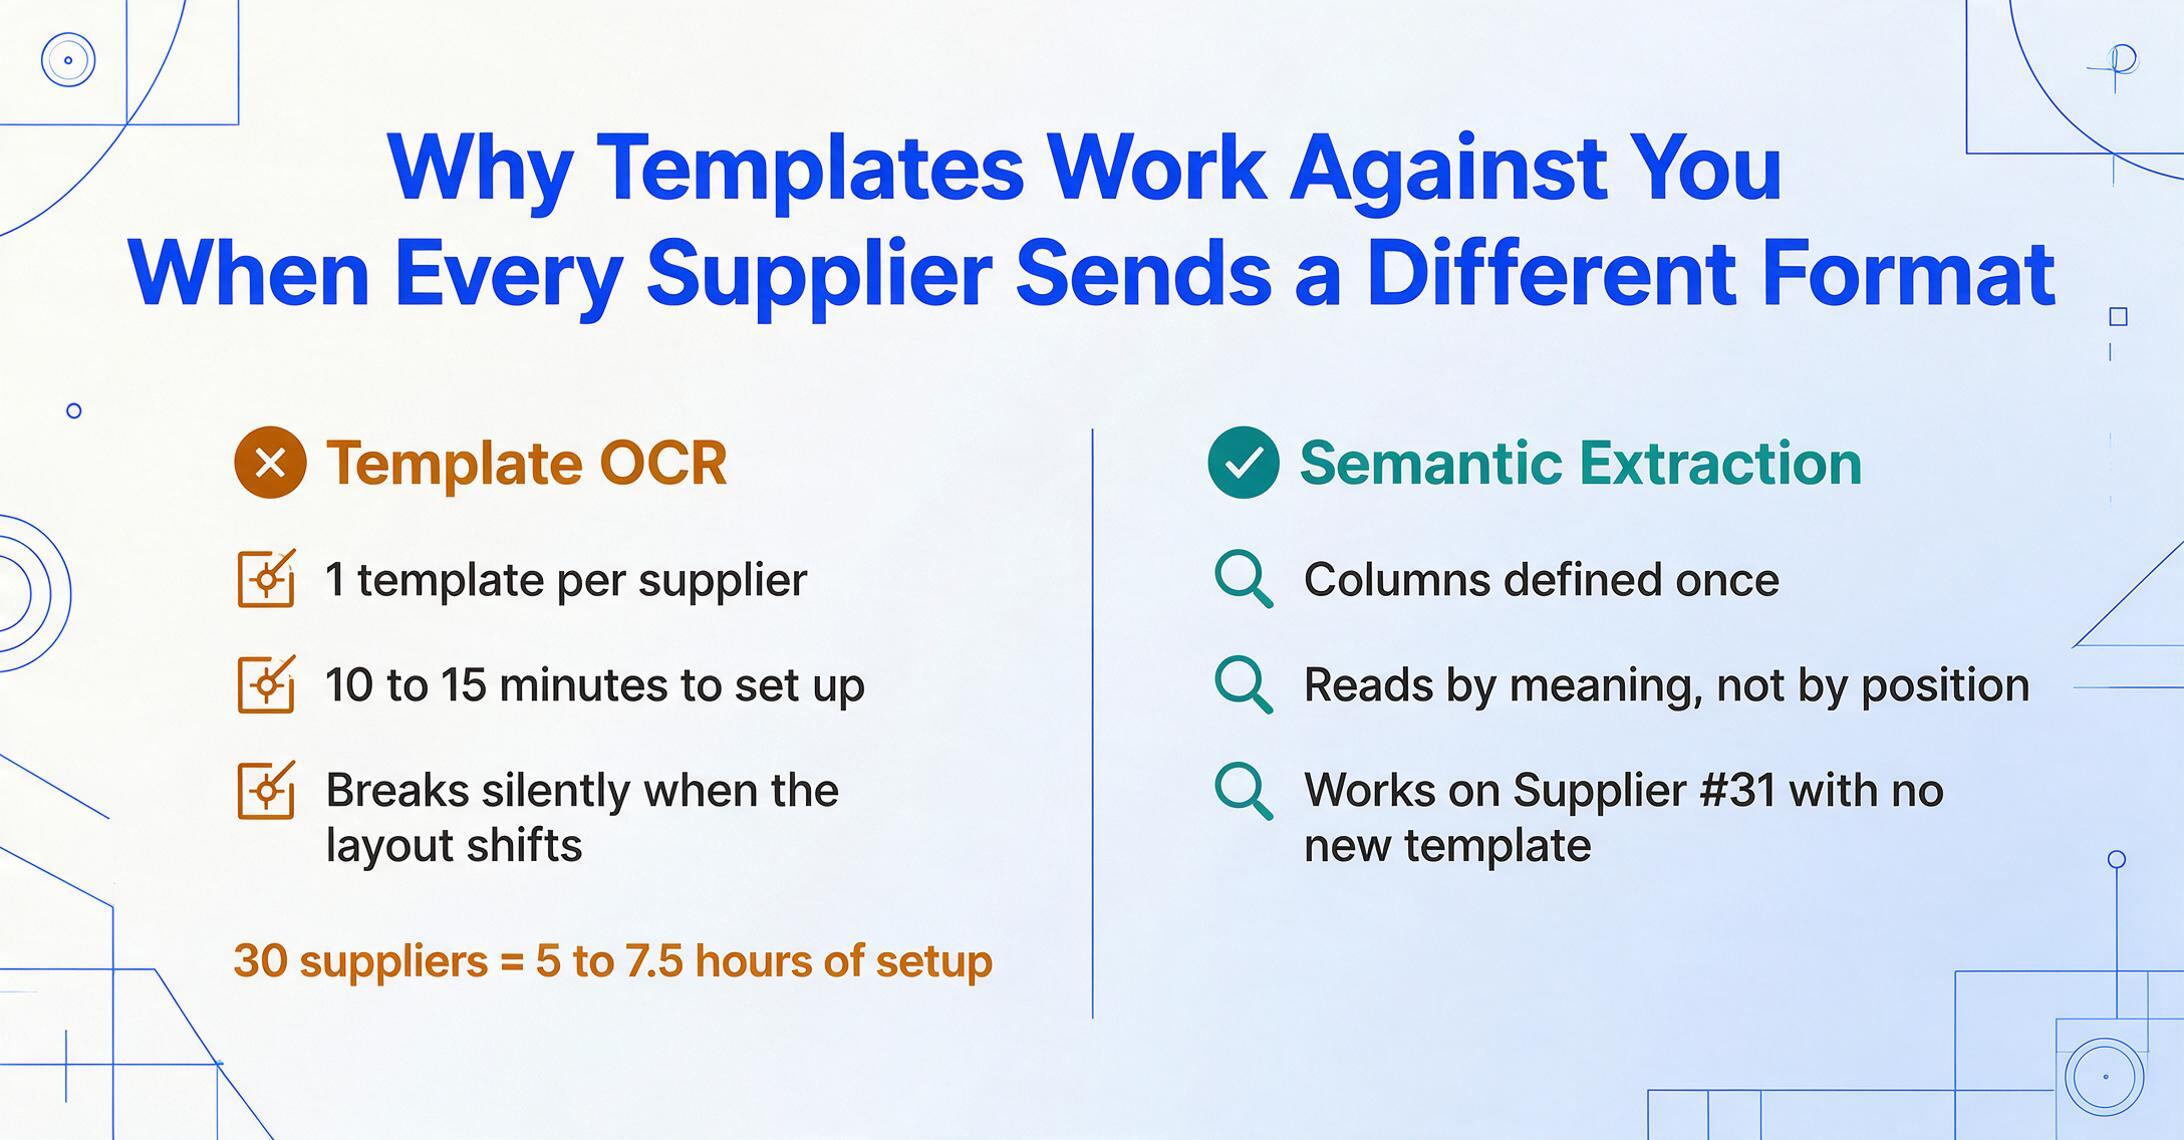
Extração Semântica: Encontrando "Quantidade" pelo Significado, Não pela Posição
Aqui está uma abordagem fundamentalmente diferente: em vez de dizer à ferramenta onde cada campo está na página, você diz a ela o que cada campo significa. Isso é chamado de Extração de Colunas Personalizadas — você define as colunas desejadas na saída (ex.: "Nº do Pedido", "Nome do Fornecedor", "Código do Item", "Descrição", "Quantidade", "Preço Unitário", "Total da Linha"), e a IA localiza cada valor compreendendo seu papel semântico no documento. Não importa se o Fornecedor A coloca o número do pedido no canto superior direito e o Fornecedor B no canto superior esquerdo, ou se um fornecedor lista quantidades antes das descrições e outro faz o inverso. A IA encontra o valor entendendo o que um número de pedido de compra é, não onde ele está.
Essa é a diferença entre OCR por template e visão por IA. O OCR por template corresponde a padrões por posição. Um grande modelo de visão — a mesma classe de IA que entende imagens, lê manuscritos e raciocina sobre layouts de documentos — lê um pedido de compra como uma pessoa faria: entendendo contexto e significado. Ele reconhece que um número impresso perto de "PO #" ou "Número do Pedido de Compra" é o número do pedido. Ele entende que uma coluna de preços sob um título que diz "Preço Unitário" contém preços unitários, mesmo que essa coluna apareça na posição 4 no pedido de um fornecedor e na posição 2 no de outro.
Os nomes das colunas que você insere se tornam os cabeçalhos da sua planilha de saída. Se você digitar "PO # / Fornecedor / SKU / Descrição / Qtd / Preço Unitário / Total", essas serão exatamente as colunas no seu Excel exportado — para todos os fornecedores, em todos os formatos. Sem criação de template por fornecedor. Sem retreinamento quando os formatos mudam. A IA se adapta ao documento; você não adapta o documento à ferramenta.
Os arquivos são processados com segurança e não são armazenados.
Do PDF para Planilha: Um Fluxo de Trabalho de Extração de PO em 3 Etapas
O fluxo de trabalho completo para extrair dados de ordens de compra para uma planilha leva três etapas. Não há configuração de modelo, dados de treinamento ou configuração por fornecedor — basta enviar, nomear suas colunas e exportar.
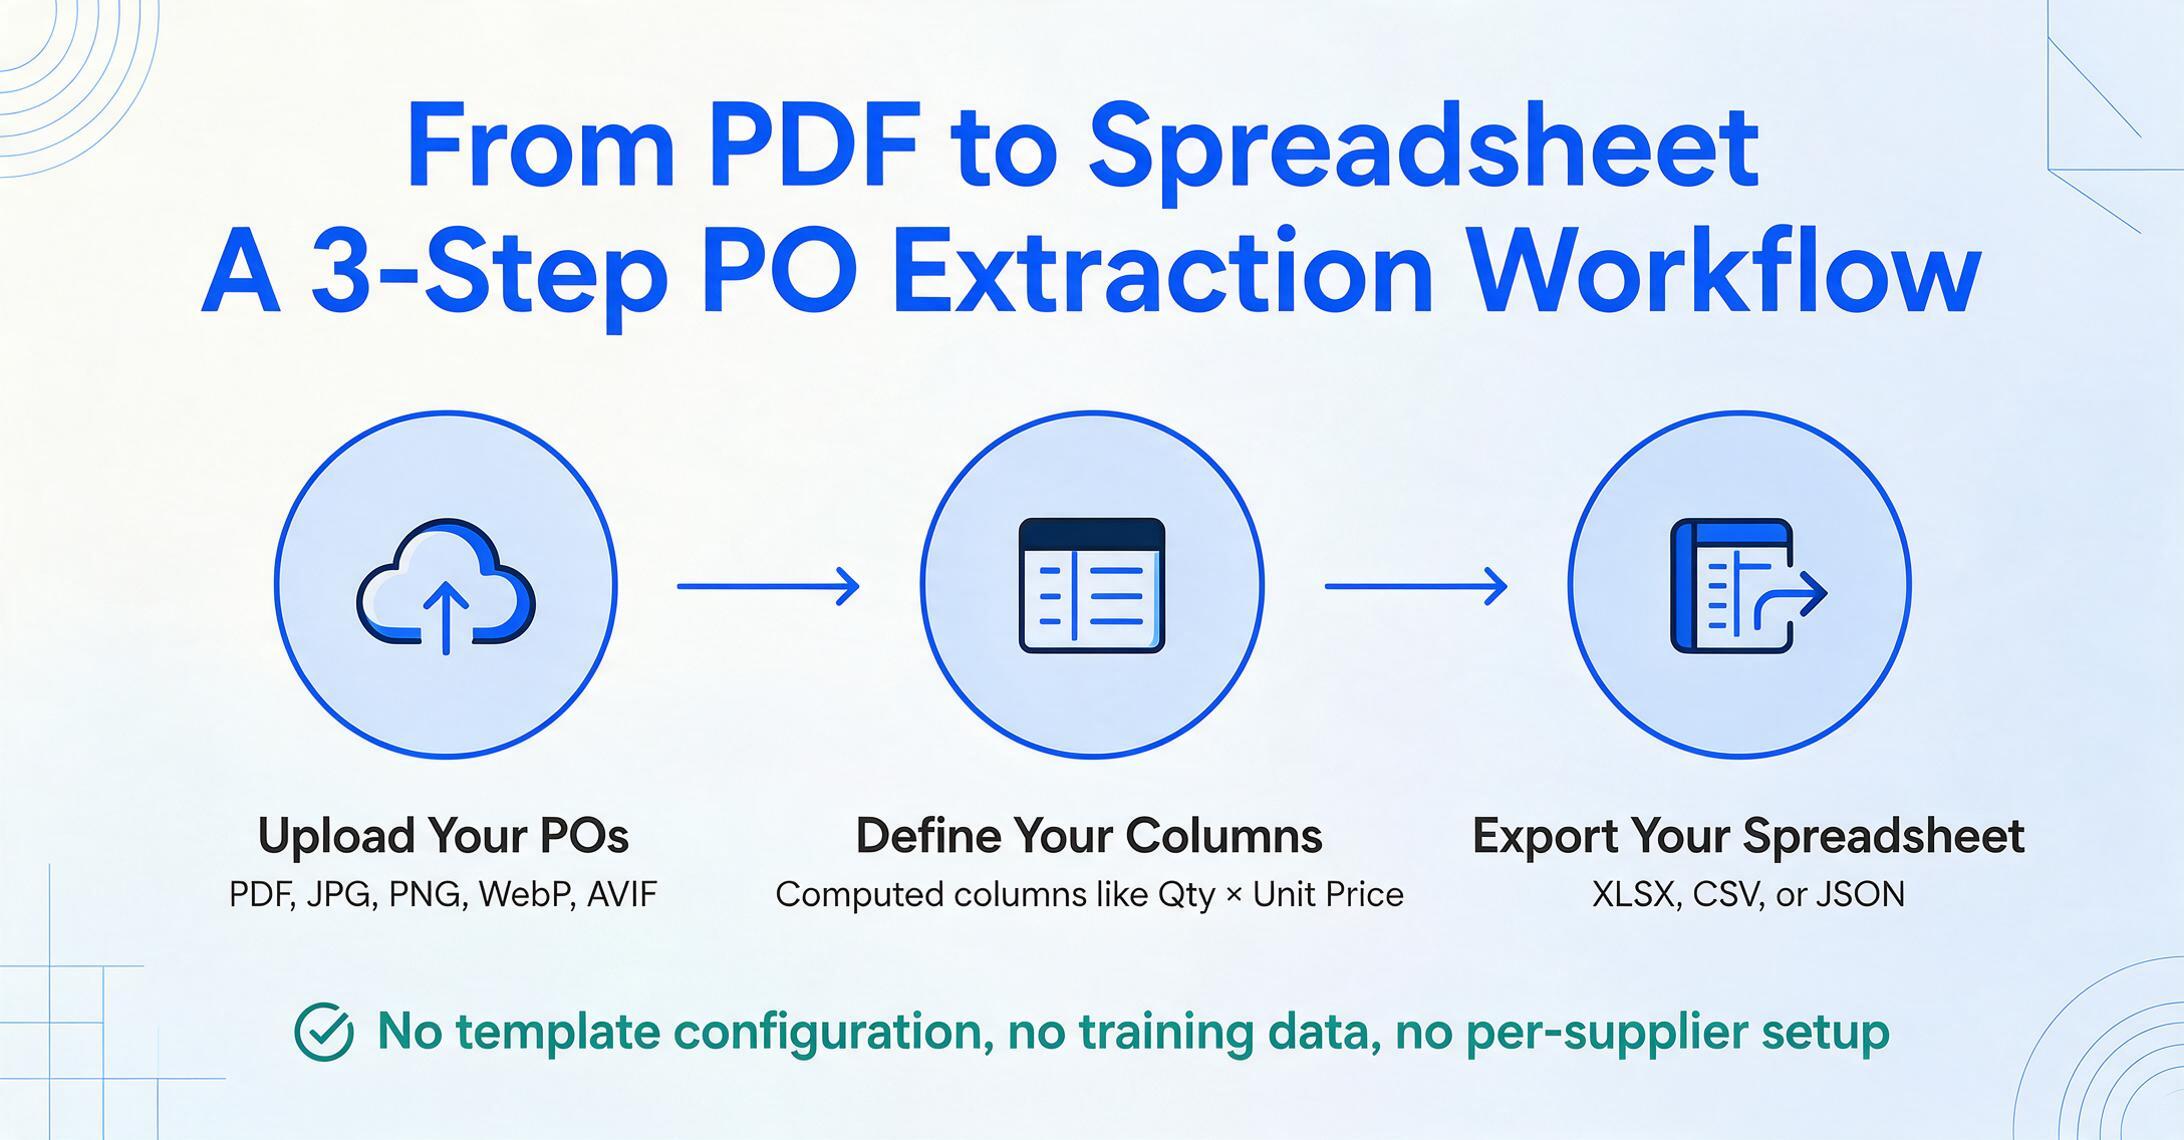
Preço Estendido (Qtd × Preço Unitário) — para que a IA realize cálculos durante a extração, em vez de depois.A capacidade de processamento em lote é o que distingue isso da extração individual. Em vez de abrir cada PDF separadamente, você envia tudo de uma vez — 20, 50 ou 100 POs — e a ferramenta processa o lote inteiro, mesclando os resultados em uma única planilha. Para uma equipe de compras que recebe anexos de PO diariamente de dezenas de compradores, isso elimina o gargalo baseado em fila, onde cada documento espera sua vez para entrada manual.
A ferramenta também lida com processamento em lote com consistência entre documentos: se o PO #1034 do Comprador A lista 8 itens e o PO #1035 do Comprador B lista 3, ambos aparecem como linhas na mesma tabela de saída. Campos vazios — onde um PO não possui um determinado dado — são deixados em branco, em vez de preenchidos com valores de erro. A saída está pronta para análise sem manipulação adicional da planilha.
O Que Isso Não Substitui — e O Que Faz
É importante deixar claro onde a extração semântica de dados de PO se encaixa no cenário de tecnologia de compras — e onde não se encaixa.
O que faz: Extrai dados estruturados de documentos de pedido de compra em qualquer formato, de qualquer fornecedor, e os exporta como uma planilha Excel. Se o problema que você está resolvendo é "tenho um PDF de um PO e preciso dos itens de linha em uma tabela", esta é a ferramenta para esse problema. Ela lida com a diversidade de formatos entre fornecedores, processa documentos em lote e produz uma única saída mesclada — tudo sem modelos ou treinamento.
O que não faz: Não roteia pedidos de compra por um fluxo de aprovação. Não aplica controles de orçamento ou políticas de gastos. Não concilia faturas de fornecedores com POs (conciliação de três vias — veja nosso guia para criar um pipeline de conciliação no Google Sheets se você precisar dessa camada também). Não lança transações no razão geral de um ERP. E não gerencia o relacionamento com o fornecedor — integração, avaliação de desempenho, acompanhamento de contratos.
Essas são funções de plataformas completas de procure-to-pay, como Coupa, SAP Ariba e Procurify — suítes de nível empresarial que orquestram todo o ciclo de vida de compras. Se sua organização precisa desse escopo de governança de compras, uma plataforma P2P é a ferramenta certa. Mas para a etapa específica de extrair dados de PO de um PDF e colocá-los em uma planilha, uma ferramenta de extração semântica preenche a lacuna que essas plataformas deixam em aberto — muitas vezes por uma fração do custo e da complexidade de implementação.
Na prática, os dois podem trabalhar juntos. Um atacadista pode usar extração semântica para converter POs recebidos de clientes em dados estruturados e, em seguida, alimentar esses dados em seu sistema de gerenciamento de pedidos ou software de contabilidade. A ferramenta de extração resolve o problema da diversidade de formatos; os sistemas downstream cuidam de atendimento, faturamento e relatórios. Nenhuma ferramenta precisa fazer o trabalho da outra.
Perguntas Frequentes
A extração por IA funciona em pedidos de compra manuscritos?
Sim. Os modelos de Visão por IA são treinados com diversas amostras de caligrafia e conseguem extrair dados de POs manuscritos, incluindo aqueles com letra de forma e cursiva misturadas. A precisão em manuscritos é menor do que em texto impresso — especialmente para caligrafia ilegível ou muito estilizada — mas a tecnologia lida bem com documentos manuscritos legíveis. Para fornecedores pequenos ou POs gerados em campo que podem chegar como formulários manuscritos, extração de PO manuscrito é um dos casos de uso mais fortes para IA semântica em vez de OCR por modelo, já que sistemas baseados em modelo geralmente falham completamente em manuscritos.
Posso processar POs de vários fornecedores em um único lote?
Sim. Esse é o principal caso de uso. Envie todos os seus POs — independentemente do número de fornecedores, diferenças de formato ou quantidade de páginas — em um único lote. Defina suas colunas de destino uma vez, e a IA extrai dados de cada documento para uma planilha unificada. Os itens de linha de cada documento se tornam linhas vinculadas ao nome do lote e ao arquivo de origem, para que você possa rastrear cada linha até o PO de origem.
Preciso de um sistema ERP para usar a extração automatizada de PO?
Não. A ferramenta de extração gera arquivos padrão Excel (XLSX), CSV ou JSON que podem ser abertos em qualquer aplicativo de planilha ou importados para qualquer sistema que aceite dados estruturados. Você não precisa de ERP, plataforma contábil ou configuração de integração. Se você sabe abrir um arquivo Excel, consegue usar a saída. Para usuários que desejam integração direta, os dados extraídos podem ser importados para QuickBooks, Xero, NetSuite ou qualquer sistema via importação de arquivo padrão.
Como a IA lida com itens de linha que se estendem por várias páginas?
A IA trata o documento inteiro como uma única fonte de dados, não como páginas isoladas. Itens de linha que continuam entre quebras de página — com ou sem cabeçalhos de coluna repetidos nas páginas seguintes — são capturados como um conjunto contínuo. A ferramenta reconhece cabeçalhos repetidos em páginas subsequentes e não os extrai como itens de linha separados. Para POs com mais de 50 itens de linha distribuídos em 6 páginas, a saída é uma tabela limpa em vez de uma extração fragmentada por página que exigiria junção manual.
Quanto custa em comparação a outras ferramentas de automação de PO?
O preço do ImageToTable.ai começa em $9/mês (Basic) para 50 créditos de IA, $19/mês (Pro) para 200 créditos e $59/mês (Max) para 600 créditos — com cada crédito processando uma página. Em contraste, plataformas P2P empresariais como Coupa e SAP Ariba usam preços personalizados que normalmente começam na faixa de cinco dígitos médios anualmente. Ferramentas P2P de médio porte como Precoro começam em aproximadamente $499/mês. Para organizações cuja necessidade principal é a extração de dados de PO, em vez de governança completa de procure-to-pay, isso representa uma diferença de custo significativa. Não há taxa de implementação, nenhum requisito de treinamento e nenhum compromisso mínimo. Se você quiser comparar isso especificamente com outras ferramentas focadas em extração (não suítes P2P completas), veja nossa comparação lado a lado de 7 ferramentas de extração de pedidos de compra. Pronto para testar seus próprios POs? Use a ferramenta de extração de dados de pedidos de compra diretamente.
Qual é a taxa de precisão na extração de dados de pedidos de compra?
Dados de tabelas impressas em PDFs digitalizados claramente ou digitais alcançam até 99% de precisão. Fatores que reduzem a precisão incluem digitalizações de baixa resolução, ruído de fundo intenso, inclinação extrema e itens de linha densamente compactados com fontes pequenas. A ferramenta é mais confiável em PDFs digitais, digitalizações de alta qualidade e capturas de tela. Para campos críticos como quantidades e preços unitários — onde erros têm consequências financeiras — é uma boa prática verificar as primeiras extrações em relação ao documento de origem, especialmente ao usar um novo formato de fornecedor pela primeira vez. Este não é um processo totalmente sem intervenção, mas substitui 8–12 minutos de digitação manual por PO por segundos de extração de IA mais uma rápida verificação.