Le tri des documents fiscaux source
est l'endroit où votre saison se joue
L'étape la plus coûteuse dans un cabinet fiscal à volume élevé n'est pas la lecture des documents. C'est de décider lesquels la déclaration nécessite réellement. Un W-2 est essentiel pour presque toutes les déclarations individuelles. Douze mois de relevés bancaires, un dossier de reçus ou la déclaration de l'année dernière agrafée au dos ne le sont pas. Quelqu'un doit faire ce choix page par page avant qu'un préparateur puisse commencer, et dans la plupart des cabinets, cette personne dispose d'une feuille de référence imprimée et d'une pile qui ne cesse de grandir.
Points clés à retenir
- De 80 à 90 pour cent des clients d'un cabinet remettaient encore des documents papier, même s'il utilisait déjà SmartVault avec Lacerte.
- Les logiciels documentaires automatisent la dénomination et l'acheminement, mais ne peuvent toujours pas dire si une page appartient à cette déclaration ; les cabinets continuent donc de rédiger des feuilles de référence pour celui qui trie la pile.
- ImageToTable.ai remplit une colonne de classification en lisant chaque document selon son sens, de sorte qu'un préparateur filtre Needs Preparer Attention sur Yes au lieu de lire toute la pile.
Les heures se perdent à l'étape du triage, pas à la numérisation
Le coût d'une saison chargée en papier se situe dans le tri et le jugement, pas dans la numérisation ou la saisie. Un client arrive avec un dossier, la réception le fait passer au scanner, puis la déclaration attend qu'un humain décide de ce qui compte. Appelons cette étape le triage des documents fiscaux. C'est la partie du processus que la plupart des cabinets ne nomment jamais, ne budgètent jamais et ne mesurent jamais, ce qui explique précisément pourquoi elle continue d'absorber des heures qui étaient censées être consacrées à la préparation.
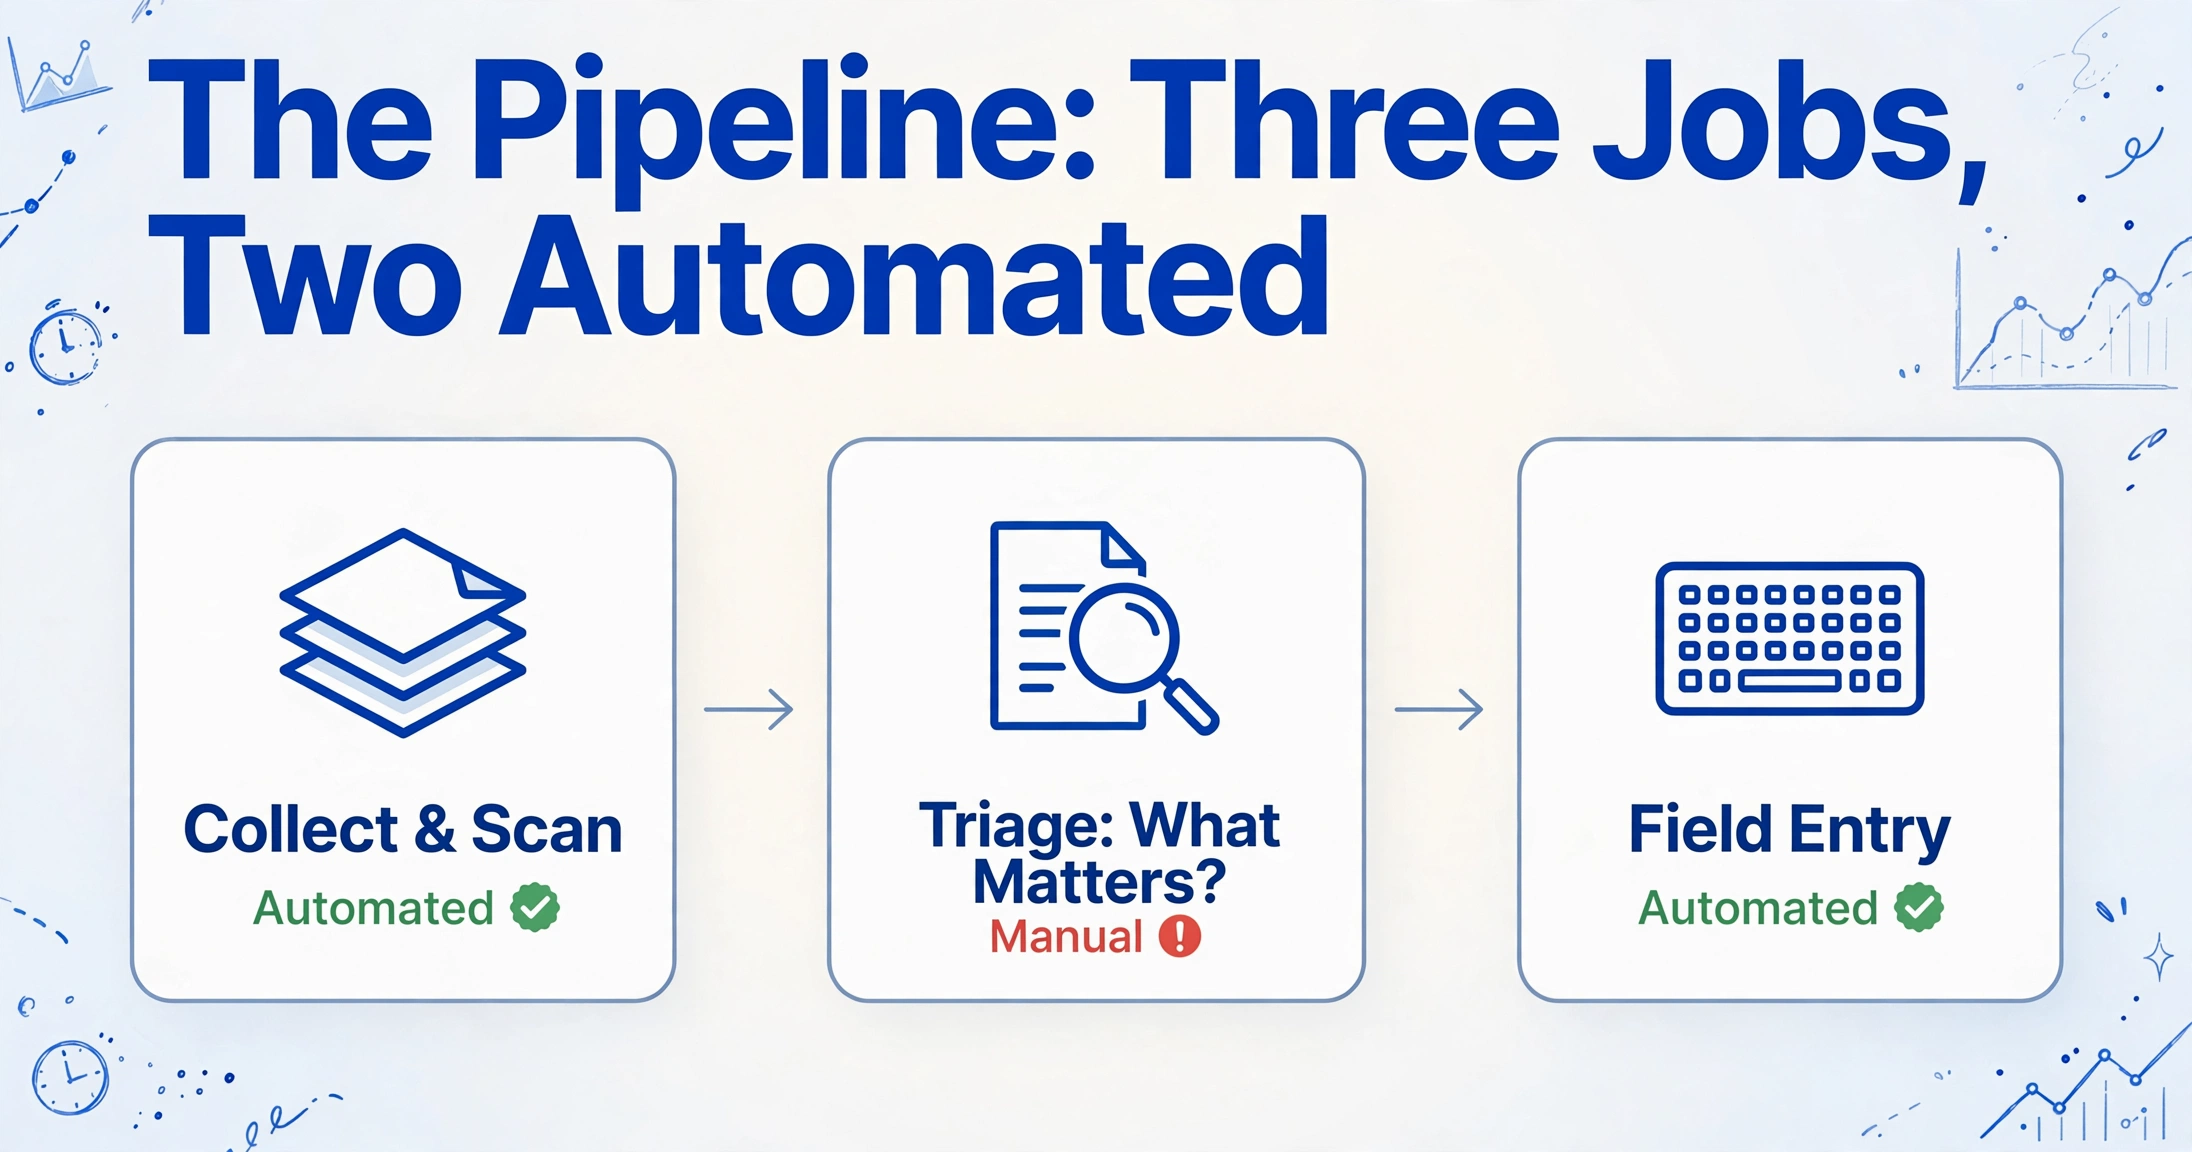
Le processus lui-même est simple à schématiser. Les documents arrivent à la réception ou sur un portail. Ils sont numérisés. Quelqu'un les trie par type de formulaire et les classe dans le dossier du client. Un préparateur ouvre la déclaration et travaille à partir de la pile. L'IRS a sa propre raison de vouloir cette pile ordonnée : la Publication 583 exige que les pièces justificatives soient conservées de manière ordonnée et, pour les systèmes électroniques, qu'elles restent indexées et récupérables sous une forme lisible pendant toute la durée de conservation (IRS Publication 583). Le tri n'est pas une tâche subalterne inventée par un chef de bureau. C'est la forme que le dossier doit prendre.
Ce que le schéma cache, c'est que le processus comporte trois tâches distinctes, et que la plupart des cabinets n'en automatisent que deux. La collecte et la numérisation ont leur outil. La saisie des champs a son outil. La tâche intermédiaire — décider quelles pages la déclaration nécessite et lesquelles ne sont là que pour le dossier — repose encore sur la mémoire d'une personne et une aide-mémoire d'une page. La plupart des conseils d'organisation des documents de préparation fiscale s'arrêtent au dossier et ne nomment jamais cette étape. Notre propre article sur l'extraction de formulaires papier par lot précise qu'il résout ce qui se passe après l'arrivée des formulaires, pas le tri qui se fait avant. C'est cet écart qui fait l'objet du présent article.
La saisonnalité rend cet écart coûteux. La National Association of Tax Professionals rapporte que 65 pour cent du revenu brut de ses cabinets membres est gagné pendant la saison des impôts (NATP), et l'IRS a traité 271,4 millions de déclarations fédérales et de documents complémentaires au cours de l'exercice 2025 (IRS Data Book 2025). Chaque heure consacrée au triage est une heure retirée aux semaines qui paient l'année.
Le triage répond à une question par page : ce document doit-il être traité ?
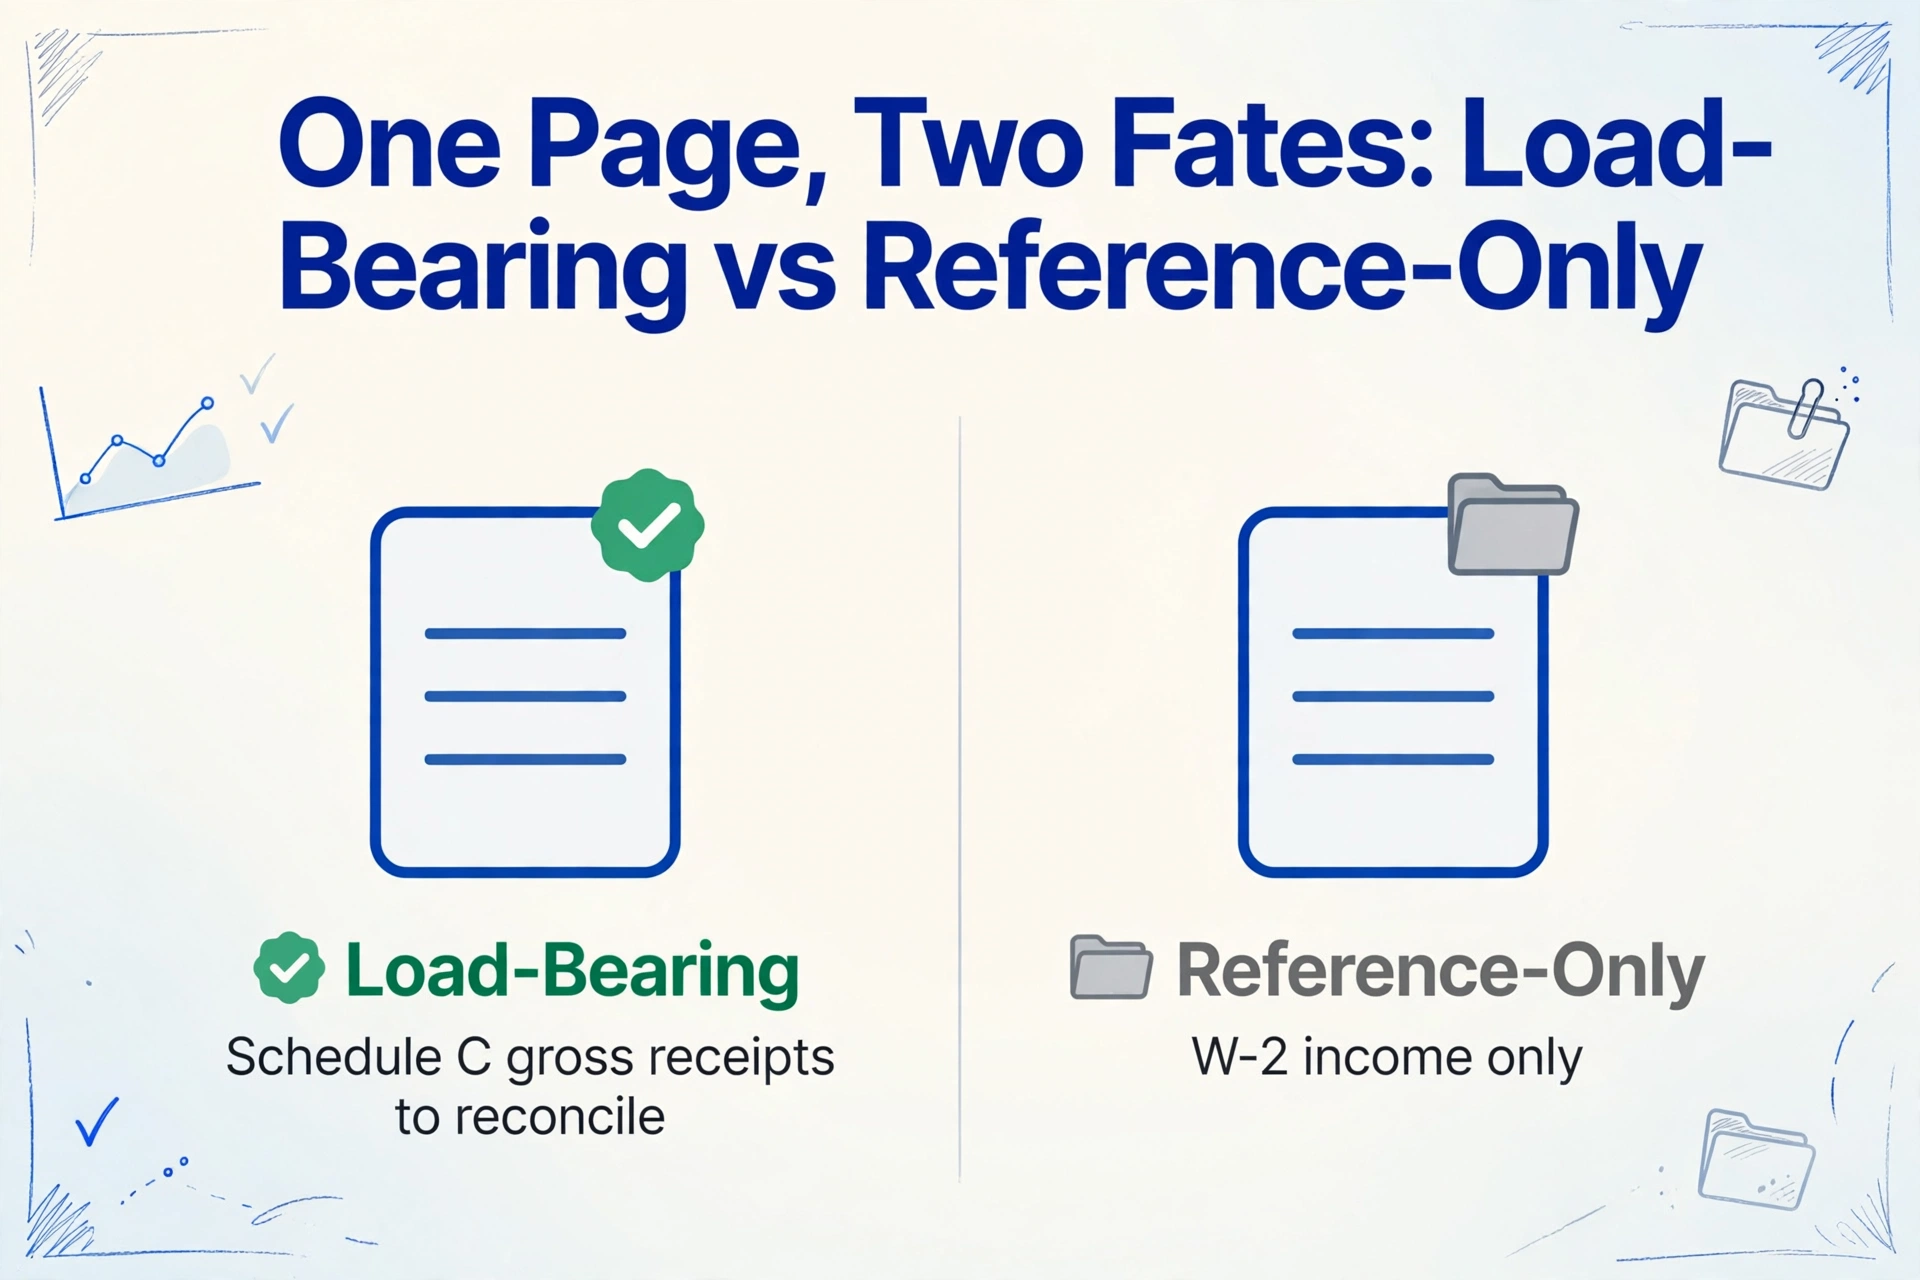
Le triage est une décision de pertinence, pas une décision de classement, et il varie selon la déclaration. La question à laquelle répond vraiment un trieur est de savoir si une page donnée contient un chiffre ou un fait dont cette déclaration précise dépend. Si c'est le cas, la page est essentielle et un préparateur doit la voir. Si ce n'est pas le cas, elle est de référence seule et elle appartient au dossier sans jamais passer sur le bureau.
La distinction n'est pas une propriété du type de document. C'est une propriété de la déclaration. Une année de relevés bancaires est essentielle pour un client dont les revenus bruts de l'annexe C doivent être rapprochés, et de référence seule pour un client dont le seul revenu est un W-2. Une pile de reçus est essentielle lorsqu'elle justifie une déduction et de référence seule lorsque le client opte pour la déduction forfaitaire. La propre définition de l'IRS concernant les documents justificatifs couvre le même mélange, en citant les tickets de caisse, les factures payées, les factures, les reçus, les bordereaux de dépôt et les chèques annulés, et en demandant qu'ils soient organisés par année et par type de revenu ou de dépense (guide de tenue de registres de l'IRS). Un relevé bancaire n'est pas du superflu. C'est exactement le document qu'un outil d'extraction est conçu pour lire lorsque la déclaration en a besoin, et exactement la page à mettre de côté lorsque la déclaration n'en a pas besoin.
Trois modes de défaillance se répètent dans chaque cabinet où le papier domine. Le premier est la mauvaise année, lorsqu'un relevé de l'année précédente ou un ancien K-1 se glisse dans le dossier de l'année en cours. Le deuxième est la mauvaise entité, lorsqu'un K-1 ou un relevé bancaire appartient à une société sœur que le client possède également. Le troisième est le mauvais client tout court, ce qui arrive lorsque deux personnes numérisent deux dossiers au même bureau dans la même heure. Aucun de ces cas n'est un problème de numérisation. Ce sont tous des problèmes de triage, et un trieur qui va vite laissera passer chacun d'eux.
Pour les pages qui nécessitent un traitement, l'extraction en elle-même est bien maîtrisée. Un relevé qui doit être rapproché ligne par ligne est un cas résolu une fois qu'il est dans un tableur, ce qui correspond au flux de travail derrière l'extraction des données de relevés bancaires dans un tableau. La partie non résolue se situe en amont : savoir quels relevés du dossier sont ceux qui nécessitent ce traitement.
Pourquoi la pile s'effondre à cause du volume, pas de la complexité
Un seul dossier est facile à trier. Le problème commence lorsque le même jugement doit être rendu mille fois par saison par la personne disponible au bureau. Les professionnels de la fiscalité décrivent l'étape de tri comme le goulot d'étranglement en langage clair. Un praticien a demandé à la communauté r/taxpros comment d'autres cabinets gèrent « la numérisation, le téléversement et le tri des documents avant de les envoyer au préparateur », et l'a nommé directement : « C'est actuellement notre goulot d'étranglement » (r/taxpros). La réponse la plus votée décrivait la solution de contournement que la plupart des cabinets adoptent : une réceptionniste qui « trie les documents en fonction du flux de déclarations » à l'aide d'une aide-mémoire que le cabinet avait dû rédiger pour elle.
Le papier n'a pas non plus disparu. Dans un fil r/taxpros de 2025 sur la transition numérique, un cabinet utilisant déjà SmartVault avec Lacerte estimait que 80 à 90 % de ses clients remettaient encore du papier (r/taxpros). C'est un cabinet qui dispose déjà d'une gestion documentaire, ce qui révèle la véritable nature du problème : les logiciels que les cabinets achètent automatisent la dénomination et l'acheminement, mais le jugement reste manuel.
Regardez ce que font réellement les outils établis. SmartVault's SmartRouting lit les métadonnées d'UltraTax CS, Drake ou CCH Axcess et classe les déclarations et les documents sources dans les bons dossiers, répartis par type de copie. Canopy renomme les fichiers et les classe par type ou par émetteur à l'aide de règles globales. SurePrep's 1040SCAN et GruntWorx vont plus loin et intègrent les champs W-2, 1099 et K-1 dans la déclaration. Chacun de ces outils résout une étape réelle. Aucun d'eux ne répond à la question de savoir si une page appartient à cette déclaration. Cette question est laissée au trieur, c'est pourquoi les cabinets qui ont acheté le logiciel rédigent encore des aide-mémoires.
Transformez le triage en colonne, puis filtrez au lieu de lire
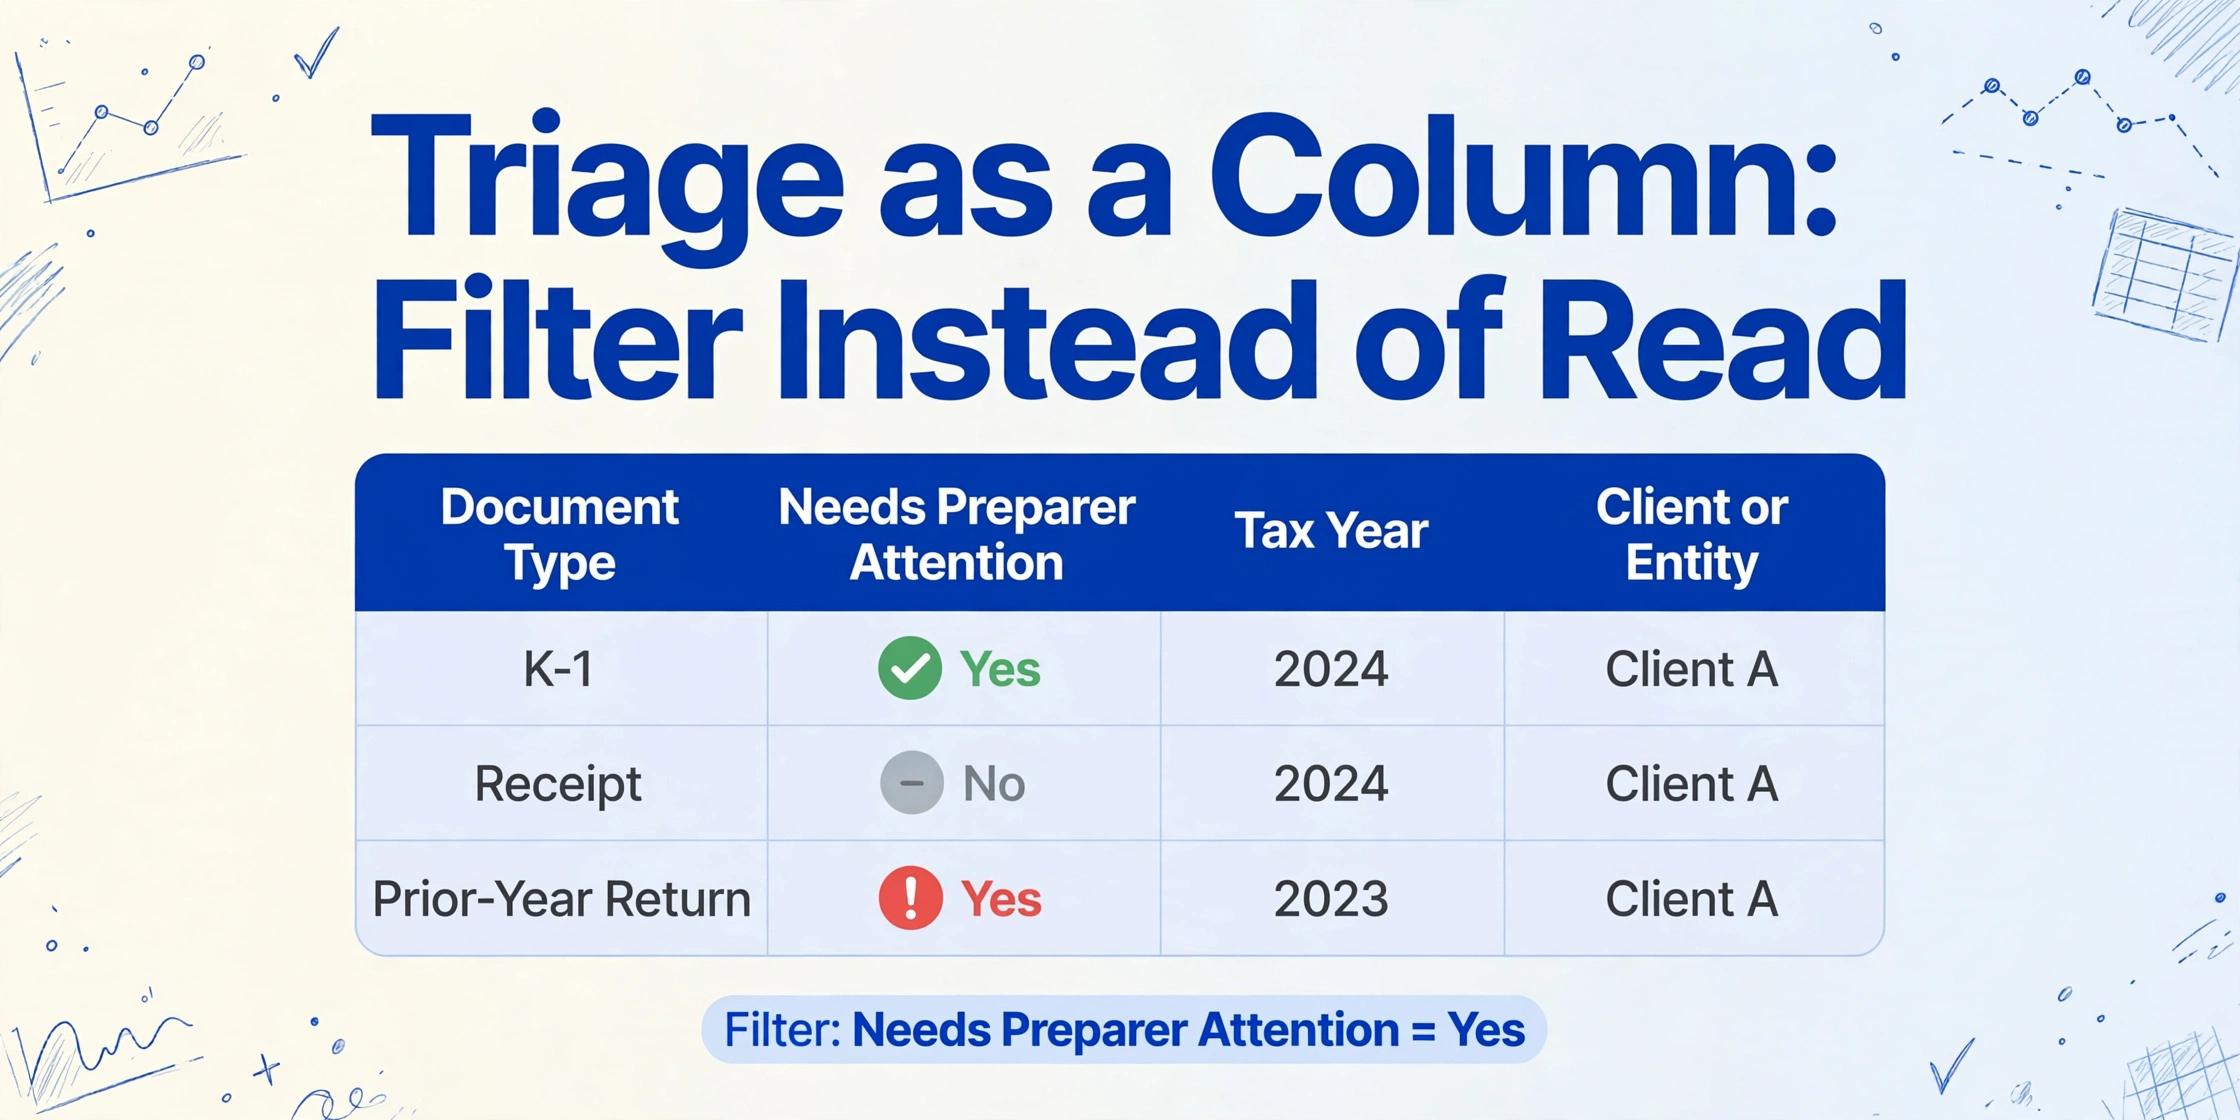
Pour sortir le triage de la tête d'une personne, il faut en faire une colonne dans le résultat d'extraction. C'est une approche différente du tri des documents sources par dossiers que proposent les outils de gestion documentaire. Au lieu de décider où va un fichier, vous décidez ce qu'est un fichier, vous inscrivez cette décision dans une colonne de feuille de calcul, et le préparateur peut filtrer dessus. Le jugement est toujours rendu, mais il l'est une seule fois, sous une forme que toute l'équipe peut voir et réutiliser.
Le mécanisme qui rend cela possible est Custom Column Extraction. Vous saisissez les noms de colonnes souhaités, et l'IA lit chaque document et remplit la valeur correspondant à chaque nom par le sens, et non par la position sur la page. C'est ce qui permet à un même ensemble de noms de colonnes de fonctionner sur un W-2, un relevé bancaire et un reçu photographié dans le même envoi, sans modèle par format. Le mode pertinent ici est la colonne inférée : une colonne dont la valeur n'est imprimée nulle part sur le document mais peut être déterminée à partir de son contenu. Un reçu n'a pas de champ « Document Type », mais l'IA peut le lire et décider qu'il s'agit d'un reçu.
Appliqué au triage, cela produit un petit ensemble de colonnes qui transforment un dossier client en file de travail :
Document Type (options: W-2, 1099-INT, 1099-DIV, 1099-B, K-1, Bank Statement, Receipt, Mortgage Interest 1098, Prior-Year Return, Other)Needs Preparer Attention (options: Yes, No)Tax YearClient or Entity
La première colonne classe chaque page. La deuxième est la décision de triage elle-même, exprimée sous forme de règle que l'IA applique de manière cohérente : un K-1 ou un 1099 avec retenue à la source donne « Yes », un relevé bancaire de douze mois sur une déclaration qui ne se rapproche pas donne « No ». Les deux dernières colonnes détectent les erreurs de mauvaise année et de mauvaise entité avant qu'elles n'atteignent un préparateur, car un document étiqueté 2024 ou attribué à une autre entité ressort dès que la feuille est triée.
Comme le traitement est effectué par lots en priorité, tout le dossier client est envoyé d'un coup et revient sous forme d'une seule feuille de calcul avec une ligne par document. Le triage cesse alors d'être une tâche de lecture pour devenir un filtre. Le préparateur ouvre la feuille, filtre Needs Preparer Attention sur Yes et traite les lignes importantes. Les pages de référence seule sont toujours dans la feuille, toujours classées, toujours traçables jusqu'au fichier, ce qui répond à l'exigence de tenue de registres ordonnés de l'IRS. C'est aussi là que la classification porte ses fruits pour les cabinets qui opèrent à l'échelle décrite dans notre guide de l'extraction documentaire pour les cabinets comptables et dans l'argumentaire en faveur d'un logiciel d'extraction dans les cabinets comptables.
La configuration complète : scan, classification, extraction
La configuration repose sur quatre décisions, et une fois prises, le triage s'exécute automatiquement sur chaque lot. Aucune ne concerne les paramètres de scan ou les conventions de dossiers. Elles portent toutes sur le contenu que doit contenir la feuille de calcul de sortie.
Téléversez tout le dossier client en un seul lot
Déposez ensemble les scans, les PDF et les photos prises au téléphone. Le traitement par lots les fusionne en un seul tableau, de sorte que le dossier du client cesse d'être un tas de documents pour devenir un ensemble de lignes. Vous n'avez pas besoin de pré-trier par type de formulaire. C'est la tâche que prend en charge l'étape suivante.
Définissez les colonnes de classification
Ajoutez Document Type avec sa liste d'options, Needs Preparer Attention, Tax Year et Client or Entity. La liste d'options est l'élément clé. C'est là que vit le vocabulaire du triage, afin que chaque personne qui trie applique les mêmes catégories au lieu d'en inventer de nouvelles.
Ajoutez les colonnes de valeurs dont la déclaration a réellement besoin
C'est ici que vous extrayez les chiffres des pages essentielles : nom du payeur, numéro de compte, période de relevé, total, retenues. Un relevé bancaire de référence seule laisse simplement ces cellules vides, et une cellule vide est un signal clair plutôt qu'une supposition. Pour la moitié du dossier consacrée aux reçus, une colonne comme Category (options: Meals, Travel, Office, Other) classe chacun d'eux lors du même passage.
Filtrez, vérifiez et transmettez
Le préparateur filtre Needs Preparer Attention sur Yes et ne traite que ces lignes. La feuille complète, y compris les pages de référence seule, reste la trace conservée. Lorsque le même client revient l'année suivante, l'ensemble de colonnes est enregistré comme préréglage et réutilisé sans avoir à le reconstruire.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Le même schéma couvre la période chargée en reçus, où le volume est élevé et la valeur par document faible, ce qui correspond au scénario décrit dans le regroupement des reçus professionnels dans un seul tableau fiscal. Lorsque la saison entière ne contient que des W-2 et des 1099, le pipeline rejoint la même idée, traitée dans le pipeline W-2 et 1099 de la saison fiscale.
Ce que ce pipeline ne peut toujours pas décider à votre place
Trois éléments restent de la responsabilité du cabinet, quelle que soit la configuration des colonnes. Le premier est le jugement professionnel lui-même. La colonne de classification oriente l'attention du préparateur vers les pages importantes, mais déterminer si une déduction s'applique ou si une dépense professionnelle est ordinaire et nécessaire reste une décision humaine. Le pipeline réduit le champ de recherche. Il ne prend pas la décision.
Le deuxième est la qualité des documents saisis. Une photo de téléphone floue ou un scan à moins de 150 dpi peut estomper la différence entre une date de 2024 et une de 2025, ce qui est précisément le champ dont dépend le triage. Une page contenant deux formulaires sans rapport, comme un K-1 imprimé au-dessus d'un bulletin de versement, peut dérouter un modèle conçu pour une ligne par document. Ces pages nécessitent encore un œil humain, et le flux de travail honnête consiste à les traiter comme des candidats à la revue plutôt que comme des lignes définitives.
Le troisième est la destination des données. Ce pipeline exporte en Excel, CSV ou JSON. Il ne transmet pas directement dans Drake, UltraTax CS, Lacerte ou CCH Axcess, et il ne remplace pas le système de gestion documentaire qui gère la conservation et le contrôle d'accès. Les règles de tenue de registres de l'IRS dans la Publication 583 et les pratiques de protection des données des contribuables restent de la responsabilité du cabinet, pas de l'outil. Une couche basée sur un tableur permet d'inspecter les données extraites avant qu'elles n'atteignent une déclaration, et cette étape d'inspection est délibérée.
Questions fréquemment posées
L'IA peut-elle distinguer un relevé bancaire d'un reçu sans que je trie d'abord ?
Oui. Vous définissez une colonne Document Type avec les catégories que vous utilisez, et l'IA lit le contenu de chaque document pour décider laquelle s'applique. Elle ne se fie ni au nom du fichier ni au dossier dans lequel il est arrivé, donc un scan sans nom est tout de même classé.
Que devient un document que l'IA classe comme Other ?
Il apparaît toujours comme une ligne avec sa classification et sa source, donc rien ne disparaît. Une ligne Other est une invitation à examiner le document, soit parce qu'il est réellement inhabituel, soit parce que votre liste d'options a besoin d'une catégorie supplémentaire. La valeur de la colonne est que les documents inhabituels remontent à la surface au lieu de se fondre dans la pile.
Est-ce que cela remplace SmartVault, Canopy ou SurePrep ?
Non. Ces outils gèrent le stockage, l'acheminement et, dans certains cas, l'insertion de champs dans les logiciels fiscaux. Ce pipeline gère la classification et l'extraction, et produit un tableur. Un cabinet peut conserver son système de gestion documentaire pour l'archivage et utiliser la couche de classification par-dessus le flux de réception qu'il possède déjà.
Puis-je traiter tout le dossier d'un client en un seul lot ?
Oui. Le traitement par lots est le mode par défaut. Tout le dossier entre d'un coup et ressort sous forme d'un tableau unique avec une ligne par document, ce qui rend le filtre de triage pratique. Traiter un document à la fois reconstruirait la même pile ailleurs.
Comment la colonne de triage gère-t-elle un document pertinent pour un client mais pas pour un autre ?
La règle derrière Needs Preparer Attention vous appartient, vous pouvez donc l'exprimer en fonction de la déclaration plutôt que du document. Un cabinet qui rapproche chaque relevé bancaire les marquerait tous Yes. Un cabinet qui ne rapproche que les clients Schedule C peut lier l'indicateur à la présence de revenus d'entreprise sur la même déclaration. La colonne suit votre règle de manière cohérente sur tout le lot.
L'importation se fait-elle directement dans Drake, UltraTax CS, Lacerte ou CCH Axcess ?
Pas directement. La sortie est en Excel, CSV ou JSON, et votre cabinet l'intègre dans le logiciel fiscal via le chemin d'importation que vous utilisez déjà. Le fait de garder cette étape explicite garantit que les données extraites sont vérifiées avant d'atteindre la déclaration.
La pile n'est pas le problème. C'est le jugement implicite sur les pages qui comptent qui l'est, et dès que ce jugement devient une colonne, un préparateur cesse de trier et commence à préparer.
Testez-le sur un vrai dossier client de votre dernière saison, y compris les pages de référence seule que vous mettriez normalement de côté, et voyez si la colonne de classification place les documents essentiels en haut de la file d'attente. Essayez avec vos propres documents.