税務ソース文書のトリアージ
が繁忙期を左右する
高件数の税務業務において最もコストがかかるのは、書類を読むことではありません。申告書に本当に必要な書類を判断することです。W-2はほぼすべての個人申告書に必須です。しかし、12か月分の銀行明細書、領収書のフォルダ、または後ろにホチキス留めされた前年度の申告書は必須ではありません。準備担当者が作業を始める前に、誰かがページごとにその判断を下す必要があります。そして、ほとんどの事務所では、その判断を下すのは、印刷されたチートシートと増え続ける書類の山を抱えた担当者です。
重要ポイント
- ある事務所では、すでにSmartVaultとLacerteを併用しているにもかかわらず、クライアントの80~90%が依然として紙で書類を提出していました。
- 文書ソフトウェアは命名とルーティングを自動化しますが、そのページがこの申告書に属するかどうかは判断できません。そのため、事務所は書類を仕分ける担当者向けのチートシートを作成し続けています。
- ImageToTable.aiは、各文書の意味を読み取って分類列を埋めるため、準備担当者は書類の山全体を読む代わりに、Needs Preparer Attentionを「はい」にフィルタリングするだけで済みます。
時間はスキャンではなくトリアージのステップで消える
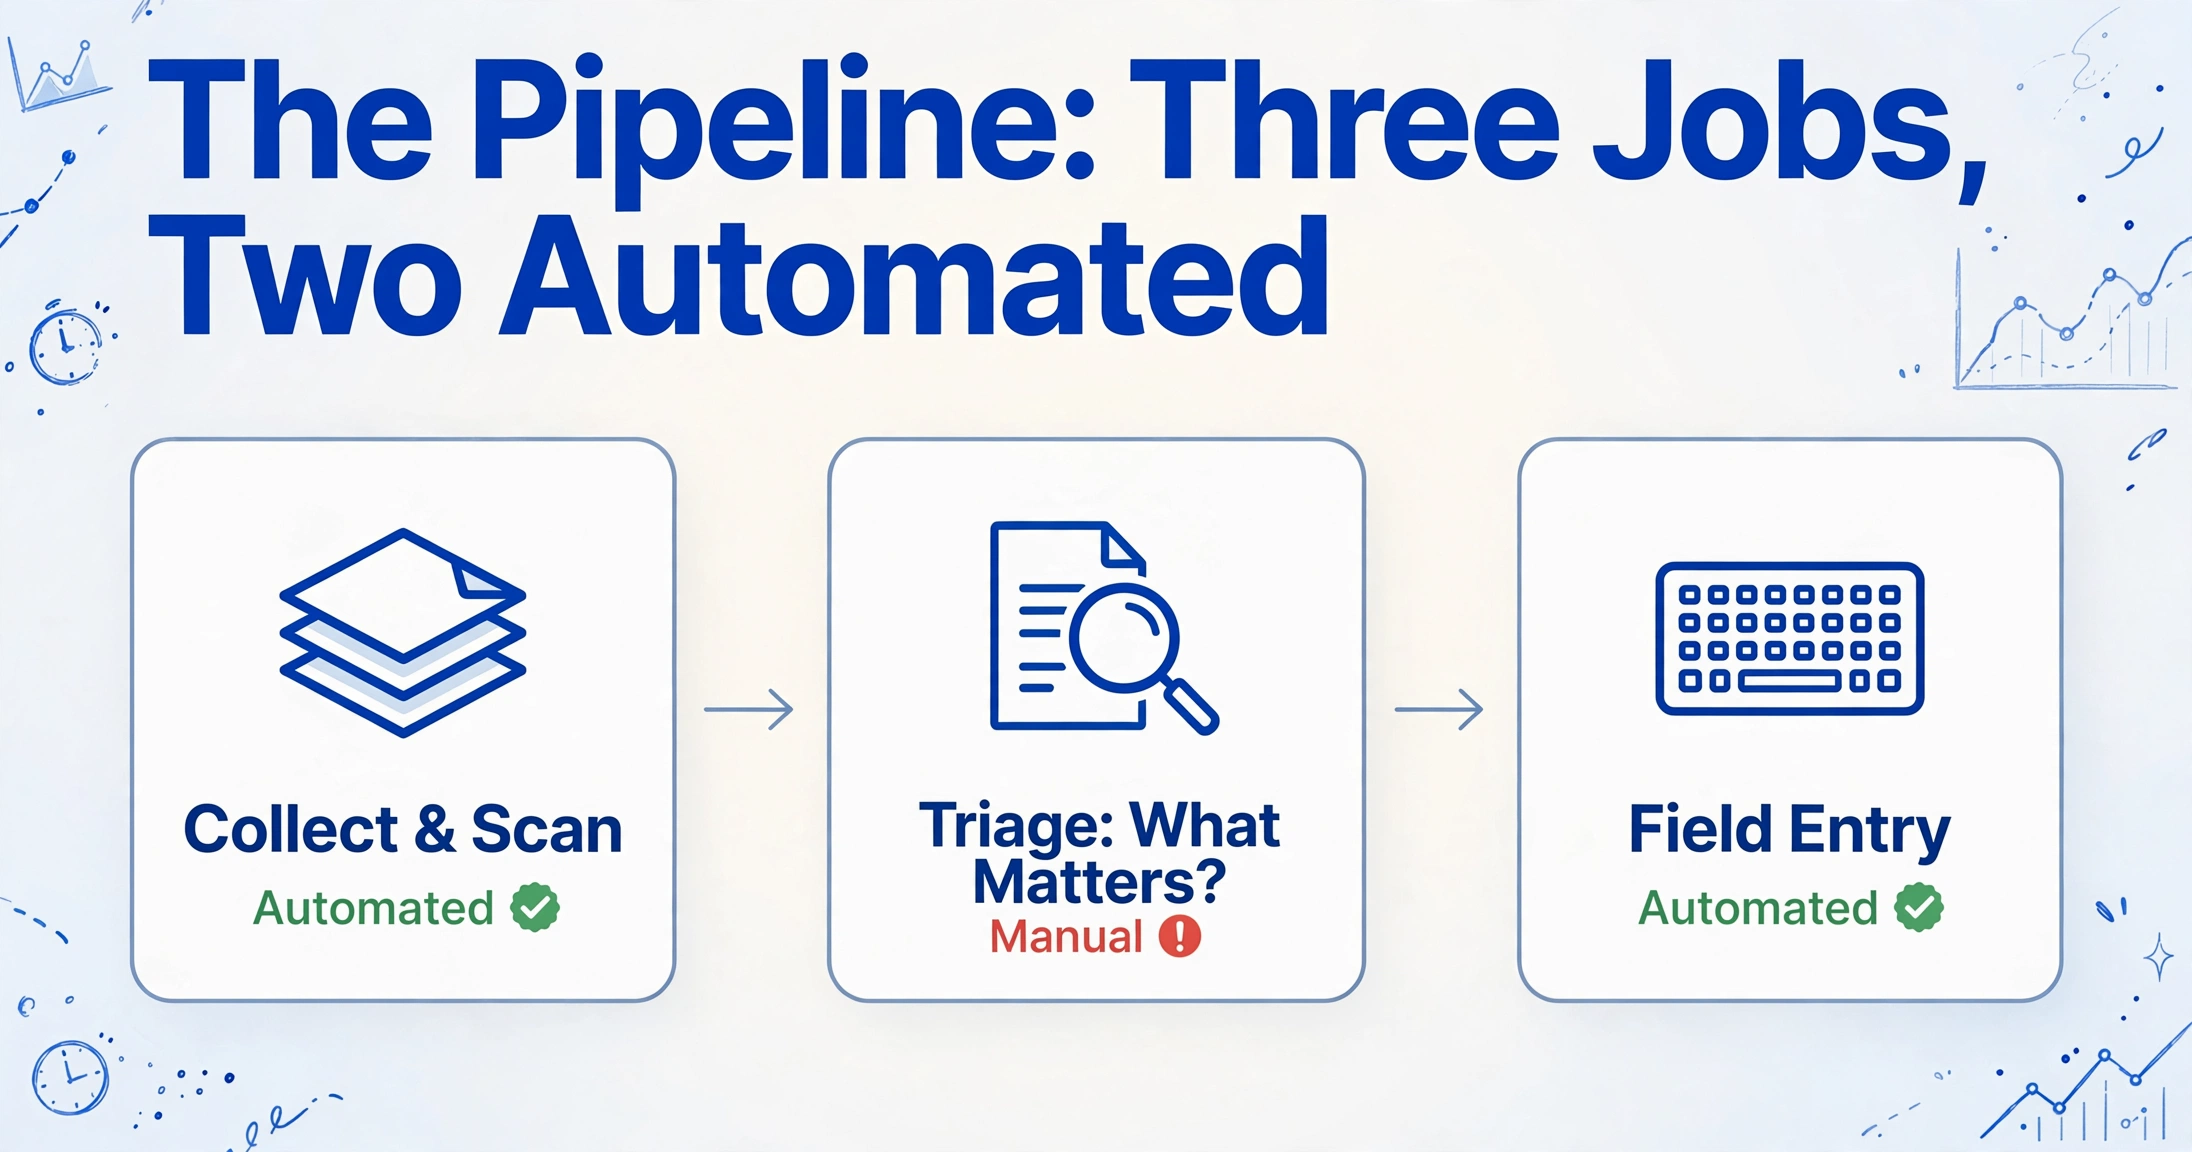
紙中心の繁忙期のコストは、スキャンやタイピングではなく、仕分けと判断にあります。クライアントがフォルダを持って来店し、フロントデスクがスキャナーに通し、その後、何が重要かを判断する人間を待って申告書が進みます。このステップを税務文書トリアージと呼びます。多くの事務所がこのパイプラインの部分に名前を付けず、予算も組まず、測定もしていません。だからこそ、本来準備に充てるはずの時間を吸い取られ続けているのです。
パイプライン自体は単純に描けます。書類がフロントデスクまたはポータルに届きます。スキャンされます。誰かがフォームの種類ごとに仕分けし、クライアントのファイルに綴じます。準備担当者が申告書を開き、書類の山から作業を始めます。IRSにもこの書類の山を整理しておくべき独自の理由があります。Publication 583は、証憑書類を秩序正しく保管し、電子システムの場合は、保存期間中、索引付けされ、判読可能な形式で検索可能な状態を維持することを要求しています(IRS Publication 583)。仕分けはオフィスマネージャーが考案した無駄な作業ではありません。記録が取るべき形なのです。
この図が隠しているのは、パイプラインには3つの別々の仕事があり、ほとんどの事務所がそのうち2つしか自動化していないことです。収集とスキャンにはツールがあります。フィールド入力にもツールがあります。真ん中の仕事、つまり申告書に必要なページとファイル用にしかないページを判断する作業は、今も担当者の記憶と1枚のチートシートに依存しています。税務申告書類の整理に関するアドバイスのほとんどはフォルダの話で終わり、このステップに名前を付けることはありません。当社のバッチ紙フォーム抽出に関する記事でも、フォームが届いた後の処理を解決するものであり、その前の仕分けを解決するものではないと明記しています。このギャップが今回のテーマです。
季節性がこのギャップを高コストにしています。全米税理士協会(NATP)の報告によると、会員事務所の総収入の65%が税務シーズン中に稼がれています(NATP)。また、IRSは2025会計年度に2億7140万件の連邦申告書と補足書類を処理しました(IRS Data Book 2025)。トリアージに費やした1時間はすべて、年間の収入を支える数週間から奪われた時間です。
トリアージがページごとに答える問いは一つ:この申告書に必要か?
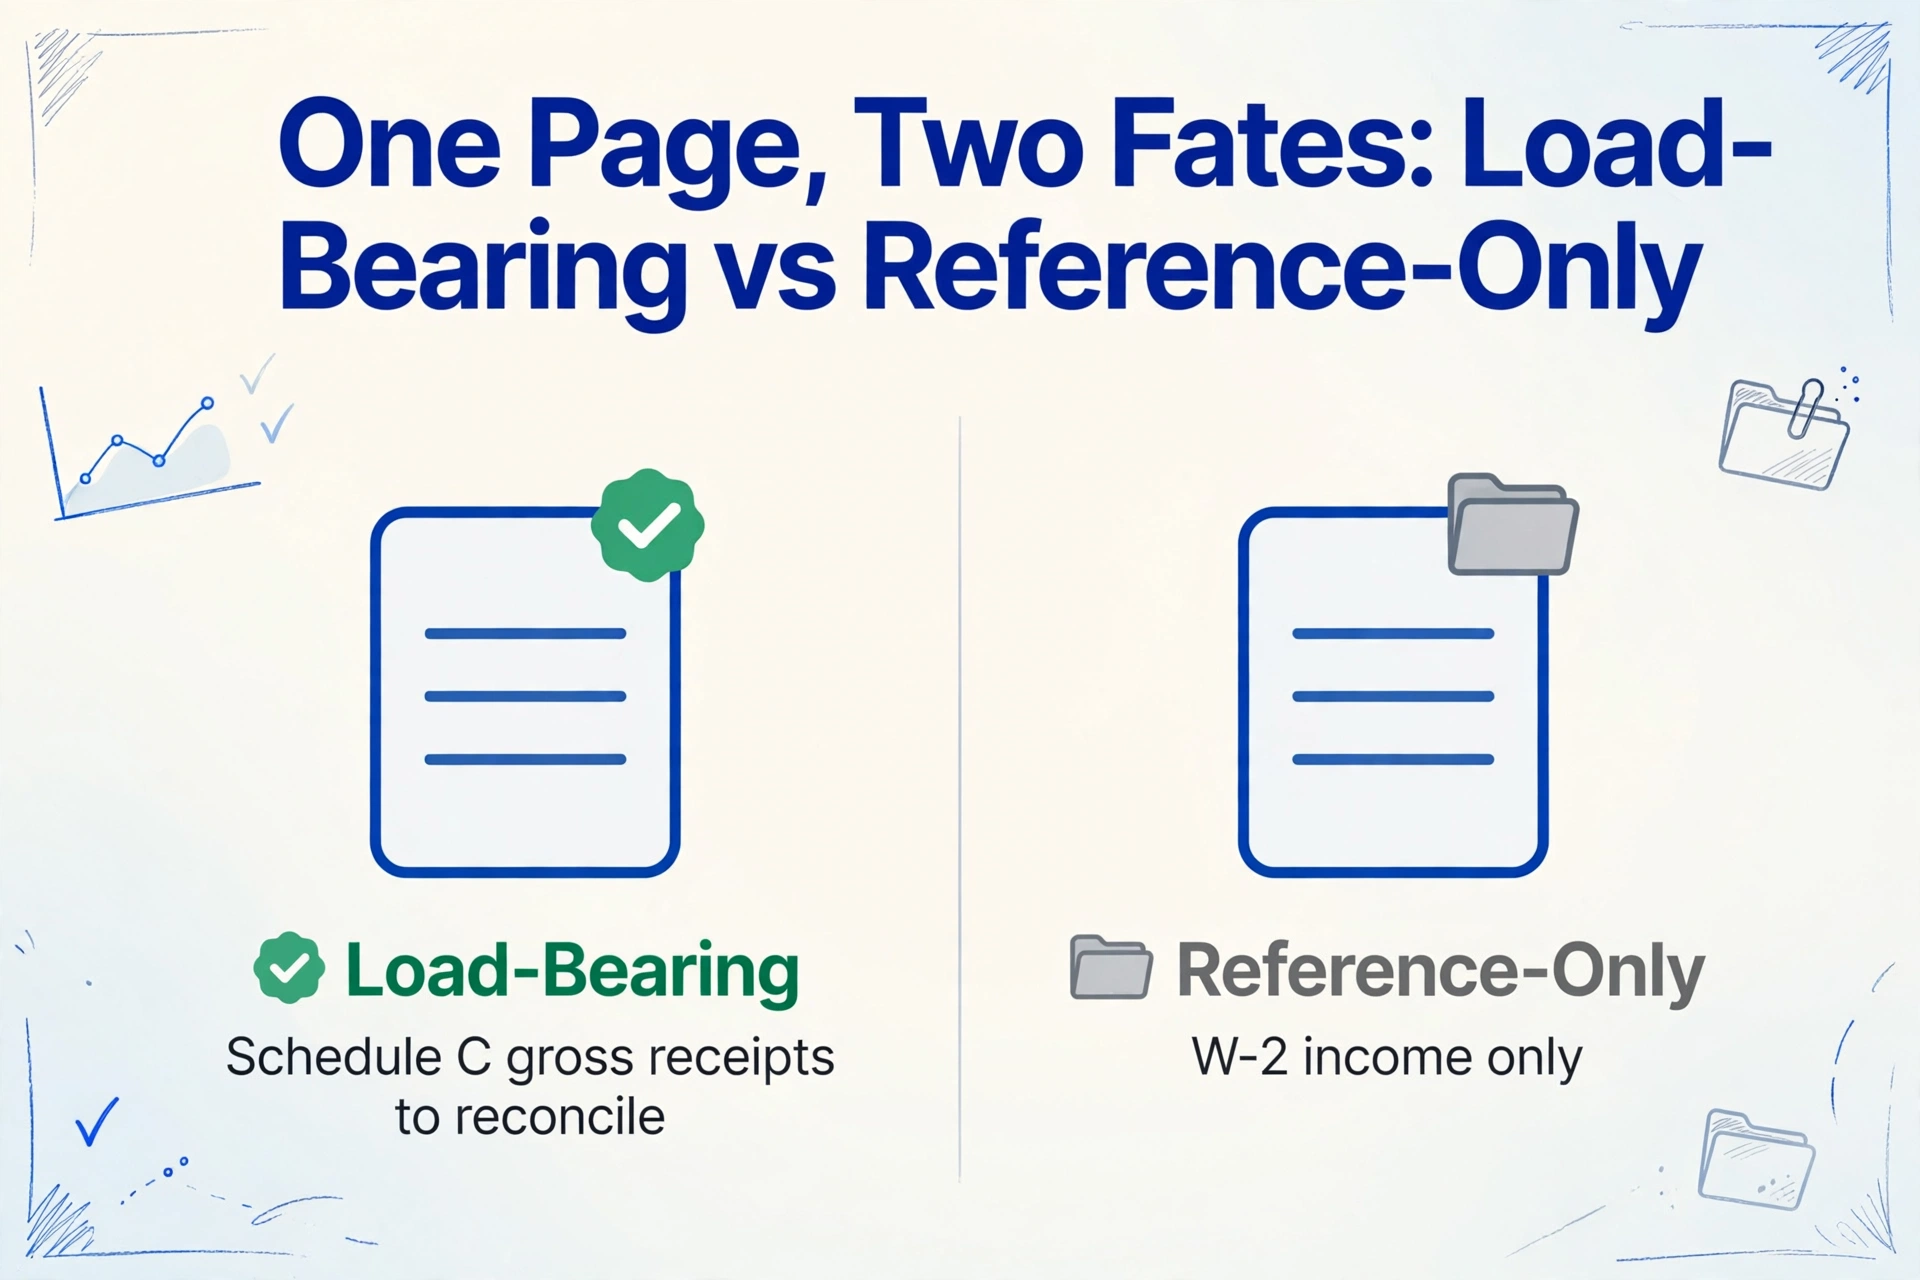
トリアージは申告の判断ではなく関連性の判断であり、申告書ごとに変わります。仕分け担当者が実際に答えている問いは、そのページがこの特定の申告書が依存する数字や事実を載せているかどうかです。載せていれば、そのページは必須であり、準備担当者が確認する必要があります。載せていなければ参考用であり、机を経由せずにファイルに保管されます。
この区別は文書タイプの性質ではありません。申告書の性質です。1年分の銀行明細書は、Schedule Cの総収入を照合する必要があるクライアントにとっては必須であり、収入がW-2のみのクライアントにとっては参考用です。領収書の束は、控除を裏付ける場合は必須であり、クライアントが標準控除を利用する場合は参考用です。IRS自身の補助文書の定義も同じ構成を対象としており、売上伝票、支払済み請求書、請求書、領収書、預金伝票、取消小切手を挙げ、収入または費用の種類別に整理するよう求めています(IRS記録保持ガイダンス)。銀行明細書は無関係な書類ではありません。申告書が必要とする場合、抽出ツールが読むために作られたまさにその文書であり、不要な場合、脇に置くべきまさにそのページです。
紙が多いオフィスでは、3つの失敗パターンが繰り返し発生します。1つ目は年度の誤りで、前年度の明細書や古いK-1が現在のフォルダに混入します。2つ目は事業体の誤りで、K-1や銀行明細書がクライアントが所有する関連会社のものである場合です。3つ目はクライアント自体の誤りで、同じ机で同じ時間帯に2人が2つのフォルダをスキャンするときに発生します。これらはいずれもスキャンの問題ではありません。すべてトリアージの問題であり、素早く作業する仕分け担当者はそれぞれを見逃してしまいます。
作業が必要なページについては、抽出自体は十分に理解されています。行ごとに照合する必要がある明細書は、スプレッドシートに入れば解決済みのケースであり、これは銀行明細書データをテーブルに取り込むワークフローの背景にあります。未解決の部分は上流にあります:フォルダ内のどの明細書がその処理を必要とするかを知ることです。
山積みが複雑さではなく量で崩れる理由
1つのフォルダーを仕分けるのは簡単です。問題が始まるのは、同じ判断をシーズン中に何千回も、その時デスクにいる誰かが行わなければならない時です。税務専門家は、仕分けのステップを率直な言葉で「ボトルネック」と表現します。ある実務者は、r/taxprosコミュニティで、他の事務所が「準備者に送る前に書類をスキャン、アップロード、仕分けする」方法を尋ね、それを直接こう名指ししました。「それが現在の当社のボトルネックです」(r/taxpros)。最も支持された回答は、多くの事務所が辿り着く回避策を説明していました。それは、事務所が彼女のために作成したチートシートを使って「申告書の流れに基づいて書類を仕分ける」受付係です。
紙もまだなくなりません。2025年のr/taxprosのデジタル化に関するスレッドで、すでにLacerteと併用してSmartVaultを運用している事務所は、クライアントの80〜90パーセントが今でも紙を渡すと推定していました(r/taxpros)。これは、文書管理がすでに導入されている事務所の話であり、問題の本質を指し示しています。つまり、事務所が購入するソフトウェアは命名とルーティングを自動化していますが、判断は手作業のままなのです。
既存ツールが実際に何をするかを見てみましょう。SmartVaultのSmartRoutingは、UltraTax CS、Drake、またはCCH Axcessからメタデータを読み取り、申告書と元書類をコピー種別ごとに正しいフォルダーに振り分けます。Canopyは、ファイル名を変更し、グローバルルールを使用して種類または発行者ごとに分類します。SurePrepの1040SCANとGruntWorxはさらに進んで、W-2、1099、K-1のフィールドを申告書に取り込みます。これらのそれぞれが、実際のステップを解決します。しかし、どのツールも、あるページがそもそもこの申告書に属するかどうかには答えません。その質問は仕分け者に委ねられており、それがソフトウェアを購入した事務所が今でもチートシートを書く理由です。
トリアージを列に変換し、読む代わりにフィルタリングする
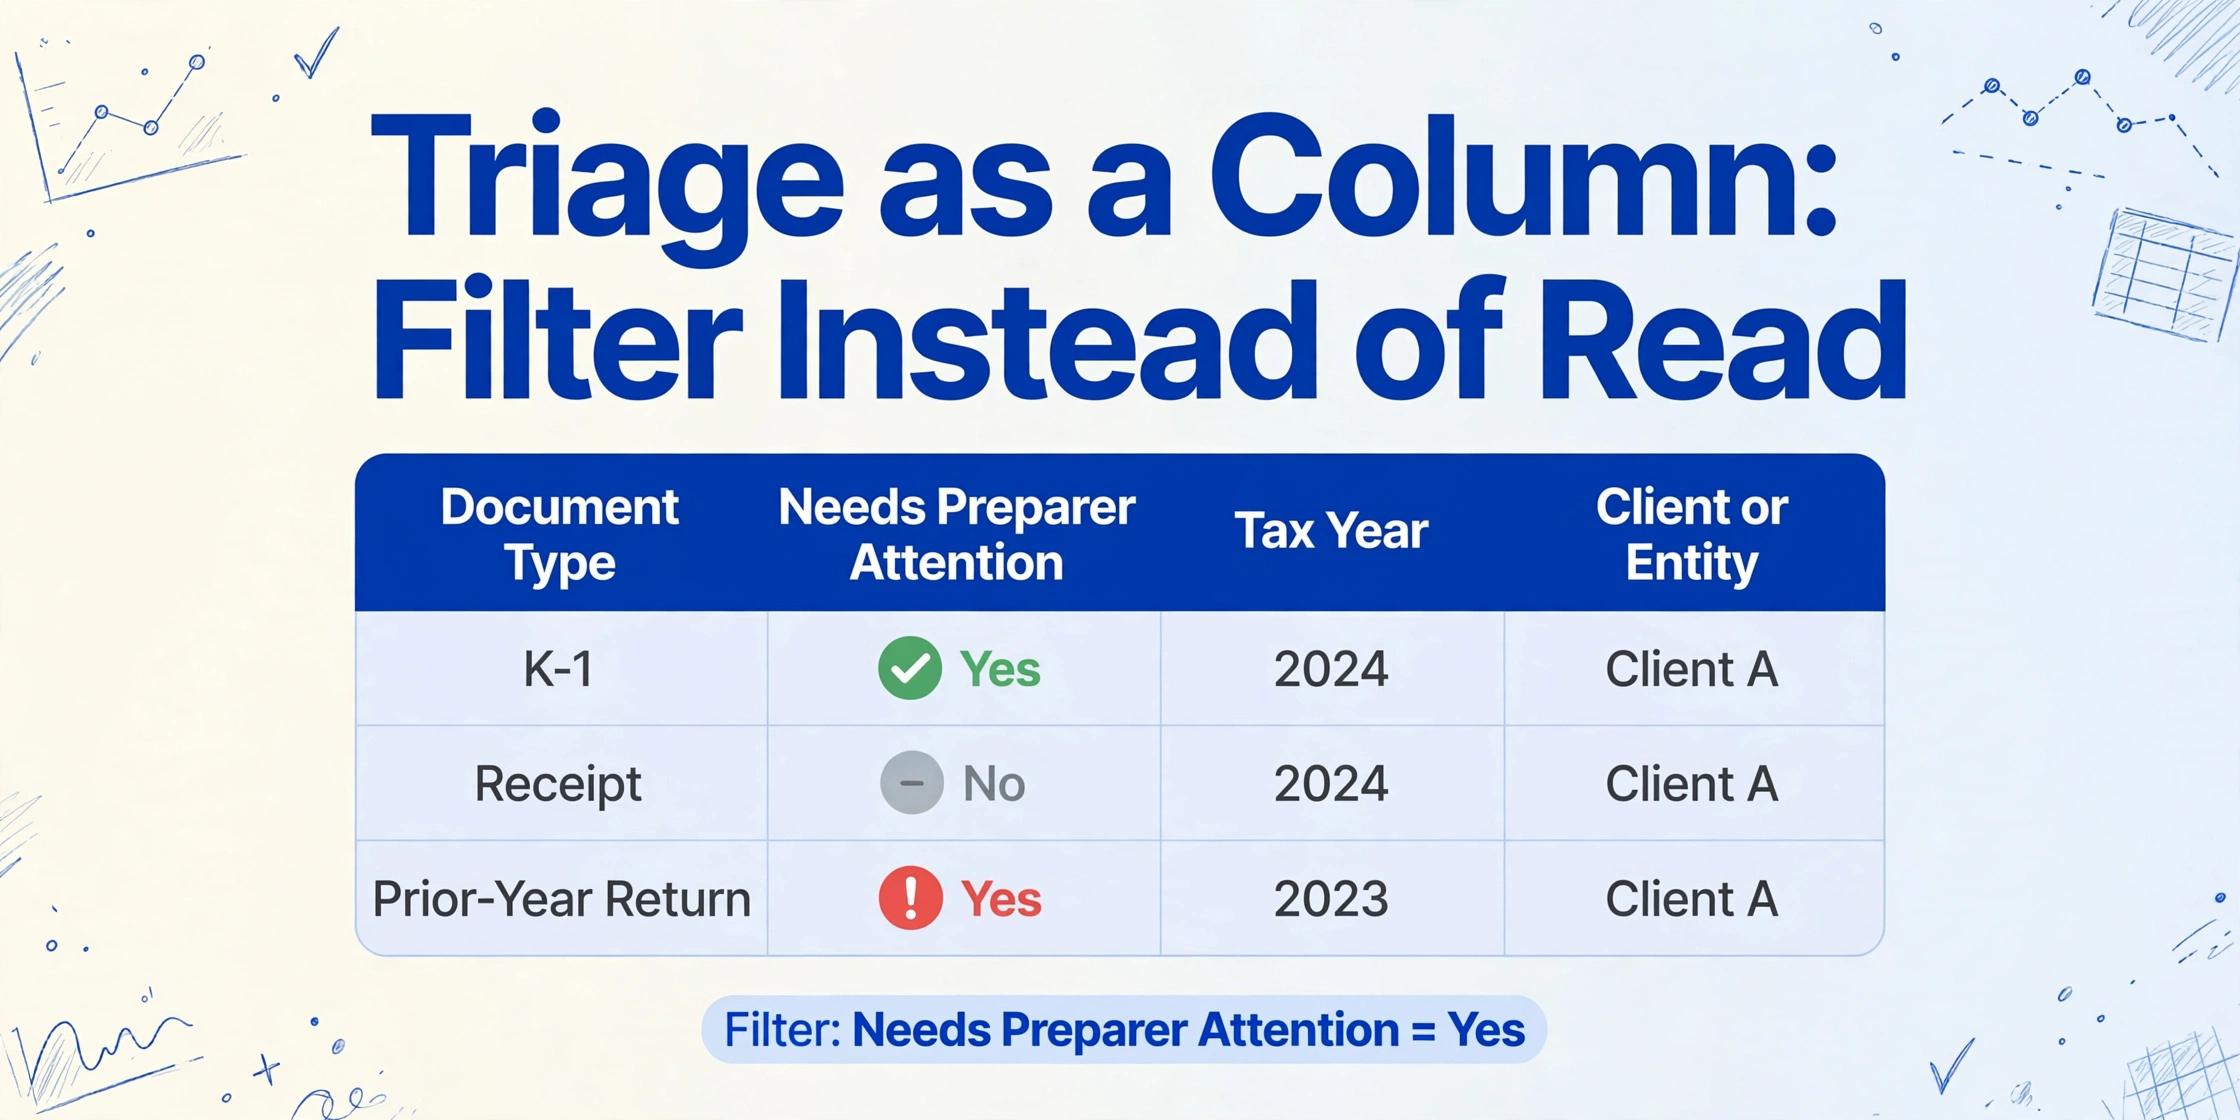
トリアージを担当者の頭の中から取り出す方法は、それを抽出出力の列にすることです。これは、文書管理ツールが提供するフォルダベースのソース文書仕分けとは異なるアプローチです。ファイルの保存先を決める代わりに、ファイルが何であるかを判断し、その判断をスプレッドシートの列に書き込み、担当者がその列でフィルタリングできるようにします。判断自体は依然として行われますが、それは一度だけ行われ、チーム全体が見て再利用できる形で残ります。
これを可能にする仕組みがカスタム列抽出です。希望する列名を入力すると、AIが各ドキュメントを読み取り、ページ上の位置ではなく意味に基づいて各列名に一致する値を入力します。これにより、同じアップロード内でW-2、銀行明細書、撮影されたレシートにわたって、フォーマットごとのテンプレートなしで一連の列名を機能させることができます。ここで関連するモードは推論列です。これは、ドキュメントに印刷されていないが、ドキュメントの内容から判断できる値を持つ列です。レシートには「Document Type」フィールドはありませんが、AIはそれを読み取り、レシートであると判断できます。
トリアージに適用すると、クライアントフォルダを作業キューに変える小さな列セットが生成されます:
Document Type (options: W-2, 1099-INT, 1099-DIV, 1099-B, K-1, Bank Statement, Receipt, Mortgage Interest 1098, Prior-Year Return, Other)Needs Preparer Attention (options: Yes, No)Tax YearClient or Entity
最初の列はすべてのページを分類します。2番目の列はトリアージ判断そのものであり、AIが一貫して適用するルールとして表現されます:K-1または源泉徴収のある1099はYes、調整が取れない申告書の12ヶ月分の銀行明細書はNoです。最後の2つの列は、誤った年や誤ったエンティティの失敗を担当者に届く前に検出します。2024とタグ付けされたドキュメントや別のエンティティにタグ付けされたドキュメントは、シートを並べ替えた瞬間に目立つからです。
処理はバッチファーストであるため、クライアントフォルダ全体が一度に入力され、ドキュメントごとに1行の1つのスプレッドシートとして返されます。トリアージは読む作業ではなくなり、フィルタになります。担当者はシートを開き、Needs Preparer AttentionをYesにフィルタリングし、重要な行を処理します。参考用のページはシートに残り、分類され、ファイルにトレース可能なままです。これはIRSの整然とした記録要件が求めるものです。また、これは会計事務所向けドキュメント抽出ガイドおよび会計事務所内での抽出ソフトウェアの導入事例で説明されている規模でこの作業を行う事務所にとって、分類が特に価値を発揮する点でもあります。
スキャン・分類・抽出の完全な設定
設定は4つの決定事項で構成され、一度決まればトリアージはすべてのバッチで自動的に実行されます。どれもスキャン設定やフォルダ規約ではありません。すべて出力されるスプレッドシートに何を含めるかに関するものです。
クライアントフォルダ全体を1つのバッチとしてアップロード
スキャン、PDF、スマートフォンの写真をまとめてドロップします。バッチ処理によりこれらは1つのテーブルに統合され、クライアントのフォルダは山積みではなく一連の行になります。フォームの種類ごとに事前に仕分ける必要はありません。それは次のステップが担う役割です。
分類列を定義
Document Typeをオプションリスト付きで追加し、Needs Preparer Attention、Tax Year、Client or Entityも追加します。オプションリストが肝心です。ここにトリアージの語彙が格納され、すべての仕分け担当者が独自のカテゴリを考案するのではなく、同じカテゴリを適用します。
申告に実際に必要な値の列を追加
ここで必須となるページの数値を取得します。支払者名、口座番号、明細期間、合計、源泉徴収額などです。参考用の銀行明細書ではこれらのセルは単に空白のままで、空白は推測ではなく明確なシグナルとなります。フォルダ内の領収書については、Category (options: Meals, Travel, Office, Other)のような列で、同じパスで各領収書を分類します。
フィルタ、レビュー、引き継ぎ
税理士はNeeds Preparer AttentionをYesにフィルタリングし、該当する行のみを処理します。参考用ページを含む完全なシートは記録として残ります。同じクライアントが翌年戻ってきたとき、列セットはプリセットとして保存され、再構築することなく再利用されます。
ファイルは安全に処理され、保存されません。
同じパターンは、量が多く1ドキュメントあたりの価値が低い繁忙期のレシート処理にも当てはまります。これは業務用レシートを1つの税務スプレッドシートにバッチ変換するシナリオです。シーズン全体がW-2と1099の場合、パイプラインは同じ考え方に集約され、税務シーズンのW-2・1099パイプラインで説明しています。
このパイプラインがまだ判断できないこと
列の設定に関係なく、3つのことは事務所に残ります。 1つ目は専門的判断そのものです。分類列は準備担当者の注意を重要なページに誘導しますが、特定の控除が適用されるか、事業経費が通常かつ必要かどうかは、依然として人が判断する事項です。パイプラインはその人が見る範囲を絞り込むだけで、判断自体は行いません。
2つ目は入力品質です。ぼやけたスマホ写真や約150 dpi未満のスキャンでは、2024年と2025年の日付の違いが曖昧になり、これはトリアージが依存するまさにその項目です。K-1の上に支払い伝票が印刷されたような、無関係な2つのフォームが含まれるページは、1ドキュメント1行を前提としたモデルを混乱させる可能性があります。そうしたページには依然として人の目が必要であり、誠実なワークフローはそれらを確定行ではなくレビュー候補として扱うことです。
3つ目はデータの送信先です。このパイプラインはExcel、CSV、JSONにエクスポートします。Drake、UltraTax CS、Lacerte、CCH Axcessへの直接転記は行わず、保存とアクセス制御を担う文書管理システムを置き換えるものでもありません。Publication 583のIRS記録保持規則と納税者データの保護慣行は、ツールではなく事務所の責任です。スプレッドシートネイティブのレイヤーにより、抽出データが申告書に到達する前に検査可能になり、その検査ステップは意図的なものです。
よくある質問
AIは、私が事前に仕分けしなくても銀行明細と領収書を区別できますか?
はい。使用するカテゴリをDocument Type列で定義すると、AIが各ドキュメントの内容を読み取り、どのカテゴリが該当するかを判断します。ファイル名やファイルが置かれているフォルダには依存しないため、名前のないスキャンでも分類されます。
AIが「その他」とラベル付けしたドキュメントはどうなりますか?
分類とその出所を含む行として表示されるため、何も消えません。「その他」の行は確認を促すもので、ドキュメントが本当に特殊な場合か、選択肢リストにカテゴリを追加する必要がある場合のどちらかです。この列の価値は、特殊なドキュメントが山に埋もれずに表面化することです。
これはSmartVault、Canopy、SurePrepを置き換えるものですか?
いいえ。これらのツールは保存、ルーティング、場合によっては税務ソフトウェアへのフィールド転送を処理します。このパイプラインは分類と抽出を処理し、スプレッドシートを生成します。事務所は保存用に文書管理システムを維持し、既存の受入処理の上に分類レイヤーを使用できます。
クライアントのフォルダ全体を1つのバッチで処理できますか?
はい。バッチ処理がデフォルトです。フォルダ全体が一緒に処理され、ドキュメントごとに1行の1つのテーブルとして返されます。これにより、トリアージフィルタが実用的になります。ドキュメントを1つずつ処理すると、別の場所に同じ山が再構築されるだけです。
トリアージ列は、あるクライアントには関連し別のクライアントには関連しないドキュメントをどのように処理しますか?
Needs Preparer Attentionの背後にあるルールは御社が定義するものであり、ドキュメントではなく申告書の観点で表現できます。すべての銀行明細を照合する事務所は、すべてに「はい」をマークします。Schedule Cのクライアントのみを照合する事務所は、同じ申告書の事業所得の存在にフラグを結び付けることができます。この列は、バッチ全体で御社のルールに一貫して従います。
出力はDrake、UltraTax CS、Lacerte、CCH Axcessに直接インポートされますか?
直接ではありません。出力はExcel、CSV、またはJSONで、御社が既に使用しているインポート経路を使用して税務ソフトウェアにマッピングします。そのステップを明示的にすることで、抽出されたデータが申告書に到達する前にレビューされることが保証されます。
問題は書類の山ではありません。どのページが重要かという暗黙の判断であり、その判断が列になると、準備担当者は仕分けをやめて準備を始めます。
前シーズンの実際のクライアントフォルダでテストしてください。通常は脇に置く参考用ページも含めて、分類列が必須のドキュメントをキューの先頭に置くかどうかを確認してください。 ご自身のドキュメントでお試しください。