Tax Source Document Triage
Is Where Your Season Goes
Der teuerste Schritt in einer Kanzlei mit hohem Volumen ist nicht das Lesen der Dokumente. Es ist die Entscheidung, welche die Steuererklärung tatsächlich benötigt. Eine W-2 ist bei fast jeder Einzelsteuererklärung tragend. Zwölf Monate Kontoauszüge, ein Ordner mit Belegen oder die letztjährige Steuererklärung, die hinten angeheftet ist, sind es nicht. Jemand muss diese Entscheidung Seite für Seite treffen, bevor ein Bearbeiter beginnen kann – und in den meisten Kanzleien ist dieser Jemand eine Person mit einem ausgedruckten Spickzettel und einem Stapel, der ständig wächst.
Key Takeaways
- 80 bis 90 Prozent der Mandanten einer Kanzlei übergaben weiterhin Papier, obwohl die Kanzlei bereits SmartVault neben Lacerte nutzte.
- Dokumentensoftware automatisiert Benennung und Weiterleitung, kann aber weiterhin nicht sagen, ob eine Seite zu dieser Steuererklärung gehört – daher schreiben Kanzleien weiterhin Spickzettel für die Person, die den Stapel sortiert.
- ImageToTable.ai füllt eine Klassifizierungsspalte, indem es jedes Dokument nach Bedeutung liest – so filtert ein Bearbeiter Needs Preparer Attention auf Yes, statt den ganzen Stapel zu lesen.
Die Stunden gehen im Triage-Schritt verloren, nicht beim Scannen
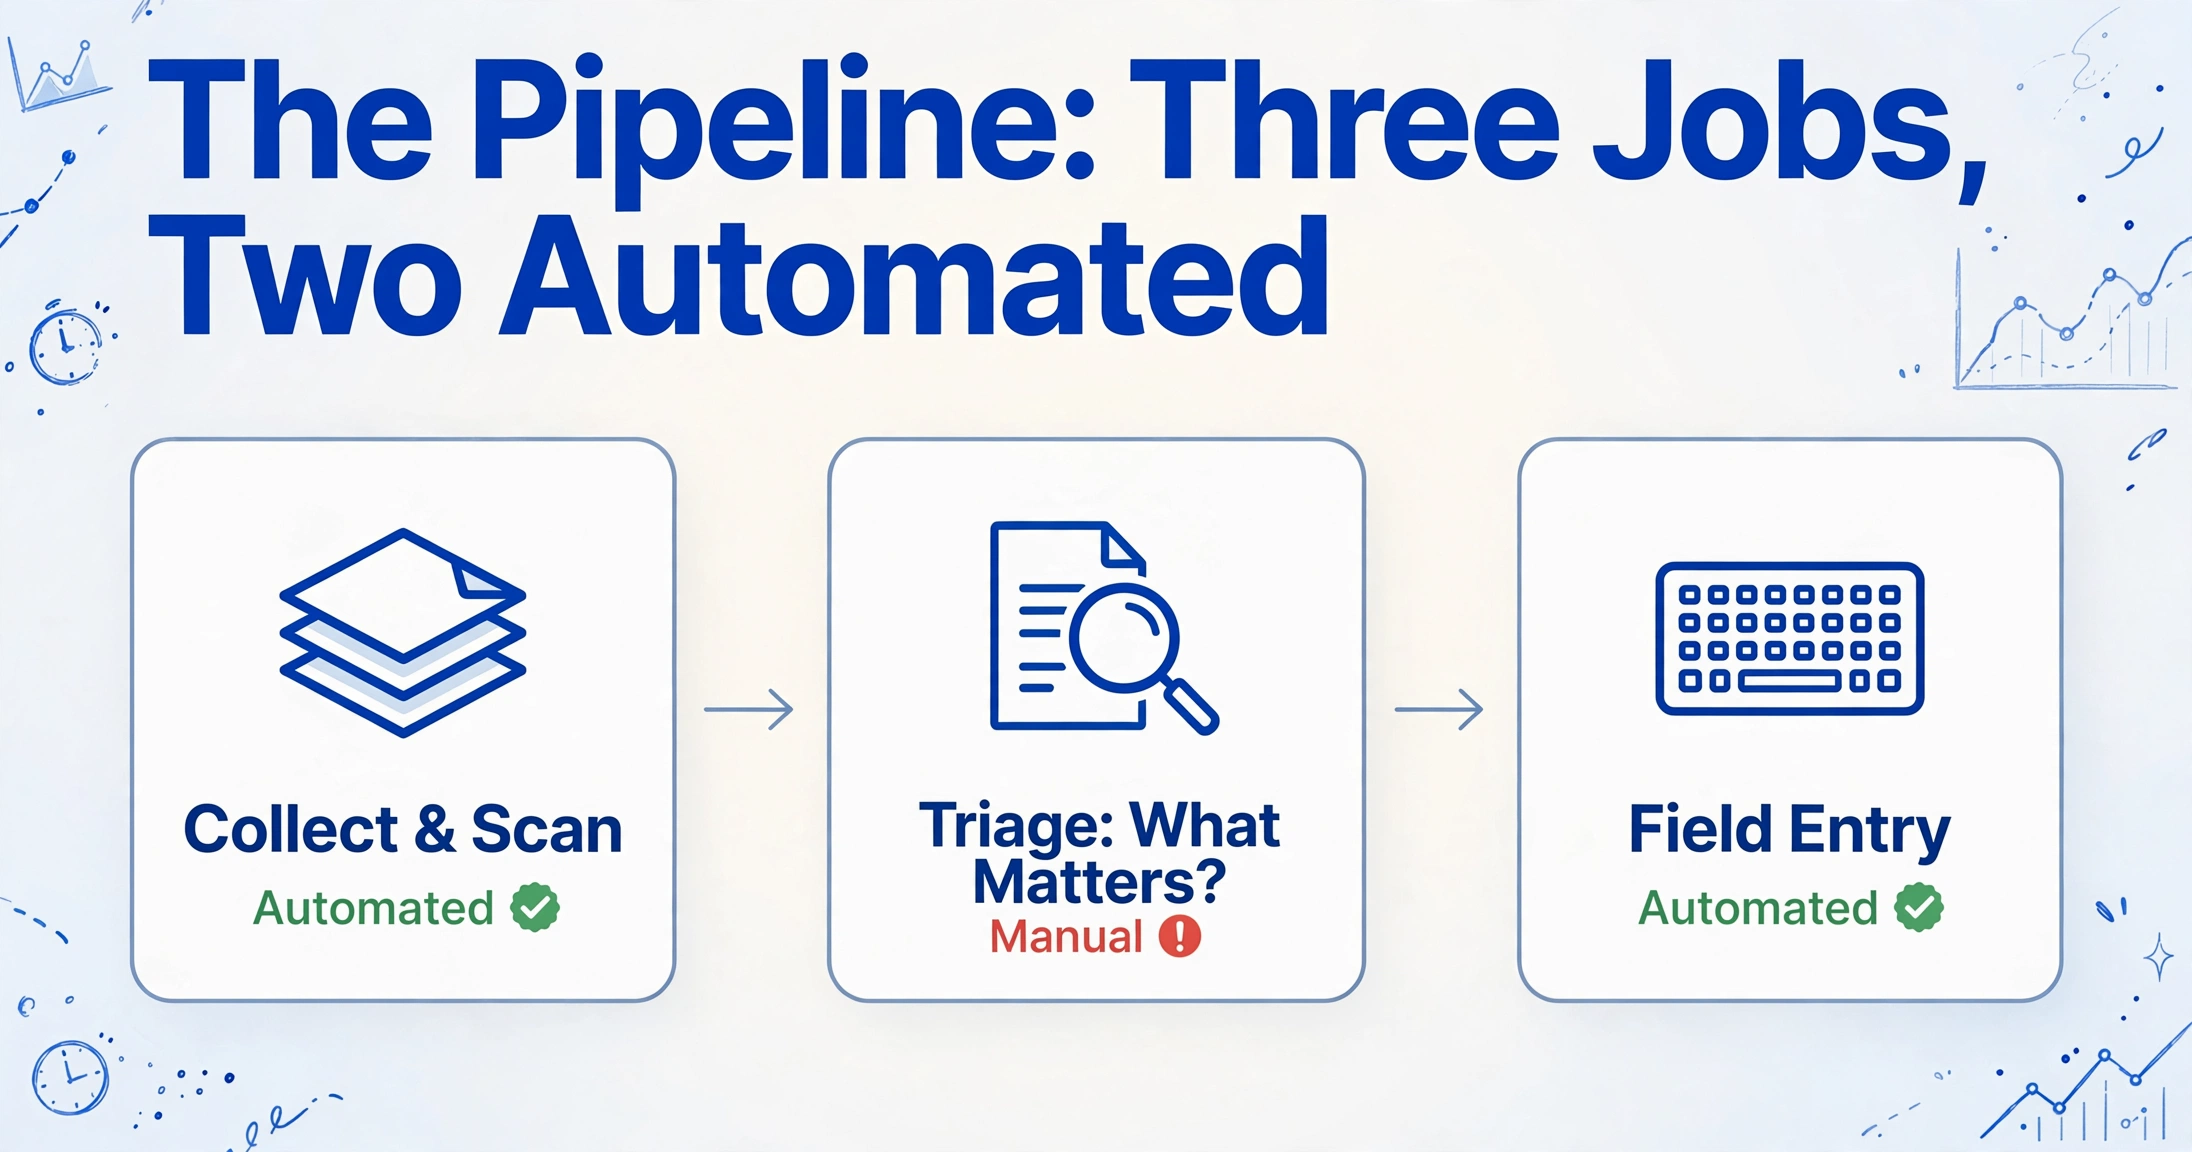
Die Kosten einer papierlastigen Saison stecken im Sortieren und in der Beurteilung, nicht im Scannen oder Tippen. Ein Mandant kommt mit einem Ordner herein, die Rezeption führt ihn durch den Scanner, und dann wartet die Steuererklärung darauf, dass ein Mensch entscheidet, was wichtig ist. Nennen wir diesen Schritt Steuerdokument-Triage. Es ist der Teil der Pipeline, den die meisten Kanzleien nie benennen, nie budgetieren und nie messen – genau deshalb verschlingt er ständig Stunden, die für die Erstellung vorgesehen waren.
Die Pipeline selbst ist einfach zu zeichnen. Dokumente treffen an einer Rezeption oder über ein Portal ein. Sie werden gescannt. Jemand sortiert sie nach Formulartyp und legt sie zum Mandanten ab. Ein Bearbeiter öffnet die Steuererklärung und arbeitet den Stapel ab. Der IRS hat seinen eigenen Grund, diesen Stapel geordnet zu halten: Publication 583 verlangt, dass Belegdokumente in geordneter Weise aufbewahrt werden und bei elektronischen Systemen während der gesamten Aufbewahrungsfrist indexiert und in lesbarer Form abrufbar bleiben (IRS Publication 583). Das Sortieren ist keine Beschäftigungstherapie, die sich ein Büroleiter ausgedacht hat. Es ist die Form, die die Akte annehmen muss.
Was die Zeichnung verbirgt, ist, dass die Pipeline drei getrennte Aufgaben hat und die meisten Kanzleien nur zwei davon automatisieren. Sammeln und Scannen bekommen ein Werkzeug. Die Felderfassung bekommt ein Werkzeug. Die mittlere Aufgabe – zu entscheiden, welche Seiten die Steuererklärung braucht und welche nur für die Ablage da sind – läuft weiterhin über das Gedächtnis einer Person und einen einseitigen Spickzettel. Die meisten Ratschläge zur Organisation von Steuerbelegen hören beim Ordner auf und benennen diesen Schritt gar nicht. Unser eigener Beitrag zu Batch-Papierformular-Extraktion stellt ausdrücklich klar, dass er das löst, was nach dem Eintreffen der Formulare passiert, nicht das Sortieren davor. Genau um diese Lücke geht es hier.
Die Saisonalität macht die Lücke teuer. Die National Association of Tax Professionals berichtet, dass 65 Prozent des Bruttoumsatzes ihrer Mitgliedskanzleien während der Steuersaison erwirtschaftet werden (NATP), und der IRS verarbeitete im Fiskaljahr 2025 271,4 Millionen Bundessteuererklärungen und ergänzende Dokumente (IRS Data Book 2025). Jede Stunde, die für die Triage aufgewendet wird, ist eine Stunde, die den Wochen fehlt, die das Jahr bezahlen.
Triage beantwortet eine Frage pro Seite: Braucht diese Beilage Bearbeitung?
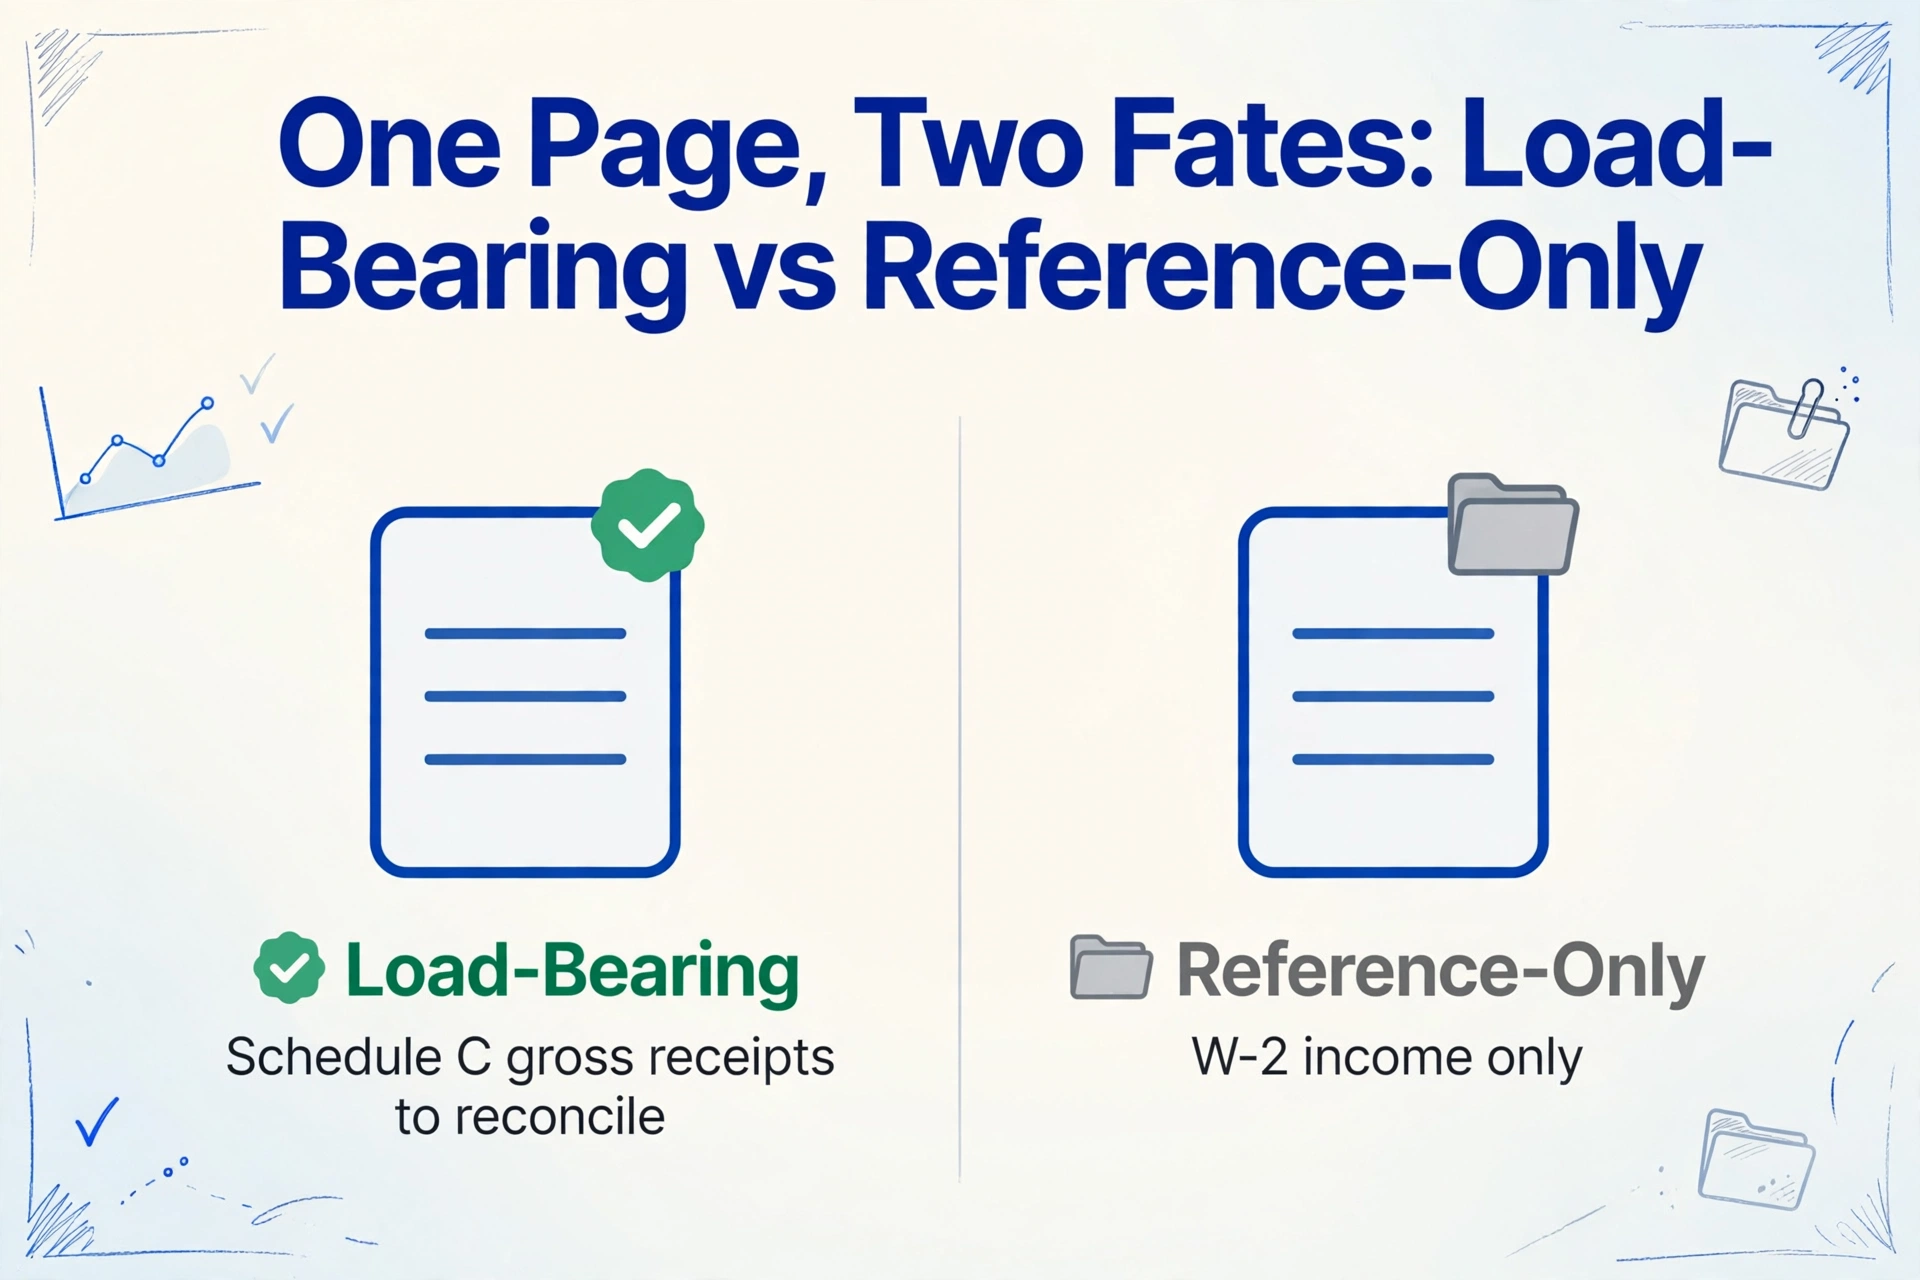
Triage ist eine Relevanzentscheidung, keine Ablageentscheidung, und sie ändert sich mit der Steuererklärung. Die Frage, die eine sortierende Person wirklich beantwortet, ist, ob eine bestimmte Seite eine Zahl oder eine Tatsache enthält, von der diese spezifische Steuererklärung abhängt. Wenn ja, ist die Seite tragend und eine Bearbeiterin bzw. ein Bearbeiter muss sie sehen. Wenn nein, ist sie nur zur Ablage und gehört in die Akte, ohne jemals den Schreibtisch zu berühren.
Der Unterschied ist keine Eigenschaft des Dokumenttyps. Er ist eine Eigenschaft der Steuererklärung. Ein Jahr Kontoauszüge ist tragend für eine Kundin bzw. einen Kunden mit abzugleichenden Schedule-C-Bruttoeinnahmen und nur zur Ablage für eine Kundin bzw. einen Kunden, dessen einziges Einkommen ein W-2 ist. Ein Stapel Belege ist tragend, wenn er einen Abzug belegt, und nur zur Ablage, wenn die Kundin bzw. der Kunde den Standardabzug wählt. Die eigene Definition des IRS zu Belegdokumenten umfasst dieselbe Mischung: Verkaufsbelege, bezahlte Rechnungen, Rechnungen, Quittungen, Einzahlungsbelege und stornierte Schecks, mit der Anforderung, sie nach Jahr und nach Art der Einnahmen oder Ausgaben zu organisieren (IRS-Aufzeichnungshinweise). Ein Kontoauszug ist kein Durcheinander. Er ist genau das Dokument, für das ein Extraktionstool gebaut ist, wenn die Steuererklärung ihn braucht, und genau die Seite, die beiseitegelegt wird, wenn die Steuererklärung ihn nicht braucht.
Drei Fehlermuster wiederholen sich in jedem papierlastigen Büro. Das erste ist das falsche Jahr, wenn eine Erklärung aus dem Vorjahr oder ein altes K-1 im aktuellen Ordner mitläuft. Das zweite ist die falsche Einheit, wenn ein K-1 oder ein Kontoauszug zu einem Schwesterunternehmen gehört, das die Kundin bzw. der Kunde ebenfalls besitzt. Das dritte ist eine komplett falsche Kundin bzw. ein komplett falscher Kunde, was passiert, wenn zwei Personen zur selben Stunde an demselben Schreibtisch zwei Ordner scannen. Keines davon ist ein Scanproblem. Alle drei sind Triage-Probleme, und eine schnelle sortierende Person lässt jedes davon durch.
Für die Seiten, die Bearbeitung benötigen, ist die Extraktion selbst gut verstanden. Ein Kontoauszug, der Zeile für Zeile abgeglichen werden muss, ist ein gelöster Fall, sobald er in einer Tabelle ist – das ist der Workflow hinter dem Übertragen von Kontoauszugsdaten in eine Tabelle. Der ungelöste Teil liegt vorgelagert: zu wissen, welche Auszüge im Ordner diejenigen sind, die diese Behandlung benötigen.
Warum der Stapel bei Volumen bricht, nicht bei Komplexität
Ein einzelner Ordner ist leicht zu triagieren. Das Problem beginnt, wenn dieselbe Entscheidung in einer Saison tausendmal von demjenigen getroffen werden muss, der gerade am Schreibtisch frei ist. Steuerfachleute beschreiben den Sortierschritt in einfacher Sprache als Engpass. Ein Praktiker fragte die r/taxpros-Community, wie andere Kanzleien mit „Scannen, Hochladen und Sortieren von Dokumenten, bevor sie an den Bearbeiter gesendet werden" umgehen, und benannte es direkt: „Das ist derzeit unser Engpass" (r/taxpros). Die am höchsten bewertete Antwort beschrieb den Workaround, auf den sich die meisten Kanzleien einigen: eine Rezeptionistin, die „die Dokumente basierend auf dem Rückfluss der Erklärung sortiert", mithilfe eines Spickzettels, den die Kanzlei für sie erstellen musste.
Das Papier ist auch nicht verschwunden. In einem r/taxpros-Thread von 2025 über die Digitalisierung schätzte eine Kanzlei, die bereits SmartVault neben Lacerte nutzt, dass 80 bis 90 Prozent ihrer Mandanten weiterhin Papier abgeben (r/taxpros). Das ist eine Kanzlei mit bereits vorhandenem Dokumentenmanagement, was auf die eigentliche Form des Problems hinweist: Die Software, die Kanzleien kaufen, hat die Benennung und Weiterleitung automatisiert, aber die Beurteilung ist manuell geblieben.
Man betrachte, was die etablierten Tools tatsächlich tun. SmartVaults SmartRouting liest Metadaten aus UltraTax CS, Drake oder CCH Axcess und legt Erklärungen und Quelldokumente in die richtigen Ordner ab, getrennt nach Kopietyp. Canopy benennt Dateien um und klassifiziert sie nach Typ oder Aussteller mithilfe globaler Regeln. SurePreps 1040SCAN und GruntWorx gehen weiter und übertragen W-2-, 1099- und K-1-Felder in die Erklärung. Jedes davon löst einen echten Schritt. Keines davon beantwortet, ob eine Seite überhaupt zu dieser Erklärung gehört. Diese Frage bleibt dem Sortierer überlassen, weshalb Kanzleien, die die Software gekauft haben, immer noch Spickzettel schreiben.
Triage in eine Spalte verwandeln, dann filtern statt lesen
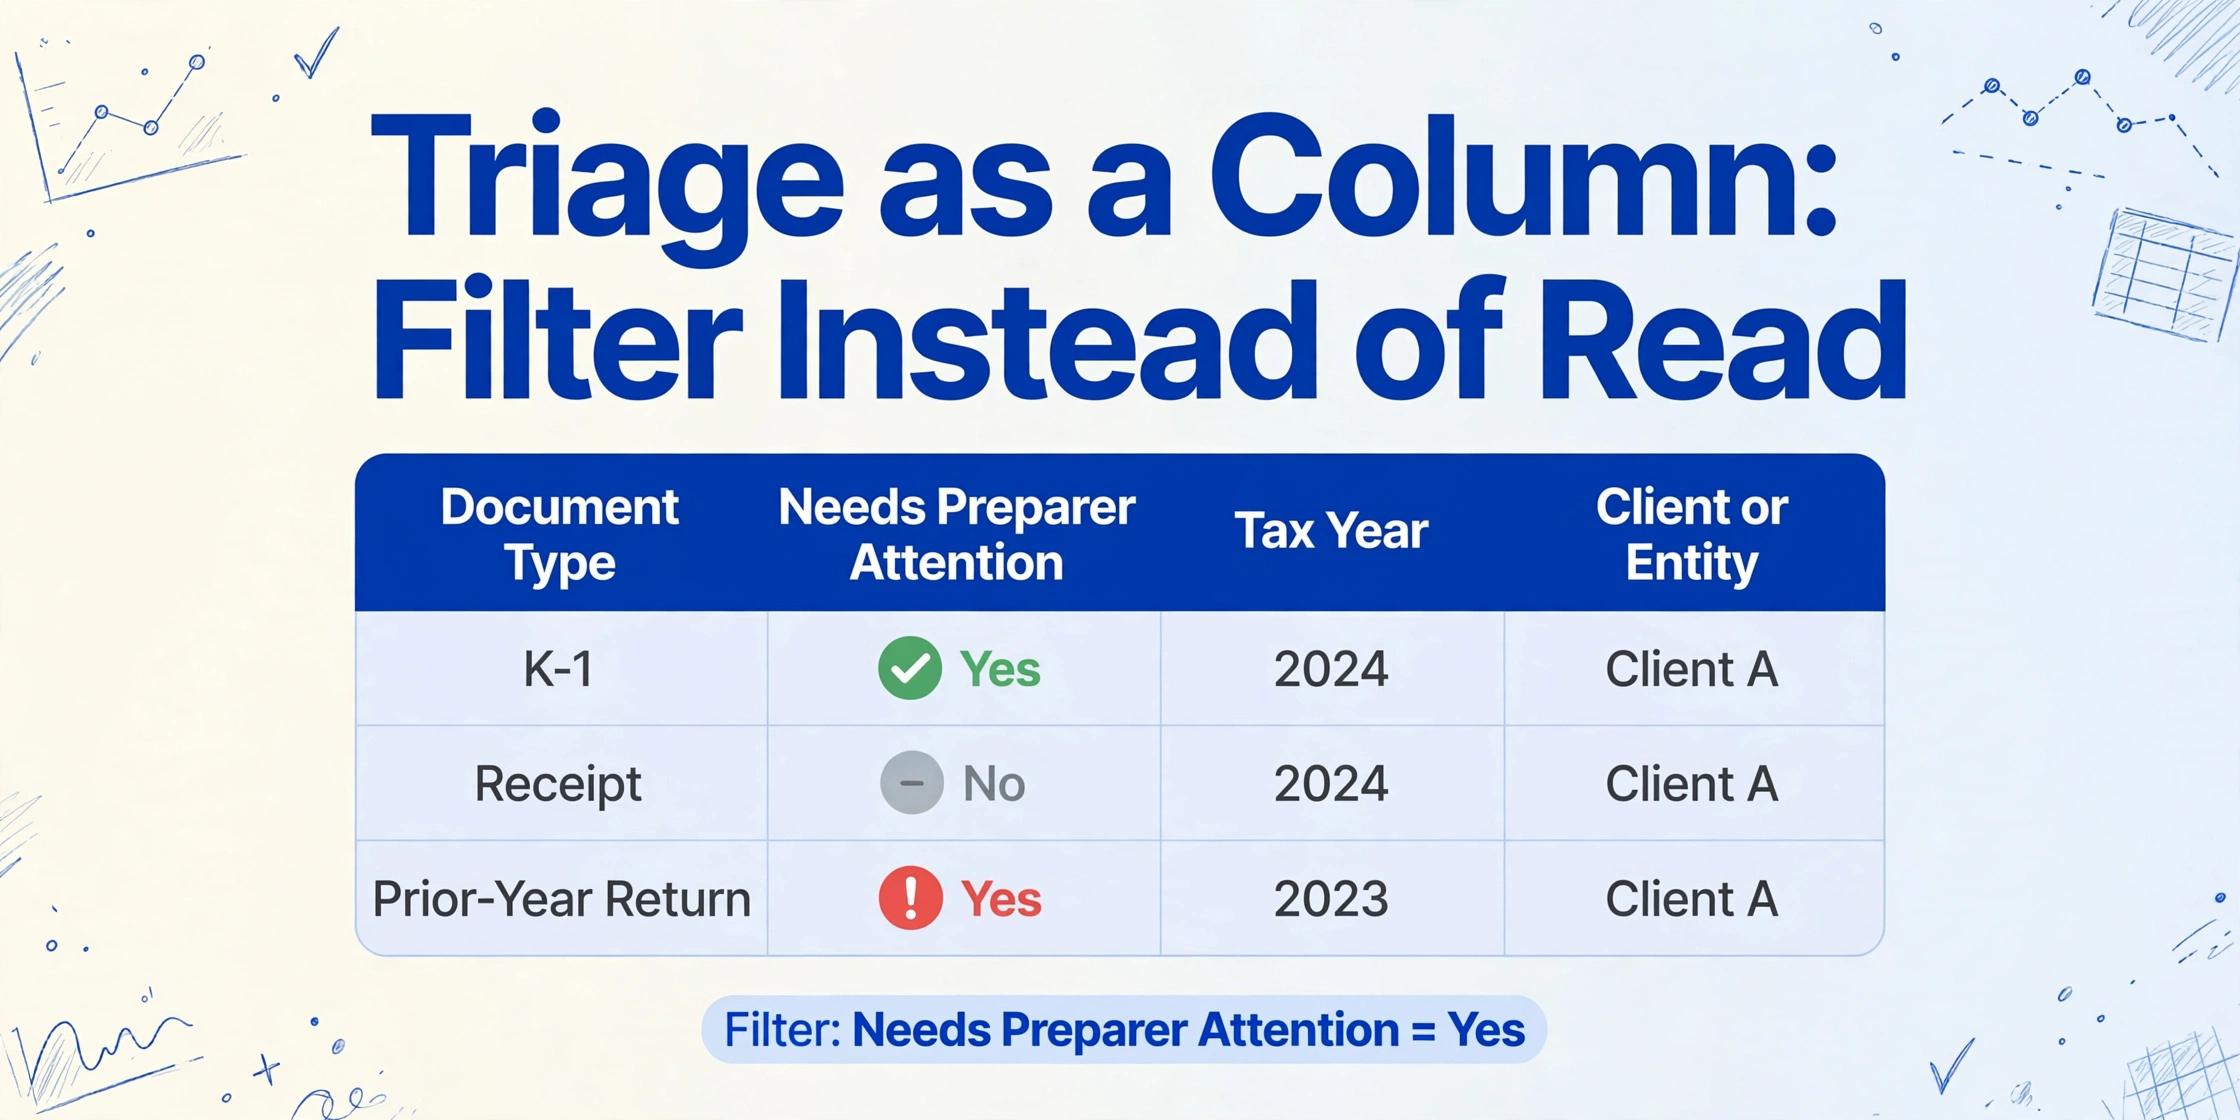
Der Weg, Triage aus dem Kopf einer Person zu holen, besteht darin, sie zu einer Spalte in der Extraktionsausgabe zu machen. Das ist ein anderer Ansatz als die ordnerbasierte Sortierung von Quelldokumenten, die Dokumentenmanagement-Tools verkaufen. Statt zu entscheiden, wohin eine Datei gehört, wird entschieden, was eine Datei ist, diese Entscheidung in eine Tabellenspalte geschrieben und der Bearbeiter filtert danach. Das Urteil wird weiterhin gefällt, aber nur einmal, in einer Form, die das gesamte Team sehen und wiederverwenden kann.
Der Mechanismus, der dies ermöglicht, ist Benutzerdefinierte Spaltenextraktion. Die gewünschten Spaltennamen werden eingegeben, und die KI liest jedes Dokument und füllt den Wert ein, der zu jedem Namen passt – nach Bedeutung, nicht nach Position auf der Seite. Dadurch kann ein Satz von Spaltennamen über eine W-2, einen Kontoauszug und eine fotografierte Quittung im selben Upload hinweg funktionieren, ohne Vorlage pro Format. Der relevante Modus hier ist die abgeleitete Spalte: eine Spalte, deren Wert nirgendwo auf dem Dokument gedruckt ist, aber aus dem Inhalt des Dokuments bestimmt werden kann. Eine Quittung hat kein Feld „Document Type", aber die KI kann sie lesen und entscheiden, dass es eine Quittung ist.
Auf Triage angewendet, ergibt das eine kleine Gruppe von Spalten, die einen Kundenordner in eine Arbeitswarteschlange verwandeln:
Document Type (options: W-2, 1099-INT, 1099-DIV, 1099-B, K-1, Bank Statement, Receipt, Mortgage Interest 1098, Prior-Year Return, Other)Needs Preparer Attention (options: Yes, No)Tax YearClient or Entity
Die erste Spalte klassifiziert jede Seite. Die zweite ist die Triage-Entscheidung selbst, ausgedrückt als Regel, die die KI konsistent anwendet: eine K-1 oder eine 1099 mit Steuerabzug ist ein Yes, ein zwölfmonatiger Kontoauszug zu einer Steuererklärung, die nicht aufgeht, ist ein No. Die letzten beiden Spalten fangen die Fehler falsches Jahr und falsche Entität ab, bevor sie einen Bearbeiter erreichen, denn ein Dokument, das mit 2024 oder einer anderen Entität gekennzeichnet ist, fällt sofort auf, sobald das Blatt sortiert ist.
Da die Verarbeitung Batch-First ist, geht der gesamte Kundenordner auf einmal hinein und kommt als eine Tabelle mit einer Zeile pro Dokument zurück. Triage ist dann keine Leseaufgabe mehr, sondern ein Filter. Der Bearbeiter öffnet das Blatt, filtert Needs Preparer Attention auf Yes und arbeitet die relevanten Zeilen ab. Die Seiten, die nur zur Ablage sind, bleiben im Blatt, weiterhin klassifiziert, weiterhin der Datei zuordenbar – genau das, was die IRS-Anforderung an eine ordentliche Aufbewahrung verlangt. Hier zahlt sich die Klassifizierung auch für Kanzleien aus, die dies in dem Umfang tun, der in unserem Leitfaden zur Dokumentextraktion für Buchhaltungspraxen und in den Argumenten für Extraktionssoftware in Buchhaltungskanzleien beschrieben ist.
Der vollständige Scan-, Klassifizierungs- und Extraktionsaufbau
Der Aufbau besteht aus vier Entscheidungen, und sobald sie getroffen sind, läuft die Triage bei jedem Batch automatisch ab. Keine davon betrifft die Scan-Einstellungen oder Ordnerkonventionen. Sie betreffen alle den Inhalt der Ausgabetabelle.
Den gesamten Kundenordner als einen Batch hochladen
Scans, PDFs und Handyfotos gemeinsam ablegen. Die Batch-Verarbeitung führt sie zu einer einzigen Tabelle zusammen, sodass der Kundenordner kein Stapel mehr ist, sondern eine Reihe von Zeilen. Eine Vorsortierung nach Formulartyp ist nicht erforderlich. Das übernimmt der nächste Schritt.
Die Klassifizierungsspalten definieren
Document Type mit seiner Optionsliste, Needs Preparer Attention, Tax Year und Client or Entity hinzufügen. Die Optionsliste ist der Kernpunkt. Hier lebt das Triage-Vokabular, sodass alle Sortierer dieselben Kategorien anwenden, statt eigene zu erfinden.
Die Wertespalten hinzufügen, die die Steuererklärung tatsächlich benötigt
Hier werden die Zahlen für die tragenden Seiten extrahiert: Name des Zahlers, Kontonummer, Abrechnungszeitraum, Gesamtsumme, einbehaltene Steuern. Ein Kontoauszug, der nur zur Ablage dient, lässt diese Zellen einfach leer, und eine leere Zelle ist ein klares Signal statt einer Vermutung. Für die Beleg-Hälfte des Ordners klassifiziert eine Spalte wie Category (options: Meals, Travel, Office, Other) jeden Beleg im selben Durchlauf.
Filtern, prüfen und übergeben
Der Bearbeiter filtert Needs Preparer Attention auf Yes und arbeitet nur diese Zeilen ab. Das vollständige Blatt, einschließlich der Seiten, die nur zur Ablage dienen, bleibt als Aufzeichnung erhalten. Kehrt derselbe Kunde im nächsten Jahr zurück, wird der Spaltensatz als Vorlage gespeichert und ohne Neuaufbau wiederverwendet.
Dateien werden sicher verarbeitet und nicht gespeichert.
Dasselbe Muster deckt das belegintensive Ende einer Saison ab, wo das Volumen hoch und der Wert pro Dokument niedrig ist – das Szenario hinter der Bündelung von Geschäftsbelegen in einer Steuertabelle. Wenn die gesamte Saison aus W-2- und 1099-Formularen besteht, mündet die Pipeline in dieselbe Idee, behandelt in der W-2- und 1099-Pipeline für die Steuersaison.
Was diese Pipeline weiterhin nicht für Sie entscheiden kann
Drei Dinge bleiben unabhängig von der Spaltenkonfiguration in der Kanzlei. Das erste ist das professionelle Urteilsvermögen selbst. Die Klassifizierungsspalte lenkt die Aufmerksamkeit der Bearbeiter auf die relevanten Seiten, aber ob ein bestimmter Abzug gilt oder ob eine Geschäftsausgabe gewöhnlich und notwendig ist, bleibt eine menschliche Entscheidung. Die Pipeline grenzt ein, wohin die Person schaut. Sie trifft die Entscheidung nicht.
Das zweite ist die Eingabequalität. Ein unscharfes Handyfoto oder ein Scan mit unter etwa 150 dpi kann den Unterschied zwischen einem Datum von 2024 und 2025 verwischen – genau das Feld, von dem die Triage abhängt. Eine Seite mit zwei unzusammenhängenden Formularen, etwa einem K-1 über einem Zahlungsbeleg, kann ein Modell verwirren, das auf eine Zeile pro Dokument ausgelegt ist. Solche Seiten brauchen weiterhin ein menschliches Auge, und der ehrliche Workflow behandelt sie als Prüfkandidaten statt als feste Zeilen.
Das dritte ist der nächste Schritt der Daten. Diese Pipeline exportiert Excel, CSV oder JSON. Sie überträgt nicht selbst in Drake, UltraTax CS, Lacerte oder CCH Axcess und ersetzt nicht das Dokumentenmanagementsystem für Aufbewahrung und Zugriffskontrolle. Die IRS-Aufbewahrungsregeln in Publication 583 und die Schutzpraktiken für Steuerzahlerdaten bleiben in der Verantwortung der Kanzlei, nicht des Tools. Eine tabellenbasierte Schicht hält die extrahierten Daten prüfbar, bevor sie in eine Steuererklärung gelangen, und dieser Prüfschritt ist beabsichtigt.
Häufig gestellte Fragen
Kann die KI einen Kontoauszug von einer Quittung unterscheiden, ohne dass ich vorher sortiere?
Ja. Sie definieren eine Document Type-Spalte mit den Kategorien, die Sie verwenden, und die KI liest den Inhalt jedes Dokuments, um zu entscheiden, welche zutrifft. Sie verlässt sich nicht auf den Dateinamen oder den Ordner, in dem die Datei angekommen ist, sodass ein unbenannter Scan trotzdem klassifiziert wird.
Was passiert mit einem Dokument, das die KI als Other einstuft?
Es erscheint weiterhin als Zeile mit seiner Klassifizierung und seiner Quelle, sodass nichts verschwindet. Eine Other-Zeile ist eine Aufforderung zur Prüfung, entweder weil das Dokument wirklich ungewöhnlich ist oder weil Ihre Optionsliste eine weitere Kategorie benötigt. Der Wert der Spalte liegt darin, dass ungewöhnliche Dokumente auftauchen, statt im Stapel unterzugehen.
Ersetzt das SmartVault, Canopy oder SurePrep?
Nein. Diese Tools übernehmen Speicherung, Weiterleitung und in einigen Fällen das Übertragen von Feldern in die Steuersoftware. Diese Pipeline übernimmt Klassifizierung und Extraktion und erzeugt eine Tabellenkalkulation. Eine Kanzlei kann ihr Dokumentenmanagementsystem für die Aufbewahrung behalten und die Klassifizierungsebene auf den bereits vorhandenen Eingang aufsetzen.
Kann ich den gesamten Ordner eines Mandanten in einem Batch verarbeiten?
Ja. Die Batch-Verarbeitung ist der Standard. Der gesamte Ordner wird gemeinsam verarbeitet und kommt als eine Tabelle mit einer Zeile pro Dokument zurück, was den Triage-Filter praktikabel macht. Die Verarbeitung einzelner Dokumente würde denselben Stapel an anderer Stelle wieder aufbauen.
Wie geht die Triage-Spalte mit einem Dokument um, das für einen Mandanten relevant ist, für einen anderen jedoch nicht?
Die Regel hinter Needs Preparer Attention legen Sie selbst fest, sodass Sie sie in Bezug auf die Steuererklärung statt auf das Dokument formulieren können. Eine Kanzlei, die jeden Kontoauszug abgleicht, würde alle mit Yes markieren. Eine Kanzlei, die nur Schedule-C-Mandanten abgleicht, kann die Markierung an das Vorhandensein von Geschäftseinkünften in derselben Steuererklärung knüpfen. Die Spalte folgt Ihrer Regel konsistent über den gesamten Batch.
Lässt sich die Ausgabe direkt in Drake, UltraTax CS, Lacerte oder CCH Axcess importieren?
Nicht direkt. Die Ausgabe erfolgt als Excel, CSV oder JSON, und Ihre Kanzlei überträgt sie über den bereits genutzten Importpfad in die Steuersoftware. Dieser Schritt bleibt bewusst explizit, damit die extrahierten Daten geprüft werden, bevor sie in die Steuererklärung gelangen.
Der Stapel ist nicht das Problem. Es ist die unausgesprochene Beurteilung, welche Seiten relevant sind – und in dem Moment, in dem diese Beurteilung zu einer Spalte wird, hört der Bearbeiter auf zu sortieren und beginnt mit der Vorbereitung.
Testen Sie es mit einem echten Mandantenordner aus Ihrer letzten Saison, einschließlich der Seiten, die Sie normalerweise nur zur Ablage beiseitelegen würden, und prüfen Sie, ob die Klassifizierungsspalte die tragenden Dokumente an die Spitze der Warteschlange setzt. Testen Sie es mit Ihren eigenen Dokumenten.