Meilleur logiciel de traitement de documents d'assurance
en 2026 : 8 comparés
81,3 milliards de dollars. C'est ce que l'industrie américaine de l'assurance IARD a comptabilisé en frais de règlement des sinistres en 2023, la ligne qui paie les personnes et les systèmes qui lisent, routent et ressaisissent les documents de sinistres, selon le rapport annuel de la NAIC. Rapporté aux 546,2 milliards de dollars de pertes nettes subies cette année-là, environ 15 cents de chaque dollar de sinistre couvrent la paperasse autour du sinistre, pas le sinistre lui-même.
Cette charge de paperasse est sur le point d'entrer en collision avec une main-d'œuvre en contraction. Le Bureau of Labor Statistics prévoit que les emplois de gestionnaire de sinistres, d'expert, d'examinateur et d'enquêteur diminueront de 6 % entre 2025 et 2035, tandis qu'environ 21 600 postes à pourvoir apparaissent chaque année, principalement pour remplacer les départs à la retraite. Le BLS explique la raison clairement : les logiciels peuvent désormais évaluer les photos de dommages et calculer les estimations de sinistres. Le travail documentaire ne disparaît pas ; les personnes qui le faisaient à la main, si.
Les équipes de souscription, de sinistres et de conformité à travers le pays se posent la même question cette année : quel logiciel de traitement de documents d'assurance correspond réellement à notre façon de travailler ? La réponse honnête n'est pas un seul gagnant. C'est une carte de quatre catégories d'outils qui résolvent différentes couches du même problème, et la plupart des synthèses les brouillent. Ce guide sépare les huit outils que vous rencontrerez réellement en ces catégories, les tarifie honnêtement, et vous dit lequel votre équipe devrait présélectionner. Pour un cadre de notation afin de mener votre propre évaluation, notre évaluation de ce qu'un outil d'extraction d'assurance doit couvrir s'associe à la comparaison ci-dessous.
Points clés à retenir
- Huit outils dominent chaque synthèse de traitement de documents d'assurance 2026, mais ils appartiennent à quatre catégories qui résolvent quatre couches différentes du même problème.
- Une précision maximale sur un ACORD 25 propre signifie peu, car le score qui compte est ce qui se passe sur le loss run du prochain assureur ou la soumission scannée qui arrive à 17 h un vendredi.
- Demandez quelle catégorie correspond aux documents que votre équipe a traités la semaine dernière avant de regarder une seule démo, car une inadéquation de catégorie gaspille une année et aucun tableau de fonctionnalités ne vous en avertira.
Pourquoi le traitement des documents d'assurance est une question de catégorie en 2026
Les chiffres de coûts ci-dessus proviennent des propres livres du secteur, mais la douleur quotidienne apparaît dans la façon dont le personnel des agences et des MGA décrit son travail. Une équipe de cinq personnes dans r/InsuranceAgent l'a dit directement : ils ressaisissent encore les mêmes données client dans quatre portails d'assureurs à chaque fois qu'ils établissent un devis commercial, et les démos d'automatisation qu'ils ont vues étaient « de l'IA par-dessus un processus cassé identique ». Une équipe proche des sinistres dans r/automation a mesuré 90 minutes chaque matin rien que pour transcrire les notes d'appels de la veille dans leur système de gestion d'agence, avec des codes postaux erronés et des noms mal orthographiés.
Les documents eux-mêmes sont la raison pour laquelle ce travail reste manuel. Les formulaires ACORD sont standardisés, mais chaque assureur les personnalise ; les loss runs et les pages de déclaration n'ont aucun format commun. Un outil qui extrait un format de manière fiable peut échouer silencieusement sur le suivant.
La vraie décision n'est donc pas « devrions-nous automatiser » mais « quelle catégorie d'outil correspond aux documents que cette équipe traite, dans le volume qu'elle voit réellement ». Les quatre catégories ci-dessous vous donnent ce filtre avant même de regarder une seule démo.
Les quatre catégories d'outils que la plupart des comparatifs confondent
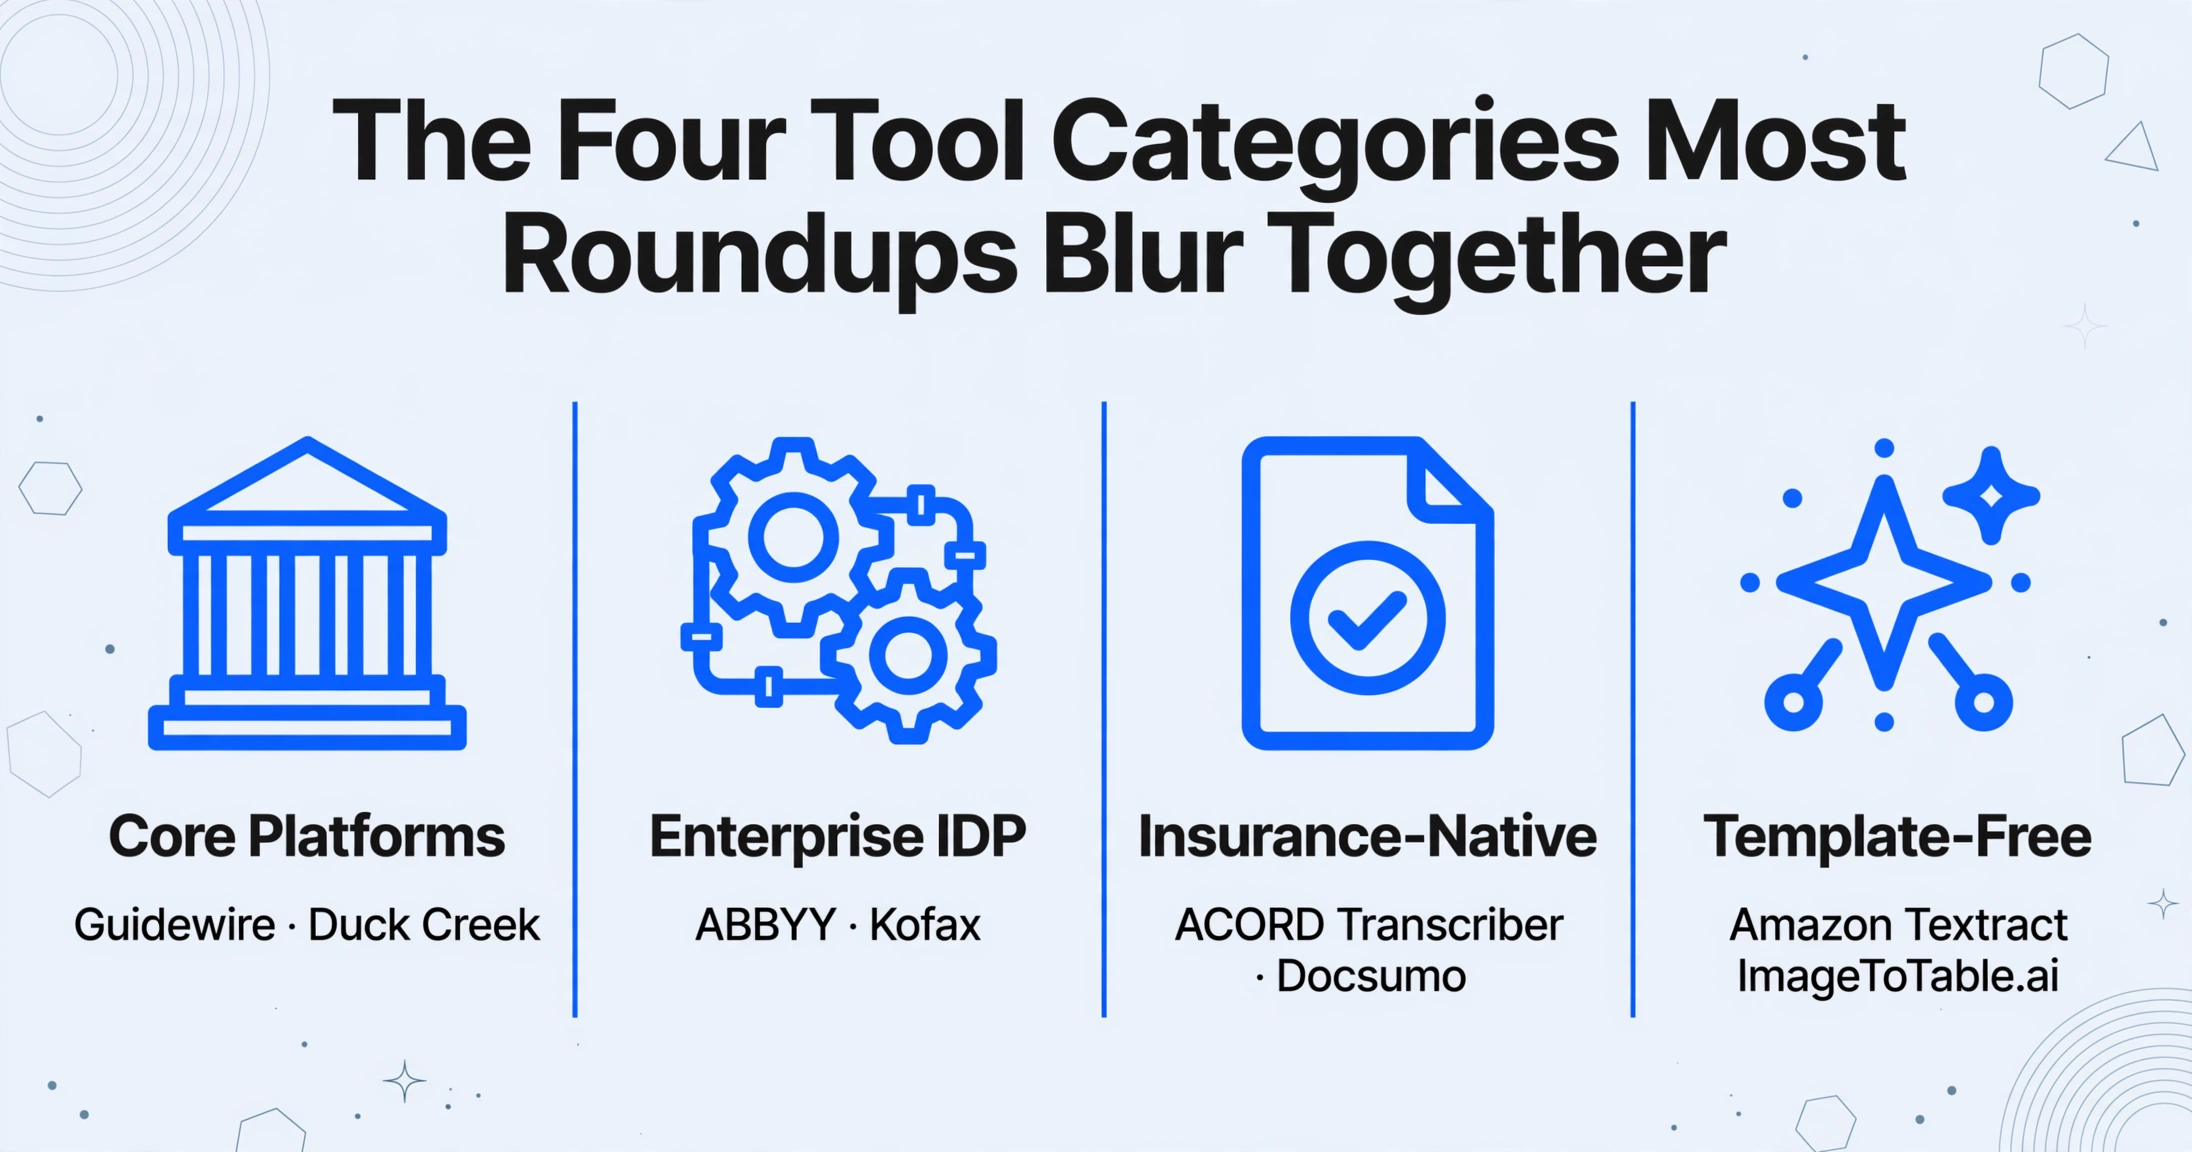
En lisant les premiers résultats pour « meilleur logiciel de traitement de documents d'assurance » en 2026, vous trouverez Guidewire et Duck Creek à côté de plateformes d'extraction, comme s'il s'agissait du même type de produit. Ce n'est pas le cas, et la différence détermine si vous perdez un an dans un mauvais achat.
Plateformes centrales de polices et de sinistres. Guidewire (PolicyCenter, ClaimCenter) et Duck Creek gèrent le cycle de vie des polices, la facturation et les sinistres pour les assureurs. Ils gèrent des enregistrements structurés une fois les données dans le système. Ils ne sont pas conçus pour lire des documents entrants hétérogènes, et ils portent des licences entreprise non publiées. Vous les achetez parce que vous avez besoin d'une administration des sinistres ou des polices, pas parce que vous avez besoin de transformer des documents en feuilles de calcul.
Traitement intelligent de documents (IDP) d'entreprise. ABBYY Vantage et Kofax (désormais Tungsten Automation) TotalAgility combinent OCR, classification de formulaires, extraction, validation et routage de flux de travail. Ce sont les plus complets, les plus chers et les plus lents à déployer, nécessitant généralement une équipe informatique et des semaines à des mois de configuration. Ils conviennent aux grands assureurs disposant d'opérations documentaires dédiées.
Spécialistes de l'extraction natifs assurance. ACORD Transcriber, issu de la branche solutions d'ACORD, et Docsumo construisent des modèles pré-entraînés autour des familles de formulaires d'assurance telles que ACORD 25 et 125. Ils atteignent une extraction précise sur les formulaires connus plus rapidement que les plateformes généralistes, au prix d'un modèle par type de document : les nouveaux formats nécessitent des échantillons ou un réentraînement.
Extraction sémantique sans modèle. Amazon Textract et ImageToTable.ai extraient en comprenant ce qu'un champ signifie plutôt que sa position sur la page, donc aucun modèle ni jeu d'entraînement n'est nécessaire par mise en page. Textract est une API développeur que vous assemblez dans votre propre pipeline. ImageToTable.ai est l'extrémité sans code de la même idée : vous saisissez les noms de colonnes souhaités et l'IA trouve ces valeurs sur chaque fichier. C'est la catégorie dans laquelle se situe notre propre produit, et nous le notons ouvertement plutôt que de prétendre être un évaluateur neutre.
Les agences ajoutent une couche de plus à cette carte : les systèmes de gestion d'agence dans lesquels elles travaillent, Applied Epic, Vertafore AMS360, EZLynx et leurs pairs. Ces systèmes génèrent des formulaires ACORD à partir des données que vous saisissez. Ils n'extraient pas de données des PDF provenant de l'extérieur. Une couche d'extraction générique distincte est ce que notre tour d'horizon 2026 des outils d'extraction de données documentaires couvre pour le côté non-assurance de ce travail.
Le spectre documentaire qui détermine le choix de l'outil
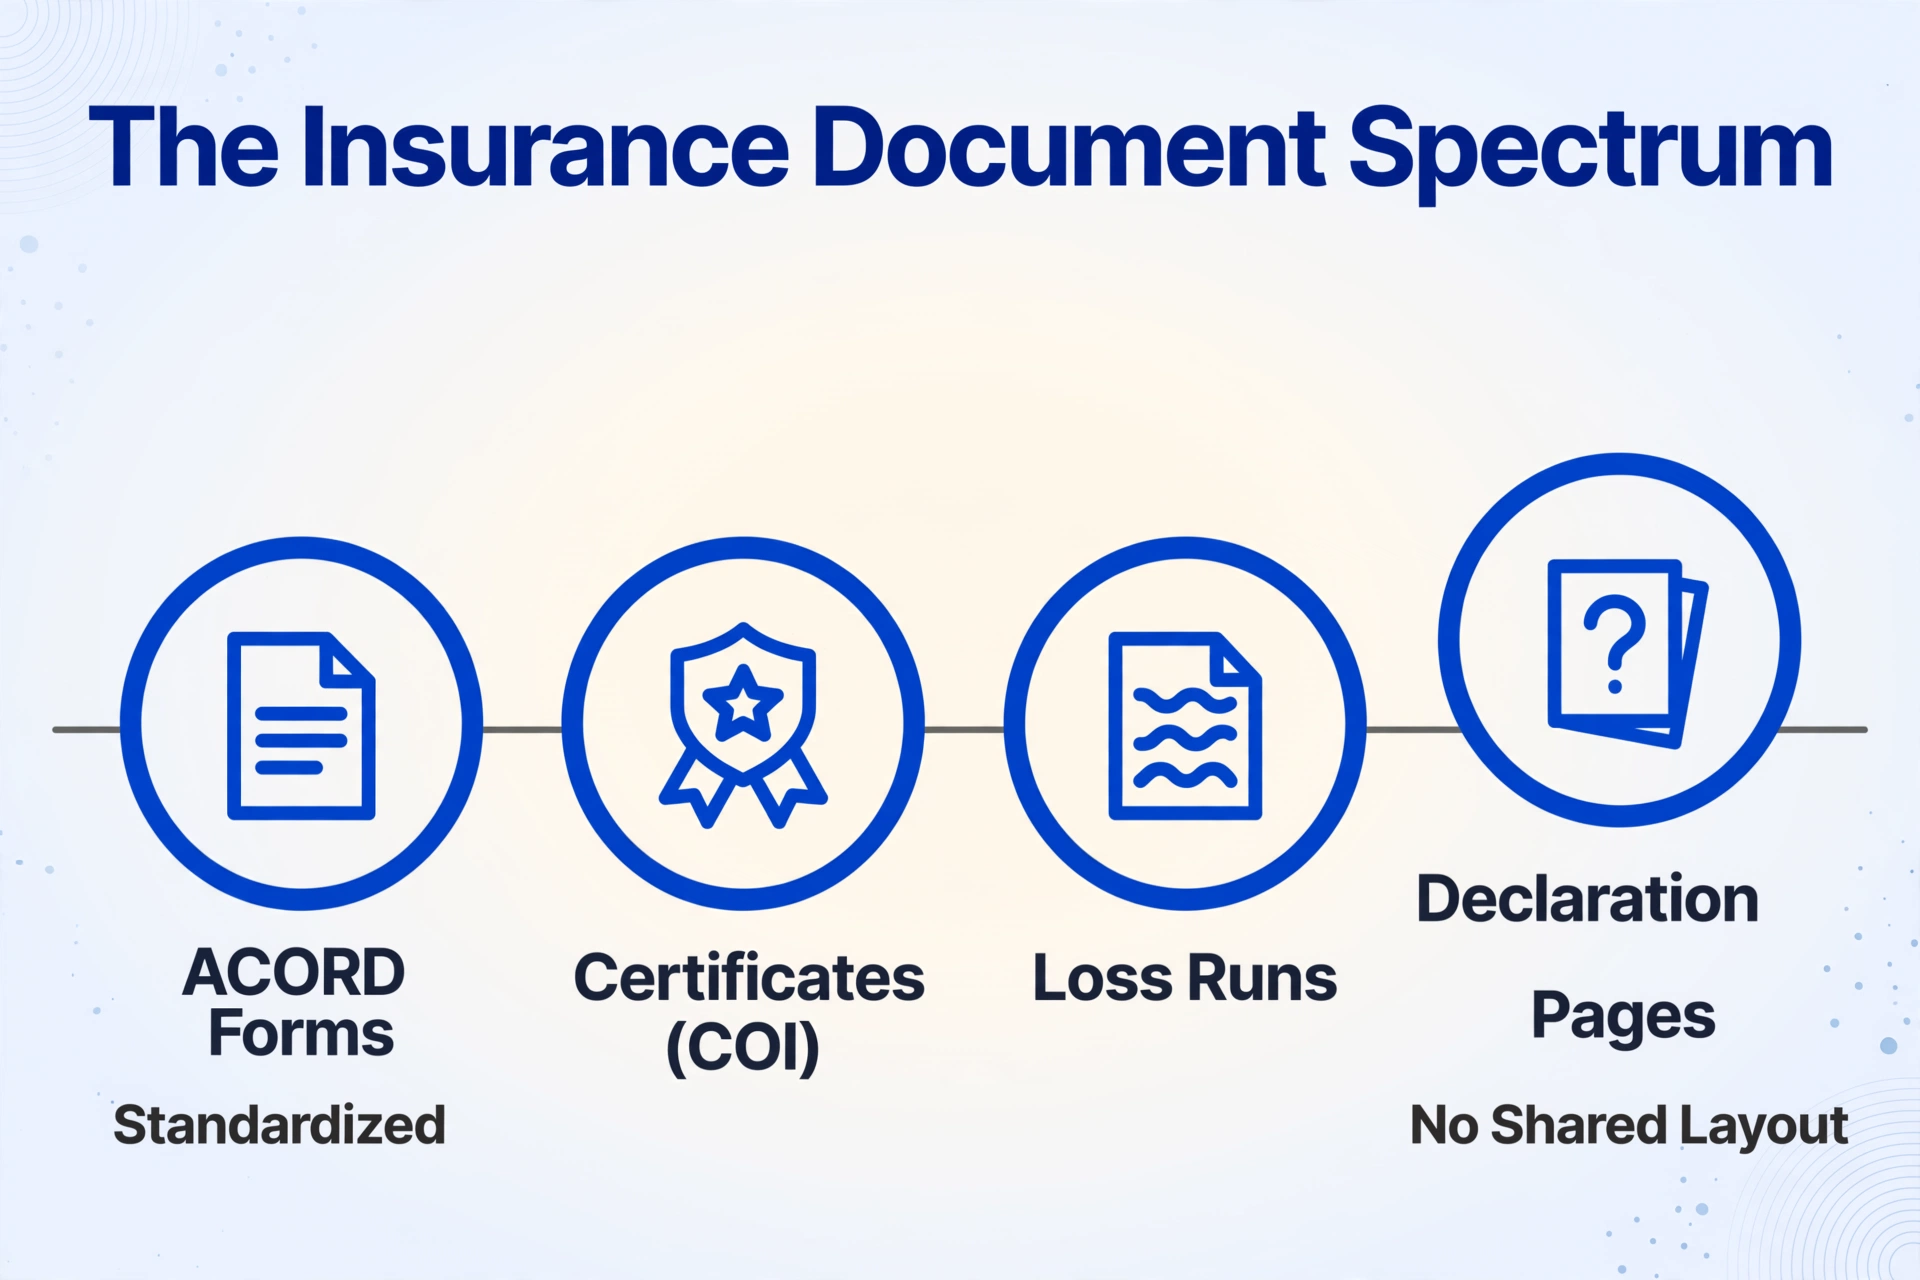
Les documents d'assurance se situent sur un spectre de standardisation, et la position d'un document sur ce spectre vous indique quelle catégorie d'outil peut le traiter.
Les formulaires ACORD sont l'extrémité standardisée. L'Association for Cooperative Operations Research and Development publie des formulaires standard depuis sa première parution en 1971, et sa bibliothèque couvre désormais plus de 850 formulaires utilisés aux États-Unis et dans plus de 100 pays, selon la bibliothèque de formulaires d'ACORD. Ceux que vous voyez quotidiennement : ACORD 25 (certificat d'assurance de responsabilité, le COI indiquant les limites de responsabilité civile générale, automobile, parapluie et accidents du travail), ACORD 27 et 28 (preuve d'assurance des biens, les versions que les prêteurs préfèrent souvent), ACORD 125/126 (demande commerciale et responsabilité civile générale), ACORD 130 (accidents du travail) et ACORD 140 (biens). Standard ne signifie pas uniforme en pratique : les assureurs impriment leurs propres éditions, les États ajoutent des versions, et ACORD dépose elle-même des révisions de formulaires auprès des départements d'assurance des États. Les équipes qui suivent les certificats connaissent cet écart de première main. Un ACORD 25 avec avenant assuré supplémentaire ne mentionne pas « assuré supplémentaire » à un endroit fixe, et un ACORD 27 requis pour la conformité du prêteur arrive d'un assureur différent à chaque fois.
Deux faits sur ACORD façonnent toute évaluation d'outil. Premièrement, un certificat d'assurance n'est pas une police : il indique les limites de couverture déclarées à un moment donné et ne modifie pas les conditions de la police. L'extraction vous dit ce que le formulaire indique ; elle ne peut pas vous dire si la couverture est réellement en vigueur. Deuxièmement, l'extraction de données des formulaires ACORD à des fins commerciales nécessite une licence. ACORD gère un abonnement d'extraction de données de formulaires pour les fournisseurs que tout outil travaillant à grande échelle est censé détenir. Cela vaut la peine de le demander lors de tout appel commercial.
Les loss runs et les pages de déclaration se situent à l'extrémité non structurée. Un loss run est le rapport d'historique de sinistres propre à l'assureur : numéro de sinistre, date du sinistre, statut, montant payé, réserves et total subi à une date d'évaluation donnée, couvrant normalement cinq ans d'historique. Les souscripteurs considèrent le montant subi (payé + réservé) comme le chiffre qui détermine le prix du compte, et un rapport avec une date d'évaluation de plus de 90 jours est renvoyé. Rien de tout cela n'est standardisé entre les assureurs, donc un loss run d'un assureur ne partage aucune mise en page visuelle avec celui d'un autre. Les pages de déclaration, les résumés de police d'une page listant l'assuré désigné, la période de police, les couvertures et les primes, sont tout aussi propres à l'assureur, aucune ne ressemble à une autre. Dans le flux de travail d'extraction de sinistres et les formulaires FNOL qui ouvrent un sinistre, la même combinaison s'applique : champs de formulaire standardisés en haut, mise en page variable selon l'assureur en dessous.
Ce spectre est l'argument principal en faveur de l'extraction sémantique sans modèle en assurance : les formulaires ACORD varient selon l'édition et l'assureur, et les loss runs et pages de déclaration n'ont aucun modèle de référence.
Comparaison rapide : 8 options de traitement de documents d'assurance
| Outil | Catégorie | Modèle tarifaire | Idéal pour |
|---|---|---|---|
| Guidewire | Plateforme centrale (police/sinistres) | Licence entreprise, non publique | Assureurs gérant sinistres et polices dans un système connecté unique |
| Duck Creek | Plateforme centrale (police/facturation/sinistres) | SaaS entreprise, non public | Assureurs s'appuyant sur une suite centrale natif cloud |
| ABBYY Vantage | IDP d'entreprise | Devis personnalisé entreprise | Grands assureurs avec besoins sur site et compétences pré-construites |
| Kofax (Tungsten) TotalAgility | IDP d'entreprise + flux de travail | Devis personnalisé entreprise | Capture à haut volume avec routage et approbations |
| ACORD Transcriber | Natif assurance (propre à ACORD) | Abonnement, contacter le fournisseur | Entreprises vivant dans les formulaires ACORD qui doivent aussi les remplir |
| Docsumo | IDP d'assurance | Essai gratuit, abonnement à l'usage | Équipes de taille moyenne avec types de documents et règles de validation définis |
| Amazon Textract | API cloud sans modèle | Paiement à la page (1,50 $ pour 1 000 textes ; 15 $ tableaux ; 50 $ formulaires) | Équipes d'ingénierie construisant leur propre pipeline AWS |
| ImageToTable.ai | Sémantique sans modèle (sans code) | Gratuit pour essayer ; à partir de 9 $/mois | Équipes de souscription, sinistres et conformité qui veulent une extraction définie par colonnes sans modèles ni formation |
Les tarifs sont ceux que le fournisseur publie ou indique publiquement en septembre 2026. Lorsqu'un montant est un devis personnalisé plutôt qu'un prix catalogue, ce tableau le précise au lieu de deviner.
1. Guidewire : idéal pour les assureurs qui construisent une base connectée sinistres et polices
Idéal pour : les assureurs qui utilisent PolicyCenter et ClaimCenter ensemble et souhaitent centraliser sinistres, polices, facturation et documentation dans un système gouverné. Pas idéal pour : les agences, les MGA ou les opérations de taille intermédiaire qui cherchent un outil d'extraction de documents ; et ce n'est pas un substitut pour lire des brochures, certificats et soumissions hétérogènes entrants et les convertir en données structurées.
Guidewire est la référence en administration des sinistres et des polices en assurance IARD, déployé dans plus de 30 pays selon ses pages produit. Son ClaimCenter gère la réception, le flux de travail, le provisionnement et le règlement de manière native. La capture de documents externes désordonnés n'est pas le cœur de ClaimCenter : les assureurs sur Guidewire l'associent généralement à une couche d'extraction ou à un partenaire marketplace pour l'étape de réception. La tarification est une licence entreprise, non publiée.
2. Duck Creek : idéal pour les suites polices et sinistres natif cloud
Idéal pour : les assureurs qui veulent polices, facturation, tarification et sinistres sur une suite SaaS unique hébergée sur Azure avec un traitement direct configurable. Pas idéal pour : les mêmes organisations que Guidewire : c'est une décision de plateforme centrale qui se mesure en mois, pas un achat de documents vers feuilles de calcul.
Duck Creek positionne son produit sinistres autour de l'affectation automatique, de la vérification de couverture et des flux de travail FNOL, avec plus d'un millier de règles métier préconfigurées. Il gère les sinistres à l'intérieur de sa suite ; les documents entrants de l'extérieur nécessitent toujours une couche de réception et d'extraction. La tarification est un SaaS entreprise, non publiée.
3. ABBYY Vantage : idéal pour les grands assureurs avec traitement sur site ou basé sur les compétences
Idéal pour : les grandes opérations avec une DSI dédiée qui veulent de l'OCR-plus-sémantique sur une plateforme avec une gestion approfondie des formulaires et un déploiement sur site. Pas idéal pour : les équipes sans capacité informatique. Le déploiement de Vantage prend des semaines à des mois, et la tarification se fait sur devis personnalisé entreprise.
ABBYY a apporté des décennies d'ingénierie OCR dans les « compétences » de Vantage : des modèles pré-entraînés pour les types de documents courants, y compris les formulaires d'assurance, que vous déployez et combinez. Ses marketplaces et connecteurs sont matures, et les exigences de résidence des données sont son terrain de prédilection. Le compromis réside dans l'effort de configuration par type de document et un investissement de mise en œuvre qui n'a de sens qu'à volume réel.
4. Kofax (Tungsten) TotalAgility : le meilleur choix pour la capture à haut volume avec routage des flux de travail
Idéal pour : les assureurs qui ont besoin de capture de documents et d'automatisation des processus sur une seule plateforme, avec réception type courrier, classification, routage et transferts d'approbation. Moins adapté à : aux petites structures ; c'est une plateforme d'entreprise avec des tarifs personnalisés et des projets longs.
TotalAgility est déployé dans l'assurance depuis plus d'une décennie comme moteur de capture et d'automatisation de contenu. Il excelle dans la classification et le routage plutôt que dans l'extraction par modèle de langage la plus récente, aussi les équipes le combinent avec des services d'extraction IA lorsque des documents vraiment désordonnés dominent. Tarification d'entreprise personnalisée.
5. ACORD Transcriber : le meilleur choix quand vous vivez entièrement dans les formulaires ACORD
Idéal pour : les organisations qui doivent à la fois lire et remplir la famille de formulaires ACORD, puisque Transcriber gère l'extraction et le remplissage des formulaires à partir de la même bibliothèque. Moins adapté à : aux équipes dont les documents sont principalement des loss runs, des pages de déclaration ou des formulaires propres à l'assureur, où son avantage natif des formulaires compte moins.
ACORD Solutions, la branche commerciale de l'organisme de normalisation, décrit Transcriber comme extrayant des données structurées de plus de 800 formulaires ACORD répartis sur plus de 4 700 versions, avec des contrôles humains dans la boucle sur les extractions à faible confiance et une intégration API d'abord. Comme la norme source vit dans la même organisation, la couverture des versions de formulaires est son avantage le plus profond. La tarification est par abonnement, contactée directement.
6. Docsumo : le meilleur choix pour les équipes mid-market sur des types de documents d'assurance définis
Idéal pour : les équipes qui traitent un ensemble stable de types de documents, comme les formulaires ACORD 25/26/125/126 et les certificats, où les modèles pré-entraînés et les règles de validation réduisent le temps de mise en place. Moins adapté à : aux flux de travail qui rencontrent une nouvelle mise en page chaque semaine ; sa propre FAQ indique que les types de documents personnalisés sont entraînés sur vos échantillons, à partir de 20 seulement.
Docsumo publie des modèles prêts à l'emploi pour les formulaires ACORD courants et une couche de routage basé sur la confiance qui envoie les champs à faible confiance vers une file de révision humaine, ce qui convient aux opérations sensibles à la conformité. La tarification est communiquée par plan et par volume plutôt que détaillée sur le site. Cette exigence d'entraînement est la limite honnête : formulaires connus, rapides ; nouvelles mises en page, un projet de collecte d'échantillons.
7. Amazon Textract : idéal pour les équipes d'ingénierie qui construisent un pipeline personnalisé
Idéal pour : les développeurs qui souhaitent une extraction au paiement à la page sur AWS avec tableaux, formulaires, paires clé-valeur et une API Queries, et qui construiront eux-mêmes le pipeline autour. Pas idéal pour : les équipes opérationnelles sans support d'ingénierie : il n'y a pas d'interface produit, et vous assemblez vous-même la classification, le stockage, la révision et la livraison.
La tarification de Textract est la plus transparente ici. AWS publie des tarifs à la page : environ $1.50 pour 1 000 pages de texte brut, $15 pour 1 000 tableaux, et $50 pour 1 000 formulaires en extraction clé-valeur au niveau standard, avec un niveau gratuit d'évaluation. Il fonctionne bien sur les formulaires imprimés propres, et comme chaque outil de cette liste, il se dégrade sur les scans et les mises en page denses, que votre pipeline doit contourner.
8. ImageToTable.ai : idéal pour l'extraction par colonnes définies sans modèle ni entraînement
Divulgation : ImageToTable.ai est le produit sur lequel cet article est publié, considérez donc cette section comme une description du fournisseur plutôt qu'un avis indépendant. Chaque capacité ci-dessous provient de l'ensemble de fonctionnalités documenté, et les limites sont indiquées dans la section des limites.
Idéal pour : les équipes de souscription, de réception des sinistres et de suivi des certificats qui veulent saisir les colonnes dont elles ont besoin et laisser l'IA trouver ces valeurs sur chaque fichier, quelle que soit la mise en page. Pas idéal pour : les entreprises qui exigent un déploiement sur site, une infrastructure SOC 2 dédiée, ou des connecteurs natifs vers Guidewire, Duck Creek ou les systèmes de gestion d'agence. Il extrait des données ; il n'écrit pas dans votre système central.
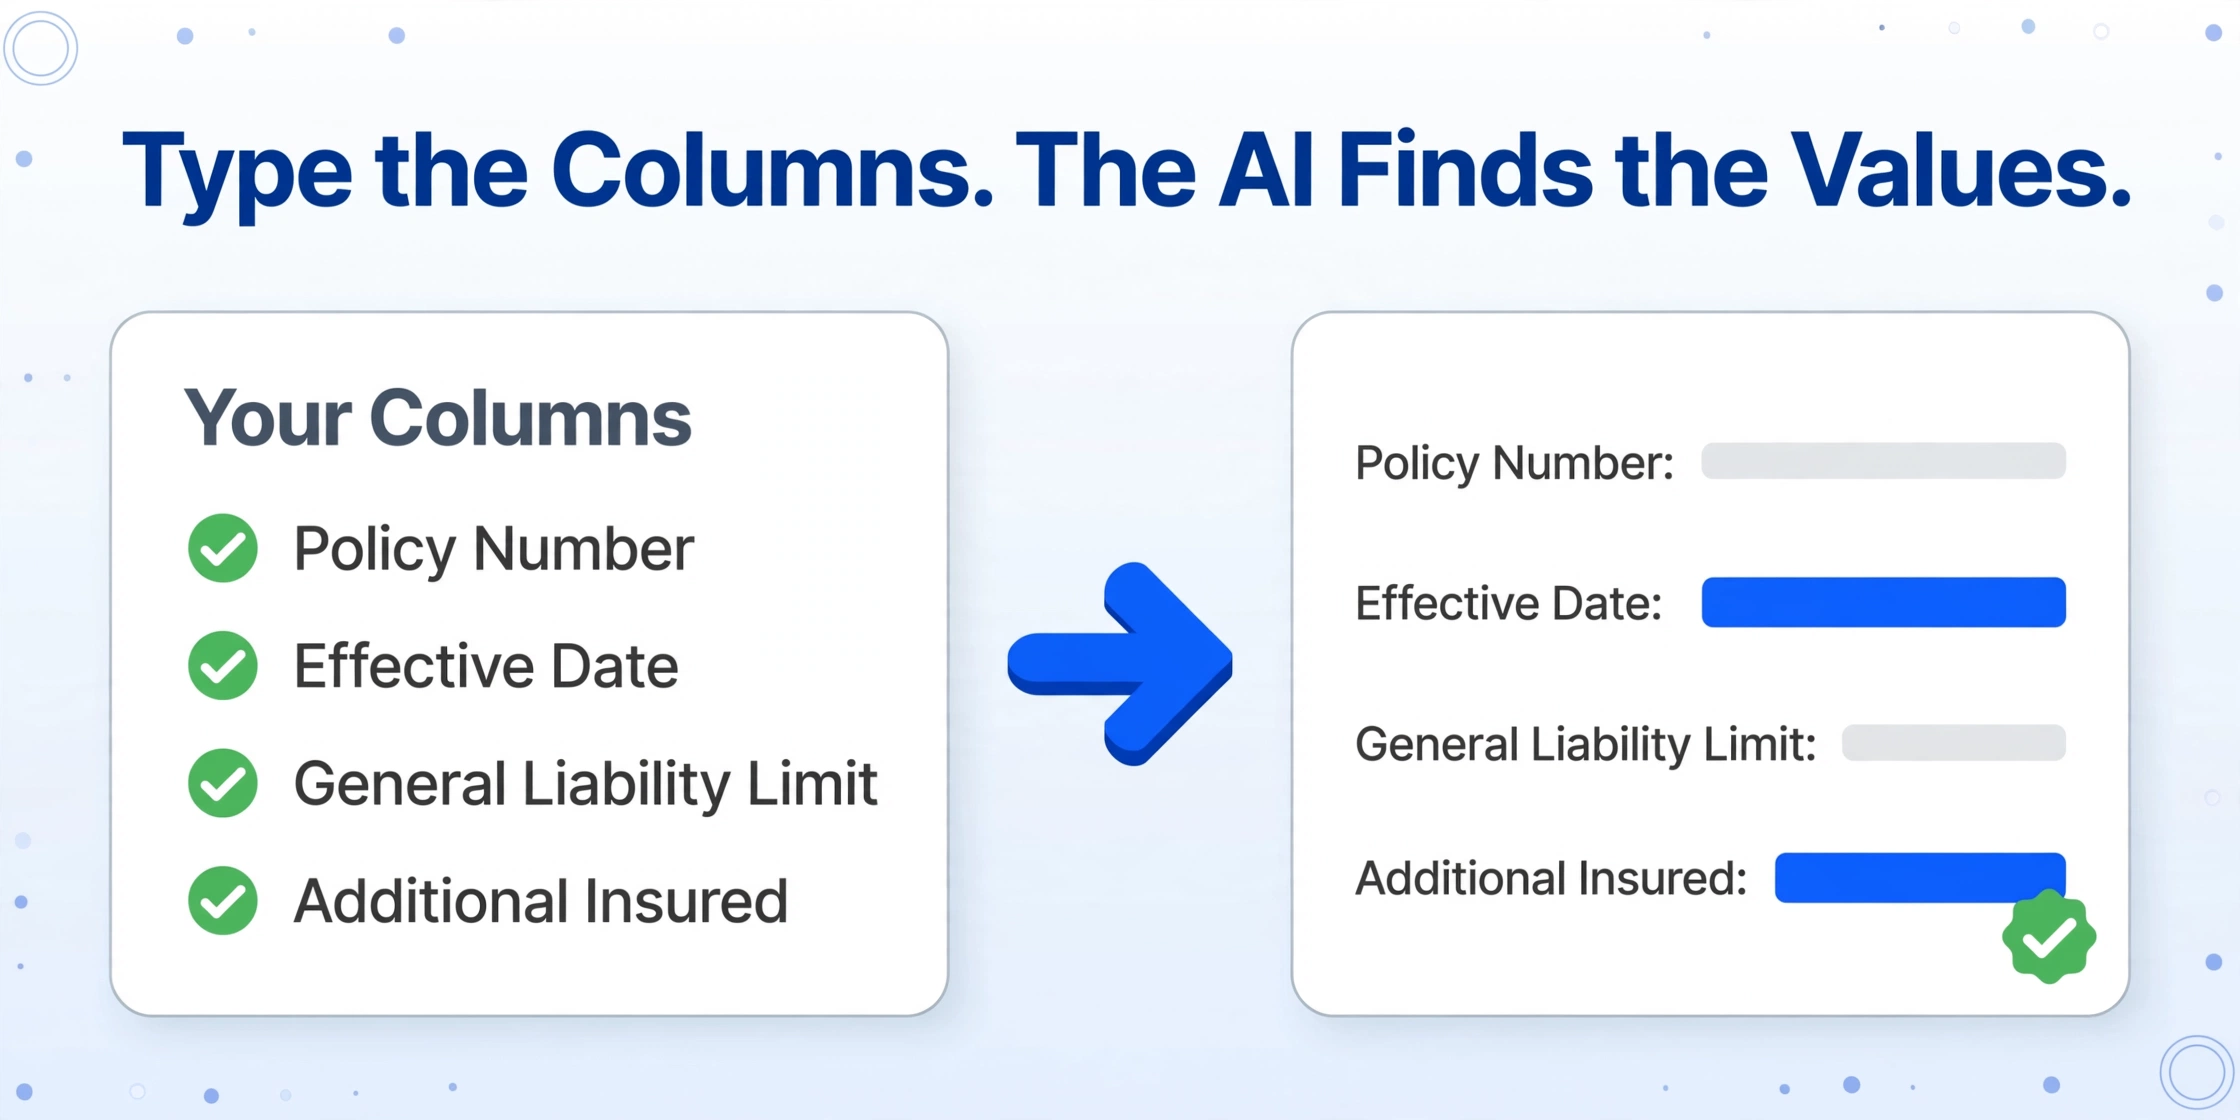
ImageToTable.ai utilise l'extraction de colonnes personnalisées : vous définissez les colonnes de sortie, comme « numéro de police », « date d'entrée en vigueur », « limite de responsabilité civile générale », « assuré supplémentaire », « date du sinistre », « montant payé », « réserves » ou « date d'évaluation », et un modèle de langage visuel localise les valeurs correspondantes sur chaque page par le sens, et non par coordonnées. Comme la correspondance est sémantique, le même ensemble de colonnes qui fonctionne sur un ACORD 25 fonctionne aussi sur un ACORD 28, une page de déclaration propre à l'assureur, ou un loss run d'un autre assureur. Aucun modèle à maintenir, aucun échantillon d'entraînement à étiqueter. Pour une présentation complète des mécanismes de noms de colonnes sur les documents d'assurance, la série sur la transformation des données de certificats en Excel et sur les formulaires de sinistre FNOL en feuilles de calcul montre la configuration en pratique.
Le traitement par lots, c'est là que l'outil montre toute sa valeur. Téléchargez un dossier de certificats ou une saison de loss runs, appliquez un ensemble de colonnes, et recevez un classeur Excel unique avec une ligne par document. Les colonnes calculées effectuent des opérations arithmétiques pendant l'extraction, par exemple une colonne qui affiche la différence lorsque le total payé sur un loss run ne correspond pas au montant subi, ou un total de ligne à partir des champs quantité et taux. Le mode de révision avec surbrillance de la boîte englobante vous permet de cliquer sur n'importe quelle cellule et de voir exactement d'où vient cette valeur sur l'image d'origine, ce qui constitue l'étape de vérification dont une équipe de conformité a besoin avant de faire confiance à l'extraction. Pour collecter des fichiers auprès de nombreux fournisseurs ou courtiers, un lien de collecte permet à chacun de téléverser dans votre file d'attente sans avoir de compte. Le prix démarre à 9 $/mois pour le niveau de base, avec un niveau gratuit pour tester sur vos propres documents.
Les fichiers sont traités en toute sécurité et ne sont pas stockés. Téléversez un vrai certificat ou un formulaire ACORD et voyez les colonnes extraites que vous définissez atterrir dans un tableau.
Comment choisir selon votre rôle : souscription, sinistres, conformité, agence
Le bon outil est celui qui correspond au mélange de documents que votre rôle traite réellement, le filtre diffère donc selon l'équipe.
Souscription et réception des soumissions (MGA, courtiers grossistes). Votre mélange quotidien est composé de demandes ACORD, de loss runs, de relevés de valeurs et de packs de certificats arrivant par e-mail et portail, chacun avec une mise en page légèrement différente. Le goulot d'étranglement est la reformatage des mêmes champs de soumission entre les assureurs, une plainte que les courtiers grossistes expriment ouvertement sur r/InsuranceAgent. L'extraction sémantique sans modèle avec traitement par lots et un lien de collecte pour les soumissions entrantes correspond d'abord à ce besoin. Si vous devez également remplir des formulaires ACORD à partir de votre système, ACORD Transcriber entre en jeu.
Opérations de sinistres (FNOL, EOB, rapports de police, devis de réparation). Le volume et la variété des canaux dominent : pièces jointes par e-mail, portails et scans. Une couche d'extraction qui accepte les fichiers par e-mail ou lien, fonctionne par lots et offre aux réviseurs un parcours de vérification par boîte englobante atteint le niveau de précision sans bureau de révision à chaque étape du flux de travail. Notre guide d'extraction des sinistres d'assurance cartographie ce flux de travail de bout en bout.
Conformité et suivi des certificats (entrepreneurs généraux, gestionnaires immobiliers, titulaires de certificats). La difficulté est bien documentée par les gestionnaires immobiliers sur r/PropertyManagement : le COI d'un fournisseur a expiré trois semaines avant que quiconque ne le remarque. La solution est une feuille de calcul qui traite les certificats comme des échéances, avec une ligne par fournisseur contenant le type de couverture, les limites, la date d'expiration et un statut, alimentée par l'extraction de chaque nouveau certificat. Notre guide sur l'extraction de certificats pour les examens de diligence raisonnable couvre le volet diligence du même problème.
Agences alimentant un AMS. Si vous utilisez Applied Epic, AMS360 ou EZLynx, la direction de génération ACORD est déjà automatisée par l'AMS. La direction inverse, faire entrer les PDF entrants dans le système, est là où l'extraction certificat-vers-feuille de calcul s'insère avant la saisie manuelle.
Quel que soit votre rôle, effectuez six vérifications avant de vous engager : quels types de documents et quels volumes décrivent votre mois réel ; si l'outil tolère la dérive de mise en page que vos assureurs produisent réellement ; où se trouve l'étape de révision humaine ; comment les données extraites quittent l'outil ; quel est le prix à votre volume réel plutôt qu'au niveau de démonstration ; et si le fournisseur détient une licence d'extraction ACORD si vous traitez des formulaires ACORD à grande échelle.
La mesure qui sépare les outils en assurance n'est pas la précision maximale sur un ACORD 25 propre. C'est ce qui arrive à la précision sur le loss run du prochain assureur, la prochaine édition du formulaire et la soumission scannée qui arrive à 17 h un vendredi.
Ce qu'aucun de ces outils ne fait (y compris le nôtre)
L'automatisation a un plafond honnête, et les données du secteur le dessinent. Dans une enquête de 2023 du groupe de travail NAIC auprès de 194 assureurs habitation, 104 ont déclaré utiliser l'IA et l'apprentissage automatique dans les sinistres, mais seules deux sociétés ont déclaré des modèles qui déterminent un montant du règlement (voir le rapport NAIC Home Survey Team). La technologie est utilisée pour lire et router des documents, pas pour décider de la valeur d'un sinistre.
- Aucun outil de cette liste ne statue sur les sinistres, ne constitue des réserves ou ne décide de la couverture. Ces tâches restent humaines, et le résultat d'extraction alimente la décision plutôt que de la prendre.
- Aucun de ces outils ne remplace Guidewire, Duck Creek ou un AMS. Ils se placent devant le système d'enregistrement. ImageToTable.ai ne propose pas de connecteur de système central prêt à l'emploi ; l'export CSV, Excel ou JSON est le transfert.
- Les verdicts inter-documents sont hors de portée. Rapprocher l'historique des sinistres sur une demande ACORD avec les loss runs réels, sinistre par sinistre, est une tâche de jugement. Nos colonnes calculées effectuent des calculs arithmétiques dans les lignes extraites, comme une différence payé vs subi sur un seul loss run. Elles ne comparent pas les champs entre des documents séparés et ne déclarent pas de correspondances.
- Chaque outil se dégrade sur les scans de mauvaise qualité et l'écriture manuscrite. La conversation honnête avec tout fournisseur porte sur le niveau de qualité des documents qui perturbe le flux de travail, et nos niveaux de modèle existent précisément parce que le traitement standard et l'écriture manuscrite dense sont des tâches différentes.
FAQ
Quel est le logiciel de traitement de documents d'assurance le moins cher ?
Si vous avez des capacités d'ingénierie, Amazon Textract est le moins cher à grande échelle, environ 1,50 $ pour 1 000 pages de texte brut, mais vous payez pour le pipeline que vous construisez autour. Sans ingénierie, ImageToTable.ai commence à 9 $/mois. Les plateformes IDP d'entreprise (ABBYY, Kofax) et les plateformes centrales (Guidewire, Duck Creek) proposent des tarifs personnalisés qui n'ont de sens qu'aux volumes d'un assureur.
Le logiciel de traitement de documents d'assurance remplace-t-il Guidewire ou Duck Creek ?
Non, c'est l'inverse. Guidewire et Duck Creek sont les systèmes d'enregistrement qui gèrent les polices et les sinistres une fois les données structurées. Les outils d'extraction les alimentent. Acheter une plateforme centrale pour résoudre la réception de documents, ou s'attendre à ce qu'un outil d'extraction gère votre flux de travail de sinistres, échoue pour la même raison : les couches sont différentes.
Ces outils peuvent-ils extraire les formulaires ACORD sans modèle ?
Seule la catégorie sans modèle le peut vraiment. Les outils natifs assurance et IDP d'entreprise fournissent des modèles pré-entraînés pour les formulaires ACORD courants, mais une nouvelle édition d'assureur ou une version d'État nécessite un réentraînement ou une configuration. L'extraction sémantique sans modèle définit les champs souhaités une seule fois et les fait correspondre par signification à travers les éditions, c'est pourquoi elle existe en premier lieu.
Quelle est la précision de l'extraction sur les loss runs et les pages de déclaration ?
La précision varie selon la qualité des scans, et aucun fournisseur ne peut honnêtement promettre un chiffre unique pour l'ensemble. La différence pratique entre les outils est la cohérence : l'extraction sémantique reste beaucoup plus stable à travers les mises en page des assureurs que la correspondance de modèles, et une couche de révision de type boîte englobante vous permet de vérifier les valeurs importantes au lieu de relire chaque page. Testez sur vos propres documents avant de vous fier aux affirmations d'un fournisseur, y compris les nôtres.
Dois-je entraîner ou configurer ces outils ?
Les plateformes IDP d'entreprise nécessitent un travail de configuration, et les outils basés sur des modèles nécessitent des échantillons étiquetés pour les mises en page non vues, avec parfois seulement 20 documents pour certains fournisseurs. Les outils sans modèle sautent cette étape entièrement : vous définissez les colonnes de sortie, et l'IA fait le reste. L'exigence d'entraînement est le coût caché de la plupart des gagnants des comparatifs d'assurance, alors demandez-la explicitement lors de chaque démo.
Extraire un certificat d'assurance prouve-t-il que la couverture est valide ?
Non. Un certificat indique quelles étaient les limites de la police à sa date d'émission, et ACORD déclare clairement qu'il ne s'agit pas d'une police et ne modifie pas la couverture. L'extraction transforme les champs en lignes de feuille de calcul que vous pouvez suivre ; confirmer que la couverture est réellement en vigueur reste votre responsabilité et celle de l'assureur émetteur.
Le schéma ci-dessus pointe vers une façon plus simple de faire ce choix que toute présentation de fournisseur. Commencez par les documents que votre équipe a traités la semaine dernière, testez les deux ou trois candidats correspondant à votre catégorie sur des fichiers réels, et observez ce qui se passe sur les documents difficiles, les scans et les mises en page inhabituelles, car c'est la précision qui se manifestera en production. Côté sans modèle, notre niveau gratuit pour tester cette question exacte sur vos propres certificats, formulaires ACORD ou loss runs avant toute conversation avec les ventes.