50 rapports QC, une feuille SPC : comment
traiter les données par lots sans saisie manuelle
Un seul laboratoire QC réalisant 30 tests de libération de produits finis par jour—chacun avec 15 à 20 paramètres mesurés provenant de trois ou quatre instruments différents—génère environ 450 à 600 points de données que quelqu'un doit saisir dans une feuille de calcul avant de pouvoir construire un graphique SPC. Au taux d'erreur de saisie manuelle de 1 % par champ, largement cité, cela représente 4 à 6 chiffres erronés entrant dans le classeur chaque jour. Mais le véritable multiplicateur de dommages est ce qui se passe ensuite : chaque erreur de transcription qui atterrit dans un graphique de contrôle a une probabilité non négligeable de déclencher un signal hors contrôle. Pour un laboratoire opérant sous 21 CFR 211.192, ce signal ne se contente pas de marquer un graphique—il déclenche une enquête obligatoire. Un seul chiffre mal saisi peut consommer 4 à 8 heures de temps analyste et superviseur, et le lot reste non libéré pendant toute la durée.
Points clés à retenir
- Trente tests QC quotidiens à 3 minutes de saisie manuelle chacun coûtent à votre laboratoire 21 000 $ par an en main-d'œuvre de transcription—des chiffres que les instruments ont déjà générés.
- Le coût que votre budget ne montre jamais : chaque chiffre mal saisi dans un graphique de contrôle peut déclencher une enquête OOS obligatoire consommant 4 à 8 heures, et chaque fausse alarme apprend aux opérateurs à ne plus faire confiance aux graphiques SPC.
- Définissez une fois les noms de vos colonnes SPC, téléversez par lots 50 PDF d'instruments de n'importe quelle marque en une seule opération, et recevez une feuille de calcul prête pour l'audit avec les drapeaux OOS affichés dans une seule colonne—votre rôle passe de la saisie de 600 champs par jour à la revue des seules exceptions signalées.
Le piège de la saisie en deux phases dans les laboratoires de contrôle qualité
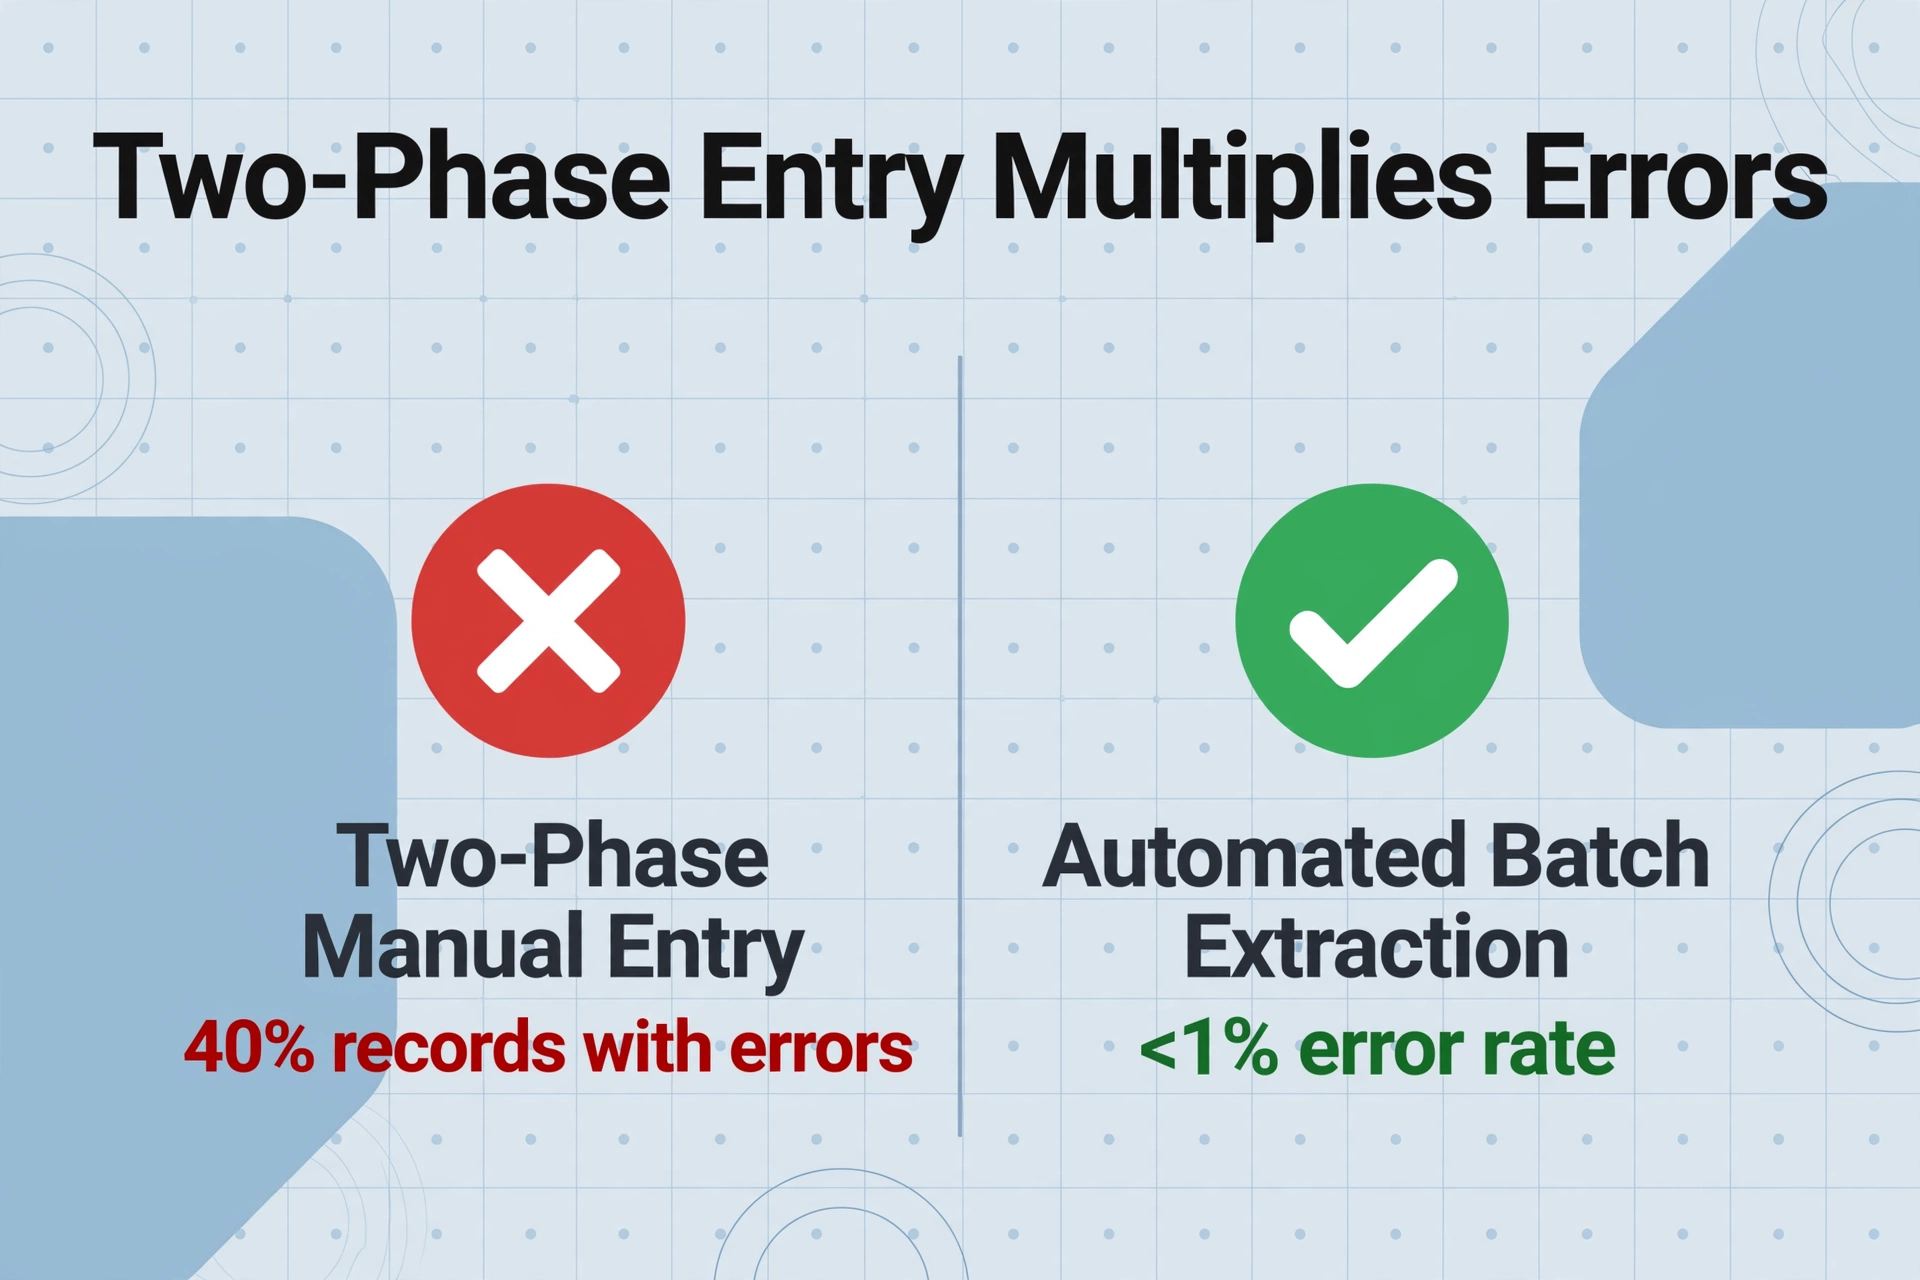
La plupart des laboratoires de contrôle qualité en fabrication n'effectuent pas de saisie manuelle en une seule phase. Ils pratiquent la saisie en deux phases : un technicien consigne les mesures sur papier à l'instrument, puis une seconde personne—parfois le même technicien, parfois une autre—retranscrit ces valeurs papier dans Excel ou un LIMS. Chaque phase multiplie l'exposition aux erreurs.
Selon Beamex, lorsque les données passent par deux points de saisie manuelle, statistiquement 40 % des enregistrements contiennent au moins une erreur. Une installation réalisant 10 000 étalonnages ou tests qualité par an en saisie en deux phases génère environ 4 000 points de données erronés. Ces chiffres ne sont pas théoriques—ils représentent de véritables investigations, de véritables reprises, et des heures réellement consommées par des personnes qui devraient analyser des tendances au lieu de courir après des erreurs de frappe.
La conséquence la moins médiatisée est l'impact des erreurs de saisie manuelle sur la crédibilité des cartes SPC. Lorsque les opérateurs voient les cartes de contrôle déclencher régulièrement des alertes qu'ils savent être dues à des erreurs de saisie, ils cessent de faire confiance aux cartes. Chaque signal hors contrôle fantôme apprend au personnel que le système SPC crie au loup—et une fois cette leçon assimilée, les véritables signaux qualité se noient dans le bruit. Un responsable de laboratoire qui a écarté cinq fausses alertes en un mois est peu susceptible de réagir avec urgence à la sixième alerte, pourtant légitime. L'investissement d'automatisation que de nombreuses usines ont consenti dans les logiciels SPC est partiellement gaspillé si les données qui les alimentent sont encore saisies à la main.
Pour un laboratoire de contrôle qualité traitant 30 tests de libération de lots par jour avec 15 à 20 paramètres mesurés chacun, un taux d'erreur de transcription au niveau du champ de 1 % signifie 120 à 180 erreurs par mois saisies dans les classeurs SPC. Chaque erreur risque soit un blocage injustifié de lot, soit une libération qui aurait dû être stoppée.
Pourquoi l'extraction de rapports individuels ne survit pas au passage à l'échelle par lots
Les outils d'extraction de rapports individuels—ceux où vous téléchargez un PDF, obtenez une ligne de données, et répétez l'opération—sont optimisés pour un flux de travail qui n'existe pas dans un laboratoire de contrôle qualité en production. Personne ne lance un seul test, n'obtient un seul rapport et ne saisit une seule ligne. La réalité quotidienne est une pile : le HPLC Shimadzu a terminé sa course et a généré un PDF avec 12 paramètres d'analyse. Le titrateur Karl Fischer Mettler Toledo a produit son rapport de teneur en humidité. La machine d'essai de traction Instron a généré son résumé des propriétés mécaniques. Le GC Agilent a renvoyé son analyse de solvants résiduels. Multipliez par le nombre de lots testés ce jour-là, et vous avez 30 à 50 rapports d'instruments qui doivent être fusionnés en un seul ensemble de données avant que toute analyse SPC puisse commencer.
Le traitement par lots n'est pas simplement un traitement individuel répété 50 fois. Il introduit des défis qu'un flux de travail séquentiel ne rencontre jamais :
- Les conventions de nommage se brisent à l'échelle. Lorsque vous traitez un rapport, la ligne de sortie appartient à un seul lot. Lorsque vous en traitez 50, vous avez besoin d'identifiants de lot, d'identifiants d'échantillon, d'identifiants d'instrument et d'horodatages attachés à chaque ligne afin que la feuille de calcul fusionnée reste interrogeable et traçable. Une colonne nommée « Assay (%) » avec 50 en-têtes identiques est inutile—vous avez besoin de « Batch-20260627-01 | HPLC | Assay (%) » dans le flux de travail, ou mieux encore, de l'instrument et du lot comme colonnes séparées reliant chaque ligne à sa source.
- La fusion des résultats est le véritable goulot d'étranglement, pas la vitesse d'extraction. Même si vous pouviez extraire chaque rapport en 10 secondes, fusionner manuellement 50 lignes de sortie dans le classeur SPC maître—en alignant les colonnes d'instruments ayant des conventions de mise en page différentes, en vérifiant les lacunes, en résolvant les colonnes en double—mange le temps que vous avez gagné sur l'extraction. Un outil conçu pour le traitement par lots produit une feuille de calcul unifiée en une seule passe, avec toutes les lignes alignées sur le même schéma de colonnes.
- La gestion des exceptions se cumule. Un rapport individuel avec un paramètre manquant est une décision de 5 secondes. Un lot de 50 rapports où 6 ont des champs différents manquants, 2 ont des valeurs d'impression thermique illisibles et 3 contiennent des drapeaux OOS devient un exercice de rapprochement de 45 minutes. Le traitement par lots à grande échelle doit faire remonter les exceptions de manière systématique—et non vous laisser faire défiler 50 lignes à la recherche de lacunes.
Pour une présentation plus détaillée du flux de travail d'extraction de rapports individuels pour les laboratoires de contrôle qualité, consultez notre guide pratique sur l'extraction de données de rapports de laboratoire de contrôle qualité de fabrication dans Excel. Le reste de cet article se concentre sur ce qui change lorsque vous devez le faire 50 fois par jour.
Comment les PDF générés par les instruments déjouent les outils basés sur des modèles
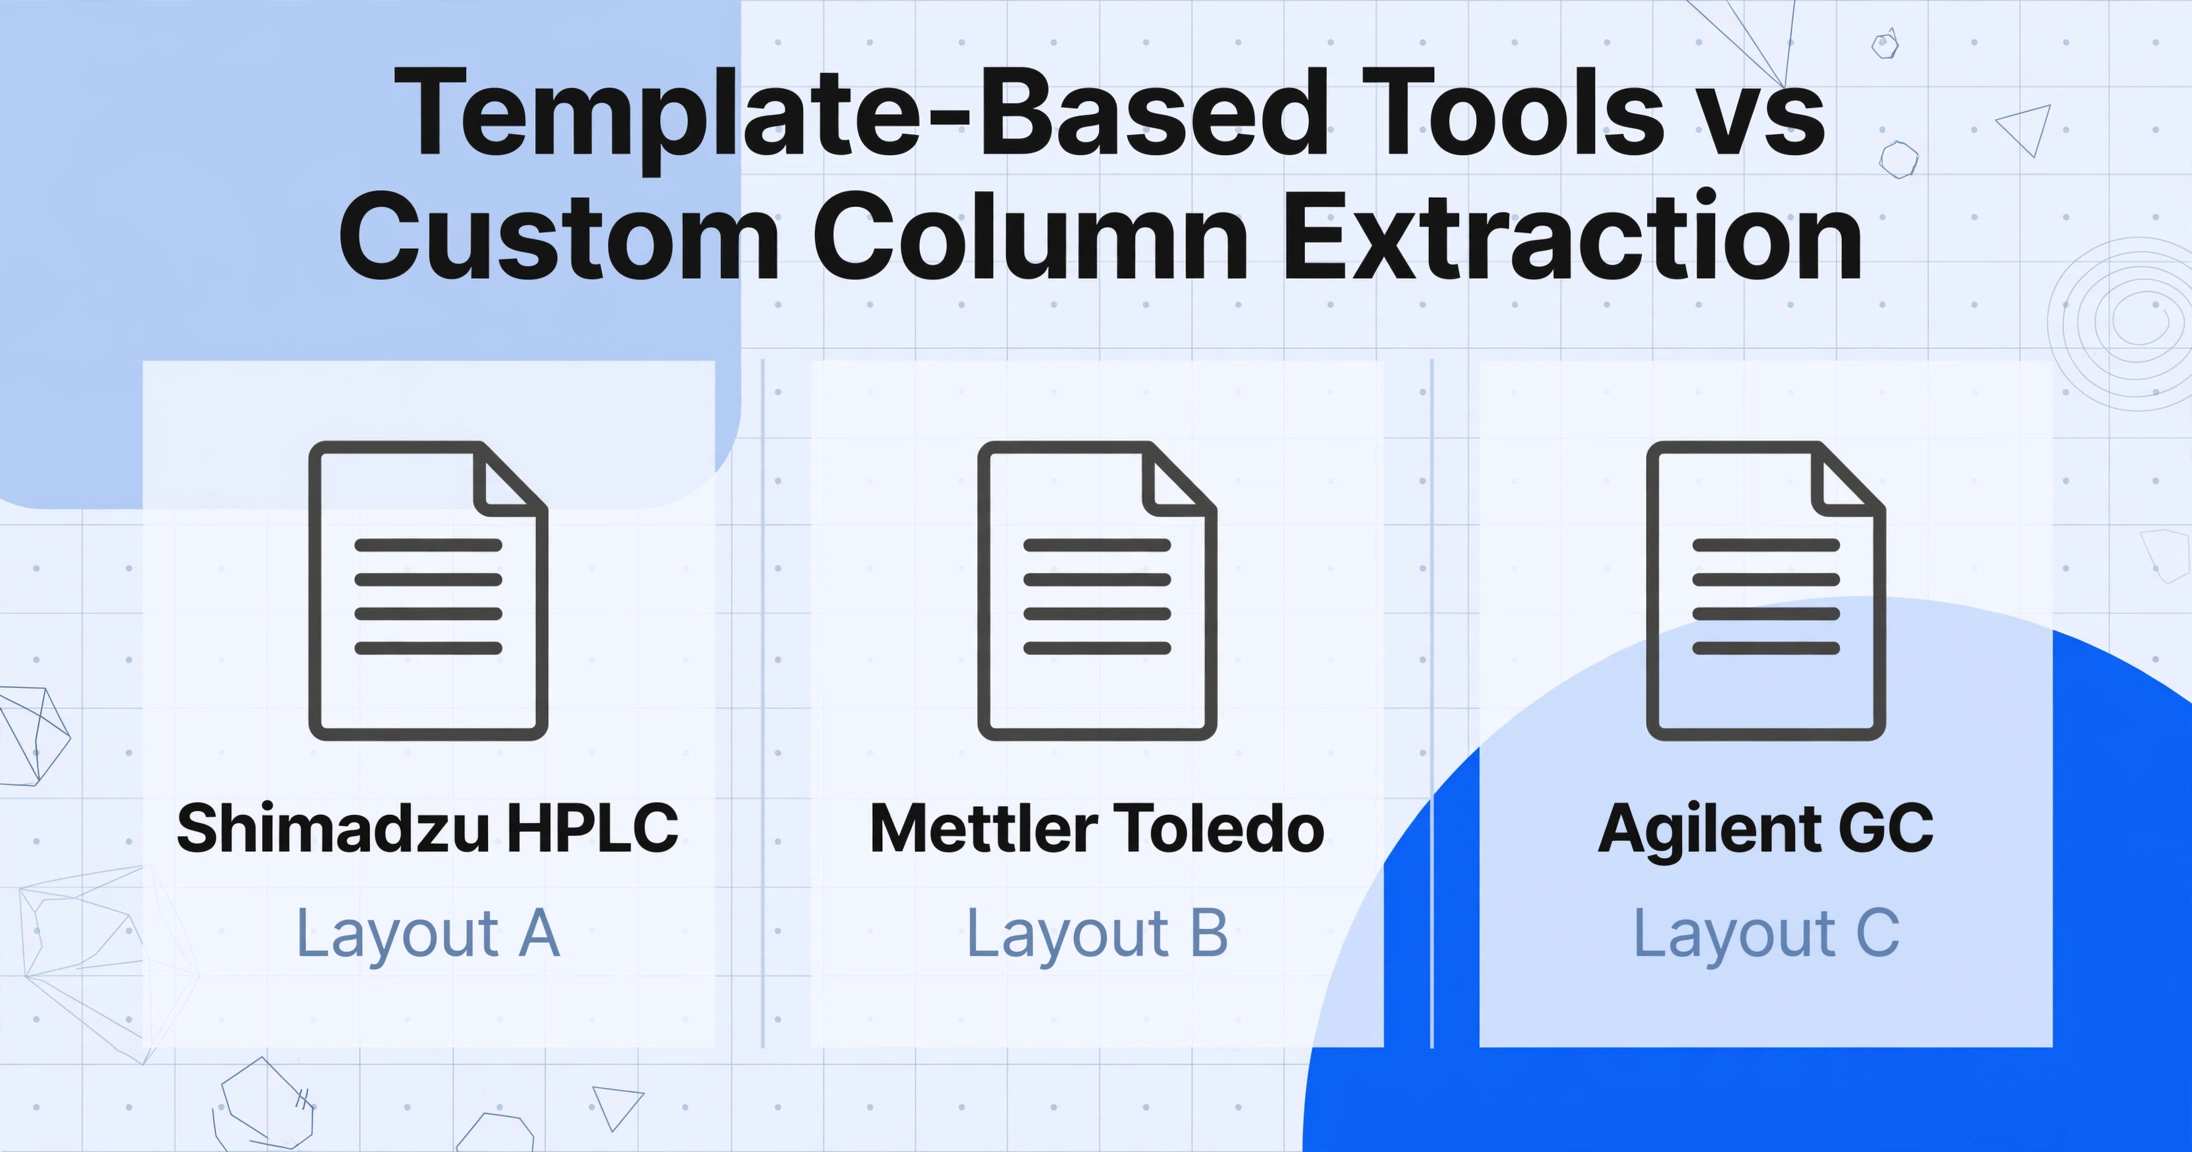
Entrez dans un laboratoire de contrôle qualité avec des instruments de différents fournisseurs, et vous êtes confronté à un problème de fragmentation des formats que les outils d'extraction basés sur des modèles n'ont jamais été conçus pour résoudre. Un HPLC Shimadzu utilisant LabSolutions imprime les résultats d'analyse dans un tableau avec des colonnes intitulées « Compound Name / Retention Time / Area / Concentration / Unit ». Un titrateur Mettler Toledo utilisant LabX imprime un rapport avec « Sample ID / Result / RSD / n » dans une mise en page complètement différente. Un GC Agilent utilisant OpenLab CDS produit encore une autre structure—parfois avec le même paramètre nommé différemment selon les versions du logiciel. Trois instruments, trois mises en page PDF, et aucun d'entre eux n'a été conçu pour être lu automatiquement dans une feuille de calcul.
Les outils OCR traditionnels et les IDP basés sur des modèles exigent que vous définissiez, pour chaque mise en page PDF d'instrument, les coordonnées exactes ou les motifs d'ancrage où se trouve chaque point de données. Lorsque le laboratoire passe à une nouvelle version de LabSolutions et que la mise en page du rapport se décale de trois lignes, le modèle se brise silencieusement—extrayant la mauvaise valeur dans la mauvaise colonne, sans aucune indication qu'un problème est survenu jusqu'à ce que l'assurance qualité le détecte lors de la revue par lots. Un laboratoire avec cinq instruments et des mises à jour logicielles périodiques maintient en réalité cinq modèles d'extraction fragiles qui se dégradent avec le temps.
L'alternative est l'Extraction de colonnes personnalisées : au lieu d'indiquer à l'outil où se trouvent les données sur la page, vous lui indiquez quelles données vous voulez. Saisissez les en-têtes de colonnes qui correspondent à vos champs de données SPC—« Assay (%) », « Moisture Content (%) », « Tensile Strength (MPa) »—et l'IA localise chaque valeur en comprenant ce que le texte signifie, et non où il apparaît. Un résultat imprimé comme « Assay: 99.2% » sur un rapport et « Content: 99.2% (as-is basis) » sur un autre correspond à la même colonne de sortie parce que le modèle reconnaît les deux comme des valeurs d'analyse, et non parce que les deux apparaissent à X=320, Y=480. Cette approche sémantique—sans modèle et indépendante du format—est le seul paradigme d'extraction qui reste fonctionnel dans un environnement de laboratoire multi-instruments.
Pour les laboratoires utilisant des instruments Agilent, Shimadzu et Mettler Toledo côte à côte, les mêmes définitions de colonnes fonctionnent sur les trois formats d'instruments sans reconfiguration. La sortie d'extraction aboutit dans une seule feuille de calcul avec une structure de colonnes identique, quel que soit l'instrument ayant généré chaque PDF source. C'est la différence fondamentale entre un outil conçu pour les environnements de traitement par lots à formats variables et un outil optimisé pour un usage à format unique et à rapport unique.
Le problème des drapeaux OOS dont personne ne parle
Un résultat hors spécifications sur un rapport de laboratoire QC n'est pas qu'un simple chiffre en rouge. Selon les directives d'enquête OOS de la FDA de 2006, chaque résultat OOS déclenche une enquête obligatoire en deux phases : la phase I examine si une erreur de laboratoire a causé le résultat, la phase II enquête sur le processus de fabrication lui-même. L'enquête doit être documentée, la cause racine identifiée, et des actions correctives mises en œuvre avant que le lot puisse être libéré. Une seule enquête OOS consomme généralement de 3 à 10 jours ouvrables, et l'exigence d'examen des dossiers de lot en vertu du 21 CFR 211.192 signifie que l'unité qualité doit approuver chaque conclusion d'enquête.
Considérons maintenant ce qui se passe lorsque les résultats OOS passent par une étape de transcription manuelle. Un technicien saisit « 0,052 » alors que le rapport de l'instrument indiquait « 0,025 »—une transposition d'un seul chiffre—et la valeur dépasse la limite de spécification. Le graphique SPC le signale. L'enquête commence. Quatre heures plus tard, l'assurance qualité trouve l'impression originale de l'instrument, la compare à la saisie Excel, et découvre qu'il s'agissait d'une faute de frappe. Le lot n'a jamais été hors spécifications. L'enquête a été gaspillée pour une erreur de frappe.
Le scénario inverse est plus dangereux : un rapport d'instrument montre une valeur OOS authentique, le technicien la transcrit incorrectement comme une valeur conforme, et le lot est libéré sans enquête. La cause racine de fabrication—contamination, dérive de processus, variabilité des matières premières—passe inaperçue jusqu'à ce qu'elle affecte les lots suivants, déclenchant potentiellement un rappel. Une erreur de transcription n'a pas seulement fait perdre du temps ; elle a contourné une protection réglementaire conçue pour détecter les défaillances qualité systémiques.
Lorsque l'extraction est automatisée, les drapeaux OOS sont gérés systématiquement. Définissez une colonne inférée appelée « Statut Conforme/Non conforme » avec une règle comme « CONFORME si toutes les valeurs mesurées sont dans les limites de spécification ; NON CONFORME si une valeur est hors spécifications »—l'IA évalue chaque valeur extraite par rapport à sa spécification pendant le traitement et signale automatiquement les violations. La feuille de calcul de sortie contient une colonne dédiée où les conditions OOS sont affichées sur l'ensemble des 50 rapports en une seule vue. Au lieu de faire défiler les PDF d'instruments à la recherche de texte rouge, les réviseurs QC scrutent une colonne, repèrent les trois lignes NON CONFORME, et n'ouvrent que ces trois rapports pour enquête. L'attention va là où elle doit aller : aux exceptions, et non à la vérification de chaque nombre déjà correctement imprimé par l'instrument.
Combler l'écart entre la sortie de l'instrument et l'entrée SPC
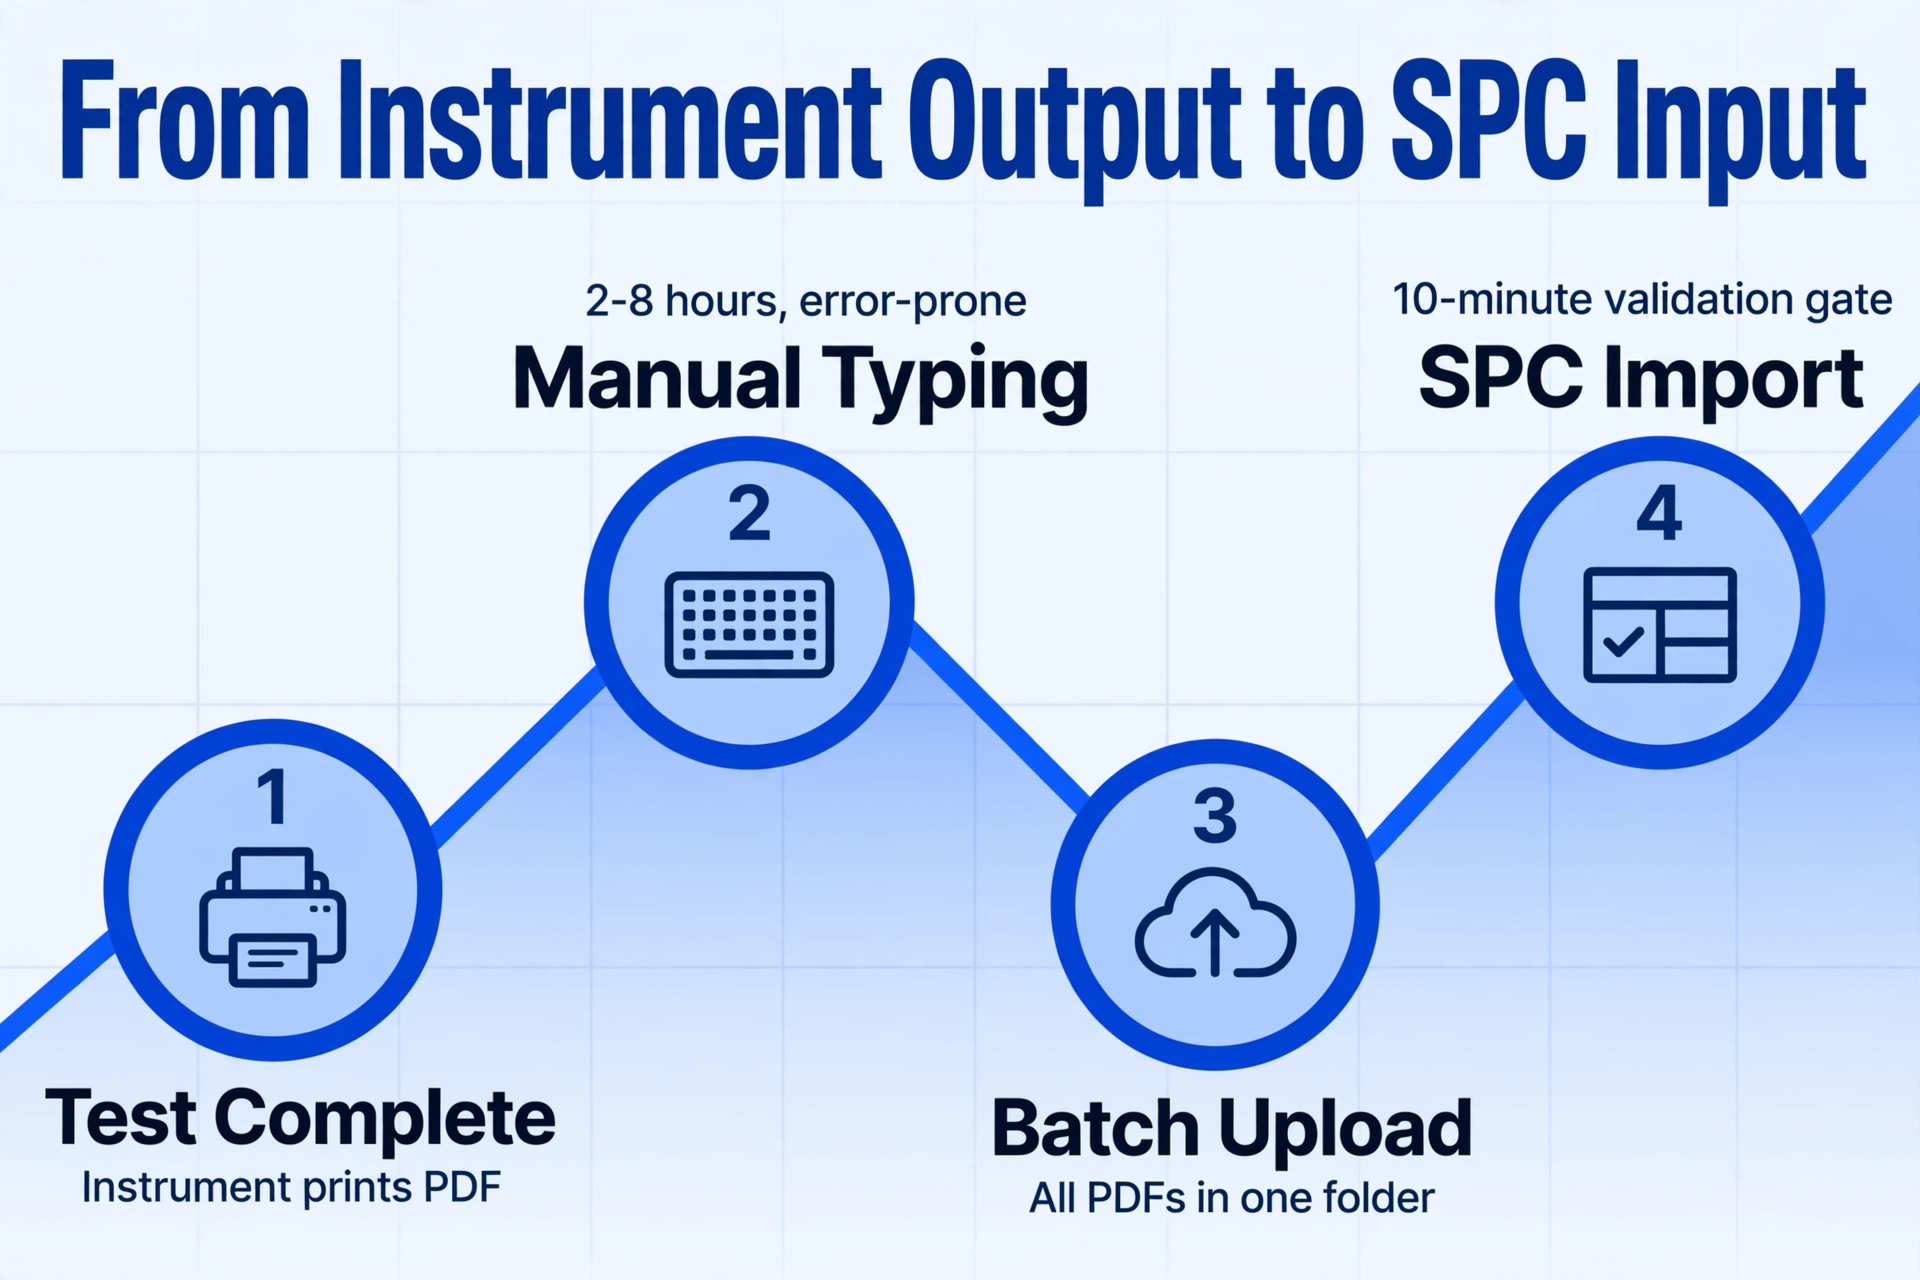
Le flux de données dans un laboratoire de contrôle qualité manuel ressemble à ceci : l'instrument termine le test → l'instrument imprime un PDF → le technicien lit le PDF → le technicien saisit les chiffres dans Excel → l'assurance qualité examine Excel → les données sont copiées dans le logiciel SPC pour l'établissement de cartes de contrôle. Chaque flèche de cette chaîne représente un point de latence et un point d'introduction d'erreur. L'écart entre « test terminé » et « données dans SPC » est généralement de 2 à 8 heures — non pas parce que le test prend du temps, mais parce que le pipeline transcription-examen-copie est séquentiel et rythmé par l'humain.
Dans un pipeline automatisé par lots, le flux se réduit à : les instruments terminent les tests tout au long de la journée → tous les PDF sont collectés dans un dossier de lot → le lot est téléversé à la fin du quart de travail ou de la journée → l'IA extrait tous les rapports dans une seule feuille de calcul structurée → la feuille de calcul est importée directement dans le logiciel SPC. L'étape d'extraction elle-même prend 5 à 10 secondes par page, donc 50 rapports sont traités en moins de 10 minutes de temps de traitement. La fenêtre de transcription de 2 à 8 heures devient une étape de validation de 10 minutes où les examinateurs QC vérifient un échantillon des résultats au lieu de saisir chaque champ.
La plupart des plateformes logicielles SPC — Minitab Real-Time SPC, InfinityQS, JMP, WinSPC, dataPARC — acceptent l'import CSV ou Excel comme voie standard d'ingestion de données. La feuille de calcul issue de l'extraction par lots est déjà formatée pour cette étape d'import : chaque ligne correspond à un résultat de test, chaque colonne correspond à un paramètre SPC, et les limites de contrôle configurées dans le logiciel SPC génèrent automatiquement les cartes I-MR, Xbar-R ou Xbar-S dès le chargement des données. Les calculs de Cp et Cpk sont mis à jour immédiatement car l'ensemble de données sous-jacent est complet et correctement structuré dès le départ.
Le calcul de productivité : un laboratoire traitant 30 lots quotidiens avec 15 paramètres chacun, transcrits par un technicien gagnant 28 $/heure, consomme environ 84 $ par jour en main-d'œuvre de saisie manuelle uniquement (3 minutes par rapport × 30 rapports = 90 minutes). Sur une année de 250 jours ouvrables, cela représente 21 000 $ de main-d'œuvre consacrée à la saisie de chiffres que les instruments ont déjà générés numériquement. Le temps d'investigation déclenché par les erreurs de transcription — de manière prudente, une investigation par semaine de 4 heures — ajoute 5 600 $ par an. Le total combiné de 26 600 $ est le coût récurrent de la non-automatisation, avant même de prendre en compte les coûts plus difficiles à quantifier des libérations de lots retardées et de la confiance érodée dans les cartes SPC.
Construire un pipeline de lots traçable
L'automatisation de l'extraction soulève une question légitime de conformité : si personne ne saisit les chiffres, comment prouver à un auditeur que la valeur dans le tableur provient bien du rapport d'instrument ? La piste d'audit ne disparaît pas avec l'automatisation—elle change de forme.
Selon 21 CFR 211.188, les enregistrements de production et de contrôle des lots doivent inclure la documentation complète de chaque étape significative, y compris les résultats des contrôles en laboratoire et l'identité des personnes effectuant et vérifiant chaque étape. Lorsque l'extraction est automatisée, la chaîne de traçabilité repose sur les métadonnées, non sur les frappes : chaque ligne du tableur de sortie renvoie à son PDF source par nom de fichier ; l'horodatage du traitement en lot enregistre le moment de l'extraction ; l'utilisateur qui a lancé le lot et vérifié les résultats est journalisé ; et les PDF originaux restent disponibles comme source de vérité inaltérable.
La norme ASTM D6299 pour l'assurance qualité statistique souligne que les statistiques des cartes de contrôle doivent être calculées à partir de données traçables et vérifiables. Un pipeline d'extraction automatisé avec des références aux fichiers sources dans chaque ligne satisfait cette exigence de manière plus systématique qu'une entrée manuscrite dans un journal, car le lien entre la valeur du tableur et le rapport d'instrument est programmatique plutôt que dépendant de la mémoire de quelqu'un notant quel tirage d'instrument il consultait. Les auditeurs inspectant un enregistrement de lot peuvent cliquer de la ligne du tableur au PDF original et confirmer la valeur en moins de 30 secondes—plus rapide et plus définitif que de retracer une écriture manuscrite dans un journal papier.
Le flux de travail pratique pour la conformité : organisez les PDF quotidiens des instruments dans des dossiers par date et poste de test (Matière première / En cours / Produit fini), traitez par lot les rapports de chaque poste dans son propre tableur avec une colonne identifiant l'instrument source, et enregistrez la sortie aux côtés des PDF originaux dans le dossier d'enregistrement du lot. Le tableur extrait devient le fichier de données de travail pour l'analyse SPC ; les PDF originaux restent la preuve immuable. Cela ressemble structurellement à la façon dont les laboratoires gèrent déjà les fichiers de données chromatographiques—le dossier brut .lcm ou .d est la source, le rapport traité est la sortie de travail—étendu à l'ensemble des instruments du laboratoire.
Configuration du flux de traitement par lots
Passer de la transcription manuelle à l'extraction automatisée par lots ne nécessite pas un projet de mise en œuvre de LIMS. Le flux de travail suivant peut être opérationnel en une seule équipe :
Définissez vos colonnes SPC
Listez chaque paramètre de test qui alimente vos graphiques SPC : « Assay (%) », « Moisture Content (%) », « pH », « Viscosity (cP) », « Dissolution (%) », « Hardness (N) », etc. Ces paramètres deviennent les noms de colonnes dans votre modèle d'extraction. Ajoutez également des colonnes de métadonnées : « Batch ID », « Sample ID », « Test Station », « Instrument », « Test Date ». Ajoutez une colonne inférée « Pass/Fail » pour signaler automatiquement les conditions OOS par rapport à vos limites de spécification.
Collectez les rapports d'instruments quotidiens
À la fin de chaque quart de travail ou de chaque journée, rassemblez tous les rapports PDF générés par les instruments dans des dossiers organisés par poste de test. La plupart des logiciels de contrôle d'instruments—LabSolutions, OpenLab, LabX—peuvent être configurés pour enregistrer automatiquement les rapports PDF dans un dossier réseau, éliminant ainsi l'étape d'impression puis de numérisation. Si votre laboratoire utilise encore des instruments avec imprimantes thermiques, numérisez ou photographiez les impressions en fichiers image—l'IA traite aussi bien les PDF numériques que les impressions photographiées avec les mêmes définitions de colonnes.
Téléversement et extraction par lots
Téléversez tous les PDF du dossier de lots du jour en une seule opération. Le moteur de traitement par lots extrait les données de chaque rapport à l'aide de vos définitions de colonnes et produit une feuille de calcul unifiée. Toutes les lignes sont alignées sur le même schéma de colonnes, quel que soit l'instrument ayant généré chaque PDF source. Le temps de traitement pour 50 rapports est d'environ 5 à 10 minutes de temps machine.
Validez les indicateurs OOS et effectuez des contrôles ponctuels
Ouvrez la feuille de calcul fusionnée et examinez la colonne « Pass/Fail ». Toute ligne signalée comme FAIL reçoit une attention prioritaire—ouvrez le PDF source, vérifiez que la valeur extraite correspond au rapport et lancez une enquête OOS si elle est confirmée. Pour les lignes conformes, effectuez un contrôle ponctuel sur un échantillon (10 à 15 % des lignes) en comparant les valeurs extraites aux PDF sources. Cela remplace la saisie de 600 champs par la vérification de 60 à 90 champs.
Importez dans le logiciel SPC et archivez
Importez la feuille de calcul validée dans Minitab, InfinityQS, JMP ou votre plateforme SPC de choix. Les cartes de contrôle, les indices de capabilité et les analyses de tendances se remplissent immédiatement à partir du jeu de données complet. Enregistrez la sortie d'extraction avec les PDF d'origine dans le dossier du dossier de lot pour garantir la traçabilité complète de l'audit. La feuille de calcul d'extraction fait partie intégrante du dossier de lot permanent requis par la norme 21 CFR 211.188.
Par rapport au flux de travail d'extraction de rapport unique conventionnel, l'approche par lots définit les colonnes et la configuration des instruments en amont, puis traite tous les rapports en parallèle—le même travail de configuration qui prendrait 10 minutes pour un rapport prend les mêmes 10 minutes pour 50. C'est cette économie d'échelle que le traitement par lots en priorité permet.
Questions fréquemment posées
Est-ce que cela fonctionne avec des notes manuscrites ou des annotations sur les rapports de laboratoire ?
Oui. Le moteur d'IA gère à la fois le texte imprimé et l'écriture manuscrite—y compris les numéros de lot manuscrits, les initiales des analystes ou les notes en marge qui apparaissent à côté des résultats imprimés par l'instrument. Si un technicien écrit à la main le facteur de dilution ou le poids de l'échantillon sur le rapport imprimé, cette valeur peut être extraite dans sa propre colonne aux côtés des données imprimées par l'instrument. Pour les laboratoires qui utilisent principalement l'enregistrement sur papier, consultez notre guide d'extraction des rapports de laboratoire QC pour les techniques spécifiques aux formulaires manuscrits.
Qu'en est-il des impressions thermiques numérisées provenant d'instruments plus anciens ?
Les impressions thermiques numérisées ou photographiées fonctionnent de la même manière que les PDF numériques—l'IA lit le contenu visuel, qu'il provienne d'un rapport numérique ou d'une impression papier. Cependant, le papier thermique décoloré (courant sur les impressions de plus de 6 à 12 mois) peut réduire la précision de l'extraction. Pour les archives thermiques, la meilleure pratique consiste à les photographier sous un éclairage constant dans les semaines suivant l'impression, avant que le revêtement thermique ne se dégrade.
Dois-je configurer séparément chaque modèle d'instrument ?
Non. Comme l'extraction de colonnes personnalisées fonctionne de manière sémantique plutôt que par correspondance de modèles, les mêmes définitions de colonnes fonctionnent sur tous les instruments. « Assay (%) » trouve la valeur du dosage qu'elle apparaisse sur un rapport Shimadzu, un rapport Agilent ou un rapport Mettler Toledo. La seule fois où vous pourriez ajouter des colonnes spécifiques à un instrument, c'est lorsque différents types d'instruments mesurent des paramètres fondamentalement différents—vous ne chercheriez pas « Tensile Strength » sur un rapport HPLC car cela n'y existe pas. L'IA renvoie simplement une valeur vide pour les colonnes sans données correspondantes dans un rapport donné.
Quel est l'impact sur la conformité 21 CFR Partie 11 pour les enregistrements électroniques ?
L'outil d'extraction par lots génère un tableau de sortie à partir des PDF d'instruments—il s'agit d'une étape de transformation des données, et non d'un système d'enregistrement. Les PDF d'instruments originaux restent vos sources électroniques, soumises aux mêmes contrôles de la Partie 11 (pistes d'audit, signatures électroniques, contrôles d'accès) que votre laboratoire applique déjà aux sorties d'instruments. Le tableau d'extraction sert de document de travail pour l'analyse SPC et la compilation des dossiers de lots. Pour les laboratoires fonctionnant sous les exigences complètes de la Partie 11 pour les enregistrements électroniques, les données extraites doivent être examinées et approuvées par l'unité qualité dans votre système de gestion documentaire ou LIMS existant, comme le seraient des données saisies manuellement. L'automatisation modifie la façon dont les données passent de l'instrument au tableau ; elle ne change pas votre cadre de conformité—elle réduit les erreurs de transcription qui créent des constats de non-conformité.
Puis-je traiter des rapports de plusieurs sites de fabrication en une seule vue SPC d'entreprise ?
Oui. En ajoutant une colonne « Site » à votre modèle d'extraction et en traitant les rapports quotidiens de chaque site comme des lots séparés (chacun produisant son propre fichier de sortie), vous pouvez consolider toutes les données des sites dans un seul tableau de bord SPC d'entreprise. Le schéma de colonnes unifié sur tous les sites signifie que les données du HPLC Shimadzu de l'usine A et du système Waters Alliance de l'usine B aboutissent dans le même format structuré. Ceci est particulièrement utile pour les organisations mettant en œuvre une surveillance SPC à l'échelle de l'entreprise de type IATF 16949 sur plusieurs sites de fabrication.
Qu'en est-il des instruments de laboratoire qui exportent directement vers le LIMS—en ai-je encore besoin ?
Si chaque instrument de votre laboratoire exporte des données structurées directement vers un LIMS, et que ce LIMS alimente votre logiciel SPC, vous n'avez pas de problème de transcription manuelle. Mais dans la plupart des laboratoires de contrôle qualité de fabrication, ce qui est directement connecté est généralement une minorité d'instruments—le HPLC peut exporter via le CDS, mais le titrateur, la balance d'humidité, le viscosimètre et le testeur de dureté génèrent encore des PDF ou des impressions autonomes. L'extraction par lots comble l'écart entre les instruments connectés et ceux qui ne le sont pas, produisant une sortie unifiée pouvant être importée parallèlement aux flux de données LIMS. Le paysage de l'extraction de documents de fabrication évolue vers des modèles hybrides où les flux d'instruments structurés et les données PDF extraites par IA coexistent dans le même pipeline SPC.
Comment gérer les échantillons testés à plusieurs postes avec des spécifications différentes ?
Définissez une structure de colonnes incluant le contexte du poste de test : « Matière première | Identité (Conforme/Non conforme) », « En cours | Dosage (%) », « Produit fini | Dissolution (%) ». Chaque colonne ne s'applique qu'aux rapports contenant ce paramètre : un rapport sur la matière première remplit les colonnes matière première, un rapport sur le produit fini remplit les colonnes produit fini, et le tableur de sortie partitionne naturellement les résultats par poste de test, avec des cellules vides lorsqu'un paramètre ne s'applique pas à un échantillon donné. Vous pouvez également utiliser les techniques de traitement par lots développées pour d'autres types de documents de fabrication—l'approche par colonnes s'applique à toutes les catégories de documents.