50 informes de QC, una hoja SPC: cómo
procesar datos por lotes sin entrada manual
Un solo laboratorio de QC que realiza 30 pruebas de liberación de producto terminado al día—cada una con 15 a 20 parámetros medidos de tres o cuatro instrumentos diferentes—genera aproximadamente 450 a 600 puntos de datos que alguien debe escribir en una hoja de cálculo antes de poder crear un gráfico SPC. Con la tasa de error de entrada manual de 1% por campo ampliamente citada, eso significa 4 a 6 números incorrectos que ingresan al libro de trabajo cada día. Pero el verdadero multiplicador de daño es lo que sucede después: cada error de transcripción que llega a un gráfico de control tiene una probabilidad no trivial de desencadenar una señal fuera de control. Para un laboratorio que opera bajo 21 CFR 211.192, esa señal no solo marca un gráfico—sino que desencadena una investigación obligatoria. Un solo dígito mal escrito puede consumir de 4 a 8 horas de tiempo del analista y del supervisor, y el lote permanece sin liberar durante ese período.
Conclusiones clave
- Treinta pruebas diarias de QC a 3 minutos de entrada manual cada una le cuesta a su laboratorio $21,000 al año en mano de obra de transcripción—escribir números que los instrumentos ya generaron.
- El costo que su presupuesto nunca muestra: cada dígito mal escrito dentro de un gráfico de control puede desencadenar una investigación OOS obligatoria que consume de 4 a 8 horas, y cada alarma fantasma entrena a los operadores a dejar de confiar en los gráficos SPC por completo.
- Defina los nombres de sus columnas SPC una vez, cargue por lotes 50 PDFs de instrumentos de cualquier marca en una sola operación, y reciba una hoja de cálculo lista para auditoría con las señales OOS resaltadas en una sola columna—su rol pasa de escribir 600 campos al día a revisar solo las excepciones marcadas.
La trampa de la entrada en dos fases en los laboratorios de QC
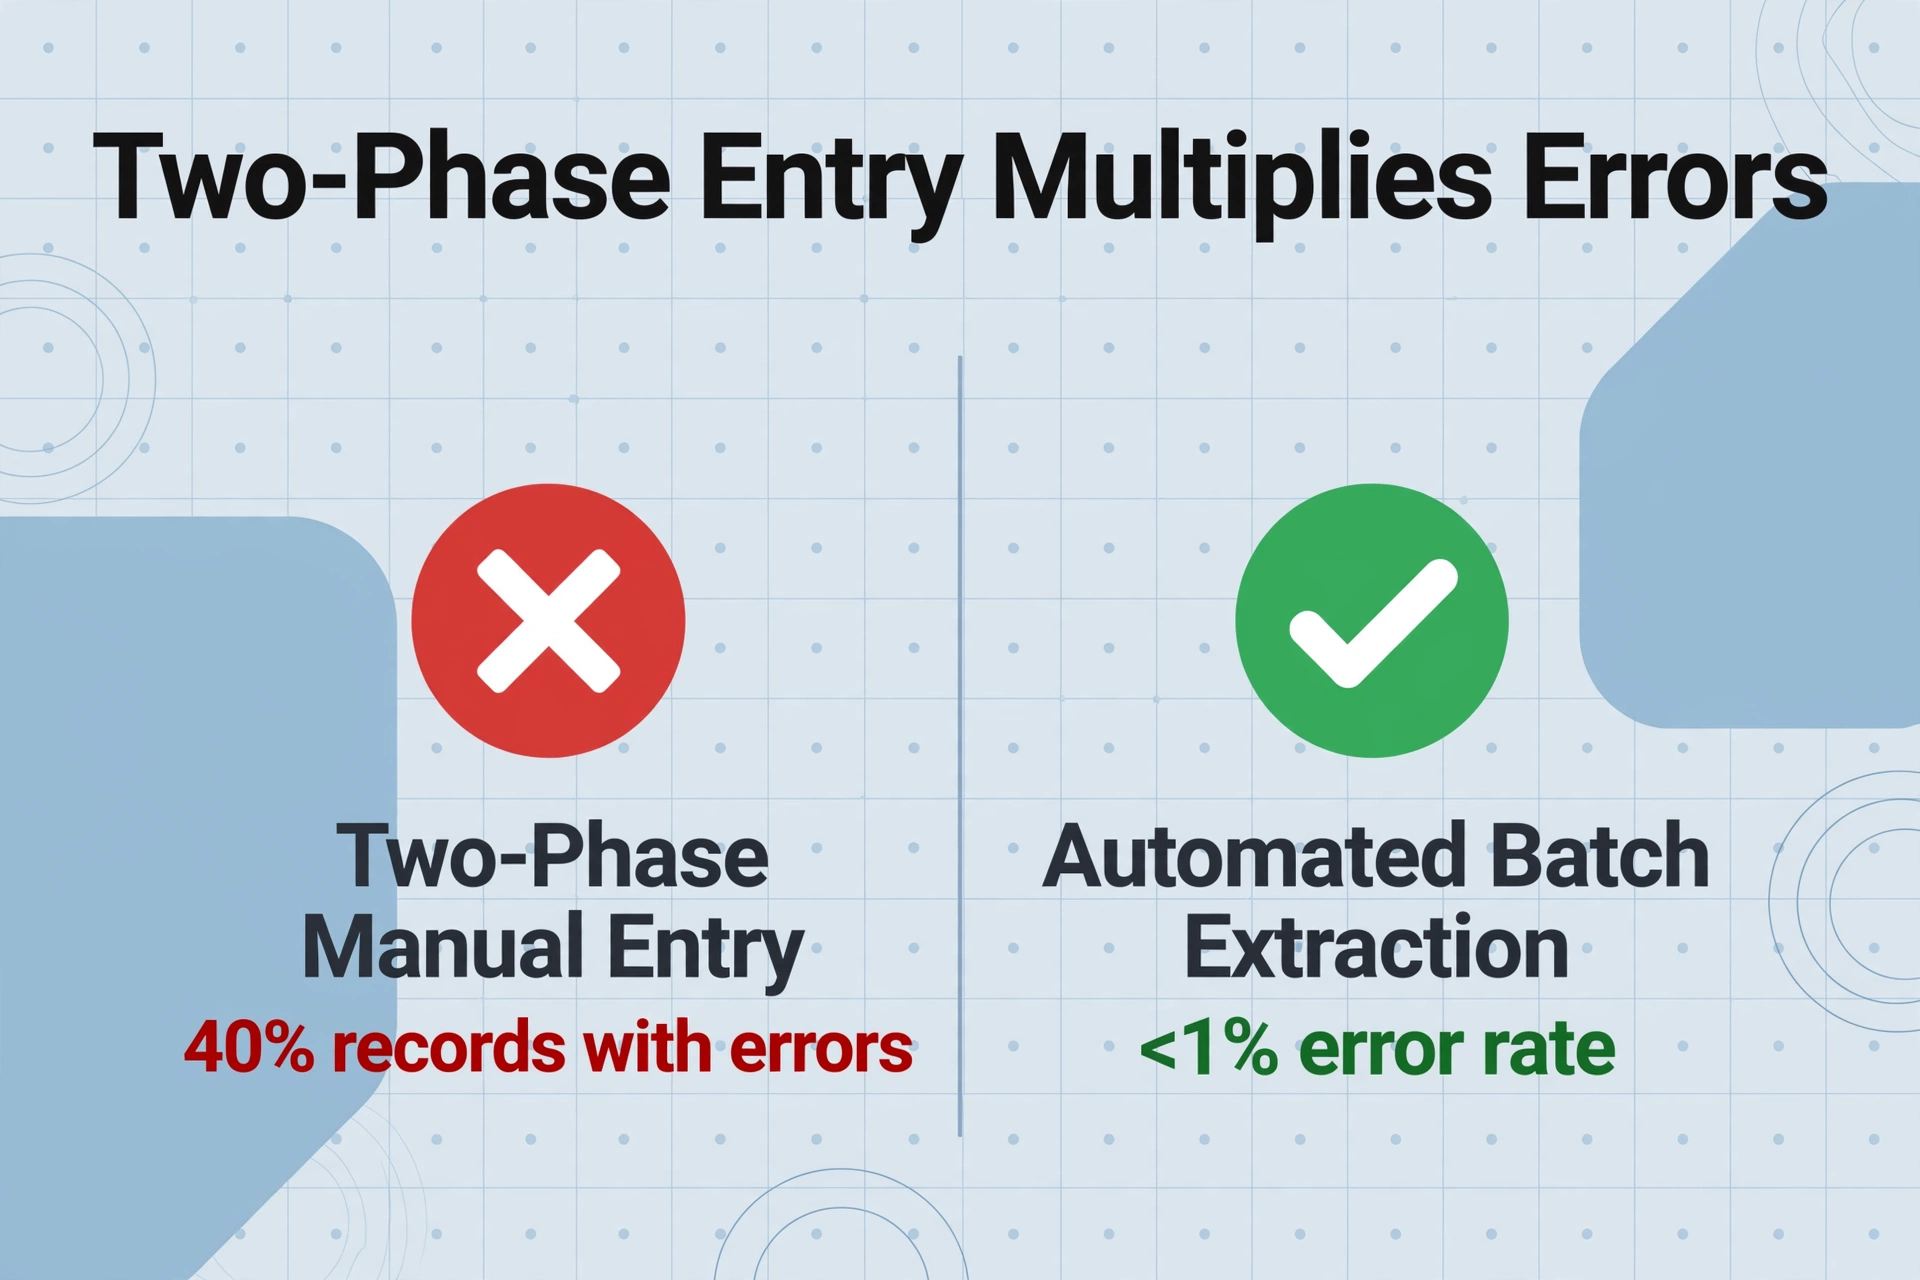
La mayoría de los laboratorios de QC en manufactura no realizan entrada manual de una sola fase. Hacen entrada en dos fases: un técnico registra las mediciones en papel en el instrumento, y una segunda persona—a veces el mismo técnico, a veces otra—transcribe esos valores del papel a Excel o a un LIMS. Cada fase multiplica la exposición al error.
Según Beamex, cuando los datos pasan por dos puntos de entrada manual, estadísticamente el 40% de los registros contienen al menos un error. Una instalación que realiza 10,000 calibraciones o pruebas de calidad al año con entrada en dos fases genera aproximadamente 4,000 puntos de datos defectuosos. Estos no son números teóricos—representan investigaciones reales, retrabajo real y horas reales consumidas por personas que deberían estar analizando tendencias, no persiguiendo errores de tecleo.
La consecuencia que recibe menos atención es lo que los errores de entrada manual le hacen a la credibilidad de los gráficos SPC. Cuando los operadores ven que los gráficos de control se activan rutinariamente por lo que saben que son errores de captura de datos, dejan de confiar en los gráficos. Cada señal fantasma fuera de control le enseña al piso que el sistema SPC grita "al lobo"—y una vez que esa lección se asienta, las señales de calidad reales se desvanecen en el ruido. Un gerente de laboratorio que descartó cinco alarmas falsas en un mes es poco probable que responda con urgencia a la sexta que era legítima. La inversión en automatización que muchas plantas hicieron en software SPC se desperdicia parcialmente si los datos que lo alimentan todavía se escriben a mano.
Para un laboratorio de QC que procesa 30 pruebas de liberación de lotes diarias con 15–20 parámetros medidos cada una, una tasa de error de transcripción a nivel de campo del 1% significa 120–180 errores por mes que entran a los libros de trabajo SPC. Cada error arriesga una retención de lote injustificada o una liberación que debería haberse detenido.
Por qué la extracción de informes individuales no sobrevive al procesamiento por lotes
Las herramientas de extracción de informes individuales—aquellas donde usted sube un PDF, obtiene una fila de datos y repite—están optimizadas para un flujo de trabajo que no existe en un laboratorio de QC de producción. Nadie ejecuta una prueba, obtiene un informe e ingresa una sola fila. La realidad diaria es una pila: el HPLC de Shimadzu terminó su corrida y generó un PDF con 12 parámetros de ensayo. El titulador Karl Fischer de Mettler Toledo produjo su informe de contenido de humedad. El probador de tracción Instron generó su resumen de propiedades mecánicas. El GC de Agilent devolvió su análisis de solventes residuales. Multiplique por la cantidad de lotes probados ese día y tendrá de 30 a 50 informes de instrumentos que deben fusionarse en un solo conjunto de datos antes de que pueda comenzar cualquier análisis SPC.
El procesamiento por lotes no es simplemente procesamiento individual repetido 50 veces. Introduce desafíos que un flujo de trabajo de uno a la vez nunca encuentra:
- Las convenciones de nomenclatura se rompen a escala. Cuando procesa un informe, la fila de salida pertenece a un lote. Cuando procesa 50, necesita identificadores de lote, ID de muestra, ID de instrumento y marcas de tiempo adjuntos a cada fila para que la hoja de cálculo fusionada siga siendo consultable y trazable. Una columna llamada "Ensayo (%)" con 50 encabezados idénticos es inútil—necesita "Lote-20260627-01 | HPLC | Ensayo (%)" en el flujo de trabajo, o mejor aún, el instrumento y el lote como columnas separadas que vinculen cada fila con su origen.
- La fusión de resultados es el verdadero cuello de botella, no la velocidad de extracción. Incluso si pudiera extraer cada informe en 10 segundos, fusionar manualmente 50 filas de salida en el libro de trabajo maestro de SPC—alineando columnas de instrumentos con diferentes convenciones de diseño, verificando vacíos, resolviendo columnas duplicadas—consume el tiempo que ahorró en la extracción. Una herramienta diseñada para procesamiento por lotes produce una hoja de cálculo unificada en una sola pasada, con todas las filas alineadas al mismo esquema de columnas.
- El manejo de excepciones se acumula. Un informe individual con un parámetro faltante es una decisión de 5 segundos. Un lote de 50 informes donde 6 tienen campos diferentes faltantes, 2 tienen valores de impresión térmica ilegibles y 3 contienen banderas OOS se convierte en un ejercicio de conciliación de 45 minutos. El procesamiento a escala de lote necesita mostrar las excepciones de manera sistemática—no dejar que usted revise 50 filas buscando vacíos.
Para un recorrido más detallado del flujo de trabajo de extracción de informes individuales para laboratorios de QC, consulte nuestra guía práctica sobre cómo extraer datos de informes de laboratorio de QC de manufactura a Excel. El resto de este artículo se centra en lo que cambia cuando necesita hacerlo 50 veces al día.
Cómo los PDF generados por instrumentos superan a las herramientas basadas en plantillas
Entre a un laboratorio de QC con instrumentos de diferentes proveedores y tendrá un problema de fragmentación de formatos que las herramientas de extracción basadas en plantillas nunca fueron diseñadas para resolver. Un Shimadzu HPLC que ejecuta LabSolutions imprime resultados de ensayo en una tabla con columnas etiquetadas como "Nombre del compuesto / Tiempo de retención / Área / Concentración / Unidad". Un titulador Mettler Toledo que ejecuta LabX imprime un informe con "ID de muestra / Resultado / RSD / n" en un diseño completamente diferente. Un Agilent GC que ejecuta OpenLab CDS produce otra estructura más—a veces con el mismo parámetro nombrado de forma distinta entre versiones de software. Tres instrumentos, tres diseños de PDF, y ninguno de ellos fue diseñado para ser leído automáticamente en una hoja de cálculo.
Las herramientas tradicionales de OCR e IDP basadas en plantillas exigen que defina, para cada diseño de PDF de instrumento, las coordenadas exactas o patrones de anclaje donde vive cada punto de datos. Cuando el laboratorio actualiza a una nueva versión de LabSolutions y el diseño del informe se desplaza tres líneas, la plantilla se rompe silenciosamente—extrayendo el valor incorrecto en la columna incorrecta, sin indicación de que algo salió mal hasta que el control de calidad lo detecta en la revisión por lotes. Un laboratorio con cinco instrumentos y actualizaciones de software periódicas está efectivamente manteniendo cinco plantillas de extracción frágiles que se degradan con el tiempo.
La alternativa es la Extracción de Columnas Personalizadas: en lugar de decirle a la herramienta dónde están los datos en la página, le dice qué datos quiere. Escriba los encabezados de columna que coincidan con sus campos de datos SPC—"Ensayo (%)", "Contenido de humedad (%)", "Resistencia a la tracción (MPa)"—y la IA localiza cada valor al comprender qué significa el texto, no dónde aparece. Un resultado impreso como "Ensayo: 99,2%" en un informe y "Contenido: 99,2% (base tal cual)" en otro se asigna a la misma columna de salida porque el modelo reconoce ambos como valores de ensayo, no porque ambos aparecieron en X=320, Y=480. Este enfoque semántico—sin plantilla e independiente del formato—es el único paradigma de extracción que sigue siendo funcional en un entorno de laboratorio con múltiples instrumentos.
Para laboratorios que operan instrumentos Agilent, Shimadzu y Mettler Toledo lado a lado, las mismas definiciones de columna funcionan en los tres formatos de instrumento sin reconfiguración. La salida de extracción llega a una sola hoja de cálculo con una estructura de columnas idéntica, independientemente de qué instrumento generó cada PDF de origen. Esta es la diferencia fundamental entre una herramienta diseñada para entornos de lotes de formato variable y una optimizada para uso de formato único e informe único.
El problema de la bandera OOS del que nadie habla
Un resultado fuera de especificaciones en un informe de laboratorio de QC no es solo un número en rojo. Según la guía de investigación OOS de la FDA de 2006, cada resultado OOS desencadena una investigación obligatoria en dos fases: la Fase I examina si un error de laboratorio causó el resultado, la Fase II investiga el proceso de manufactura en sí. La investigación debe documentarse, identificarse la causa raíz e implementarse acciones correctivas antes de que el lote pueda liberarse. Una sola investigación OOS consume rutinariamente de 3 a 10 días hábiles, y el requisito de revisión del registro del lote según 21 CFR 211.192 significa que la unidad de calidad debe aprobar cada conclusión de la investigación.
Ahora considere qué sucede cuando los resultados OOS pasan por un paso de transcripción manual. Un técnico escribe "0.052" cuando el informe del instrumento decía "0.025"—una transposición de un solo dígito—y el valor excede el límite de especificación. El gráfico SPC lo señala. La investigación comienza. Cuatro horas después, QA encuentra la impresión original del instrumento, la compara con la entrada de Excel y descubre que fue un error de tipeo. El lote nunca estuvo fuera de especificaciones. La investigación se desperdició en un error de tecleo.
El escenario inverso es más peligroso: un informe de instrumento muestra un valor OOS genuino, el técnico lo transcribe incorrectamente como un valor que pasa, y el lote se libera sin investigación. La causa raíz de manufactura—contaminación, deriva del proceso, variabilidad de la materia prima—pasa desapercibida hasta que afecta lotes posteriores, potencialmente desencadenando un retiro del mercado. Un error de transcripción no solo desperdició tiempo; eludió una salvaguarda regulatoria diseñada para detectar fallas sistémicas de calidad.
Cuando la extracción está automatizada, las banderas OOS se manejan sistemáticamente. Defina una columna inferida llamada "Estado de Aprobado/Reprobado" con una regla como "APROBADO si todos los valores medidos están dentro de los límites de especificación; REPROBADO si algún valor está fuera de especificación"—la IA evalúa cada valor extraído contra su especificación durante el procesamiento y señala las violaciones automáticamente. La hoja de cálculo de salida contiene una columna dedicada donde las condiciones OOS se muestran en los 50 informes en una sola vista. En lugar de desplazarse por los PDF del instrumento buscando texto en rojo, los revisores de QC escanean una columna, detectan las tres filas de REPROBADO y abren solo esos tres informes para investigación. La atención va donde corresponde: a las excepciones, no a verificar cada número que el instrumento ya imprimió correctamente.
Cerrando la brecha entre la salida del instrumento y la entrada al SPC
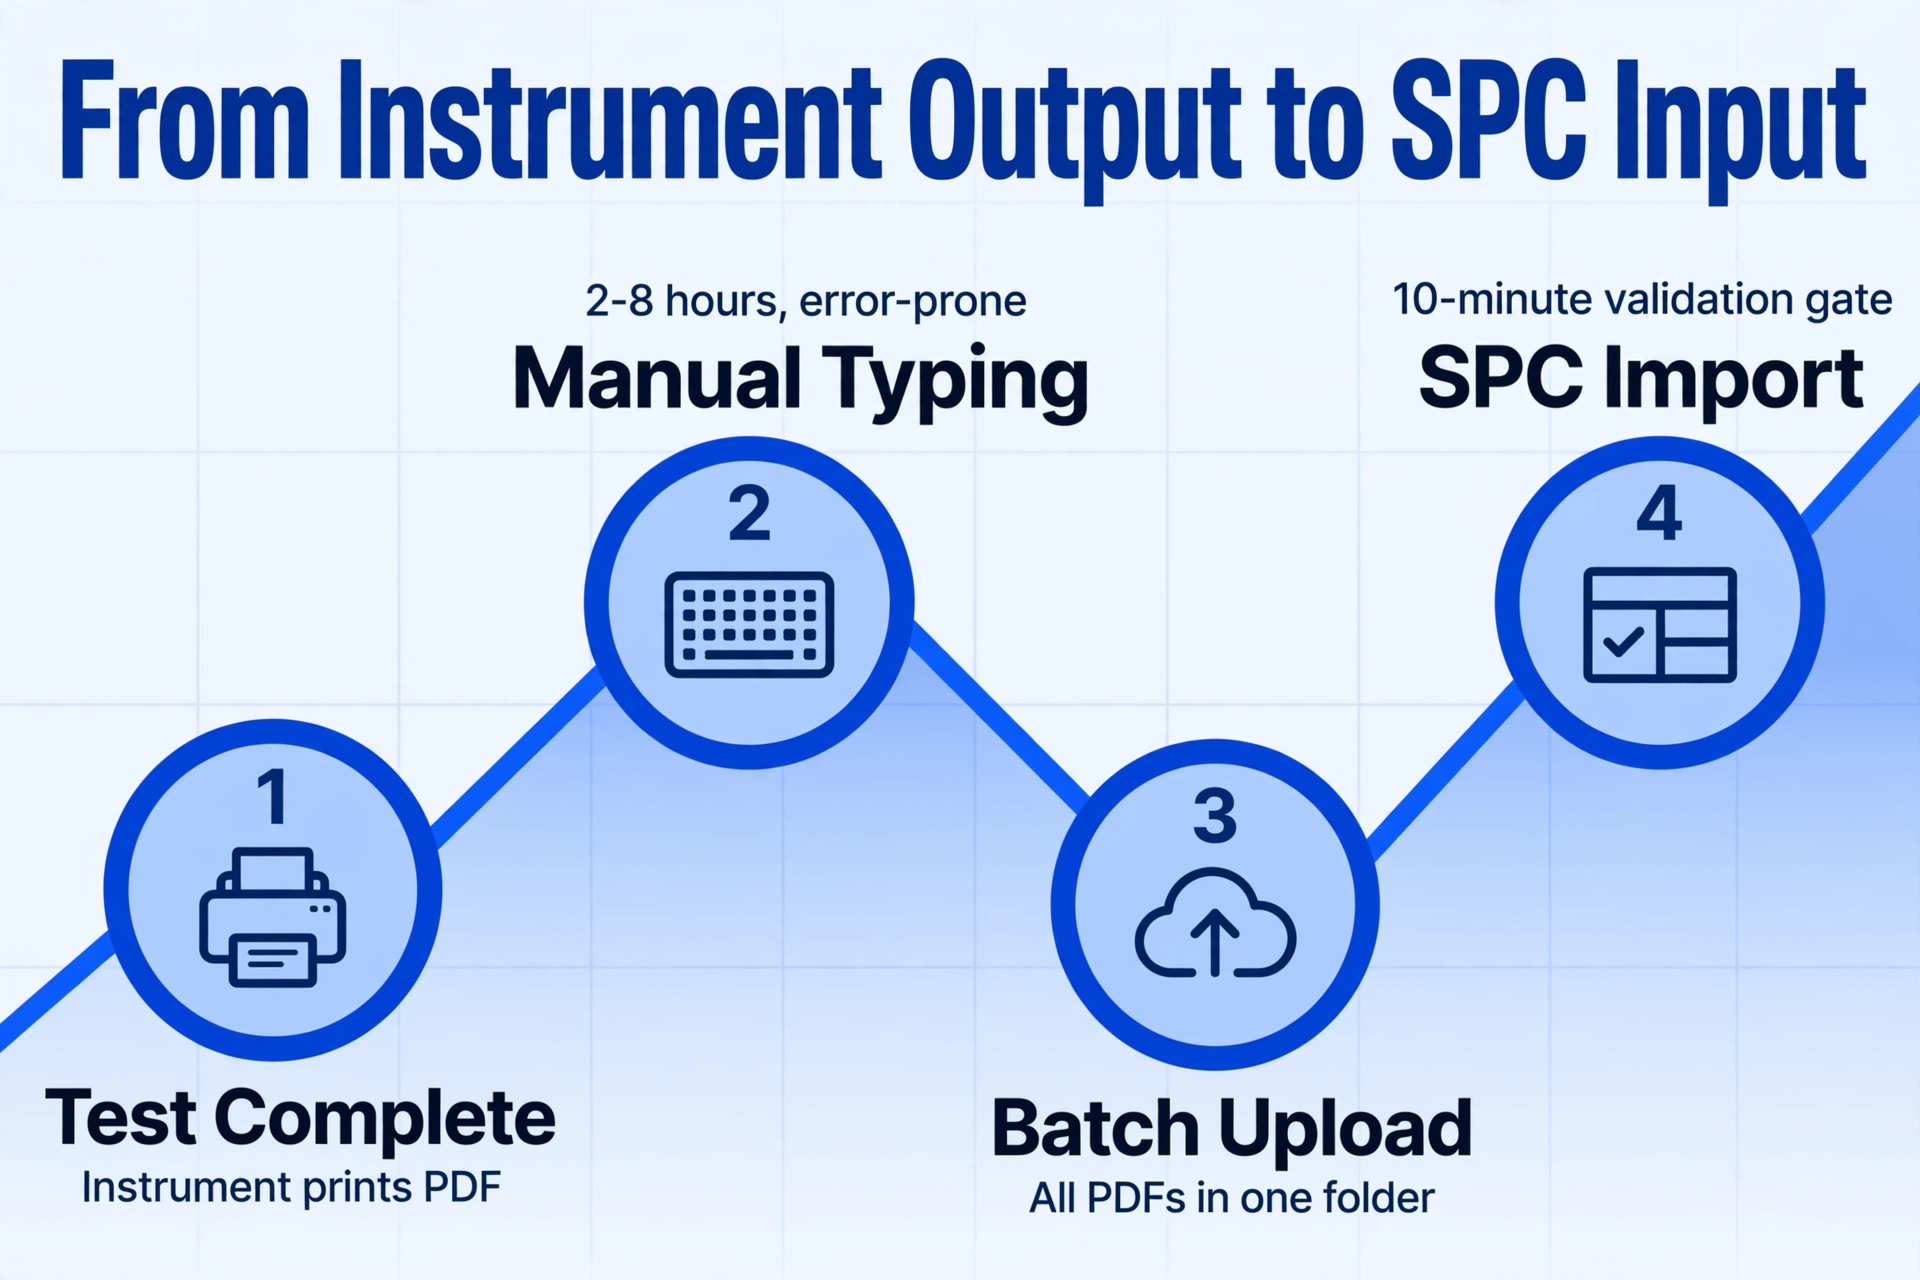
El flujo de datos en un laboratorio de QC manual se ve así: el instrumento completa la prueba → el instrumento imprime un PDF → el técnico lee el PDF → el técnico escribe los números en Excel → QA revisa Excel → los datos se copian al software SPC para gráficos de control. Cada flecha en esa cadena es un punto de latencia y un punto de introducción de errores. La brecha entre «prueba completada» y «datos en SPC» suele ser de 2 a 8 horas, no porque la prueba tarde mucho, sino porque el proceso de transcripción-revisión-copia es secuencial y a ritmo humano.
En un pipeline de lotes automatizado, el flujo se reduce a: los instrumentos completan pruebas durante el día → todos los PDFs se recopilan en una carpeta de lote → el lote se carga al final del turno o del día → la IA extrae todos los informes en una hoja de cálculo estructurada → la hoja de cálculo se importa directamente al software SPC. El paso de extracción toma de 5 a 10 segundos por página, por lo que 50 informes se completan en menos de 10 minutos de procesamiento. La ventana de transcripción de 2 a 8 horas se convierte en una compuerta de validación de 10 minutos donde los revisores de QC verifican una muestra de resultados en lugar de escribir cada campo.
La mayoría de las plataformas de software SPC —Minitab Real-Time SPC, InfinityQS, JMP, WinSPC, dataPARC— aceptan la importación de CSV o Excel como ruta estándar de ingreso de datos. La hoja de cálculo que sale de la extracción por lotes ya está formateada para este paso de importación: cada fila es un resultado de prueba, cada columna corresponde a un parámetro de SPC, y los límites de control configurados en el software SPC generan automáticamente gráficos I-MR, Xbar-R o Xbar-S en el momento en que se cargan los datos. Los cálculos de Cp y Cpk se actualizan de inmediato porque el conjunto de datos subyacente está completo y correctamente estructurado desde el inicio.
Las matemáticas de productividad: un laboratorio que procesa 30 lotes diarios con 15 parámetros cada uno, transcritos por un técnico que gana $28/hora, gasta aproximadamente $84 al día solo en trabajo de entrada manual de datos (3 minutos por informe × 30 informes = 90 minutos). En un año de 250 días laborables, eso equivale a $21,000 en mano de obra dedicada a escribir números que los instrumentos ya generaron digitalmente. El tiempo de investigación provocado por errores de transcripción —conservadoramente, una investigación por semana de 4 horas— añade otros $5,600 anuales. Los $26,600 combinados son el costo recurrente de no automatizar, sin contar los costos más difíciles de cuantificar por liberaciones de lotes retrasadas y la pérdida de confianza en los gráficos SPC.
Construcción de un pipeline de registros de lotes trazables
Automatizar la extracción plantea una pregunta legítima de cumplimiento: si nadie escribe los números, ¿cómo se demuestra a un auditor que el valor en la hoja de cálculo realmente provino del informe del instrumento? La pista de auditoría no desaparece con la automatización, sino que cambia de forma.
Según 21 CFR 211.188, los registros de producción y control de lotes deben incluir documentación completa de cada paso significativo, incluidos los resultados de control de laboratorio y la identidad de las personas que realizan y verifican cada paso. Cuando la extracción está automatizada, la cadena de trazabilidad funciona a través de metadatos, no de pulsaciones de teclas: cada fila en la hoja de cálculo de salida se vincula con su PDF de origen por nombre de archivo; la marca de tiempo del procesamiento por lotes registra cuándo se realizó la extracción; el usuario que inició el lote y revisó los resultados queda registrado; y los PDF originales permanecen disponibles como la fuente de verdad inalterable.
El estándar ASTM D6299 para aseguramiento estadístico de calidad enfatiza que las estadísticas de gráficos de control deben calcularse a partir de datos trazables y verificables. Un pipeline de extracción automatizada con referencias al archivo fuente en cada fila satisface este requisito de manera más sistemática que una entrada en un libro de registro manuscrito, porque el vínculo entre el valor de la hoja de cálculo y el informe del instrumento es programático, en lugar de depender de que alguien recuerde anotar qué impresión del instrumento estaba viendo. Los auditores que inspeccionan un registro de lote pueden hacer clic desde la fila de la hoja de cálculo hasta el PDF original y confirmar el valor en menos de 30 segundos, más rápido y más concluyente que rastrear la escritura a mano en un registro en papel.
El flujo de trabajo práctico para el cumplimiento: organice los PDF diarios de los instrumentos en carpetas por fecha y estación de prueba (Materia Prima / En Proceso / Producto Terminado), procese por lotes los informes de cada estación en su propia hoja de cálculo con una columna que identifique el instrumento fuente, y guarde la salida junto con los PDF originales en el paquete de registro del lote. La hoja de cálculo extraída se convierte en el archivo de datos de trabajo para el análisis SPC; los PDF originales siguen siendo la evidencia inmutable. Esto es estructuralmente similar a cómo los laboratorios ya manejan los archivos de datos cromatográficos (la carpeta .lcm o .d en bruto es la fuente, el informe procesado es la salida de trabajo), extendido al conjunto completo de instrumentos del laboratorio.
Configuración del flujo de trabajo de procesamiento por lotes
Pasar de la transcripción manual a la extracción automatizada por lotes no requiere un proyecto de implementación de LIMS. El siguiente flujo de trabajo puede estar operativo en un solo turno:
Defina sus columnas SPC
Enumere cada parámetro de prueba que alimenta sus gráficos SPC: "Ensayo (%)", "Contenido de humedad (%)", "pH", "Viscosidad (cP)", "Disolución (%)", "Dureza (N)", etc. Estos se convierten en los nombres de columna en su plantilla de extracción. Agregue también columnas de metadatos: "ID de lote", "ID de muestra", "Estación de prueba", "Instrumento", "Fecha de prueba". Agregue una columna inferida "Pasa/No pasa" para marcar automáticamente las condiciones OOS frente a sus límites de especificación.
Recopile los informes diarios de los instrumentos
Al final de cada turno o del día, reúna todos los informes PDF generados por los instrumentos en carpetas organizadas por estación de prueba. La mayoría del software de control de instrumentos—LabSolutions, OpenLab, LabX—puede configurarse para guardar automáticamente los informes PDF en una carpeta de red, eliminando el paso de imprimir y escanear. Si su laboratorio aún utiliza instrumentos con impresoras térmicas, escanee o fotografie las impresiones en archivos de imagen—la IA maneja tanto PDF digitales como impresiones fotografiadas con las mismas definiciones de columna.
Carga por lotes y extracción
Sube todos los PDF de la carpeta de lotes del día en una sola operación. El motor de procesamiento por lotes extrae datos de cada informe usando sus definiciones de columna y produce una hoja de cálculo unificada. Todas las filas se alinean con el mismo esquema de columnas, independientemente del instrumento que generó cada PDF de origen. El tiempo de procesamiento para 50 informes es de aproximadamente 5 a 10 minutos de tiempo de máquina.
Valide las marcas OOS y verifique por muestreo
Abra la hoja de cálculo combinada y revise la columna "Pasa/No pasa". Cualquier fila marcada como NO PASA recibe atención prioritaria—abra el PDF de origen, verifique que el valor extraído coincida con el informe e inicie la investigación OOS si se confirma. Para las filas que pasan, verifique una muestra (10-15% de las filas) comparando los valores extraídos con los PDF de origen. Esto reemplaza escribir 600 campos por revisar de 60 a 90 campos.
Importe al software SPC y archive
Importe la hoja de cálculo validada en Minitab, InfinityQS, JMP o su plataforma SPC preferida. Los gráficos de control, los índices de capacidad y los análisis de tendencias se completan inmediatamente con el conjunto de datos completo. Guarde la salida de extracción junto con los PDF originales en el paquete de registro del lote para completar el rastro de auditoría. La hoja de cálculo de extracción se convierte en parte del registro permanente del lote requerido por 21 CFR 211.188.
En comparación con el flujo de trabajo convencional de extracción de un solo informe, el enfoque por lotes adelanta la definición de columnas y la configuración del instrumento, y luego procesa todos los informes en paralelo—el mismo trabajo de configuración que tomaría 10 minutos para un informe toma los mismos 10 minutos para 50. Esa economía de escala es lo que el diseño de procesamiento por lotes prioritario desbloquea.
Preguntas Frecuentes
¿Funciona con notas manuscritas o anotaciones en los informes de laboratorio?
Sí. El motor de IA maneja tanto texto impreso como escritura a mano—incluyendo números de lote manuscritos, iniciales del analista o notas al margen que aparecen junto a los resultados impresos del instrumento. Si un técnico escribe a mano el factor de dilución o el peso de la muestra en el informe impreso, ese valor puede extraerse en su propia columna junto con los datos impresos del instrumento. Para laboratorios que utilizan principalmente registro en papel, consulte nuestra guía de extracción de informes de laboratorio de QC para técnicas específicas de formularios manuscritos.
¿Qué pasa con las impresiones térmicas escaneadas de instrumentos más antiguos?
Las impresiones térmicas escaneadas o fotografiadas funcionan igual que los PDF digitales—la IA lee el contenido visual independientemente de si se originó como informe digital o impresión en papel. Sin embargo, el papel térmico desvanecido (común en impresiones de más de 6 a 12 meses) puede reducir la precisión de la extracción. Para registros térmicos archivados, la mejor práctica es fotografiarlos con iluminación constante dentro de unas semanas de la impresión, antes de que el recubrimiento térmico se degrade.
¿Necesito una configuración separada para cada modelo de instrumento?
No. Debido a que la Extracción de Columnas Personalizadas funciona semánticamente en lugar de por coincidencia de plantillas, las mismas definiciones de columnas funcionan en todos los instrumentos. "Ensayo (%)" encuentra el valor de ensayo ya sea que aparezca en un informe de Shimadzu, un informe de Agilent o un informe de Mettler Toledo. La única vez que podría agregar columnas específicas del instrumento es cuando diferentes tipos de instrumentos miden parámetros fundamentalmente distintos—no buscaría "Resistencia a la Tracción" en un informe de HPLC porque no existe allí. La IA simplemente devuelve vacío para las columnas que no tienen datos coincidentes en un informe determinado.
¿Cómo afecta esto al cumplimiento de 21 CFR Parte 11 para registros electrónicos?
La herramienta de extracción por lotes genera una hoja de cálculo de salida a partir de los PDF del instrumento: es un paso de transformación de datos, no un sistema de registro. Los PDF originales del instrumento siguen siendo sus registros fuente electrónicos, sujetos a los mismos controles de la Parte 11 (pistas de auditoría, firmas electrónicas, controles de acceso) que su laboratorio ya aplica a la salida del instrumento. La hoja de cálculo de extracción sirve como documento de trabajo para el análisis SPC y la compilación de registros de lotes. Para laboratorios que operan bajo requisitos completos de registros electrónicos de la Parte 11, los datos extraídos deben ser revisados y aprobados por la unidad de calidad en su sistema de gestión de documentos o LIMS existente, tal como se haría con los datos ingresados manualmente. La automatización cambia cómo se mueven los datos del instrumento a la hoja de cálculo; no cambia su marco de cumplimiento: reduce los errores de transcripción que generan hallazgos de cumplimiento.
¿Puedo procesar informes de múltiples sitios de fabricación en una vista SPC empresarial unificada?
Sí. Al agregar una columna "Sitio" a su plantilla de extracción y procesar los informes diarios de cada sitio como lotes separados (cada uno produciendo su propio archivo de salida), puede consolidar todos los datos del sitio en un único panel SPC empresarial. El esquema de columnas unificado en todos los sitios significa que los datos del HPLC Shimadzu de la Planta A y del sistema Waters Alliance de la Planta B llegan en el mismo formato estructurado. Esto es particularmente valioso para organizaciones que implementan monitoreo SPC empresarial de estilo IATF 16949 en múltiples ubicaciones de fabricación.
¿Qué pasa con los instrumentos de laboratorio que exportan directamente al LIMS? ¿Aún necesito esto?
Si cada instrumento en su laboratorio exporta datos estructurados directamente a un LIMS, y ese LIMS alimenta su software SPC, no tiene un problema de transcripción manual. Pero en la mayoría de los laboratorios de control de calidad de fabricación, lo que está conectado directamente suele ser una minoría de instrumentos: el HPLC puede exportar a través de CDS, pero el titulador, la balanza de humedad, el viscosímetro y el durómetro aún generan PDF o impresiones independientes. La extracción por lotes cierra la brecha entre los instrumentos conectados y los no conectados, produciendo una salida unificada que se puede importar junto con las fuentes de datos del LIMS. El panorama de extracción de documentos de fabricación está evolucionando hacia modelos híbridos donde las fuentes de instrumentos estructurados y los datos PDF extraídos por IA coexisten en el mismo pipeline SPC.
¿Cómo manejar muestras analizadas en múltiples estaciones de prueba con distintas especificaciones?
Defina una estructura de columnas que incluya el contexto de la estación de prueba: "Materia Prima | Identidad (Apto/No apto)", "En Proceso | Ensayo (%)", "Producto Terminado | Disolución (%)". Cada columna se aplica solo a los informes que contienen ese parámetro, por lo que un informe de materia prima completa las columnas de materia prima, un informe de producto terminado completa las columnas de producto terminado, y la hoja de cálculo resultante divide naturalmente los resultados por estación de prueba, dejando celdas en blanco donde un parámetro no aplica a una muestra determinada. También puede usar técnicas de procesamiento por lotes desarrolladas para otros tipos de documentos de fabricación; el enfoque basado en columnas se transfiere entre categorías de documentos.