50 Relatórios de QC, Uma Planilha SPC: Como
Processar Dados em Lote Sem Entrada Manual
Um único laboratório de QC executando 30 testes de liberação de produto acabado por dia—cada um com 15 a 20 parâmetros medidos de três ou quatro instrumentos diferentes—gera aproximadamente 450 a 600 pontos de dados que alguém precisa digitar em uma planilha antes que qualquer pessoa possa construir um gráfico SPC. Na taxa de erro de entrada manual de 1% por campo, amplamente citada, isso significa 4 a 6 números errados entrando na pasta de trabalho todos os dias. Mas o verdadeiro multiplicador de danos é o que acontece em seguida: cada erro de transcrição que cai dentro de um gráfico de controle tem uma chance não trivial de acionar um sinal fora de controle. Para um laboratório operando sob 21 CFR 211.192, esse sinal não apenas marca um gráfico—ele aciona uma investigação obrigatória. Um único dígito digitado incorretamente pode consumir de 4 a 8 horas do tempo do analista e do supervisor, e o lote permanece não liberado durante esse período.
Principais Conclusões
- Trinta testes diários de QC com 3 minutos de entrada manual cada custam ao seu laboratório $21.000 por ano em mão de obra de transcrição—digitando números que os instrumentos já geraram.
- O custo que seu orçamento nunca mostra: cada dígito digitado incorretamente dentro de um gráfico de controle pode acionar uma investigação OOS obrigatória consumindo de 4 a 8 horas, e cada alarme fantasma treina os operadores a parar de confiar nos gráficos SPC.
- Defina os nomes das colunas SPC uma vez, faça o upload em lote de 50 PDFs de instrumentos de qualquer marca em uma única operação e receba uma planilha pronta para auditoria com sinalizadores OOS destacados em uma única coluna—sua função muda de digitar 600 campos por dia para revisar apenas as exceções sinalizadas.
A Armadilha da Entrada em Duas Etapas em Laboratórios de QC
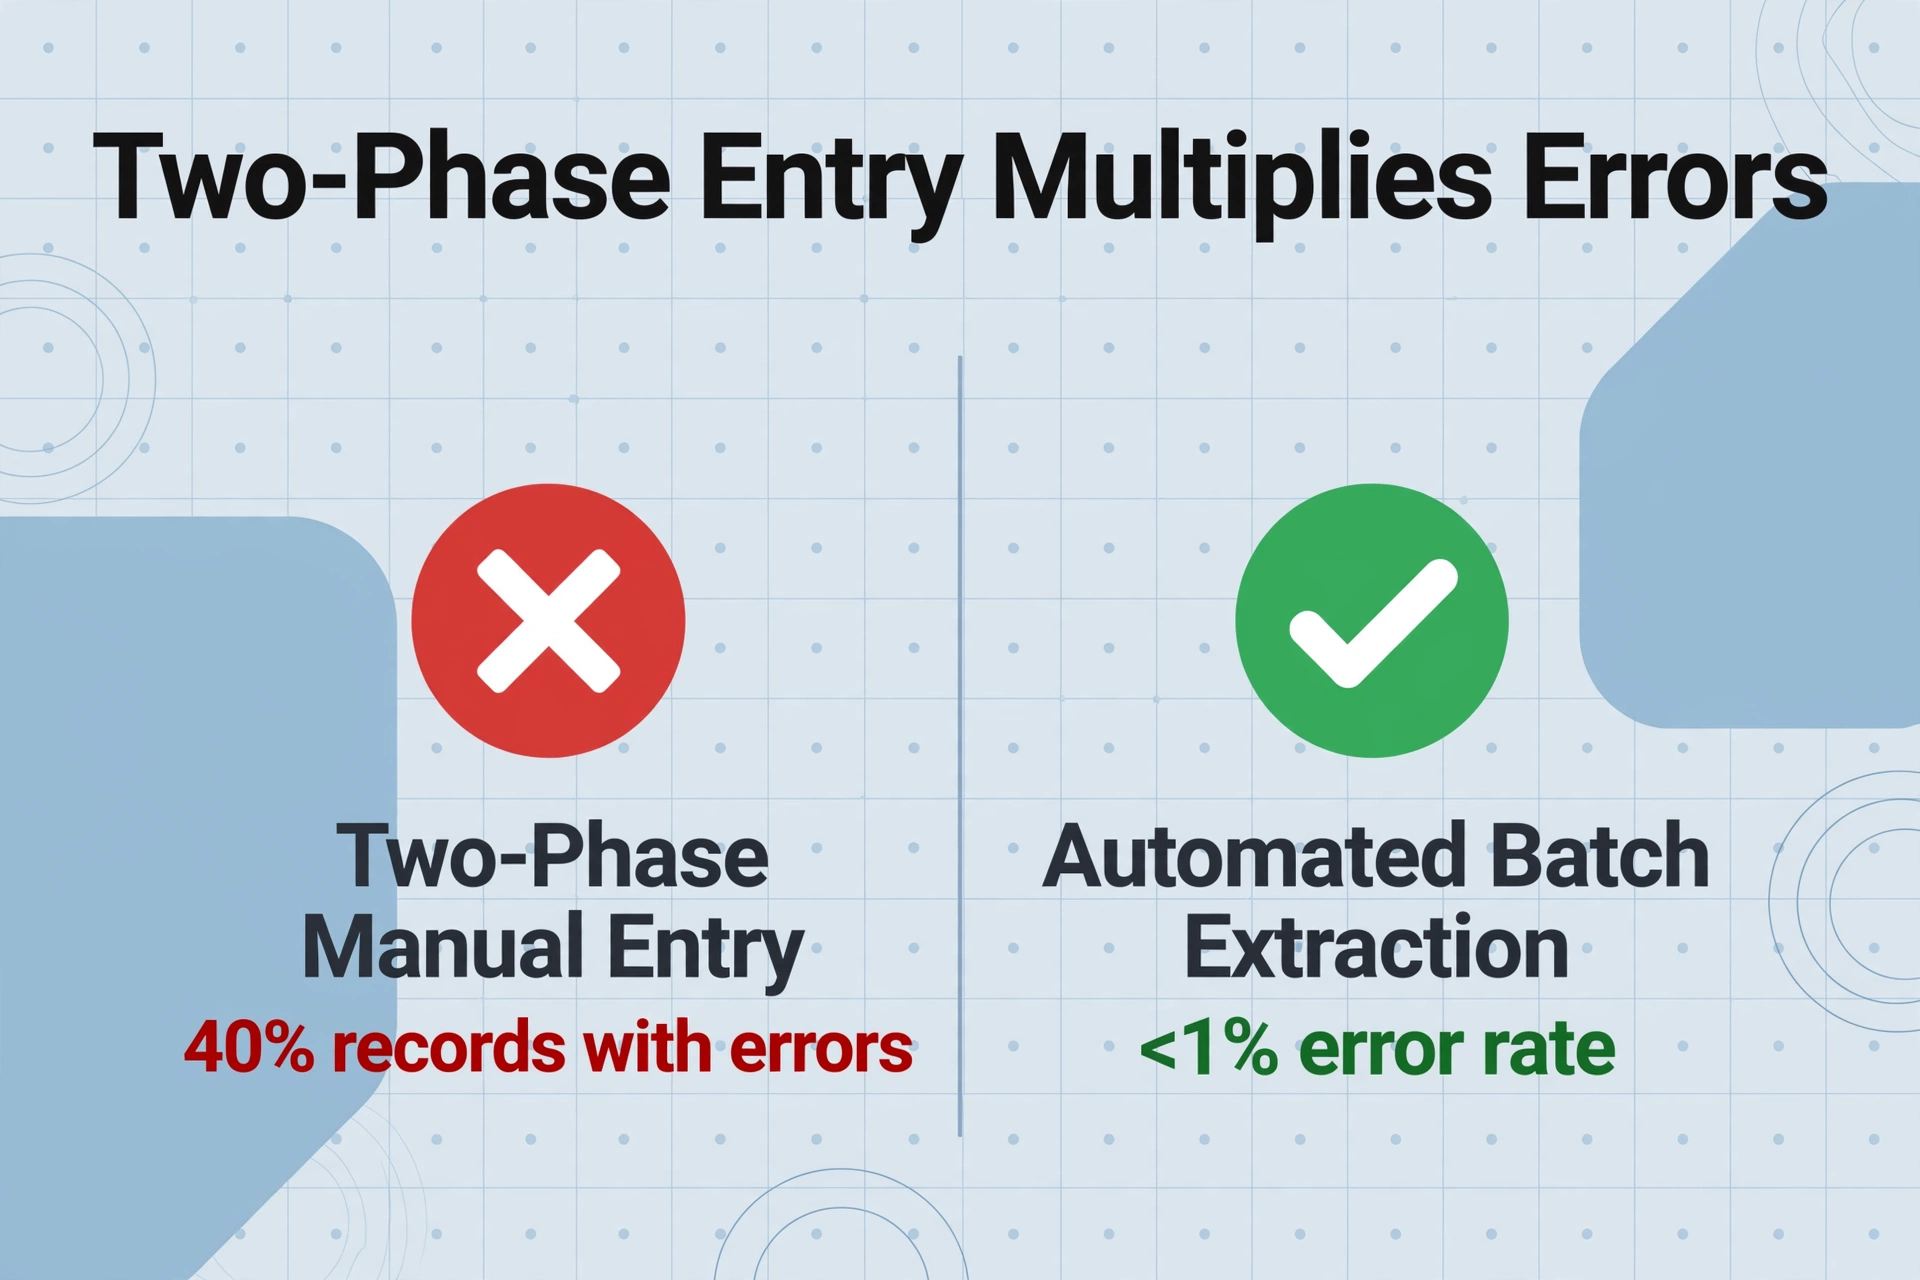
A maioria dos laboratórios de QC na manufatura não faz entrada manual em etapa única. Eles fazem entrada em duas etapas: um técnico registra as medições em papel no instrumento, e uma segunda pessoa—às vezes o mesmo técnico, às vezes outro—transcreve esses valores do papel para o Excel ou um LIMS. Cada etapa multiplica a exposição a erros.
De acordo com a Beamex, quando os dados passam por dois pontos de entrada manual, estatisticamente 40% dos registros contêm pelo menos um erro. Uma instalação que realiza 10.000 calibrações ou testes de qualidade por ano com entrada em duas etapas gera aproximadamente 4.000 pontos de dados defeituosos. Esses não são números teóricos—eles representam investigações reais, retrabalho real e horas reais gastas por pessoas que deveriam estar analisando tendências, não perseguindo erros de digitação.
A consequência que recebe menos atenção é o que os erros de entrada manual fazem com a credibilidade dos gráficos de SPC. Quando os operadores veem gráficos de controle acionando rotineiramente com base no que sabem ser erros de entrada de dados, eles param de confiar nos gráficos. Cada sinal fora de controle fantasma treina o chão de fábrica para acreditar que o sistema de SPC está "chorando lobo"—e uma vez que essa lição é absorvida, os sinais reais de qualidade se perdem no ruído. Um gerente de laboratório que descartou cinco alarmes falsos em um mês dificilmente responderá com urgência ao sexto, que era legítimo. O investimento em automação que muitas plantas fizeram em software de SPC é parcialmente desperdiçado se os dados que o alimentam ainda são digitados manualmente.
Para um laboratório de QC processando 30 testes de liberação de lote diariamente com 15–20 parâmetros medidos cada, uma taxa de erro de transcrição de 1% no nível de campo significa 120–180 erros por mês entrando nas planilhas de SPC. Cada erro arrisca uma retenção indevida de lote ou uma liberação que deveria ter sido interrompida.
Por que a Extração de Relatório Único Não Sobrevive à Escala de Lote
Ferramentas de extração de relatório único—aquelas em que você envia um PDF, obtém uma linha de dados e repete—são otimizadas para um fluxo de trabalho que não existe em um laboratório de QC de produção. Ninguém executa um teste, obtém um relatório e insere uma linha. A realidade diária é uma pilha: o HPLC Shimadzu terminou sua execução e gerou um PDF com 12 parâmetros de ensaio. O titulador Karl Fischer da Mettler Toledo produziu seu relatório de teor de umidade. A máquina de teste de tração Instron gerou seu resumo de propriedades mecânicas. O GC Agilent retornou sua análise de solventes residuais. Multiplique pelo número de lotes testados naquele dia, e você terá de 30 a 50 relatórios de instrumentos que precisam ser mesclados em um único conjunto de dados antes que qualquer análise de SPC possa começar.
O processamento em lote não é apenas o processamento único feito 50 vezes. Ele introduz desafios que um fluxo de trabalho um-a-um nunca encontra:
- Convenções de nomenclatura quebram em escala. Ao processar um relatório, a linha de saída pertence a um lote. Ao processar 50, você precisa de identificadores de lote, IDs de amostra, IDs de instrumento e carimbos de data/hora anexados a cada linha para que a planilha mesclada permaneça consultável e rastreável. Uma coluna chamada "Ensaio (%)" com 50 cabeçalhos idênticos é inútil—você precisa de "Lote-20260627-01 | HPLC | Ensaio (%)" no fluxo de trabalho, ou melhor ainda, o instrumento e o lote como colunas separadas vinculando cada linha à sua origem.
- A mesclagem de resultados é o verdadeiro gargalo, não a velocidade de extração. Mesmo que você pudesse extrair cada relatório em 10 segundos, mesclar manualmente 50 linhas de saída na pasta de trabalho mestre de SPC—alinhando colunas de instrumentos com diferentes convenções de layout, verificando lacunas, resolvendo colunas duplicadas—consome o tempo que você economizou na extração. Uma ferramenta projetada para processamento em lote produz uma planilha unificada em uma única passagem, com todas as linhas alinhadas ao mesmo esquema de colunas.
- O tratamento de exceções se acumula. Um relatório único com um parâmetro ausente é uma decisão de 5 segundos. Um lote de 50 relatórios onde 6 estão faltando campos diferentes, 2 têm valores de impressão térmica ilegíveis e 3 contêm sinalizações de OOS se torna um exercício de reconciliação de 45 minutos. O processamento em escala de lote precisa expor exceções sistematicamente—não deixar você rolando por 50 linhas em busca de lacunas.
Para um passo a passo mais detalhado do fluxo de trabalho de extração de relatório único para laboratórios de QC, consulte nosso guia prático sobre extração de dados de relatórios de laboratório de QC de manufatura para Excel. O restante deste artigo foca no que muda quando você precisa fazer isso 50 vezes por dia.
Como PDFs Gerados por Instrumentos Superam Ferramentas Baseadas em Modelos
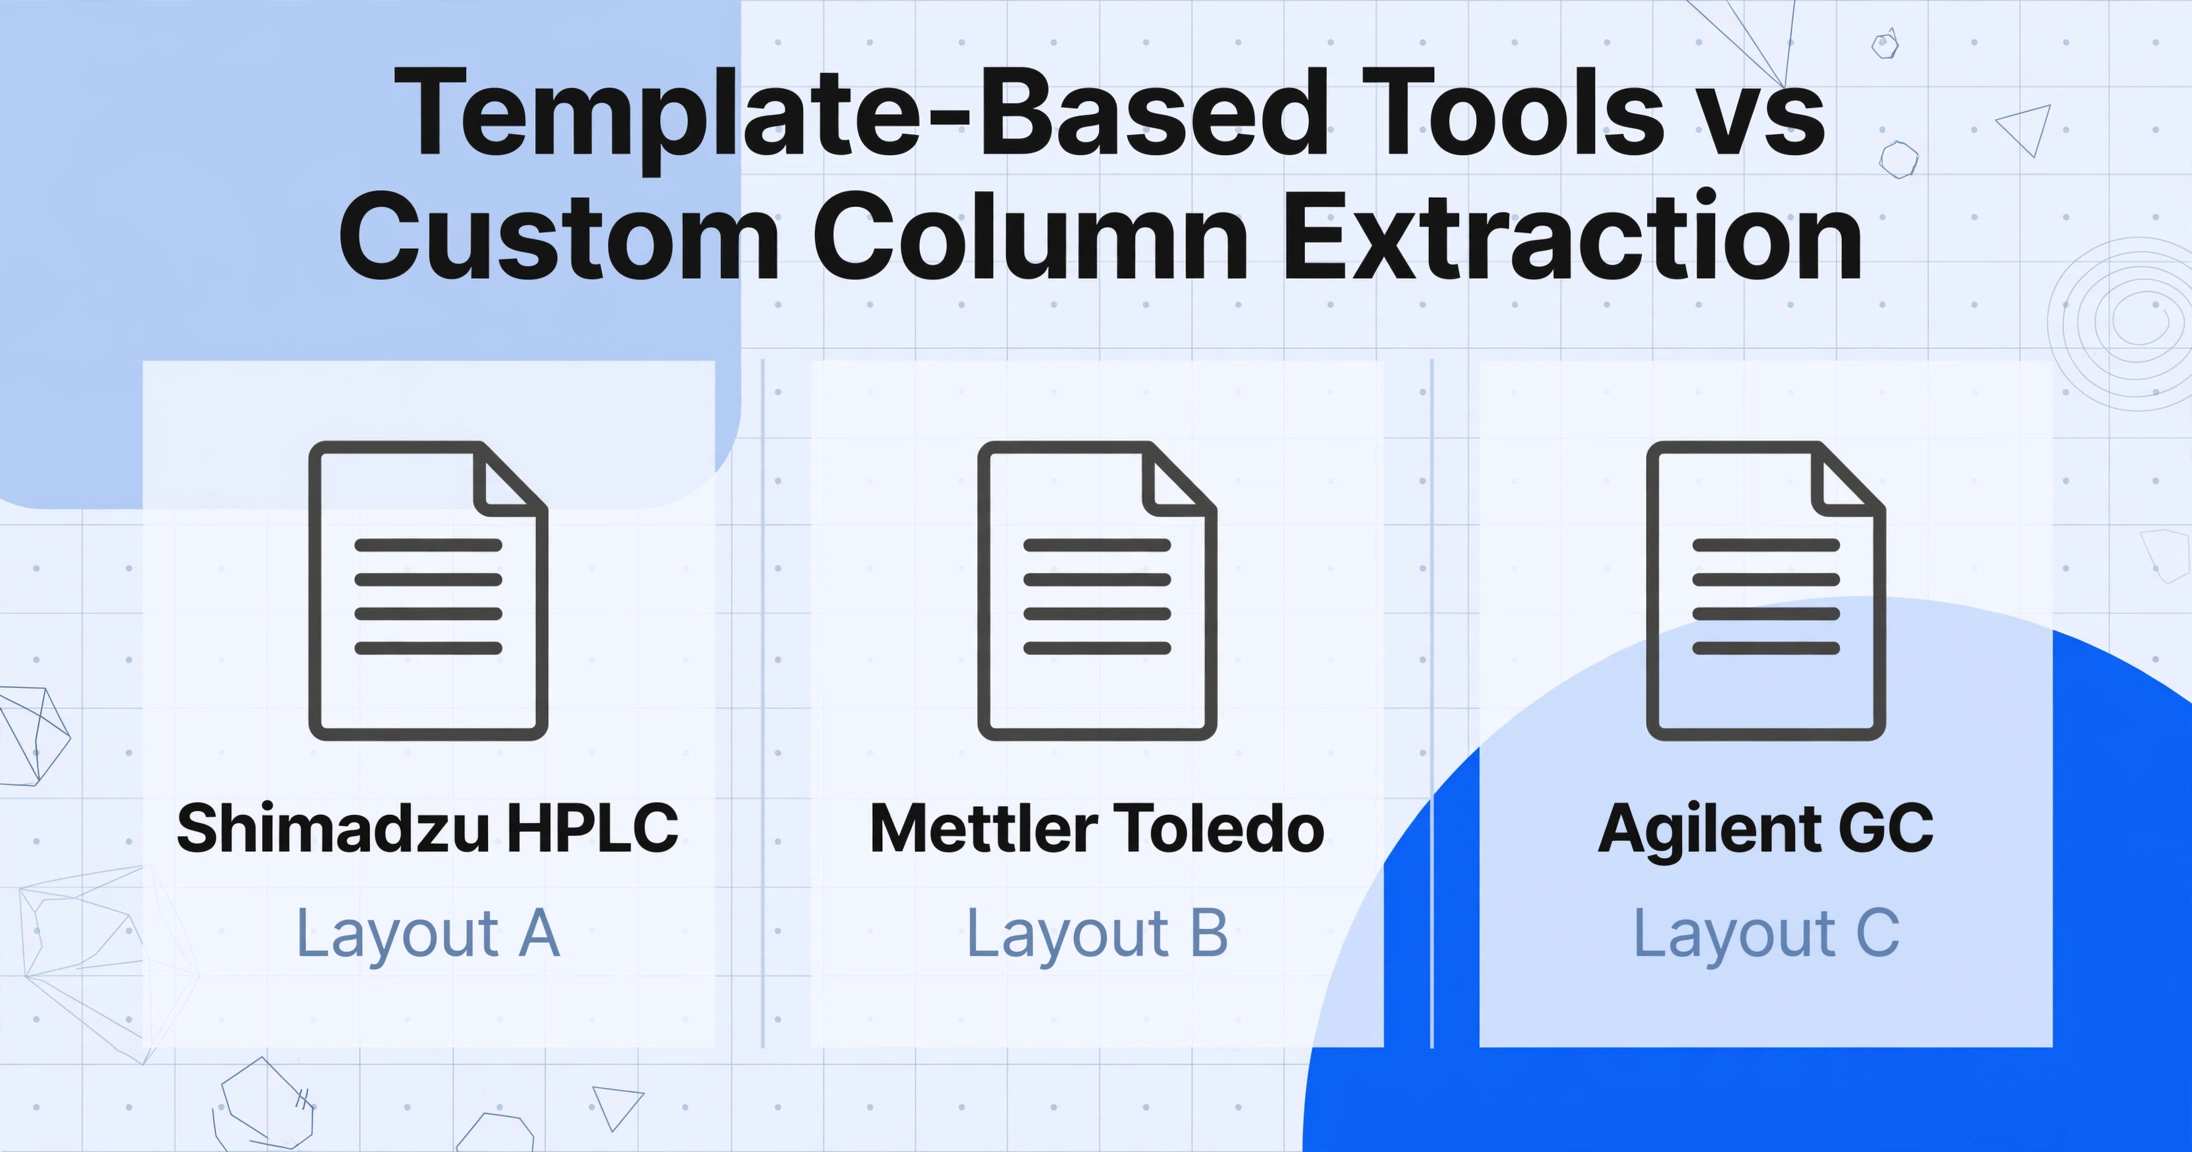
Ao entrar em um laboratório de QC com instrumentos de diferentes fornecedores, você encontra um problema de fragmentação de formatos que ferramentas de extração baseadas em modelos nunca foram projetadas para resolver. Um Shimadzu HPLC executando LabSolutions imprime resultados de ensaio em uma tabela com colunas rotuladas como "Compound Name / Retention Time / Area / Concentration / Unit." Um titulador Mettler Toledo executando LabX imprime um relatório com "Sample ID / Result / RSD / n" em um layout completamente diferente. Um Agilent GC executando OpenLab CDS produz ainda outra estrutura—às vezes com o mesmo parâmetro nomeado de forma diferente entre versões de software. Três instrumentos, três layouts de PDF, e nenhum deles foi projetado para ser lido por máquina em uma planilha.
Ferramentas tradicionais de OCR e IDP baseadas em modelos exigem que você defina, para cada layout de PDF de instrumento, as coordenadas exatas ou padrões de ancoragem onde cada ponto de dados está localizado. Quando o laboratório atualiza para uma nova versão do LabSolutions e o layout do relatório muda em três linhas, o modelo quebra silenciosamente—extraindo o valor errado para a coluna errada, sem qualquer indicação de que algo deu errado até o QA detectar na revisão em lote. Um laboratório com cinco instrumentos e atualizações periódicas de software está efetivamente mantendo cinco modelos de extração frágeis que se degradam com o tempo.
A alternativa é a Extração de Colunas Personalizadas: em vez de dizer à ferramenta onde os dados estão na página, você diz a ela quais dados deseja. Digite os cabeçalhos de coluna que correspondem aos seus campos de dados SPC—"Assay (%)", "Moisture Content (%)", "Tensile Strength (MPa)"—e a IA localiza cada valor entendendo o que o texto significa, não onde ele aparece. Um resultado impresso como "Assay: 99.2%" em um relatório e "Content: 99.2% (as-is basis)" em outro é mapeado para a mesma coluna de saída porque o modelo reconhece ambos como valores de ensaio, não porque ambos apareceram em X=320, Y=480. Essa abordagem semântica—sem modelo e independente de formato—é o único paradigma de extração que permanece funcional em um ambiente de laboratório com múltiplos instrumentos.
Para laboratórios que operam instrumentos Agilent, Shimadzu e Mettler Toledo lado a lado, as mesmas definições de coluna funcionam em todos os três formatos de instrumento sem reconfiguração. A saída da extração é consolidada em uma única planilha com estrutura de coluna idêntica, independentemente de qual instrumento gerou cada PDF de origem. Essa é a diferença fundamental entre uma ferramenta projetada para ambientes de lote com formato variável e uma otimizada para uso de formato único e relatório único.
O Problema da Sinalização de OOS Que Ninguém Menciona
Um resultado Fora de Especificação em um relatório de laboratório de QC não é apenas um número em vermelho. De acordo com a orientação de investigação de OOS da FDA de 2006, todo resultado OOS aciona uma investigação obrigatória em duas fases: a Fase I examina se um erro de laboratório causou o resultado, a Fase II investiga o próprio processo de fabricação. A investigação deve ser documentada, a causa raiz identificada e as ações corretivas implementadas antes que o lote possa ser liberado. Uma única investigação de OOS consome rotineiramente de 3 a 10 dias úteis, e o requisito de revisão do registro do lote sob 21 CFR 211.192 significa que a unidade de qualidade deve aprovar cada conclusão da investigação.
Agora considere o que acontece quando os resultados de OOS passam por uma etapa de transcrição manual. Um técnico digita "0,052" quando o relatório do instrumento dizia "0,025"—uma transposição de um único dígito—e o valor excede o limite de especificação. O gráfico de SPC sinaliza. A investigação começa. Quatro horas depois, a QA encontra a impressão original do instrumento, compara com a entrada no Excel e descobre que foi um erro de digitação. O lote nunca esteve fora de especificação. A investigação foi desperdiçada em um erro de teclado.
O cenário inverso é mais perigoso: um relatório de instrumento mostra um valor de OOS genuíno, o técnico o transcreve incorretamente como um valor aprovado, e o lote é liberado sem investigação. A causa raiz da fabricação—contaminação, desvio de processo, variabilidade da matéria-prima—permanece não detectada até afetar lotes subsequentes, potencialmente desencadeando um recall. Um erro de transcrição não apenas desperdiçou tempo; ele contornou uma salvaguarda regulatória projetada para detectar falhas sistêmicas de qualidade.
Quando a extração é automatizada, as sinalizações de OOS são tratadas sistematicamente. Defina uma coluna inferida chamada "Status de Aprovado/Reprovado" com uma regra como "APROVADO se todos os valores medidos estiverem dentro dos limites de especificação; REPROVADO se qualquer valor estiver fora da especificação"—a IA avalia cada valor extraído contra sua especificação durante o processamento e sinaliza violações automaticamente. A planilha de saída contém uma coluna dedicada onde as condições de OOS são exibidas em todos os 50 relatórios em uma única visão. Em vez de percorrer PDFs de instrumentos procurando texto em vermelho, os revisores de QC examinam uma coluna, identificam as três linhas REPROVADO e abrem apenas esses três relatórios para investigação. A atenção vai para onde pertence: para as exceções, não para verificar cada número que já foi impresso corretamente pelo instrumento.
Fechando a Lacuna Entre a Saída do Instrumento e a Entrada no SPC
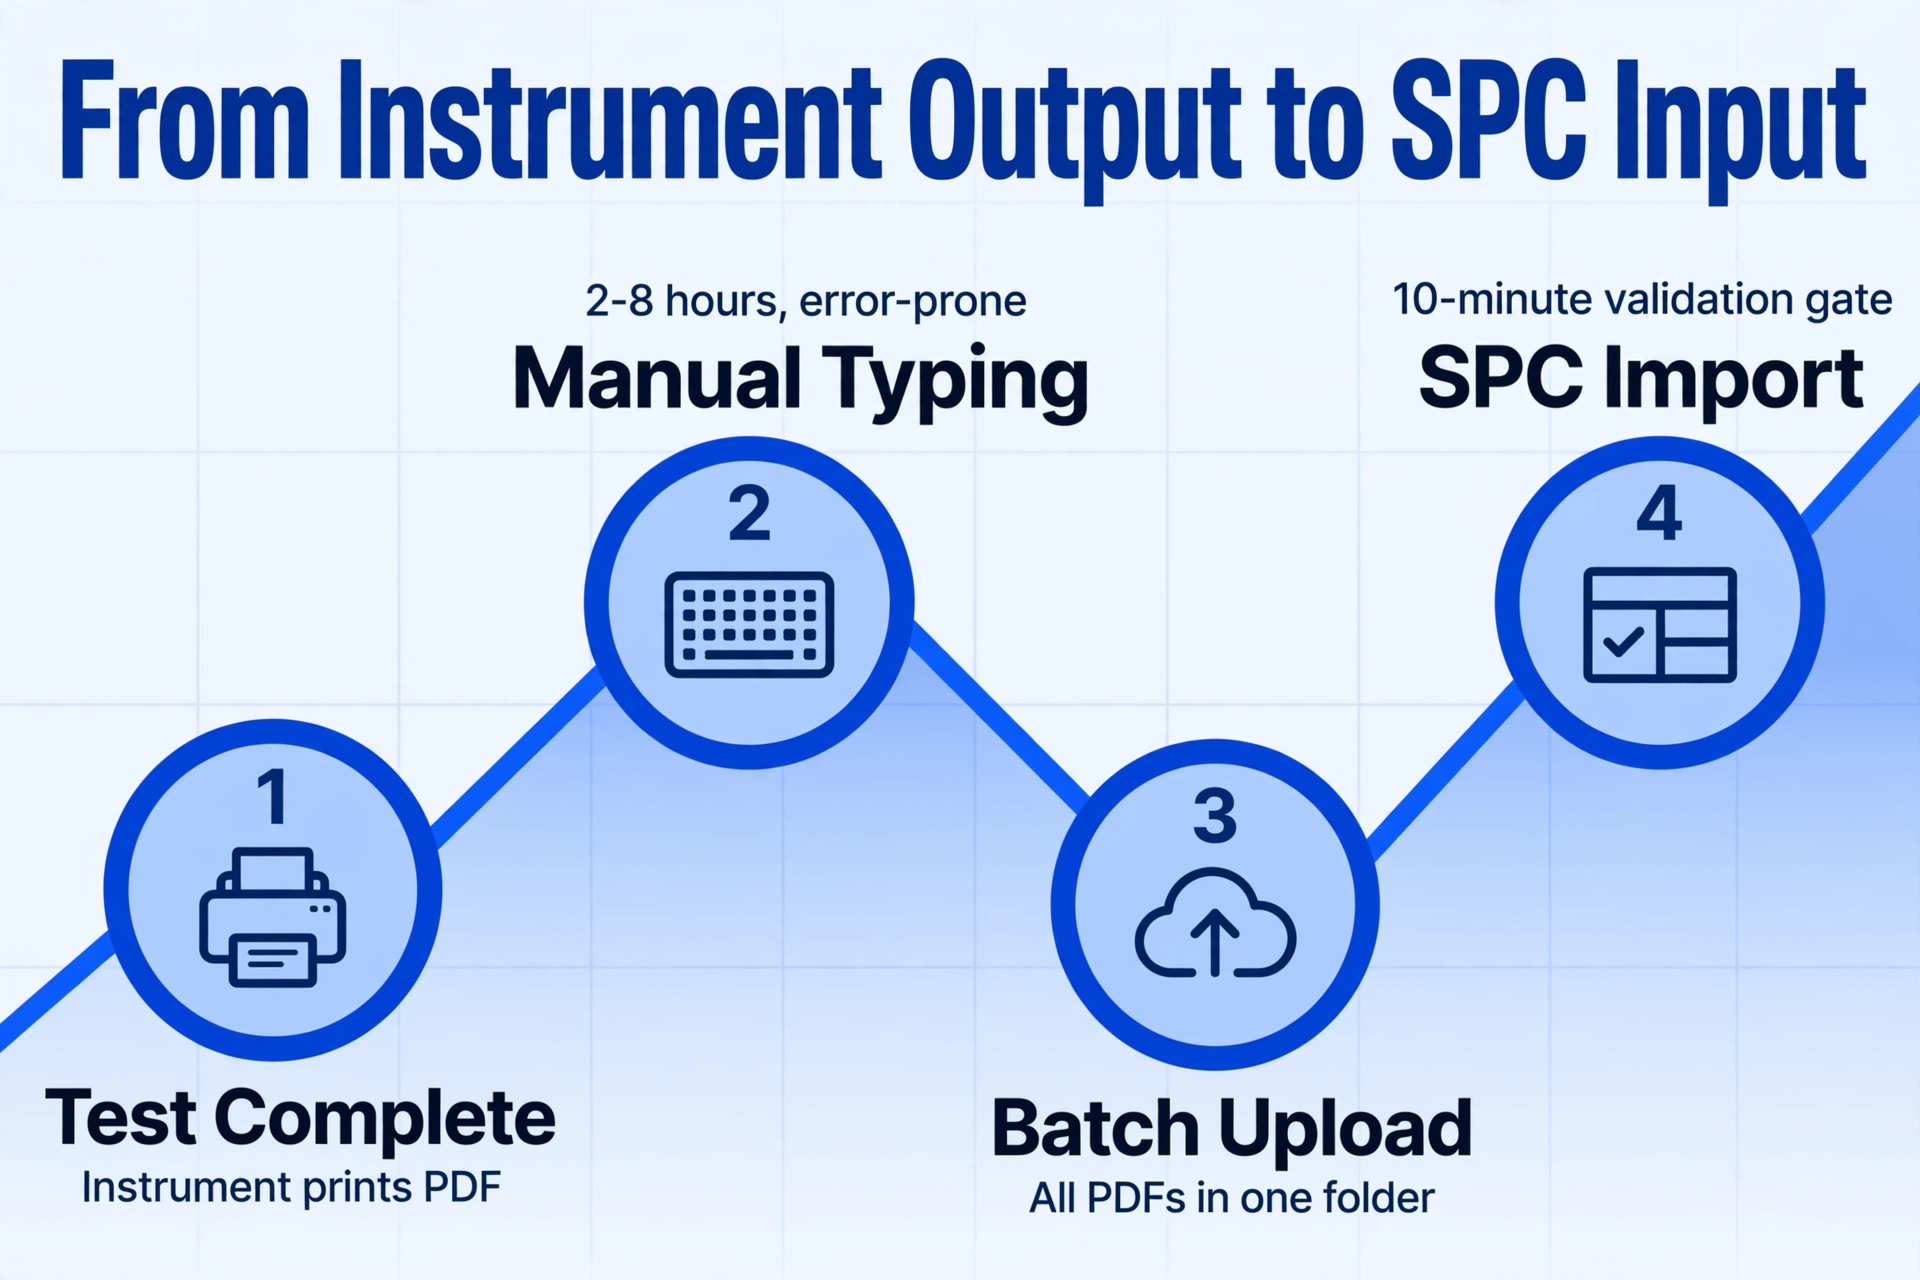
O fluxo de dados em um laboratório de controle de qualidade manual é assim: instrumento conclui o teste → instrumento imprime PDF → técnico lê o PDF → técnico digita os números no Excel → QA revisa o Excel → dados copiados para o software SPC para criação de gráficos de controle. Cada seta nessa cadeia é um ponto de latência e um ponto de introdução de erros. A lacuna entre "teste concluído" e "dados no SPC" é tipicamente de 2 a 8 horas—não porque o teste demora, mas porque o pipeline de transcrição-revisão-cópia é sequencial e no ritmo humano.
Em um pipeline automatizado em lote, o fluxo se reduz a: instrumentos concluem testes ao longo do dia → todos os PDFs são coletados em uma pasta de lote → lote enviado no final do turno ou do dia → IA extrai todos os relatórios em uma planilha estruturada → planilha importada diretamente no software SPC. A etapa de extração em si leva de 5 a 10 segundos por página, então 50 relatórios são concluídos em menos de 10 minutos de processamento. A janela de transcrição de 2 a 8 horas se torna um portão de validação de 10 minutos, onde os revisores de QC verificam uma amostra dos resultados em vez de digitar cada campo.
A maioria das plataformas de software SPC—Minitab Real-Time SPC, InfinityQS, JMP, WinSPC, dataPARC—aceita importação CSV ou Excel como caminho padrão de ingestão de dados. A planilha que sai da extração em lote já está formatada para esta etapa de importação: cada linha é um resultado de teste, cada coluna corresponde a um parâmetro SPC, e os limites de controle configurados no software SPC geram automaticamente gráficos I-MR, Xbar-R ou Xbar-S no momento em que os dados carregam. Os cálculos de Cp e Cpk são atualizados imediatamente porque o conjunto de dados subjacente está completo e corretamente estruturado desde o início.
A matemática de produtividade: um laboratório que processa 30 lotes diários com 15 parâmetros cada, transcritos por um técnico que ganha $28/hora, gasta aproximadamente $84 por dia apenas em trabalho manual de entrada de dados (3 minutos por relatório × 30 relatórios = 90 minutos). Em um ano de 250 dias úteis, isso representa $21.000 em trabalho gasto digitando números que os instrumentos já geraram digitalmente. O tempo de investigação desencadeado por erros de transcrição—conservadoramente, uma investigação por semana com 4 horas—adiciona outros $5.600 anualmente. Os $26.600 combinados são o custo recorrente de não automatizar, antes de considerar os custos mais difíceis de quantificar de liberações de lotes atrasadas e confiança corroída nos gráficos SPC.
Construindo um Pipeline de Lotes de Registros Rastreáveis
A extração automatizada levanta uma questão legítima de conformidade: se ninguém está digitando os números, como provar a um auditor que o valor na planilha realmente veio do relatório do instrumento? A trilha de auditoria não desaparece na automação—ela muda de forma.
De acordo com a 21 CFR 211.188, os registros de produção e controle de lotes devem incluir documentação completa de cada etapa significativa, incluindo resultados de controle laboratorial e a identidade das pessoas que executam e verificam cada etapa. Quando a extração é automatizada, a cadeia de rastreabilidade funciona por metadados, não por digitação: cada linha na planilha de saída se vincula ao seu PDF de origem pelo nome do arquivo; o timestamp do processamento em lote registra quando a extração foi realizada; o usuário que iniciou o lote e revisou os resultados é registrado; e os PDFs originais permanecem disponíveis como a fonte imutável da verdade.
A norma ASTM D6299 para garantia estatística da qualidade enfatiza que as estatísticas do gráfico de controle devem ser calculadas a partir de dados rastreáveis e verificáveis. Um pipeline de extração automatizada com referências ao arquivo de origem em cada linha atende a esse requisito de forma mais sistemática do que uma entrada manual em um livro de registro, porque o vínculo entre o valor da planilha e o relatório do instrumento é programático, em vez de depender de alguém se lembrar de anotar qual impressão do instrumento estava sendo consultada. Auditores inspecionando um registro de lote podem clicar da linha da planilha de volta ao PDF original e confirmar o valor em menos de 30 segundos—mais rápido e mais definitivo do que rastrear a caligrafia em um registro em papel.
O fluxo de trabalho prático para conformidade: organize os PDFs diários dos instrumentos em pastas por data e estação de teste (Matéria-Prima / Em Processo / Produto Acabado), processe em lote os relatórios de cada estação em sua própria planilha com uma coluna identificando o instrumento de origem e salve a saída junto com os PDFs originais no pacote do registro de lote. A planilha extraída se torna o arquivo de dados de trabalho para análise SPC; os PDFs originais permanecem como a evidência imutável. Isso é estruturalmente semelhante a como os laboratórios já lidam com arquivos de dados cromatográficos—a pasta .lcm ou .d bruta é a fonte, o relatório processado é a saída de trabalho—estendido para o conjunto completo de instrumentos no laboratório.
Configuração do Fluxo de Trabalho de Processamento em Lote
Passar da transcrição manual à extração automatizada em lote não exige um projeto de implementação de LIMS. O seguinte fluxo de trabalho pode estar operativo em um único turno:
Defina suas colunas de SPC
Liste cada parâmetro de teste que alimenta seus gráficos de SPC: "Ensaio (%)", "Teor de Umidade (%)", "pH", "Viscosidade (cP)", "Dissolução (%)", "Dureza (N)", etc. Esses se tornam os nomes das colunas no seu modelo de extração. Adicione também colunas de metadados: "ID do Lote", "ID da Amostra", "Estação de Teste", "Instrumento", "Data do Teste". Adicione uma coluna inferida "Aprovado/Reprovado" para sinalizar automaticamente condições de OOS em relação aos seus limites de especificação.
Colete relatórios diários dos instrumentos
Ao final de cada turno ou do dia, reúna todos os relatórios em PDF gerados pelos instrumentos em pastas organizadas por estação de teste. A maioria dos softwares de controle de instrumentos—LabSolutions, OpenLab, LabX—pode ser configurada para salvar automaticamente relatórios em PDF em uma pasta de rede, eliminando a etapa de imprimir e depois escanear. Se o seu laboratório ainda usa instrumentos com impressoras térmicas, escaneie ou fotografe as impressões em arquivos de imagem—a IA lida tanto com PDFs digitais quanto com impressões fotografadas usando as mesmas definições de colunas.
Upload em lote e extração
Carregue todos os PDFs da pasta do lote do dia em uma única operação. O mecanismo de processamento em lote extrai dados de cada relatório usando suas definições de colunas e produz uma planilha unificada. Todas as linhas são alinhadas ao mesmo esquema de colunas, independentemente de qual instrumento gerou cada PDF de origem. O tempo de processamento para 50 relatórios é de aproximadamente 5 a 10 minutos de tempo de máquina.
Valide os alertas de OOS e faça verificação por amostragem
Abra a planilha mesclada e revise a coluna "Aprovado/Reprovado". Qualquer linha sinalizada como REPROVADO recebe atenção prioritária—abra o PDF de origem, verifique se o valor extraído corresponde ao relatório e inicie a investigação de OOS se confirmado. Para linhas aprovadas, faça uma verificação por amostragem (10-15% das linhas) comparando os valores extraídos com os PDFs de origem. Isso substitui a digitação de 600 campos pela revisão de 60 a 90 campos.
Importe para o software de SPC e arquive
Importe a planilha validada para o Minitab, InfinityQS, JMP ou sua plataforma de SPC de preferência. Gráficos de controle, índices de capacidade e análises de tendência são preenchidos imediatamente a partir do conjunto de dados completo. Salve a saída da extração junto com os PDFs originais no pacote de registro do lote para completude da trilha de auditoria. A planilha de extração torna-se parte do registro permanente do lote exigido pela 21 CFR 211.188.
Em comparação com o fluxo de trabalho convencional de extração de relatório único, a abordagem em lote antecipa a definição de colunas e a configuração do instrumento, processando todos os relatórios em paralelo—o mesmo trabalho de configuração que levaria 10 minutos para um relatório leva os mesmos 10 minutos para 50. Essa economia de escala é o que o design de processamento prioritário em lote proporciona.
Perguntas Frequentes
Isso funciona com anotações ou observações manuscritas em relatórios de laboratório?
Sim. O mecanismo de IA processa tanto texto impresso quanto manuscrito—incluindo números de lote manuscritos, iniciais de analistas ou anotações marginais que aparecem junto aos resultados impressos pelo instrumento. Se um técnico escreve à mão o fator de diluição ou o peso da amostra no relatório impresso, esse valor pode ser extraído para uma coluna própria, junto aos dados impressos pelo instrumento. Para laboratórios que usam principalmente registro em papel, consulte nosso guia de extração de relatórios de laboratório de QC para técnicas específicas para formulários manuscritos.
E quanto a impressões térmicas digitalizadas de instrumentos mais antigos?
Impressões térmicas digitalizadas ou fotografadas funcionam da mesma forma que PDFs digitais—a IA lê o conteúdo visual independentemente de ter sido originado como relatório digital ou impressão em papel. No entanto, papel térmico desbotado (comum em impressões com mais de 6 a 12 meses) pode reduzir a precisão da extração. Para registros térmicos de arquivo, a melhor prática é fotografá-los sob iluminação consistente dentro de algumas semanas após a impressão, antes que o revestimento térmico se degrade.
Preciso de uma configuração separada para cada modelo de instrumento?
Não. Como a Extração de Colunas Personalizadas funciona semanticamente, em vez de por correspondência de modelo, as mesmas definições de coluna funcionam em todos os instrumentos. "Ensaio (%)" encontra o valor do ensaio esteja ele em um relatório Shimadzu, Agilent ou Mettler Toledo. A única ocasião em que você pode adicionar colunas específicas do instrumento é quando diferentes tipos de instrumentos medem parâmetros fundamentalmente diferentes—você não procuraria "Resistência à Tração" em um relatório de HPLC porque ela não existe lá. A IA simplesmente retorna vazio para colunas que não têm dados correspondentes em um determinado relatório.
Como isso afeta a conformidade com 21 CFR Part 11 para registros eletrônicos?
A ferramenta de extração em lote gera uma planilha de saída a partir de PDFs de instrumentos — é uma etapa de transformação de dados, não um sistema de registro. Os PDFs originais dos instrumentos continuam sendo seus registros eletrônicos de origem, sujeitos aos mesmos controles da Part 11 (trilhas de auditoria, assinaturas eletrônicas, controles de acesso) que seu laboratório já aplica à saída dos instrumentos. A planilha de extração serve como documento de trabalho para análise SPC e compilação de registros de lote. Para laboratórios que operam sob requisitos completos de registros eletrônicos da Part 11, os dados extraídos devem ser revisados e aprovados pela unidade da qualidade em seu sistema de gerenciamento de documentos ou LIMS existente, assim como os dados inseridos manualmente. A automação muda como os dados se movem do instrumento para a planilha; não altera sua estrutura de conformidade — reduz os erros de transcrição que geram não conformidades.
Posso processar relatórios de várias unidades fabris em uma única visão SPC corporativa?
Sim. Adicionando uma coluna "Unidade" ao seu modelo de extração e processando os relatórios diários de cada unidade como lotes separados (cada um gerando seu próprio arquivo de saída), você pode consolidar todos os dados das unidades em um único painel SPC corporativo. O esquema de colunas unificado em todas as unidades significa que os dados do HPLC Shimadzu da Planta A e do sistema Waters Alliance da Planta B chegam no mesmo formato estruturado. Isso é particularmente valioso para organizações que implementam monitoramento SPC corporativo no estilo IATF 16949 em várias unidades fabris.
E quanto aos instrumentos de laboratório que exportam diretamente para o LIMS — ainda preciso disso?
Se todos os instrumentos do seu laboratório exportam dados estruturados diretamente para um LIMS, e esse LIMS alimenta seu software SPC, você não tem um problema de transcrição manual. Mas na maioria dos laboratórios de controle de qualidade fabril, o que está diretamente conectado geralmente é uma minoria dos instrumentos — o HPLC pode exportar via CDS, mas o titulador, balança de umidade, viscosímetro e durômetro ainda geram PDFs ou impressões independentes. A extração em lote preenche a lacuna entre os instrumentos conectados e os não conectados, produzindo uma saída unificada que pode ser importada junto com os feeds de dados do LIMS. O cenário de extração de documentos fabris está evoluindo para modelos híbridos onde feeds estruturados de instrumentos e dados extraídos por IA coexistem no mesmo pipeline SPC.
Como lidar com amostras testadas em múltiplas estações de teste com especificações diferentes?
Defina uma estrutura de colunas que inclua o contexto da estação de teste: "Matéria-prima | Identidade (Aprovado/Reprovado)", "Em processo | Ensaio (%)", "Produto acabado | Dissolução (%)". Cada coluna se aplica apenas aos relatórios que contêm esse parâmetro. Assim, um relatório de matéria-prima preenche as colunas de matéria-prima, um relatório de produto acabado preenche as colunas de produto acabado, e a planilha de saída particiona naturalmente os resultados por estação de teste, com células em branco onde um parâmetro não se aplica a uma determinada amostra. Você também pode usar técnicas de processamento em lote desenvolvidas para outros tipos de documentos de fabricação—a abordagem baseada em colunas é transferível entre categorias de documentos.