QCレポート50件を1枚のSPCシートに:
手入力なしでデータを一括処理する方法
1つのQCラボで1日あたり30件の最終製品リリース試験を実施し、各試験で3~4種類の異なる機器から15~20項目の測定パラメータを取得する場合、SPCチャートを作成する前に、誰かがスプレッドシートに入力しなければならないデータポイントは1日あたりおよそ450~600件に上ります。一般的に引用されるフィールドあたり1%の手入力エラー率で計算すると、毎日4~6件の誤った数値がワークブックに入り込むことになります。しかし、本当のダメージはその先にあります。管理図内に入り込んだ転記エラーはそれぞれ、管理外シグナルを引き起こす可能性が無視できない確率で存在します。21 CFR 211.192の下で運営されているラボにとって、そのシグナルは単にチャートにフラグを立てるだけでは済まず、必須の調査を引き起こします。1桁の入力ミスがアナリストとスーパーバイザーの時間を4~8時間消費し、その間バッチはリリースされないままとなります。
重要ポイント
- 1日30件のQC試験を各3分の手入力で処理する場合、転記作業にかかる人件費は年間21,000ドルに達します。機器がすでに生成した数値を、ただ打ち直しているだけなのです。
- 予算には決して表れないコスト:管理図内の1桁の入力ミスが必須のOOS調査を引き起こし、4~8時間を消費する可能性があります。さらに、誤ったアラームが繰り返されると、オペレーターはSPCチャートそのものを信頼しなくなってしまいます。
- SPCの列名を一度定義し、あらゆるメーカーの機器PDF50件を1回の操作で一括アップロードすれば、OOSフラグが1つの列に表示された監査対応済みスプレッドシートを受け取れます。あなたの役割は、1日600フィールドを打ち込むことから、フラグが付いた例外のみをレビューすることへと変わります。
QCラボにおける二段階手入力の落とし穴
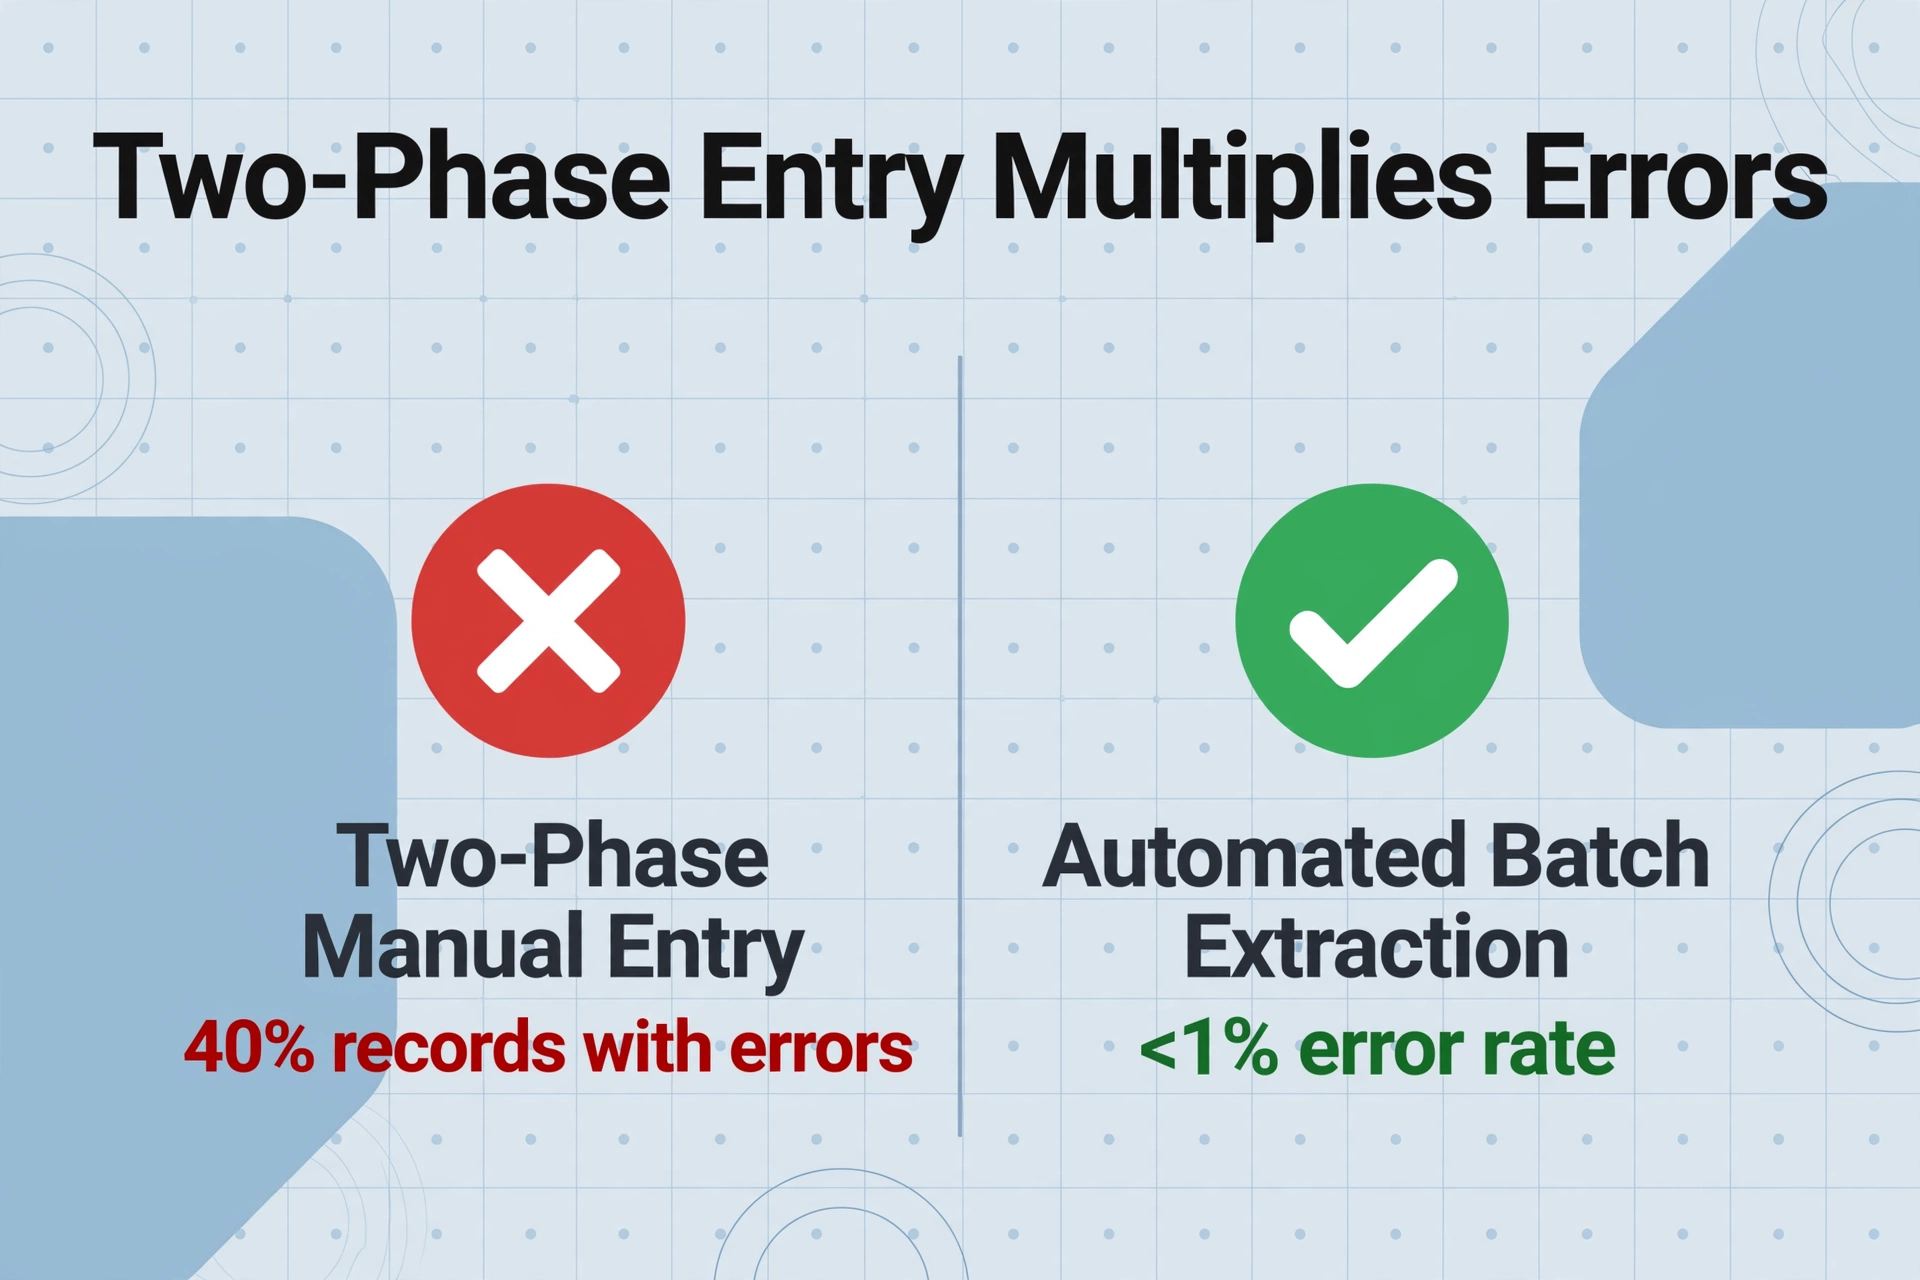
ほとんどの製造業のQCラボでは、単一段階の手入力は行っていません。二段階入力を採用しています。すなわち、技術者が測定値を機器の前で紙に記録し、別の担当者(同じ技術者の場合も、別の人の場合もあります)がその紙の値をExcelやLIMSに転記するという流れです。各段階でエラー発生のリスクが倍増します。
Beamexの報告によると、データが2つの手入力ポイントを通過する場合、統計的にレコードの40%に少なくとも1つのエラーが含まれます。二段階入力のもとで年間10,000件の校正または品質試験を実施する施設では、約4,000件の不良データポイントが発生します。これらは理論上の数字ではありません。実際の調査、実際の手直し、そしてトレンド分析に注力すべき担当者がキー入力ミスの追跡に費やす実際の時間を表しているのです。
最も注目されていない影響は、手入力エラーがSPCチャートの信頼性に与えるダメージです。オペレーターが、データ入力ミスと分かっている原因で管理図が頻繁にシグナルを発するのを目にすると、チャートへの信頼を失います。幽霊のような異常シグナルが発生するたびに、現場はSPCシステムが狼少年だと学習します。そしてその教訓が浸透すると、本当の品質シグナルはノイズに埋もれてしまいます。1か月に5回の誤警報を軽視したラボマネージャーが、6回目に正当な警報が発せられても緊急対応する可能性は低いでしょう。多くの工場がSPCソフトウェアに投資した自動化は、そこに供給されるデータが依然として手入力である限り、その価値が部分的に損なわれます。
毎日30件のバッチリリース試験を処理し、各試験に15〜20の測定パラメータがあるQCラボでは、フィールドレベルの転記エラー率1%で、毎月120〜180件のミスがSPCワークブックに入力されることになります。各ミスは、誤ったバッチ保留、または停止すべきだったリリースのいずれかのリスクをもたらします。
単一レポート抽出がバッチ規模で通用しない理由
単一レポート抽出ツール—PDFを1つアップロードして1行のデータを取得し、それを繰り返すタイプのツール—は、実際の生産現場のQCラボには存在しないワークフローに最適化されています。1つのテストを実行し、1つのレポートを取得し、1行を入力するだけの運用は誰もしていません。日常の現実は積み重ねです:ShimadzuのHPLCがランを終え、12のアッセイパラメータを含むPDFを生成する。Mettler Toledoのカールフィッシャー水分計が水分含有量レポートを出力する。Instronの引張試験機が機械的特性のサマリーを出力する。AgilentのGCが残留溶媒分析を返す。その日にテストしたバッチ数を掛け合わせると、SPC分析を開始する前に単一のデータセットに統合する必要がある30〜50件の機器レポートが発生します。
バッチ処理は、単一処理を50回繰り返すだけではありません。1件ずつ処理するワークフローでは決して遭遇しない課題が生じます:
- 命名規則は規模が大きくなると破綻します。1件のレポートを処理する場合、出力行は1つのバッチに属します。50件を処理する場合、バッチ識別子、サンプルID、機器ID、タイムスタンプを各行に付与し、統合されたスプレッドシートが検索可能でトレーサブルな状態を保つ必要があります。「Assay (%)」という列が50件分同じヘッダーで並んでも無意味です—ワークフロー上では「Batch-20260627-01 | HPLC | Assay (%)」、あるいはさらに良いのは、機器とバッチを別々の列として各行をそのソースにリンクさせることです。
- 結果のマージこそが真のボトルネックであり、抽出速度ではありません。各レポートを10秒で抽出できたとしても、50件の出力行をマスターSPCワークブックに手動でマージする作業—レイアウト規則が異なる機器の列を揃え、欠落を確認し、重複列を解決する—には、抽出で節約した時間を費やしてしまいます。バッチ処理用に設計されたツールは、1回のパスで1つの統合スプレッドシートを生成し、すべての行が同じ列スキーマに揃えられます。
- 例外処理は複合的に発生します。パラメータが1つ欠落した単一レポートは5秒で判断できます。異なるフィールドが欠落した6件、判読不能な感熱印刷値が2件、OOSフラグを含む3件を含む50件のバッチは、45分の照合作業になります。バッチ規模の処理では、例外を体系的に表面化させる必要があります—50行をスクロールして欠落を探すような作業を強いられるべきではありません。
QCラボ向けの単一レポート抽出ワークフローの詳細な解説については、製造業QCラボレポートデータをExcelに抽出する方法ガイドをご覧ください。この記事の残りの部分では、それを1日50回行う必要がある場合に何が変わるかに焦点を当てます。
機器が生成するPDFがテンプレート型ツールを無力化する理由
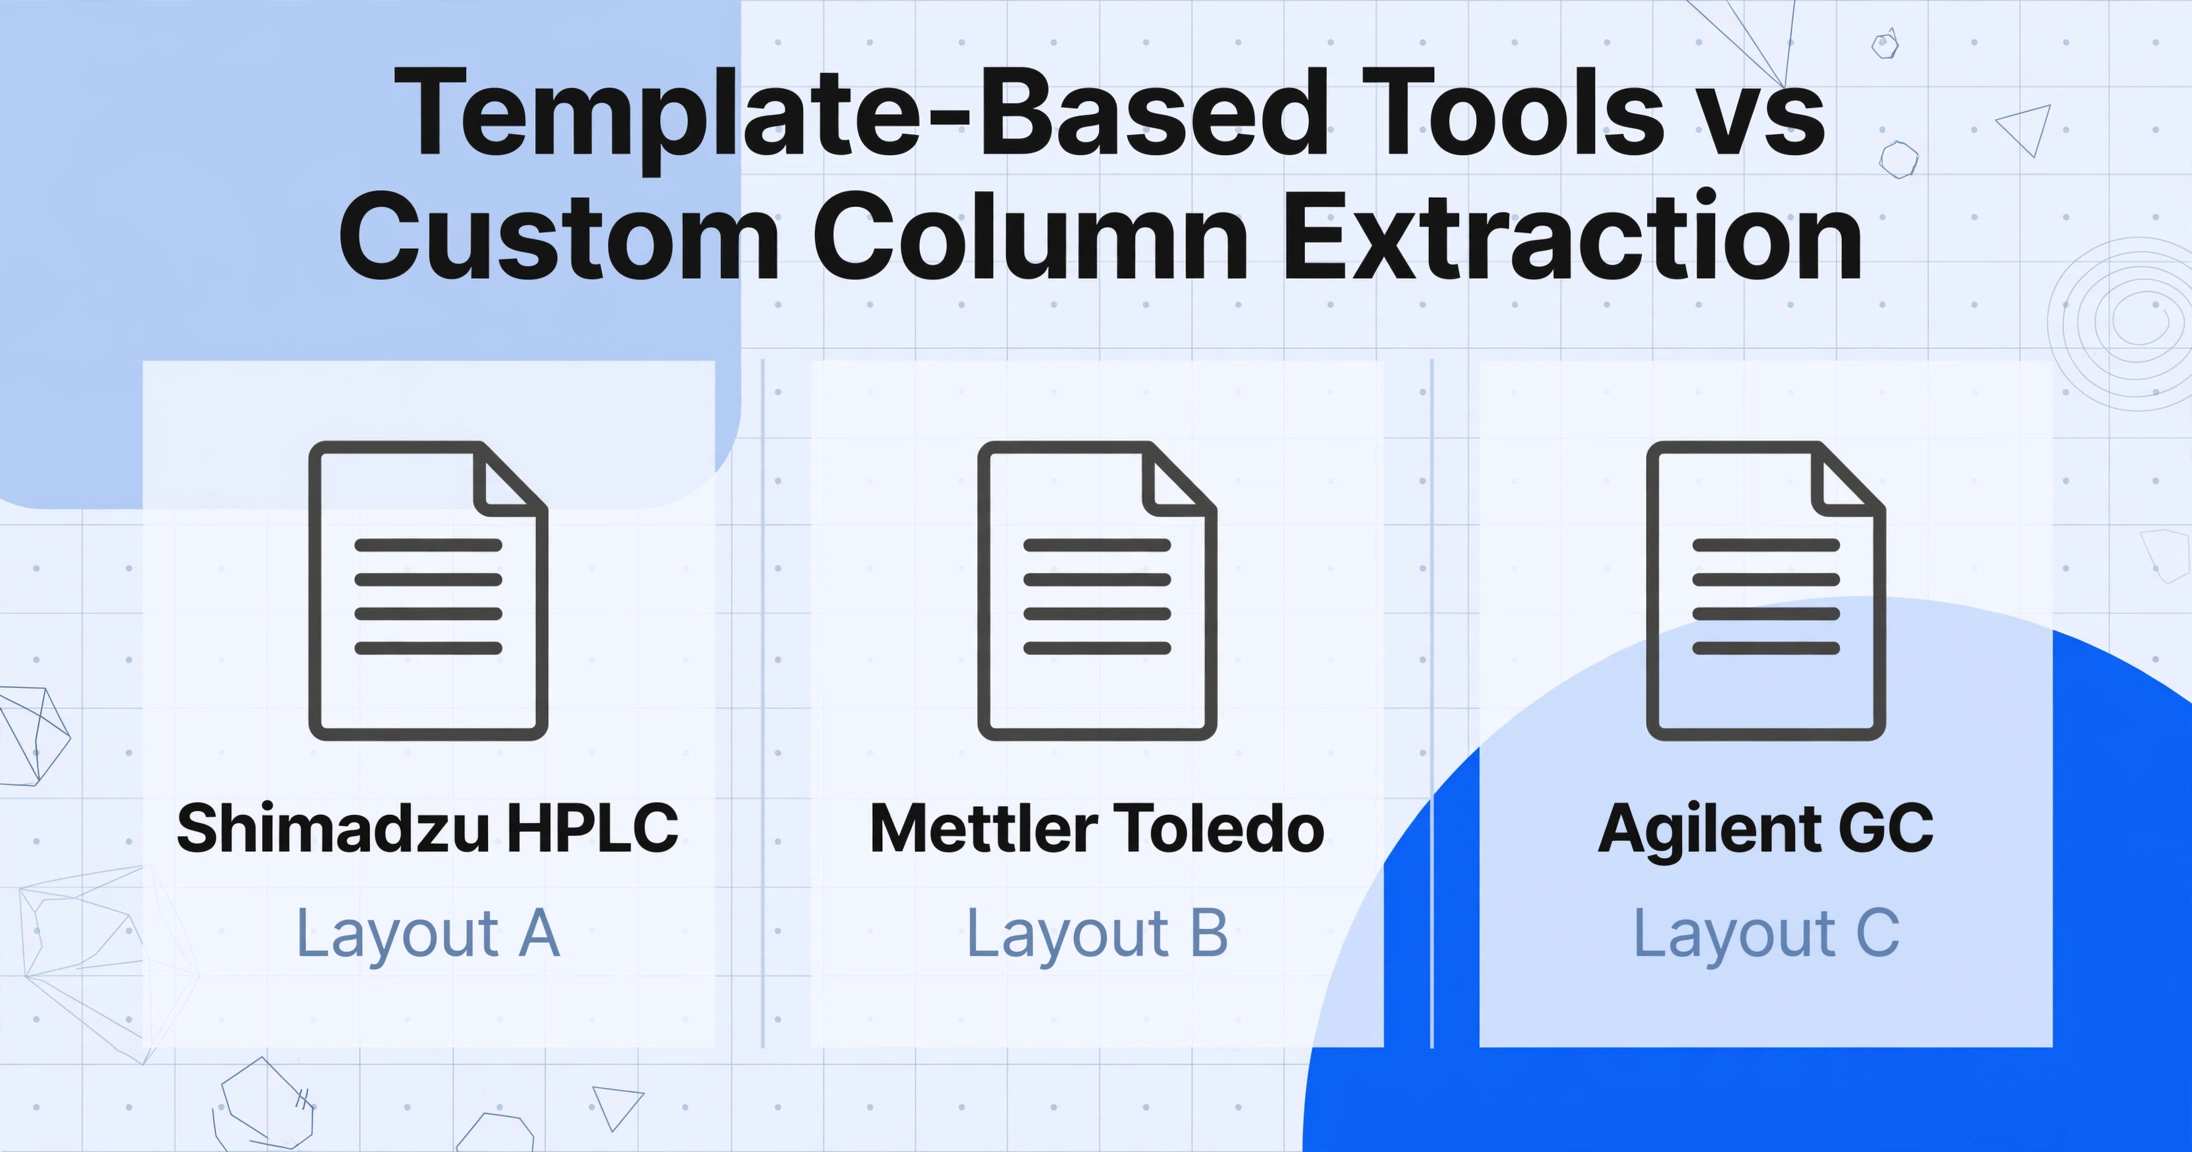
異なるベンダーの機器が並ぶQCラボでは、テンプレート型の抽出ツールでは決して解決できないフォーマット断片化の問題が発生します。LabSolutionsを搭載したShimadzu HPLCは、「化合物名/保持時間/面積/濃度/単位」という列ラベルの表でアッセイ結果を出力します。LabXを搭載したMettler Toledoの滴定装置は、「サンプルID/結果/RSD/n」というまったく異なるレイアウトのレポートを出力します。OpenLab CDSを搭載したAgilent GCは、さらに別の構造を生成します。ソフトウェアのバージョンによって同じパラメータが異なる名前で呼ばれることもあります。3つの機器、3つのPDFレイアウト、そしてどれもスプレッドシートへの機械読み取りを想定して設計されていません。
従来のOCRやテンプレート型IDPツールでは、各機器のPDFレイアウトごとに、各データポイントが存在する正確な座標やアンカーパターンを定義する必要があります。ラボが新しいバージョンのLabSolutionsにアップグレードし、レポートのレイアウトが3行ずれると、テンプレートは静かに壊れます。間違った値を間違った列に抽出し、QAがバッチレビューで見つけるまで何も問題が起きていないかのように見えます。5つの機器と定期的なソフトウェア更新を抱えるラボは、時間の経過とともに劣化する5つの脆弱な抽出テンプレートを実質的に維持していることになります。
その代替案がカスタム列抽出です。ツールにデータがページのどこにあるかを伝える代わりに、必要なデータが何かを伝えます。SPCデータフィールドに一致する列ヘッダー(「アッセイ(%)」「水分含有量(%)」「引張強度(MPa)」)を入力すると、AIはテキストがどこに表示されるかではなく、その意味を理解して各値を特定します。あるレポートで「Assay: 99.2%」と印刷され、別のレポートで「Content: 99.2% (as-is basis)」と印刷された結果は、両方がX=320、Y=480に表示されたからではなく、モデルが両方をアッセイ値として認識するため、同じ出力列にマッピングされます。この意味論的アプローチ(テンプレート不要でフォーマット非依存)は、複数機器のラボ環境で機能し続ける唯一の抽出パラダイムです。
Agilent、Shimadzu、Mettler Toledoの機器を並行して運用するラボでは、同じ列定義が再設定なしで3つの機器フォーマットすべてで機能します。抽出出力は、各ソースPDFを生成した機器に関係なく、同一の列構造を持つ単一のスプレッドシートにまとめられます。これが、可変フォーマットのバッチ環境向けに設計されたツールと、単一フォーマット・単一レポートの使用に最適化されたツールとの根本的な違いです。
誰も語らないOOSフラグ問題
QCラボレポートにおけるOOS(規格外)結果は、単なる赤い数字ではありません。FDAの2006年OOS調査ガイダンスに基づき、OOS結果が発生するたびに、必須の2段階調査が開始されます。フェーズIではラボエラーが原因かどうかを調査し、フェーズIIでは製造プロセス自体を調査します。調査は文書化され、根本原因が特定され、是正措置が実施されてから、バッチをリリースできます。1件のOOS調査で通常3〜10営業日を要し、21 CFR 211.192に基づくバッチ記録レビュー要件により、品質部門はすべての調査結論を承認する必要があります。
ここで、OOS結果が手動転記ステップを経る場合を考えてみましょう。技術者が機器レポートの「0.025」を「0.052」と入力した場合—1桁の転記ミス—その値は規格限度を超えます。SPCチャートがフラグを立て、調査が始まります。4時間後、QAが元の機器プリントアウトを見つけ、Excel入力を比較し、単なるタイプミスだったと判明します。バッチは実際には規格外ではありませんでした。調査はキーストロークエラーで無駄になりました。
逆のシナリオはより危険です。機器レポートが真のOOS値を示しているのに、技術者が合格値として誤って転記し、バッチは調査なしでリリースされます。製造上の根本原因—汚染、プロセスドリフト、原材料のばらつき—は、後続のバッチに影響を及ぼすまで検出されず、リコールにつながる可能性があります。転記エラーは時間を無駄にしただけでなく、系統的な品質不良を検出するための規制上の安全策を迂回したのです。
抽出が自動化されると、OOSフラグは体系的に処理されます。「Pass/Failステータス」という推論列を定義し、「すべての測定値が規格限度内であればPASS、いずれかの値が規格外であればFAIL」というルールを設定します—AIは処理中にすべての抽出値を仕様に対して評価し、違反を自動的にフラグ付けします。出力スプレッドシートには専用の列が含まれ、50件すべてのレポートのOOS状態が1つのビューに表示されます。機器PDFをスクロールして赤い文字を探す代わりに、QCレビュー担当者は1つの列をスキャンし、3つのFAIL行を確認して、調査のためにその3件のレポートだけを開きます。注意は本来あるべき場所—例外—に向けられ、機器がすでに正しく印刷したすべての数値を検証する作業には向けられません。
機器出力とSPC入力のギャップを埋める
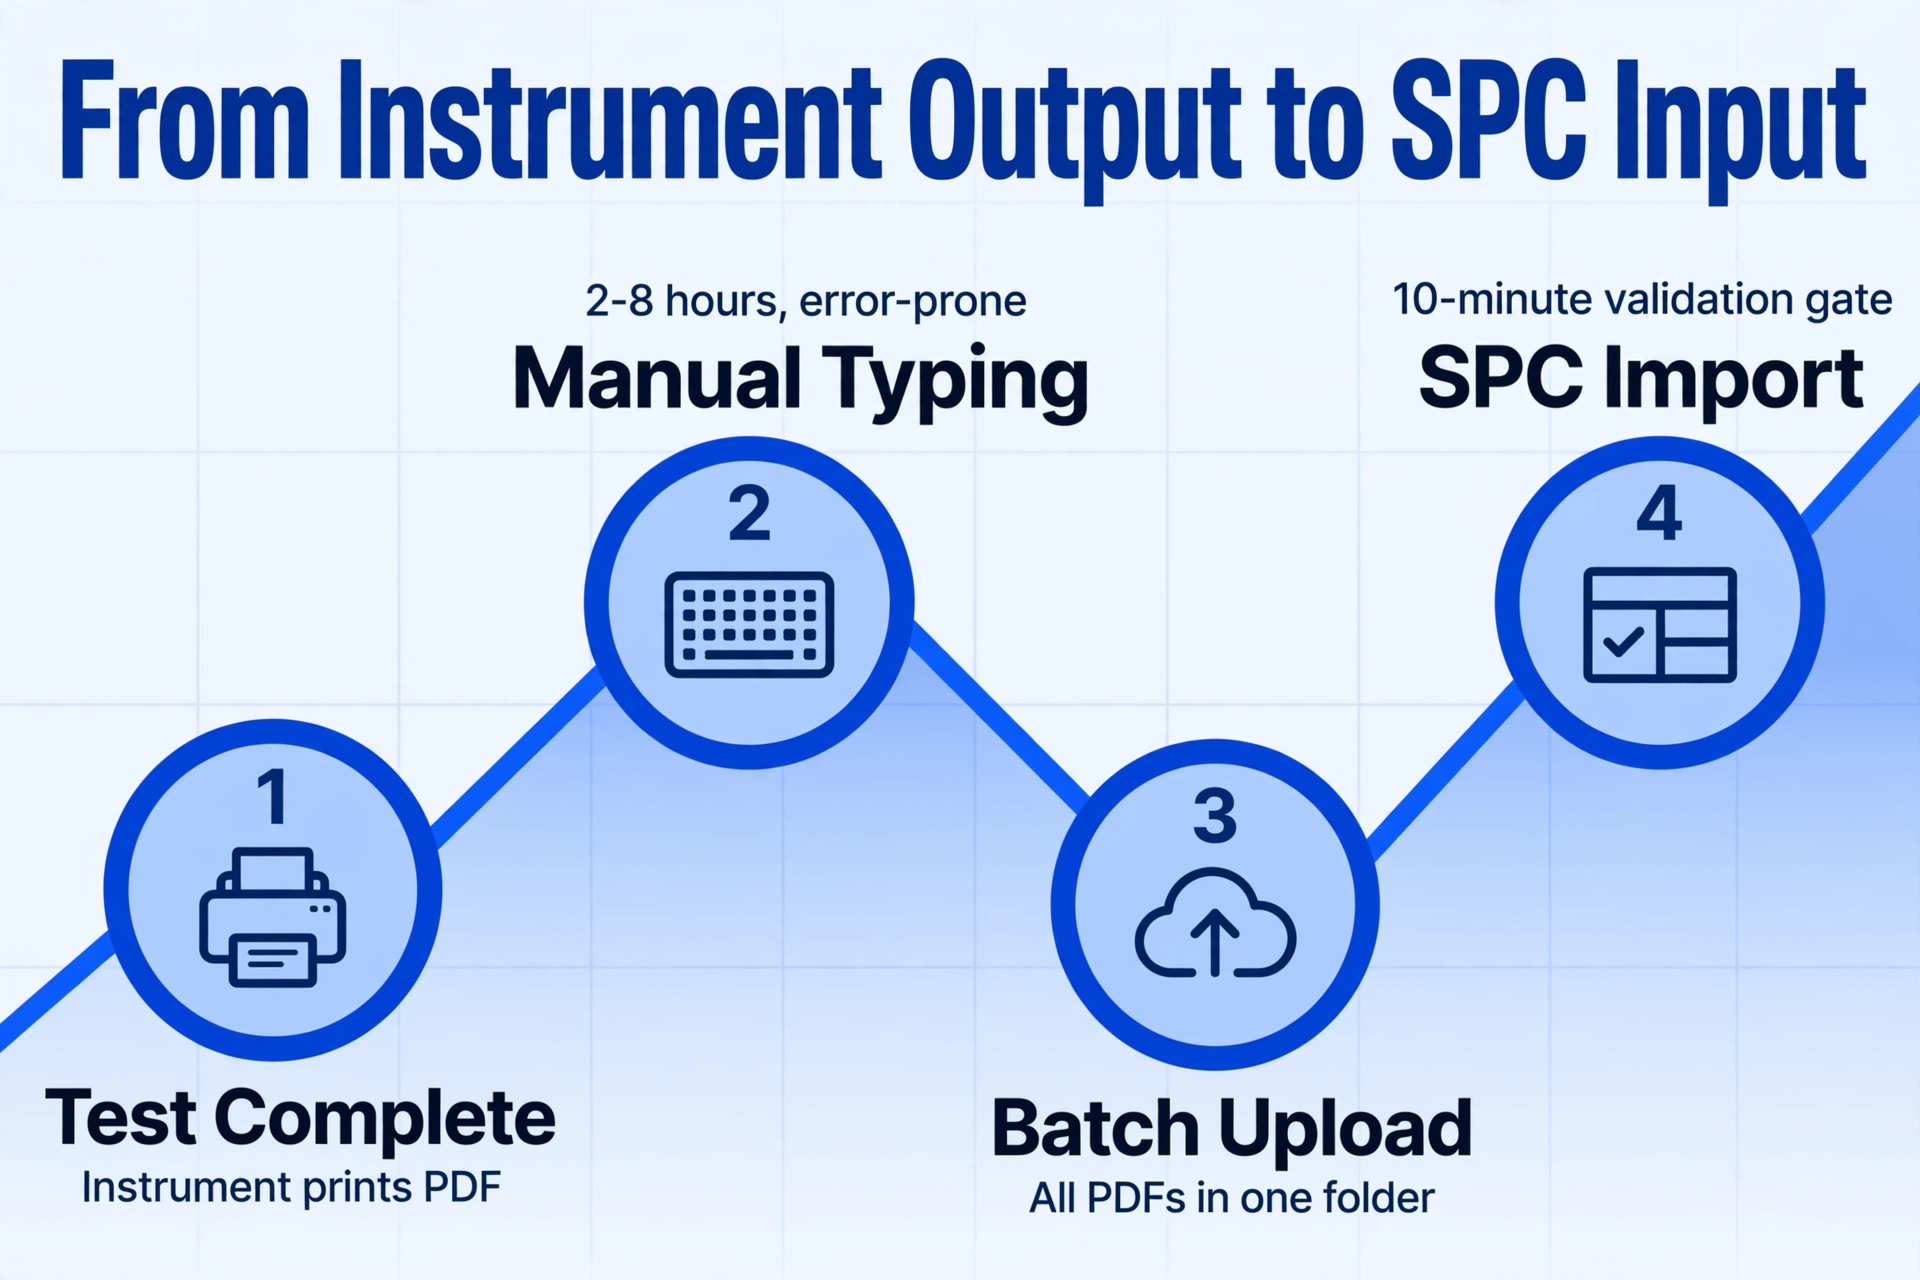
手動QCラボのデータフローは次のようになります。機器がテストを完了 → 機器がPDFを印刷 → 技術者がPDFを読む → 技術者がExcelに数値を入力 → QAがExcelをレビュー → データがSPCソフトウェアにコピーされ管理図を作成。この一連の流れの各矢印が、遅延ポイントでありエラー発生ポイントでもあります。「テスト完了」から「SPCにデータが入る」までのギャップは通常2〜8時間です。これはテスト自体に時間がかかるからではなく、転記・レビュー・コピーのパイプラインが順次処理で人的ペースだからです。
自動化されたバッチパイプラインでは、フローは次のように集約されます。機器が1日を通してテストを完了 → すべてのPDFがバッチフォルダに収集 → シフト終了時または1日終了時にバッチがアップロード → AIがすべてのレポートを1つの構造化スプレッドシートに抽出 → スプレッドシートがSPCソフトウェアに直接インポート。抽出ステップ自体は1ページあたり5〜10秒かかるため、50件のレポートは10分未満の処理時間で完了します。2〜8時間の転記ウィンドウは、QCレビュー担当者が全フィールドを入力する代わりに結果のサンプルをスポットチェックする10分の検証ゲートになります。
ほとんどのSPCソフトウェアプラットフォーム(Minitab Real-Time SPC、InfinityQS、JMP、WinSPC、dataPARC)は、標準的なデータ取り込み経路としてCSVまたはExcelインポートを受け付けます。バッチ抽出から得られるスプレッドシートは、このインポートステップ用にすでにフォーマットされています。各行が1つのテスト結果、各列が1つのSPCパラメータに対応し、SPCソフトウェアで設定された管理限界により、データが読み込まれた瞬間にI-MR、Xbar-R、またはXbar-S管理図が自動生成されます。CpおよびCpk計算は、基盤となるデータセットが最初から完全で正しく構造化されているため、即座に更新されます。
生産性の計算:1日30バッチ、各15パラメータを処理し、時給$28の技術者が転記するラボでは、手動データ入力作業だけで1日あたり約$84かかります(レポート1件あたり3分 × 30件 = 90分)。年間250稼働日で換算すると、機器がすでにデジタル生成した数値を入力する作業に$21,000の人件費がかかります。転記エラーによって引き起こされる調査時間(控えめに見積もって週1回の調査、各4時間)は、年間さらに$5,600追加されます。合計$26,600は、自動化しない場合の定常的なコストであり、バッチリリースの遅延やSPC管理図の信頼性低下といった定量化が難しいコストは含まれていません。
トレーサブルなバッチレコードパイプラインの構築
抽出の自動化は、正当なコンプライアンス上の疑問を提起します。誰も数字を入力していない場合、スプレッドシートの値が実際に機器レポートから来たことを監査人にどう証明するのか?自動化によって監査証跡が消えるわけではなく、その形が変わるのです。
21 CFR 211.188に基づき、バッチ製造記録および管理記録には、各重要な工程の完全な文書化(試験管理結果、各工程を実施・確認した者の識別情報を含む)が必要です。抽出が自動化される場合、トレーサビリティチェーンはキーストロークではなくメタデータを通じて機能します。出力スプレッドシートの各行は、ファイル名によって元のPDFにリンクされ、バッチ処理のタイムスタンプは抽出が実行された時刻を記録し、バッチを開始して結果をレビューしたユーザーが記録され、元のPDFは不変の情報源として利用可能なまま残ります。
ASTM D6299統計的品質保証基準は、管理図の統計量がトレーサブルで検証可能なデータから計算されなければならないことを強調しています。各行にソースファイル参照を含む自動抽出パイプラインは、手書きのログブックへの記入よりも体系的にこの要件を満たします。なぜなら、スプレッドシートの値と機器レポートの間のリンクがプログラム的に確立され、誰かがどの機器のプリントアウトを見ていたかを覚えておく必要に依存しないからです。バッチレコードを検査する監査人は、スプレッドシートの行から元のPDFにクリックして移動し、30秒以内に値を確認できます。これは、紙のログの手書きを追跡するよりも迅速かつ決定的です。
コンプライアンスのための実用的なワークフロー:日々の機器PDFを日付と試験ステーション(原材料/工程内/完成品)ごとにフォルダに整理し、各ステーションのレポートを、ソース機器を識別する列を持つ独自のスプレッドシートにバッチ処理し、出力を元のPDFと一緒にバッチレコードパッケージに保存します。抽出されたスプレッドシートはSPC分析のための作業データファイルとなり、元のPDFは不変の証拠として残ります。これは、ラボが既にクロマトグラフィーデータファイルを扱う方法(生の.lcmまたは.dフォルダがソースであり、処理済みレポートが作業出力である)と構造的に類似しており、ラボ内の全機器セットに拡張されたものです。
バッチ処理ワークフローの設定
手動転記から自動バッチ抽出への移行には、LIMS導入プロジェクトは必要ありません。以下のワークフローは、1シフト内で運用を開始できます。
SPC列を定義する
SPCチャートに取り込むすべての試験パラメータを列挙します:「Assay(%)」「Moisture Content(%)」「pH」「Viscosity(cP)」「Dissolution(%)」「Hardness(N)」など。これらが抽出テンプレートの列名になります。メタデータ列も追加します:「Batch ID」「Sample ID」「Test Station」「Instrument」「Test Date」。また、推論列「Pass/Fail」を追加して、規格値に対するOOS状態を自動的にフラグ付けします。
日次の機器レポートを収集する
各シフト終了時または1日の終わりに、試験ステーションごとに整理したフォルダへ、機器が生成したすべてのPDFレポートを集めます。ほとんどの機器制御ソフトウェア(LabSolutions、OpenLab、LabX)は、PDFレポートをネットワークフォルダに自動保存するよう設定でき、印刷してからスキャンする手順を省けます。ラボでサーマルプリンタ付きの機器をまだ使用している場合は、プリントアウトをスキャンまたは撮影して画像ファイルにします。AIはデジタルPDFと撮影したプリントアウトの両方を、同じ列定義で処理します。
一括アップロードと抽出
当日のバッチフォルダからすべてのPDFを1回の操作でアップロードします。バッチ処理エンジンが、列定義を使用して各レポートからデータを抽出し、1つの統合スプレッドシートを生成します。すべての行は、各ソースPDFを生成した機器に関係なく、同じ列スキーマに揃えられます。50件のレポートの処理時間は、マシン時間で約5〜10分です。
OOSフラグの検証とスポットチェック
結合したスプレッドシートを開き、「Pass/Fail」列を確認します。FAILとフラグ付けされた行は優先的に対応します。ソースPDFを開き、抽出値がレポートと一致することを確認し、確認できた場合はOOS調査を開始します。合格した行については、サンプル(行の10〜15%)をスポットチェックし、抽出値とソースPDFを照合します。これにより、600フィールドの入力が、60〜90フィールドのレビューに置き換わります。
SPCソフトウェアへのインポートとアーカイブ
検証済みのスプレッドシートをMinitab、InfinityQS、JMP、またはお好みのSPCプラットフォームにインポートします。管理図、工程能力指数、トレンド分析は、完全なデータセットから即座に生成されます。監査証跡を完全にするため、抽出出力を元のPDFと一緒にバッチ記録パッケージに保存します。抽出スプレッドシートは、21 CFR 211.188で要求される恒久的なバッチ記録の一部になります。
従来の単一レポート抽出ワークフローと比較すると、バッチ方式では列定義と機器設定を先に行い、その後すべてのレポートを並列処理します。1件のレポートに10分かかる設定作業が、50件でも同じ10分で完了します。このスケールメリットこそが、バッチファースト設計が実現する価値です。
よくある質問
実験レポートの手書きメモや注釈にも対応していますか?
はい。AIエンジンは印字テキストと手書きの両方を処理できます。手書きのロット番号、分析者のイニシャル、機器印字結果の横に書かれた余白メモなども対象です。技術者が希釈倍率や試料重量を印字レポートに手書きした場合、その値も機器印字データと並んで専用の列として抽出できます。主に紙ベースで記録しているラボ向けに、手書きフォーム特有の手法をまとめたQCラボレポート抽出ガイドもご用意しています。
古い機器の感熱紙プリントアウトをスキャンしたものはどうですか?
スキャンまたは撮影した感熱紙プリントアウトも、デジタルPDFと同様に処理できます。AIはデジタルレポートか紙のプリントアウトかを問わず、視覚的な内容を読み取ります。ただし、6〜12か月以上経過した感熱紙は退色していることが多く、抽出精度が低下する可能性があります。長期保存用の感熱記録については、感熱コーティングが劣化する前に、印字後数週間以内に一定の照明下で撮影するのが最善の方法です。
機器モデルごとに個別の設定が必要ですか?
いいえ。カスタム列抽出はテンプレート照合ではなく意味的に動作するため、同じ列定義が複数の機器で使用できます。「Assay (%)」は、ShimadzuのレポートでもAgilentのレポートでもMettler Toledoのレポートでも、アッセイ値を検出します。機器固有の列を追加する必要があるのは、異なる機器タイプが根本的に異なるパラメータを測定する場合だけです。たとえば、HPLCレポートに「引張強度」は存在しないため、そのような列を探す必要はありません。AIは、特定のレポートに一致するデータがない列については単に空欄を返します。
電子記録の21 CFR Part 11準拠にどのような影響がありますか?
バッチ抽出ツールは、機器のPDFから出力スプレッドシートを生成します。これはデータ変換のステップであり、記録システムではありません。元の機器PDFは引き続き電子ソース記録として、ラボが機器出力に既に適用しているのと同じPart 11管理(監査証跡、電子署名、アクセス制御)の対象となります。抽出スプレッドシートは、SPC分析やバッチ記録の編集のための作業文書として機能します。完全なPart 11電子記録要件の下で運用するラボでは、抽出データは、手動入力データと同様に、既存の文書管理システムまたはLIMSシステムで品質部門によるレビューと承認を受ける必要があります。自動化によってデータが機器からスプレッドシートに移動する方法が変わるだけで、コンプライアンスの枠組みは変わりません。むしろ、コンプライアンス上の問題を引き起こす転記ミスを削減します。
複数の製造拠点からのレポートを1つのエンタープライズSPCビューに処理できますか?
はい。抽出テンプレートに「拠点」列を追加し、各拠点の日次レポートを個別のバッチ(それぞれが独自の出力ファイルを生成)として処理することで、すべての拠点データを単一のエンタープライズSPCダッシュボードに統合できます。全拠点で統一された列スキーマにより、プラントAの島津HPLCとプラントBのWaters Allianceシステムからのデータが同じ構造化形式で統合されます。これは、複数の製造拠点にわたってIATF 16949スタイルのエンタープライズ全体のSPC監視を導入する組織にとって特に価値があります。
LIMSに直接エクスポートするラボ機器については、これが必要ですか?
ラボ内のすべての機器が構造化データをLIMSに直接エクスポートし、そのLIMSがSPCソフトウェアにデータを供給している場合、手動転記の問題はありません。しかし、ほとんどの製造QCラボでは、直接接続されているのは通常、機器のごく一部です。HPLCはCDS経由でエクスポートするかもしれませんが、滴定装置、水分計、粘度計、硬度計は依然としてスタンドアロンのPDFやプリントアウトを生成します。バッチ抽出は、接続された機器と接続されていない機器の間のギャップを埋め、LIMSデータフィードと一緒にインポートできる統一された出力を生成します。製造文書抽出の状況は、構造化された機器フィードとAI抽出されたPDFデータが同じSPCパイプライン内で共存するハイブリッドモデルへと進化しています。
複数の試験ステーションで異なる規格に基づき試験されるサンプルを扱うには?
試験ステーションのコンテキストを含む列構造を定義します:「原材料 | 確認試験(合格/不合格)」、「工程内 | 定量(%)」、「最終製品 | 溶出試験(%)」。各列はそのパラメータを含むレポートにのみ適用されるため、原材料レポートは原材料の列に、最終製品レポートは最終製品の列にデータが入力され、出力されるスプレッドシートでは、サンプルに該当しないパラメータのセルは空白となり、試験ステーションごとに結果が自然に区分されます。また、他の製造文書タイプ向けに開発されたバッチ処理手法も利用可能です。この列ベースのアプローチは文書カテゴリ間で転用できます。