3 ans de pages de livret bancaire japonais
Un seul livre de comptes annuel des dépenses
Un travailleur indépendant à Osaka qui dépose une déclaration bleue (青色申告) rassemble trois livrets bancaires (通帳, tsūchō) couvrant 2023 à 2025 — MUFG pour les opérations courantes, Japan Post Bank (ゆうちょ銀行) pour les réserves fiscales, et une caisse de crédit régionale (信用金庫) pour la paie. Entre eux : environ 36 pages de transactions imprimées, 280 lignes d'historique de dépôts et de retraits, imprimées à trois distributeurs différents avec trois têtes d'impression matricielles différentes, et reliées dans trois livrets d'usure variable. La déclaration bleue offre une déduction de 650 000 ¥ en échange d'une comptabilité en partie double — ce qui signifie que chacune de ces 280 lignes doit être intégrée dans Yayoi Accounting (弥生会計), freee, ou MoneyForward Cloud Accounting en tant qu'écriture de journal catégorisée. Extraire une page à la fois, recouper les soldes de trois livrets, et convertir manuellement les dates en ère japonaise (和暦) en calendrier grégorien est gérable pour une seule année de transactions. Pour trois ans sur trois banques, le flux de travail sur une seule page s'effondre sous sa propre étape de fusion manuelle.
Points clés à retenir
- Trois ans de pages de livret ne vous vainquent pas à l'étape de la saisie. Ils vous vainquent à l'étape de la fusion — lorsque 36 extractions sur une seule page doivent devenir un seul livre de comptes trié.
- Le solde courant d'un livret est sa plus grande piste d'audit — mais une seule erreur de lecture le transforme en bombe à retardement qui corrompt chaque ligne suivante, silencieusement, au-delà des limites de page.
- L'extraction par lots avec une vérification de solde calculée détecte une erreur de lecture au moment où elle se produit — vous corrigez une ligne en deux minutes au lieu de chercher en arrière sur 280 lignes une heure plus tard lorsque le bilan de vérification échoue.
L'écart entre le traitement par lots et le grand livre : pourquoi l'extraction d'une seule page ne résout pas le problème des 3 ans
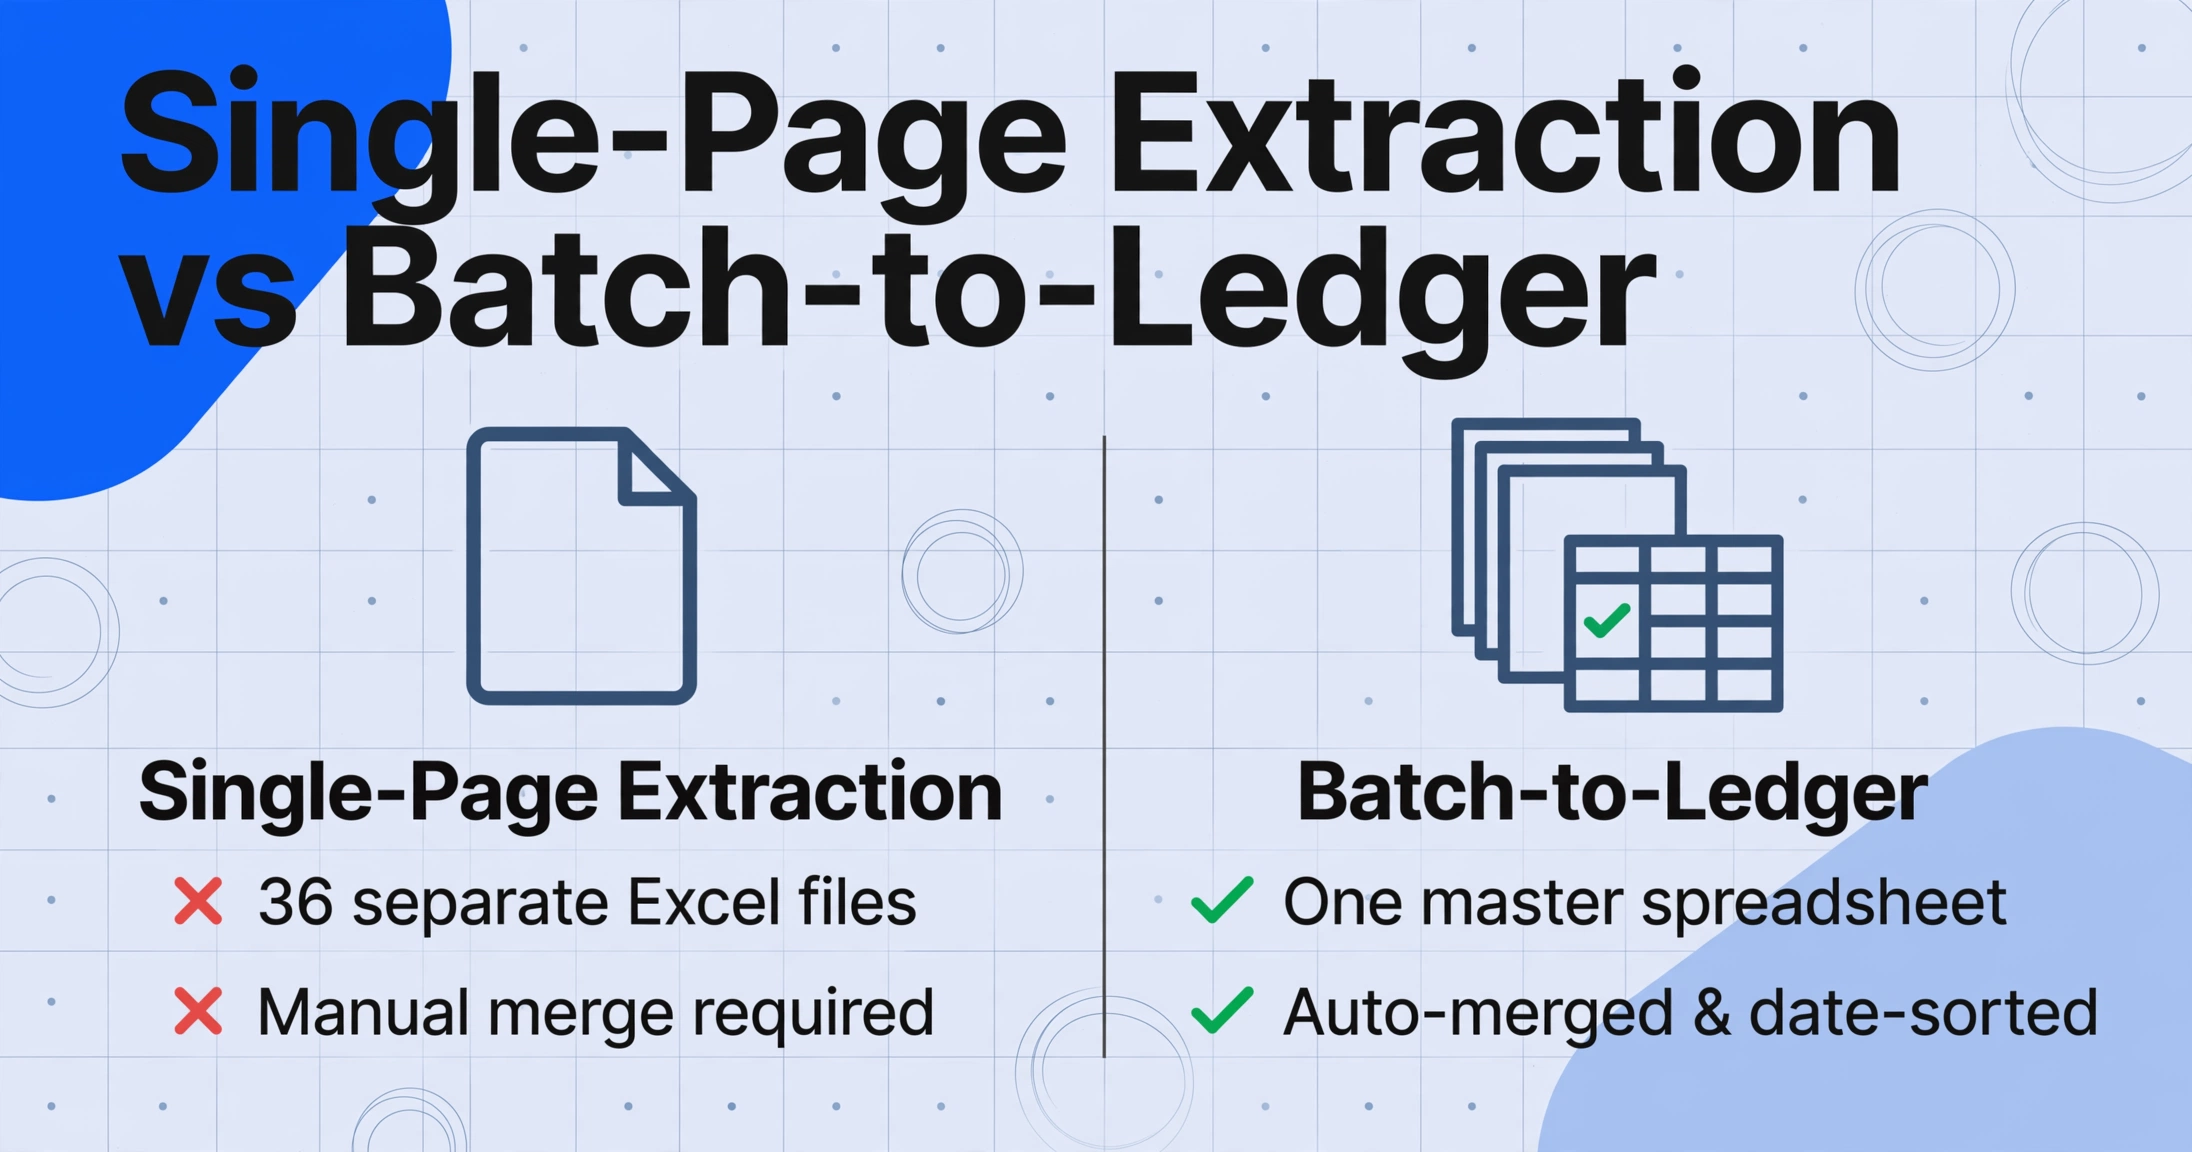
Extraire une seule page de livret bancaire est la moitié résolue du problème. Le flux de travail d'extraction de livret bancaire japonais — définir cinq colonnes, téléverser la page, obtenir une ligne de feuille de calcul par transaction — gère une page de manière fiable. La moitié non résolue est ce qui se passe lorsque l'extraction se termine et que 36 feuilles de calcul individuelles se retrouvent sur le bureau, chacune couvrant 8 à 10 transactions, chacune provenant d'une page différente d'un livret différent d'une banque différente.
La fusion manuelle est l'endroit où l'efficacité de l'extraction d'une seule page s'évapore. Trois livrets × 12 pages chacun = 36 fichiers Excel distincts. Chaque fichier doit voir ses transactions ajoutées dans une feuille maîtresse, triées par date sur trois en-têtes d'année d'ère différents (令和5年 sur la page MUFG, R6 sur la page Japan Post Bank, 2024 sur un export numérique), et les colonnes de solde doivent être recoupées entre les livrets qui ont enregistré le même virement interne à des dates différentes.
Un ménage qui suit ses dépenses mensuelles est confronté à une version plus légère du même calcul : deux livrets personnels mis à jour mensuellement sur trois ans (36 mises à jour, potentiellement sur deux carnets de livret physiques de 50 à 100 pages chacun), produisant environ 250 transactions qui doivent être fusionnées dans un seul livre de comptes du ménage annuel (家計簿). MoneyForward ME et Zaim récupèrent de nouvelles transactions via les API bancaires quotidiennement — mais ils ne remontent pas dans le passé, avant l'inscription à l'API, ce qui correspond exactement à la collection de pages qui dort dans le tiroir des livrets. Ces applications résolvent la visibilité quotidienne. Elles ne résolvent pas le moment annuel où trois ans de papier doivent devenir une seule feuille de calcul.
L'écart du traitement par lots en un chiffre : trois livrets × 280 transactions × 5 champs = 1 400 points de données extraits. Avec l'extraction d'une seule page, ces 1 400 points atterrissent dans 36 fichiers distincts qu'une personne doit fusionner. Avec l'extraction par lots, ils atterrissent dans une seule feuille de calcul avec chaque ligne triée, chaque date convertie au calendrier grégorien, et chaque solde vérifié par rapport à son prédécesseur — aucune étape de fusion, aucun copier-coller, aucun tri manuel.
Ce que le traitement par lots change concrètement pour les livrets bancaires japonais
Le traitement par lots, appliqué aux livrets bancaires (通帳), diffère du traitement par lots d'une pile de factures ou de reçus. Un lot de factures est un ensemble de documents indépendants — les données de chaque facture sont autonomes, et une erreur de lecture sur la facture 47 n'affecte que la facture 47. Un lot de livrets est un ensemble de pages interdépendantes : chaque page reprend là où la précédente s'est arrêtée, le solde (差引残高) se reporte vers l'avant, et le contexte de date — y compris l'en-tête d'année d'ère — se transmet d'une page à l'autre. Une seule erreur de lecture sur la page 3 d'un lot de 12 pages corrompt silencieusement la vérification du solde de toutes les pages suivantes.
Trois dimensions font du traitement par lots de livrets un problème distinct de l'extraction d'une seule page :
Consolidation multi-livrets. Une petite entreprise avec un livret d'exploitation, un livret de réserve fiscale et un livret de paie a trois soldes distincts. Les transferts entre comptes — déplacer 200 000 ¥ du compte d'exploitation vers le compte de réserve fiscale — apparaissent comme un retrait sur un livret et un dépôt sur l'autre, souvent à des dates différentes. Un résultat de lot qui fusionne les trois livrets en un seul grand livre trié rend le transfert traçable entre les comptes. Trois feuilles de calcul séparées le rendent invisible.
Report de la date d'ère entre les pages. Une page de livret imprime l'en-tête d'année — 令和6年 ou R6 — une fois en haut. Les lignes suivantes sur la même page ne portent que le mois et le jour (7.15). Lorsque l'extraction traite les pages individuellement, les transactions de la page 7 deviennent des dates flottantes — « 7.15 » sans référence d'année car l'en-tête se trouve sur la page 6. L'extraction consciente du lot lit l'en-tête une fois et l'applique à chaque transaction de cette page et des pages suivantes, convertissant toutes les dates en calendrier grégorien (西暦) dans le résultat. Lorsque l'année d'ère s'incrémente au 1er janvier, la logique de lot gère l'incrémentation en milieu de lot — ainsi le 30 décembre de 令和6年 et le 5 janvier de 令和7年 se résolvent tous deux en dates grégoriennes correctes sans intervention manuelle.
Livrets trans-ères. Un livret ouvert en 2018 et renouvelé en 2024 contient des transactions couvrant deux ères impériales : 平成 (Heisei, 1989–2019) et 令和 (Reiwa, 2019–présent). Le changement d'ère se produit en milieu de livret — Heisei 31 devient Reiwa 1 le 1er mai 2019. Une extraction qui traite une page à la fois pourrait appliquer le mauvais contexte d'ère aux transactions proches de la frontière. L'extraction consciente du lot détecte le changement d'ère à la page où l'en-tête passe de 平成 à 令和 et applique le décalage d'ère correct (Heisei + 1988, Reiwa + 2018) à chaque transaction en fonction de sa position. Pour les livrets qui incluent également des transactions de la fin de l'ère Showa (昭和) — comptes ouverts dans les années 1980 — la même logique s'étend à Showa + 1925.
Un outil d'extraction d'une seule page traite chaque page comme une île. Un outil de lot les traite comme une séquence — et pour un type de document défini par sa continuité, cette distinction détermine si le résultat est immédiatement utilisable ou nécessite des heures de réassemblage manuel.
Le défi de la 和暦, multiplié par le volume de lots
La conversion des dates en ère japonaise (和暦) sur une seule page de livret bancaire est une étape manuelle gérable : lire l'en-tête d'année en haut, connaître le décalage de l'ère, et convertir mentalement chaque date. Sur 36 pages provenant de trois livrets — où l'en-tête d'année apparaît sur la première page de chaque lot mensuel d'impressions ATM puis disparaît pour les 5 à 7 pages de continuation suivantes — la charge de conversion manuelle passe de « gérable » à « la principale source d'erreurs qui se répercutent en rejets dans les logiciels comptables ».
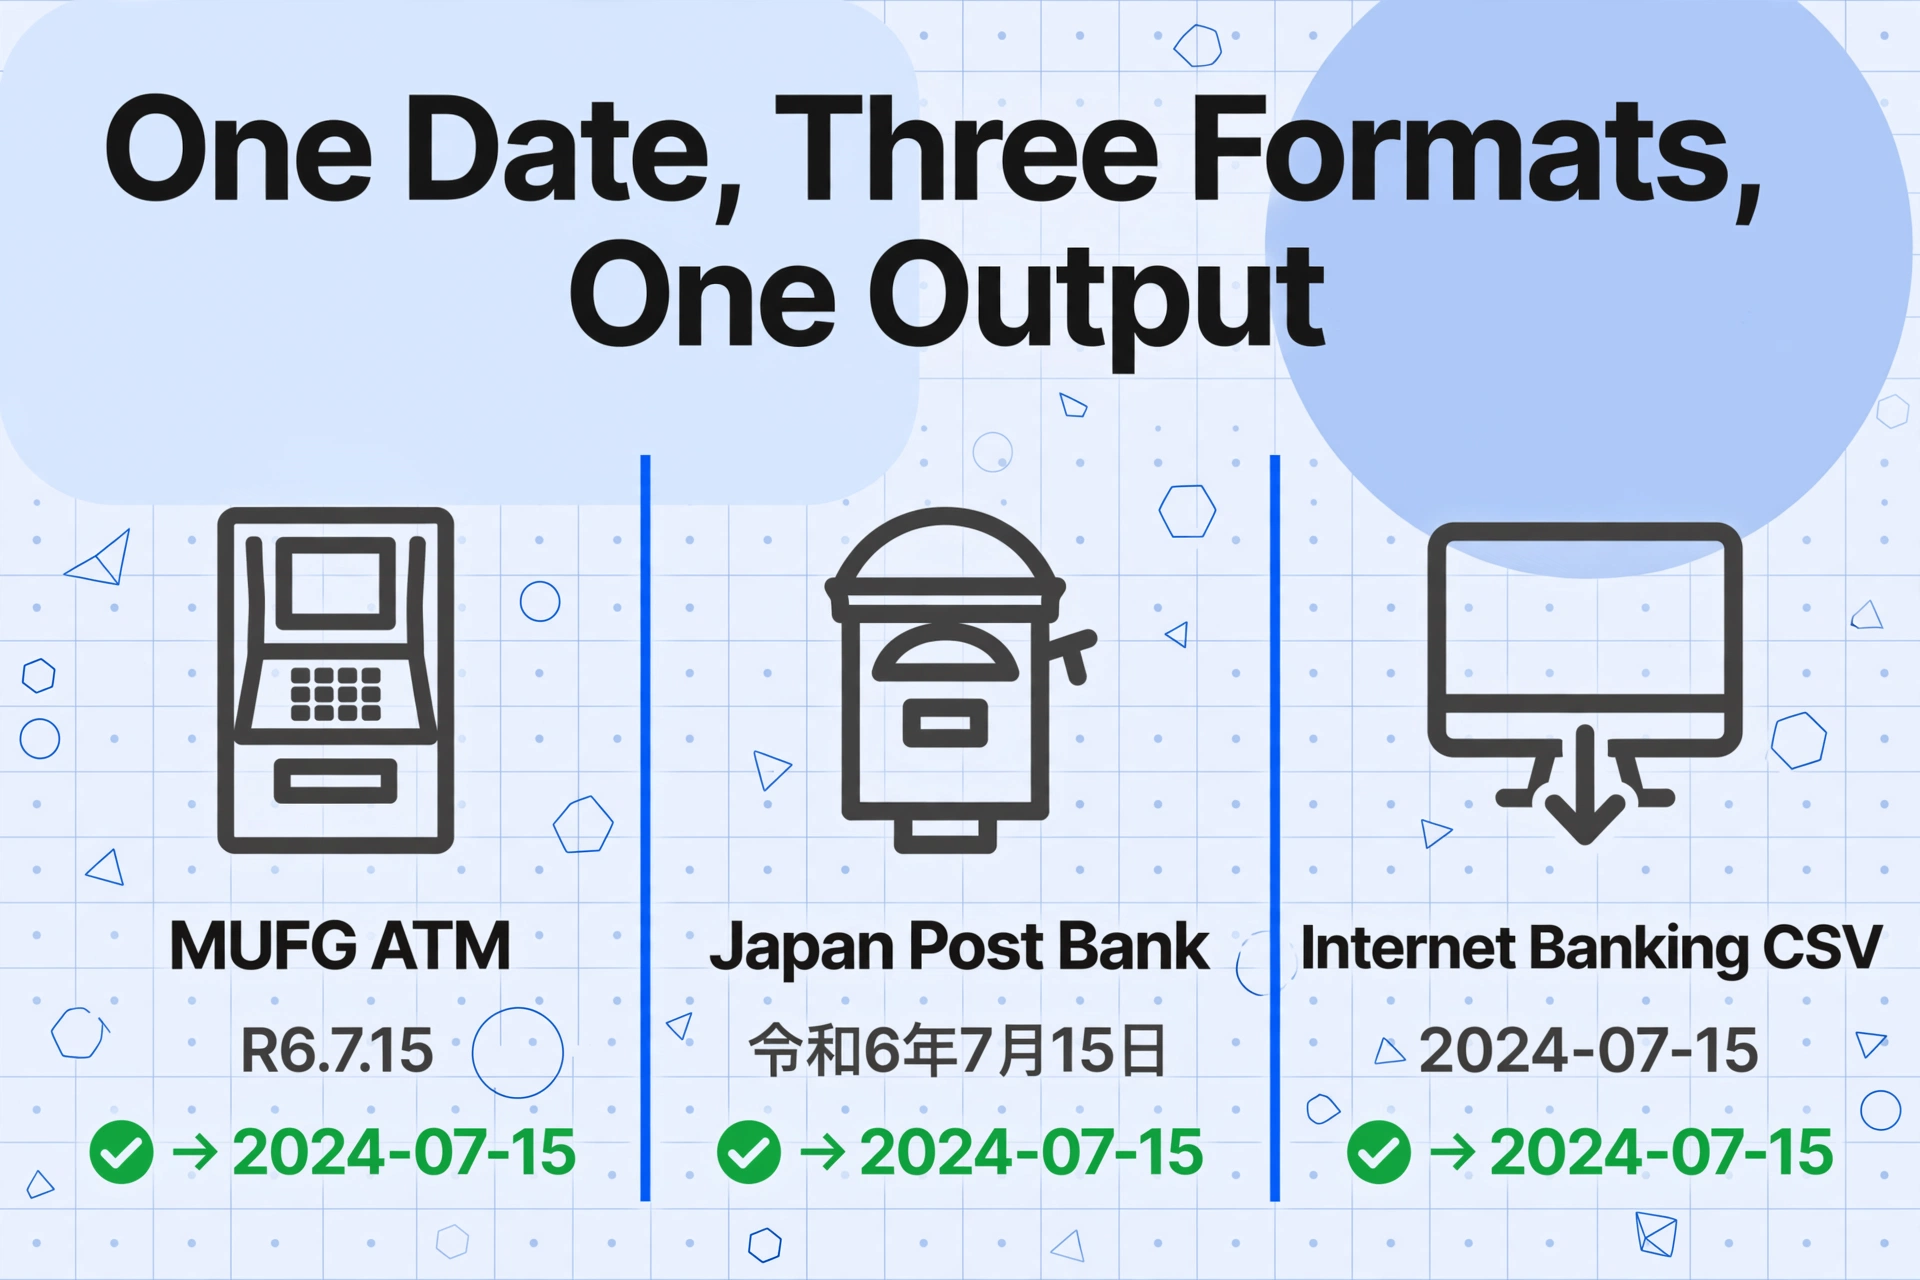
Considérez le chemin des données. Un livret imprimé par un distributeur MUFG utilise le format R6.7.15 pour le 15 juillet 2024 (année 6 de Reiwa). La même transaction, si elle est imprimée depuis le distributeur de Japan Post Bank, peut utiliser le nom complet de l'ère 令和6年7月15日. Si l'utilisateur exporte certains mois depuis la banque en ligne en CSV, ces dates arrivent au format 2024-07-15. Trois représentations de la même date, dans un seul lot.
Yayoi Accounting (弥生会計) attend des dates au format yyyy-mm-dd pour l'import CSV. Envoyez-lui une chaîne de date « R6.7.15 » et l'import échoue silencieusement — la ligne de transaction est ignorée, et l'échec ne se manifeste que des heures plus tard lorsque le bilan ne correspond pas au livret.
L'extraction par lots gère la conversion d'ère au niveau de la sortie : quel que soit le format de la date sur chaque page de livret — ère abrégée + mois.jour, nom complet de l'ère + 年月日, ou déjà en calendrier grégorien — chaque date du tableur consolidé arrive au format yyyy-mm-dd. Pour un lot couvrant trois ans et deux ères (2019 chevauche 平成31年 de janvier à avril et 令和元年 de mai à décembre), le moteur d'extraction applique le décalage correct par transaction en fonction du contexte d'ère détecté sur chaque page, et non d'une annotation manuelle de l'utilisateur.
La logique de conversion d'ère est déterministe : année Reiwa n = année grégorienne (n + 2018), Heisei n = (n + 1988), Showa n = (n + 1925). Le défi n'est pas l'arithmétique — c'est de détecter quelle ère s'applique à quelle ligne sur quelle page lorsque l'en-tête d'ère n'apparaît qu'une fois toutes les plusieurs pages et que l'ère elle-même peut changer en cours de lot. L'OCR basé sur des modèles ne peut pas faire cette détermination car il lit des cellules isolées. L'extraction sémantique avec contexte de lot le peut, car elle lit la relation entre un en-tête de page et ses lignes de contenu.
Créer un flux de travail par lots pour les livrets bancaires en trois étapes
Le flux de travail qui traite par lots trois années de pages de livret bancaire en un seul registre de dépenses annuel est le même, que vous traitiez trois livrets ou trente. L'étape de configuration — définir vos colonnes de sortie — est effectuée une seule fois et réutilisée pour chaque lot, chaque banque et chaque exercice fiscal. Si vous avez déjà configuré des colonnes pour l'extraction d'un livret unique, vous réutilisez le même schéma de colonnes ici.
Définissez vos colonnes de sortie et vos règles de vérification — une seule fois, pour chaque banque et chaque année
Saisissez les noms de champs exactement tels qu'ils doivent apparaître comme en-têtes de colonnes dans le tableur de sortie. Pour l'extraction de livrets bancaires, le schéma standard est : Date, Description (摘要), Retrait (お支払金額), Dépôt (お預り金額), Solde (差引残高). Il s'agit de l'Extraction de colonnes personnalisées : vous définissez le schéma de sortie, et l'IA fait correspondre les champs imprimés de chaque livret à vos colonnes en lisant la signification des champs, et non leur position. Les mêmes noms de colonnes fonctionnent avec le format sur une ligne de MUFG, la mise en page sur deux lignes par transaction de Japan Post Bank, et l'impression compacte d'une caisse de crédit régionale — les trois livrets du même lot produisent un tableur unifié. Pour un livre de comptes du ménage annuel, complétez avec des colonnes calculées qui s'exécutent pendant l'extraction : une colonne Vérification du solde (Solde précédent + Dépôt − Retrait = Solde actuel ? 'OK' : 'REVIEW') signale les erreurs de flottement avant que les données n'entrent dans votre logiciel comptable, et une colonne Catégorie (si Description contient "給与" alors "Salary" ; si contient "振込" alors "Transfer" ; si contient "引落" alors "Direct Debit" ; si contient "手数料" alors "Fee" ; sinon "Other") pré-tri les transactions par type afin que la sortie soit un livre de comptes du ménage annuel, et non simplement une liste ordonnée chronologiquement.
Téléversez le lot complet — tous les livrets, toutes les pages, en un seul téléversement
Numérisez ou photographiez chaque page de chaque livret — y compris les couvertures avant indiquant les numéros de compte et la couverture arrière avec la bande magnétique (磁気ストライプ) — et déposez toutes les images dans un seul téléversement par lot. Les 12 pages d'un livret MUFG de 2023, les 10 pages d'un livret Japan Post Bank de la même année, et les 14 pages d'un livret de caisse de crédit régionale couvrant 2023–2025 vont tous dans le même téléversement. Le traitement par lots les gère comme une seule tâche : chaque page est traitée indépendamment avec votre schéma de colonnes appliqué, les dates en ère japonaise sont converties au calendrier grégorien avec le contexte correct au niveau de la page, et tous les résultats sont fusionnés dans un seul tableur trié par date. Les pages peuvent être des numérisations d'un scanner de documents, des photos prises avec un smartphone, ou des exports PDF de la banque en ligne qui incluent des listes de transactions au format livret. Le temps total de téléversement est dominé par la numérisation — à environ 30 secondes par page pour l'alignement et la numérisation, 36 pages prennent environ 18 minutes de préparation. L'extraction elle-même se termine en quelques minutes.
Exportez le grand livre consolidé et lancez votre flux de travail comptable
Téléchargez un fichier Excel d'environ 280 lignes — une par transaction — avec chaque champ dans sa propre colonne. La colonne de date est au calendrier grégorien (aaaa-mm-jj) et prête pour l'import CSV vers Yayoi, freee ou MoneyForward Cloud Accounting. La colonne Balance Check affiche OK à côté de chaque transaction dont le calcul est cohérent, et REVIEW pour les lignes où le solde cumulé ne se réconcilie pas — généralement une ou deux lignes sur 280, causées par une virgule mal lue ou un chiffre taché sur une page de livret vieillissante. Corrigez ces deux lignes, et les 278 restantes sont vérifiées. La colonne Category regroupe les transactions par type, donc filtrer sur « Direct Debit (引落) » vous donne une année de loyers, de charges et de primes d'assurance en une seule vue. Le même schéma de colonnes fonctionnera l'année prochaine pour les mêmes livrets — les champs d'un livret bancaire japonais, définis par l'Association des banquiers japonais (全国銀行協会), ne changeront pas.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Codes de description et registre de dépenses annuel
La colonne de description d'un livret bancaire (摘要) utilise des codes compacts qu'un lecteur japonais catégorise immédiatement : 給与 est le salaire, 振込 est un virement bancaire, 引落 est un prélèvement automatique, 手数料 est des frais bancaires, 利息 est des intérêts, カード est une transaction par carte. Une extraction brute qui reproduit fidèlement ces codes — 振込, 振込, 引落, 給与, 振込 — produit une liste de transactions. Une extraction par lots qui les classe pendant le traitement produit un registre de dépenses annuel.
Cette distinction est importante car le logiciel comptable de destination — Yayoi Accounting, freee Accounting ou MoneyForward Cloud Accounting — a besoin d'écritures de journal avec des comptes comptables (勘定科目), et non de codes de description bruts. Le flux de travail manuel après l'extraction d'une seule page consiste à ouvrir le tableur, ajouter une colonne Catégorie et parcourir 280 lignes en attribuant 売上 (chiffre d'affaires) aux dépôts de salaire et 水道光熱費 (services publics) aux prélèvements automatiques. Pour un lot de trois années, cela représente environ 45 minutes de catégorisation répétitive — plus si un code comme 振込 nécessite une sous-classification (paiement client vs. remboursement d'un ami pour un dîner).
Une colonne calculée qui mappe les codes de description aux catégories de dépenses pendant l'extraction — « Revenus salariaux » pour 給与, « Services publics » pour 引落 à Tokyo Electric (東京電力), « Frais bancaires » pour 手数料, « Revenus d'intérêts » pour 利息 — transforme la sortie d'une liste de transactions en un registre pré-catégorisé. Les règles de mappage sont définies une fois dans le schéma de colonnes et appliquées automatiquement aux 280 lignes.
La même classification calculée gère les codes qui nécessitent un contexte au-delà du seul champ description. Un 振込 de 500 000 ¥ provenant d'un nom d'entreprise cliente connu dans le champ bénéficiaire est un revenu professionnel. Un 振込 de 15 000 ¥ provenant d'un particulier est probablement personnel. Une colonne calculée peut combiner le code de description avec le montant du dépôt pour effectuer la classification : if Description="振込" and Amount > 100000 then "Business Income"; if Description="振込" and Amount <= 100000 then "Personal Transfer". Le moteur d'extraction évalue cette logique pendant le traitement, et la sortie arrive avec les décisions de classification déjà prises — l'utilisateur approuve ou corrige, plutôt que de prendre chaque décision de zéro.
Dérive du solde : pourquoi une seule erreur de lecture dans un lot détruit toutes les lignes suivantes
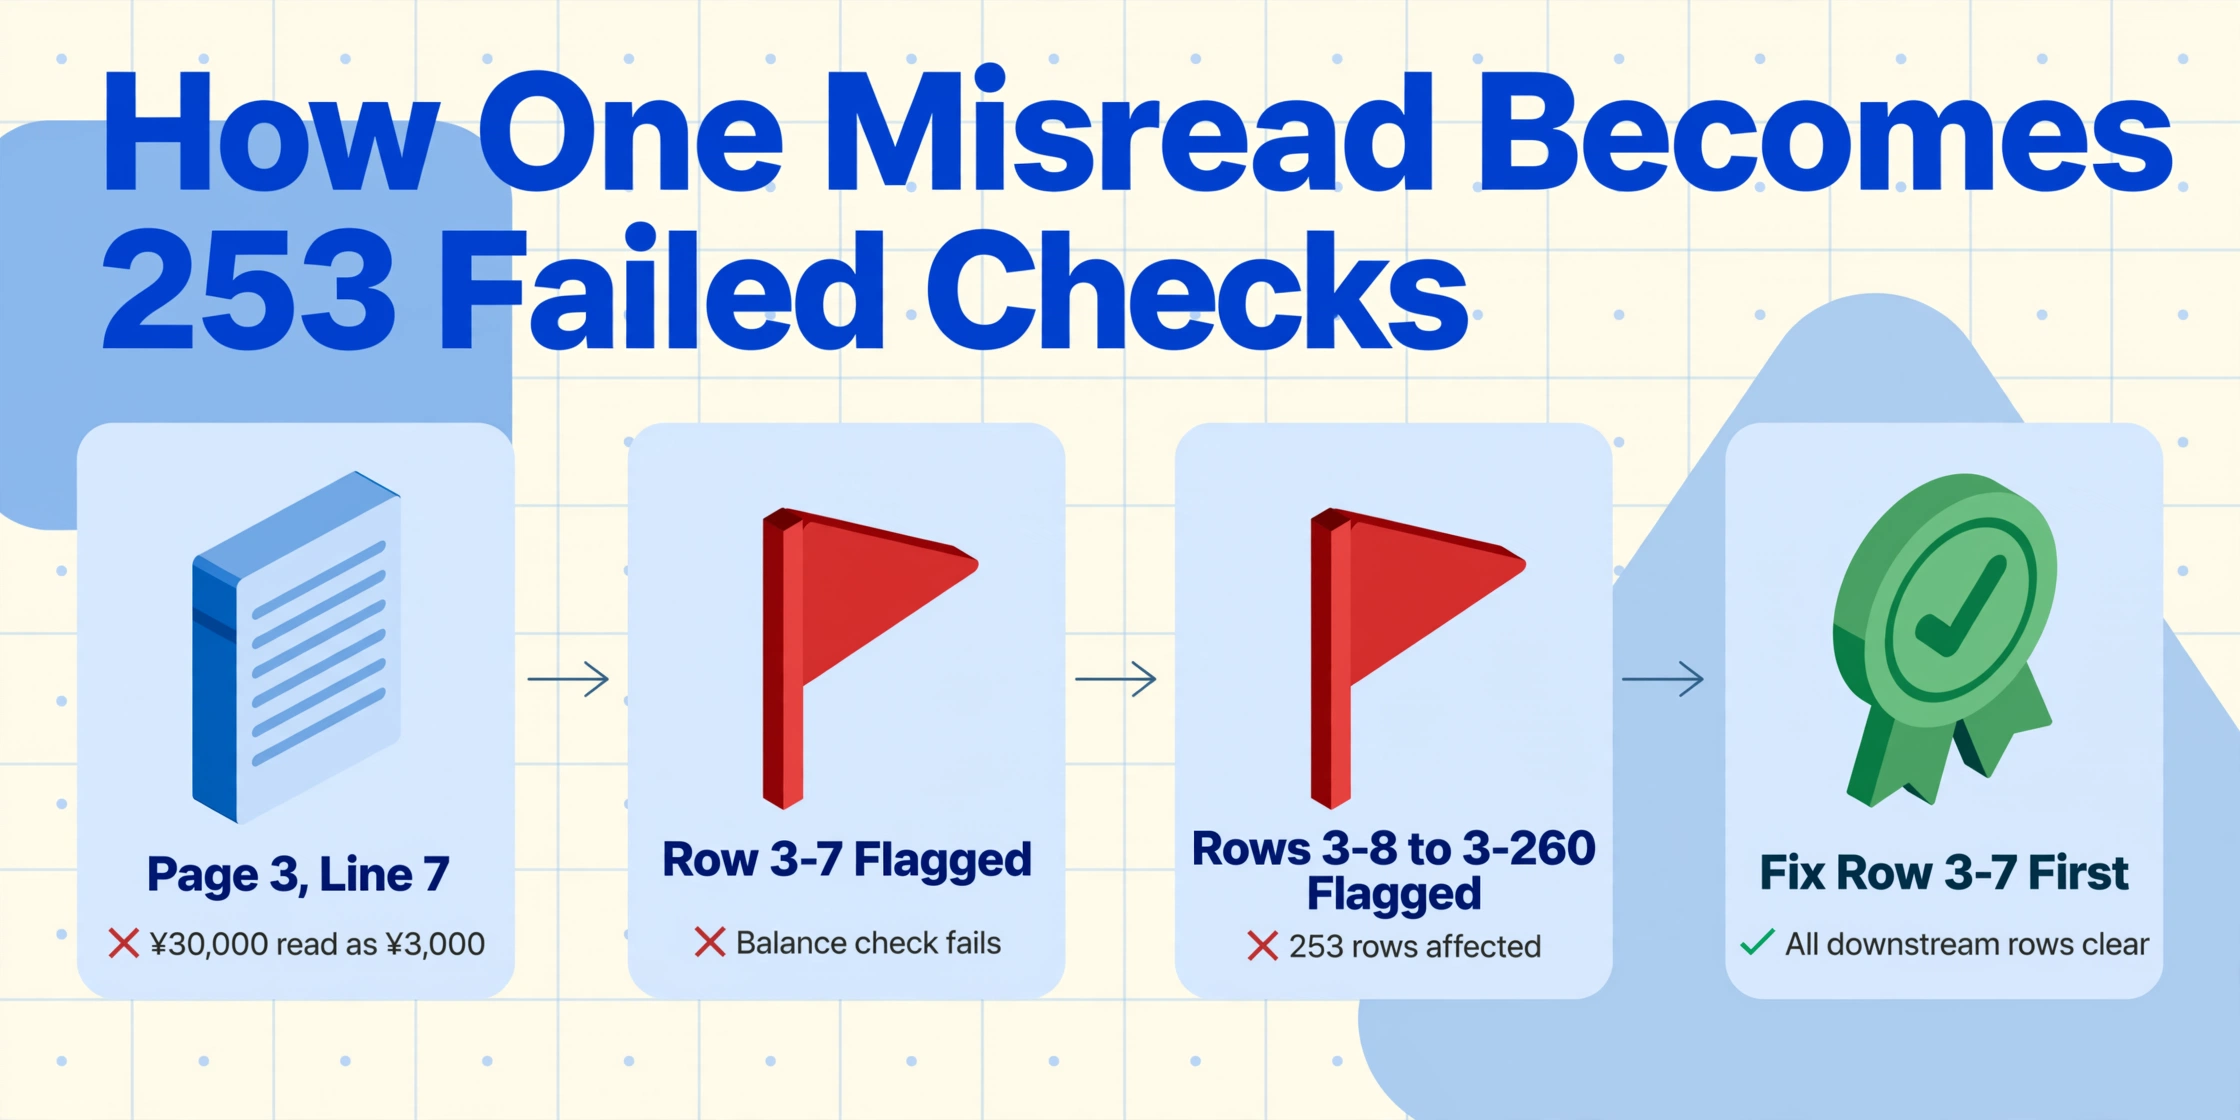
Le solde courant du livret (差引残高) est à la fois sa plus grande force pour la vérification comptable et son mode de défaillance le plus dangereux dans le traitement par lots. Un relevé bancaire est un résumé mensuel : une erreur de lecture à la ligne 14 n'affecte que la ligne 14. Un livret est un registre : le solde de la ligne 15 est égal au solde de la ligne 14 plus le dépôt de la ligne 15 moins le retrait de la ligne 15. Une erreur de lecture à la ligne 14 — une virgule omise transformant 30 000 ¥ en 3 000 ¥ — corrompt le solde de la ligne 14, ce qui corrompt le contrôle du solde de la ligne 15, ce qui corrompt celui de la ligne 16, et ainsi de suite sur chaque ligne suivante du livret.
Dans une extraction sur une seule page de 10 transactions, la cascade s'arrête à la limite de la page — la page suivante repart avec sa propre continuité de solde. Dans un lot de 280 transactions fusionnées à partir de 36 pages, la cascade franchit les limites de page car le solde est reporté de la dernière ligne de la page N à la première ligne de la page N+1. Une seule virgule mal lue à la page 3, ligne 7 produit 253 résultats de vérification de solde incorrects — chaque ligne à partir de ce point échoue au contrôle du solde, rendant impossible d'identifier la ligne à l'origine du problème sans remonter ligne par ligne.
L'approche par colonne calculée — Balance Check (previous Balance + Deposit − Withdrawal = current Balance? 'OK' : 'REVIEW') — détecte le problème au point de défaillance. La ligne 3-7 est marquée REVIEW. La ligne 3-8, dont le solde dépend de celui de la 3-7, est également marquée REVIEW — mais l'utilisateur sait qu'il faut corriger la ligne 3-7 en premier, après quoi les lignes 3-8 jusqu'à la fin du lot se recalculent correctement. Une seule ligne REVIEW dans une mer de OK est une correction ciblée. Deux cents lignes REVIEW en séquence indiquent une cause racine unique à la première ligne signalée.
L'avantage de la vérification par lots : un livret actif depuis trois ans contient 36 pages de soldes imprimés qui doivent se concilier. Une colonne calculée qui vérifie les calculs de solde sur chaque ligne extraite pendant le traitement détecte l'écart au moment de l'extraction. Sans elle, l'erreur apparaît dans le logiciel comptable lorsque la balance de vérification ne correspond pas au relevé bancaire — une réconciliation qui doit remonter à travers 280 lignes, sur trois livrets, pour trouver la seule erreur de lecture à l'origine de la cascade. Le signalement au moment de l'extraction représente deux minutes de correction. Le signalement au moment de la comptabilité représente une heure de travail d'enquête.
Cette logique de vérification s'applique directement à d'autres scénarios d'extraction par lots où la continuité de document à document crée le même risque en cascade. Un cabinet fiscal britannique consolidant 80 déclarations SA100 dans une seule feuille de calcul traite des documents indépendants — les données de chaque déclaration sont autonomes. Une équipe de paie australienne traitant par lots 300 relevés de paie PAYG est confrontée à la même indépendance. Le lot de livrets bancaires est différent parce que le document lui-même crée la continuité — et cette continuité, lorsqu'elle est respectée par une extraction adaptée aux lots, devient une piste d'audit intégrée plutôt qu'une bombe à retardement cachée.
Questions fréquentes
Puis-je traiter par lots des livrets bancaires de différentes banques dans le même téléversement ?
Oui — et c'est l'un des arguments les plus solides pour extraire par lots les trois années de livrets ensemble plutôt que de les traiter séparément. Un livret de MUFG imprime les transactions avec une entrée sur une seule ligne et la date à gauche. Un livret de Japan Post Bank (ゆうちょ銀行) utilise souvent un format de deux lignes par transaction où le champ de description passe à la ligne. Un livret d'une caisse de crédit régionale (信用金庫) imprime avec une taille de police et un alignement légèrement différents. Comme l'extraction lit le sens des champs — une date est une date, qu'elle soit imprimée R6.7.15 sur un livret ou 令和6年7月15日 sur un autre — les trois formats peuvent être téléversés dans le même lot et produire une feuille de calcul unifiée avec des colonnes cohérentes. Le même schéma de colonnes qui localise le champ du solde sur une impression MUFG propre trouve également celui d'un livret Japan Post Bank usé à l'encre délavée, car l'IA lit le contenu sémantique, pas des coordonnées de pixels alignées sur un modèle.
Que se passe-t-il lorsqu'un livret couvre deux ères impériales — 平成 et 令和 ?
L'extraction détecte le changement d'ère à la page où l'en-tête d'année change. Un livret qui va de Heisei 30 (2018) à Reiwa 6 (2024) contient les deux en-têtes d'ère. Le moteur de traitement par lots lit l'en-tête de chaque page, détermine si l'ère est 平成 ou 令和, et applique le décalage de conversion correct pour chaque transaction. Pour l'année charnière critique — 2019, qui est Heisei 31 du 1er janvier au 30 avril et Reiwa 1 (令和元年) du 1er mai au 31 décembre — l'en-tête de la page couvrant les transactions de mai sera passé à 令和, et toutes les transactions de cette page et des pages suivantes seront converties avec le décalage Reiwa (+2018). Les transactions sur les pages avec l'en-tête 平成 utiliseront le décalage Heisei (+1988). Pour les livrets contenant des transactions encore plus anciennes de l'ère Showa (昭和, 1926–1989), la même logique s'étend avec Showa + 1925.
Comment le lot gère-t-il les pages où l'en-tête d'année est manquant ?
Les pages de continuation — les pages du même livret qui ne réimpriment pas l'en-tête d'année parce qu'elles font suite à une page précédente — reportent le contexte d'ère de la page la plus récente avec un en-tête. Si la page 5 imprime 令和6年 en haut et que les pages 6 à 8 n'impriment que le mois et le jour pour chaque transaction, l'extraction applique le contexte 令和6年 à toutes les transactions des pages 5 à 8. Lorsque la page 9 imprime un nouvel en-tête — 令和7年 après la limite du 1er janvier — le contexte est mis à jour. Le report évite l'erreur de conversion d'ère la plus courante dans le traitement manuel des livrets : traiter une transaction de janvier sur une page de continuation comme l'année précédente parce que l'en-tête d'année est trois pages en arrière et que l'utilisateur a oublié de vérifier.
Que faire si certaines pages du livret contiennent des annotations manuscrites dans la marge — loyer, achats de stock, ventilation des salaires ?
De nombreux livrets bancaires contiennent des annotations manuscrites — une mention comme 家賃 (loyer) ou 仕入 (achat de stock) écrite au stylo à bille à côté d'une transaction imprimée. Si l'outil d'extraction prend en charge la reconnaissance de l'écriture manuscrite en plus du texte imprimé, ces notes marginales apparaissent dans les données extraites en tant que contexte supplémentaire. Définissez une colonne intitulée « Notes » dans votre schéma, et toute annotation manuscrite lisible à proximité d'une ligne de transaction sera capturée lors de l'extraction. Notez que la qualité de l'écriture manuscrite varie : une annotation claire au stylo à bille en kanji standard est généralement lisible ; une note au crayon à papier, écrite en biais et traversant les lignes de la grille imprimée, est moins fiable. Pour les livrets où les notes manuscrites contiennent des informations comptables cruciales — le seul enregistrement d'un travailleur indépendant pour savoir quel 振込 était un paiement client ou un virement personnel — le fichier extrait doit être vérifié en ayant le livret physique sous les yeux pour les quelques lignes où l'écriture manuscrite était ambiguë. L'IA traite la majorité lisible, réduisant la vérification d'une revue ligne par ligne à une gestion des exceptions.
Quel format de données l'extraction produit-elle, et Yayoi Accounting l'acceptera-t-il ?
Le résultat du traitement par lots est un fichier Excel (.xlsx) contenant toutes les transactions du livret dans une seule feuille. Toutes les dates sont au format aaaa-mm-jj — prêtes pour une importation CSV directe dans Yayoi Accounting (弥生会計) via la fonction Smart Transaction Import (スマート取引取込), dans freee Accounting (freee会計) via le chemin de téléchargement CSV manuel, ou dans MoneyForward Cloud Accounting (マネーフォワード クラウド会計) via la fonction de migration de données. Les autres plateformes comptables japonaises qui acceptent le même format d'importation CSV incluent MJS Accounting (会計大将), TKC (séries FX2/MX), OBC (勘定奉行), Sorimachi (会計王), EPSON (財務応援R4) et PCA (PCA会計). Le format à cinq colonnes du livret — date, description, retrait, dépôt, solde — est standardisé dans toutes les banques japonaises, donc le même résultat fonctionne avec toute plateforme comptable qui importe des données de transaction CSV.
Dois-je encore conserver les livrets physiques après l'extraction par lots ?
En vertu de la Loi japonaise sur la conservation électronique des livres comptables (電子帳簿保存法), les copies numérisées des documents financiers peuvent servir de documents légalement recevables — l'amendement de 2022 a considérablement assoupli les exigences de résolution et d'horodatage. Cependant, le livret physique reste l'original définitif. L'Agence nationale des impôts (国税庁) peut demander les originaux lors d'un contrôle fiscal. La bonne pratique pour les déclarants bleus : extrayez par lots tous les livrets vers le grand livre des dépenses annuelles pour votre flux de travail comptable, mais conservez chaque livret physique pendant la période de conservation légale de sept ans. L'extraction remplace la saisie manuelle des données et les étapes de fusion — elle ne remplace pas le document légal.
Le livret qui attend dans le tiroir
Trois ans de pages de livret bancaire patientent dans un tiroir, non pas parce que les données sont inaccessibles — chaque transaction est imprimée clairement, cinq colonnes par ligne, solde à chaque ligne — mais parce que le volume franchit le seuil où la saisie manuelle cesse d'être fastidieuse pour devenir une perte de temps. Un déclarant bleu qui saisit manuellement 280 transactions à raison de deux minutes par ligne — lire la date, déchiffrer le code de description, taper le montant, vérifier le solde — passe environ neuf heures rien qu'à la saisie. Neuf heures que la déduction de 650 000 ¥ récompense pour la tenue rigoureuse des comptes, pas pour la resaisie de données bancaires.
L'extraction par lots change la donne. Les neuf heures de saisie deviennent 18 minutes de numérisation des pages de livret plus deux minutes de vérification des indicateurs de colonne calculée — les une ou deux lignes REVIEW sur 280 où le contrôle de solde a signalé une possible erreur de lecture. Les 278 lignes restantes ont passé la vérification automatisée lors de l'extraction et sont prêtes à être importées dans le logiciel comptable sans autre examen. Le lot de l'année prochaine utilise le même schéma de colonnes avec des pages différentes. Celui de l'année suivante aussi. Le format du livret — défini par l'Association des banquiers japonais, imprimé par les distributeurs bancaires, standardisé dans toutes les institutions financières du pays — ne changera pas.