일본 통장 3년치
연간 지출 원장 한 권으로
오사카의 개인사업자가 청색신고를 위해 2023년부터 2025년까지의 통장 3권을 모았습니다 — 일상 운영용 MUFG, 세금 적립용 Japan Post Bank(ゆうちょ銀行), 급여 지급용 지역 신용금고. 세 통장에는 약 36페이지 분량의 인쇄 거래 내역, 입출금 기록 280행이 있으며, 각기 다른 ATM에서 다른 도트매트릭스 프린트 헤드로 출력되었고, 마모 상태도 각각 다른 통장 3권에 묶여 있습니다. 청색신고는 복식부기를 조건으로 65만 엔 공제를 제공합니다 — 즉 280행 전부를 Yayoi Accounting(弥生会計), freee, MoneyForward Cloud Accounting에 분류된 분개로 입력해야 합니다. 한 페이지씩 추출하고, 통장 3권의 잔액을 대조하고, 일본 연호(和暦)를 서력으로 수동 변환하는 작업은 1년치 거래라면 감당할 수 있습니다. 그러나 3개 은행 3년치라면 단일 페이지 워크플로우는 수동 병합 단계에서 무너집니다.
핵심 요점
- 통장 3년치 페이지가 당신을 무너뜨리는 지점은 타이핑 단계가 아닙니다. 병합 단계입니다 — 36개의 단일 페이지 추출 결과를 하나의 정렬된 원장으로 만들어야 할 때입니다.
- 통장의 누적 잔액은 최고의 감사 추적 장치입니다 — 그러나 한 번의 오독이 그것을 시한폭탄으로 바꿔 페이지 경계를 넘어 그 이후의 모든 행을 조용히 오염시킵니다.
- 계산 잔액 검증이 포함된 일괄 추출은 오독이 발생한 즉시 잡아냅니다 — 한 행을 2분 만에 수정하면 되고, 한 시간 뒤 시산표가 실패했을 때 280행을 거슬러 올라가며 찾을 필요가 없습니다.
일괄 처리와 장부 사이의 간극: 단일 페이지 추출로는 3년치 문제를 해결할 수 없는 이유
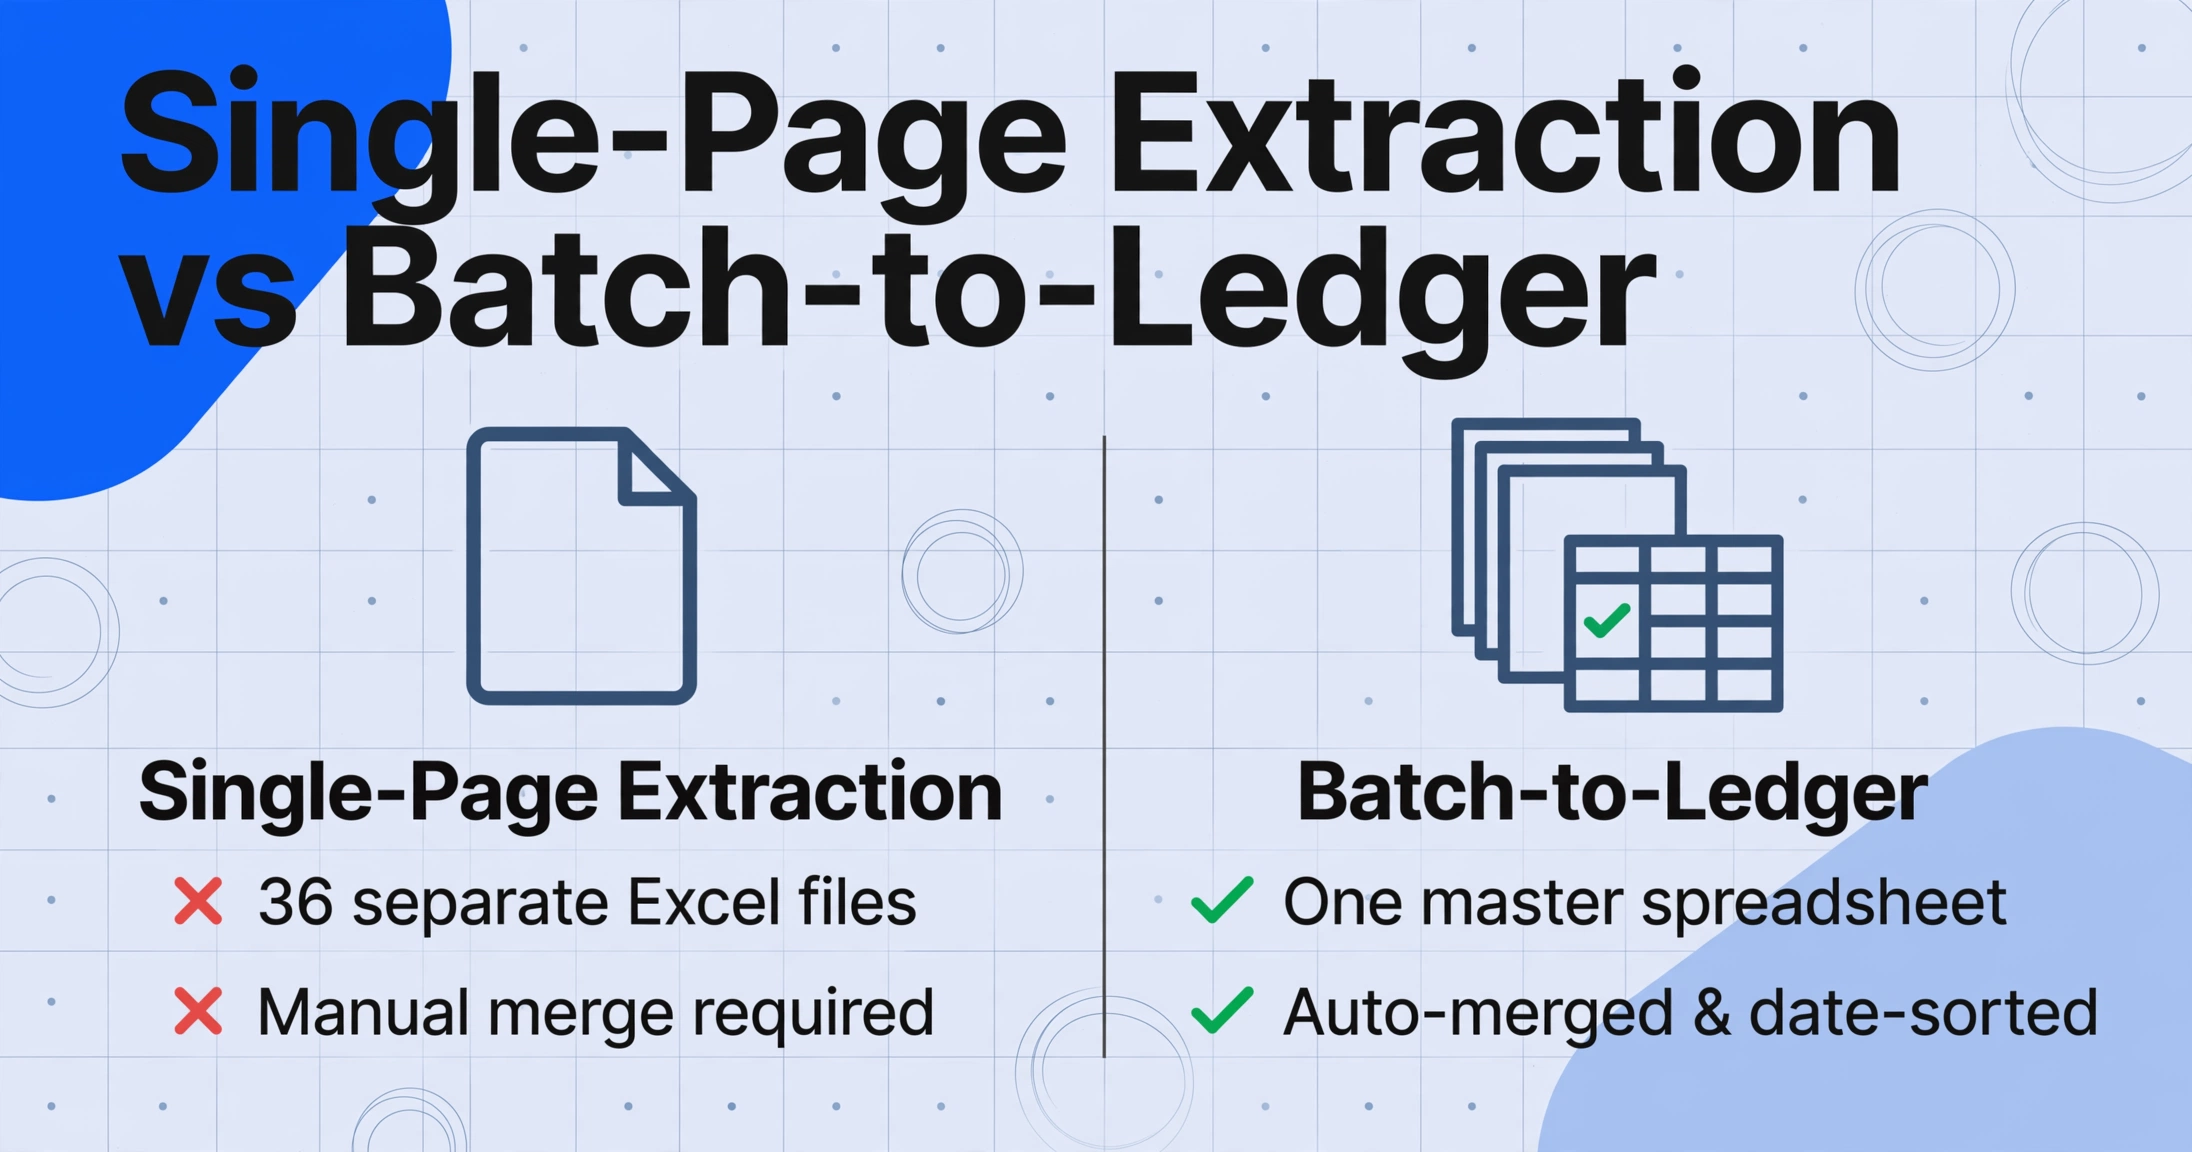
통장 한 페이지를 추출하는 것은 문제의 절반이 해결된 셈입니다. 일본 통장 추출 워크플로우 — 열 다섯 개를 정의하고, 페이지를 업로드하고, 거래마다 스프레드시트 행을 얻는 방식 — 은 한 페이지를 안정적으로 처리합니다. 해결되지 않은 나머지 절반은 추출이 끝난 뒤에 일어나는 일입니다. 데스크톱에 각각 8~10건의 거래를 담은 스프레드시트 36개가 놓여 있고, 각각은 서로 다른 은행, 서로 다른 통장, 서로 다른 페이지에서 나온 것입니다.
수동 병합이 바로 단일 페이지 추출의 효율성이 사라지는 지점입니다. 통장 3권 × 각 12페이지 = 별도의 Excel 파일 36개. 각 파일의 거래를 마스터 시트 하나에 추가하고, 서로 다른 연호 헤더를 기준으로 날짜 정렬하고, 동일한 은행 내 이체를 서로 다른 날짜에 기록한 통장들 간에 잔액 열을 교차 검증해야 합니다.
월별 지출을 추적하는 가계는 같은 계산의 더 가벼운 버전에 직면합니다. 개인 통장 두 권을 3년간 매달 갱신하면 약 250건의 거래가 발생하며, 이를 단일 연간 지출 장부(家計簿)로 병합해야 합니다. MoneyForward ME와 Zaim은 은행 API에서 새 거래를 매일 가져옵니다. 하지만 API 등록 이전의 과거 기간까지 소급하지는 않으며, 바로 그 기간의 페이지들이 통장 서랍에 쌓여 있습니다. 이 앱들은 일상적인 가시성 문제를 해결합니다. 3년치 종이가 스프레드시트 하나가 되어야 하는 연 1회의 순간은 해결하지 못합니다.
숫자 하나로 본 일괄 처리의 격차: 통장 3권 × 거래 280건 × 필드 5개 = 추출된 데이터 포인트 1,400개. 단일 페이지 추출로는 이 1,400개 포인트가 36개의 개별 파일에 나뉘어 담기며, 사용자가 직접 병합해야 합니다. 일괄 추출로는 모든 행이 정렬되고, 모든 날짜가 서력으로 변환되며, 모든 잔액이 이전 잔액과 대조 검증된 스프레드시트 하나에 담깁니다 — 병합 단계도, 복사-붙여넣기도, 수동 정렬도 필요 없습니다.
일괄 처리가 일본 통장에 실제로 가져오는 변화
일괄 처리를 은행 통장에 적용할 때는, 인보이스나 영수증 더미를 일괄 처리하는 것과는 다릅니다. 인보이스 배치는 각각 독립된 문서의 집합입니다. 각 인보이스의 데이터는 자체적으로 완결되며, 47번 인보이스의 판독 오류는 47번 인보이스에만 영향을 미칩니다. 반면 통장 배치는 상호 의존적인 페이지들의 집합입니다. 각 페이지는 이전 페이지의 내용을 이어받고, 차인 잔액은 앞으로 누적되며, 연호 헤더를 포함한 날짜 컨텍스트는 페이지 경계를 넘어 전달됩니다. 12페이지 분량 배치의 3페이지에서 단 한 번의 판독 오류가 발생하면, 이후 모든 페이지의 잔액 검증이 조용히 망가집니다.
통장 일괄 처리를 단일 페이지 추출과 구분 짓는 세 가지 차원이 있습니다:
다중 통장 통합. 운영, 세금 적립, 급여 통장을 가진 소규모 사업체는 세 개의 개별적인 누적 잔액을 보유합니다. 계좌 간 이체는 한 통장에서는 출금으로, 다른 통장에서는 입금으로 나타나며, 종종 날짜도 다릅니다. 세 통장을 모두 단일 정렬 원장으로 병합하는 일괄 출력을 사용하면 계좌 간 이체를 추적할 수 있습니다. 세 개의 개별 스프레드시트로는 이를 확인할 수 없습니다.
페이지 간 연호 날짜 이월. 통장 페이지 상단에는 연호 헤더가 한 번 인쇄됩니다. 같은 페이지의 이후 행에는 월과 일(7.15)만 표시됩니다. 추출이 페이지를 개별적으로 처리하면, 7페이지의 거래는 헤더가 6페이지에 있기 때문에 연도 참조 없이 "7.15"라는 부동 날짜가 됩니다. 배치 인식 추출은 헤더를 한 번 읽고 해당 페이지와 이후 페이지의 모든 거래에 적용하여 출력에서 모든 날짜를 서력으로 변환합니다. 연호가 1월 1일에 변경되면, 배치 로직이 배치 중간에서 이 변경을 처리합니다. 따라서 令和6年 12월 30일과 令和7年 1월 5일이 모두 수동 개입 없이 올바른 서력 날짜로 변환됩니다.
연대를 넘나드는 통장. 2018년에 개설되어 2024년에 갱신된 통장에는 平成과 令和 두 시대에 걸친 거래가 포함됩니다. 시대 전환은 통장 중간, 즉 2019년 5월 1일에 헤이세이 31년이 레이와 1년이 되는 시점에 발생합니다. 한 번에 한 페이지씩 처리하는 추출 방식은 경계 부근의 거래에 잘못된 시대 컨텍스트를 적용할 수 있습니다. 배치 인식 추출은 헤더가 平成에서 令和로 전환되는 페이지에서 시대 변경을 감지하고, 각 거래의 위치에 따라 올바른 시대 오프셋을 적용합니다. 1980년대에 개설된 계좌처럼 昭和 시대 후반 거래도 포함된 통장의 경우, 동일한 로직이 쇼와 + 1925로 확장됩니다.
단일 페이지 추출 도구는 각 페이지를 독립된 섬처럼 처리합니다. 일괄 도구는 이를 연속된 시퀀스로 처리합니다. 그리고 연속성을 기반으로 정의된 문서 유형의 경우, 이 차이가 출력물을 즉시 사용할 수 있게 만들지, 아니면 수동 재조립에 몇 시간을 소비하게 할지를 결정합니다.
和暦 문제, 일괄 처리량으로 인해 더욱 복잡해지다
통장 한 페이지에서 일본 연호(和暦) 날짜를 변환하는 것은 수동으로 처리 가능한 단계입니다. 상단의 연도 헤더를 읽고, 연호 오프셋을 알고, 각 날짜를 암산으로 변환하면 됩니다. 그러나 세 개의 통장에서 36페이지에 걸쳐 — 연도 헤더가 매월 ATM 출력물 묶음의 첫 페이지에만 나타나고 이후 5~7페이지의 연속 페이지에서는 사라지는 경우 — 수동 변환 작업량은 "감당 가능한 수준"에서 "회계 소프트웨어 거부로 이어지는 오류의 주요 원인"으로 바뀝니다.
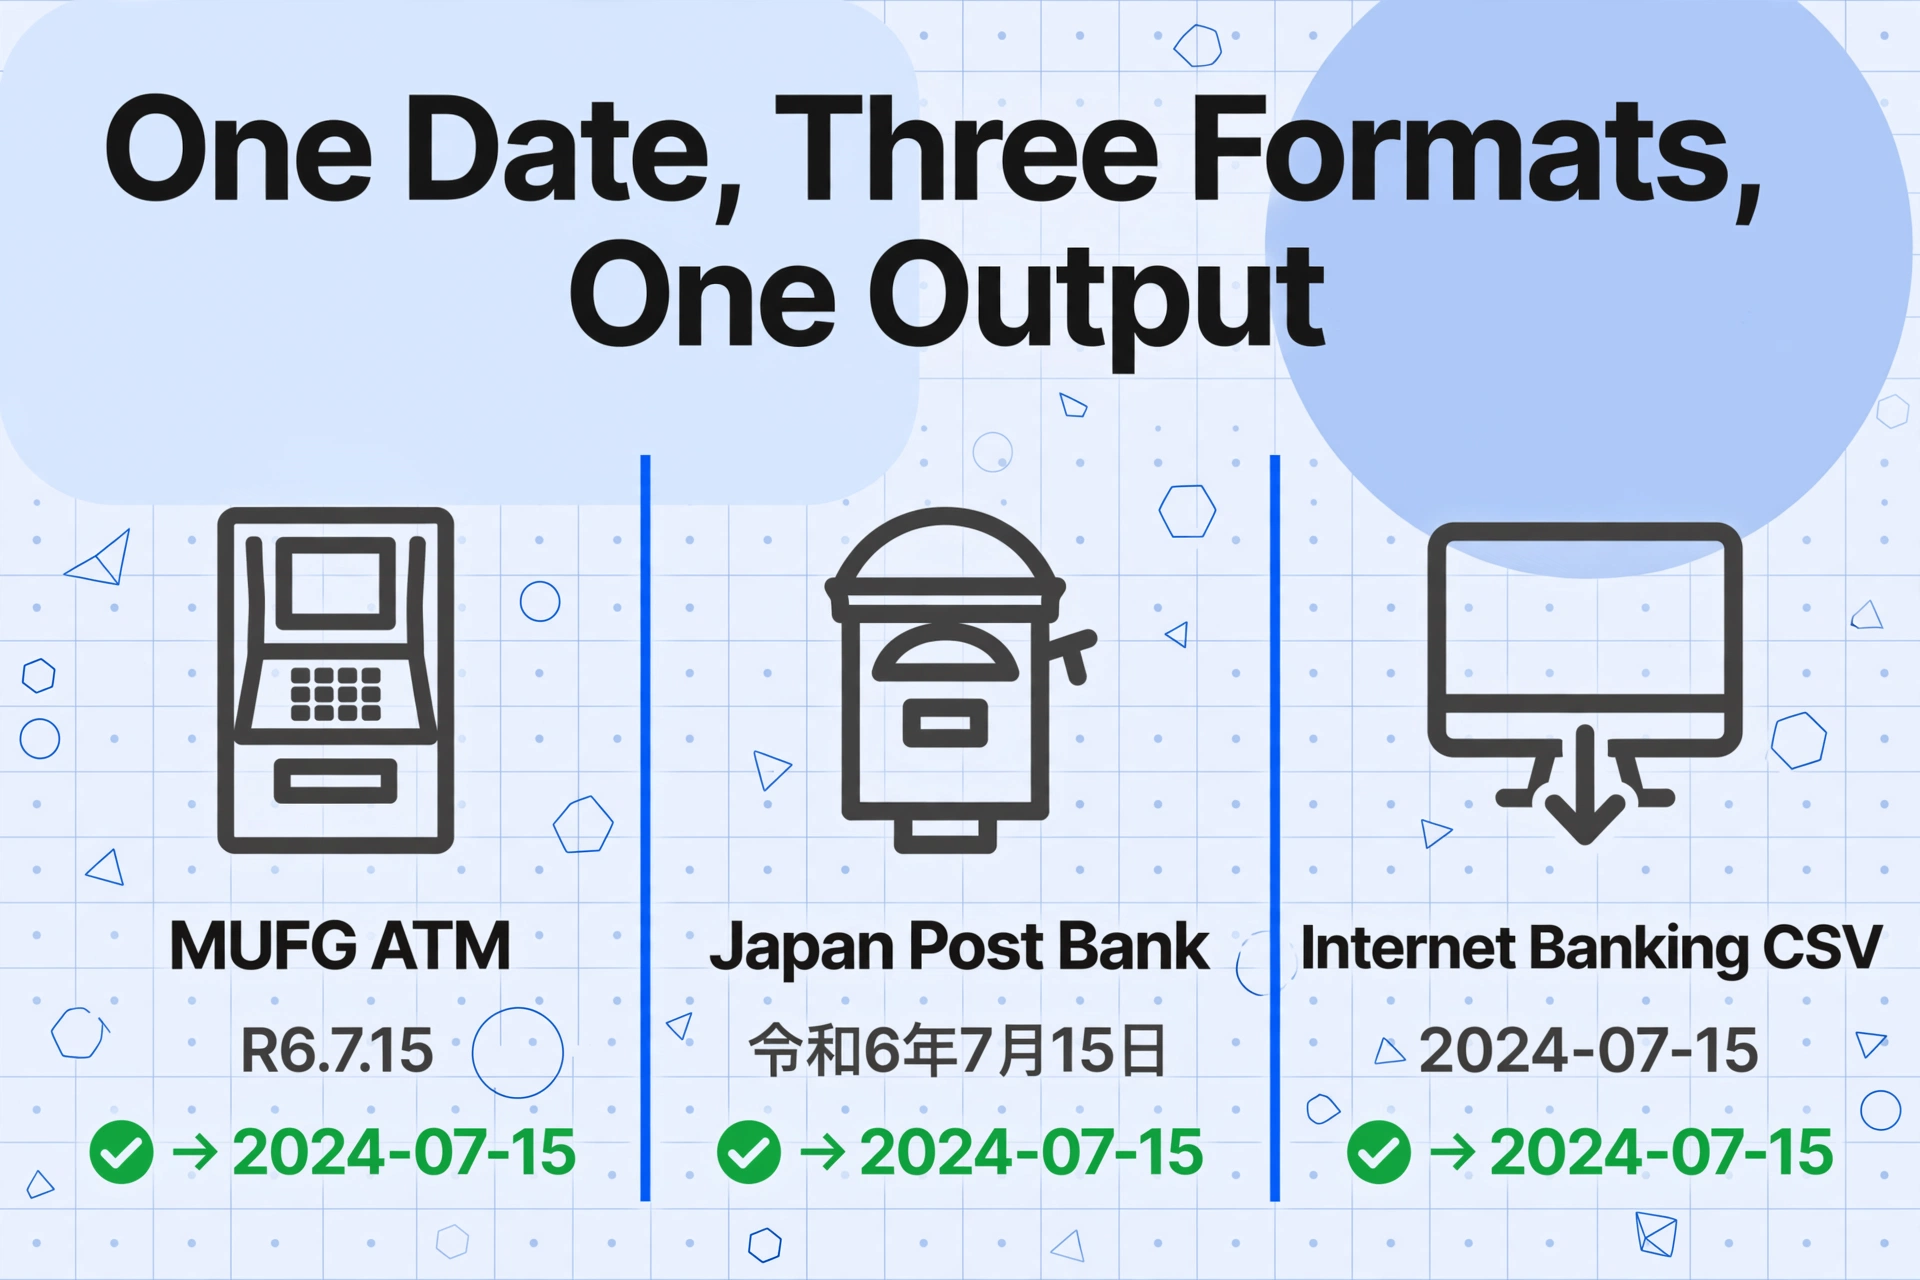
데이터 경로를 생각해 보겠습니다. MUFG ATM에서 출력된 통장은 2024년 7월 15일을 R6.7.15 형식으로 표기합니다. 동일한 거래가 Japan Post Bank ATM에서 출력되면 전체 연호명인 令和6年7月15日로 표기될 수 있습니다. 사용자가 인터넷 뱅킹에서 일부 월을 CSV로 내보내면 해당 날짜는 2024-07-15로 도착합니다. 동일한 날짜의 세 가지 표기 방식이 하나의 일괄 처리 안에 존재합니다.
Yayoi Accounting(弥生会計)은 CSV 가져오기 시 날짜가 yyyy-mm-dd 형식이어야 합니다. "R6.7.15"라는 날짜 문자열을 보내면 가져오기가 조용히 실패합니다 — 거래 행이 건너뛰어지고, 실패는 몇 시간 후 시산표가 통장과 일치하지 않을 때 표면화됩니다.
일괄 추출은 출력 계층에서 연호 변환을 처리합니다. 각 통장 페이지에 날짜가 어떻게 표시되든 — 축약 연호 + 월.일, 전체 연호명 + 年月日, 또는 이미 서력으로 표기된 경우 — 통합 스프레드시트의 모든 날짜는 yyyy-mm-dd로 도착합니다. 3년과 두 연호에 걸친 일괄 처리의 경우, 추출 엔진은 사용자의 수동 주석이 아닌 각 페이지에서 감지된 연호 컨텍스트를 기반으로 거래별 올바른 오프셋을 적용합니다.
연호 변환 로직은 결정적입니다. 레이와 n년 = 서력 (n + 2018)년, 헤이세이 n년 = (n + 1988)년, 쇼와 n년 = (n + 1925)년입니다. 문제는 산술이 아니라 — 연호 헤더가 몇 페이지마다 한 번씩 나타나고 연호 자체가 일괄 처리 중간에 바뀔 수 있을 때, 어떤 연호가 어떤 페이지의 어떤 줄에 적용되는지 감지하는 것입니다. 템플릿 기반 OCR은 고립된 셀만 읽기 때문에 이 판단을 내릴 수 없습니다. 일괄 컨텍스트를 갖춘 의미론적 추출은 페이지 헤더와 해당 콘텐츠 행 간의 관계를 읽기 때문에 가능합니다.
통장 일괄 처리 워크플로우 구축: 3단계
3년치 통장 페이지를 연간 지출 원장 하나로 일괄 처리하는 워크플로우는 통장 3권을 처리하든 30권을 처리하든 동일합니다. 설정 단계는 한 번만 수행하며 모든 배치, 모든 은행, 모든 과세 연도에 걸쳐 재사용됩니다. 단일 통장 추출을 위해 열을 이미 설정했다면 여기서도 동일한 열 스키마를 재사용합니다.
출력 열과 검증 규칙을 한 번만 정의하세요 — 모든 은행, 모든 연도에 대해
출력 스프레드시트의 열 머리글로 표시될 필드 이름을 정확히 입력하세요. 통장 추출의 표준 스키마는 다음과 같습니다: 날짜, 적요, 출금, 입금, 차인 잔액. 이것이 맞춤 열 추출입니다: 출력 스키마를 정의하면 AI가 각 통장의 인쇄된 필드를 필드 위치가 아닌 필드 의미를 읽어 열에 매핑합니다. 동일한 열 이름이 MUFG의 단일 라인 형식, Japan Post Bank의 거래당 2줄 레이아웃, 지역 신용금고의 컴팩트 인쇄에서 모두 작동합니다 — 같은 배치의 세 통장 모두 통합 스프레드시트를 생성합니다. 연간 지출 장부의 경우 추출 중 실행되는 계산 열로 보완하세요: 잔액 확인 열은 데이터가 회계 소프트웨어에 들어가기 전에 부동 소수점 오류를 표시하고, 카테고리 열은 거래를 유형별로 미리 분류하여 출력이 단순한 시간순 목록이 아닌 연간 지출 장부가 되도록 합니다.
전체 배치를 업로드하세요 — 모든 통장, 모든 페이지, 한 번의 업로드로
모든 통장의 모든 페이지를 스캔하거나 촬영하세요 — 계좌 번호가 표시된 앞표지와 마그네틱 띠가 있는 뒷표지 포함 — 모든 이미지를 하나의 배치 업로드에 넣으세요. 2023년 MUFG 통장 12페이지, 같은 해 Japan Post Bank 통장 10페이지, 2023–2025년을 포함한 신용금고 통장 14페이지가 모두 같은 업로드에 들어갑니다. 일괄 처리는 이를 단일 작업으로 처리합니다: 각 페이지는 열 스키마가 적용된 상태로 개별 처리되고, 일본 연호 날짜는 올바른 페이지 수준 컨텍스트로 서력으로 변환되며, 모든 결과는 날짜순으로 정렬된 하나의 스프레드시트로 병합됩니다. 페이지는 문서 스캐너의 스캔, 스마트폰으로 찍은 사진, 또는 통장 스타일 거래 내역이 포함된 인터넷 뱅킹의 PDF 내보내기일 수 있습니다. 총 업로드 시간은 스캔이 지배합니다 — 페이지당 정렬 및 스캔에 약 30초, 36페이지는 약 18분의 준비 시간이 걸립니다. 추출 자체는 몇 분 안에 완료됩니다.
통합 원장을 내보내고 회계 작업을 시작하세요
거래당 한 행씩, 약 280개 행이 포함된 Excel 파일 하나를 다운로드하세요. 모든 필드는 각각의 열에 담겨 있습니다. 날짜 열은 서력(yyyy-mm-dd) 형식이며 Yayoi, freee 또는 MoneyForward Cloud Accounting CSV 가져오기에 바로 사용할 수 있습니다. 잔액 확인 열에는 계산이 맞는 모든 거래 옆에 OK가 표시되고, 누적 잔액이 일치하지 않는 행에는 REVIEW가 표시됩니다. 일반적으로 280개 중 1~2개 행이 오래된 통장 페이지의 잘못 읽은 쉼표나 번진 숫자 때문에 발생합니다. 그 두 행을 수정하면 나머지 278개는 검증됩니다. 분류 열은 거래를 유형별로 그룹화하므로 "자동이체(引落)"로 필터링하면 한 화면에서 1년치 임대료, 공과금, 보험료 납부 내역을 볼 수 있습니다. 동일한 열 구조는 내년에도 같은 통장에 그대로 적용됩니다. 전국은행협회(全国銀行協会)가 정의한 일본 통장의 필드는 변경되지 않기 때문입니다.
파일은 안전하게 처리되며 저장되지 않습니다.
적요 코드와 연간 지출 원장
통장의 적요(摘要) 열은 일본인이 즉시 분류할 수 있는 간결한 코드를 사용합니다. 給与는 급여, 振込는 은행 송금, 引落은 자동이체, 手数料는 은행 수수료, 利息는 이자, カード는 카드 거래입니다. 이러한 코드(振込, 振込, 引落, 給与, 振込)를 그대로 재현하는 원시 추출은 거래 목록을 생성합니다. 처리 중에 이를 분류하는 일괄 추출은 연간 지출 원장을 생성합니다.
이 구분이 중요한 이유는 회계 소프트웨어 대상(Yayoi, freee, MoneyForward Cloud Accounting)이 원시 적요 코드가 아닌 계정 과목(勘定科目)이 포함된 분개를 필요로 하기 때문입니다. 단일 페이지 추출 후 수동 워크플로우는 스프레드시트를 열고 Category 열을 추가한 다음 280개 행을 살펴보며 급여 입금에 売上을, 자동이체에 水道光熱費를 할당하는 것입니다. 3년치 배치의 경우 반복적인 분류 작업에 약 45분이 소요되며, 振込 같은 코드를 하위 분류해야 하는 경우 더 오래 걸립니다.
추출 중 적요 코드를 지출 카테고리에 매핑하는 계산 열은 출력을 거래 목록에서 사전 분류된 원장으로 전환합니다. 매핑 규칙은 열 스키마에 한 번 정의되며 280개 행 전체에 자동으로 적용됩니다.
동일한 계산 분류 로직은 설명 필드만으로는 파악할 수 없는 맥락이 필요한 코드에도 적용됩니다. 알려진 거래처 회사명이 지급인 필드에 있는 ¥500,000의 振込은 사업 수입입니다. 개인으로부터의 ¥15,000 振込은 개인 송금일 가능성이 높습니다. 계산 열은 설명 코드와 입금 금액을 결합하여 분류할 수 있습니다: if Description="振込" and Amount > 100000 then "Business Income"; if Description="振込" and Amount <= 100000 then "Personal Transfer". 추출 엔진은 처리 중에 이 로직을 평가하고, 분류 결정이 완료된 상태로 출력이 도착합니다 — 사용자는 모든 결정을 처음부터 내리는 대신 승인하거나 수정하기만 하면 됩니다.
잔액 오류 전파: 배치에서 한 건의 오독이 이후 모든 행을 무너뜨리는 이유
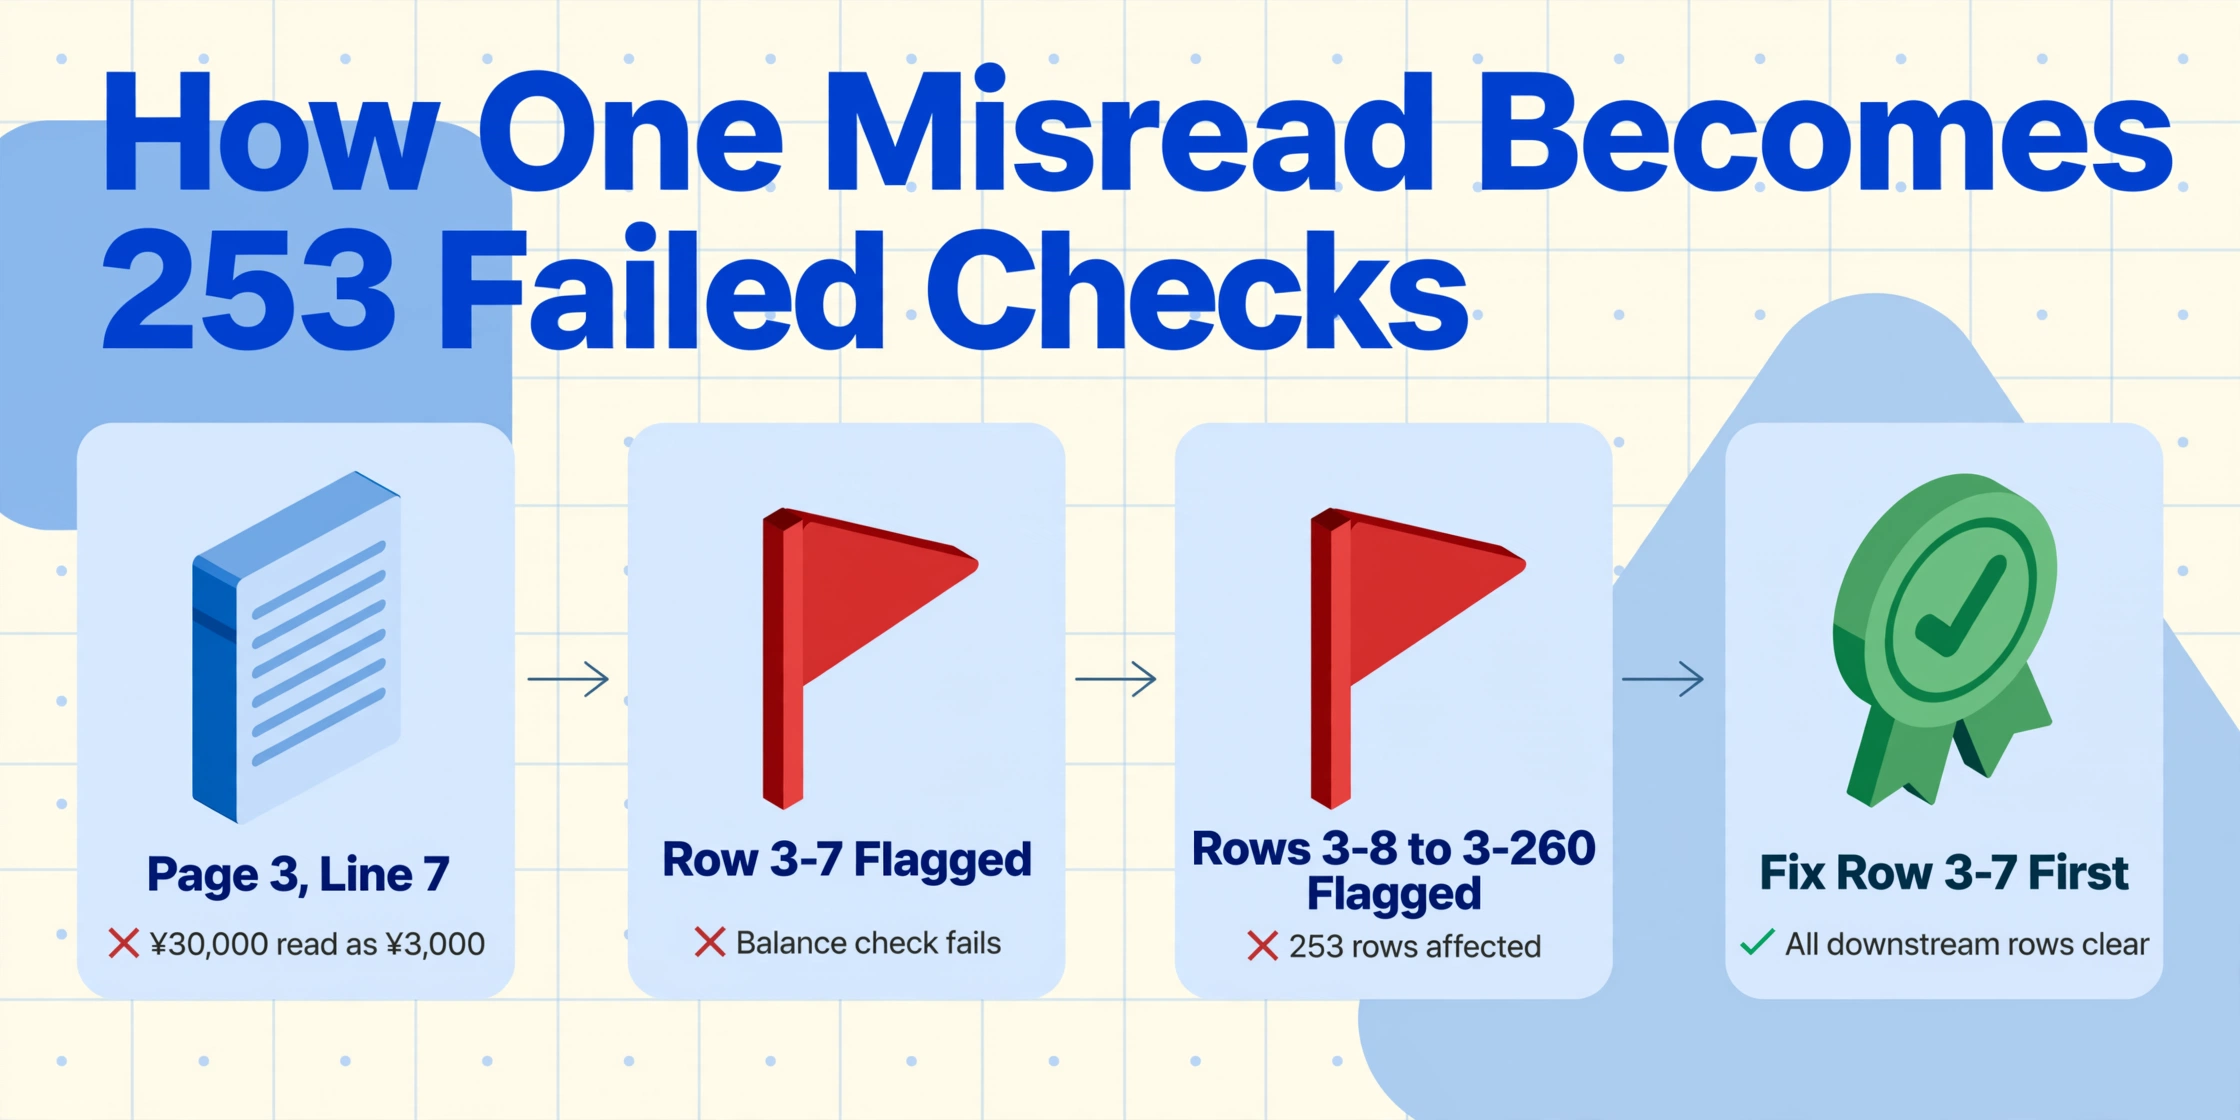
통장의 차인 잔액은 회계 검증에 있어 가장 큰 강점이자, 일괄 처리에서 가장 위험한 실패 지점입니다. 은행 거래 내역서는 월간 요약입니다. 14행의 오독은 14행에만 영향을 줍니다. 그러나 통장은 원장입니다. 15행의 잔액은 14행의 잔액에 15행의 입금을 더하고 15행의 출금을 뺀 값입니다. 14행의 오독 — 콤마 하나가 빠져 ¥30,000이 ¥3,000으로 읽히는 경우 — 14행의 잔액을 오염시키고, 이는 15행의 잔액 검증을 오염시키며, 다시 16행으로 이어져 통장의 모든 후속 행에 영향을 미칩니다.
10건의 거래를 단일 페이지에서 추출하는 경우, 오류 전파는 페이지 경계에서 멈춥니다. 다음 페이지는 자체 잔액 연속성으로 새로 시작하기 때문입니다. 36페이지에서 병합된 280건의 거래 배치에서는 잔액이 N페이지의 마지막 행에서 N+1페이지의 첫 행으로 이월되므로 오류 전파가 페이지 경계를 넘어섭니다. 3페이지 7행의 콤마 하나 오독은 253건의 잘못된 잔액 검증 결과를 만듭니다. 그 지점 이후의 모든 행이 잔액 검증에 실패하므로, 문제를 일으킨 행을 찾으려면 한 행씩 거슬러 올라갈 수밖에 없습니다.
계산 열 접근 방식 — Balance Check (previous Balance + Deposit − Withdrawal = current Balance? 'OK' : 'REVIEW') — 은 실패 지점에서 문제를 포착합니다. 3-7행은 REVIEW로 표시됩니다. 3-7행의 잔액에 의존하는 3-8행도 REVIEW로 표시되지만, 사용자는 3-7행을 먼저 수정해야 한다는 것을 알며, 수정 후 3-8행부터 배치 끝까지 올바르게 재계산됩니다. OK로 가득한 데이터에서 REVIEW 행 하나는 정확히 짚어낸 수정 지점입니다. 연속된 200개의 REVIEW 행은 첫 번째 오류 표시 행 하나가 근본 원인임을 의미합니다.
일괄 검증의 이점: 3년간 사용된 통장에는 조정이 필요한 36페이지 분량의 인쇄된 잔액이 있습니다. 처리 중 추출된 모든 행의 잔액 계산을 검증하는 계산 열은 추출 시점에 불일치를 포착합니다. 이것이 없으면 오류는 시산표가 은행 거래 내역서와 일치하지 않을 때 회계 소프트웨어 내부에서 표면화됩니다. 이때는 280개 행, 통장 3권을 거슬러 올라가 오류 전파를 시작한 단 한 건의 오독을 찾아야 하는 조정 작업이 필요합니다. 추출 시점의 오류 표시는 2분이면 수정됩니다. 회계 시점의 오류 발견은 한 시간의 회계 감사 작업입니다.
이 검증 로직은 문서 간 연속성이 동일한 연쇄 위험을 만드는 다른 일괄 추출 시나리오에도 그대로 적용됩니다. 영국 세무 법인이 80개의 SA100 자진 신고서를 하나의 스프레드시트로 통합하는 경우 독립적인 문서를 처리하는 것입니다 — 각 신고서의 데이터는 자체적으로 완결됩니다. 호주 급여 팀이 300개의 PAYG 지급 요약서를 일괄 처리하는 경우에도 동일한 독립성이 적용됩니다. 통장 일괄 처리는 문서 자체가 연속성을 만들기 때문에 다릅니다 — 그리고 일괄 인식 추출이 그 연속성을 존중할 때, 그 연속성은 숨겨진 시한폭탄이 아닌 내장된 감사 추적 장치가 됩니다.
자주 묻는 질문
같은 업로드에서 다른 은행의 통장을 일괄 처리할 수 있나요?
네 — 그리고 이것이 3년치 통장을 개별 처리하는 대신 함께 일괄 추출하는 가장 강력한 이유 중 하나입니다. MUFG 통장은 거래를 한 줄로 인쇄하고 날짜가 왼쪽에 표시됩니다. Japan Post Bank(ゆうちょ銀行) 통장은 종종 거래당 두 줄 형식을 사용하며 적요 필드가 줄바꿈됩니다. 지역 신용금고(信用金庫) 통장은 약간 다른 글꼴 크기와 정렬로 인쇄됩니다. 추출이 필드 의미를 읽기 때문에 — 날짜는 한 통장에 R6.7.15로 인쇄되든 다른 통장에 令和6年7月15日로 인쇄되든 날짜입니다 — 세 형식을 모두 같은 배치에 업로드하고 일관된 열이 있는 통합 스프레드시트를 생성할 수 있습니다. 깨끗한 MUFG 인쇄물에서 잔액 필드를 찾는 동일한 열 스키마는 글자가 바랜 Japan Post Bank 통장에서도 잔액을 찾습니다. AI가 템플릿 정렬 픽셀 좌표가 아닌 의미적 콘텐츠를 읽기 때문입니다.
통장이 平成과 令和 두 연호에 걸쳐 있을 때는 어떻게 되나요?
추출은 연도 헤더가 전환되는 페이지에서 연호 변경을 감지합니다. 平成 30(2018)부터 令和 6(2024)까지 이어지는 통장에는 두 연호 헤더가 모두 포함됩니다. 일괄 엔진은 각 페이지의 헤더를 읽고 연호가 平成인지 令和인지 판단한 후 거래별로 올바른 변환 오프셋을 적용합니다. 중요한 경계 연도인 2019년 — 1월 1일부터 4월 30일까지는 平成 31, 5월 1일부터 12월 31일까지는 令和 1(令和元年) — 의 경우 5월 거래가 포함된 페이지의 헤더는 令和로 전환되어 있으며 해당 페이지와 이후 페이지의 모든 거래는 令和 오프셋(+2018)으로 변환됩니다. 平成 헤더가 있는 페이지의 거래는 平成 오프셋(+1988)을 사용합니다. 昭和(1926–1989) 시대의 더 이른 거래가 포함된 통장의 경우에도 동일한 로직이 昭和 + 1925로 확장됩니다.
연도 헤더가 없는 페이지는 일괄 처리에서 어떻게 처리되나요?
계속 페이지 — 이전 페이지에서 이어지기 때문에 연도 헤더를 다시 인쇄하지 않는 같은 통장 내의 페이지 — 는 가장 최근 헤더가 있는 페이지의 연호 컨텍스트를 이어받습니다. 5페이지 상단에 令和6年이 인쇄되고 6~8페이지에 거래별로 월과 일만 인쇄된 경우, 추출은 5~8페이지의 모든 거래에 令和6年 컨텍스트를 적용합니다. 9페이지에 새 헤더가 인쇄되면 컨텍스트가 업데이트됩니다. 이 이어받기는 수동 통장 처리에서 가장 흔한 연호 변환 오류를 방지합니다: 연도 헤더가 세 페이지 앞에 있는데 사용자가 확인하는 것을 잊어 계속 페이지의 1월 거래를 전년도로 처리하는 오류입니다.
통장 페이지에 수기 메모가 있는 경우는 어떻게 되나요?
많은 통장에는 수기로 작성된 메모(예: 거래 내역 옆에 볼펜으로 적힌 '家賃' 또는 '仕入')가 포함되어 있습니다. 추출 도구가 인쇄된 텍스트와 함께 필기 텍스트 인식을 지원하는 경우, 이러한 여백 메모는 추가 컨텍스트로 추출된 데이터에 나타납니다. 스키마에 "Notes"라는 열을 정의하면 거래 줄 근처에 있는 판독 가능한 수기 메모가 추출 중에 캡처됩니다. 필기 품질은 다양합니다. 표준 한자로 된 선명한 볼펜 메모는 일반적으로 읽을 수 있지만, 인쇄된 격자선을 가로지르며 비스듬히 쓰여진 희미한 연필 메모는 신뢰도가 낮습니다. 수기 메모에 중요한 회계 정보(예: 개인 사업자가 특정 振込이 고객 결제인지 개인 이체인지 구분하는 유일한 기록)가 포함된 통장의 경우, 필기가 모호한 몇몇 행에 대해서는 추출된 스프레드시트를 실제 통장과 함께 대조하여 검토해야 합니다. AI가 판독 가능한 대부분을 처리하므로, 검토는 행별 확인에서 예외 처리로 축소됩니다.
추출 결과는 어떤 데이터 형식이며, Yayoi Accounting에서 사용할 수 있나요?
일괄 출력은 모든 통장 거래가 하나의 시트에 포함된 단일 Excel 파일(.xlsx)입니다. 모든 날짜는 yyyy-mm-dd 형식으로, Yayoi Accounting(弥生会計)의 Smart Transaction Import(スマート取引取込) 기능, freee Accounting(freee会計)의 수동 CSV 업로드 경로, 또는 MoneyForward Cloud Accounting(マネーフォワード クラウド会計)의 데이터 마이그레이션 기능을 통해 바로 CSV로 가져올 수 있습니다. 동일한 CSV 가져오기 형식을 지원하는 기타 일본 회계 플랫폼으로는 MJS Accounting(会計大将), TKC(FX2/MX 시리즈), OBC(勘定奉行), Sorimachi(会計王), EPSON(財務応援R4), PCA(PCA会計) 등이 있습니다. 통장의 5열 형식은 모든 일본 은행에서 표준화되어 있으므로, 동일한 출력이 CSV 거래 데이터를 가져오는 모든 회계 플랫폼에서 작동합니다.
일괄 추출 후에도 실제 통장을 보관해야 하나요?
일본의 전자장부보존법(電子帳簿保存法)에 따라, 금융 문서의 스캔 사본은 법적으로 인정되는 기록으로 사용될 수 있습니다. 그러나 실제 통장은 여전히 최종 원본입니다. 국세청(国税庁)은 세무 조사 시 원본을 요청할 수 있습니다. 청색신고자를 위한 모범 사례: 모든 통장을 일괄 추출하여 회계 워크플로우의 연간 지출 원장에 통합하되, 법정 7년 문서 보존 기간 동안 각 실제 통장을 보관하십시오. 추출은 수동 데이터 입력 및 병합 단계를 대체할 뿐, 법적 기록을 대체하지는 않습니다.
서랍 속에서 기다리는 통장
3년 치 통장 페이지가 서랍에 보관되어 있는 이유는 데이터에 접근할 수 없어서가 아닙니다. 모든 거래가 깨끗이 인쇄되어 있고, 행당 5개 열, 모든 줄에 차인 잔액이 표시되어 있습니다. 문제는 그 양이 수동 입력이 지루함을 넘어 시간 낭비로 느껴지는 임계점을 넘었기 때문입니다. 청색신고자가 280건의 거래를 행당 2분씩 수동으로 입력한다면 데이터 입력만으로 약 9시간이 소요됩니다. 연간 65만 엔 공제는 장부 정리를 위한 보상이지, 은행 데이터를 다시 입력하는 대가가 아닙니다.
일괄 추출은 이러한 계산을 바꿉니다. 9시간의 입력 작업이 통장 페이지 18분 스캔과 계산 열 플래그 확인 2분으로 단축됩니다. 280건 중 REVIEW로 표시된 1~2건의 행에서 잔액 확인이 잠재적 오독을 알리는 경우입니다. 나머지 278건은 추출 중 자동 검증을 통과했으며 추가 검토 없이 회계 소프트웨어로 가져올 준비가 되었습니다. 다음 해의 일괄 작업은 다른 페이지로 동일한 열 스키마를 사용합니다. 그 다음 해에도 다시 사용합니다. 전국은행협회가 규정하고 은행 ATM이 인쇄하며, 전국 모든 금융 기관에서 표준화된 통장 형식은 변하지 않을 것입니다.