Por que a Extração de Tabelas com Células Mescladas
Falha? 4 Causas Comuns e Correções
Você não está sozinho — este é o problema de extração mais comum. Sua ferramenta lê o texto, mas a saída volta com células vazias onde deveria haver dados, cabeçalhos de coluna espalhados nas colunas erradas ou linhas que simplesmente desapareceram. Células mescladas no documento de origem são quase sempre as culpadas, e a correção depende de entender qual tipo de padrão de célula mesclada está causando o problema.
Principais Conclusões
- Sua extração foi concluída sem erro, mas colunas inteiras voltaram vazias porque cada célula mesclada na origem forçou sua ferramenta a fazer uma suposição silenciosa.
- Essas células em branco não são aleatórias — quatro padrões específicos de células mescladas as causam, e cada um tem uma causa raiz nomeada que você pode diagnosticar em 30 segundos.
- Uma única verificação pós-extração — desmesclar células restantes, preencher para baixo para propagar valores e verificar a contagem de linhas em relação à origem — detecta a corrupção silenciosa à qual toda ferramenta é vulnerável.
Isso Parece Familiar?
Se você está aqui, provavelmente um destes cenários corresponde ao que você está vendo agora:
- Células vazias em colunas que deveriam ter dados. Um rótulo de categoria mesclado ("Q1 Revenue") que abrange três linhas — a primeira linha tem o texto, as outras duas estão vazias.
- Dados migraram para a coluna errada. Valores que pertencem a "Amount" acabaram em "Description" porque o cabeçalho mesclado confundiu a detecção de limites das colunas.
- Cabeçalhos de coluna ausentes ou bagunçados. Um bloco de cabeçalho de duas linhas onde "Product Details" abrange cinco colunas — a extração o reduziu a uma única coluna.
- As linhas não batem. A origem tem 14 linhas de dados, mas a saída mostra 9, ou vice-versa, porque os limites das linhas mescladas foram contados incorretamente.
Cada um desses sintomas aponta para uma causa raiz diferente. A boa notícia: uma vez que você sabe qual padrão está em jogo, a correção é simples.
O Panorama Geral: Por Que Células Mescladas Quebram a Extração
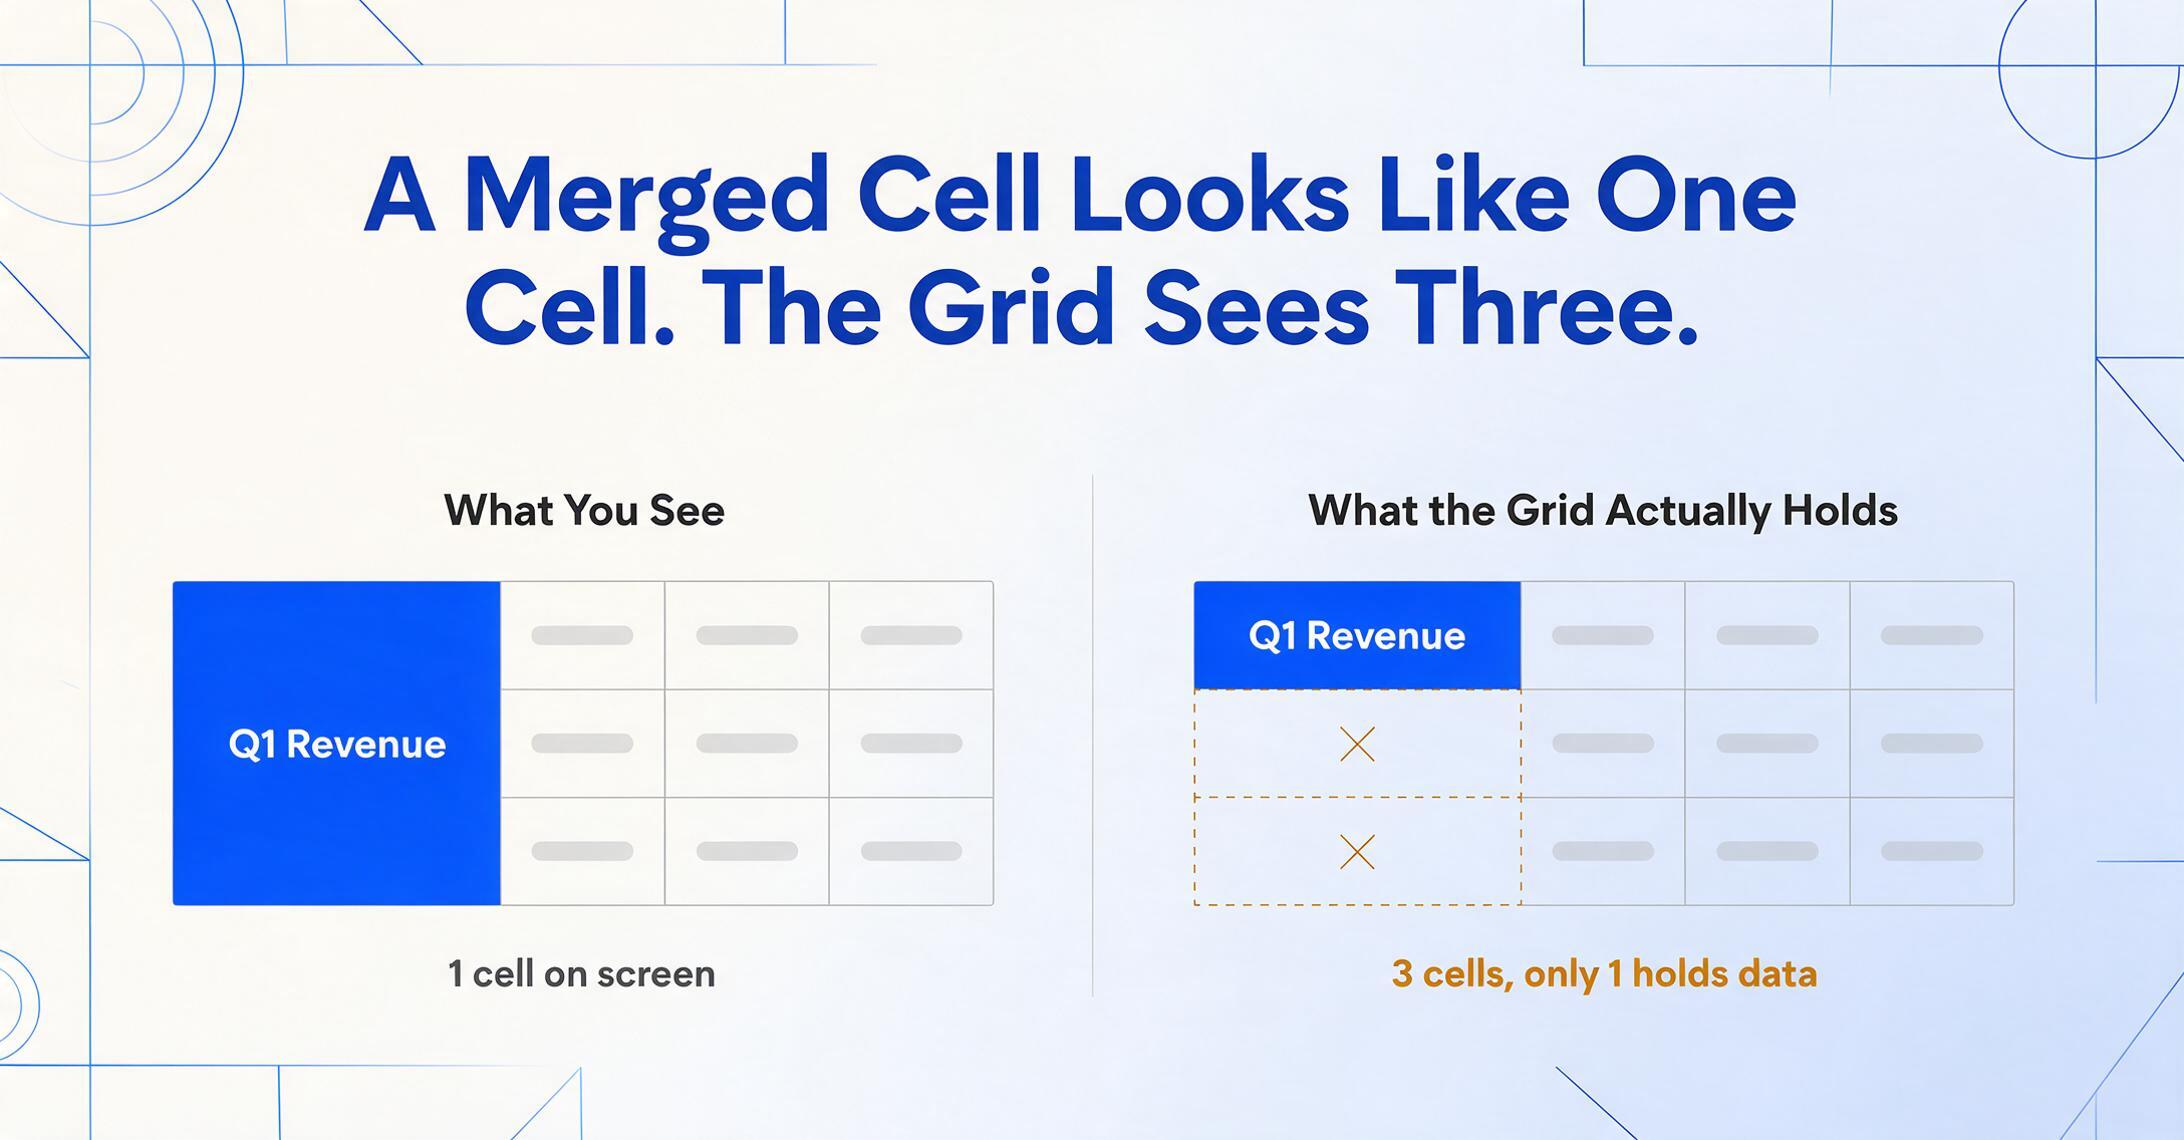
Uma tabela é uma grade — linhas e colunas formando células, cada uma com um valor. Uma célula mesclada combina células adjacentes em uma única unidade visual. Parece uma célula grande na tela, mas a estrutura subjacente ainda as trata como células separadas — apenas uma delas contém dados de fato.
Essa lacuna entre aparência visual e realidade estrutural é onde as ferramentas de extração tropeçam. Seja usando OCR tradicional ou um modelo de IA de visão, o mecanismo de extração precisa decidir: "Como mapear esse intervalo visual de volta para uma grade limpa?" É nessa decisão que as coisas dão errado.
Células mescladas forçam as ferramentas de extração a adivinhar. Ambas as abordagens falham quando a suposição está errada — e com células mescladas, isso acontece com frequência.
Causa Raiz 1: OCR Linha por Linha Não Lida com Estrutura 2D
Sintomas
O texto está todo lá, mas o mapeamento linha-coluna está quebrado. Uma linha que deveria ser "Peça A | $12.50 | 3 | $37.50" sai como "Peça A | $12.50 | " com os valores restantes empurrados para a próxima linha. Células mescladas que abrangem várias linhas produzem linhas em branco na saída.
Causa Raiz: Fratura de Coordenadas
Os mecanismos de OCR tradicionais processam documentos sequencialmente — linhas de cima para baixo, palavras da esquerda para a direita. Isso funciona para parágrafos. Para tabelas, ele trata cada bloco de texto como uma linha independente, sem entender o alinhamento vertical que define uma coluna.
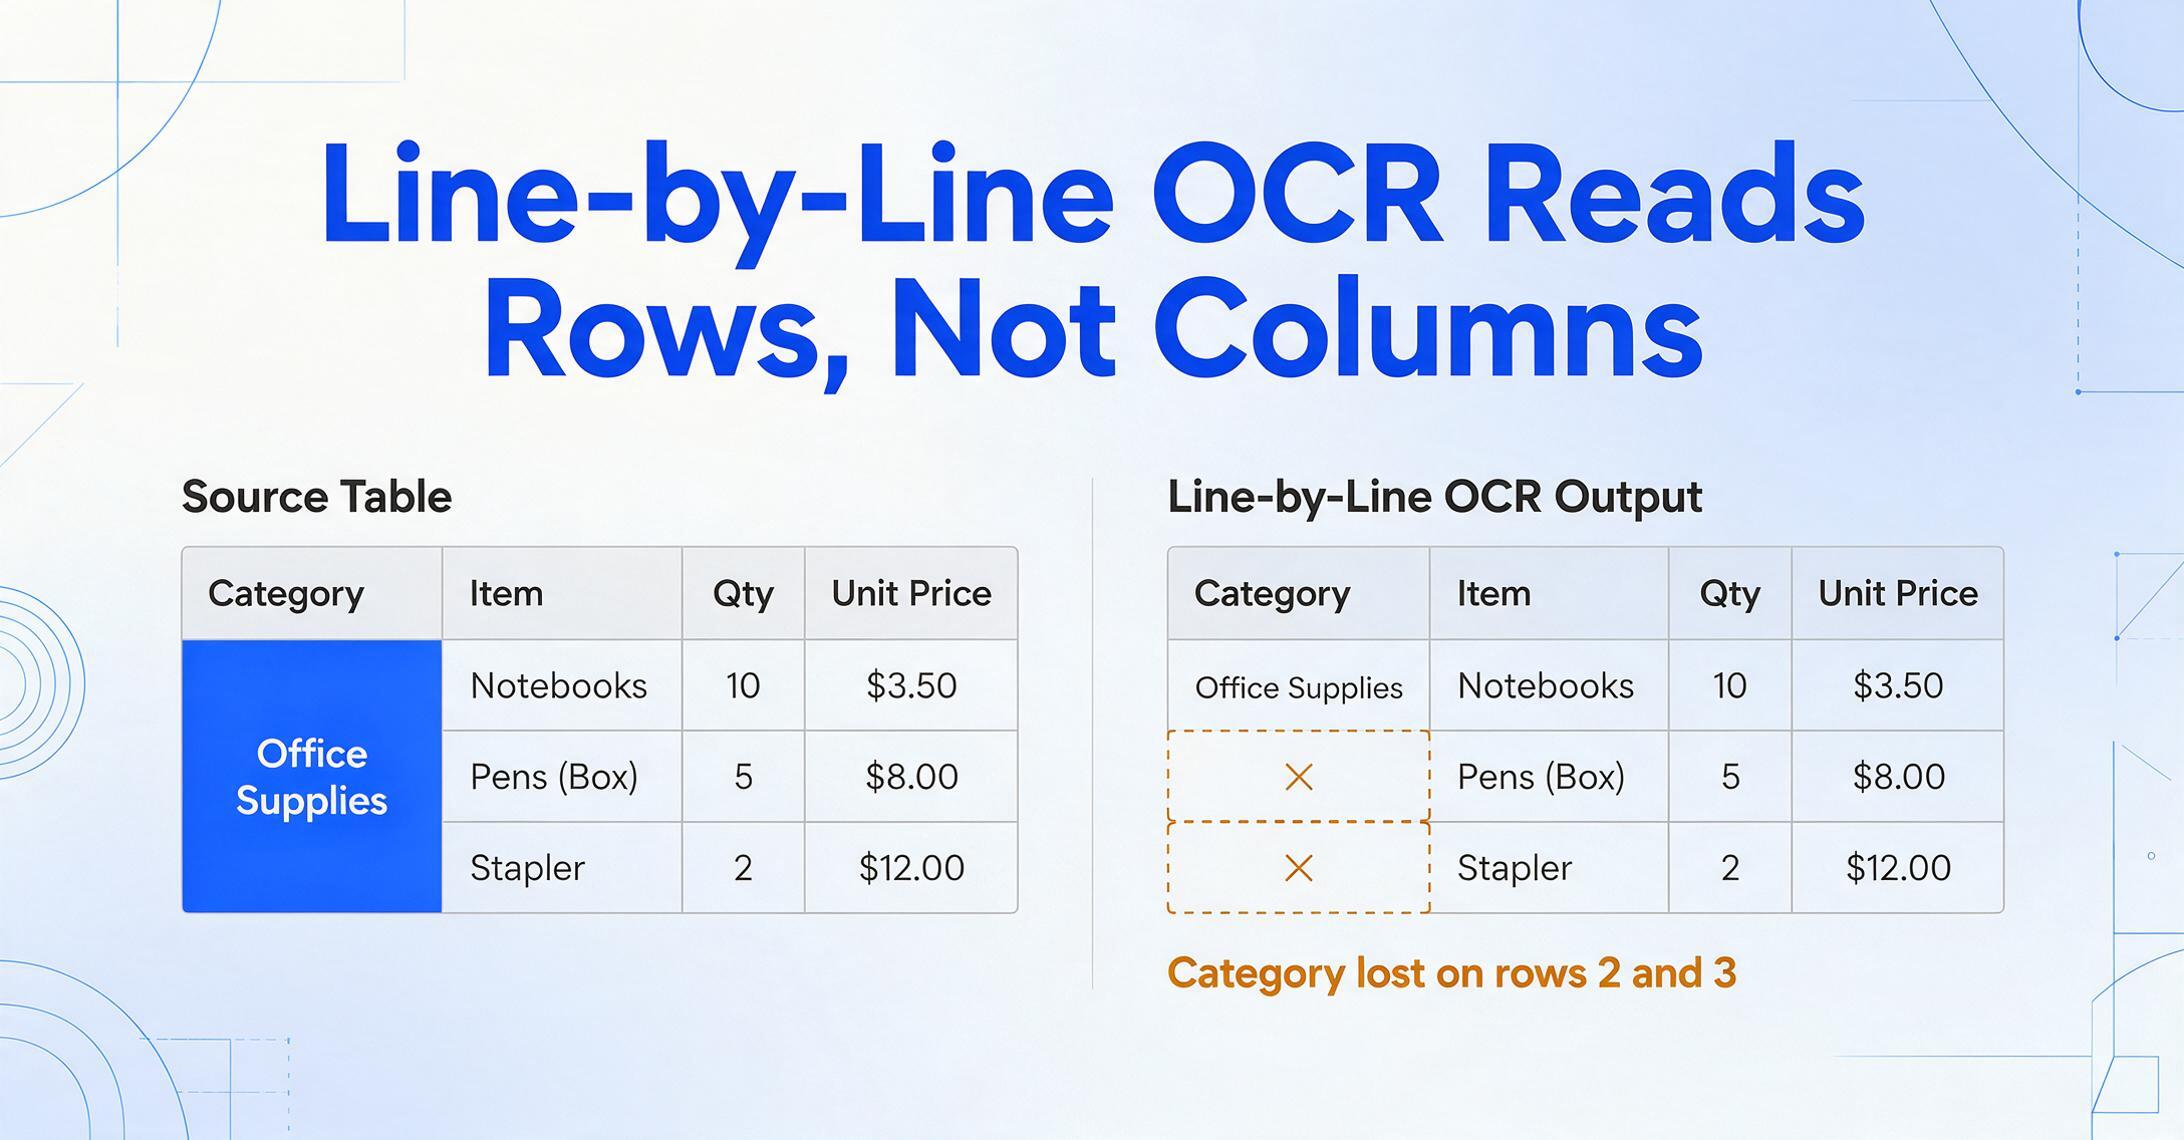
Aqui está um exemplo concreto. Imagine um pedido de compra com uma célula mesclada "Material de Escritório" que abrange três linhas:
| Categoria | Item | Qtd | Preço Unitário |
|---|---|---|---|
| Material de Escritório | Cadernos | 10 | $3.50 |
| Canetas (Caixa) | 5 | $8.00 | |
| Grampeador | 2 | $12.00 |
Um mecanismo de OCR baseado em linhas lê isso assim:
Linha 1: "Material de Escritório" | "Cadernos" | "10" | "$3.50"
Linha 2: "Canetas (Caixa)" | "5" | "$8.00"
Linha 3: "Grampeador" | "2" | "$12.00"
Perceba o que aconteceu: "Material de Escritório" foi lido na linha 1 junto com os dados reais daquela linha, porque o OCR o encontrou na mesma posição vertical. Nas linhas 2 e 3, o mecanismo de OCR não sabe que "Material de Escritório" ainda se aplica àquelas linhas — o texto fisicamente não está lá. O resultado é uma extração onde a coluna Categoria fica vazia nas linhas 2 e 3, quebrando qualquer análise posterior que agrupe por categoria.
A Solução
Pré-processamento: detectar os limites das células mescladas antes da extração. Algumas ferramentas (incluindo ImageToTable.ai) analizam primeiro o layout do documento — identificando a grade da tabela, incluindo os intervalos mesclados — antes de ler qualquer texto. Ao comprender a estrutura 2D completa de antemano, o motor de extração sabe que "Office Supplies" ocupa das filas 1 a 3 e pode propagar esse valor em todas as três filas na saída. Se sua ferramenta atual não faz isso, procure uma que realize análise de layout como uma fase separada antes do OCR ou da extração de texto — esta é a maior melhora em comparação com a extração baseada em linhas.
Causa Raiz 2: Ambigüidade de Intervalo — A Célula Que Pertenece a Todo Lugar
Sintomas
Um cabeçalho de columna mesclado faz que os dados apareçam sob o cabeçalho incorreto. Por exemplo, uma tabela com cabeçalhos "Product Details | Q1 | Q2 | Q3 | Q4" onde "Product Details" abarca duas sub-colunas ("Item" e "SKU") — a saída extraída colapsa as duas sub-colunas em uma, ou duplica valores entre elas.
Causa Raiz: Ambigüidade de Intervalo
Quando uma célula mesclada abarca múltiplas colunas, a ferramenta de extração precisa responder: "Esta célula pertence à columna 1, à columna 2, ou a todas elas?" A resposta parece óbvia para um olho humano, mas para um algoritmo, é ambigua.
Isso é especialmente complicado para modelos de IA de visão que usan análise baseada em patches. Estes modelos dividem a imagem em pequenos tiles e analizam cada um de forma independente. Uma célula mesclada que abarca cinco colunas se fragmenta em múltiples tiles. Cada tile ve só uma parte da célula mesclada, e o modelo tem que reconstruir a partir delas — uma tarefa que introduce erros em cada costura. Uma análise da Medium sobre falhas práticas na reconstrução de tabelas documentou este problema exato: os modelos de visão que dividem imagens em patches "têm um desempeño pobre para objetos que dependen da continuidade global — sendo as tabelas um deles."
A Solução
Projete sua extração com a estrutura esperada. Se você sabe que seu documento de origem tem um cabeçalho como "Detalhes do Produto (Item | SKU)", defina os nomes das suas colunas de acordo — "Item" e "SKU" — em vez de depender da ferramenta para adivinhar a hierarquia. Ferramentas como ImageToTable.ai que usam Extração de Colunas Personalizadas permitem que você especifique exatamente as colunas desejadas. A IA então combina cada coluna com a subcoluna correta no documento, entendendo o significado de cada campo, em vez de adivinhar limites de extensão. Isso contorna o problema de ambiguidade completamente: em vez de perguntar à ferramenta "qual é a largura desta célula mesclada?", você diz "estas são as colunas que preciso — encontre-as no documento."
Causa Raiz 3: Alturas de Linha Irregulares Quebram o Ritmo
Sintomas
A tabela extraída tem linhas demais ou de menos. Uma linha de subtotal de seção que abrange toda a largura da tabela é contada como uma nova linha (expandindo a grade) ou completamente ignorada (colapsando-a). A contagem total de linhas da tabela extraída não corresponde à origem.
Causa Raiz: Variação na Altura das Linhas
A maioria dos algoritmos de extração de tabelas depende da detecção de linhas horizontais ou lacunas de espaços em branco para identificar limites de linhas. Uma célula mesclada que abrange várias linhas altera o padrão visual de altura — seja mais alto (conteúdo mesclado precisa de mais espaço) ou mais baixo (área mesclada vazia). De qualquer forma, a heurística do algoritmo para limites de linhas fica confusa.
Isso é especialmente comum com padrões em escada, onde células mescladas criam um limite diagonal. O algoritmo vê alturas inconsistentes e não consegue determinar se deve tratar o bloco inteiro como uma linha grande ou dividi-lo.
A Solução
Pós-processamento: verifique a contagem de linhas em relação à estrutura esperada. Após a extração, faça uma verificação rápida de sanidade: o número de linhas de dados corresponde ao que você espera? Se você sabe que cada fatura tem uma seção de itens com 3 a 12 linhas, sinalize qualquer saída fora desse intervalo. No Excel, você pode usar uma verificação simples de COUNTA ou uma tabela dinâmica para verificar contagens de linhas entre lotes. Ferramentas mais avançadas oferecem validação integrada que compara automaticamente a estrutura extraída com as contagens esperadas de linhas e colunas e destaca discrepâncias para revisão manual.
Causa Raiz 4: Sem Validação Pós-Processamento
Sintomas
A extração parece ter sucesso — sem erros, sem timeouts — mas quando você usa os dados, descobre que os valores estão nas linhas ou colunas erradas. O erro é silencioso, o que o torna mais perigoso do que uma extração falha.
Causa Raiz: Colapso Pós-Processamento
Muitas ferramentas de extração têm uma etapa final de montagem onde blocos de texto detectados são mapeados de volta para uma grade. Se células mescladas causaram problemas a montante (fratura de coordenadas, ambiguidade de extensão ou confusão de altura de linha), a etapa de pós-processamento frequentemente tenta disfarçá-los colapsando ou preenchendo células para caber em uma grade retangular. É aqui que ocorre a corrupção silenciosa de dados: a ferramenta preenche células vazias com valores vizinhos, desloca colunas inteiras para a esquerda ou direita, ou descarta linhas que não se encaixam no formato de grade que ela decidiu.
O mecanismo específico: o pós-processador tem um formato de grade alvo (ex.: 4 colunas × 15 linhas) inferido a partir da contagem de células detectadas. Quando uma célula mesclada cria uma anomalia — digamos, 63 células detectadas para o que deveria ser uma grade de 4×16=64 — o mecanismo precisa lidar com a lacuna. Algumas ferramentas preenchem com espaços em branco (criando o sintoma de "célula vazia"). Outras comprimem: redistribuem as 63 células em 64 espaços, empurrando um valor de dados para a coluna errada.
A Solução
Imponha validação pós-extração. Seja manual ou automatizada, cada lote de extrações de documentos com células mescladas deve incluir uma etapa de verificação cruzada. A abordagem mais prática: exporte sua tabela extraída, desmescle as células mescladas restantes no Excel ou Google Sheets usando o recurso integrado "Desmesclar Células" e use "Preencher Abaixo" para propagar valores nas células recém-vazias. Isso fornece uma grade retangular limpa que você pode validar contra sua fonte original.
Três Correções Que Realmente Funcionam
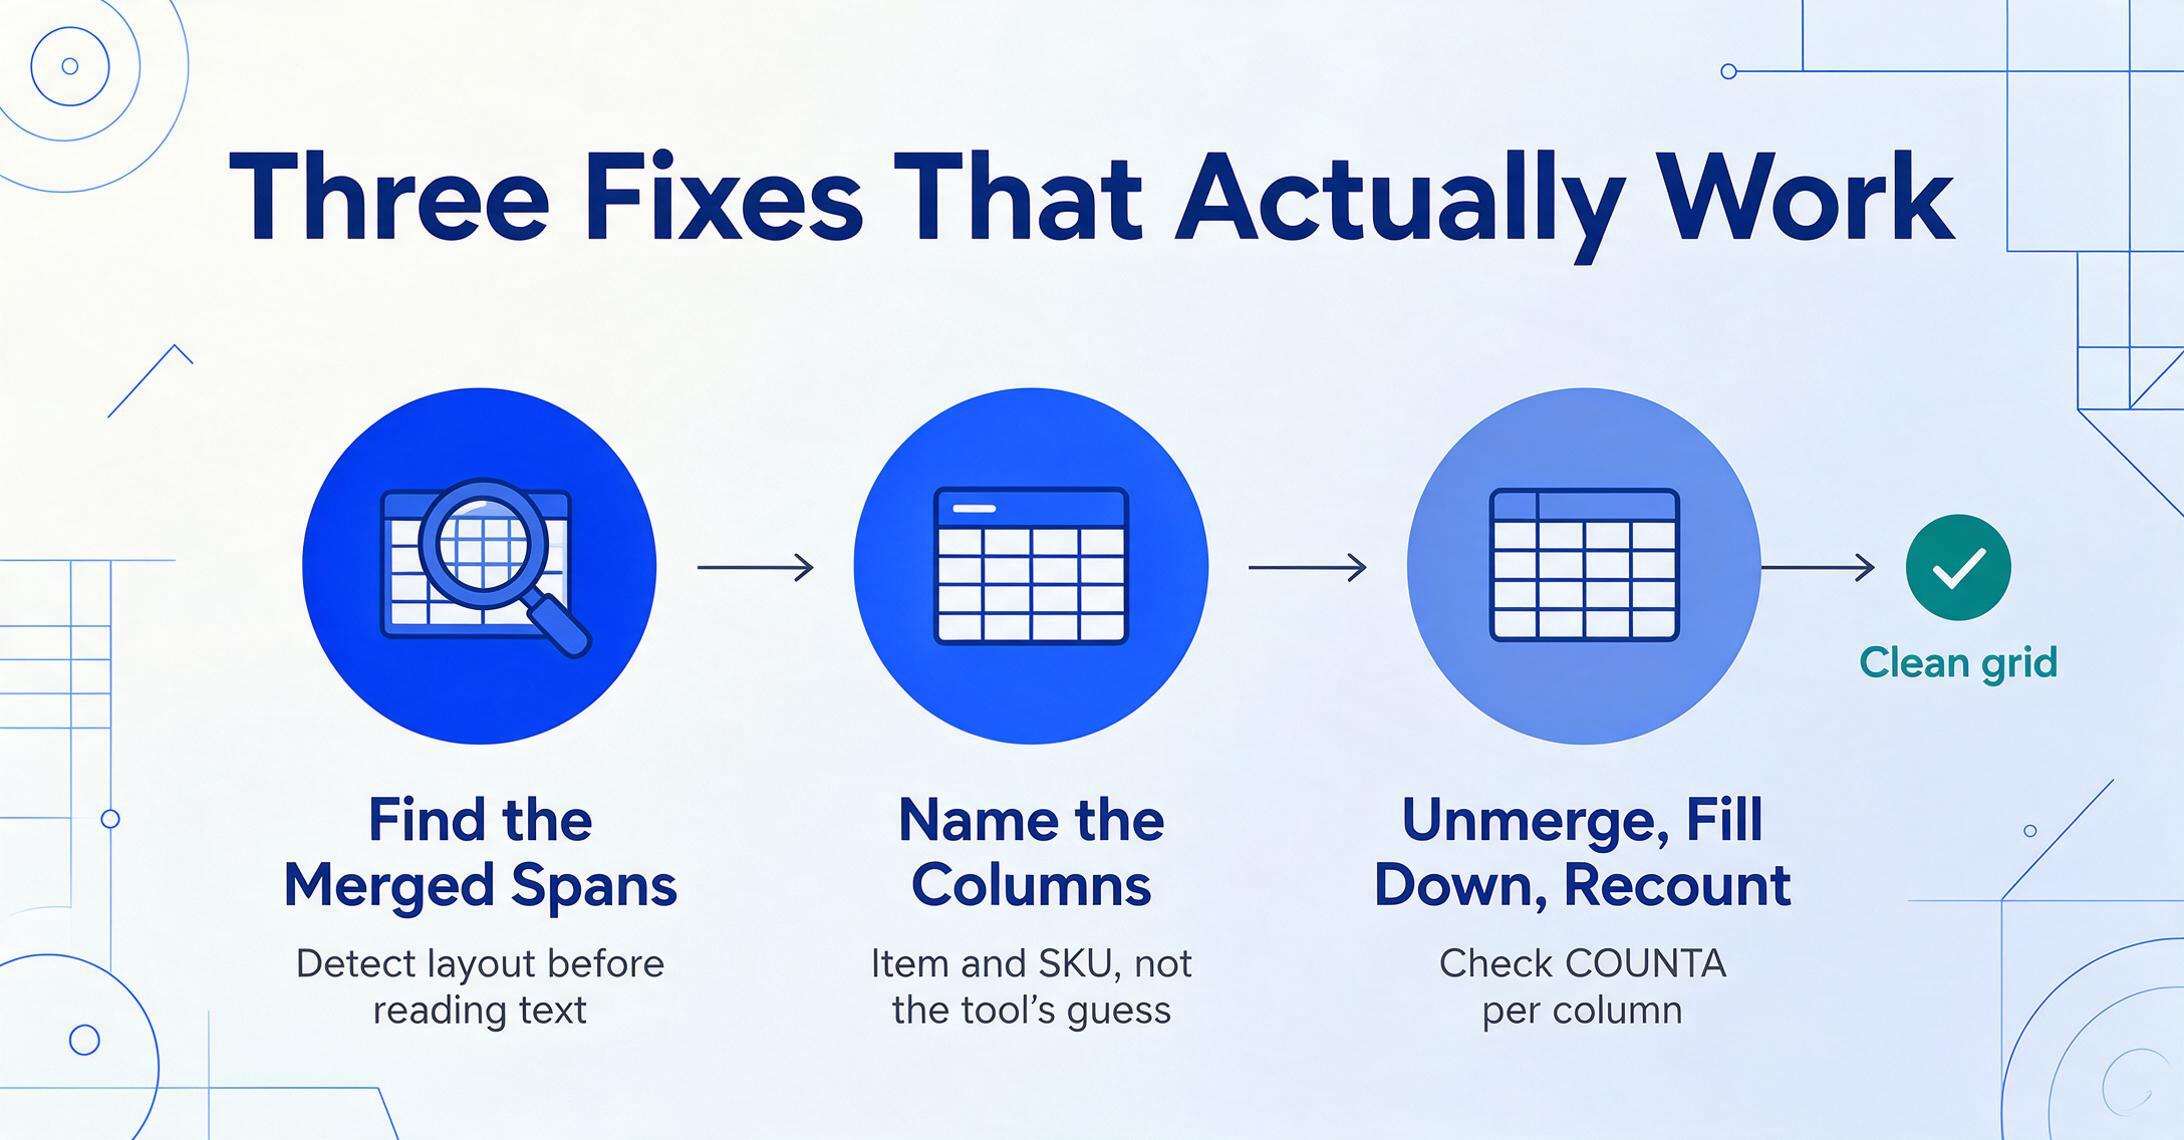
Com base nas quatro causas raiz acima, aqui está o caminho prático de correção — do mais simples ao mais completo.
Se sua ferramenta suportar, ative a análise de layout ou a detecção de estrutura de tabela como etapa de pré-processamento. Isso instrui o mecanismo de extração a identificar a grade completa — incluindo intervalos mesclados — antes de ler o texto. Para ferramentas que não oferecem isso, considere dividir o documento antecipadamente. Para PDFs, ferramentas como o "Preparar Formulário" do Adobe Acrobat podem ajudar a definir limites manualmente. Para imagens, procure uma ferramenta que realize a detecção de tabela como uma primeira etapa discreta.
Não dependa da ferramenta para adivinhar suas colunas. Especifique-as explicitamente. Com a Extração de Colunas Personalizadas do ImageToTable.ai, você define os nomes das colunas desejadas — e a IA associa cada uma aos dados corretos no documento por compreensão semântica, não por posição. Isso significa que, mesmo que um cabeçalho mesclado confunda a detecção de layout, o mapeamento das colunas continua correto porque a IA sabe o que "SKU" significa, não apenas onde está localizado.
Após a extração, execute uma validação simples no Excel ou Google Sheets: desmescle quaisquer células que permaneçam mescladas, use Preencher Abaixo para propagar valores e verifique se a contagem de linhas corresponde ao documento de origem. Para processamento em lote, configure uma fórmula COUNTA por coluna para sinalizar qualquer coluna com menos entradas do que o esperado. Se você processar o mesmo tipo de documento regularmente, salve essa validação como modelo — leva 30 segundos para executar e detecta quase toda corrupção silenciosa.
Quando Escalar: Nem Todas as Células Mescladas Podem Ser Corrigidas Automaticamente
Alguns padrões de células mescladas são genuinamente difíceis — até para IA avançada. Veja quando você deve considerar pré-processar o documento de origem manualmente em vez de tentar corrigir a extração:
- Mesclagens aninhadas (rowspan + colspan na mesma célula): Uma célula que abrange 3 linhas E 2 colunas cria um buraco na grade que nenhuma ferramenta preenche perfeitamente. Pré-dividir o documento em tabelas mais simples antes da extração geralmente produz melhores resultados.
- Padrões de mesclagem em escada: Limites diagonais onde a linha 1 mescla colunas A-B, a linha 2 mescla B-C, a linha 3 mescla C-D — essa estrutura em cascata quebra quase todos os mecanismos de extração. A correção mais eficiente geralmente é exportar o documento como uma tabela plana do aplicativo de origem antes da extração.
- Tabelas de várias páginas com células mescladas cruzando quebras de página: Até as melhores ferramentas têm dificuldade aqui. Considere processar cada página de forma independente e unir os resultados manualmente.
A resposta honesta: se seu documento tem mesclagens aninhadas ou em escada complexas e você processa mais de 50 desses documentos por mês, vale calcular o ROI de mudar de ferramenta (para algo que lide com esses padrões nativamente). Para documentos ocasionais, o pré-processamento manual antes da extração é mais barato do que lutar com resultados ruins.
Perguntas Frequentes
A extração com IA lida com células mescladas melhor do que o OCR tradicional?
Sim — mas não perfeitamente. Os modelos de IA de visão analisam o documento como um layout inteiro, em vez de linha por linha, então identificam limites de células mescladas com mais precisão do que o OCR baseado em linhas. No entanto, a ambiguidade de extensão continua sendo um desafio para modelos de IA, porque a análise baseada em blocos pode fragmentar células mescladas entre blocos. Ferramentas como ImageToTable.ai, que combinam análise de layout com correspondência semântica de campos, lidam com células mescladas significativamente melhor do que o OCR tradicional, mas não são 100% imunes, especialmente com padrões aninhados ou em escada.
Posso corrigir erros de extração de células mescladas no Excel sem reprocessar?
Sim, para a maioria dos padrões de mesclagem de linhas. Selecione a coluna, vá em Página Inicial → Mesclar e Centralizar → Desfazer Mesclagem de Células, depois selecione as células em branco e pressione Ctrl+D (Preencher Abaixo) para propagar o valor. Para padrões de mesclagem de colunas, use Texto para Colunas ou Preenchimento Relâmpago. Isso funciona como uma solução temporária, mas para processamento em lote, corrija a extração na origem.
Células mescladas em PDFs são o mesmo problema que células mescladas no Excel?
Estruturalmente, sim. Mas PDFs são mais difíceis de corrigir porque você não pode simplesmente "desfazer a mesclagem". Uma célula mesclada em PDF está incorporada ao layout da página, então a correção deve acontecer no momento da extração, não na origem.
E se meu documento de origem tiver bordas que parecem células mescladas, mas não são?
Isso é comum. Bordas fracas ou quebradas podem fazer células separadas parecerem mescladas, especialmente em digitalizações. Tente pré-processar a imagem para melhorar o contraste — isso pode tornar bordas fracas detectáveis. Veja nosso guia sobre pré-processamento de imagem para melhor detecção para técnicas específicas.
Minha ferramenta diz "extração de tabela concluída", mas os dados estão errados — o que aconteceu?
Esta é a Causa Raiz 4. O pós-processador montou o texto detectado em uma grade, mas células mescladas causaram erros a montante que não foram sinalizados. "Sucesso" significava que uma grade retangular foi produzida — não que a grade estava correta. Sempre valide a saída de amostra. Para saber mais sobre como criar um fluxo de validação, leia nosso guia abrangente de solução de problemas para extração de tabelas.
Células mescladas são a fonte mais comum de erros de extração — mas uma vez que você entende qual padrão está causando o problema, a correção geralmente é simples.
Teste seu próprio documento com uma ferramenta que faz análise de layout primeiro. Muitos problemas com células mescladas desaparecem quando o mecanismo de extração vê a grade completa antes de ler uma única palavra.