A IA consegue ler pedidos de venda?
Sim — em qualquer formato de cliente
Sim. A IA moderna consegue extrair campos de cabeçalho e itens de linha de pedidos de venda — incluindo referências de PO do cliente, códigos de item, quantidades, preços unitários, descontos, impostos, endereços de entrega e datas de entrega — em qualquer número de formatos de clientes, sem configuração de modelo por cliente. A distinção principal está na perspectiva: o documento que você recebe de um cliente é tecnicamente o pedido de compra dele, mas para você ele se torna os dados de origem para criar seu pedido de venda. A IA o lê como você lê — como uma solicitação de bens ou serviços — e extrai os campos de que você precisa, independentemente de o cliente rotulá-los como "PO No.", "Order Ref." ou "Customer #". Em pedidos em PDF impressos ou digitais limpos, a precisão em nível de campo chega a 95-99%, com os resultados mais confiáveis em pedidos de compra padrão gerados por ERP.
Principais conclusões
- Uma ferramenta de OCR baseada em modelo funciona perfeitamente no PO de um cliente — até que ele atualize o ERP e mova o bloco Ship To para uma nova posição, quebrando o modelo silenciosamente e retornando zero dados de um lote de 30 pedidos que você só descobre estar vazio depois que ele é processado.
- O custo oculto da extração baseada em modelo não é a configuração — é a manutenção que se acumula com cada cliente: cada mudança de formato quebra silenciosamente um modelo diferente, e a quebra aparece em produção quando você processa um lote com prazo apertado, não durante uma verificação agendada.
- A extração semântica elimina os modelos por completo — ela lê Ship To pelo significado, e não pelas coordenadas, então a mesma definição de coluna lida com 50 formatos de clientes ao mesmo tempo e qualquer mudança de layout de um único cliente tem impacto zero na qualidade da extração.
Um Exemplo Real de Ordem de Venda — O Que a IA Lê, Campo por Campo
Vamos analisar um pedido de compra típico de cliente que chega na sua caixa de entrada — um anexo PDF de um varejista solicitando 50 unidades de um item com 3 variantes de cor, um armazém de destino na Costa Oeste e uma data de entrega solicitada para três semanas à frente. Este não é um caso isolado. É a realidade diária do processamento de pedidos para milhares de vendedores B2B. Aqui está exatamente o que a IA lê e onde encontra cada campo.
Bloco de cabeçalho. A IA começa identificando as regiões estruturais do documento, assim como você faz ao abrir um PDF. Na seção superior — o cabeçalho — ela lê o nome e o endereço da empresa do cliente (bill-to), o número do pedido de compra (geralmente rotulado como "PO No.", "PO #", "Customer Ref." ou "Order No."), a data de emissão do PO e a data de entrega solicitada ou data "Ship by". Cada um desses campos é localizado pelo seu significado semântico dentro da região do cabeçalho, não pela correspondência de um rótulo a uma coordenada fixa na página. Um rótulo que diz "Req. Ship Date" é reconhecido como a data de entrega. Um rótulo que diz "Date" ao lado do número do PO no cabeçalho é reconhecido como a data de emissão. Esta é a mesma desambiguação que uma pessoa faz sem pensar — exceto que a IA faz isso em todos os documentos, sempre, sem se cansar.
Endereços Ship-to vs. Bill-to. A maioria dos pedidos de compra de clientes inclui dois blocos de endereço: para onde as mercadorias devem ir (ship-to) e para onde a fatura deve ser enviada (bill-to). A IA os distingue lendo o rótulo acima de cada bloco e compreendendo a relação entre o endereço e o conteúdo ao redor. O bloco de endereço rotulado como "Ship To", "Deliver To" ou "Delivery Location" é capturado como o destino de envio — este é o endereço que determina custos de frete, prazos de entrega e roteamento de fulfillment. O bloco de endereço rotulado como "Bill To" ou adjacente às informações de "Remit To" é capturado separadamente. Em pedidos em que ambos os blocos não têm rótulos explícitos — apenas dois endereços impressos lado a lado — a IA recorre a heurísticas posicionais: o endereço mais próximo do topo do documento, alinhado com o cabeçalho do cliente, é o bill-to, enquanto o endereço em uma seção inferior separada ou alinhado com as instruções de entrega é o ship-to.
Itens de linha. A IA identifica a tabela de itens de linha pela sua estrutura — uma grade de várias colunas no corpo do documento com cabeçalhos de coluna como "Item No.", "Description", "Qty", "Unit Price" e "Total". Cada linha dessa tabela é lida como um item de linha. O código do item (SKU ou part number), a descrição do item, a quantidade pedida, o preço unitário e o total da linha são todos extraídos por linha, independentemente da ordem das colunas ou da variação de nomenclatura entre clientes. A tabela de um cliente tem colunas na ordem "Qty | Item Code | Description | Unit Price | Total" e usa "EAN" em vez de "Item Code". A tabela de outro cliente traz "Part # | Description | Price Each | Quantity". A IA lê os cabeçalhos das colunas semanticamente — ela entende que "Price Each" e "Unit Price" significam a mesma coisa — e mapeia cada valor para a coluna de saída correta.
Totais, descontos e impostos. Na parte inferior da tabela de itens ou em uma seção separada de totais, a IA lê o subtotal (soma de todos os totais de linha antes dos ajustes), qualquer desconto aplicado (percentual ou valor fixo), a alíquota e o valor do imposto (que varia conforme a jurisdição — VAT, GST, sales tax ou HST), as despesas de frete e manuseio, e o total geral. Cada um desses valores é desambiguado por sua posição no bloco de totais e por sua relação semântica com os itens de linha acima. O valor imediatamente abaixo do último item de linha é o subtotal. O valor após uma linha rotulada "Discount 2% Net 30" é um desconto. O valor após "Tax" ou "VAT" ou "GST" é o valor do imposto. O valor na parte inferior da coluna, geralmente em negrito ou fonte maior, é o total geral.
Este passo a passo cobre um único pedido de um único cliente. Agora imagine repetir isso para 15 clientes, cada um com um layout diferente. A IA processa todos os 15 no mesmo lote, com as mesmas definições de coluna, e gera uma única planilha consolidada. Para uma explicação mais detalhada do mecanismo subjacente, leia nosso guia sobre os fundamentos da extração de dados de PO — a estrutura do documento é a mesma, mas as necessidades de extração do vendedor adicionam a camada de mapeamento dos formatos dos clientes para os campos internos de SO.
Por Que Isso Funciona — A Extração Semântica Substitui a Configuração Modelo por Modelo
A razão pela qual a IA consegue ler uma dúzia de pedidos de clientes diferentes em uma única passagem não é que ela tenha um modelo para cada formato. Ela não tem nenhum modelo. O mecanismo é chamado Extração de Colunas Personalizadas, e funciona invertendo a lógica tradicional de extração.
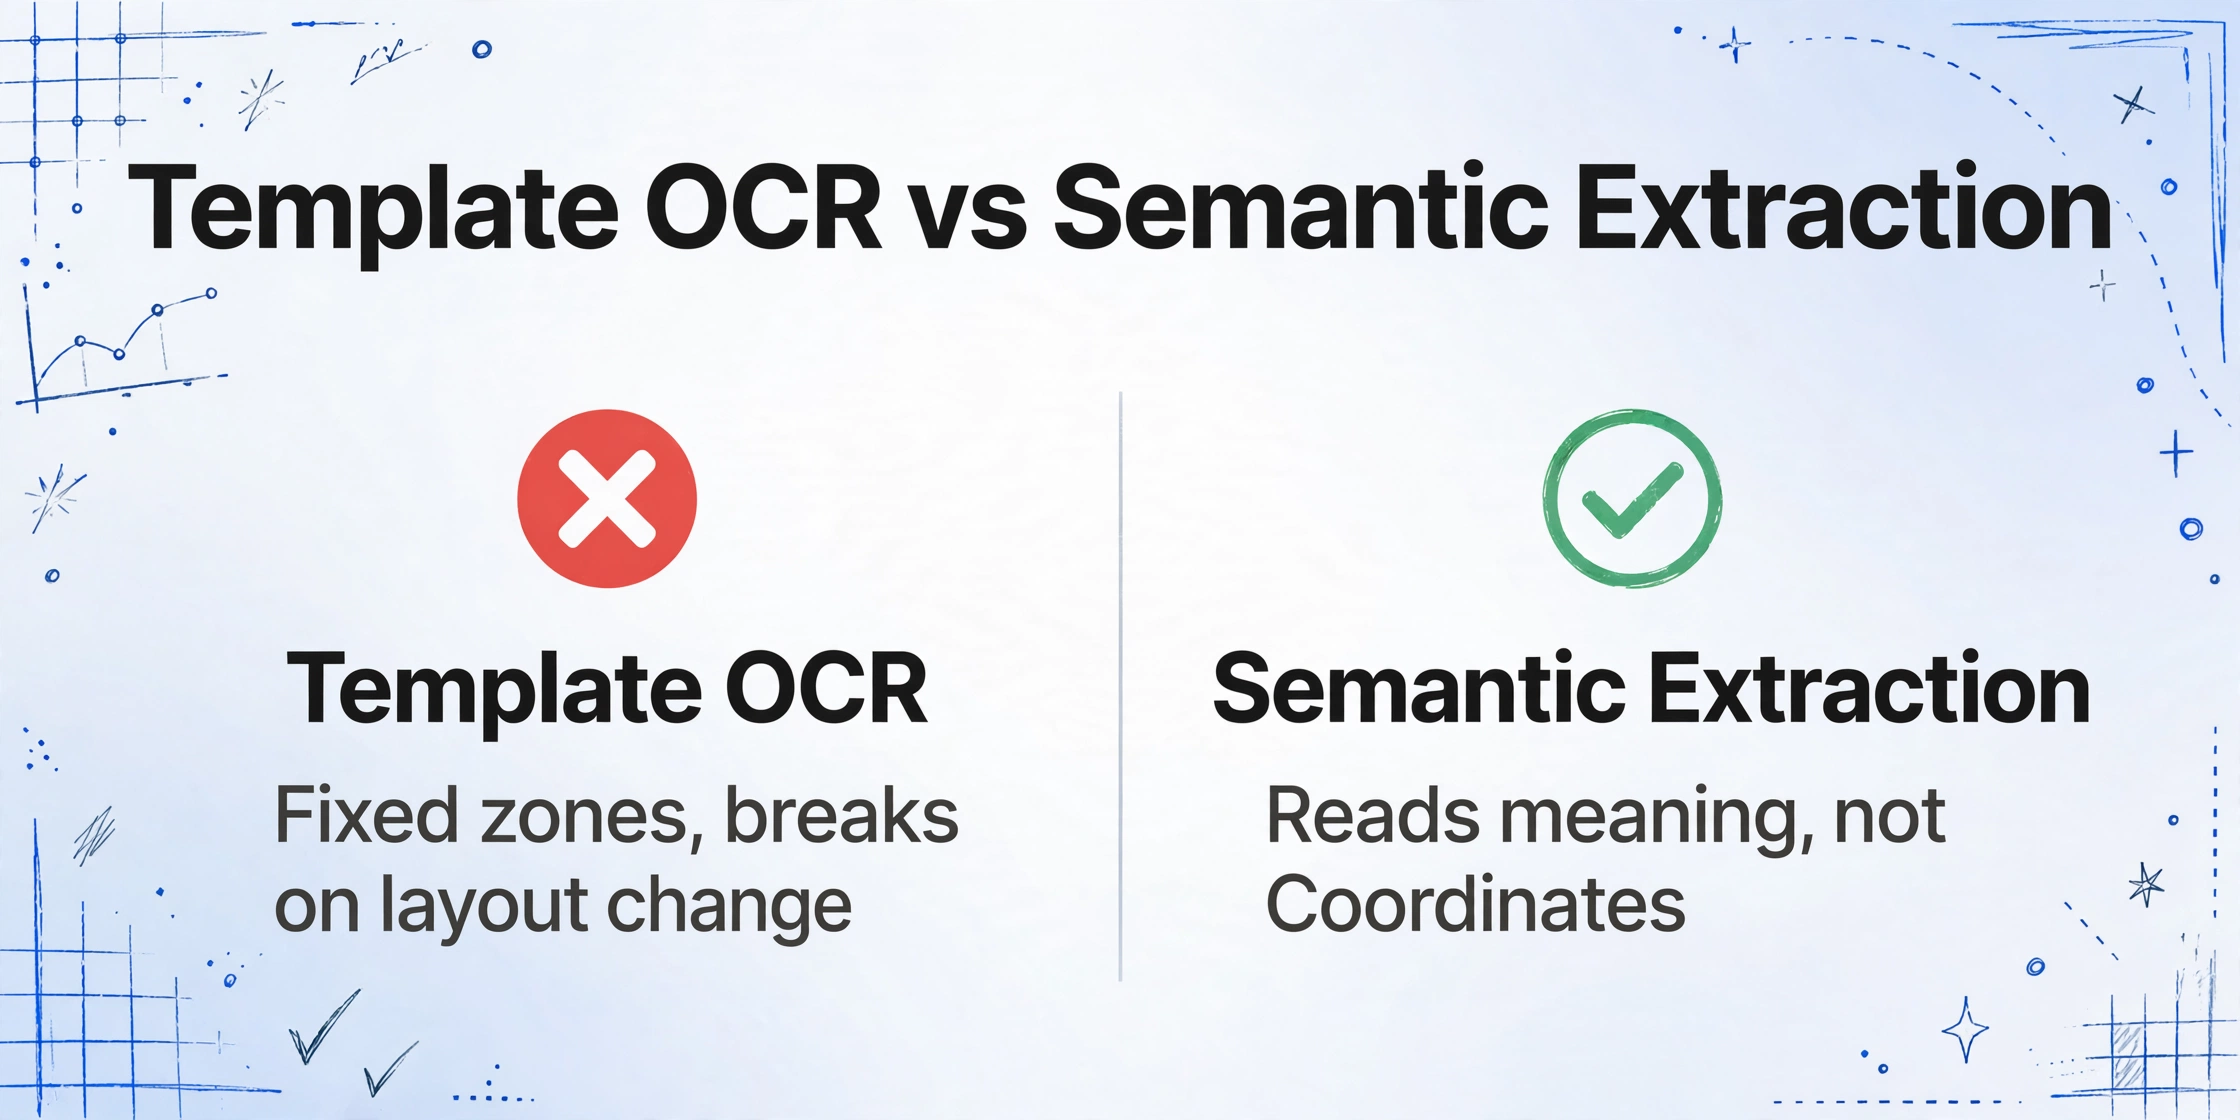
Ferramentas tradicionais de OCR baseadas em modelo exigem que você defina zonas fixas em um documento de amostra para cada campo — "o preço unitário está nas coordenadas (200, 450) a (300, 470)". Quando um segundo cliente envia um pedido com o preço unitário em uma posição diferente, a zona não corresponde mais e a extração quebra. Você cria um segundo modelo. Depois um terceiro. Toda vez que um cliente atualiza o layout do formulário — o que acontece com mais frequência do que a maioria das equipes acompanha — seu modelo quebra e você precisa mantê-lo. Este é o custo oculto da extração baseada em modelo: não o tempo de configuração por cliente, mas o tempo de manutenção em todos os clientes ao longo de meses e anos.
A extração semântica elimina completamente a camada de modelo. Em vez de perguntar "onde está este campo?", ela pergunta "o que é este campo?" — e a resposta não depende do layout do documento.
Veja como funciona na prática. Você define suas colunas de saída uma vez — "Customer PO Number", "Item Code", "Quantity Ordered", "Unit Price", "Line Total", "Ship To Address", "Requested Ship Date" — e as salva como um modelo (este é seu modelo de coluna pessoal, não um modelo de documento por cliente). Quando você carrega o pedido de compra de um cliente, a IA lê o documento como um todo, identifica cada campo pelo seu significado semântico dentro do layout do documento e o mapeia para o nome de coluna correspondente que você definiu.
É por isso que a mesma definição de coluna funciona quer um cliente rotule o campo como "Unit Price", "Price Each", "单价" (chinês) ou "Precio Unitario" (espanhol) — a IA entende o que cada frase significa, não quais caracteres ela contém. E é por isso que uma mudança de layout de um cliente (mover o bloco "Ship To" do canto superior direito para o canto inferior esquerdo entre revisões de formato) não quebra a extração: a IA procura o significado de "Ship To", não suas coordenadas em pixels.
Para pedidos em que o total da linha não está impresso — aparecem apenas Quantity e Unit Price — você pode usar uma coluna calculada. Nomeie sua coluna como "Line Total (Qty × Unit Price)" e a IA realiza a multiplicação durante a extração, adicionando o valor calculado à sua saída sem qualquer pós-processamento no Excel. Esta é uma das várias melhorias de extração que deixam a saída pronta para seu ERP ou sistema de gestão de pedidos sem limpeza manual. Para um passo a passo completo do fluxo de extração de pedidos de venda de ponta a ponta, consulte nosso guia de pedido de venda para Excel.
Onde Ainda Pode Falhar — Limitações Honestas
Nenhuma ferramenta de extração é perfeita em todos os documentos. Os cenários a seguir exigem atenção extra, e conhecê-los antecipadamente economiza mais tempo do que descobri-los em produção.
Tabelas complexas de preços escalonados e descontos. Se o pedido de compra de um cliente inclui uma tabela de preços por faixa de quantidade — "$10/unit for 1-50 units, $8.50/unit for 51-200 units" — exibida como uma tabela separada ao lado dos itens de linha, a IA pode atribuir a faixa de preço errada a um item de linha se os limites das faixas forem implícitos (não repetidos em cada linha) ou se a tabela de preços e a tabela de itens de linha não estiverem visualmente conectadas. A IA lê cada tabela de forma independente, mas mapear a quantidade pedida de um item de linha para a linha correta em uma tabela de preços separada exige um raciocínio de várias etapas que é mais confiável em uma revisão humana do que em uma única passagem de extração. Recomendação: para pedidos com faixas de desconto ou preços separados, faça uma verificação pontual dos preços unitários nos primeiros pedidos desse cliente. Depois de confirmar que a IA mapeia os preços para a faixa correta, você pode confiar nos pedidos subsequentes do mesmo cliente — mas verifique o primeiro lote.
Pedidos muito grandes (mais de 100 itens de linha) que abrangem várias páginas. A IA lida com documentos de várias páginas nativamente — ela lê a tabela de itens de linha através das quebras de página e continua contando as linhas. Mas quando um único pedido tem 150 itens de linha distribuídos em 6 páginas, a probabilidade de um artefato de quebra de página (uma linha dividida entre páginas onde os cabeçalhos das colunas não são repetidos) aumenta. O modelo visual da IA normalmente consegue lidar com esses casos porque entende a estrutura da tabela, mas a taxa de erro por linha se acumula com o número total de linhas. Recomendação: para pedidos que excedem 100 itens de linha, percorra a saída extraída e verifique a contagem total de linhas em relação à contagem de linhas do pedido. A maioria das divergências ocorre nos limites de quebra de página e é fácil de identificar.
Cópias carbono e pedidos enviados por fax muito degradados. Se um cliente ainda envia pedidos por fax ou formulários de cópia carbono, a qualidade do texto pode ficar abaixo do que a IA consegue ler de forma confiável. Caracteres apagados, números borrados e anotações manuscritas nas margens podem causar leituras incorretas — "1,000 units" vira "100 units" se o terceiro zero estiver ilegível. Recomendação: configure um fluxo de trabalho de sinalização de baixa confiança. A IA retorna uma pontuação de confiança para cada valor extraído; configure seu processo para revisar todos os valores abaixo de um limite de confiança. Isso captura os casos de documentos degradados sem exigir revisão humana de cada pedido limpo.
Números de PO do cliente que incluem caracteres especiais ou espaços. Alguns números de pedido de compra incluem hífens, barras ou espaços incorporados que fazem parte semanticamente do número (por exemplo, "PO-2026-0715"), mas podem ser fragmentados pelo layout do documento. A IA lê o texto em blocos visuais, então um número de PO quebrado em duas linhas pode ser reconstruído como dois tokens separados. Recomendação: após a extração, verifique a coluna "Customer PO Number" em busca de valores que pareçam truncados ou divididos. A IA normalmente lida bem com formatos padrão, mas layouts incomuns com números de PO fragmentados se beneficiam de uma rápida verificação visual da coluna de saída.
Essas limitações não são impeditivas — são considerações de design de processo. O mesmo vale para toda ferramenta de extração, e as honestas dizem onde você deve ficar atento. Para um framework mais amplo sobre como avaliar se a extração por IA é adequada para sua equipe, consulte nosso guia prático para melhorar a precisão da extração.
A diferença entre uma ferramenta de extração que dá conta dos seus pedidos de venda e uma que gera mais trabalho não está em se ela comete erros — toda ferramenta comete. A diferença está em se ela comete erros previsíveis em documentos que você pode testar, ou erros imprevisíveis em documentos que você não pode. A extração semântica em vez de modelos significa que a IA falha de forma consistente em condições específicas de documento (preços escalonados, digitalizações degradadas) que você pode testar, verificar por amostragem e estruturar um processo em torno — em vez de falhar aleatoriamente quando um cliente atualiza o layout do formulário e quebra seu modelo.
Uma lista de verificação para a decisão — seu processo de pedidos de venda está pronto para IA?
Nem todo fluxo de processamento de pedidos é igualmente adequado para extração por IA. As cinco perguntas a seguir ajudam você a determinar onde a extração entregará mais valor e onde precisará de apoio humano.
1. Quantos formatos distintos de pedido de cliente você recebe? Se você processa pedidos de 5 clientes com 5 formatos padrão, o OCR baseado em modelo pode funcionar adequadamente — você investe o tempo de configuração uma vez por cliente e o custo de manutenção é gerenciável. Se você processa pedidos de 20, 50 ou 200 clientes, cada um com seu próprio layout — o que é a realidade da maioria dos distribuidores, atacadistas e fabricantes B2B —, a extração semântica se torna não apenas mais rápida, mas estruturalmente necessária. Os custos de modelo escalam linearmente com o número de clientes. A extração semântica escala a um custo marginal quase zero por novo cliente.
2. Quão estruturados são os pedidos que você recebe? A extração por IA funciona melhor em pedidos que têm estrutura clara de cabeçalho-corpo-totais — pedidos de compra em PDF gerados por ERP, formulários padrão de confirmação de pedido e documentos de pedido digitados ou impressos. Funciona moderadamente bem em planilhas enviadas por e-mail ou anexos CSV (a IA lê dados tabulares em anexos). Não é ideal para corpos de e-mail de formato livre que descrevem o que o cliente quer em texto corrido sem campos estruturados — esses exigem compreensão de linguagem natural, melhor tratada por ferramentas de análise de e-mail dedicadas. Se 80% dos seus pedidos chegam como PDFs estruturados dos sistemas ERP dos clientes, a extração por IA automatizará a maior parte da sua carga de trabalho.
3. Qual é a sua tolerância a erros por tipo de campo? Nem todos os campos têm o mesmo risco. Um erro em "Requested Ship Date" (capturar a data errada) pode causar atrasos no atendimento, mas geralmente é detectado quando o armazém não encontra um pedido agendado para essa data. Um erro em "Customer PO Number" (capturar a referência errada) pode quebrar a conciliação de três vias e atrasar o reconhecimento de receita. Um erro em "Quantity Ordered" (capturar 100 em vez de 1.000) pode resultar em envio a menor, custos de recompra e um cliente insatisfeito. Mapeie sua tolerância a erros por campo antes de configurar a extração — e priorize a verificação pontual dos campos de alto risco (quantidades, números de PO, descontos) em vez dos de baixo risco (nomes de empresas, datas genéricas).
4. Você consegue processar seus pedidos em lote? A extração por AI é projetada para o Processamento Prioritário em Lote — envie vários pedidos de uma vez, processe-os juntos e revise a saída consolidada. Se o seu fluxo de trabalho atual processa os pedidos um a um conforme chegam (abrir e-mail, digitar dados, passar para o próximo e-mail), o ganho real de eficiência vem do processamento em lote. Isso pode exigir uma mudança de processo: coletar os pedidos ao longo da manhã, processar o lote antes do almoço, revisar as exceções à tarde. O tempo por pedido cai de 3 a 5 minutos de digitação para 10 segundos de processamento por AI mais 20 segundos de validação do lote.
5. Seus clientes alguma vez mudam o formato do pedido sem aviso? Este é o custo silencioso da extração baseada em modelo que a maioria dos tomadores de decisão não considera até que aconteça. Um cliente atualiza o sistema ERP e o layout do pedido de compra muda. O modelo que você criou no ano passado não extrai mais nada útil. Você descobre isso quando um lote de 30 pedidos desse cliente é processado sem nenhum dado — e você precisa reinserir todos os 30 manualmente. A extração semântica absorve mudanças de formato porque não depende do formato. A AI lê cada pedido de forma independente, pelo significado, então uma mudança de layout de um cliente tem impacto zero na qualidade da extração. Se você já viveu o momento "o cliente atualizou o formulário e nossa automação quebrou", este é o argumento mais forte para migrar da extração baseada em modelo para a extração semântica.
Para um guia mais detalhado sobre como construir um fluxo de trabalho de extração de pedidos de venda de ponta a ponta — incluindo a configuração do Link de Coleta para permitir que os clientes enviem seus próprios pedidos, o processamento em lote com saídas prontas para ERP e padrões de integração — consulte nosso guia completo de extração de pedidos de venda (Parte 3 da nossa série de extração de order-to-cash).
Os arquivos são processados com segurança e não são armazenados.
Perguntas Frequentes
A IA consegue extrair dados de pedidos de venda de pedidos de compra manuscritos?
Parcialmente. A IA de visão moderna consegue ler manuscritos com 85-95% de precisão em pedidos manuscritos razoavelmente legíveis — significativamente melhor que o OCR tradicional, que normalmente cai abaixo de 50% em escrita cursiva ou mista. No entanto, formulários de pedido manuscritos com anotações à margem, riscos ou correções aumentam a ambiguidade. Se seus clientes enviam pedidos de compra manuscritos por fax ou foto, planeje uma taxa maior de revisão humana (busque 100% de revisão de quantidades e preços, que têm o maior custo de erro). Pedidos em PDF impressos ou digitais dos sistemas ERP dos clientes não têm essa limitação e são processados com 95-99% de precisão com revisão mínima.
A IA lida com pedidos de venda de várias páginas com itens que continuam entre páginas?
Sim. A IA lê o documento inteiro como uma única estrutura visual — ela acompanha a tabela de itens ao longo das quebras de página e continua extraindo linhas na sequência correta. A única condição é que os cabeçalhos das colunas sejam repetidos em cada página (como fazem a maioria dos pedidos de compra gerados por ERP). Se os cabeçalhos estiverem ausentes nas páginas de continuação, a IA ainda consegue manter a integridade das linhas inferindo a estrutura da tabela a partir da disposição das colunas, mas verifique o primeiro pedido de várias páginas de cada cliente para confirmar que o layout da tabela foi interpretado corretamente.
E se o pedido de um cliente usar uma moeda ou unidade de medida diferente?
A IA extrai os valores como aparecem no documento — ela lerá "$2,450.00 USD" como o valor e o símbolo da moeda como prefixo ou sufixo. A saída preserva os valores originais, incluindo símbolos de moeda e abreviações de unidades de medida (EA, KG, LB, M, L). Para importação no ERP, você pode configurar lógica de pós-processamento na sua planilha ou usar uma coluna calculada para converter unidades durante a extração (por exemplo, "Weight in KG (LBS × 0.4536)"). A IA não converte moedas automaticamente — essa é uma decisão de lógica de negócio melhor tratada no seu ERP ou em uma coluna de fórmula na planilha de saída.
Posso configurar um sistema em que os clientes enviam os próprios pedidos e eles são processados automaticamente?
Sim. Gere um Link de Coleta — uma URL compartilhável que qualquer pessoa pode abrir para enviar arquivos diretamente para a fila de processamento da sua conta, sem se registrar ou fazer login. Compartilhe este link com seus clientes, e os pedidos de compra deles chegam à sua fila conforme são enviados. Você processa o lote no seu ritmo, revisa as exceções e exporta os dados consolidados. Isso elimina a cadeia "baixar do e-mail → salvar na pasta → enviar para a ferramenta" e reduz a fricção de coletar pedidos de dezenas de clientes. Para clientes recorrentes, você pode salvar sua configuração de colunas como um modelo, para que cada lote use as mesmas colunas de extração sem reinserir os nomes dos campos.
Como a IA lida com pedidos que incluem itens baseados em quantidade e itens de serviço (taxas por hora)?
Ela lê os dois tipos da mesma forma — cada linha da tabela de itens é extraída com seu código de item, descrição, quantidade ou horas, preço unitário (por unidade ou por hora) e total da linha. A IA não distingue os tipos de item no momento da extração, a menos que você peça. Se você precisar separar produtos físicos de serviços na sua saída, defina duas passagens de extração: uma com uma coluna chamada "Item Type" e a IA vai inferir pela descrição se cada linha é um produto ou um serviço. Como alternativa, use uma coluna calculada com lógica condicional — "se a descrição contém 'hour' ou 'consulting' então 'Service', senão 'Product'" — para classificar as linhas durante a extração.
Qual taxa de erro devo esperar na extração de pedidos de venda em produção?
Em pedidos de compra limpos, impressos e em formato padrão (o tipo gerado por sistemas ERP conhecidos), a precisão em nível de campo é de 95-99% para campos de cabeçalho e 92-97% para campos de itens de linha, dependendo da complexidade da tabela. Em pedidos com layouts complexos — tabelas de preços escalonados, grades de desconto, itens de linha divididos entre páginas — a precisão cai para 85-92% e exige mais verificação humana por amostragem. Esses números são consistentes com o que benchmarks de terceiros relatam para extração de documentos por IA em diversos tipos de documento: documentos estruturados impressos têm o melhor desempenho, documentos de formato misto exigem revisão moderada, e digitalizações de baixa qualidade exigem a maior validação humana. A métrica operacional principal não é a precisão média — é o tempo de revisão por pedido após a extração. Uma redução de 5 minutos de digitação manual para 1 minuto de revisão de exceções é um ganho de produtividade de 5x, mesmo que a precisão não seja perfeita.
A pergunta "A IA consegue ler pedidos de venda?" tem uma resposta clara: sim — e a tecnologia está madura o suficiente para lidar com a diversidade de formatos que torna a digitação manual de pedidos tão cara. A verdadeira questão é quanto do seu fluxo de trabalho específico você pode confiar para rodar com revisão apenas de exceções, em vez de exigir validação linha por linha. Essa resposta depende do seu mix de clientes, da distribuição de qualidade dos documentos e da sua tolerância a riscos em nível de campo — mas é uma pergunta que você pode responder em uma única tarde de testes com os seus próprios pedidos. Envie 10 pedidos de 10 clientes diferentes, configure os nomes das suas colunas uma vez e veja o que retorna. O resultado dirá mais do que mil palavras sobre a precisão da extração.
Se você está pronto para avaliar a extração por IA nos seus pedidos de venda reais, comece com a nossa ferramenta de pedido de venda para Excel — envie um pedido de exemplo e veja o que a IA extrai sem configurar nenhum modelo. Para o fluxo completo — incluindo processamento em lote, configuração do Link de Coleta e exportação pronta para ERP — consulte o guia completo de extração de pedidos de venda.