¿Puede la IA leer órdenes de venta?
Sí — en cualquier formato de cliente
Sí. La IA moderna puede extraer campos de encabezado y líneas de artículos de órdenes de venta — incluyendo referencias de PO del cliente, códigos de artículo, cantidades, precios unitarios, descuentos, impuestos, direcciones de envío y fechas de entrega — en cualquier cantidad de formatos de cliente, sin configuración de plantilla por cliente. La distinción clave es la perspectiva: el documento que recibes de un cliente es técnicamente su orden de compra, pero para ti se convierte en los datos fuente para crear tu orden de venta. La IA lo lee como tú lo harías — como una solicitud de bienes o servicios — y extrae los campos que necesitas sin importar si el cliente los etiqueta como "PO No.", "Order Ref." o "Customer #". En órdenes PDF impresas o digitales limpias, la precisión a nivel de campo alcanza el 95-99%, con los resultados más confiables en órdenes de compra estándar generadas por ERP.
Conclusiones clave
- Una herramienta OCR basada en plantillas funciona perfectamente con el PO de un cliente — hasta que actualizan su ERP y mueven el bloque Ship To a una nueva posición, rompiendo silenciosamente la plantilla y devolviendo cero datos de un lote de 30 órdenes que solo descubres que está vacío después de procesarlo.
- El costo oculto de la extracción basada en plantillas no es la configuración — es el mantenimiento que se acumula con cada cliente: cada cambio de formato rompe silenciosamente una plantilla diferente, y la falla aparece en producción cuando procesas un lote contra una fecha límite, no durante una verificación programada.
- La extracción semántica elimina las plantillas por completo — lee Ship To por significado en lugar de coordenadas, por lo que la misma definición de columna maneja 50 formatos de cliente a la vez y cualquier cambio de diseño de un solo cliente tiene cero impacto en la calidad de extracción.
Recorrido real de una orden de venta: qué lee la IA, campo por campo
Veamos una orden de compra típica de un cliente que llega a tu bandeja de entrada: un archivo PDF adjunto de un minorista que solicita 50 unidades de un artículo con 3 variantes de color, un almacén de envío en la Costa Oeste y una fecha de entrega solicitada a tres semanas. Esto no es un caso excepcional. Es la realidad diaria del procesamiento de pedidos para miles de vendedores B2B. Esto es exactamente lo que la IA lee y dónde encuentra cada campo.
Bloque de encabezado. La IA comienza identificando las regiones estructurales del documento, igual que tú al abrir un PDF. En la sección superior — el encabezado — lee el nombre y la dirección de la empresa del cliente, el número de orden de compra (a menudo etiquetado como "PO No.", "PO #", "Customer Ref." u "Order No."), la fecha de emisión de la PO y la fecha de entrega solicitada o fecha "Ship by". Cada uno de estos campos se localiza por su significado semántico dentro de la región del encabezado, no comparando una etiqueta con una coordenada fija en la página. Una etiqueta que dice "Req. Ship Date" se reconoce como la fecha de entrega. Una etiqueta que dice "Date" junto al número de PO en el encabezado se reconoce como la fecha de emisión. Esta es la misma desambiguación que una persona hace sin pensar — excepto que la IA lo hace en cada documento, cada vez, sin cansarse.
Direcciones de envío vs. facturación. La mayoría de las órdenes de compra de clientes incluyen dos bloques de dirección: a dónde deben ir los bienes y a dónde se debe enviar la factura (facturación). La IA los distingue leyendo la etiqueta sobre cada bloque y comprendiendo la relación entre la dirección y el contenido circundante. El bloque de dirección etiquetado como "Ship To", "Deliver To" o "Delivery Location" se captura como el destino de envío — esta es la dirección que determina los costos de flete, los cronogramas de entrega y el enrutamiento de cumplimiento. El bloque de dirección etiquetado como "Bill To" o adyacente a la información de "Remit To" se captura por separado. En pedidos donde ambos bloques carecen de etiquetas explícitas — solo dos direcciones impresas una al lado de la otra — la IA recurre a heurísticas posicionales: la dirección más cercana a la parte superior del documento, alineada con el encabezado del cliente, es la de facturación, mientras que la dirección en una sección inferior separada o alineada con instrucciones de entrega es la de envío.
Partidas. La IA identifica la tabla de partidas por su estructura: una cuadrícula de múltiples columnas en el cuerpo del documento con encabezados de columna como "Item No.", "Description", "Qty", "Unit Price" y "Total". Cada fila de esta tabla se lee como una partida. El código del artículo (SKU o número de pieza), la descripción del artículo, la cantidad ordenada, el precio unitario y el total de la línea se extraen por fila, independientemente del orden de columnas o las variaciones de nombres entre clientes. La tabla de un cliente tiene columnas en el orden "Qty | Item Code | Description | Unit Price | Total" y usa "EAN" en lugar de "Item Code". La tabla de otro cliente dice "Part # | Description | Price Each | Quantity". La IA lee los encabezados de columna semánticamente — entiende que "Price Each" y "Unit Price" significan lo mismo — y asigna cada valor a la columna de salida correcta.
Totales, descuentos e impuestos. En la parte inferior de la tabla de partidas o en una sección separada de totales, la IA lee el subtotal (suma de todos los totales de partidas antes de ajustes), cualquier descuento aplicado (porcentaje o monto fijo), la tasa y el monto de impuesto (que varía según la jurisdicción — VAT, GST, impuesto a las ventas o HST), los cargos de envío y manejo, y el total general. Cada uno de estos montos se distingue por su posición en el bloque de totales y su relación semántica con las partidas anteriores. El monto inmediatamente debajo de la última partida es el subtotal. El monto después de una línea etiquetada "Discount 2% Net 30" es un descuento. El monto después de "Tax", "VAT" o "GST" es el monto de impuesto. El monto al final de la columna, generalmente en negrita o con una fuente más grande, es el total general.
Este recorrido cubre un solo pedido de un solo cliente. Ahora imagine repetirlo para 15 clientes, cada uno con un diseño diferente. La IA procesa los 15 en el mismo lote, con las mismas definiciones de columnas, y genera una sola hoja de cálculo consolidada. Para una explicación más profunda del mecanismo subyacente, lea nuestra guía sobre fundamentos de extracción de datos de PO — la estructura del documento es la misma, pero las necesidades de extracción del vendedor añaden la capa de mapear formatos de clientes a campos internos de SO.
Por qué funciona — La extracción semántica reemplaza la configuración plantilla por plantilla
La razón por la que la IA puede leer una docena de pedidos de clientes diferentes en una sola pasada no es que tenga una plantilla para cada formato. No tiene plantillas en absoluto. El mecanismo se llama Extracción de Columnas Personalizadas y funciona invirtiendo la lógica tradicional de extracción.
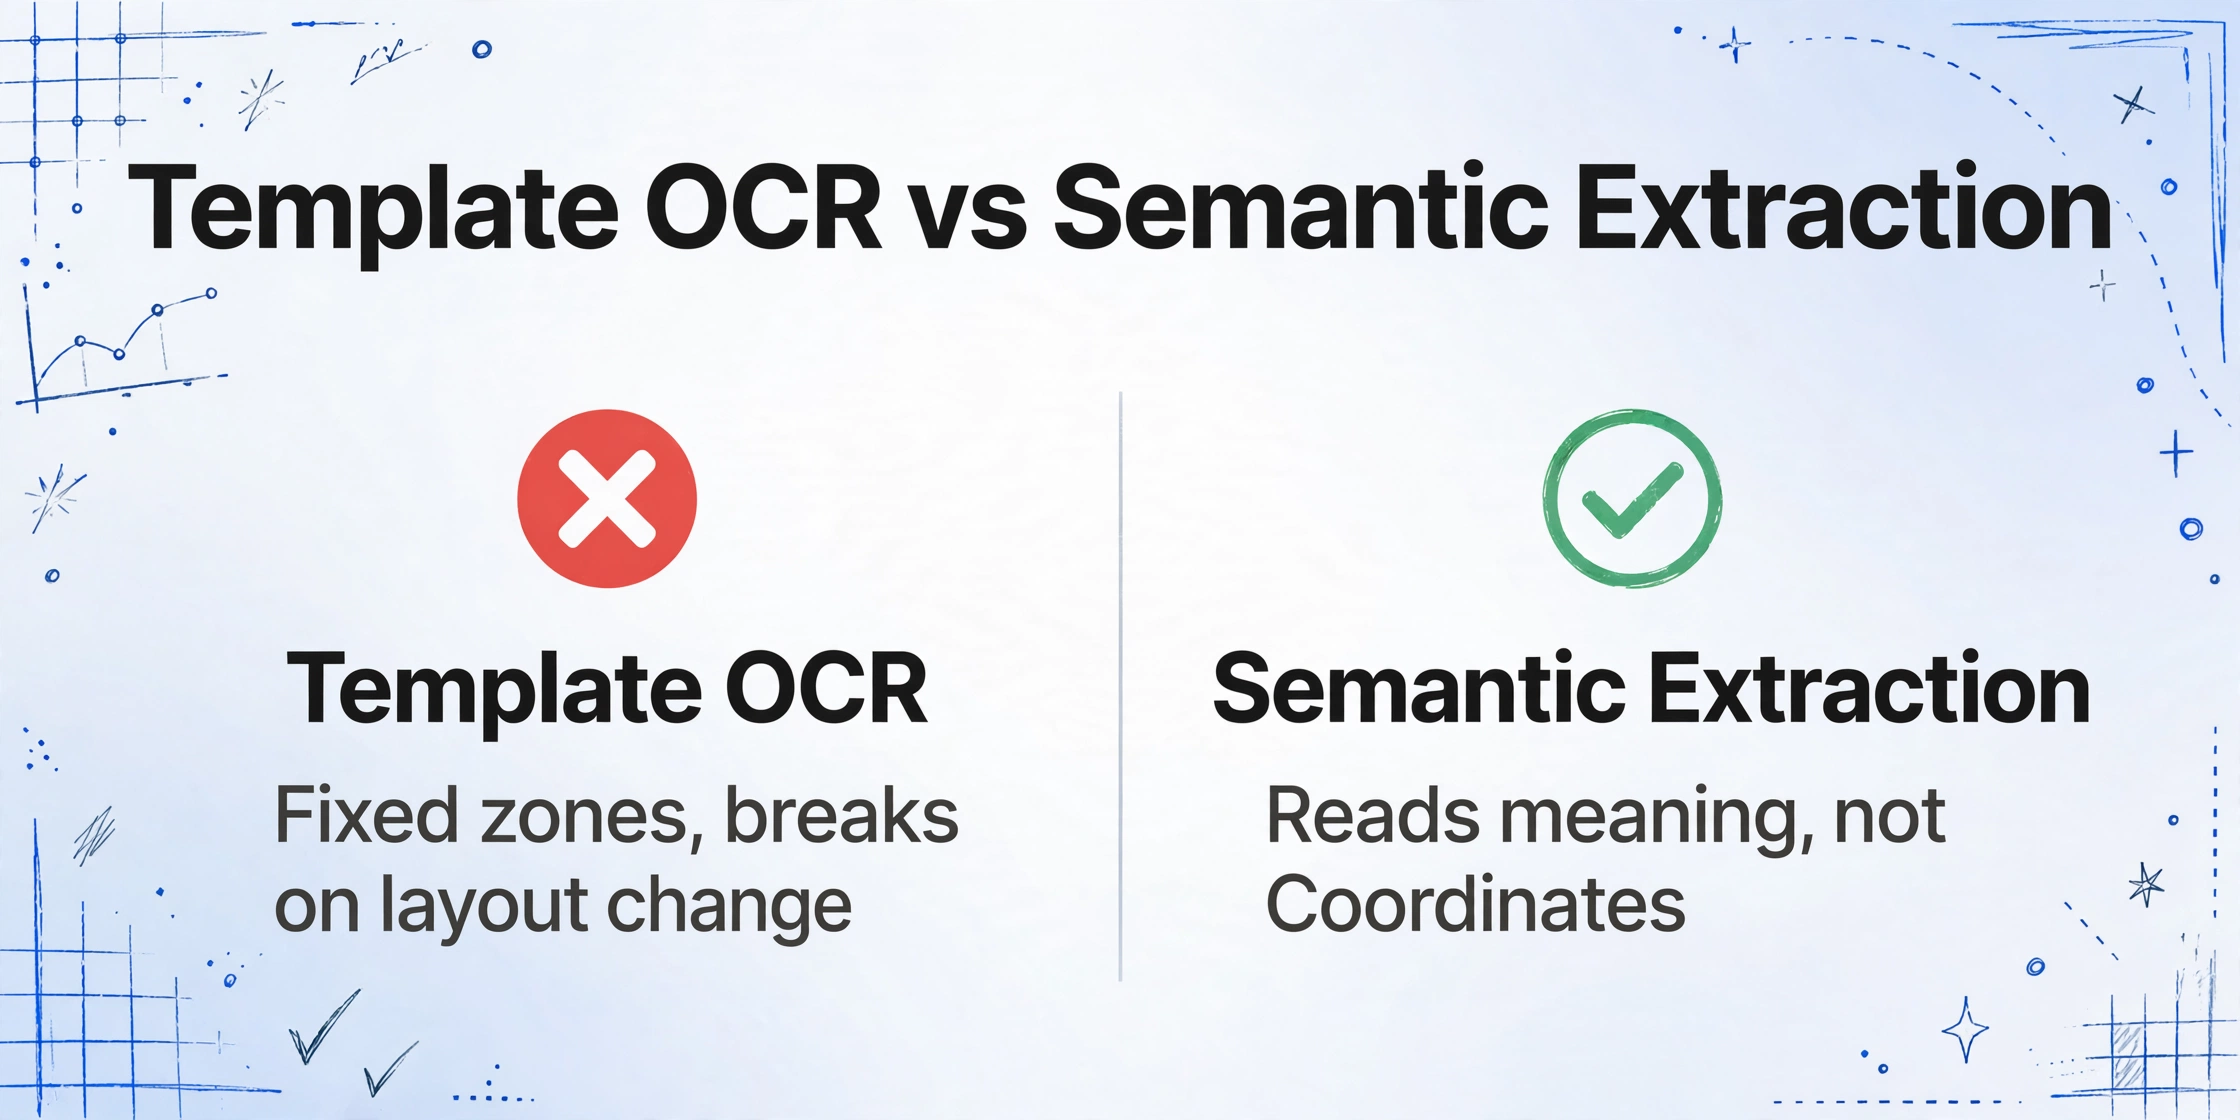
Las herramientas tradicionales de OCR basadas en plantillas requieren que defina zonas fijas en un documento de muestra para cada campo — "el precio unitario está en las coordenadas (200, 450) a (300, 470)". Cuando un segundo cliente envía un pedido con el precio unitario en una posición diferente, la zona ya no coincide y la extracción se rompe. Usted crea una segunda plantilla. Luego una tercera. Cada vez que un cliente actualiza el diseño de su formulario — lo que ocurre más a menudo de lo que la mayoría de los equipos registran — su plantilla se rompe y usted la mantiene. Este es el costo oculto de la extracción basada en plantillas: no el tiempo de configuración por cliente, sino el tiempo de mantenimiento en todos los clientes a lo largo de meses y años.
La extracción semántica elimina la capa de plantillas por completo. En lugar de preguntar "¿dónde está este campo?", pregunta "¿qué es este campo?" — y la respuesta no depende del diseño del documento.
Así es como funciona en la práctica. Usted define sus columnas de salida una vez — "Customer PO Number", "Item Code", "Quantity Ordered", "Unit Price", "Line Total", "Ship To Address", "Requested Ship Date" — y las guarda como una plantilla (esta es su plantilla de columnas personal, no una plantilla de documento por cliente). Cuando sube la orden de compra de un cliente, la IA lee el documento como un todo, identifica cada campo por su significado semántico dentro del diseño del documento y lo mapea al nombre de columna que usted definió.
Por eso la misma definición de columnas funciona ya sea que un cliente etiquete el campo "Unit Price", "Price Each", "单价" (chino) o "Precio Unitario" (español) — la IA entiende lo que significa cada frase, no qué caracteres contiene. Y por eso un cambio de diseño del cliente (mover el bloque "Ship To" de la esquina superior derecha a la inferior izquierda entre revisiones de formato) no rompe la extracción: la IA busca el significado de "Ship To", no sus coordenadas de píxeles.
Para pedidos donde no se imprime el total de la línea (solo aparecen Cantidad y Precio Unitario), puede usar una columna calculada. Nombre su columna "Line Total (Qty × Unit Price)" y la IA realiza la multiplicación durante la extracción, añadiendo el valor calculado a su salida sin necesidad de procesamiento posterior en Excel. Esta es una de varias mejoras de extracción que hacen que la salida esté lista para su ERP o sistema de gestión de pedidos sin limpieza manual. Para un recorrido completo del flujo de trabajo de extracción de pedidos de venta de principio a fin, consulte nuestra guía de pedidos de venta a Excel.
Donde aún puede fallar — Limitaciones honestas
Ninguna herramienta de extracción es perfecta en todos los documentos. Los siguientes escenarios requieren atención adicional, y conocerlos de antemano ahorra más tiempo que descubrirlos en producción.
Tablas complejas de precios escalonados y descuentos. Si la orden de compra de un cliente incluye una tabla de precios por cantidad — "$10/unidad para 1-50 unidades, $8.50/unidad para 51-200 unidades" — mostrada como una tabla separada junto a los artículos de línea, la IA puede asignar el nivel de precio incorrecto a un artículo si los límites de los niveles son implícitos (no repetidos en cada línea) o si la tabla de precios y la tabla de artículos no están visualmente conectadas. La IA lee cada tabla de forma independiente, pero mapear la cantidad pedida de un artículo a la fila correcta en una tabla de precios separada requiere un razonamiento de múltiples pasos que es más fiable en una revisión humana que en una sola pasada de extracción. Recomendación: para pedidos con niveles de descuento o precios separados, haga una verificación puntual de los precios unitarios de los primeros pedidos de ese cliente. Una vez que confirme que la IA mapea los precios al nivel correcto, puede confiar en los pedidos posteriores del mismo cliente — pero verifique el primer lote.
Pedidos muy grandes (100+ artículos de línea) que abarcan varias páginas. La IA maneja documentos de varias páginas de forma nativa — lee la tabla de artículos a través de los saltos de página y continúa contando filas. Pero cuando un solo pedido tiene 150 artículos repartidos en 6 páginas, la probabilidad de un artefacto de salto de página (una fila dividida entre páginas donde los encabezados de columna no se repiten) aumenta. El modelo visual de la IA generalmente puede manejar estos casos porque entiende la estructura de tablas, pero la tasa de error por fila se acumula con el número total de filas. Recomendación: para pedidos que superen los 100 artículos, revise la salida extraída y verifique el recuento total de líneas contra el recuento del pedido. La mayoría de las discrepancias ocurren en los límites de salto de página y son fáciles de detectar.
Copias carbón muy degradadas y pedidos por fax. Si un cliente aún envía pedidos por fax o formularios de copia carbón, la calidad del texto puede estar por debajo de lo que la IA puede leer de forma fiable. Caracteres tenues, números borrosos y anotaciones manuscritas en los márgenes pueden causar lecturas erróneas — "1,000 unidades" se convierte en "100 unidades" si el tercer cero es ilegible. Recomendación: configure un flujo de trabajo de marcado de baja confianza. La IA devuelve una puntuación de confianza para cada valor extraído; configure su proceso para revisar todos los valores por debajo de un umbral de confianza. Esto detecta los casos de documentos degradados sin requerir revisión humana de cada pedido limpio.
Números de PO de cliente que incluyen caracteres especiales o espacios. Algunos números de órdenes de compra incluyen guiones, barras o espacios integrados que forman parte semántica del número (p. ej., "PO-2026-0715"), pero que pueden fragmentarse por el diseño del documento. La IA lee el texto en bloques visuales, por lo que un número de PO dividido en dos líneas puede reconstruirse como dos tokens separados. Recomendación: después de la extracción, revise la columna "Customer PO Number" para detectar valores que parezcan truncados o divididos. La IA normalmente maneja bien los formatos estándar, pero los diseños inusuales con números de PO fragmentados se benefician de una revisión visual rápida de la columna de salida.
Estas limitaciones no son obstáculos insalvables: son consideraciones de diseño de proceso. Lo mismo ocurre con toda herramienta de extracción, y las honestas te indican dónde prestar atención. Para un marco más amplio sobre cómo evaluar si la extracción con IA es adecuada para tu equipo, consulta nuestra guía práctica para mejorar la precisión de la extracción.
La diferencia entre una herramienta de extracción que gestiona tus órdenes de venta y una que añade más trabajo no es si comete errores — toda herramienta los comete. La diferencia está en si comete errores predecibles en documentos que puedes probar, o errores impredecibles en documentos que no puedes. La extracción semántica sobre plantillas significa que la IA falla de manera consistente en condiciones específicas del documento (precios escalonados, escaneos degradados) que puedes probar, verificar y convertir en un proceso — en lugar de fallar aleatoriamente cuando un cliente actualiza el formato de su formulario y rompe tu plantilla.
Una Lista de Verificación — ¿Está tu Proceso de Órdenes de Venta Listo para la IA?
No todos los flujos de trabajo de procesamiento de órdenes son igualmente adecuados para la extracción con IA. Las siguientes cinco preguntas te ayudan a determinar dónde la extracción aportará más valor y dónde necesitará respaldo humano.
1. ¿Cuántos formatos distintos de órdenes de clientes recibes? Si procesas órdenes de 5 clientes con 5 formatos estándar, el OCR basado en plantillas puede funcionar adecuadamente: inviertes el tiempo de configuración una vez por cliente y el costo de mantenimiento es manejable. Si procesas órdenes de 20, 50 o 200 clientes, cada uno con su propio diseño — que es la realidad para la mayoría de distribuidores, mayoristas y fabricantes B2B — la extracción semántica se vuelve no solo más rápida sino estructuralmente necesaria. Los costos de plantillas escalan linealmente con el número de clientes. La extracción semántica escala con un costo marginal casi nulo por cada cliente nuevo.
2. ¿Qué tan estructuradas son las órdenes que recibes? La extracción con IA funciona mejor en órdenes que tienen una estructura clara de encabezado-cuerpo-totales — órdenes de compra en PDF generadas por ERP, formularios estándar de confirmación de pedido y documentos de órdenes mecanografiados o impresos. Funciona moderadamente bien en hojas de cálculo enviadas por correo electrónico o archivos CSV adjuntos (la IA lee datos tabulares en archivos adjuntos). No es ideal para cuerpos de correo electrónico de formato libre que describen lo que el cliente quiere en texto de párrafo sin campos estructurados — esos requieren comprensión de lenguaje natural que se maneja mejor con herramientas especializadas de análisis de correos. Si el 80% de tus órdenes llegan como PDFs estructurados de los sistemas ERP de los clientes, la extracción con IA automatizará la mayor parte de tu carga de trabajo.
3. ¿Cuál es su tolerancia a errores por tipo de campo? No todos los campos conllevan el mismo riesgo. Un error en "Requested Ship Date" (capturar la fecha incorrecta) puede causar retrasos en el cumplimiento, pero generalmente se detecta cuando el almacén no encuentra un pedido programado para esa fecha. Un error en "Customer PO Number" (capturar la referencia incorrecta) puede romper la conciliación de tres vías y retrasar el reconocimiento de ingresos. Un error en "Quantity Ordered" (capturar 100 en lugar de 1,000) puede resultar en envíos insuficientes, costos de reorden y un cliente decepcionado. Defina su tolerancia a errores por campo antes de configurar la extracción — y priorice la verificación puntual de los campos de alto riesgo (cantidades, números de PO, descuentos) sobre los de bajo riesgo (nombres de empresas, fechas genéricas).
4. ¿Puede procesar sus pedidos por lotes? La extracción con IA está diseñada para el Procesamiento por lotes prioritario — cargue varios pedidos a la vez, procéselos juntos y revise el resultado consolidado. Si su flujo de trabajo actual procesa pedidos uno a la vez a medida que llegan (abrir correo, escribir datos, pasar al siguiente correo), la ganancia real de eficiencia proviene del procesamiento por lotes. Esto puede requerir un cambio de proceso: recopile pedidos durante la mañana, procese el lote antes del almuerzo, revise las excepciones por la tarde. El tiempo por pedido se reduce de 3 a 5 minutos de escritura a 10 segundos de procesamiento con IA más 20 segundos de validación del lote.
5. ¿Sus clientes cambian alguna vez el formato de sus pedidos sin previo aviso? Este es el costo silencioso de la extracción basada en plantillas que la mayoría de los tomadores de decisiones no consideran hasta que ocurre. Un cliente actualiza su sistema ERP y el diseño de su orden de compra cambia. La plantilla que creó el año pasado ya no extrae nada útil. Lo descubre cuando un lote de 30 pedidos de ese cliente se procesa sin datos — y tiene que volver a ingresar los 30 manualmente. La extracción semántica absorbe los cambios de formato porque no depende del formato. La IA lee cada pedido de forma independiente, por significado, por lo que un cambio de diseño de un cliente no tiene ningún impacto en la calidad de la extracción. Si alguna vez ha experimentado el momento de "el cliente actualizó su formulario y nuestra automatización se rompió", este es el argumento más sólido para pasar de la extracción basada en plantillas a la semántica.
Para obtener una guía más detallada sobre cómo crear un flujo de trabajo completo de extracción de pedidos de venta — incluida la configuración del Enlace de Recopilación para que los clientes carguen sus propios pedidos, el procesamiento por lotes con resultados listos para ERP y los patrones de integración — consulte nuestra guía completa de extracción de pedidos de venta (Parte 3 de nuestra serie de extracción de pedidos a cobro).
Los archivos se procesan de forma segura y no se almacenan.
Preguntas Frecuentes
¿Puede la IA extraer datos de pedidos de compra manuscritos?
Parcialmente. La IA de visión moderna lee escritura a mano con una precisión del 85-95% en pedidos manuscritos razonablemente legibles, significativamente mejor que el OCR tradicional, que suele caer por debajo del 50% en escritura cursiva o mixta. Sin embargo, los formularios de pedido manuscritos con notas al margen, tachaduras o correcciones aumentan la ambigüedad. Si sus clientes envían pedidos manuscritos por fax o foto, planifique una tasa de revisión humana más alta (apunte al 100% de revisión de cantidades y precios, que conllevan el mayor costo de error). Los pedidos impresos o en PDF digital de los sistemas ERP de los clientes no tienen esta limitación y se procesan con una precisión del 95-99% con una revisión mínima.
¿La IA maneja pedidos de venta de varias páginas con líneas de artículo que continúan entre páginas?
Sí. La IA lee el documento completo como una única estructura visual: sigue la tabla de líneas de artículo a través de los saltos de página y continúa extrayendo filas en la secuencia correcta. La única condición es que los encabezados de columna deben repetirse en cada página (como ocurre en la mayoría de los pedidos de compra generados por ERP). Si faltan los encabezados en las páginas de continuación, la IA aún puede mantener la integridad de las filas infiriendo la estructura de la tabla a partir de la disposición de las columnas, pero verifique el primer pedido de varias páginas de cada cliente para confirmar que el diseño de la tabla se interpreta correctamente.
¿Qué sucede si el pedido de un cliente utiliza una moneda o unidad de medida diferente?
La IA extrae los valores tal como aparecen en el documento: leerá "$2,450.00 USD" como el monto y el símbolo de moneda como prefijo o sufijo. La salida conserva los valores originales, incluidos los símbolos de moneda y las abreviaturas de unidad de medida (EA, KG, LB, M, L). Para la importación a ERP, puede configurar la lógica de posprocesamiento en su hoja de cálculo o usar una Columna Calculada para convertir unidades durante la extracción (por ejemplo, "Peso en KG (LBS × 0.4536)"). La IA no convierte monedas automáticamente; esa es una decisión de lógica de negocio que se maneja mejor en su ERP o en una columna de fórmula en la hoja de cálculo de salida.
¿Puedo configurar un sistema donde los clientes suban sus pedidos y se procesen automáticamente?
Sí. Genere un Enlace de Recogida — una URL compartible que cualquiera puede abrir para subir archivos directamente a la cola de procesamiento de su cuenta, sin registrarse ni iniciar sesión. Comparta este enlace con sus clientes y sus órdenes de compra llegarán a su cola a medida que se reciban. Usted procesa el lote en su horario, revisa excepciones y exporta los datos consolidados. Esto elimina la cadena de "descargar del correo → guardar en carpeta → subir a la herramienta" y reduce la fricción de recolectar pedidos de decenas de clientes. Para clientes recurrentes, puede guardar su configuración de columnas como plantilla para que cada lote use las mismas columnas de extracción sin tener que reingresar los nombres de los campos.
¿Cómo maneja la IA pedidos que incluyen tanto artículos basados en cantidad como líneas de servicio (tarifas por hora)?
Lee ambos tipos de la misma manera: cada fila en la tabla de líneas se extrae con su código de artículo, descripción, cantidad u horas, precio unitario (por unidad o por hora) y total de línea. La IA no distingue tipos de artículo al momento de la extracción a menos que se lo pida. Si necesita separar bienes físicos de servicios en su salida, defina dos pasadas de extracción: una con una columna llamada "Tipo de Artículo" y la IA inferirá de la descripción si cada línea es un producto o un servicio. Alternativamente, use una Columna Calculada con lógica condicional — "si la descripción contiene 'hora' o 'consultoría', entonces 'Servicio', si no 'Producto'" — para clasificar filas durante la extracción.
¿Qué tasa de error debo esperar en la extracción de órdenes de venta en producción?
En órdenes de compra limpias, impresas y de formato estándar (el tipo generado por sistemas ERP conocidos), la precisión a nivel de campo es del 95-99% para campos de encabezado y del 92-97% para campos de líneas, dependiendo de la complejidad de la tabla. En pedidos con diseños complejos — tablas de precios escalonados, cuadrículas de descuentos, líneas divididas en páginas — la precisión baja al 85-92% y requiere más verificación humana puntual. Estas cifras son consistentes con lo que reportan evaluaciones comparativas de terceros para la extracción de documentos con IA en distintos tipos de documentos: los documentos estructurados impresos funcionan mejor, los documentos de formato mixto requieren revisión moderada y los escaneos de baja calidad requieren la mayor validación humana. La métrica operativa clave no es la precisión promedio, sino el tiempo de revisión por pedido después de la extracción. Pasar de 5 minutos de ingreso manual a 1 minuto de revisión de excepciones es una ganancia de productividad de 5x incluso si la precisión no es perfecta.
La pregunta "¿Puede la IA leer órdenes de venta?" tiene una respuesta clara: sí — y la tecnología es lo suficientemente madura para manejar la diversidad de formatos que hace que el ingreso manual de pedidos sea tan costoso. La verdadera pregunta es cuánto de su flujo de trabajo específico puede confiar para que funcione solo con revisión de excepciones versus requerir validación línea por línea. Esa respuesta depende de su combinación de clientes, distribución de calidad de documentos y tolerancia al riesgo a nivel de campo — pero es una pregunta que puede responder en una sola tarde de pruebas con sus propios pedidos. Suba 10 pedidos de 10 clientes diferentes, configure los nombres de sus columnas una vez y vea qué devuelve. El resultado le dirá más que mil palabras sobre la precisión de la extracción.
Si está listo para evaluar la extracción con IA en sus órdenes de venta reales, comience con nuestra herramienta de órdenes de venta a Excel — suba un pedido de muestra y vea qué extrae la IA sin configurar plantillas. Para el flujo de trabajo completo — incluyendo procesamiento por lotes, configuración de Enlace de Recogida y exportación lista para ERP — consulte la guía completa para la extracción de órdenes de venta.