Kann KI Auftragsbestellungen lesen?
Ja – in jedem Kundenformat
Ja. Moderne KI kann Kopf- und Positionsfelder aus Auftragsbestellungen extrahieren – einschließlich Kunden-PO-Referenzen, Artikelcodes, Mengen, Einzelpreisen, Rabatten, Steuern, Lieferadressen und Lieferterminen – in beliebig vielen Kundenformaten, ohne kundenspezifische Vorlagenkonfiguration. Der entscheidende Unterschied liegt in der Perspektive: Das Dokument, das Sie vom Kunden erhalten, ist technisch gesehen dessen Bestellung, aber für Sie wird es zur Quelldatenbasis für Ihre Auftragsbestellung. Die KI liest es so, wie Sie es tun – als Anfrage nach Waren oder Dienstleistungen – und extrahiert die benötigten Felder, unabhängig davon, ob der Kunde sie als „PO No.", „Order Ref." oder „Customer #" bezeichnet. Bei sauberen gedruckten oder digitalen PDF-Bestellungen liegt die Feldgenauigkeit bei 95–99 %, mit den zuverlässigsten Ergebnissen bei standardmäßig ERP-generierten Bestellungen.
Wichtigste Erkenntnisse
- Ein vorlagenbasiertes OCR-Tool funktioniert perfekt mit der Bestellung eines Kunden – bis dieser sein ERP aktualisiert und den Ship-To-Block an eine neue Position verschiebt, wodurch die Vorlage stillschweigend bricht und bei einer Charge von 30 Bestellungen null Daten zurückgibt, was Sie erst nach der Verarbeitung bemerken.
- Die versteckten Kosten der vorlagenbasierten Extraktion liegen nicht im Setup, sondern in der Wartung, die mit jedem Kunden wächst: Jede Formatänderung bricht stillschweigend eine andere Vorlage, und der Bruch tritt in der Produktion auf, wenn Sie eine Charge unter Zeitdruck verarbeiten – nicht bei einer geplanten Prüfung.
- Semantische Extraktion eliminiert Vorlagen vollständig – sie liest Ship To nach Bedeutung statt nach Koordinaten, sodass dieselbe Spaltendefinition 50 Kundenformate gleichzeitig verarbeitet und eine Layoutänderung eines einzelnen Kunden keinerlei Auswirkung auf die Extraktionsqualität hat.
Ein echter Auftragsbeleg im Detail – Was die KI liest, Feld für Feld
Gehen wir einen typischen Kundenauftrag durch, der in Ihrem Posteingang landet – ein PDF-Anhang eines Einzelhändlers, der 50 Einheiten eines Artikels in 3 Farbvarianten bestellt, mit einer Lieferadresse an der Westküste und einem gewünschten Liefertermin in drei Wochen. Das ist kein Sonderfall. Es ist der Alltag der Auftragsabwicklung für Tausende von B2B-Verkäufern. Hier ist genau, was die KI liest und wo sie jedes Feld findet.
Kopfbereich. Die KI beginnt damit, die strukturellen Bereiche des Dokuments zu identifizieren – genau wie Sie es tun, wenn Sie eine PDF-Datei öffnen. Im oberen Abschnitt – dem Kopfbereich – liest sie den Firmennamen und die Adresse des Kunden (Bill To), die Bestellnummer (häufig als „PO No.", „PO #", „Customer Ref." oder „Order No." bezeichnet), das Ausstellungsdatum der Bestellung sowie das gewünschte Lieferdatum oder das „Ship by"-Datum. Jedes dieser Felder wird über seine semantische Bedeutung im Kopfbereich lokalisiert, nicht durch den Abgleich einer Beschriftung mit einer festen Position auf der Seite. Eine Beschriftung wie „Req. Ship Date" wird als Lieferdatum erkannt. Eine Beschriftung wie „Date" neben der Bestellnummer im Kopfbereich wird als Ausstellungsdatum erkannt. Das ist dieselbe Unterscheidung, die ein Mensch gedankenlos vornimmt – nur dass die KI es bei jedem Dokument, jedes Mal, ohne Ermüdung tut.
Ship-to- vs. Bill-to-Adressen. Die meisten Kundenaufträge enthalten zwei Adressblöcke: wohin die Ware geliefert werden soll (Ship To) und wohin die Rechnung gesendet werden soll (Bill To). Die KI unterscheidet sie, indem sie die Beschriftung über jedem Block liest und die Beziehung zwischen der Adresse und dem umgebenden Inhalt versteht. Der Adressblock mit der Beschriftung „Ship To", „Deliver To" oder „Delivery Location" wird als Lieferadresse erfasst – das ist die Adresse, die Frachtkosten, Lieferpläne und die Erfüllungslogistik bestimmt. Der Adressblock mit der Beschriftung „Bill To" oder in Verbindung mit „Remit To"-Informationen wird separat erfasst. Bei Aufträgen, bei denen beide Blöcke keine expliziten Beschriftungen haben – nur zwei nebeneinander gedruckte Adressen – greift die KI auf Positionsheuristiken zurück: Die Adresse näher am oberen Dokumentrand, ausgerichtet mit dem Kundenkopfbereich, ist die Bill-to-Adresse, während die Adresse in einem separaten unteren Abschnitt oder ausgerichtet mit Lieferanweisungen die Ship-to-Adresse ist.
Positionen. Die KI identifiziert die Positionstabelle anhand ihrer Struktur – einem mehrspaltigen Raster im Dokumentkörper mit Spaltenüberschriften wie „Item No.", „Description", „Qty", „Unit Price" und „Total". Jede Zeile dieser Tabelle wird als eine Position gelesen. Der Artikelcode (SKU oder Teilenummer), die Artikelbeschreibung, die bestellte Menge, der Einzelpreis und der Positionsgesamtbetrag werden pro Zeile extrahiert – unabhängig von Spaltenreihenfolge oder Benennungsvarianten bei verschiedenen Kunden. Die Tabelle des einen Kunden hat Spalten in der Reihenfolge „Qty | Item Code | Description | Unit Price | Total" und verwendet „EAN" statt „Item Code". Die Tabelle eines anderen Kunden lautet „Part # | Description | Price Each | Quantity". Die KI liest die Spaltenüberschriften semantisch – sie versteht, dass „Price Each" und „Unit Price" dasselbe bedeuten – und ordnet jeden Wert der richtigen Ausgabespalte zu.
Summen, Rabatte und Steuern. Am Ende der Positionszeilentabelle oder in einem separaten Summenbereich liest die KI die Zwischensumme (Summe aller Positionszeilen vor Anpassungen), jeden angewandten Rabatt (prozentual oder als fester Betrag), den Steuersatz und -betrag (der je nach Rechtsgebiet variiert — VAT, GST, Sales Tax oder HST), Versand- und Bearbeitungskosten sowie die Gesamtsumme. Jeder dieser Beträge wird durch seine Position im Summenblock und seine semantische Beziehung zu den darüberliegenden Positionszeilen eindeutig zugeordnet. Der Betrag direkt unter der letzten Positionszeile ist die Zwischensumme. Der Betrag nach einer Zeile mit der Bezeichnung „Discount 2% Net 30“ ist ein Rabatt. Der Betrag nach „Tax“, „VAT“ oder „GST“ ist der Steuerbetrag. Der Betrag ganz unten in der Spalte, typischerweise fett oder in größerer Schrift, ist die Gesamtsumme.
Dieser Durchlauf behandelt eine einzelne Bestellung von einem einzelnen Kunden. Stellen Sie sich nun vor, Sie wiederholen das für 15 Kunden, jeder mit einem anderen Layout. Die KI verarbeitet alle 15 im selben Batch, mit denselben Spaltendefinitionen, und gibt eine einzige konsolidierte Tabelle aus. Für eine tiefere Erklärung des zugrunde liegenden Mechanismus lesen Sie unseren Leitfaden zu den Grundlagen der PO-Datenextraktion — die Dokumentstruktur ist dieselbe, aber die Extraktionsanforderungen des Verkäufers fügen die Ebene hinzu, Kundenformate auf interne SO-Felder abzubilden.
Warum das funktioniert — Semantische Extraktion ersetzt die Einrichtung von Vorlage zu Vorlage
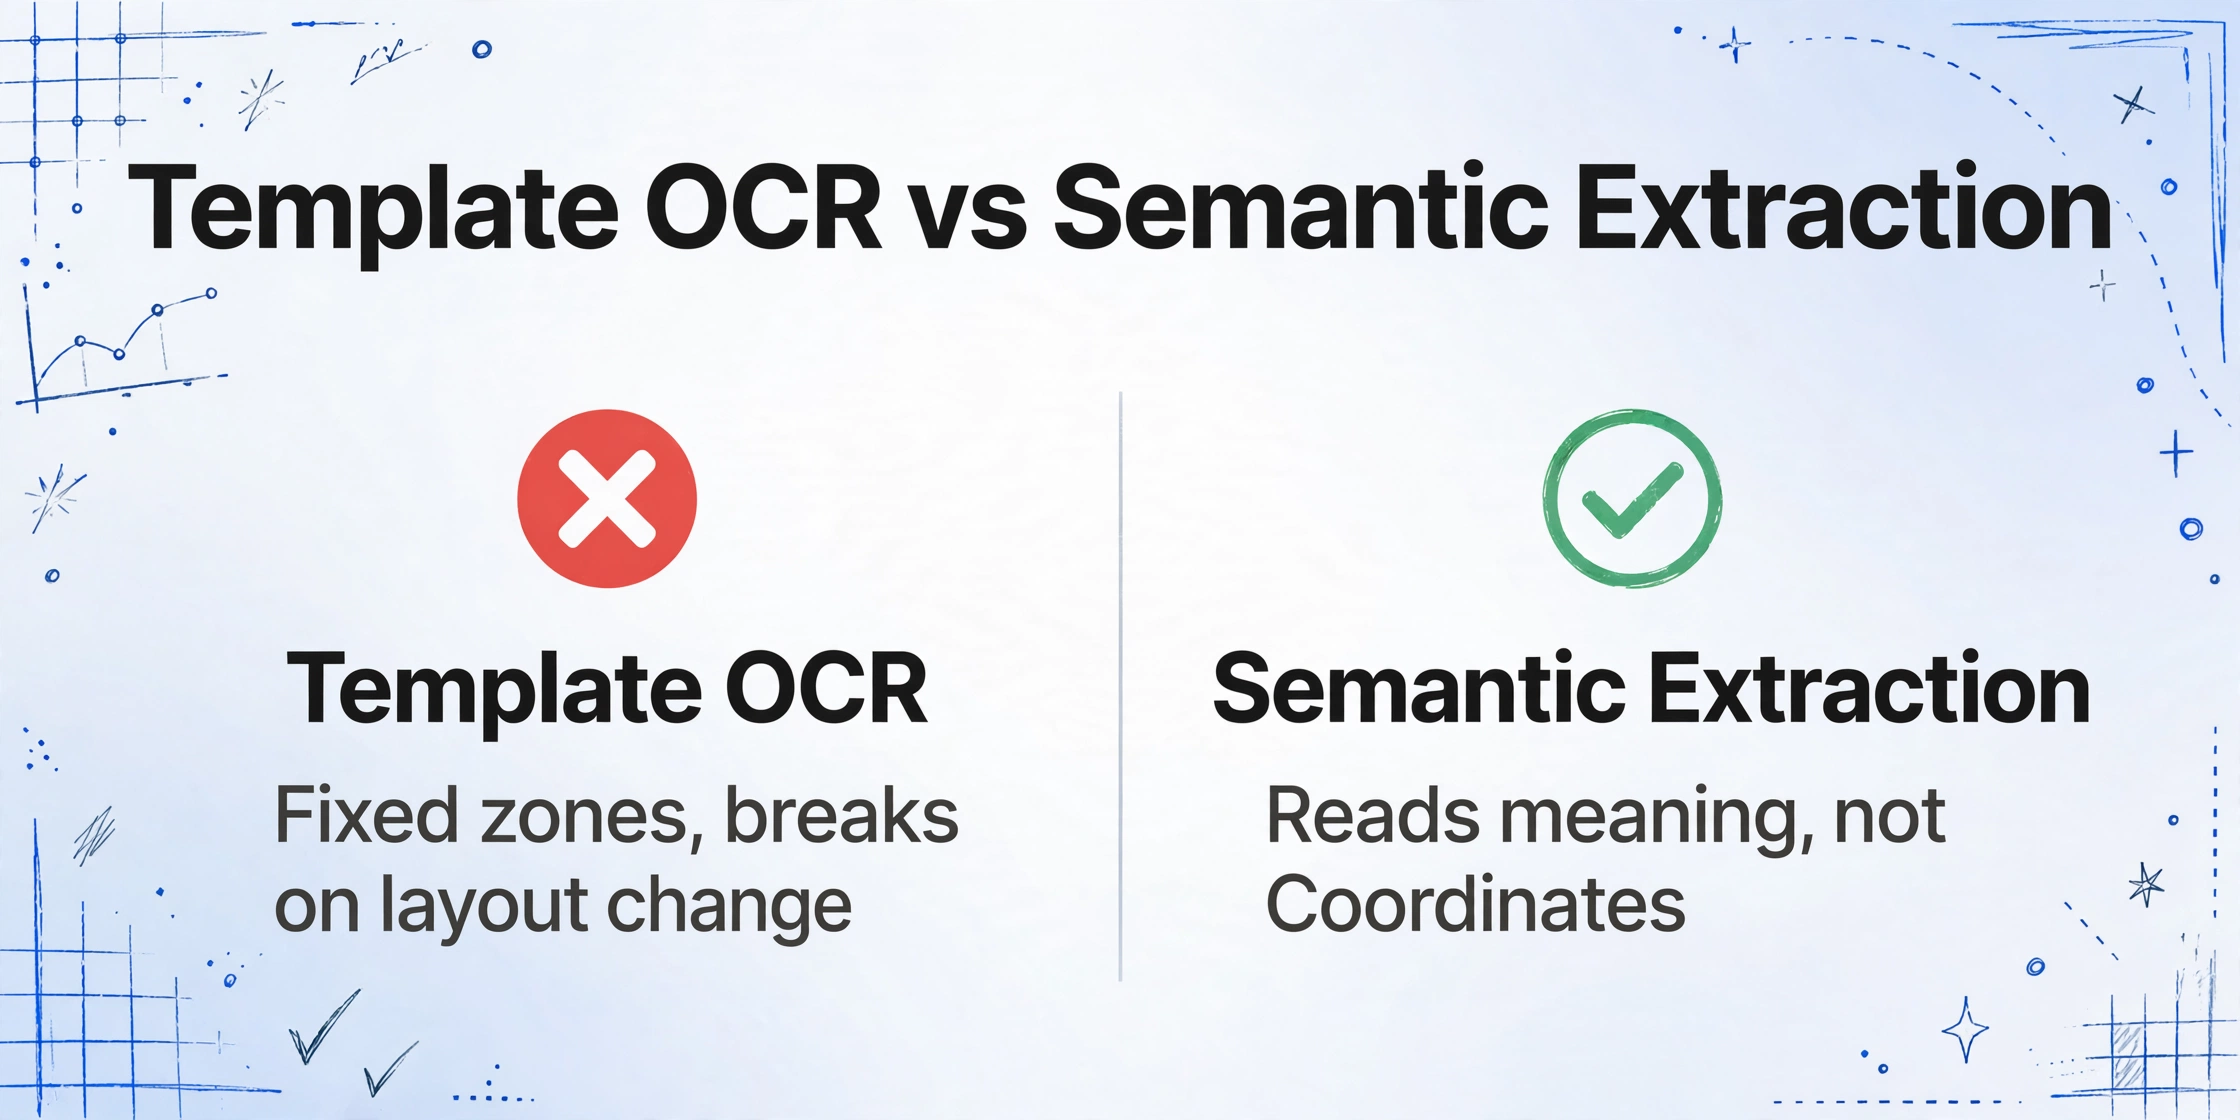
Der Grund, warum die KI ein Dutzend verschiedener Kundenbestellungen in einem einzigen Durchgang lesen kann, ist nicht, dass sie für jedes Format eine Vorlage hat. Sie hat überhaupt keine Vorlagen. Der Mechanismus heißt Benutzerdefinierte Spaltenextraktion und funktioniert, indem er die traditionelle Extraktionslogik umkehrt.
Traditionelle template-basierte OCR-Tools erfordern, dass Sie feste Zonen auf einem Beispieldokument für jedes Feld definieren — „der Stückpreis liegt bei den Koordinaten (200, 450) bis (300, 470).“ Wenn ein zweiter Kunde eine Bestellung mit dem Stückpreis an einer anderen Position sendet, stimmt die Zone nicht mehr überein und die Extraktion bricht. Sie erstellen eine zweite Vorlage. Dann eine dritte. Jedes Mal, wenn ein Kunde sein Formularlayout aktualisiert — was häufiger passiert, als die meisten Teams nachverfolgen — bricht Ihre Vorlage und Sie müssen sie warten. Das sind die versteckten Kosten der template-basierten Extraktion: nicht die Einrichtungszeit pro Kunde, sondern die Wartungszeit über alle Kunden hinweg über Monate und Jahre.
Semantische Extraktion eliminiert die Vorlagenebene vollständig. Statt zu fragen „Wo ist dieses Feld?“ fragt sie „Was ist dieses Feld?“ — und die Antwort hängt nicht vom Layout des Dokuments ab.
So funktioniert es in der Praxis. Sie definieren Ihre Ausgabespalten einmal — „Customer PO Number“, „Item Code“, „Quantity Ordered“, „Unit Price“, „Line Total“, „Ship To Address“, „Requested Ship Date“ — und speichern sie als Vorlage (das ist Ihre persönliche Spaltenvorlage, keine Dokumentvorlage pro Kunde). Wenn Sie eine Kundenbestellung hochladen, liest die KI das Dokument als Ganzes, identifiziert jedes Feld anhand seiner semantischen Bedeutung im Dokumentlayout und ordnet es dem von Ihnen definierten passenden Spaltennamen zu.
Deshalb funktioniert dieselbe Spaltendefinition, ob ein Kunde das Feld „Unit Price“, „Price Each“, „单价“ (Chinesisch) oder „Precio Unitario“ (Spanisch) nennt — die KI versteht, was jede Phrase bedeutet, nicht, welche Zeichen sie enthält. Und deshalb bricht eine Layoutänderung des Kunden (z. B. das Verschieben des „Ship To“-Blocks von oben rechts nach unten links zwischen Formatversionen) die Extraktion nicht: Die KI sucht nach der Bedeutung von „Ship To“, nicht nach seinen Pixelkoordinaten.
Wenn bei Bestellungen die Positionssumme nicht gedruckt wird – nur Menge und Einzelpreis erscheinen – können Sie eine berechnete Spalte verwenden. Benennen Sie Ihre Spalte „Line Total (Qty × Unit Price)“ und die KI führt die Multiplikation während der Extraktion durch und fügt den berechneten Wert Ihrer Ausgabe hinzu, ohne dass eine Nachbearbeitung in Excel erforderlich ist. Dies ist eine von mehreren Extraktionsverbesserungen, die die Ausgabe ohne manuelle Bereinigung für Ihr ERP- oder Auftragsverwaltungssystem bereit machen. Eine vollständige Anleitung zum Workflow der Verkaufsauftragsextraktion von Anfang bis Ende finden Sie in unserem Leitfaden für Verkaufsaufträge in Excel.
Wo es dennoch haken kann – ehrliche Grenzen
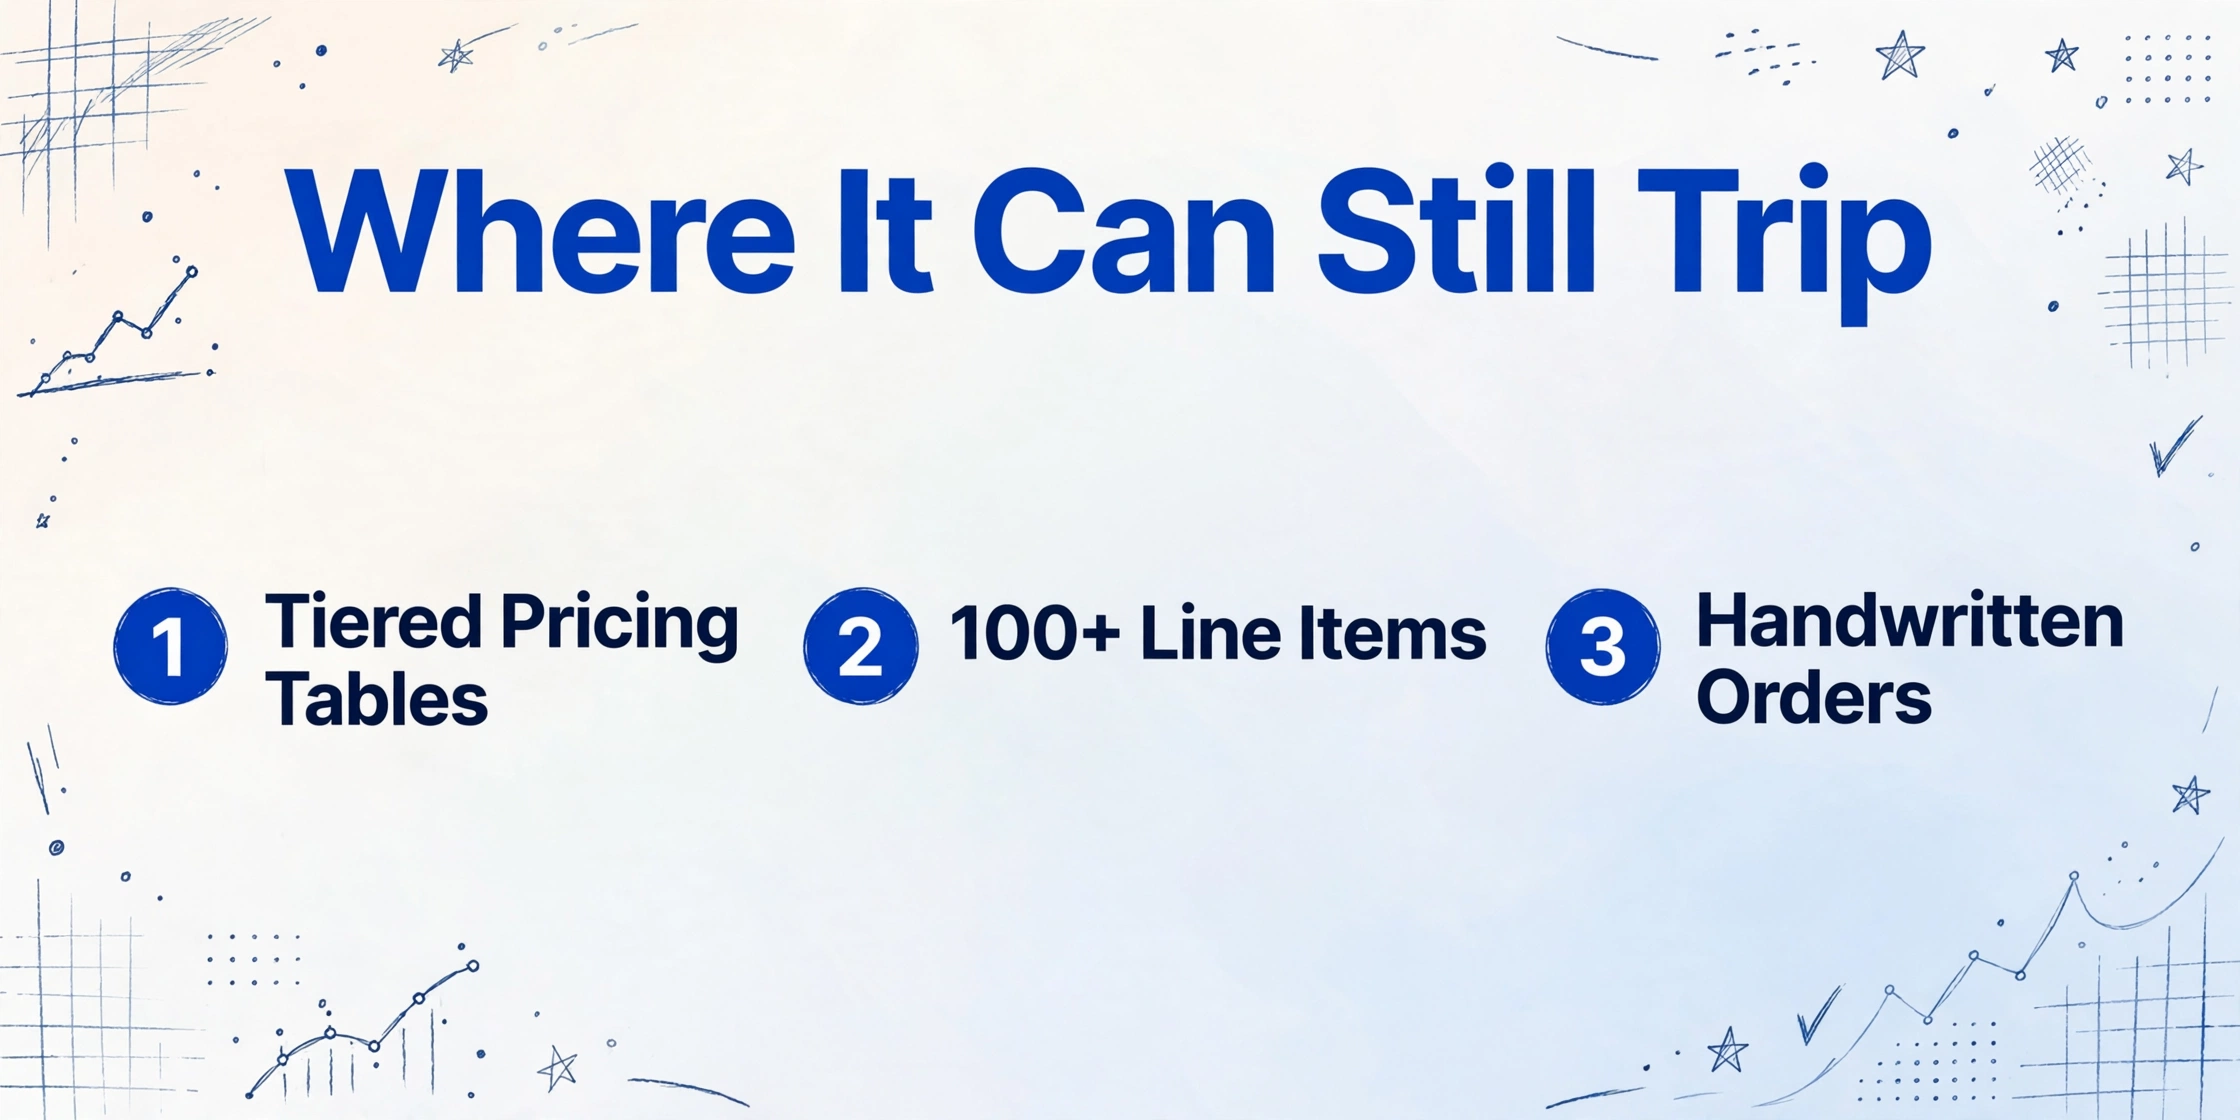
Kein Extraktionstool ist bei jedem Dokument perfekt. Die folgenden Szenarien erfordern besondere Aufmerksamkeit, und sie im Voraus zu kennen, spart mehr Zeit, als sie erst in der Produktion zu entdecken.
Komplexe Preisstaffel- und Rabatt-Tabellen. Wenn die Bestellung eines Kunden eine Mengenstaffel-Preistabelle enthält – „$10/Einheit für 1-50 Einheiten, $8,50/Einheit für 51-200 Einheiten“ – die als separate Tabelle neben den Positionen angezeigt wird, kann die KI einer Position die falsche Preisstufe zuordnen, wenn die Stufengrenzen implizit sind (nicht in jeder Zeile wiederholt) oder wenn die Preistabelle und die Positionstabelle nicht visuell verbunden sind. Die KI liest jede Tabelle unabhängig, aber die Zuordnung der bestellten Menge einer Position zur richtigen Zeile in einer separaten Preistabelle erfordert mehrstufiges Denken, das bei einer menschlichen Prüfung zuverlässiger ist als bei einem einzigen Extraktionsdurchlauf. Empfehlung: Prüfen Sie bei Bestellungen mit separaten Rabatt- oder Preisstufen die Einzelpreise der ersten Bestellungen dieses Kunden stichprobenartig. Sobald Sie bestätigt haben, dass die KI Preise der richtigen Stufe zuordnet, können Sie nachfolgenden Bestellungen desselben Kunden vertrauen – aber überprüfen Sie die erste Charge.
Sehr große Bestellungen (100+ Positionen) über mehrere Seiten. Die KI verarbeitet mehrseitige Dokumente nativ – sie liest die Positionstabelle über Seitenumbrüche hinweg und zählt die Zeilen weiter. Aber wenn eine einzelne Bestellung 150 Positionen über 6 Seiten verteilt hat, steigt die Wahrscheinlichkeit eines Seitenumbruch-Artefakts (eine Zeile, die über Seiten geteilt wird, ohne dass die Spaltenüberschriften wiederholt werden). Das visuelle Modell der KI kann diese Fälle in der Regel bewältigen, da es Tabellenstrukturen versteht, aber die Fehlerrate pro Zeile steigt mit der Gesamtzahl der Zeilen. Empfehlung: Scrollen Sie bei Bestellungen mit mehr als 100 Positionen durch die extrahierte Ausgabe und prüfen Sie die Gesamtzahl der Zeilen gegen die Bestellzeilenzahl. Die meisten Abweichungen treten an Seitenumbrüchen auf und sind leicht zu erkennen.
Stark beschädigte Durchschläge und Faxbestellungen. Wenn ein Kunde Bestellungen weiterhin per Fax oder Durchschlagformular sendet, kann die Textqualität unter dem liegen, was die KI zuverlässig lesen kann. Blasse Zeichen, verschmierte Zahlen und handschriftliche Randnotizen können zu Fehllesungen führen – „1.000 Einheiten“ wird zu „100 Einheiten“, wenn die dritte Null unleserlich ist. Empfehlung: Richten Sie einen Workflow zur Kennzeichnung geringer Konfidenz ein. Die KI gibt für jeden extrahierten Wert einen Konfidenzwert zurück; konfigurieren Sie Ihren Prozess so, dass alle Werte unterhalb eines Konfidenzschwellenwerts überprüft werden. Dies fängt die Fälle beschädigter Dokumente ab, ohne dass jede saubere Bestellung manuell geprüft werden muss.
Kundenbestellnummern mit Sonderzeichen oder Leerzeichen. Manche Bestellnummern enthalten Bindestriche, Schrägstriche oder eingebettete Leerzeichen, die semantisch Teil der Nummer sind (z. B. „PO-2026-0715“), aber durch das Dokumentlayout fragmentiert werden können. Die KI liest Text in visuellen Blöcken, daher kann eine über zwei Zeilen verteilte Bestellnummer als zwei getrennte Tokens rekonstruiert werden. Empfehlung: Überprüfen Sie nach der Extraktion die Spalte „Customer PO Number“ auf Werte, die abgeschnitten oder aufgeteilt erscheinen. Die KI verarbeitet Standardformate in der Regel gut, aber ungewöhnliche Layouts mit fragmentierten Bestellnummern profitieren von einer schnellen visuellen Prüfung der Ausgabespalte.
Diese Einschränkungen sind keine Ausschlusskriterien – sie sind Überlegungen zur Prozessgestaltung. Das gilt für jedes Extraktionstool, und die ehrlichen sagen Ihnen, worauf Sie achten müssen. Für einen umfassenderen Rahmen zur Bewertung, ob KI-Extraktion für Ihr Team geeignet ist, lesen Sie unseren praktischen Leitfaden zur Verbesserung der Extraktionsgenauigkeit.
Der Unterschied zwischen einem Extraktionstool, das Ihre Verkaufsaufträge verarbeitet, und einem, das mehr Arbeit verursacht, liegt nicht darin, ob es Fehler macht – jedes Tool macht Fehler. Der Unterschied liegt darin, ob es vorhersehbare Fehler bei Dokumenten macht, die Sie testen können, oder unvorhersehbare Fehler bei Dokumenten, die Sie nicht testen können. Semantische Extraktion über Vorlagen bedeutet, dass die KI konsistent bei bestimmten Dokumentbedingungen versagt (gestaffelte Preise, qualitätsgeminderte Scans), die Sie testen, stichprobenartig prüfen und in einen Prozess einbauen können – anstatt zufällig zu versagen, wenn ein Kunde sein Formularlayout aktualisiert und Ihre Vorlage bricht.
Eine Entscheidungs-Checkliste – Ist Ihr Verkaufsauftragsprozess bereit für KI?
Nicht jeder Auftragsverarbeitungs-Workflow ist gleichermaßen für KI-Extraktion geeignet. Die folgenden fünf Fragen helfen Ihnen zu bestimmen, wo Extraktion den größten Mehrwert liefert und wo sie menschliche Unterstützung benötigt.
1. Wie viele verschiedene Kundenauftragsformate erhalten Sie? Wenn Sie Aufträge von 5 Kunden mit 5 Standardformaten verarbeiten, kann vorlagenbasierte OCR ausreichend sein – Sie investieren die Einrichtungszeit einmal pro Kunde, und die Wartungskosten sind überschaubar. Wenn Sie Aufträge von 20, 50 oder 200 Kunden verarbeiten, jeweils mit eigenem Layout – was für die meisten Distributoren, Großhändler und B2B-Hersteller die Realität ist – wird semantische Extraktion nicht nur schneller, sondern strukturell notwendig. Vorlagenkosten skalieren linear mit der Kundenzahl. Semantische Extraktion skaliert mit nahezu null Grenzkosten pro neuem Kunden.
2. Wie strukturiert sind die Aufträge, die Sie erhalten? KI-Extraktion funktioniert am besten bei Aufträgen mit klarer Kopf-Body-Summen-Struktur – ERP-generierte PDF-Bestellungen, Standard-Auftragsbestätigungsformulare und getippte oder gedruckte Bestelldokumente. Sie funktioniert mäßig gut bei per E-Mail gesendeten Tabellenkalkulationen oder CSV-Anhängen (die KI liest tabellarische Daten in Anhängen). Sie ist nicht ideal für freie E-Mail-Texte, die in Absatzform beschreiben, was der Kunde möchte, ohne strukturierte Felder – diese erfordern Verständnis natürlicher Sprache, das besser von speziell entwickelten E-Mail-Parsing-Tools übernommen wird. Wenn 80 % Ihrer Aufträge als strukturierte PDFs aus Kunden-ERP-Systemen eintreffen, automatisiert KI-Extraktion den Großteil Ihrer Arbeitslast.
3. Wie hoch ist Ihre Fehlertoleranz je Feldtyp? Nicht alle Felder bergen das gleiche Risiko. Ein Fehler bei „Requested Ship Date" (falsches Datum erfasst) kann zu Lieferverzögerungen führen, wird aber meist erkannt, wenn das Lager keinen Auftrag für dieses Datum findet. Ein Fehler bei „Customer PO Number" (falsche Referenz erfasst) kann den Drei-Wege-Abgleich stören und die Umsatzrealisierung verzögern. Ein Fehler bei „Quantity Ordered" (100 statt 1.000 erfasst) kann zu Unterlieferung, Nachbestellkosten und einem enttäuschten Kunden führen. Legen Sie Ihre Fehlertoleranz pro Feld fest, bevor Sie die Extraktion einrichten – und priorisieren Sie Stichprobenkontrollen bei risikoreichen Feldern (Mengen, PO-Nummern, Rabatte) gegenüber risikoarmen Feldern (Firmennamen, allgemeine Daten).
4. Können Sie Ihre Auftragsverarbeitung bündeln? Die KI-Extraktion ist für die Batch-First-Verarbeitung konzipiert – laden Sie mehrere Aufträge gleichzeitig hoch, verarbeiten Sie sie gemeinsam und prüfen Sie die konsolidierten Ergebnisse. Wenn Ihr aktueller Workflow Aufträge einzeln verarbeitet, sobald sie eintreffen (E-Mail öffnen, Daten eingeben, nächste E-Mail), liegt der eigentliche Effizienzgewinn im Bündeln. Dies kann eine Prozessänderung erfordern: Aufträge den Vormittag über sammeln, den Batch vor dem Mittagessen verarbeiten, Ausnahmen am Nachmittag prüfen. Die Zeit pro Auftrag sinkt von 3–5 Minuten Tipparbeit auf 10 Sekunden KI-Verarbeitung plus 20 Sekunden Batch-Validierung.
5. Ändern Ihre Kunden ihr Auftragsformat ohne Vorwarnung? Das sind die versteckten Kosten der vorlagenbasierten Extraktion, die die meisten Entscheider erst bemerken, wenn es passiert. Ein Kunde aktualisiert sein ERP-System und das Layout seiner Bestellungen ändert sich. Die Vorlage, die Sie letztes Jahr erstellt haben, extrahiert nichts Brauchbares mehr. Sie merken das, wenn ein Batch von 30 Aufträgen dieses Kunden mit null Daten verarbeitet wird – und Sie alle 30 manuell neu eingeben müssen. Die semantische Extraktion absorbiert Formatänderungen, weil sie nicht vom Format abhängt. Die KI liest jeden Auftrag unabhängig nach Bedeutung, sodass eine Layoutänderung eines Kunden keinerlei Auswirkung auf die Extraktionsqualität hat. Wenn Sie schon einmal den Moment erlebt haben, in dem „der Kunde sein Formular aktualisiert hat und unsere Automatisierung kaputtging", ist dies das stärkste Argument für den Wechsel von vorlagenbasierter zu semantischer Extraktion.
Eine ausführlichere Anleitung zum Aufbau eines End-to-End-Workflows für die Bestellextraktion – einschließlich Sammellink-Einrichtung, damit Kunden ihre eigenen Aufträge hochladen können, Batch-Verarbeitung mit ERP-fähigen Ausgaben und Integrationsmustern – finden Sie in unserem vollständigen Leitfaden zur Bestellextraktion (Teil 3 unserer Serie zur Order-to-Cash-Extraktion).
Dateien werden sicher verarbeitet und nicht gespeichert.
Häufig gestellte Fragen
Kann KI Bestelldaten aus handschriftlichen Aufträgen extrahieren?
Teilweise. Moderne Bild-KI erkennt Handschrift bei gut lesbaren Bestellungen mit 85–95 % Genauigkeit – deutlich besser als herkömmliche OCR, die bei Schreibschrift oder gemischter Handschrift meist unter 50 % liegt. Handschriftliche Formulare mit Randnotizen, Durchstreichungen oder Korrekturen erhöhen jedoch die Fehleranfälligkeit. Wenn Ihre Kunden handschriftliche Bestellungen per Fax oder Foto senden, planen Sie eine höhere manuelle Prüfquote ein (100 % Prüfung von Mengen und Preisen empfohlen, da hier die höchsten Fehlerkosten entstehen). Gedruckte oder digitale PDF-Bestellungen aus ERP-Systemen der Kunden haben diese Einschränkung nicht und werden mit 95–99 % Genauigkeit bei minimaler Prüfung verarbeitet.
Verarbeitet die KI mehrseitige Aufträge mit positionsübergreifenden Zeilen?
Ja. Die KI liest das gesamte Dokument als eine visuelle Einheit – sie folgt der Positionszeilen-Tabelle über Seitenumbrüche hinweg und extrahiert die Zeilen in der richtigen Reihenfolge. Voraussetzung ist, dass die Spaltenüberschriften auf jeder Seite wiederholt werden (wie bei den meisten ERP-generierten Bestellungen). Fehlen die Überschriften auf Folgeseiten, kann die KI die Zeilenstruktur dennoch aus der Spaltenanordnung ableiten. Prüfen Sie jedoch die erste mehrseitige Bestellung jedes Kunden, um sicherzustellen, dass das Tabellenlayout korrekt interpretiert wird.
Was ist, wenn eine Bestellung eine andere Währung oder Maßeinheit verwendet?
Die KI extrahiert die Werte so, wie sie im Dokument erscheinen – sie liest „$2.450,00 USD“ als Betrag und das Währungssymbol als Präfix oder Suffix. Die Ausgabe enthält die Originalwerte inklusive Währungssymbole und Maßeinheiten-Abkürzungen (ST, KG, LB, M, L). Für den ERP-Import können Sie in Ihrer Tabellenkalkulation eine Nachbearbeitungslogik konfigurieren oder eine Berechnete Spalte verwenden, um Einheiten während der Extraktion umzurechnen (z. B. „Gewicht in KG (LBS × 0,4536)“). Die KI führt keine automatische Währungsumrechnung durch – dies ist eine Geschäftslogik-Entscheidung, die besser in Ihrem ERP oder einer Formelspalte in der Ausgabetabelle umgesetzt wird.
Kann ich ein System einrichten, bei dem Kunden ihre Bestellungen selbst hochladen und diese automatisch verarbeitet werden?
Ja. Erstellen Sie einen Sammlungslink – eine teilbare URL, über die jeder Dateien direkt in die Verarbeitungswarteschlange Ihres Kontos hochladen kann, ohne sich registrieren oder anmelden zu müssen. Teilen Sie diesen Link mit Ihren Kunden, und deren Bestellungen landen nach Eingang in Ihrer Warteschlange. Sie verarbeiten den Batch nach Ihrem Zeitplan, prüfen Ausnahmen und exportieren die konsolidierten Daten. Dies eliminiert die Kette „Herunterladen aus E-Mail → Speichern im Ordner → Hochladen ins Tool“ und reduziert den Aufwand beim Sammeln von Bestellungen von Dutzenden Kunden. Für wiederkehrende Kunden können Sie Ihre Spaltenkonfiguration als Vorlage speichern, sodass jeder Batch dieselben Extraktionsspalten verwendet, ohne Feldnamen erneut eingeben zu müssen.
Wie verarbeitet die KI Bestellungen, die sowohl mengenbasierte Artikel als auch Dienstleistungspositionen (Stundensätze) enthalten?
Sie liest beide Typen auf die gleiche Weise – jede Zeile in der Positionstabelle wird mit Artikelcode, Beschreibung, Menge oder Stunden, Einzelpreis (pro Stück oder pro Stunde) und Zeilensumme extrahiert. Die KI unterscheidet bei der Extraktion nicht zwischen Artikeltypen, es sei denn, Sie fordern dies an. Wenn Sie in Ihrer Ausgabe physische Waren von Dienstleistungen trennen müssen, definieren Sie zwei Extraktionsdurchläufe: einen mit einer Spalte namens „Artikeltyp“, und die KI leitet aus der Beschreibung ab, ob es sich um ein Produkt oder eine Dienstleistung handelt. Alternativ verwenden Sie eine Berechnete Spalte mit bedingter Logik – „wenn Beschreibung 'Stunde' oder 'Beratung' enthält, dann 'Dienstleistung', sonst 'Produkt'“ – um Zeilen während der Extraktion zu klassifizieren.
Mit welcher Fehlerrate sollte ich bei der Extraktion von Verkaufsbestellungen im Produktivbetrieb rechnen?
Bei sauberen, gedruckten Bestellungen im Standardformat (wie sie von bekannten ERP-Systemen erzeugt werden) liegt die Feldgenauigkeit bei 95-99 % für Kopffelder und 92-97 % für Positionsfelder, abhängig von der Tabellenkomplexität. Bei Bestellungen mit komplexen Layouts – Preisstaffeltabellen, Rabattgittern, positionsübergreifenden Seiten – sinkt die Genauigkeit auf 85-92 % und erfordert mehr manuelle Stichprobenprüfungen. Diese Zahlen entsprechen den Benchmarks Dritter für KI-Dokumentenextraktion über Dokumenttypen hinweg: gedruckte strukturierte Dokumente schneiden am besten ab, gemischte Formate erfordern moderate Prüfung, und minderwertige Scans benötigen die meiste manuelle Validierung. Die entscheidende Betriebskennzahl ist nicht die Durchschnittsgenauigkeit – es ist die Prüfzeit pro Bestellung nach der Extraktion. Ein Rückgang von 5 Minuten manueller Eingabe auf 1 Minute Ausnahmenprüfung bedeutet einen 5-fachen Produktivitätsgewinn, selbst wenn die Genauigkeit nicht perfekt ist.
Die Frage „Kann KI Bestellungen lesen?“ hat eine klare Antwort: ja – und die Technologie ist ausgereift genug, um die Formatvielfalt zu bewältigen, die die manuelle Bestellungseingabe so kostspielig macht. Die eigentliche Frage ist, wie viel Ihres spezifischen Workflows Sie auf reine Ausnahmenprüfung stützen können, im Vergleich zu einer zeilenweisen Validierung. Die Antwort hängt von Ihrem Kundenmix, der Dokumentqualitätsverteilung und der feldbezogenen Risikotoleranz ab – aber es ist eine Frage, die Sie an einem einzigen Nachmittag mit Tests an Ihren eigenen Bestellungen beantworten können. Laden Sie 10 Bestellungen von 10 verschiedenen Kunden hoch, richten Sie Ihre Spaltennamen einmal ein und sehen Sie, was zurückkommt. Das Ergebnis sagt Ihnen mehr als tausend Worte über die Extraktionsgenauigkeit.
Wenn Sie bereit sind, die KI-Extraktion an Ihren tatsächlichen Bestellungen zu evaluieren, beginnen Sie mit unserem Tool zur Umwandlung von Bestellungen in Excel – laden Sie eine Musterbestellung hoch und sehen Sie, was die KI ohne Vorlageneinrichtung extrahiert. Für den vollständigen Workflow – inklusive Batch-Verarbeitung, Sammlungslink-Einrichtung und ERP-fähigem Export – lesen Sie die vollständige Anleitung zur Bestellungsextraktion.