L'IA peut-elle lire les bons de commande ?
Oui — quel que soit le format client
Oui. L'IA moderne peut extraire les champs d'en-tête et les lignes d'article des bons de commande — y compris les références de bon de commande client, les codes article, les quantités, les prix unitaires, les remises, les taxes, les adresses de livraison et les dates de livraison — quel que soit le nombre de formats clients, sans configuration de modèle par client. La distinction clé est une question de perspective : le document que vous recevez d'un client est techniquement son bon de commande, mais pour vous, il devient la source de données pour créer votre bon de commande client. L'IA le lit comme vous le feriez — comme une demande de biens ou de services — et extrait les champs dont vous avez besoin, que le client les appelle « PO No. », « Order Ref. » ou « Customer # ». Sur des commandes PDF imprimées ou numériques propres, la précision au niveau des champs atteint 95 à 99 %, avec les résultats les plus fiables sur les bons de commande standard générés par ERP.
Points clés à retenir
- Un outil OCR basé sur des modèles fonctionne parfaitement sur le bon de commande d'un client — jusqu'à ce qu'il mette à niveau son ERP et déplace le bloc Ship To vers une nouvelle position, cassant silencieusement le modèle et renvoyant zéro donnée d'un lot de 30 commandes dont vous ne découvrez qu'il est vide qu'après le traitement.
- Le coût caché de l'extraction basée sur des modèles n'est pas la configuration — c'est la maintenance qui s'accumule avec chaque client : chaque changement de format casse silencieusement un modèle différent, et la panne apparaît en production lorsque vous traitez un lot en urgence, et non lors d'une vérification planifiée.
- L'extraction sémantique élimine entièrement les modèles — elle lit Ship To par le sens plutôt que par les coordonnées, de sorte que la même définition de colonne gère 50 formats clients à la fois et qu'un changement de mise en page d'un seul client n'a aucun impact sur la qualité de l'extraction.
Démonstration d'un bon de commande réel — Ce que l'IA lit, champ par champ
Parcourons un bon de commande client typique qui arrive dans votre boîte de réception — une pièce jointe PDF d'un détaillant demandant 50 unités d'un article avec 3 variantes de couleur, un entrepôt de livraison sur la côte Ouest et une date de livraison demandée à trois semaines. Ce n'est pas un cas limite. C'est la réalité quotidienne du traitement des commandes pour des milliers de vendeurs B2B. Voici exactement ce que l'IA lit et où elle trouve chaque champ.
Bloc d'en-tête. L'IA commence par identifier les zones structurelles du document, tout comme vous le faites lorsque vous ouvrez un PDF. Dans la section supérieure — l'en-tête — elle lit le nom et l'adresse de l'entreprise cliente, le numéro de bon de commande (souvent libellé « PO No. », « PO # », « Customer Ref. » ou « Order No. »), la date d'émission du PO et la date de livraison demandée ou la date « Ship by ». Chacun de ces champs est localisé par sa signification sémantique dans la zone d'en-tête, et non en faisant correspondre une chaîne de libellé à une coordonnée fixe sur la page. Un libellé « Req. Ship Date » est reconnu comme la date de livraison. Un libellé « Date » adjacent au numéro de PO dans l'en-tête est reconnu comme la date d'émission. C'est la même désambiguïsation qu'une personne effectue sans réfléchir — sauf que l'IA le fait sur chaque document, à chaque fois, sans se fatiguer.
Adresses de livraison vs. de facturation. La plupart des bons de commande clients incluent deux blocs d'adresses : où les marchandises doivent être livrées et où la facture doit être envoyée (facturation). L'IA les distingue en lisant le libellé au-dessus de chaque bloc et en comprenant la relation entre l'adresse et le contenu environnant. Le bloc d'adresse libellé « Ship To », « Deliver To » ou « Delivery Location » est capturé comme destination d'expédition — c'est l'adresse qui détermine les frais de transport, les délais de livraison et l'acheminement de l'exécution. Le bloc d'adresse libellé « Bill To » ou adjacent aux informations « Remit To » est capturé séparément. Sur les commandes où les deux blocs manquent de libellés explicites — juste deux adresses imprimées côte à côte — l'IA s'appuie sur des heuristiques positionnelles : l'adresse plus proche du haut du document, alignée avec l'en-tête du client, est l'adresse de facturation, tandis que l'adresse dans une section inférieure distincte ou alignée avec les instructions de livraison est l'adresse de livraison.
Lignes d'article. L'IA identifie le tableau des lignes d'article par sa structure — une grille multi-colonnes dans le corps du document avec des en-têtes de colonnes comme « Item No. », « Description », « Qty », « Unit Price » et « Total ». Chaque ligne de ce tableau est lue comme une ligne d'article. Le code article (SKU ou numéro de pièce), la description de l'article, la quantité commandée, le prix unitaire et le total de la ligne sont tous extraits par ligne, indépendamment de l'ordre des colonnes ou des variations de dénomination entre clients. Le tableau d'un client a des colonnes dans l'ordre « Qty | Item Code | Description | Unit Price | Total » et utilise « EAN » au lieu de « Item Code ». Le tableau d'un autre client indique « Part # | Description | Price Each | Quantity ». L'IA lit les en-têtes de colonnes sémantiquement — elle comprend que « Price Each » et « Unit Price » signifient la même chose — et mappe chaque valeur à la colonne de sortie correcte.
Totaux, remises et taxes. En bas du tableau des lignes d'articles ou dans une section distincte des totaux, l'IA lit le sous-total (somme de tous les totaux de ligne avant ajustements), toute remise appliquée (pourcentage ou montant fixe), le taux et le montant de la taxe (qui varie selon la juridiction — TVA, GST, taxe de vente ou HST), les frais d'expédition et de manutention, et le total général. Chacun de ces montants est désambiguïsé par sa position dans le bloc des totaux et sa relation sémantique avec les lignes d'articles ci-dessus. Le montant immédiatement sous la dernière ligne d'article est le sous-total. Le montant après une ligne intitulée « Discount 2% Net 30 » est une remise. Le montant après « Tax », « VAT » ou « GST » est le montant de la taxe. Le montant tout en bas de la colonne, généralement en gras ou dans une police plus grande, est le total général.
Cette procédure couvre une seule commande d'un seul client. Imaginez maintenant la répéter pour 15 clients, chacun avec une mise en page différente. L'IA traite les 15 dans le même lot, avec les mêmes définitions de colonnes, et génère une feuille de calcul consolidée unique. Pour une explication plus approfondie du mécanisme sous-jacent, lisez notre guide des fondamentaux de l'extraction de données PO — la structure du document est la même, mais les besoins d'extraction du vendeur ajoutent la couche de mappage des formats clients vers les champs SO internes.
Pourquoi cela fonctionne — l'extraction sémantique remplace la configuration modèle par modèle
La raison pour laquelle l'IA peut lire une douzaine de commandes clients différentes en une seule passe n'est pas qu'elle dispose d'un modèle pour chaque format. Elle n'a aucun modèle du tout. Le mécanisme s'appelle Extraction de colonnes personnalisées, et il fonctionne en inversant la logique d'extraction traditionnelle.
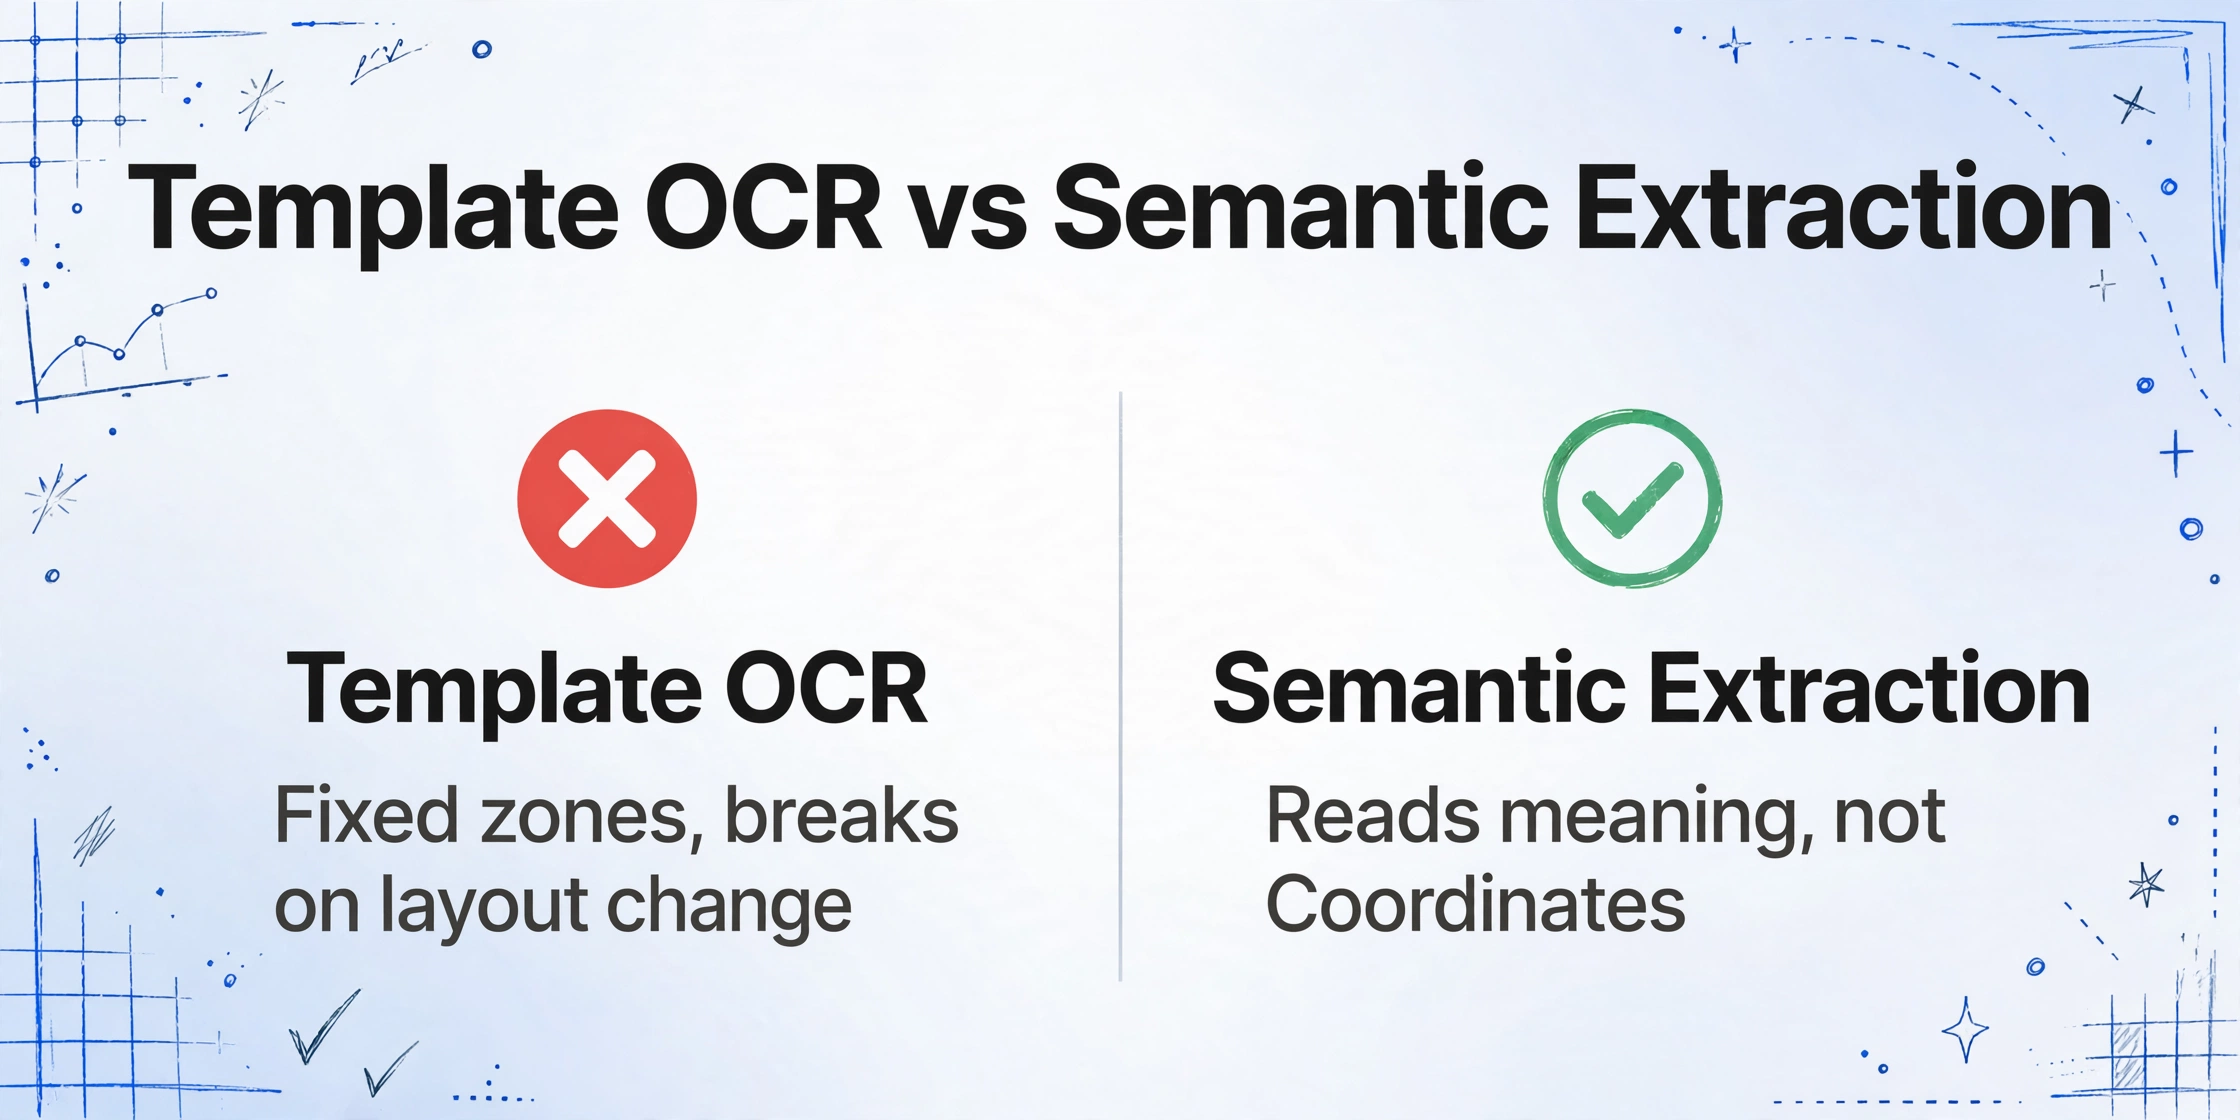
Les outils OCR traditionnels basés sur des modèles exigent de définir des zones fixes sur un document échantillon pour chaque champ — « le prix unitaire se trouve aux coordonnées (200, 450) à (300, 470) ». Lorsqu'un deuxième client envoie une commande avec le prix unitaire à une position différente, la zone ne correspond plus et l'extraction échoue. Vous créez un deuxième modèle. Puis un troisième. Chaque fois qu'un client met à jour la mise en page de son formulaire — ce qui arrive plus souvent que la plupart des équipes ne le suivent — votre modèle casse et vous devez le maintenir. C'est le coût caché de l'extraction basée sur des modèles : non pas le temps de configuration par client, mais le temps de maintenance sur tous les clients, mois après mois, année après année.
L'extraction sémantique élimine entièrement la couche de modèles. Au lieu de demander « où se trouve ce champ ? », elle demande « qu'est-ce que ce champ ? » — et la réponse ne dépend pas de la mise en page du document.
Voici comment cela fonctionne en pratique. Vous définissez vos colonnes de sortie une seule fois — « Customer PO Number », « Item Code », « Quantity Ordered », « Unit Price », « Line Total », « Ship To Address », « Requested Ship Date » — et vous les enregistrez comme modèle (il s'agit de votre modèle de colonnes personnel, pas d'un modèle de document par client). Lorsque vous téléchargez le bon de commande d'un client, l'IA lit le document dans son ensemble, identifie chaque champ par sa signification sémantique dans la mise en page du document, et le mappe au nom de colonne correspondant que vous avez défini.
C'est pourquoi la même définition de colonnes fonctionne, que le client libelle le champ « Unit Price », « Price Each », « 单价 » (chinois) ou « Precio Unitario » (espagnol) — l'IA comprend ce que chaque phrase signifie, pas quels caractères elle contient. Et c'est pourquoi un changement de mise en page d'un client (déplacement du bloc « Ship To » du coin supérieur droit vers le coin inférieur gauche entre deux révisions de format) ne casse pas l'extraction : l'IA cherche le sens de « Ship To », pas ses coordonnées en pixels.
Pour les commandes où le total de ligne n'est pas imprimé — seuls la Quantité et le Prix unitaire apparaissent — vous pouvez utiliser une colonne calculée. Nommez votre colonne « Line Total (Qty × Unit Price) » et l'IA effectue la multiplication lors de l'extraction, ajoutant la valeur calculée à votre sortie sans aucun post-traitement dans Excel. C'est l'une des plusieurs améliorations d'extraction qui rendent la sortie prête pour votre ERP ou système de gestion des commandes sans nettoyage manuel. Pour une procédure complète du flux de travail d'extraction des bons de commande de bout en bout, consultez notre guide des bons de commande vers Excel.
Où cela peut encore échouer — Limites honnêtes
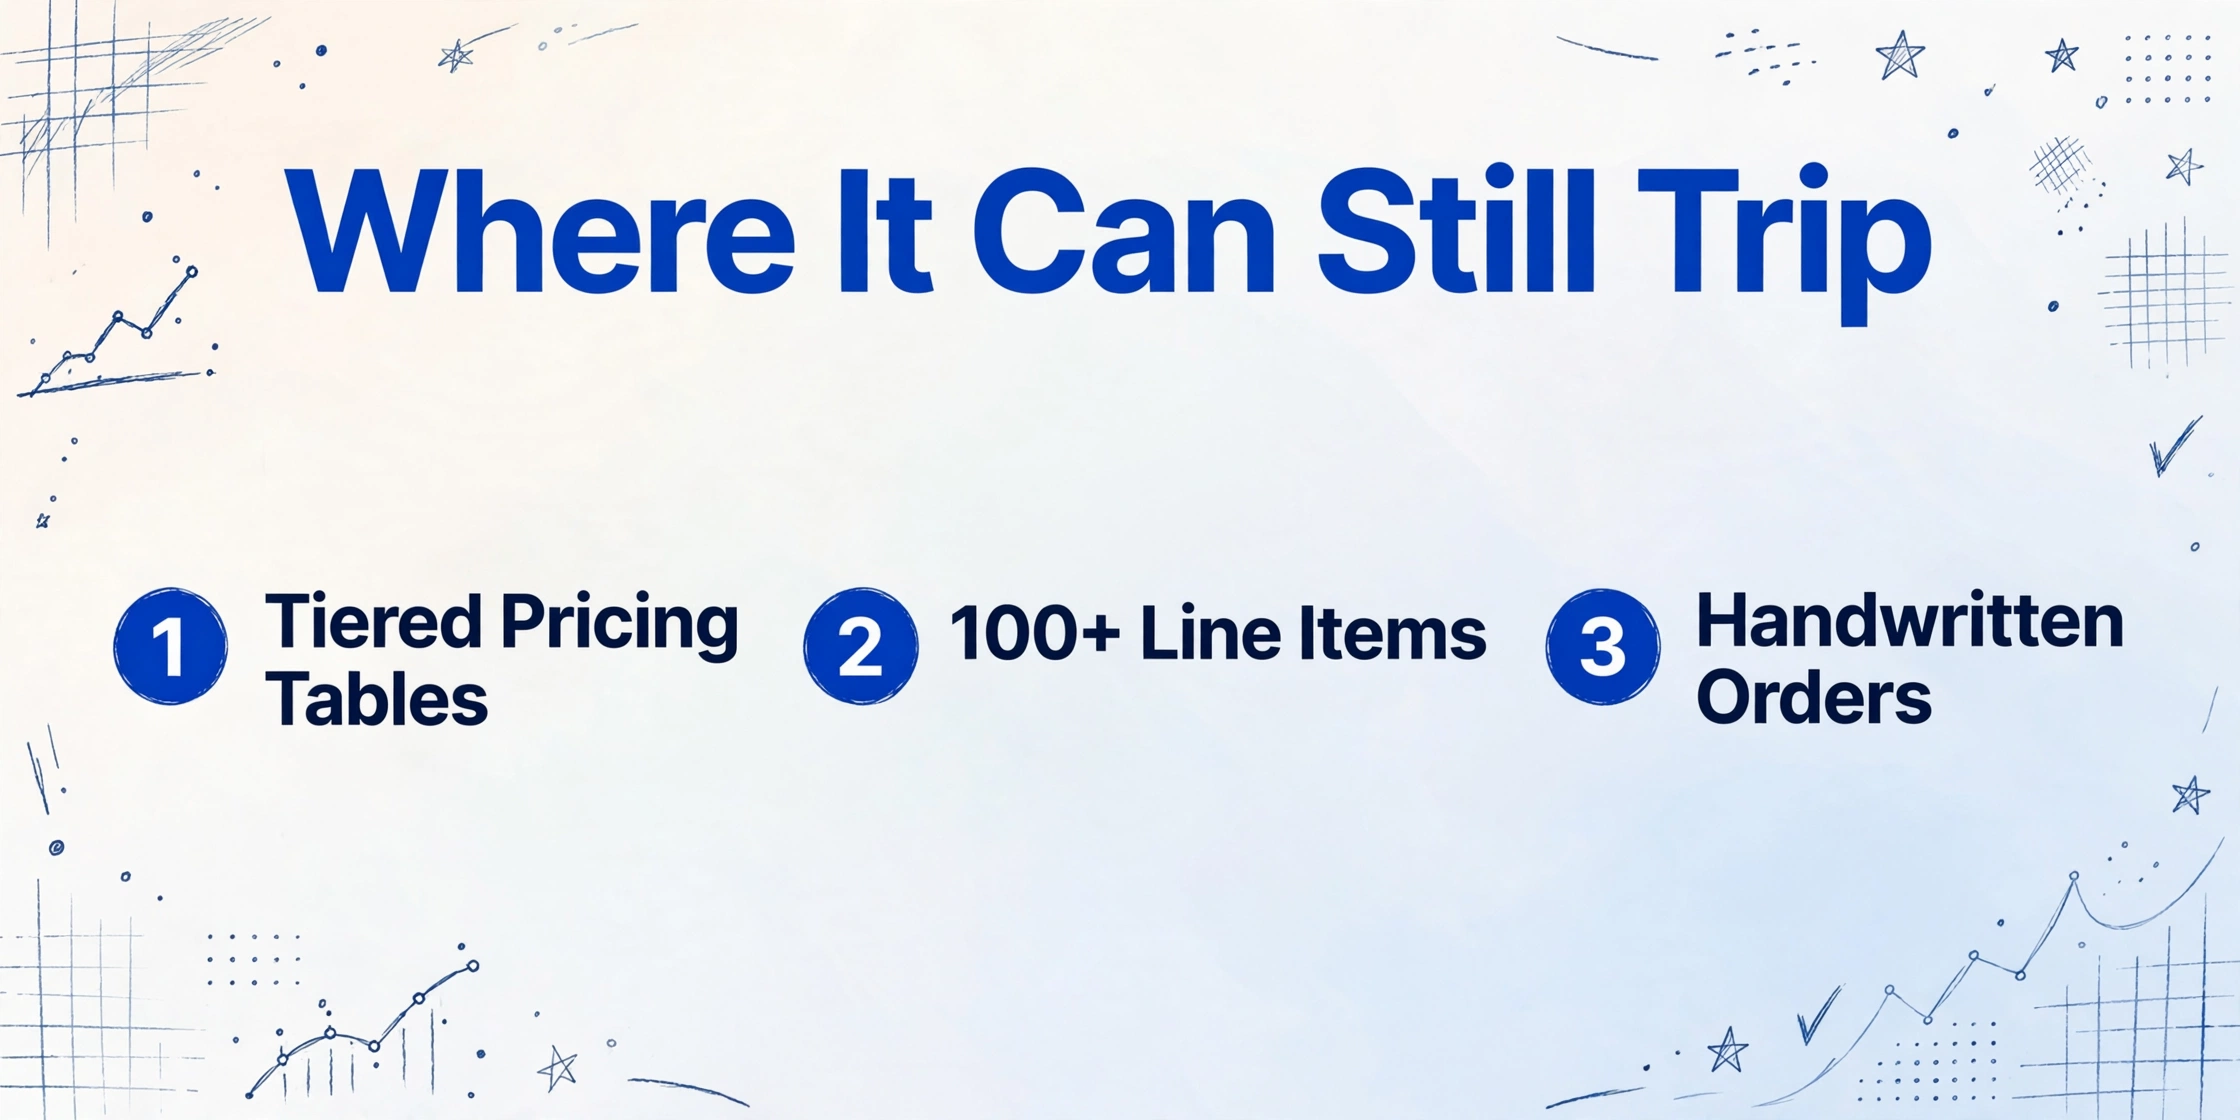
Aucun outil d'extraction n'est parfait sur chaque document. Les scénarios suivants nécessitent une attention particulière, et les connaître à l'avance fait gagner plus de temps que de les découvrir en production.
Tableaux de prix par paliers et remises complexes. Si le bon de commande d'un client inclut un tableau de prix par quantité — « 10 $/unité pour 1 à 50 unités, 8,50 $/unité pour 51 à 200 unités » — affiché comme un tableau séparé à côté des lignes d'articles, l'IA peut attribuer le mauvais palier de prix à une ligne si les limites des paliers sont implicites (non répétées sur chaque ligne) ou si le tableau des prix et le tableau des lignes d'articles ne sont pas visuellement connectés. L'IA lit chaque tableau indépendamment, mais faire correspondre la quantité commandée d'une ligne au bon palier dans un tableau de prix séparé nécessite un raisonnement en plusieurs étapes plus fiable lors d'une relecture humaine que lors d'une seule passe d'extraction. Recommandation : pour les commandes avec des paliers de remise ou de prix séparés, vérifiez ponctuellement les prix unitaires des premières commandes de ce client. Une fois que vous confirmez que l'IA attribue correctement les prix au bon palier, vous pouvez faire confiance aux commandes suivantes du même client — mais vérifiez le premier lot.
Commandes très volumineuses (100+ lignes d'articles) sur plusieurs pages. L'IA gère nativement les documents multipages — elle lit le tableau des lignes d'articles à travers les sauts de page et continue de compter les lignes. Mais lorsqu'une seule commande comporte 150 lignes réparties sur 6 pages, la probabilité d'un artefact de saut de page (une ligne divisée entre deux pages où les en-têtes de colonnes ne sont pas répétés) augmente. Le modèle visuel de l'IA peut généralement gérer ces cas car il comprend la structure des tableaux, mais le taux d'erreur par ligne s'accumule avec le nombre total de lignes. Recommandation : pour les commandes dépassant 100 lignes, parcourez la sortie extraite et vérifiez le nombre total de lignes par rapport au nombre de lignes de la commande. La plupart des écarts se produisent aux limites des sauts de page et sont faciles à repérer.
Copies carbone très dégradées et commandes par fax. Si un client envoie encore des commandes par fax ou via des formulaires en copie carbone, la qualité du texte peut être inférieure à ce que l'IA peut lire de manière fiable. Des caractères faibles, des chiffres tachés et des annotations manuscrites dans les marges peuvent provoquer des erreurs de lecture — « 1 000 unités » devient « 100 unités » si le troisième zéro est illisible. Recommandation : mettez en place un flux de travail de signalement de faible confiance. L'IA renvoie un score de confiance pour chaque valeur extraite ; configurez votre processus pour examiner toutes les valeurs sous un seuil de confiance. Cela permet de détecter les cas de documents dégradés sans nécessiter une relecture humaine de chaque commande propre.
Numéros de PO client contenant des caractères spéciaux ou des espaces. Certains numéros de bons de commande incluent des traits d'union, des barres obliques ou des espaces intégrés qui font partie intégrante du numéro (par exemple, « PO-2026-0715 ») mais peuvent être fragmentés par la mise en page du document. L'IA lit le texte en blocs visuels, donc un numéro de PO réparti sur deux lignes peut être reconstitué en deux jetons distincts. Recommandation : après l'extraction, examinez la colonne « Customer PO Number » pour détecter les valeurs tronquées ou divisées. L'IA gère généralement bien les formats standard, mais les mises en page inhabituelles avec des numéros de PO fragmentés bénéficient d'un contrôle visuel rapide de la colonne de sortie.
Ces limites ne sont pas des obstacles — ce sont des considérations de conception de processus. Il en va de même pour chaque outil d'extraction, et les plus honnêtes vous indiquent où surveiller. Pour un cadre plus large sur l'évaluation de la pertinence de l'extraction par IA pour votre équipe, consultez notre guide pratique pour améliorer la précision de l'extraction.
La différence entre un outil d'extraction qui gère vos bons de commande et un qui ajoute du travail ne réside pas dans le fait qu'il commet des erreurs — tous les outils en commettent. La différence est de savoir s'il commet des erreurs prévisibles sur des documents que vous pouvez tester, ou des erreurs imprévisibles sur des documents que vous ne pouvez pas tester. L'extraction sémantique par rapport aux modèles signifie que l'IA échoue de manière cohérente sur des conditions documentaires spécifiques (tarification par paliers, scans dégradés) que vous pouvez tester, vérifier ponctuellement et intégrer dans un processus — plutôt que d'échouer aléatoirement lorsqu'un client met à jour son format de formulaire et casse votre modèle.
Une liste de contrôle décisionnelle — Votre processus de traitement des commandes est-il prêt pour l'IA ?
Tous les flux de traitement des commandes ne se prêtent pas également à l'extraction par IA. Les cinq questions suivantes vous aident à déterminer où l'extraction apportera le plus de valeur et où elle nécessitera un soutien humain.
1. Combien de formats de commandes clients distincts recevez-vous ? Si vous traitez des commandes de 5 clients avec 5 formats standard, l'OCR basé sur des modèles peut fonctionner correctement — vous investissez le temps de configuration une fois par client et le coût de maintenance est gérable. Si vous traitez des commandes de 20, 50 ou 200 clients, chacun avec sa propre mise en page — ce qui est la réalité pour la plupart des distributeurs, grossistes et fabricants B2B — l'extraction sémantique devient non seulement plus rapide mais structurellement nécessaire. Les coûts liés aux modèles augmentent linéairement avec le nombre de clients. L'extraction sémantique évolue à un coût marginal quasi nul par nouveau client.
2. Dans quelle mesure les commandes que vous recevez sont-elles structurées ? L'extraction par IA fonctionne mieux sur les commandes ayant une structure claire en-tête-corps-totaux — bons de commande PDF générés par ERP, formulaires de confirmation de commande standard et documents de commande tapés ou imprimés. Elle fonctionne modérément bien sur les feuilles de calcul envoyées par e-mail ou les pièces jointes CSV (l'IA lit les données tabulaires dans les pièces jointes). Elle n'est pas idéale pour les corps d'e-mails libres qui décrivent ce que le client souhaite en texte paragraphe sans champs structurés — ceux-ci nécessitent une compréhension du langage naturel mieux gérée par des outils d'analyse d'e-mails spécialisés. Si 80 % de vos commandes arrivent sous forme de PDF structurés provenant des systèmes ERP clients, l'extraction par IA automatisera l'essentiel de votre charge de travail.
3. Quelle est votre tolérance aux erreurs par type de champ ? Tous les champs ne présentent pas le même risque. Une erreur sur « Requested Ship Date » (mauvaise date capturée) peut entraîner des retards d'exécution, mais elle est généralement détectée lorsque l'entrepôt ne trouve pas de commande planifiée à cette date. Une erreur sur « Customer PO Number » (mauvaise référence capturée) peut rompre le rapprochement à trois niveaux et retarder la comptabilisation des revenus. Une erreur sur « Quantity Ordered » (100 capturé au lieu de 1 000) peut entraîner une sous-expédition, des coûts de réapprovisionnement et un client déçu. Cartographiez votre tolérance aux erreurs par champ avant de configurer l'extraction — et priorisez la vérification ponctuelle des champs à haut risque (quantités, numéros de PO, remises) plutôt que des champs à faible risque (noms d'entreprises, dates génériques).
4. Pouvez-vous traiter vos commandes par lots ? L'extraction par IA est conçue pour le traitement par lots en priorité — téléversez plusieurs commandes à la fois, traitez-les ensemble et examinez la sortie consolidée. Si votre flux de travail actuel traite les commandes une par une à leur arrivée (ouvrir l'e-mail, saisir les données, passer à l'e-mail suivant), le véritable gain d'efficacité vient du traitement par lots. Cela peut nécessiter un changement de processus : collectez les commandes pendant la matinée, traitez le lot avant le déjeuner, examinez les exceptions l'après-midi. Le temps par commande passe de 3 à 5 minutes de saisie à 10 secondes de traitement IA plus 20 secondes de validation par lot.
5. Vos clients changent-ils parfois le format de leurs commandes sans préavis ? C'est le coût silencieux de l'extraction basée sur des modèles que la plupart des décideurs ne prennent pas en compte jusqu'à ce qu'il se manifeste. Un client met à jour son système ERP et la mise en page de ses bons de commande change. Le modèle que vous avez créé l'année dernière n'extrait plus rien d'utile. Vous le découvrez lorsqu'un lot de 30 commandes de ce client est traité sans aucune donnée — et vous devez ressaisir les 30 manuellement. L'extraction sémantique absorbe les changements de format car elle ne dépend pas du format. L'IA lit chaque commande indépendamment, par le sens, donc un changement de mise en page d'un client n'a aucun impact sur la qualité de l'extraction. Si vous avez déjà vécu le moment « le client a mis à jour son formulaire et notre automatisation est tombée en panne », c'est l'argument le plus fort pour passer de l'extraction basée sur des modèles à l'extraction sémantique.
Pour un guide plus détaillé sur la création d'un flux de travail complet d'extraction de bons de commande — y compris la configuration du Lien de collecte pour permettre aux clients de téléverser leurs propres commandes, le traitement par lots avec des sorties prêtes pour l'ERP, et les modèles d'intégration — consultez notre guide complet de l'extraction de bons de commande (Partie 3 de notre série d'extraction order-to-cash).
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Questions fréquentes
L'IA peut-elle extraire les données de commandes clients à partir de bons de commande manuscrits ?
Partiellement. L'IA visuelle moderne lit l'écriture manuscrite avec une précision de 85 à 95 % sur des commandes manuscrites raisonnablement lisibles — bien mieux que l'OCR traditionnel, qui tombe souvent sous les 50 % sur l'écriture cursive ou mixte. Cependant, les formulaires manuscrits avec annotations, ratures ou corrections augmentent l'ambiguïté. Si vos clients envoient des commandes manuscrites par fax ou photo, prévoyez un taux de relecture humaine plus élevé (visez 100 % pour les quantités et les prix, qui comportent le plus grand risque d'erreur). Les commandes imprimées ou PDF numériques issues des ERP clients n'ont pas cette limitation et sont traitées avec une précision de 95 à 99 % avec une relecture minimale.
L'IA gère-t-elle les commandes multipages avec des lignes d'articles se poursuivant d'une page à l'autre ?
Oui. L'IA lit l'intégralité du document comme une structure visuelle unique — elle suit le tableau des lignes d'articles à travers les sauts de page et continue d'extraire les lignes dans le bon ordre. Une seule condition : les en-têtes de colonnes doivent être répétés sur chaque page (comme le font la plupart des bons de commande générés par ERP). Si les en-têtes manquent sur les pages de continuation, l'IA peut toujours maintenir l'intégrité des lignes en déduisant la structure du tableau à partir de la disposition des colonnes, mais vérifiez la première commande multipage de chaque client pour confirmer que la disposition du tableau est correctement interprétée.
Que faire si la commande d'un client utilise une devise ou une unité de mesure différente ?
L'IA extrait les valeurs telles qu'elles apparaissent sur le document — elle lira « 2 450,00 $ USD » comme le montant et le symbole monétaire comme préfixe ou suffixe. La sortie conserve les valeurs d'origine, y compris les symboles monétaires et les abréviations d'unités de mesure (U, KG, LB, M, L). Pour l'importation dans l'ERP, vous pouvez configurer une logique de post-traitement dans votre tableur ou utiliser une Colonne calculée pour convertir les unités lors de l'extraction (ex. : « Poids en KG (LBS × 0,4536) »). L'IA ne convertit pas automatiquement les devises — c'est une décision métier qui relève de votre ERP ou d'une formule dans le tableur de sortie.
Puis-je mettre en place un système où les clients téléchargent leurs commandes et elles sont traitées automatiquement ?
Oui. Générez un Lien de collecte — une URL partageable que chacun peut ouvrir pour déposer des fichiers directement dans la file de traitement de votre compte, sans inscription ni connexion. Partagez ce lien avec vos clients, et leurs bons de commande atterrissent dans votre file au fur et à mesure. Vous traitez le lot selon votre planning, examinez les exceptions et exportez les données consolidées. Cela élimine la chaîne « télécharger depuis l'email → enregistrer dans un dossier → importer dans l'outil » et réduit les frictions liées à la collecte des commandes de dizaines de clients. Pour les clients récurrents, vous pouvez enregistrer votre configuration de colonnes comme modèle afin que chaque lot utilise les mêmes colonnes d'extraction sans ressaisir les noms de champs.
Comment l'IA gère-t-elle les commandes incluant à la fois des articles basés sur la quantité et des lignes de service (taux horaires) ?
Elle lit les deux types de la même manière — chaque ligne du tableau de détail est extraite avec son code article, sa description, sa quantité ou ses heures, son prix unitaire (à l'unité ou à l'heure) et son total ligne. L'IA ne distingue pas les types d'articles lors de l'extraction, sauf si vous le lui demandez. Si vous devez séparer les biens physiques des services dans votre sortie, définissez deux passes d'extraction : l'une avec une colonne nommée « Type d'article » et l'IA déduira de la description si chaque ligne est un produit ou un service. Sinon, utilisez une Colonne calculée avec une logique conditionnelle — « si la description contient 'heure' ou 'conseil' alors 'Service', sinon 'Produit' » — pour classer les lignes lors de l'extraction.
À quel taux d'erreur dois-je m'attendre pour l'extraction des bons de commande en production ?
Sur des bons de commande propres, imprimés et au format standard (ceux générés par les ERP connus), la précision au niveau des champs est de 95 à 99 % pour les champs d'en-tête et de 92 à 97 % pour les champs de détail selon la complexité du tableau. Sur les commandes avec des mises en page complexes — tableaux de prix par paliers, grilles de remises, lignes réparties sur plusieurs pages — la précision tombe à 85-92 % et nécessite plus de vérification humaine. Ces chiffres sont cohérents avec ce que les benchmarks tiers rapportent pour l'extraction de documents par IA : les documents structurés imprimés donnent les meilleurs résultats, les formats mixtes nécessitent une relecture modérée, et les scans de mauvaise qualité exigent le plus de validation humaine. La mesure opérationnelle clé n'est pas la précision moyenne — c'est le temps de relecture par commande après extraction. Passer de 5 minutes de saisie manuelle à 1 minute de vérification des exceptions représente un gain de productivité de 5x, même si la précision n'est pas parfaite.
La question « L'IA peut-elle lire les bons de commande ? » a une réponse claire : oui — et la technologie est suffisamment mature pour gérer la diversité des formats qui rend la saisie manuelle des commandes si coûteuse. La vraie question est de savoir quelle partie de votre flux de travail spécifique vous pouvez confier à une relecture basée uniquement sur les exceptions, par opposition à une validation ligne par ligne. La réponse dépend de votre mix client, de la distribution de la qualité des documents et de votre tolérance au risque au niveau des champs — mais c'est une question à laquelle vous pouvez répondre en un seul après-midi de test sur vos propres commandes. Téléchargez 10 commandes de 10 clients différents, configurez vos noms de colonnes une fois, et observez le résultat. Le résultat vous en apprendra plus que mille mots sur la précision de l'extraction.
Si vous êtes prêt à évaluer l'extraction par IA sur vos bons de commande réels, commencez avec notre outil de transformation de bon de commande en Excel — téléchargez un exemple de commande et voyez ce que l'IA extrait sans configurer de modèles. Pour le flux complet — incluant le traitement par lots, la configuration du Lien de collecte et l'export prêt pour ERP — consultez le guide complet de l'extraction de bons de commande.