¿Puede la IA leer escritura a mano desde fotos?
Sí — aquí está la precisión
Sí. Los modelos de visión con IA modernos pueden leer escritura a mano con una precisión del 85–95% en imágenes de calidad razonable — muchísimo mejor que el OCR tradicional, que baja por debajo del 50% en cursiva y a menudo falla por completo con la escritura desordenada. La diferencia no es pequeña: es la que hay entre obtener datos utilizables y obtener galimatías. Pero la precisión no es un solo número — depende en gran medida del tipo de escritura. La escritura a mano en letras de imprenta ronda el 95%. La cursiva clara se sitúa en torno al 85%. La cursiva desordenada baja al 65–75%. ¿Garabatos difíciles de leer? Siguen siendo un reto para todos los modelos del mercado.
Dónde encaja esto: esta página es la referencia de precisión para las preguntas del tipo "¿puede la IA leer...?", con cifras desglosadas por tipo de escritura. Para la definición de la tecnología, consulta qué es el reconocimiento de escritura a mano con IA; para saber cómo funciona por dentro, consulta cómo funciona el reconocimiento de escritura a mano.
Puntos clave
- El OCR tradicional se equivoca en 95 de cada 100 palabras en cursiva — su arquitectura se diseñó para letras impresas separadas, y la cursiva conecta cada letra por definición.
- Los modelos de visión con IA dan la vuelta al enfoque leyendo las páginas como lees tú una nota escrita a mano — usando la etiqueta "Invoice Number" como contexto para desambiguar cada carácter ambiguo.
- La diferencia de 30 puntos de precisión entre las letras de imprenta al 95% y las notas de campo desordenadas al 65% es la cifra honesta que ningún proveedor pone en su página de inicio.
Qué tan bien lee la IA la escritura a mano hoy
El reconocimiento de escritura a mano con IA ha pasado de "casi inútil" a "utilizable en producción" en aproximadamente tres años, pero la variación en precisión según el tipo de escritura es grande, y saber dónde se ubican tus documentos en ese espectro es la diferencia entre un flujo de trabajo que funciona y uno frustrante.
En 2023, incluso los mejores modelos de IA fallaban con la cursiva. Para 2026, el panorama es diferente. En la base de datos de escritura a mano IAM — un punto de referencia académico estándar con 13,353 líneas de texto de 657 escritores distintos — los mejores modelos ahora alcanzan tasas de error de caracteres (CER) por debajo del 2%. Eso significa menos de 2 caracteres incorrectos por cada 100 caracteres leídos. GPT-5 lidera con aproximadamente 1.22% de CER, seguido de Claude Opus 4.7 con ~1.31%, y Gemini 3 con ~1.44% (codesota.com, benchmark 2026). Microsoft Azure Document Intelligence ofrece ~1.8% de CER con la ventaja de salida estructurada con cuadros delimitadores — útil para formularios.
Ese es el panorama académico. Pero la precisión en el mundo real varía enormemente según el estilo de escritura. Esto es lo que nos dicen los benchmarks independientes y los informes de profesionales (AIMultiple 2026; Businessware Technologies 2026; codesota.com 2026):
| Tipo de escritura a mano | Precisión de IA (2026) | OCR tradicional | Notas |
|---|---|---|---|
| Escritura a mano en letras de imprenta | 90–95% | 60–80% | Caracteres limpios y separados. Azure alcanza ~95% en letras de imprenta claras. |
| Cursiva clara | 80–88% | 30–50% | Letras conectadas pero con estilo consistente. GPT-4.1 obtuvo ~85% en cursiva limpia de una sola página. |
| Cursiva desordenada | 65–75% | 10–25% | Formas de letras inconsistentes, inclinación variable, ambigüedad a nivel de palabra. |
| Difícil de leer / degradado | 45–60% | <10% | Caligrafía muy estilizada, copias carbón desvanecidas, texto superpuesto. |
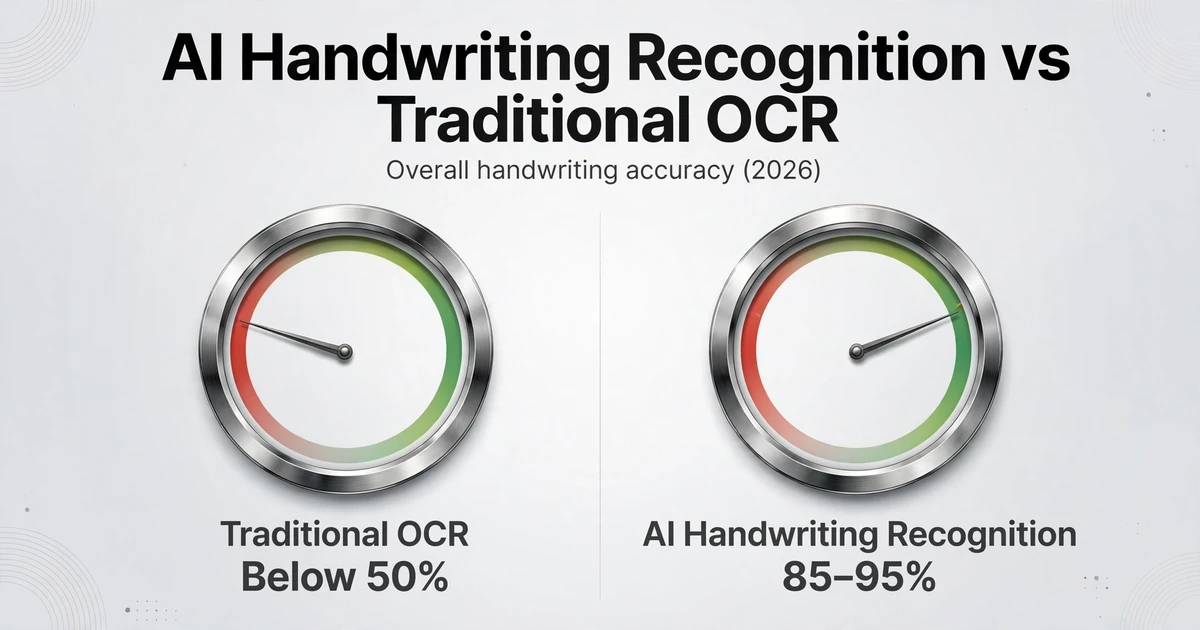
Estas son cifras prácticas de precisión utilizable según el tipo de escritura — lo que puedes esperar de las herramientas de IA actuales en fotos y escaneos reales. Las tasas de error a nivel de carácter (CER/WER) detrás de estos números, y cómo se amplía la brecha frente al OCR tradicional a medida que la escritura se degrada, son el tema de nuestro análisis profundo sobre cómo funciona el reconocimiento de escritura a mano. Y porque incluso una alta precisión de caracteres puede seguir significando totales incorrectos, consulta nuestro análisis sobre por qué un 90% de CER sigue significando totales incorrectos.
Las dos últimas filas explican por qué la mayoría de las herramientas no mencionan la precisión de la escritura a mano. Un número por debajo del 70% es difícil de comercializar. Pero esa es la realidad. Si tus documentos son principalmente escritura a mano en letras de imprenta o cursiva clara, la IA te servirá bien. Si son notas de campo desordenadas de 12 técnicos diferentes, espera tener que revisar los resultados.
El punto de referencia que mejor ilustra la brecha entre la IA y el OCR tradicional proviene de una prueba independiente de 2026 (codesota.com): Tesseract — el motor OCR de código abierto más utilizado — devuelve un 12.5% de tasa de error de caracteres (CER) en el conjunto de datos de escritura a mano IAM. Eso es un error cada 8 caracteres. En el punto de referencia WER de handwritingocr.com 2026, Tesseract obtuvo un 95.4% de tasa de error de palabras (WER) — lo que significa que se equivoca en casi todas las palabras en cursiva. Esto no es un problema de ajuste; Tesseract fue diseñado para texto impreso. Su enfoque de segmentación de caracteres asume que las letras están separadas — una suposición que la cursiva rompe en cada línea.
Lo que la IA de reconocimiento de escritura a mano hace bien
La IA destaca donde la escritura sigue una estructura — formularios con campos etiquetados, formatos consistentes y escritura contenida en áreas designadas.
El OCR tradicional funciona segmentando una página en caracteres individuales — aísla cada letra, la compara con una forma conocida y genera el resultado. La cursiva rompe este modelo por completo. Los caracteres se conectan, se fusionan y se distorsionan de maneras que los motores basados en segmentación no pueden separar. La IA moderna adopta el enfoque opuesto: mira la página completa como lo haría un humano, usando el contexto para resolver la ambigüedad. Un "1" escrito a mano y una "l" escrita a mano pueden ser visualmente idénticos de forma aislada, pero una IA que entiende que el campo es un monto en dólares puede distinguirlos — el OCR tradicional no puede.
Los formularios estructurados con campos etiquetados son donde el reconocimiento de escritura a mano con IA brilla más. Cuando un campo está etiquetado como "Número de factura" o "Fecha", los modelos de visión-lenguaje usan esa etiqueta como ancla semántica — saben qué tipo de contenido esperar en esa región. Este es el mismo mecanismo detrás de la extracción de columnas personalizada: defines qué datos quieres (nombres de columnas como "Total", "Nombre del proveedor", "Fecha"), y la IA localiza cada valor entendiendo qué significa, no dónde está en la página. La IA lee el documento completo, cruza las etiquetas de campo con el contenido manuscrito cercano y extrae datos estructurados — incluso cuando las posiciones de los campos varían entre documentos.
La escritura a mano en letras de imprenta y las letras de imprenta son ahora un problema resuelto para los modelos de IA. La investigación de Businessware Technologies (2026) confirmó que los modelos de lenguaje grandes modernos logran una precisión casi humana en escritura de imprenta limpia. Una revisión práctica separada de 2025 encontró que Azure Document Intelligence obtuvo ~95% en imprenta clara — cerca de su rendimiento en texto impreso. Si alguien escribe en letras de imprenta mayúsculas con un bolígrafo oscuro sobre papel blanco, la IA lo leerá de manera confiable.
Los documentos consistentes de un solo escritor también funcionan bien. Cuando la misma persona completa un lote de albaranes de entrega o formularios de inspección, los modelos de IA aprenden los patrones del escritor implícitamente a lo largo de las páginas. En un punto de referencia de 100 muestras de escritura cursiva escritas por un conjunto fijo de colaboradores, los mejores modelos lograron puntuaciones de similitud semántica lo suficientemente altas para uso en producción (AIMultiple, 2026). La variable clave no es el número de escritores — es si cada escritor es consistente dentro de sus propios documentos.
La escritura a mano en inglés tiene la mayor cantidad de datos de entrenamiento y el rendimiento de modelo más fuerte. El soporte para idiomas con escritura latina (francés, español, alemán, portugués) también es sólido, aunque la precisión cae de 5 a 10 puntos porcentuales para escritura a mano que no es en inglés. Las escrituras no latinas (árabe, chino, caracteres japoneses escritos a mano, cursiva cirílica) están mejorando pero siguen rezagadas — esta sigue siendo un área de investigación activa más que un problema resuelto.
Donde el Reconocimiento de Escritura Manual Aún Falla
La lista honesta de limitaciones importa más que las capacidades — porque prometer de más es la forma más rápida de perder la confianza cuando alguien sube su primer documento y obtiene malos resultados.
Documentos muy deteriorados — tinta desvaída, papel amarillento, copias carbón, fotocopias de tercera generación — reducen drásticamente la precisión. La escritura que ya es difícil de leer para un humano se vuelve casi imposible para la IA. Las marcas de lápiz tenues, la tinta dañada por agua y los documentos donde el texto traspasa desde el reverso agravan los errores. Una reseña de 2025 en Reddit (r/computervision) lo documentó con precisión: un usuario que probó 75 informes de inspección (225 páginas) con escritura desordenada de diferentes técnicos de campo encontró que los modelos de IA de propósito general producían resultados utilizables en páginas más limpias, pero fallaban sistemáticamente en las deterioradas. Las herramientas especializadas de OCR para escritura manual manejaron las mismas páginas deterioradas significativamente mejor, lo que ilustra que la arquitectura del modelo ajustada para escritura manual importa más que la capacidad bruta de la IA en documentos difíciles.
La cursiva muy estilizada y escrituras inusuales siguen siendo difíciles. La caligrafía copperplate del siglo XIX, la Sütterlin alemana y la caligrafía ornamentada están fuera de la distribución de entrenamiento de la mayoría de los modelos comerciales. El benchmark de codesota 2026 señaló que incluso el 1.22% de CER del GPT-5 — el mejor de su clase — se aplica a la cursiva inglesa estándar del conjunto de datos IAM, no a escrituras históricas o muy estilizadas. Herramientas especializadas como Transkribus, que permiten entrenar modelos personalizados en estilos de escritura específicos, abordan este nicho pero requieren una inversión de configuración significativa.
La deriva de contexto en varias páginas es un problema sutil pero real. GPT-4.1 logró ~85% de precisión en páginas individuales limpias, pero cayó a ~75% en secciones narrativas más desordenadas y hasta ~65% en la tercera página de documentos de varias páginas (revisión de profesionales de 2025). El modelo comienza a alucinar continuaciones — inventando texto que no está allí — a medida que se acumula el contexto. Esta es una limitación conocida de las arquitecturas actuales de modelos de visión-lenguaje y se está trabajando activamente en ella.
Los números y cantidades monetarias merecen especial precaución. Leer mal un "3" por "8" o un "5" por "6" en una cantidad en dólares es un error mucho más costoso que una palabra mal escrita. En cantidades en cursiva desordenada, la verificación es esencial: la IA acierta el número correcto aproximadamente el 80–85% de las veces en escritura clara, pero eso aún significa que 1 de cada 6 cantidades podría ser incorrecta en muestras difíciles. Para documentos financieros, el flujo de trabajo práctico es: deja que la IA extraiga todo, luego revisa todos los campos de moneda.
Contenido mixto impreso y escrito a mano en la misma página puede confundir a los modelos que no están diseñados específicamente para ello. Un formulario donde las etiquetas de campo impresas están junto a las respuestas escritas a mano es el caso estándar — y funciona bien. Pero un documento impreso cubierto de anotaciones manuscritas, notas al margen y correcciones desafía la comprensión del diseño. La IA puede fusionar el texto impreso y el escrito a mano en un solo flujo o atribuir incorrectamente qué texto pertenece a qué campo.
Cómo obtener los mejores resultados de la lectura de escritura a mano con IA
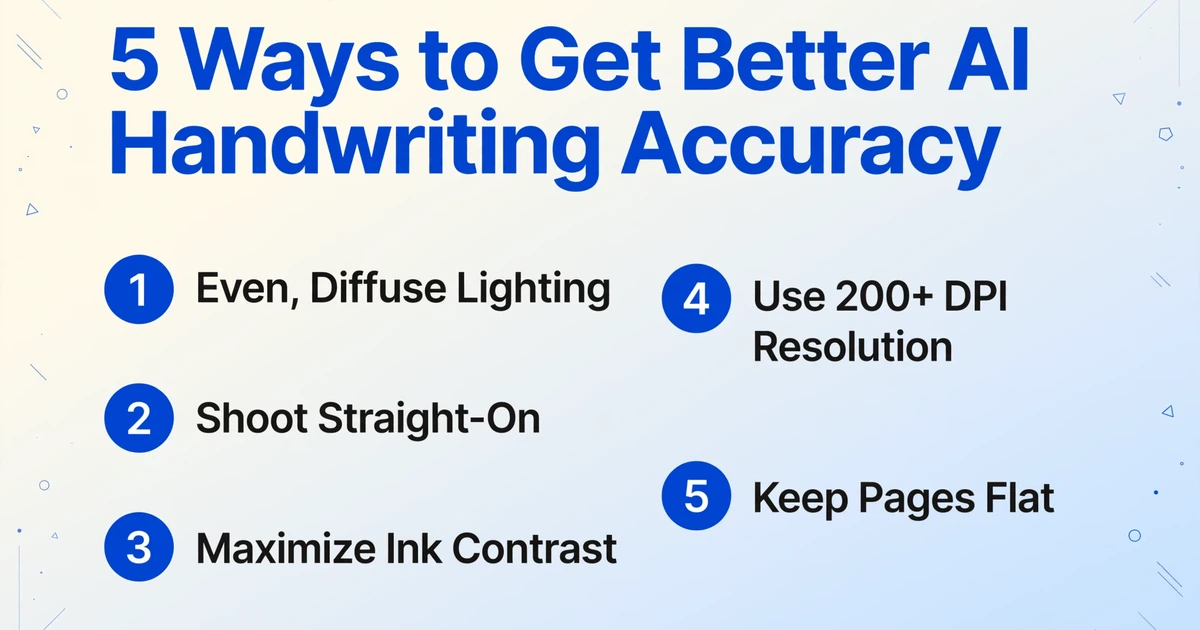
El factor más importante que controlas es la calidad de la foto. Una foto bien iluminada, tomada de frente y en alta resolución puede llevar una muestra de escritura a mano que estaba al límite a un rango utilizable, sin necesidad de actualizar el modelo.
1. Usa iluminación uniforme y difusa. Las sombras en la página crean bordes de contraste artificiales que confunden a los modelos de IA. La luz natural de una ventana es ideal. Si usas luz artificial, coloca dos fuentes de luz en ángulos de 45 grados para eliminar sombras. Evita el flash directo: crea puntos brillantes que desvanecen la tinta.
2. Fotografía de frente, no en ángulo. La distorsión de perspectiva en fotos inclinadas obliga a la IA a enderezar la página antes de leer, añadiendo un paso de preprocesamiento donde los errores se acumulan. Sostén el teléfono paralelo al documento. La mayoría de las apps de cámara modernas tienen un modo de escaneo de documentos que corrige la perspectiva automáticamente; úsalo.
3. Maximiza el contraste entre tinta y papel. La tinta azul oscuro o negra sobre papel blanco es ideal. El lápiz claro, la tinta roja sobre papel de color o la tinta de pluma tenue reducen la precisión. Si controlas la entrada (por ejemplo, personal de campo llenando formularios), exige bolígrafos de tinta oscura: es la mejora de precisión más económica disponible.
4. Usa una resolución de al menos 200 PPP. Para una página tamaño carta estándar, eso significa aproximadamente 1700 x 2200 píxeles, algo fácilmente alcanzable con cualquier teléfono inteligente de los últimos cinco años. Por debajo de 150 PPP, los trazos de los caracteres se difuminan y la precisión cae drásticamente. Por encima de 300 PPP, los beneficios son marginales para los modelos de IA modernos, aunque ayuda con escritura muy pequeña.
5. Mantén la página plana y sin arrugas. Los pliegues y dobleces crean distorsiones geométricas que rompen la forma de los caracteres. Si un documento ha sido doblado, aplánalo bajo un libro durante unas horas antes de fotografiarlo, o usa un escáner. Los documentos escaneados superan consistentemente a las fotos de teléfono por 3 a 8 puntos porcentuales en la misma muestra de escritura a mano.
Documentos reales donde la IA lee escritura a mano
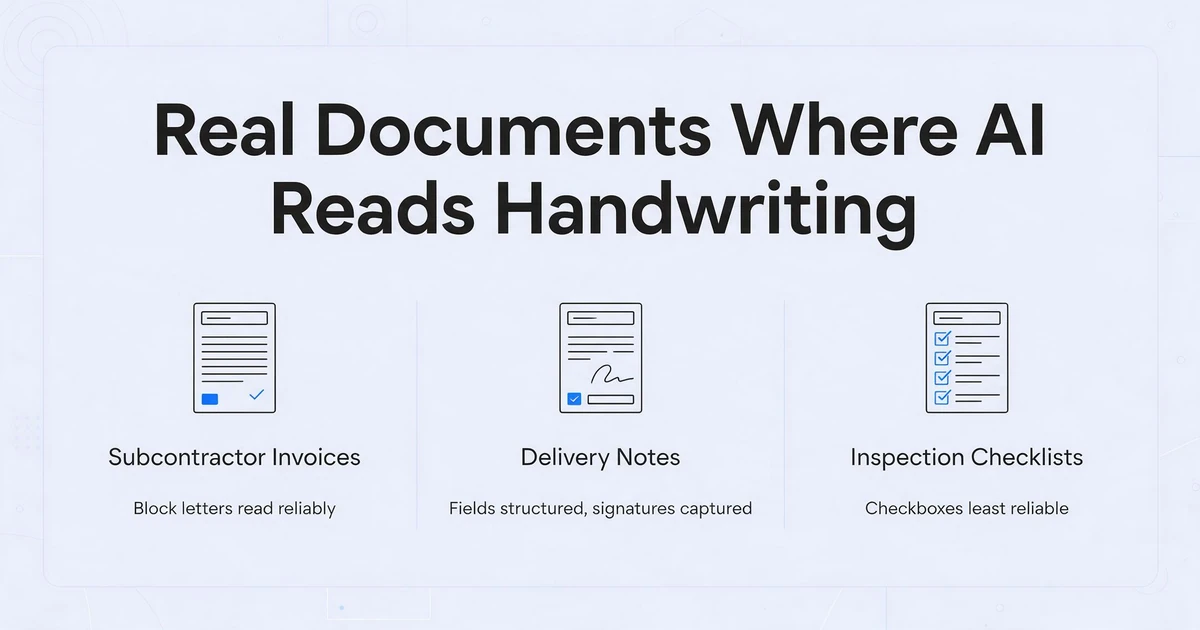
La mejor manera de entender la precisión de la IA para leer escritura a mano es observar los documentos que la gente realmente procesa — y qué sucede cuando lo hace.
Facturas manuscritas de subcontratistas. Las empresas de construcción, oficios y servicios de campo siguen recibiendo facturas manuscritas a diario — un plomero anota la dirección del trabajo, las horas de mano de obra, los materiales y el total en un block de copia carbón. Estas facturas combinan membrete impreso con partidas manuscritas. La IA maneja esto bien: el texto impreso proporciona anclas de diseño, el contenido manuscrito suele ser letras de imprenta o cursiva clara, y las etiquetas de campo como "Total" y "Fecha" son consistentes. Una herramienta que usa Custom Column Extraction puede leer los montos manuscritos directamente en columnas estructuradas — horas, tarifa, materiales, total — sin necesidad de volver a teclear nada. Para más sobre este escenario específico, consulta nuestra guía sobre extraer datos de facturas manuscritas de subcontratistas.
Notas de campo de entrega y comprobantes de entrega. Los conductores y mensajeros llenan las notas de entrega a mano — nombre del destinatario, artículos entregados, fecha, firma. Estos formularios viajan en cabinas de camiones, se doblan y llegan a la oficina días después con manchas de café. La escritura rara vez es prolija, pero los campos están estructurados: un bloque de firma, un campo de fecha, una columna de cantidad. La IA lee los campos en letras de imprenta de manera confiable; las firmas se capturan como indicadores de presencia (¿está firmado? sí/no) en lugar de leerse como texto. Para equipos de logística que procesan docenas de notas de entrega a diario, la extracción por lotes con IA puede eliminar horas de entrada manual. Consulta nuestro artículo sobre procesamiento por lotes de notas de entrega manuscritas para ver un flujo de trabajo detallado.
Listas de verificación de inspección en campo. Los inspectores de seguridad, los equipos de control de calidad y el personal de mantenimiento llenan listas de verificación en papel en el campo — a menudo en condiciones adversas donde una tableta no es práctica. Estos formularios combinan casillas de verificación (marcadas/sin marcar), lecturas numéricas (valores de medidores, temperaturas, presiones) y comentarios manuscritos breves ("fuga en la válvula 3 — marcada para reparación"). La IA moderna lee los tres: las casillas se detectan mediante reconocimiento visual de patrones, los campos numéricos se extraen con alta precisión y los comentarios manuscritos se transcriben para el registro. La detección de casillas es la menos confiable de las tres — para un análisis profundo de por qué incluso los mejores modelos fallan al detectar una casilla marcada, y los patrones de fallo a los que debes prestar atención, consulta por qué la IA lee formularios manuscritos pero aún así no detecta una casilla marcada. En una prueba del mundo real documentada en Reddit r/computervision, un usuario procesó 75 informes de inspección (225 páginas) con escritura desordenada de técnicos de campo — los modelos de IA especializados extrajeron datos estructurados con éxito en ~85% de los campos, mientras que las API generales de OCR en la nube tuvieron dificultades considerables con los comentarios en cursiva.
Hojas de horas escritas a mano. Los trabajadores por horas, las cuadrillas de construcción y el personal de campo todavía presentan hojas de horas escritas a mano: nombre, fechas, horas por día, códigos de trabajo, totales. La disposición en cuadrícula de una hoja de horas ayuda a la IA: cada celda contiene un único dato, los encabezados de columna aportan contexto semántico y el contenido es mayormente numérico. La IA extrae las entradas de tiempo columna por columna, preservando la relación entre fecha, horas y código de trabajo. El desafío es la aritmética: los números escritos a mano como «8.5» pueden leerse mal como «8.5», «8.3» o «8.8» según la claridad de la escritura. Verificar los totales contra las sumas diarias detecta la mayoría de los errores. Para el procesamiento de nóminas, consulta procesamiento por lotes de hojas de horas escritas a mano para nóminas.
Formularios médicos y documentos de admisión escritos a mano. Los formularios de admisión de pacientes, los documentos de consentimiento y las notas clínicas siguen siendo en papel en muchas consultas. El desafío de la escritura a mano aquí se ve agravado por la terminología médica y las abreviaturas que los modelos generales de IA pueden no conocer. El reconocimiento especializado de escritura médica logra mejores resultados al entrenarse con vocabulario específico del dominio. El OCR estándar de IA sobre escritura médica alcanza aproximadamente un 70–80 % de precisión: útil como primer paso, pero requiere verificación humana para datos clínicos donde los errores tienen consecuencias.
Preguntas frecuentes
¿Puede la IA leer escritura desordenada?
Parcialmente. La IA maneja escritura moderadamente desordenada con un 65–75 % de precisión: suficiente para reducir el trabajo manual, pero no para confiar en ella sin revisión. Los garabatos realmente ilegibles —del tipo que incluso los humanos discuten— siguen estando fuera de la capacidad actual de la IA. El umbral práctico: si dos personas distintas que leen la misma escritura coinciden en lo que dice, la IA probablemente lo hará bien. Si los humanos discrepan, la IA fallará.
¿Puede la IA leer escritura cursiva antigua?
Depende de la época y el estilo. La cursiva moderna (posterior a 1950, en inglés) está bien cubierta: la base de datos de escritura a mano IAM y otros conjuntos de datos de entrenamiento usan este estilo ampliamente. La caligrafía inglesa del siglo XIX, la Kurrent/Sütterlin alemana y la caligrafía ornamentada son mucho más difíciles. Herramientas especializadas como Transkribus, que pueden entrenarse con estilos específicos de escritura, manejan guiones históricos mejor que los modelos generales de IA. Si estás digitalizando cartas familiares o archivos históricos, espera invertir tiempo en entrenar modelos o en revisión manual.
¿El OCR de escritura a mano funciona con fotos tomadas con un teléfono?
Sí, y las fotos de teléfono son ahora el tipo de entrada más común. La clave es la calidad de la foto: ángulo recto, iluminación uniforme, sin sombras y al menos 200 PPP de resolución efectiva. Una foto bien tomada con el teléfono de un documento escrito a mano produce una precisión dentro de 3 a 5 puntos porcentuales de un escaneo de cama plana. La brecha entre las fotos de teléfono y los escaneos se ha reducido significativamente desde 2024, ya que los modelos de IA han mejorado en el manejo de artefactos de imagen del mundo real.
¿Puede la IA extraer datos estructurados de formularios escritos a mano, no solo transcribir el texto?
Sí, esto es lo que distingue la extracción moderna con IA de la transcripción básica de escritura a mano a texto. En lugar de generar un bloque de texto sin procesar («Factura #1042 Fecha 15/3/26 Total $847.50»), la extracción estructurada coloca cada valor en su propia columna: «Número de factura: 1042», «Fecha: 15/3/26», «Total: $847.50», listo para importar a una hoja de cálculo, sistema contable o base de datos. Esto se logra mediante la extracción de columnas personalizada: defines los nombres de columna que quieres y la IA localiza y extrae cada valor al comprender su significado semántico, no al coincidir con una posición de plantilla. Para una explicación más profunda de cómo funciona este mecanismo, consulta nuestro artículo sobre qué es el reconocimiento de escritura a mano con IA y cómo funciona.
¿Puede la IA leer escritura a mano en idiomas distintos del inglés?
Sí, con matices. Los idiomas con escritura latina (francés, español, alemán, portugués, italiano) están bien soportados y logran una precisión dentro de 5 a 10 puntos porcentuales del inglés. AWS Textract, por ejemplo, admite explícitamente la escritura a mano en inglés, con soporte de texto impreso extendido a español, portugués, francés, alemán e italiano. Las escrituras no latinas (árabe, caracteres chinos escritos a mano, japonés, cursiva cirílica) están mejorando, pero van por detrás: espera una precisión menor y errores más frecuentes. Para documentos con varios idiomas, los modelos de IA manejan el cambio de idioma razonablemente bien si ambos idiomas usan escritura latina, pero tienen dificultades cuando las escrituras difieren (por ejemplo, anotaciones en inglés en un formulario japonés escrito a mano).
¿Cómo se compara el reconocimiento de escritura a mano por IA con un transcriptor humano?
Con escritura clara y ordenada, la IA iguala o supera la precisión humana: los humanos también cometen errores de transcripción, aproximadamente del 2 al 5 % en texto limpio. Con cursiva desordenada, un humano que conoce el estilo del escritor sigue superando a la IA. Un estudio de caso de 2025 de Digital Scientists (I+D de Mailchimp) reportó un 85 % de precisión en escritura legible y un 60 % en escritura deficiente usando una red neuronal LSTM entrenada, aproximadamente comparable a un lector humano no familiarizado que se encuentra con la misma escritura por primera vez. La ventaja clave de la IA es la velocidad: un documento manuscrito de 2 páginas que a un humano le toma de 15 a 20 minutos transcribir, la IA lo procesa en menos de 30 segundos.
¿Puedo usar herramientas OCR gratuitas como Tesseract para escritura a mano?
No, no para escritura a mano. Tesseract fue diseñado para texto impreso y alcanza como máximo un 20–40 % de precisión en escritura a mano. En el punto de referencia de escritura a mano IAM, Tesseract obtiene una tasa de error de caracteres del 12,5 %, aproximadamente un error cada 8 caracteres, y en cursiva, su tasa de error de palabras supera el 95 %. Herramientas gratuitas como EasyOCR rinden algo mejor, con un 60–70 % en escritura ordenada, pero la brecha entre los motores gratuitos y la IA moderna (GPT-5, Claude, Gemini, Azure) es enorme. El OCR "gratuito" a menudo cuesta más en trabajo de corrección manual que usar una herramienta de IA capaz desde el principio. Para una comparación detallada, consulta reconocimiento de escritura a mano por IA vs. OCR tradicional.
El reconocimiento de escritura a mano por IA en 2026 es lo suficientemente bueno como para transformar flujos de trabajo reales, pero solo si ajustas tus expectativas a la calidad de tus documentos. ¿Letras de imprenta y cursiva clara en formularios estructurados? La IA te ahorrará horas. ¿Notas de campo desordenadas, copias carbón degradadas y escritura histórica ornamentada? La IA ayudará, pero aún necesitarás a un humano en el circuito. La pregunta correcta no es "¿puede la IA leer escritura a mano?", sino "¿puede la IA leer mi escritura, en mis documentos?" La única forma de averiguarlo es probarla con una muestra real.
Para una comprensión más amplia de cómo la IA maneja documentos, no solo escritura a mano, comienza con qué es la extracción de documentos por IA y cómo funciona. Si trabajas específicamente con formularios de inspección manuscritos, consulta nuestra guía sobre extracción y precisión de formularios de inspección manuscritos. Y si estás solucionando malos resultados, nuestro artículo sobre modos de fallo y soluciones en la extracción de escritura a mano cubre los problemas más comunes y sus soluciones.