L'IA peut-elle lire l'écriture manuscrite sur photo ?
Oui — voici la précision
Oui. Les modèles de vision IA modernes lisent l'écriture manuscrite avec une précision de 85 à 95 % sur des images de qualité raisonnable — bien mieux que l'OCR traditionnel, qui tombe sous les 50 % en cursive et échoue souvent complètement sur une écriture brouillonne. L'écart n'est pas mince : c'est la différence entre des données exploitables et du charabia. Mais la précision n'est pas un chiffre unique — elle dépend fortement du type d'écriture. L'écriture manuscrite en lettres détachées approche les 95 %. La cursive soignée se situe autour de 85 %. La cursive brouillonne tombe à 65–75 %. Un gribouillage difficile à lire ? Cela reste un défi pour tous les modèles du marché.
Où cela s'inscrit : cette page est la référence de précision pour les questions « l'IA peut-elle lire... », avec des chiffres détaillés par type d'écriture. Pour la définition de la technologie, voir ce qu'est la reconnaissance d'écriture manuscrite par IA ; pour son fonctionnement interne, voir comment fonctionne la reconnaissance d'écriture manuscrite.
Points clés
- L'OCR traditionnel se trompe sur 95 mots cursifs sur 100 — son architecture a été conçue pour des lettres imprimées séparées, et la cursive relie chaque lettre par nature.
- Les modèles de vision IA renversent l'approche en lisant les pages comme vous lisez une note manuscrite — en utilisant le libellé « Numéro de facture » comme contexte pour lever l'ambiguïté de chaque caractère.
- L'écart de précision de 30 points entre les lettres capitales détachées à 95 % et les notes de terrain brouillonnes à 65 % est le chiffre honnête qu'aucun fournisseur n'affiche sur sa page d'accueil.
Dans quelle mesure l'IA lit l'écriture manuscrite aujourd'hui
La reconnaissance d'écriture manuscrite par l'IA est passée de « pratiquement inutile » à « utilisable en production » en environ trois ans — mais l'écart de précision selon le type d'écriture est important, et savoir où vos documents se situent sur ce spectre fait toute la différence entre un flux de travail efficace et un flux frustrant.
En 2023, même les meilleurs modèles d'IA échouaient face à l'écriture cursive. En 2026, la donne a changé. Sur la base de données d'écriture manuscrite IAM — une référence académique standard avec 13 353 lignes de texte provenant de 657 scripteurs différents — les meilleurs modèles atteignent désormais des taux d'erreur sur les caractères (CER) inférieurs à 2 %. Cela signifie moins de 2 caractères erronés pour 100 caractères lus. GPT-5 est en tête avec environ 1,22 % de CER, suivi de Claude Opus 4.7 à ~1,31 %, et Gemini 3 à ~1,44 % (codesota.com, benchmark 2026). Microsoft Azure Document Intelligence atteint ~1,8 % de CER, avec l'avantage d'une sortie structurée avec boîtes englobantes — utile pour les formulaires.
Voilà pour le tableau académique. Mais la précision dans le monde réel varie énormément selon le style d'écriture. Voici ce que nous apprennent les benchmarks indépendants et les retours de praticiens (AIMultiple 2026 ; Businessware Technologies 2026 ; codesota.com 2026) :
| Type d'écriture manuscrite | Précision de l'IA (2026) | OCR traditionnel | Notes |
|---|---|---|---|
| Écriture manuscrite en lettres détachées (lettres capitales) | 90–95 % | 60–80 % | Caractères propres et séparés. Azure atteint ~95 % sur une écriture en capitales soignée. |
| Écriture cursive soignée | 80–88 % | 30–50 % | Lettres liées mais style cohérent. GPT-4.1 a obtenu ~85 % sur une cursive propre d'une page. |
| Écriture cursive brouillonne | 65–75 % | 10–25 % | Formes de lettres irrégulières, inclinaison variable, ambiguïté au niveau des mots. |
| Difficile à lire / dégradé | 45–60 % | <10 % | Écriture très stylisée, copies carbone délavées, texte superposé. |
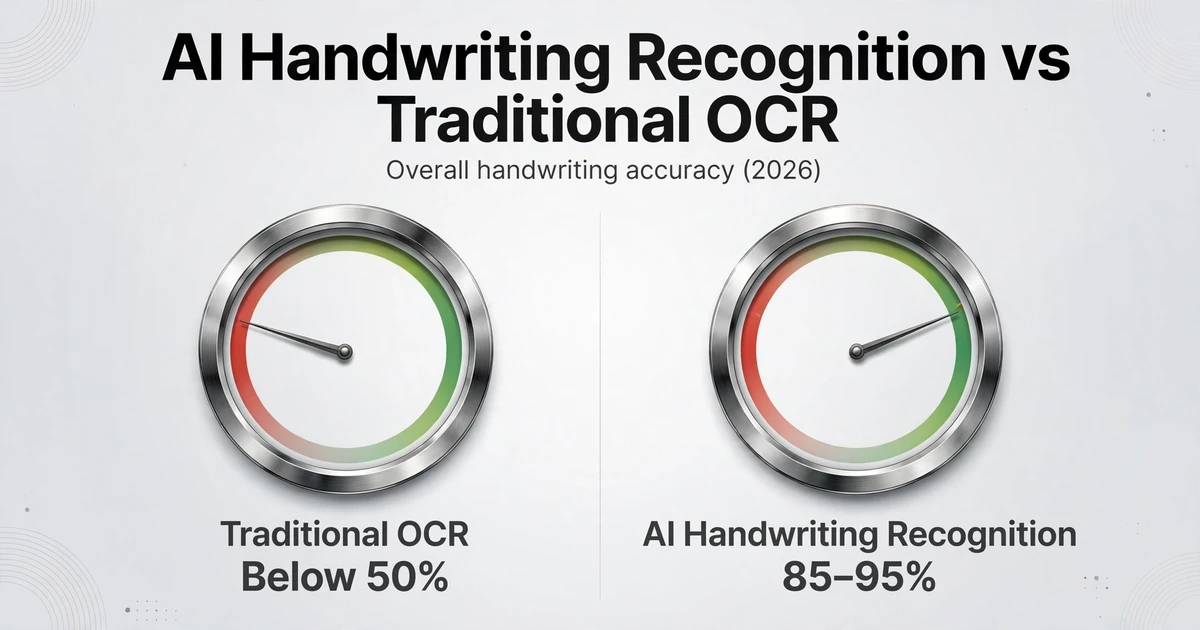
Ce sont des chiffres de précision pratique par type d'écriture — ce que vous pouvez attendre des outils d'IA actuels sur de vraies photos et scans. Les taux d'erreur au niveau des caractères (CER/WER) sous-jacents à ces chiffres, et la façon dont l'écart avec l'OCR traditionnel se creuse à mesure que l'écriture se dégrade, font l'objet de notre analyse approfondie sur le fonctionnement de la reconnaissance d'écriture manuscrite. Et parce qu'une précision élevée au niveau des caractères peut encore signifier des totaux erronés, consultez notre analyse sur pourquoi un CER de 90 % signifie encore des totaux erronés.
Les deux dernières lignes expliquent pourquoi la plupart des outils ne mentionnent pas la précision de l'écriture manuscrite. Un chiffre inférieur à 70 % est difficile à commercialiser. Mais c'est la réalité. Si vos documents sont principalement en écriture manuscrite en lettres détachées ou en cursive soignée, l'IA vous sera d'une grande utilité. S'il s'agit de notes de terrain brouillonnes de 12 techniciens différents, prévoyez de vérifier les résultats.
Le benchmark qui illustre le mieux l'écart entre l'IA et l'OCR traditionnel provient d'un test indépendant de 2026 (codesota.com) : Tesseract — le moteur OCR open-source le plus déployé — affiche un CER de 12,5 % sur la base de données d'écriture manuscrite IAM. Cela représente une erreur toutes les 8 caractères. Sur le benchmark WER 2026 de handwritingocr.com, Tesseract a obtenu un taux d'erreur sur les mots de 95,4 % — ce qui signifie qu'il se trompe sur presque chaque mot en écriture cursive. Ce n'est pas un problème de réglage ; Tesseract a été conçu pour le texte imprimé. Son approche de segmentation des caractères suppose que les lettres sont séparées — une hypothèse que l'écriture cursive contredit à chaque ligne.
Ce que la reconnaissance d'écriture manuscrite par IA réussit bien
L'IA excelle là où l'écriture manuscrite suit une structure — formulaires avec champs étiquetés, formats cohérents et écriture confinée dans des zones désignées.
L'OCR traditionnel fonctionne en segmentant une page en caractères individuels — isoler chaque lettre, la faire correspondre à une forme connue, puis produire le résultat. L'écriture cursive brise entièrement ce modèle. Les caractères se connectent, se fusionnent et se déforment d'une manière que les moteurs basés sur la segmentation ne peuvent pas séparer. L'IA moderne adopte l'approche inverse : elle examine la page entière comme le ferait un humain, en utilisant le contexte pour résoudre les ambiguïtés. Un « 1 » manuscrit et un « l » manuscrit peuvent être visuellement identiques isolément, mais une IA qui comprend que le champ est un montant en dollars peut les distinguer — l'OCR traditionnel ne le peut pas.
Les formulaires structurés avec champs étiquetés sont le domaine où la reconnaissance d'écriture manuscrite par IA brille le plus. Lorsqu'un champ est étiqueté « Numéro de facture » ou « Date », les modèles vision-langage utilisent cette étiquette comme ancre sémantique — ils savent quel type de contenu attendre dans cette zone. C'est le même mécanisme qui sous-tend l'extraction de colonnes personnalisée : vous définissez les données souhaitées (noms de colonnes comme « Total », « Nom du fournisseur », « Date »), et l'IA localise chaque valeur en comprenant ce qu'elle signifie, et non où elle se trouve sur la page. L'IA lit l'intégralité du document, recoupe les étiquettes de champs avec le contenu manuscrit environnant et extrait des données structurées — même lorsque les positions des champs varient entre les documents.
L'écriture manuscrite en lettres détachées et les lettres capitales sont désormais un problème résolu pour les modèles d'IA. Des recherches de Businessware Technologies (2026) ont confirmé que les grands modèles de langage modernes atteignent une précision quasi humaine sur une écriture en lettres capitales propre. Un examen distinct mené par des praticiens en 2025 a constaté qu'Azure Document Intelligence obtenait environ 95 % sur une écriture en lettres détachées soignée — proche de ses performances sur le texte imprimé. Si quelqu'un écrit en lettres capitales avec un stylo foncé sur du papier blanc, l'IA le lira de manière fiable.
Les documents cohérents rédigés par un seul scripteur fonctionnent également bien. Lorsque la même personne remplit un lot de bons de livraison ou de formulaires d'inspection, les modèles d'IA apprennent implicitement les schémas d'écriture du scripteur à travers les pages. Sur un benchmark de 100 échantillons d'écriture cursive rédigés par un ensemble fixe de contributeurs, les meilleurs modèles ont obtenu des scores de similarité sémantique suffisamment élevés pour une utilisation en production (AIMultiple, 2026). La variable clé n'est pas le nombre de scripteurs — c'est la cohérence de chaque scripteur au sein de ses propres documents.
L'écriture manuscrite en anglais dispose du plus grand volume de données d'entraînement et des meilleures performances de modèle. La prise en charge des langues à écriture latine (français, espagnol, allemand, portugais) est également solide, bien que la précision chute de 5 à 10 points de pourcentage pour l'écriture manuscrite non anglaise. Les écritures non latines (arabe, chinois, caractères japonais manuscrits, cursive cyrillique) s'améliorent mais restent en retrait — c'est encore un domaine de recherche active plutôt qu'un problème résolu.
Là où la reconnaissance d'écriture IA peine encore
La liste honnête des limites importe plus que les capacités — car promettre trop est le plus sûr moyen de perdre la confiance quand quelqu'un télécharge son premier document et obtient de mauvais résultats.
Documents très dégradés — encre pâlie, papier jauni, carbones, photocopies de troisième génération — réduisent fortement la précision. Une écriture déjà difficile à lire pour un humain devient quasi impossible pour l'IA. Les traits de crayon à peine visibles, l'encre abîmée par l'eau et les documents où le texte transparaît au verso cumulent les erreurs. Un avis Reddit 2025 de r/computervision l'a documenté précisément : un utilisateur testant 75 rapports d'inspection (225 pages) avec une écriture brouillonne de différents techniciens de terrain a constaté que les modèles d'IA généralistes produisaient des résultats utilisables sur les pages propres mais échouaient systématiquement sur les pages dégradées. Les outils OCR spécialisés dans l'écriture manuscrite ont bien mieux traité ces mêmes pages dégradées, montrant qu'une architecture de modèle adaptée à l'écriture compte plus que la capacité brute de l'IA sur les documents difficiles.
L'écriture cursive très stylisée et les scripts inhabituels restent difficiles. La copperplate du XIXe siècle, le Sütterlin allemand et la calligraphie ornementale sortent de la distribution d'entraînement de la plupart des modèles commerciaux. Le benchmark codesota 2026 notait que même le CER de 1,22 % de GPT-5 — le meilleur de sa catégorie — s'applique à la cursive anglaise standard du jeu de données IAM, pas aux scripts historiques ou très stylisés. Des outils spécialisés comme Transkribus, qui permettent d'entraîner des modèles personnalisés sur des styles d'écriture spécifiques, répondent à ce besoin de niche mais exigent un investissement important en configuration.
La dérive contextuelle sur plusieurs pages est un problème subtil mais réel. GPT-4.1 atteignait environ 85 % de précision sur une page unique propre, mais tombait à environ 75 % sur des sections narratives plus brouillonnes et jusqu'à environ 65 % à la troisième page de documents multipages (revue de praticien 2025). Le modèle commence à halluciner des suites — inventer du texte qui n'existe pas — à mesure que le contexte s'accumule. C'est une limitation connue des architectures actuelles de modèles vision-langage, activement travaillée.
Les chiffres et montants monétaires méritent une attention particulière. Un « 3 » mal lu pour un « 8 » ou un « 5 » pour un « 6 » dans un montant en dollars est une erreur bien plus coûteuse qu'un mot mal orthographié. Sur des montants cursifs brouillons, la vérification est essentielle — l'IA obtient le bon chiffre environ 80 à 85 % du temps sur une écriture claire, mais cela signifie qu'1 montant sur 6 pourrait être erroné sur des échantillons difficiles. Pour les documents financiers, le flux de travail pratique est : laissez l'IA tout extraire, puis vérifiez tous les champs monétaires.
Le contenu mixte imprimé et manuscrit sur la même page peut dérouter les modèles non spécifiquement conçus pour cela. Un formulaire où les étiquettes de champs imprimées côtoient des réponses manuscrites est le cas standard — et fonctionne bien. Mais un document imprimé couvert d'annotations manuscrites, de notes marginales et de corrections met à l'épreuve la compréhension de la mise en page. L'IA peut fusionner le texte imprimé et manuscrit en un seul flux ou attribuer de manière erronée quel texte appartient à quel champ.
Comment obtenir les meilleurs résultats de la lecture d'écriture manuscrite par IA
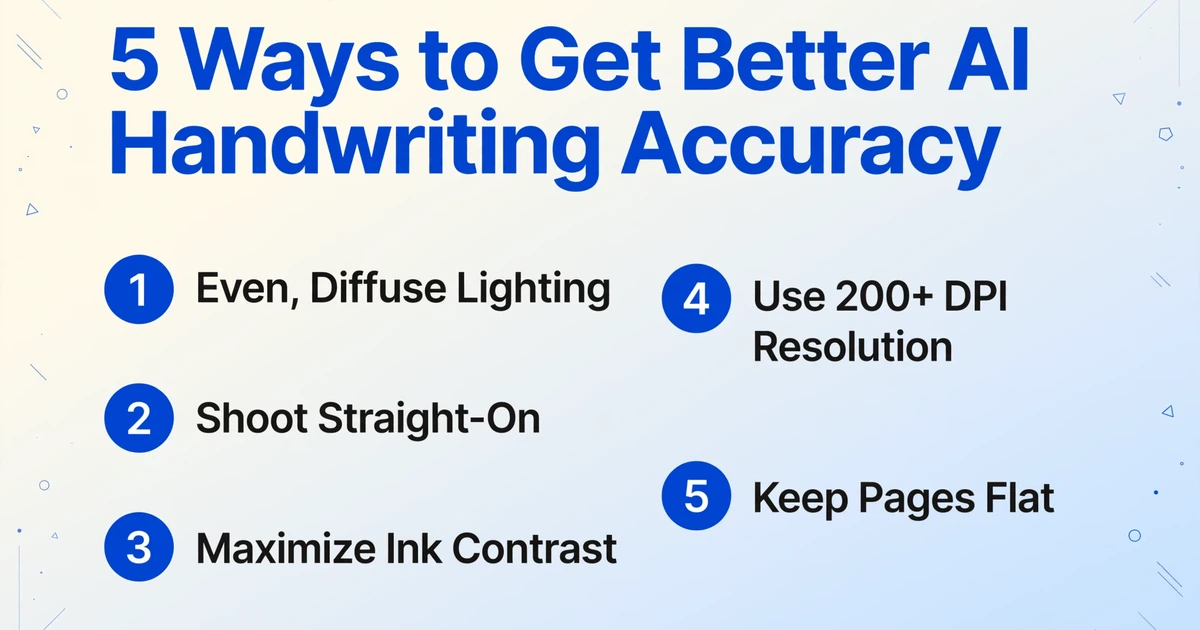
Le levier le plus important que vous contrôlez est la qualité de la photo. Une photo bien éclairée, prise de face et en haute résolution peut faire passer un échantillon d'écriture manuscrite limite dans la plage utilisable — sans mise à niveau du modèle.
1. Utilisez un éclairage uniforme et diffus. Les ombres sur une page créent des bords de contraste artificiels qui perturbent les modèles d'IA. La lumière naturelle du jour provenant d'une fenêtre est idéale. Si vous utilisez une lumière artificielle, placez deux sources lumineuses à des angles de 45 degrés pour éliminer les ombres. Évitez le flash direct — il crée des zones surbrillantes qui estompent l'encre.
2. Photographiez à la verticale, pas en biais. La distorsion de perspective due aux photos en angle oblige l'IA à redresser la page avant de la lire — ajoutant une étape de prétraitement où les erreurs s'accumulent. Tenez le téléphone parallèlement au document. La plupart des applications d'appareil photo modernes ont un mode de numérisation de document qui corrige automatiquement la perspective ; utilisez-le.
3. Maximisez le contraste entre l'encre et le papier. L'encre bleu foncé ou noire sur papier blanc est idéale. Le crayon clair, l'encre rouge sur papier coloré ou l'encre de stylo plume pâle réduisent tous la précision. Si vous contrôlez la saisie (par exemple, le personnel de terrain remplissant des formulaires), imposez des stylos à encre foncée — c'est l'amélioration de précision la moins chère disponible.
4. Utilisez une résolution d'au moins 200 PPP. Pour une page au format lettre standard, cela signifie environ 1700 x 2200 pixels — facilement réalisable avec n'importe quel smartphone des cinq dernières années. En dessous de 150 PPP, les traits des caractères se brouillent et la précision chute fortement. Au-dessus de 300 PPP, les gains sont marginaux pour les modèles d'IA modernes, bien que cela aide pour les très petites écritures manuscrites.
5. Gardez la page à plat et sans plis. Les plis et les froissements créent des distorsions géométriques qui cassent les formes des caractères. Si un document a été plié, aplatissez-le sous un livre pendant quelques heures avant de le photographier — ou utilisez plutôt un scanner. Les documents numérisés surpassent systématiquement les photos de téléphone de 3 à 8 points de pourcentage sur le même échantillon d'écriture manuscrite.
Exemples concrets de documents où l'IA lit l'écriture manuscrite
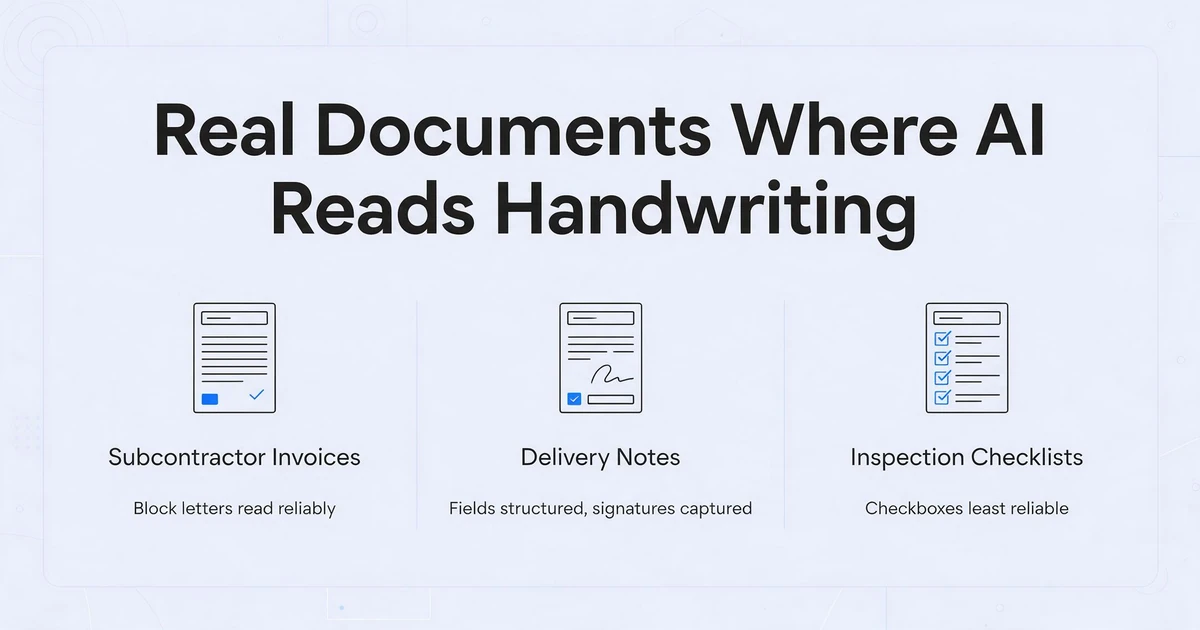
La meilleure façon de comprendre la précision de l'IA en lecture manuscrite est d'examiner les documents que les gens traitent réellement — et ce qui se passe lorsqu'ils le font.
Factures manuscrites de sous-traitants. Les entreprises de construction, de métiers spécialisés et de services sur site reçoivent encore chaque jour des factures manuscrites — un plombier griffonne l'adresse du chantier, les heures de travail, les matériaux et le total sur un bloc autocopiant. Ces factures mélangent un en-tête imprimé et des lignes manuscrites. L'IA gère bien ce cas : le texte imprimé fournit des points d'ancrage de mise en page, le contenu manuscrit est généralement en lettres capitales ou en écriture cursive soignée, et les libellés de champs comme « Total » et « Date » sont cohérents. Un outil utilisant l'extraction de colonnes personnalisées peut lire directement les montants manuscrits dans des colonnes structurées — heures, taux, matériaux, total — sans aucune ressaisie manuelle. Pour en savoir plus sur ce scénario précis, consultez notre guide sur l'extraction de données à partir de factures manuscrites de sous-traitants.
Bons de livraison et preuves de livraison sur le terrain. Les chauffeurs et coursiers remplissent les bons de livraison à la main — nom du destinataire, articles livrés, date, signature. Ces formulaires voyagent dans les cabines de camion, se plient et arrivent au bureau des jours plus tard avec des taches de café. L'écriture manuscrite est rarement soignée, mais les champs sont structurés : un bloc de signature, un champ date, une colonne quantité. L'IA lit de manière fiable les champs en lettres capitales ; les signatures sont capturées comme indicateurs de présence (a-t-elle été signée ? oui/non) plutôt que lues comme du texte. Pour les équipes logistiques qui traitent des dizaines de bons de livraison par jour, l'extraction IA par lots peut éliminer des heures de saisie manuelle. Consultez notre article sur le traitement par lots de bons de livraison manuscrits pour un flux de travail détaillé.
Listes de contrôle d'inspection sur le terrain. Les inspecteurs de sécurité, les équipes de contrôle qualité et les équipes de maintenance remplissent des listes de contrôle papier sur le terrain — souvent dans des conditions difficiles où une tablette n'est pas pratique. Ces formulaires combinent des cases à cocher (cochées/non cochées), des relevés numériques (valeurs de compteurs, températures, pressions) et de courts commentaires manuscrits (« fuite au niveau de la vanne 3 — signalée pour réparation »). L'IA moderne lit les trois : les cases à cocher sont détectées par reconnaissance visuelle de motifs, les champs numériques sont extraits avec une grande précision, et les commentaires manuscrits sont transcrits pour la tenue de registres. La détection des cases à cocher est la moins fiable des trois — pour une analyse approfondie des raisons pour lesquelles même les meilleurs modèles manquent une case cochée, et des schémas d'échec à surveiller, voir pourquoi l'IA lit les formulaires manuscrits mais manque encore une case cochée. Lors d'un test réel documenté sur Reddit r/computervision, un utilisateur a traité 75 rapports d'inspection (225 pages) avec une écriture manuscrite brouillonne de techniciens de terrain — des modèles d'IA spécialisés ont extrait avec succès des données structurées sur ~85 % des champs, tandis que les API OCR cloud généralistes ont eu beaucoup de mal avec les commentaires en écriture cursive.
Feuilles de temps manuscrites. Les travailleurs horaires, les équipes de chantier et le personnel de terrain soumettent encore des feuilles de temps manuscrites — nom, dates, heures par jour, codes de tâche, totaux. La disposition en grille d'une feuille de temps aide l'IA : chaque cellule contient un seul point de données, les en-têtes de colonnes fournissent un contexte sémantique, et le contenu est principalement composé de chiffres. L'IA extrait les entrées de temps colonne par colonne, en préservant la relation entre la date, les heures et le code de tâche. Le défi réside dans l'arithmétique — des chiffres manuscrits comme « 8,5 » peuvent être mal lus comme « 8,5 », « 8,3 » ou « 8,8 » selon la clarté de l'écriture. La vérification ponctuelle des totaux par rapport aux sommes quotidiennes permet de détecter la plupart des erreurs. Pour le traitement de la paie, voir le traitement par lots des feuilles de temps manuscrites pour la paie.
Formulaires médicaux manuscrits et documents d'admission. Les formulaires d'admission des patients, les documents de consentement et les notes cliniques restent sur papier dans de nombreux cabinets. Le défi de l'écriture manuscrite est ici aggravé par la terminologie médicale et les abréviations que les modèles d'IA généraux peuvent ne pas connaître. La reconnaissance spécialisée de l'écriture manuscrite médicale obtient de meilleurs résultats en s'entraînant sur un vocabulaire spécifique au domaine. L'OCR d'IA standard sur l'écriture manuscrite médicale atteint environ 70 à 80 % de précision — utilisable comme premier passage, mais nécessitant une vérification humaine pour les données cliniques où les erreurs ont des conséquences.
Questions fréquemment posées
L'IA peut-elle lire une écriture manuscrite brouillonne ?
Partiellement. L'IA gère une écriture manuscrite modérément brouillonne avec une précision de 65 à 75 % — suffisant pour réduire le travail manuel, mais pas assez pour s'y fier sans vérification. Un gribouillage vraiment illisible — le genre qui suscite des débats même entre humains — reste hors de portée des capacités actuelles de l'IA. Le seuil pratique : si deux personnes différentes lisant la même écriture s'accordent sur ce qu'elle dit, l'IA la déchiffrera probablement correctement. Si les humains ne sont pas d'accord, l'IA se trompera.
L'IA peut-elle lire une ancienne écriture cursive ?
Cela dépend de l'époque et du style. L'écriture cursive moderne (après 1950, en anglais) est bien couverte — la base de données d'écriture manuscrite IAM et d'autres ensembles de données d'entraînement utilisent ce style de manière extensive. L'anglaise du XIXe siècle, le Kurrent/Sütterlin allemand et la calligraphie ornée sont beaucoup plus difficiles. Des outils spécialisés comme Transkribus, qui peuvent être entraînés sur des styles d'écriture manuscrite spécifiques, gèrent mieux les écritures historiques que les modèles d'IA généralistes. Si vous numérisez des lettres de famille ou des archives historiques, prévoyez d'investir du temps dans l'entraînement du modèle ou la vérification manuelle.
La reconnaissance OCR de l'écriture manuscrite fonctionne-t-elle sur des photos prises avec un téléphone ?
Oui — et les photos prises avec un téléphone sont désormais le type d'entrée le plus courant. La clé réside dans la qualité de la photo : angle de face, éclairage uniforme, pas d'ombres, résolution effective d'au moins 200 PPP. Une photo bien prise d'un document manuscrit avec un téléphone produit une précision à 3 à 5 points de pourcentage près d'un scan à plat. L'écart entre les photos prises avec un téléphone et les scans s'est considérablement réduit depuis 2024, car les modèles d'IA se sont améliorés pour gérer les artefacts d'image du monde réel.
L'IA peut-elle extraire des données structurées de formulaires manuscrits, et pas seulement transcrire le texte ?
Oui — c'est ce qui distingue l'extraction moderne par IA de la simple transcription d'écriture manuscrite en texte. Au lieu de produire un bloc de texte brut (« Facture n° 1042 Date 15/03/26 Total 847,50 $ »), l'extraction structurée place chaque valeur dans sa propre colonne — « Numéro de facture : 1042 », « Date : 15/03/26 », « Total : 847,50 $ » — prête à être importée dans un tableur, un système comptable ou une base de données. Cela est réalisé grâce à l'extraction de colonnes personnalisées : vous définissez les noms de colonnes souhaités, et l'IA localise et extrait chaque valeur en comprenant sa signification sémantique, sans correspondance avec une position de modèle. Pour une explication plus approfondie de ce mécanisme, consultez notre article sur ce qu'est la reconnaissance d'écriture manuscrite par IA et comment elle fonctionne.
L'IA peut-elle lire l'écriture manuscrite dans d'autres langues que l'anglais ?
Oui, avec des réserves. Les langues à écriture latine (français, espagnol, allemand, portugais, italien) sont bien prises en charge et atteignent une précision à 5 à 10 points de pourcentage près de l'anglais. AWS Textract, par exemple, prend explicitement en charge l'écriture manuscrite en anglais, avec la prise en charge du texte imprimé étendue à l'espagnol, au portugais, au français, à l'allemand et à l'italien. Les écritures non latines (arabe, caractères chinois manuscrits, japonais, cursive cyrillique) s'améliorent mais restent en retrait — attendez-vous à une précision moindre et à des erreurs plus fréquentes. Pour les documents multilingues, les modèles d'IA gèrent assez bien le changement de langue si les deux langues utilisent l'écriture latine, mais rencontrent des difficultés lorsque les écritures diffèrent (par exemple, des annotations en anglais sur un formulaire manuscrit japonais).
Comment la reconnaissance d'écriture manuscrite par IA se compare-t-elle à un transcripteur humain ?
Sur une écriture claire et soignée, l'IA égale ou dépasse la précision humaine — les humains commettent aussi des erreurs de transcription, d'environ 2 à 5 % sur un texte propre. Sur une écriture cursive brouillonne, un humain qui connaît le style de l'auteur surpasse encore l'IA. Une étude de cas de 2025 menée par Digital Scientists (R&D de Mailchimp) a rapporté une précision de 85 % sur une écriture lisible et de 60 % sur une écriture médiocre, à l'aide d'un réseau neuronal LSTM entraîné — approximativement comparable à un lecteur humain non familier confronté à la même écriture pour la première fois. Le principal avantage de l'IA est la vitesse : un document manuscrit de 2 pages qui prend 15 à 20 minutes à un humain pour être transcrit est traité par l'IA en moins de 30 secondes.
Puis-je utiliser des outils OCR gratuits comme Tesseract pour l'écriture manuscrite ?
Non — pas pour l'écriture manuscrite. Tesseract a été conçu pour le texte imprimé et atteint au mieux 20 à 40 % de précision sur l'écriture manuscrite. Sur le benchmark d'écriture manuscrite IAM, Tesseract obtient un taux d'erreur sur les caractères (CER) de 12,5 % — environ une erreur tous les 8 caractères — et sur l'écriture cursive, son taux d'erreur sur les mots (WER) dépasse 95 %. Des outils gratuits comme EasyOCR performent légèrement mieux, avec 60 à 70 % sur une écriture soignée, mais l'écart entre les moteurs gratuits et l'IA moderne (GPT-5, Claude, Gemini, Azure) est énorme. L'OCR « gratuit » coûte souvent plus cher en travail de correction manuelle que l'utilisation d'un outil d'IA performant dès le départ. Pour une comparaison détaillée, consultez la reconnaissance d'écriture manuscrite par IA vs l'OCR traditionnel.
La reconnaissance d'écriture manuscrite par IA en 2026 est suffisamment performante pour transformer des flux de travail réels — mais seulement si vous alignez vos attentes sur la qualité de vos documents. Des lettres capitales imprimées et une écriture cursive soignée sur des formulaires structurés ? L'IA vous fera gagner des heures. Des notes de terrain brouillonnes, des copies carbone dégradées et des écritures historiques ornées ? L'IA vous aidera, mais vous aurez toujours besoin d'un humain dans la boucle. La bonne question n'est pas « l'IA peut-elle lire l'écriture manuscrite ? » — c'est « l'IA peut-elle lire mon écriture, sur mes documents ? » La seule façon de le savoir est de l'essayer sur un échantillon réel.
Pour une compréhension plus large de la façon dont l'IA traite les documents — pas seulement l'écriture manuscrite — commencez par ce qu'est l'extraction de documents par IA et comment elle fonctionne. Si vous traitez spécifiquement des formulaires d'inspection manuscrits, consultez notre guide sur l'extraction de formulaires d'inspection manuscrits et sa précision. Et si vous rencontrez des résultats médiocres, notre article sur les modes de défaillance de l'extraction manuscrite et leurs correctifs couvre les problèmes les plus courants et leurs solutions.