A IA consegue ler escrita à mão em fotos?
Sim — veja a precisão
Sim. Os modelos de visão de IA modernos conseguem ler escrita à mão com 85–95% de precisão em imagens de qualidade razoável — muito melhor que o OCR tradicional, que cai abaixo de 50% em cursiva e muitas vezes falha completamente em escrita bagunçada. A diferença não é pequena: é a diferença entre obter dados utilizáveis e obter algo sem sentido. Mas a precisão não é um número único — depende muito do tipo de escrita à mão. A escrita à mão em letra de forma fica perto de 95%. A cursiva legível fica em torno de 85%. A cursiva bagunçada cai para 65–75%. Escrita difícil de ler? Ainda é um desafio para todos os modelos do mercado.
Onde isso se encaixa: esta página é a referência de precisão para perguntas do tipo "a IA consegue ler...", com números detalhados por tipo de escrita à mão. Para a definição da tecnologia, veja o que é reconhecimento de escrita à mão por IA; para saber como funciona por dentro, veja como funciona o reconhecimento de escrita à mão.
Principais conclusões
- O OCR tradicional erra 95 de cada 100 palavras em cursiva — sua arquitetura foi feita para letras impressas separadas, e a cursiva conecta cada letra por definição.
- Os modelos de visão de IA invertem toda a abordagem ao ler páginas como você lê uma anotação à mão — usando o rótulo "Invoice Number" como contexto para desambiguar cada caractere ambíguo.
- A diferença de 30 pontos de precisão entre letra de forma a 95% e notas de campo bagunçadas a 65% é o número honesto que nenhum fornecedor coloca na página inicial.
O Quão Bem a IA Lê Escrita à Mão Hoje
O reconhecimento de escrita à mão por IA passou de "quase inútil" para "utilizável em produção" em cerca de três anos — mas a variação de precisão por tipo de escrita é grande, e saber onde seus documentos se encaixam nesse espectro é a diferença entre um fluxo de trabalho funcional e um frustrante.
Em 2023, até os melhores modelos de IA falhavam com letra cursiva. Em 2026, o cenário é diferente. No banco de dados de caligrafia IAM — um benchmark acadêmico padrão com 13.353 linhas de texto de 657 escritores diferentes — os melhores modelos agora alcançam taxas de erro de caracteres (CERs) abaixo de 2%. Isso significa menos de 2 caracteres errados por 100 caracteres lidos. O GPT-5 lidera com aproximadamente 1,22% de CER, seguido pelo Claude Opus 4.7 com ~1,31%, e o Gemini 3 com ~1,44% (codesota.com, benchmark de 2026). O Microsoft Azure Document Intelligence entrega ~1,8% de CER com o bônus de saída estruturada com caixas delimitadoras — útil para formulários.
Esse é o cenário acadêmico. Mas a precisão no mundo real varia enormemente conforme o estilo de escrita. Aqui está o que benchmarks independentes e relatos de profissionais (AIMultiple 2026; Businessware Technologies 2026; codesota.com 2026) nos dizem:
| Tipo de Escrita à Mão | Precisão da IA (2026) | OCR Tradicional | Observações |
|---|---|---|---|
| Escrita à mão em letra de forma | 90–95% | 60–80% | Caracteres limpos e separados. O Azure atinge ~95% em letra de forma legível. |
| Cursiva legível | 80–88% | 30–50% | Letras conectadas, mas estilo consistente. O GPT-4.1 obteve ~85% em cursiva limpa de página única. |
| Cursiva bagunçada | 65–75% | 10–25% | Formatos de letras inconsistentes, inclinação variável, ambiguidade no nível da palavra. |
| Difícil de ler / degradado | 45–60% | <10% | Caligrafia altamente estilizada, cópias carbono desbotadas, texto sobreposto. |
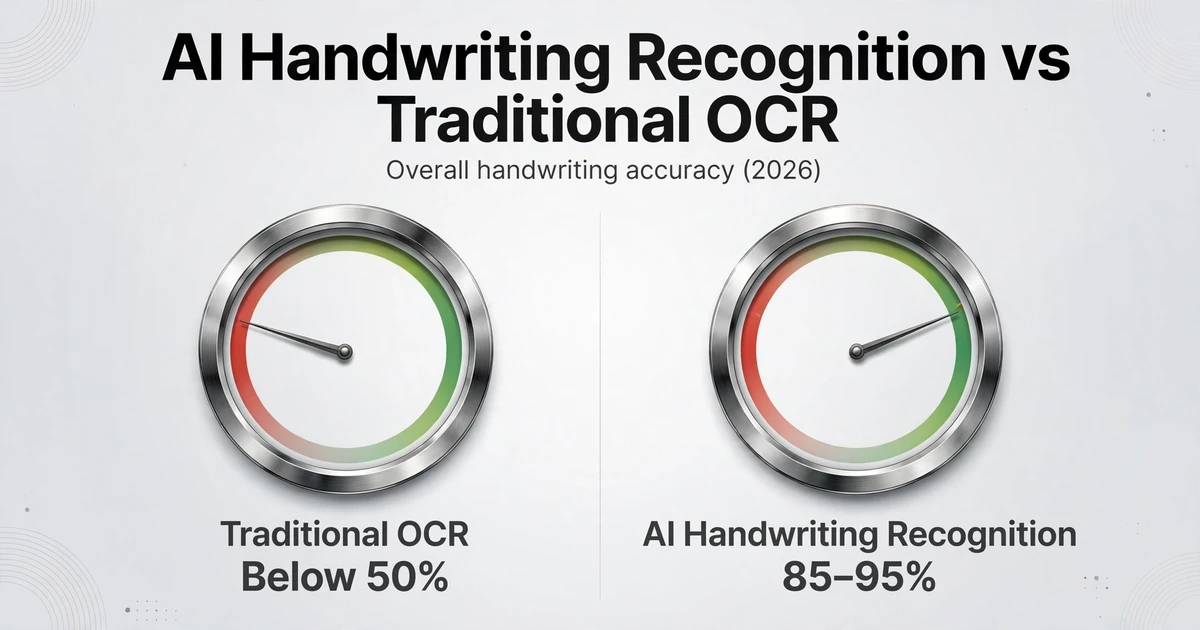
Estes são números práticos de precisão utilizável por tipo de escrita — o que você pode esperar das ferramentas de IA atuais em fotos e digitalizações reais. As taxas de erro em nível de caractere (CER/WER) por trás desses números, e como a diferença para o OCR tradicional aumenta conforme a escrita se degrada, são o tema do nosso mergulho profundo em como funciona o reconhecimento de escrita à mão. E porque mesmo alta precisão de caracteres ainda pode significar totais errados, veja nossa análise sobre por que 90% de CER ainda significa totais errados.
As duas últimas linhas explicam por que a maioria das ferramentas não menciona a precisão da escrita à mão. Um número abaixo de 70% é difícil de comercializar. Mas essa é a realidade. Se seus documentos são principalmente escrita à mão em letra de forma ou cursiva legível, a IA vai te atender bem. Se forem notas de campo bagunçadas de 12 técnicos diferentes, espere revisar os resultados.
O benchmark que melhor ilustra a diferença entre IA e OCR tradicional vem de um teste independente de 2026 (codesota.com): o Tesseract — o mecanismo de OCR de código aberto mais amplamente utilizado — retorna uma taxa de erro de caracteres (CER) de 12,5% no banco de dados de caligrafia IAM. Isso é um erro a cada 8 caracteres. No benchmark de taxa de erro de palavras (WER) de 2026 do handwritingocr.com, o Tesseract obteve 95,4% de taxa de erro de palavras — ou seja, ele erra quase todas as palavras em texto cursivo. Isso não é um problema de ajuste; o Tesseract foi arquitetado para texto impresso. Sua abordagem de segmentação de caracteres assume que as letras são separadas — uma suposição que a escrita cursiva quebra em todas as linhas.
O que o Reconhecimento de Caligrafia por IA Acerta
A IA se destaca onde a caligrafia segue uma estrutura — formulários com campos rotulados, formatos consistentes e escrita contida em áreas designadas.
O OCR tradicional funciona segmentando uma página em caracteres individuais — isolar cada letra, compará-la a uma forma conhecida e gerar o resultado. A escrita cursiva quebra esse modelo por completo. Os caracteres se conectam, se mesclam e se distorcem de maneiras que os mecanismos baseados em segmentação não conseguem separar. A IA moderna adota a abordagem oposta: ela olha para a página inteira como um humano faria, usando o contexto para resolver ambiguidades. Um "1" manuscrito e um "l" manuscrito podem ser visualmente idênticos isoladamente, mas uma IA que entende que o campo é um valor em dólares consegue diferenciá-los — o OCR tradicional não consegue.
Formulários estruturados com campos rotulados são onde o reconhecimento de caligrafia por IA mais brilha. Quando um campo é rotulado como "Número da Fatura" ou "Data", os modelos de visão e linguagem usam esse rótulo como uma âncora semântica — eles sabem que tipo de conteúdo esperar naquela região. Esse é o mesmo mecanismo por trás da extração de colunas personalizada: você define quais dados quer (nomes de colunas como "Total", "Nome do Fornecedor", "Data"), e a IA localiza cada valor entendendo o que ele significa, não onde ele está na página. A IA lê o documento inteiro, cruza os rótulos dos campos com o conteúdo manuscrito próximo e extrai dados estruturados — mesmo quando as posições dos campos variam entre documentos.
Escrita à mão em letra de forma agora é um problema resolvido para modelos de IA. Pesquisas da Businessware Technologies (2026) confirmaram que modelos de linguagem modernos alcançam precisão quase humana em caligrafia limpa em letra de forma. Uma revisão prática de 2025 descobriu que o Azure Document Intelligence obteve ~95% de precisão em letra de forma legível — próximo ao seu desempenho em texto impresso. Se alguém escreve em letras maiúsculas com caneta escura em papel branco, a IA lerá de forma confiável.
Documentos consistentes de um único escritor também têm bom desempenho. Quando a mesma pessoa preenche um lote de notas de entrega ou formulários de inspeção, os modelos de IA aprendem os padrões do escritor implicitamente entre as páginas. Em um benchmark de 100 amostras de caligrafia cursiva escritas por um conjunto fixo de colaboradores, os melhores modelos alcançaram pontuações de similaridade semântica altas o suficiente para uso em produção (AIMultiple, 2026). A variável-chave não é o número de escritores — é se cada escritor é consistente em seus próprios documentos.
Caligrafia em inglês tem a maior quantidade de dados de treinamento e o desempenho de modelo mais forte. O suporte para idiomas com escrita latina (francês, espanhol, alemão, português) também é sólido, embora a precisão caia de 5 a 10 pontos percentuais para caligrafia não inglesa. Escritas não latinas (árabe, chinês, caracteres manuscritos japoneses, cursiva cirílica) estão melhorando, mas ainda ficam para trás — essa ainda é uma área de pesquisa ativa, não um problema resolvido.
Onde o Reconhecimento de Escrita Manual por IA Ainda Enfrenta Dificuldades
A lista honesta de limitações é mais importante que as capacidades — porque prometer demais é o caminho mais rápido para perder a confiança quando alguém envia seu primeiro documento e obtém resultados ruins.
Documentos muito degradados — tinta desbotada, papel amarelado, cópias carbono, fotocópias de terceira geração — reduzem drasticamente a precisão. Escrita manual que já é difícil para um humano ler torna-se quase impossível para a IA. Marcas de lápis fracas, tinta danificada por água e documentos onde o texto vaza do verso agravam os erros. Uma avaliação de 2025 no Reddit (r/computervision) documentou isso precisamente: um usuário testando 75 relatórios de inspeção (225 páginas) com caligrafia confusa de diferentes técnicos de campo descobriu que modelos de IA de uso geral produziam resultados utilizáveis em páginas mais limpas, mas falhavam consistentemente nas degradadas. Ferramentas especializadas de OCR para escrita manual lidaram significativamente melhor com as mesmas páginas degradadas, ilustrando que a arquitetura do modelo ajustada para caligrafia importa mais que a capacidade bruta da IA em documentos difíceis.
Caligrafia cursiva muito estilizada e escritas incomuns continuam sendo um desafio. Copperplate do século XIX, Sütterlin alemão e caligrafia ornamentada estão fora da distribuição de treinamento da maioria dos modelos comerciais. O benchmark codesota 2026 observou que mesmo o CER de 1,22% do GPT-5 — o melhor da categoria — se aplica à cursiva inglesa padrão do conjunto de dados IAM, não a escritas históricas ou altamente estilizadas. Ferramentas especializadas como Transkribus, que permitem treinar modelos personalizados em estilos específicos de caligrafia, atendem a esse nicho, mas exigem um investimento significativo de configuração.
Desvio de contexto em várias páginas é um problema sutil, mas real. O GPT-4.1 alcançou ~85% de precisão em caligrafia limpa de página única, mas caiu para ~75% em seções narrativas mais confusas e para ~65% na terceira página de documentos com várias páginas (avaliação de profissional de 2025). O modelo começa a alucinar continuações — inventando texto que não existe — à medida que o contexto se acumula. Esta é uma limitação conhecida das arquiteturas atuais de modelos de linguagem-visão e está sendo ativamente trabalhada.
Números e valores monetários merecem cuidado especial. Um "3" lido como "8" ou "5" como "6" em um valor em dólar é um erro muito mais custoso que uma palavra escrita incorretamente. Em valores cursivos confusos, a verificação é essencial — a IA acerta o número aproximadamente 80–85% das vezes em caligrafia clara, mas isso ainda significa que 1 em cada 6 valores pode estar errado em amostras difíceis. Para documentos financeiros, o fluxo de trabalho prático é: deixe a IA extrair tudo, depois verifique todos os campos de moeda.
Conteúdo misto impresso e manuscrito na mesma página pode confundir modelos que não são especificamente projetados para isso. Um formulário onde rótulos de campos impressos ficam ao lado de respostas manuscritas é o caso padrão — e funciona bem. Mas um documento impresso coberto de anotações manuscritas, notas marginais e correções desafia a compreensão do layout. A IA pode mesclar texto impresso e manuscrito em um único fluxo ou atribuir incorretamente qual texto pertence a qual campo.
Como obter os melhores resultados com a leitura de caligrafia por IA
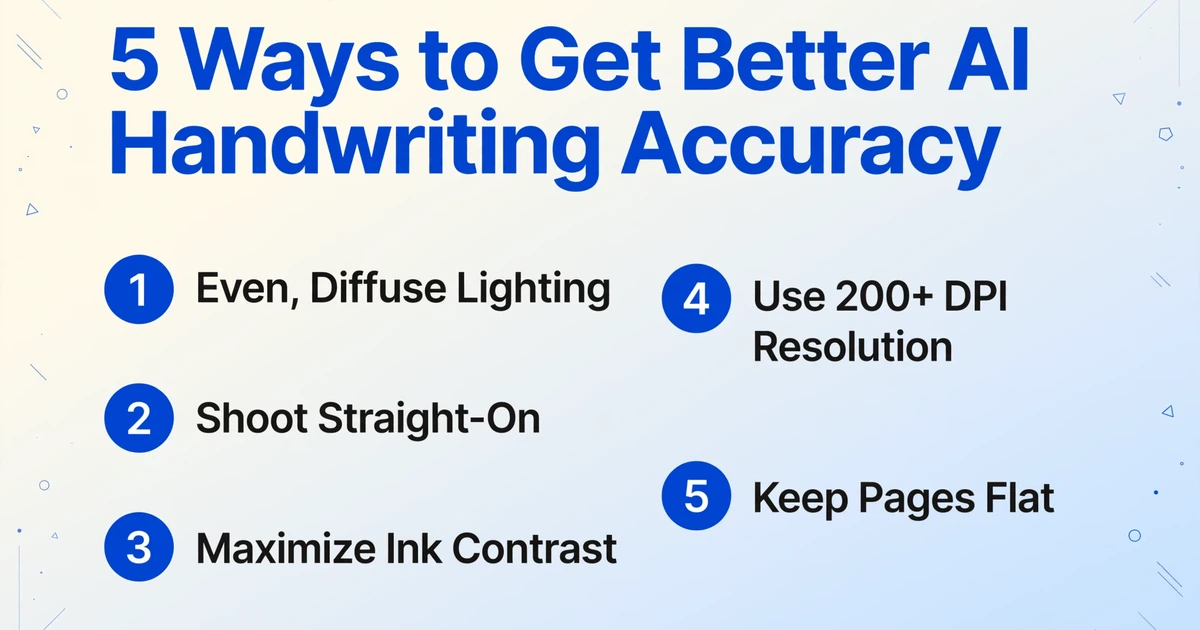
O maior fator que você controla é a qualidade da foto. Uma foto bem iluminada, de frente e em alta resolução pode levar uma amostra de caligrafia no limite para a faixa utilizável — sem precisar de upgrade de modelo.
1. Use iluminação uniforme e difusa. Sombras na página criam bordas de contraste artificiais que confundem os modelos de IA. A luz natural de uma janela é ideal. Se usar luz artificial, posicione duas fontes de luz em ângulos de 45 graus para eliminar sombras. Evite flash direto — ele cria pontos de brilho que apagam a tinta.
2. Fotografe de frente, não em ângulo. A distorção de perspectiva em fotos anguladas força a IA a endireitar a página antes de ler — adicionando uma etapa de pré-processamento onde erros se acumulam. Segure o celular paralelo ao documento. A maioria dos aplicativos de câmera modernos tem um modo de digitalização de documentos que corrige a perspectiva automaticamente; use-o.
3. Maximize o contraste entre tinta e papel. Tinta azul escura ou preta em papel branco é ideal. Lápis claro, tinta vermelha em papel colorido ou tinta de caneta-tinteiro fraca reduzem a precisão. Se você controla a entrada (por exemplo, equipe de campo preenchendo formulários), exija canetas de tinta escura — é a melhoria de precisão mais barata disponível.
4. Use uma resolução de pelo menos 200 DPI. Para uma página tamanho carta padrão, isso significa aproximadamente 1700 x 2200 pixels — facilmente alcançável com qualquer smartphone dos últimos cinco anos. Abaixo de 150 DPI, os traços das letras se misturam e a precisão cai drasticamente. Acima de 300 DPI, os ganhos são marginais para modelos de IA modernos, embora ajude em caligrafia muito pequena.
5. Mantenha a página plana e sem vincos. Dobras e amassados criam distorções geométricas que quebram o formato das letras. Se um documento foi dobrado, achate-o sob um livro por algumas horas antes de fotografar — ou use um scanner. Documentos digitalizados superam consistentemente fotos de celular em 3 a 8 pontos percentuais na mesma amostra de caligrafia.
Documentos Reais em que a IA Lê Escrita à Mão
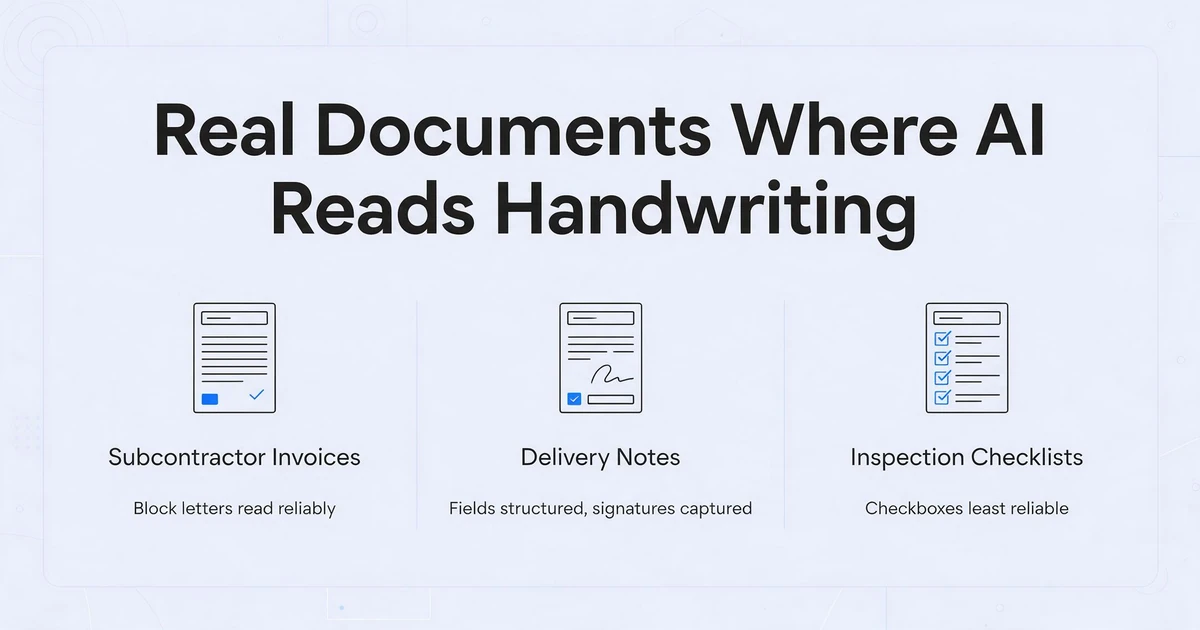
A melhor forma de entender a precisão da IA na leitura de escrita à mão é observar os documentos que as pessoas realmente processam — e o que acontece quando elas o fazem.
Faturas manuscritas de subcontratados. Empresas de construção, ofícios e serviços de campo ainda recebem faturas manuscritas diariamente — um encanador rabisca o endereço do serviço, horas de trabalho, materiais e total em um bloco de papel carbono. Essas faturas misturam cabeçalho impresso com itens manuscritos. A IA lida bem com isso: o texto impresso fornece âncoras de layout, o conteúdo manuscrito geralmente é em letra de forma ou cursiva legível, e rótulos de campo como "Total" e "Data" são consistentes. Uma ferramenta que usa Extração de Colunas Personalizadas pode ler os valores manuscritos diretamente em colunas estruturadas — horas, taxa, materiais, total — sem redigitação manual. Para mais detalhes sobre esse cenário específico, veja nosso guia sobre extração de dados de faturas manuscritas de subcontratados.
Notas de entrega em campo e comprovante de entrega. Motoristas e entregadores preenchem notas de entrega à mão — nome do destinatário, itens entregues, data, assinatura. Esses formulários viajam em cabines de caminhão, são dobrados e chegam ao escritório dias depois com manchas de café. A caligrafia raramente é caprichada, mas os campos são estruturados: um bloco de assinatura, um campo de data, uma coluna de quantidade. A IA lê os campos em letra de forma de forma confiável; assinaturas são capturadas como indicadores de presença (foi assinado? sim/não) em vez de lidas como texto. Para equipes de logística que processam dezenas de notas de entrega diariamente, a extração em lote com IA pode eliminar horas de entrada manual. Veja nosso artigo sobre processamento em lote de notas de entrega manuscritas para um fluxo de trabalho detalhado.
Checklists de inspeção em campo. Inspetores de segurança, equipes de controle de qualidade e equipes de manutenção preenchem checklists de papel no campo — muitas vezes em condições adversas onde um tablet não é prático. Esses formulários combinam caixas de seleção (marcadas/não marcadas), leituras numéricas (valores de medidores, temperaturas, pressões) e comentários manuscritos curtos ("vazamento na válvula 3 — sinalizado para reparo"). A IA moderna lê os três: caixas de seleção detectadas por reconhecimento de padrões visuais, campos numéricos extraídos com alta precisão e comentários manuscritos transcritos para registro. A detecção de caixas de seleção é a menos confiável dos três — para um mergulho profundo sobre por que até os melhores modelos erram uma caixa marcada e os padrões de falha a observar, veja por que a IA lê formulários manuscritos, mas ainda erra uma caixa marcada. Em um teste do mundo real documentado no Reddit r/computervision, um usuário processou 75 relatórios de inspeção (225 páginas) com caligrafia bagunçada de técnicos de campo — modelos de IA especializados extraíram dados estruturados com sucesso em ~85% dos campos, enquanto APIs de OCR em nuvem de uso geral tiveram dificuldades consideráveis com comentários em cursiva.
Folhas de ponto manuscritas. Trabalhadores horistas, equipes de construção e funcionários de campo ainda enviam folhas de ponto manuscritas — nome, datas, horas por dia, códigos de trabalho, totais. O layout em grade de uma folha de ponto ajuda a IA: cada célula contém um único dado, os cabeçalhos das colunas fornecem contexto semântico e o conteúdo é principalmente números. A IA extrai os registros de tempo coluna por coluna, preservando a relação entre data, horas e código de trabalho. O desafio é a aritmética — números manuscritos como "8,5" podem ser lidos incorretamente como "8,5" ou "8,3" ou "8,8", dependendo da clareza da caligrafia. A verificação pontual dos totais em relação às somas diárias detecta a maioria dos erros. Para processamento de folha de pagamento, consulte processamento em lote de folhas de ponto manuscritas para folha de pagamento.
Formulários médicos manuscritos e documentos de admissão. Fichas de admissão de pacientes, documentos de consentimento e notas clínicas continuam em papel em muitos consultórios. O desafio da caligrafia aqui é agravado pela terminologia médica e abreviações que os modelos gerais de IA podem não conhecer. O reconhecimento especializado de caligrafia médica alcança melhores resultados ao treinar com vocabulário específico do domínio. O OCR de IA padrão em caligrafia médica alcança aproximadamente 70–80% de precisão — utilizável como primeira passagem, mas exigindo verificação humana para dados clínicos onde erros têm consequências.
Perguntas Frequentes
A IA consegue ler caligrafia bagunçada?
Parcialmente. A IA lida com caligrafia moderadamente bagunçada com 65–75% de precisão — o suficiente para reduzir o trabalho manual, mas não o suficiente para confiar sem revisão. Rabiscos verdadeiramente ilegíveis — o tipo que até humanos discutem — permanecem além da capacidade atual da IA. O limite prático: se duas pessoas diferentes lendo a mesma caligrafia concordam sobre o que está escrito, a IA provavelmente acertará. Se os humanos discordam, a IA errará.
A IA consegue ler caligrafia cursiva antiga?
Depende da época e do estilo. A cursiva moderna (pós-1950, inglês) é bem coberta — o banco de dados de caligrafia IAM e outros conjuntos de dados de treinamento usam esse estilo extensivamente. A caligrafia inglesa do século XIX, Kurrent/Sütterlin alemão e caligrafia ornamentada são muito mais difíceis. Ferramentas especializadas como Transkribus, que podem ser treinadas em estilos específicos de caligrafia, lidam melhor com escritas históricas do que modelos gerais de IA. Se você está digitalizando cartas de família ou arquivos históricos, espere investir tempo em treinamento de modelo ou revisão manual.
A OCR de escrita manual funciona em fotos tiradas com o celular?
Sí — e as fotos de celular são agora o tipo de entrada mais comum. A chave é a qualidade da foto: ângulo reto, iluminação uniforme, sem sombras, resolução efetiva de pelo menos 200 DPI. Uma foto de celular bem tirada de um documento manuscrito produz uma precisão dentro de 3–5 pontos percentuais de um scan de mesa. A diferença entre fotos de celular e scans diminuiu significativamente desde 2024, à medida que os modelos de IA melhoraram no manuseo de artefactos de imagem do mundo real.
A IA pode extrair dados estruturados de formulários manuscritos, não apenas transcribir o texto?
Sí — isso é o que separa a extração moderna com IA da transcrição básica de escrita manual a texto. Em vez de produzir um bloco de texto bruto ("Fatura #1042 Data 3/15/26 Total $847.50"), a extração estruturada coloca cada valor em sua própria coluna — "Número de Fatura: 1042," "Data: 3/15/26," "Total: $847.50" — pronto para importar em uma planilha, sistema contable ou base de dados. Isso é alcanzado através de extração de colunas personalizada: você define os nomes de colunas que deseja, e a IA localiza e extrae cada valor entendendo o que significa semanticamente, não combinando uma posição de modelo. Para uma explicação mais profunda de como este mecanismo funciona, veja nosso artigo sobre o que é o reconhecimento de escrita manual com IA e como funciona.
A IA pode ler escrita manual em idiomas diferentes do inglês?
Sí, com qualificação. Idiomas com alfabeto latino (francês, espanhol, alemán, português, italiano) estão bem suportados e alcanzan precisão dentro de 5–10 pontos percentuais do inglês. AWS Textract, por exemplo, suporta explicitamente escrita manual em inglês com suporte de texto impresso estendido a espanhol, português, francés, alemán e italiano. Escrituras não latinas (árabe, caracteres chineses manuscritos, japonés, cursiva cirílica) estão melhorando mas ficam atrás — espere menor precisão e erros mais frequentes. Para documentos em idiomas mistos, os modelos de IA manusean bem a comutação de idiomas se ambos usan alfabeto latino, mas têm dificultades quando as escrituras diferem (por exemplo, anotações em inglês em um formulário japonés manuscrito).
Como o reconhecimento de caligrafia por IA se compara a um transcritor humano?
Em caligrafia clara e legível, a IA iguala ou supera a precisão humana — humanos também cometem erros de transcrição, em cerca de 2–5% em texto limpo. Em cursiva bagunçada, um humano que conhece o estilo do escritor ainda supera a IA. Um estudo de caso de 2025 da Digital Scientists (P&D do Mailchimp) relatou 85% de precisão em caligrafia legível e 60% em caligrafia ruim usando uma rede neural LSTM treinada — aproximadamente comparável a um leitor humano não familiarizado que encontra a mesma caligrafia pela primeira vez. A principal vantagem da IA é a velocidade: um documento manuscrito de 2 páginas que leva 15–20 minutos para um humano transcrever é processado pela IA em menos de 30 segundos.
Posso usar ferramentas de OCR gratuitas como o Tesseract para caligrafia?
Não — não para caligrafia. O Tesseract foi projetado para texto impresso e atinge no máximo 20–40% de precisão em caligrafia. No benchmark de caligrafia IAM, o Tesseract pontua uma taxa de erro de caracteres (CER) de 12,5% — aproximadamente um erro a cada 8 caracteres — e em cursiva, sua taxa de erro de palavras (WER) excede 95%. Ferramentas gratuitas como o EasyOCR têm desempenho marginalmente melhor, com 60–70% em caligrafia legível, mas a lacuna entre mecanismos gratuitos e IA moderna (GPT-5, Claude, Gemini, Azure) é enorme. O OCR "gratuito" muitas vezes custa mais em trabalho de correção manual do que usar uma ferramenta de IA capaz desde o início. Para uma comparação detalhada, veja reconhecimento de caligrafia por IA vs OCR tradicional.
O reconhecimento de caligrafia por IA em 2026 é bom o suficiente para transformar fluxos de trabalho reais — mas apenas se você alinhar suas expectativas à qualidade do seu documento. Letra de forma impressa e cursiva legível em formulários estruturados? A IA vai economizar horas para você. Notas de campo bagunçadas, cópias carbono degradadas e escrita histórica ornamentada? A IA vai ajudar, mas você ainda precisará de um humano no processo. A pergunta certa não é "a IA consegue ler caligrafia?" — é "a IA consegue ler minha caligrafia, em meus documentos?" A única maneira de descobrir é testar com uma amostra real.
Para uma compreensão mais ampla de como a IA lida com documentos — não apenas caligrafia — comece com o que é extração de documentos por IA e como funciona. Se você está lidando especificamente com formulários de inspeção manuscritos, veja nosso guia sobre extração e precisão de formulários de inspeção manuscritos. E se você está solucionando resultados ruins, nosso artigo sobre modos de falha e correções na extração de caligrafia cobre os problemas mais comuns e suas soluções.