AIは写真から手書き文字を読める?
はい — 精度はこちら
はい。最新のAIビジョンモデルは、適切な品質の画像であれば85~95%の精度で手書き文字を読み取れます — 筆記体では50%を下回り、乱雑な筆記ではほぼ完全に失敗することもある従来のOCRよりはるかに優れています。この差は小さくありません。使えるデータが得られるか、意味不明な文字列になるかの違いです。ただし精度は一つの数字ではありません。手書きの種類に大きく左右されます。活字体の手書きは95%前後。整った筆記体は約85%。乱雑な筆記体は65~75%まで下がります。判読困難な走り書きは? 市場のどのモデルにとっても依然として難題です。
このページの位置づけ:このページは「AIは読めるか」という疑問に対する精度のリファレンスで、手書きの種類別に数値を分解しています。技術の定義についてはAI手書き文字認識とは何かを、仕組みについては手書き文字認識の仕組みをご覧ください。
主なポイント
- 従来のOCRは筆記体の単語100語のうち95語を誤ります — そのアーキテクチャは分離した活字用に作られており、筆記体は設計上すべての文字がつながっています。
- AIビジョンモデルは、あなたが手書きメモを読むのと同じようにページを読むことで、アプローチを根本から覆します — 「請求書番号」というラベルを文脈として使い、曖昧な文字を判別します。
- 活字体のブロック体で95%、乱雑な現場メモで65%という30ポイントの精度差こそ、どのベンダーもランディングページに載せない正直な数字です。
AIは現在、手書きをどこまで正確に読めるのか
AI手書き文字認識は、この約3年で「ほぼ役に立たない」から「実用レベル」へと進化しました。ただし、手書きの種類による精度の差は大きく、自分の文書がそのスペクトラムのどこに位置するかを把握しているかどうかで、スムーズに機能するワークフローになるか、ストレスの多いものになるかが決まります。
2023年時点では、最高性能のAIモデルでも筆記体はほとんど読めませんでした。2026年の現在、状況は一変しています。標準的な学術ベンチマークであるIAM手書き文字データベース(657人の異なる筆記者による13,353行のテキスト行)では、トップモデルの文字誤り率(CER)は2%未満を達成しています。つまり、100文字読んで誤りは2文字未満ということです。GPT-5が約1.22%のCERでトップを走り、Claude Opus 4.7が約1.31%、Gemini 3が約1.44%と続きます(codesota.com、2026年ベンチマーク)。Microsoft Azure Document Intelligenceは約1.8%のCERに加え、バウンディングボックス付きの構造化出力という利点も備えており、フォーム処理に役立ちます。
これは学術的な数値です。しかし実際の精度は、筆記スタイルによって大きく異なります。独立したベンチマークと実務者の報告(AIMultiple 2026年、Businessware Technologies 2026年、codesota.com 2026年)によると、次のようになっています:
| 手書きの種類 | AI精度(2026年) | 従来のOCR | 備考 |
|---|---|---|---|
| 活字体の手書き(ブロック体) | 90〜95% | 60〜80% | きれいで分離された文字。Azureは整ったブロック体で約95%を達成。 |
| 整った筆記体 | 80〜88% | 30〜50% | 文字がつながっているが、スタイルは一貫。GPT-4.1はきれいな単一ページの筆記体で約85%を記録。 |
| 乱雑な筆記体 | 65〜75% | 10〜25% | 文字の形が不揃いで、傾きもまちまち、単語レベルの曖昧さがある。 |
| 判読困難/劣化文書 | 45〜60% | <10% | 装飾が強い書体、色あせたカーボンコピー、文字の重なりなど。 |
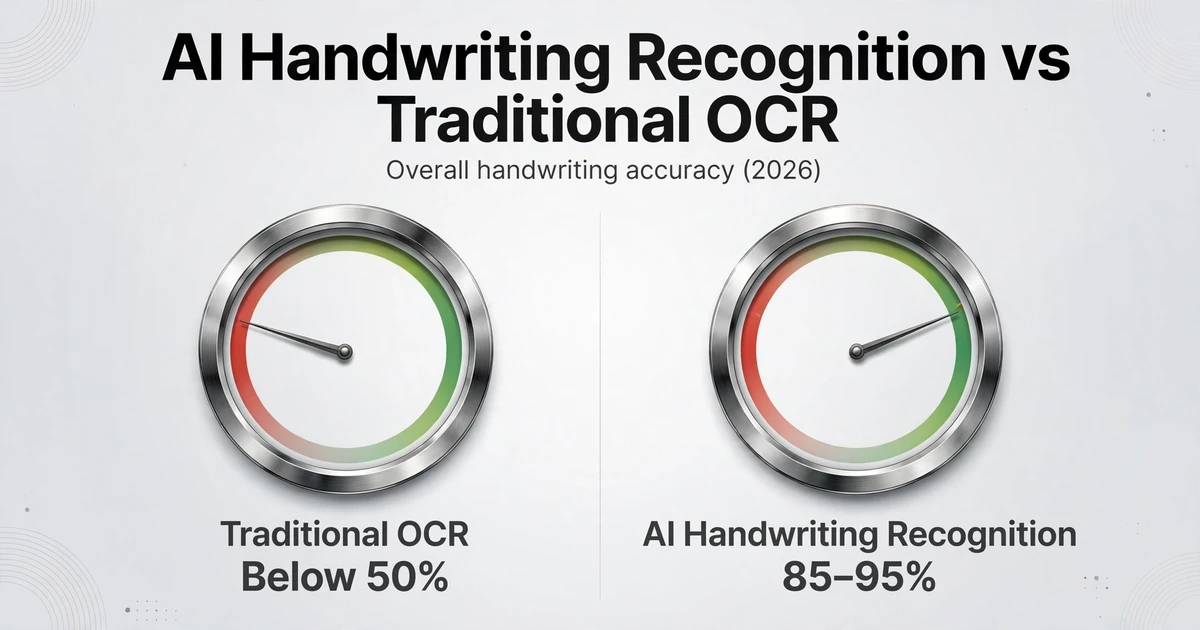
これは手書きの種類別の実用的な精度の目安です。実際の写真やスキャンに対して現在のAIツールが期待できる性能を示しています。これらの数値の背後にある文字レベルの誤り率(CER/WER)と、筆記が劣化するにつれて従来のOCRとの差がどう広がるかについては、手書き文字認識の仕組みの詳細解説で取り上げています。また、文字精度が高くても合計値が間違っていることがある点については、90%のCERでも合計値が間違う理由の分析をご覧ください。
下の2行が、ほとんどのツールが手書き精度を公表しない理由を説明しています。70%未満の数字はマーケティングしにくいのです。しかし、それが現実です。文書のほとんどが活字体の手書きか整った筆記体であれば、AIは十分に役立ちます。12人の異なる技術者による乱雑な現場メモなら、結果の確認が必要になることを想定してください。
AIと従来のOCRの差を最もよく示すベンチマークは、2026年の独立テスト(codesota.com)によるものです。Tesseract — 最も広く導入されているオープンソースOCRエンジン — は、IAM手書き文字データベースで12.5%の文字誤り率(CER)を記録しています。これは8文字に1文字の誤りです。handwritingocr.comの2026年WERベンチマークでは、Tesseractは95.4%の単語誤り率(WER)を記録しました。つまり、筆記体ではほぼすべての単語を誤認識するということです。これはチューニングの問題ではありません。Tesseractは活字を前提に設計されています。その文字セグメンテーション手法は文字が分離していることを前提としており、筆記体はその前提をすべての行で崩してしまいます。
AI手書き文字認識が得意なこと
AIは、ラベル付きフィールド、一貫したフォーマット、指定された領域内に収まる筆記など、構造に従った手書き文字で優れた性能を発揮します。
従来のOCRは、ページを個々の文字にセグメント化して処理します。各文字を分離し、既知の形状と照合し、結果を出力します。筆記体はこのモデルを完全に破綻させます。文字が連結し、融合し、変形するため、セグメンテーションベースのエンジンでは分離できません。現代のAIは逆のアプローチを取ります。人間と同じようにページ全体を捉え、文脈を使って曖昧さを解決します。手書きの「1」と手書きの「l」は単体では視覚的に同一かもしれませんが、フィールドが金額であることを理解しているAIは両者を判別できます。従来のOCRにはそれができません。
ラベル付きフィールドを持つ構造化フォームは、AI手書き文字認識が最も輝く領域です。「請求書番号」や「日付」というラベルがフィールドにある場合、ビジョンランゲージモデルはそのラベルを意味的なアンカーとして使用します。その領域にどのような内容が含まれるかを事前に把握しているのです。これはカスタム列抽出の背後にある仕組みと同じです。抽出したいデータ(「合計」「ベンダー名」「日付」などの列名)を定義すると、AIはページ上の位置ではなく意味を理解して各値を特定します。AIはドキュメント全体を読み、フィールドラベルと近くの手書きコンテンツを照合し、フィールドの位置がドキュメントごとに異なっていても構造化データを抽出します。
活字体の手書きとブロック体は、AIモデルにとってはもはや解決済みの問題です。Businessware Technologies(2026年)の研究では、現代の大規模言語モデルがきれいなブロック体の手書き文字で人間に近い精度を達成することが確認されました。2025年の実務者レビューでは、Azure Document Intelligenceが整った活字体で約95%の精度を記録し、活字に対する性能に近い結果でした。白い紙に濃いペンで大文字のブロック体で書かれていれば、AIは確実に読み取ります。
一貫した単一筆記者のドキュメントも良好な性能を発揮します。同じ人物が配送伝票や点検フォームのバッチを記入する場合、AIモデルはページをまたいで筆記者のパターンを暗黙的に学習します。固定された寄稿者セットによって書かれた100件の筆記体サンプルのベンチマークでは、トップモデルは実運用に十分な意味的類似性スコアを達成しました(AIMultiple、2026年)。重要な変数は筆記者の数ではなく、各筆記者が自身のドキュメント内で一貫しているかどうかです。
英語の手書き文字は最も多くのトレーニングデータがあり、モデル性能も最も高いです。ラテン文字言語(フランス語、スペイン語、ドイツ語、ポルトガル語)のサポートも堅調ですが、英語以外の手書き文字では精度が5〜10ポイント低下します。非ラテン文字(アラビア語、中国語、日本語の手書き文字、キリル文字の筆記体)は改善が進んでいますが、依然として遅れを取っています。これは解決済みの問題ではなく、現在も活発に研究が進められている領域です。
AI手書き文字認識が依然として苦手とする領域
能力よりも限界を正直に伝えることの方が重要です。なぜなら、最初の文書をアップロードして悪い結果を得たとき、過剰な約束は信頼を失う最も早い道だからです。
著しく劣化した文書 — 薄れたインク、黄ばんだ紙、カーボンコピー、3世代目のコピー — は精度を劇的に低下させます。人間が読むのも難しい手書き文字は、AIにとってはほぼ不可能になります。薄い鉛筆の跡、水濡れによるインクのにじみ、裏面の文字が透けて見える文書は、すべてエラーを悪化させます。2025年のRedditレビュー(r/computervision)はこれを正確に記録しています。さまざまな現場技術者による乱雑な手書き文字を含む75件の点検報告書(225ページ)をテストしたユーザーは、汎用AIモデルがきれいなページでは使える出力を生成したものの、劣化したページでは一貫して失敗したことを発見しました。専用の手書き文字OCRツールは同じ劣化ページを大幅に良好に処理し、難しい文書では、生のAI能力よりも手書き文字に特化したモデルアーキテクチャが重要であることを示しています。
高度に様式化された筆記体や珍しい書体は依然として困難です。19世紀の銅版画書体、ドイツのジュッターリーン体、華麗なカリグラフィーは、ほとんどの商用モデルの学習分布の外側にあります。codesota 2026ベンチマークでは、GPT-5の1.22%のCER(クラス最高)でさえ、IAMデータセットの標準的な英語筆記体に適用されるものであり、歴史的または高度に様式化された書体には適用されないと指摘されています。Transkribusのような専門ツールは、特定の手書きスタイルにカスタムモデルをトレーニングできるため、このニッチに対応しますが、かなりのセットアップ投資が必要です。
複数ページにわたるコンテキストのずれは、微妙ですが現実的な問題です。GPT-4.1は、きれいな単一ページの手書き文字では約85%の精度を達成しましたが、乱雑な説明セクションでは約75%に低下し、複数ページの文書の3ページ目では約65%にまで低下しました(2025年の実務者レビュー)。コンテキストが蓄積されるにつれて、モデルは継続部分を幻覚し始めます — 存在しないテキストを作り出します。これは現在の視覚言語モデルアーキテクチャの既知の限界であり、現在活発に研究が進められています。
数字と金額には特に注意が必要です。誤って「3」を「8」と読んだり、「5」を「6」と読んだりするのは、単語のスペルミスよりもはるかにコストのかかるエラーです。乱雑な筆記体の金額では、検証が不可欠です。AIはきれいな手書き文字では約80~85%の確率で正しい数字を取得しますが、それでも難しいサンプルでは6件に1件の割合で金額が間違っている可能性があります。財務文書の場合、実用的なワークフローは次のとおりです。AIにすべてを抽出させ、その後すべての通貨フィールドをスポットチェックします。
印刷文字と手書き文字が混在したコンテンツが同じページにあると、特にそのために設計されていないモデルは混乱する可能性があります。印刷されたフィールドラベルが手書きの回答の隣にあるフォームは標準的なケースであり、うまく機能します。しかし、手書きの注釈、余白のメモ、修正で覆われた印刷文書は、レイアウトの理解に課題をもたらします。AIは印刷文字と手書き文字を単一のストリームに統合したり、どのテキストがどのフィールドに属するかを誤って割り当てたりする可能性があります。
AI手書き文字読み取りで最高の結果を得る方法
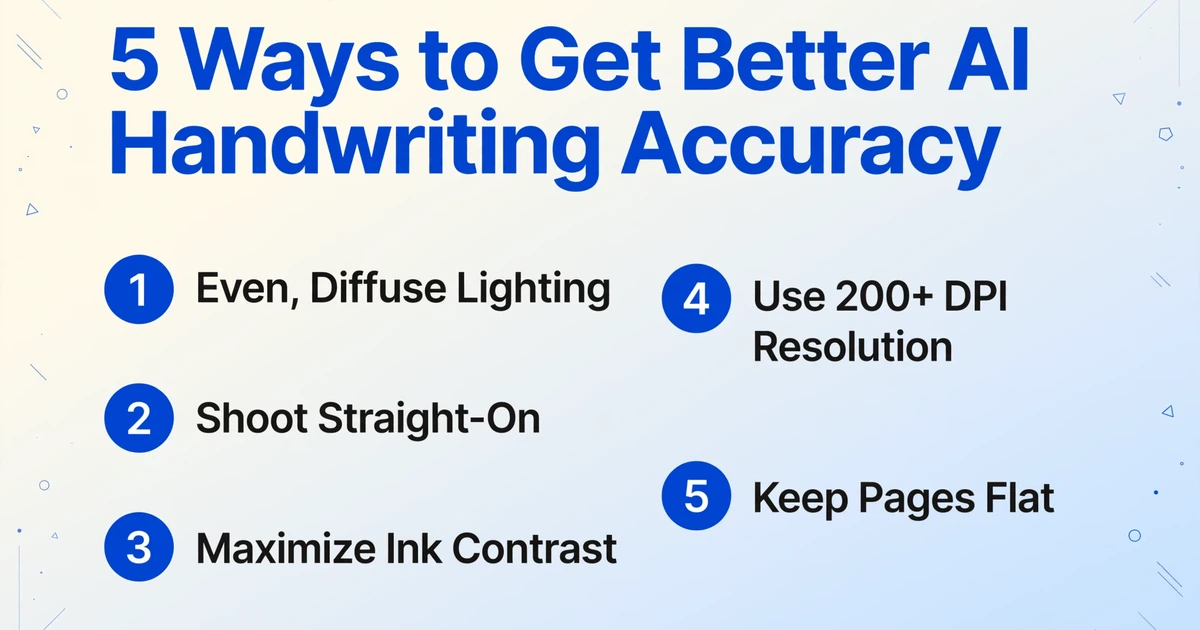
あなたが最もコントロールできるのは、写真の品質です。明るく、正面から撮影し、高解像度の写真であれば、ぎりぎり読めるレベルの手書き文字も実用範囲に引き上げられます。モデルのアップグレードは必要ありません。
1. 均一で拡散した照明を使う。ページに影ができると、人工的なコントラストの輪郭が生まれ、AIモデルを混乱させます。窓からの自然光が理想的です。人工光を使う場合は、45度の角度から2つの光源を当てて影をなくしましょう。直接フラッシュを当てると、インクが飛んで見えるホットスポットができるため避けてください。
2. 斜めではなく、正面から撮影する。斜めからの撮影による遠近感の歪みは、AIが読み取り前にページの傾きを補正することを強制し、エラーが積み重なる前処理ステップを追加します。スマートフォンを文書と平行に保ちましょう。最近のカメラアプリのほとんどには、遠近感を自動補正する文書スキャンモードがあります。ぜひ活用してください。
3. インクと紙のコントラストを最大限に高める。白い紙に濃い青または黒のインクが理想的です。薄い鉛筆、色付きの紙に赤いインク、またはかすれた万年筆のインクは、いずれも精度を低下させます。入力内容を管理できる場合(例:現場スタッフがフォームに記入する場合)は、濃いインクのペンを必須にしましょう。これは、利用可能な中で最も費用対効果の高い精度向上策です。
4. 解像度は少なくとも200 DPIにする。標準的なレターサイズのページの場合、これはおよそ1700×2200ピクセルに相当し、過去5年間のスマートフォンなら簡単に達成できます。150 DPIを下回ると、文字のストロークがぼやけて融合し、精度が急激に低下します。300 DPIを超えると、最新のAIモデルでは追加の利点は限られますが、非常に小さな手書き文字には役立ちます。
5. ページを平らに保ち、しわを伸ばす。折り目やしわは、文字の形を崩す幾何学的な歪みを生み出します。折りたたまれた文書がある場合は、撮影前に数時間本の下に挟んで平らにしましょう。または、スキャナーを使用してください。スキャンした文書は、同じ手書き文字サンプルでスマートフォンの写真よりも一貫して3〜8パーセントポイント高い精度を発揮します。
AIが手書き文字を読み取る実際の文書例
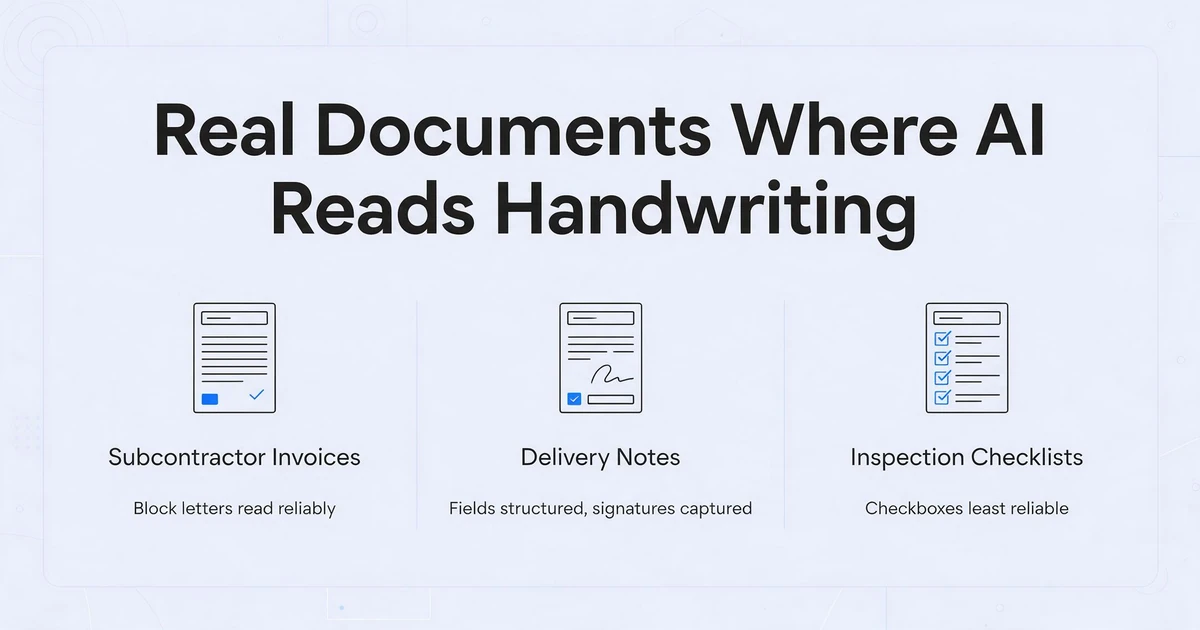
AIの手書き文字認識精度を理解する最良の方法は、人々が実際に処理している文書と、その処理結果を見ることです。
下請業者からの手書きの請求書。建設業、設備工事業、現場サービス業では、今でも毎日手書きの請求書を受け取っています。配管工がカーボン複写式のパッドに、工事現場の住所、作業時間、材料費、合計金額を走り書きします。これらの請求書は、印刷されたレターヘッドと手書きの明細項目が混在しています。AIはこれをうまく処理します。印刷されたテキストがレイアウトの基準点となり、手書きの内容は通常ブロック体か整った筆記体で、[Total]や[Date]などのフィールドラベルは一貫しています。カスタム列抽出を使用するツールは、手書きの金額を手入力なしで構造化された列(時間、単価、材料費、合計)に直接読み取ることができます。この具体的なシナリオの詳細については、手書きの下請業者請求書からのデータ抽出に関するガイドをご覧ください。
現場の配送伝票と配達証明。ドライバーや配送員は、配送伝票に受取人名、納品物、日付、署名を手書きで記入します。これらの伝票はトラックの運転室内を移動し、折りたたまれ、数日後にコーヒーの染みが付いた状態でオフィスに届きます。手書き文字が整っていることはほとんどありませんが、フィールドは構造化されています。署名欄、日付欄、数量列などです。AIはブロック体のフィールドを確実に読み取ります。署名はテキストとして読み取るのではなく、存在の指標(署名されたか?はい/いいえ)として取得されます。毎日数十枚の配送伝票を処理する物流チームにとって、バッチAI抽出は手作業による入力時間を大幅に削減できます。詳細なワークフローについては、手書きの配送伝票のバッチ処理に関する記事をご覧ください。
現場の点検チェックリスト。安全検査官、品質管理チーム、保守作業員は、現場で紙のチェックリストに記入します。タブレットの使用が現実的でない過酷な環境であることも少なくありません。これらのフォームには、チェックボックス(チェックあり/なし)、数値の読み取り値(メーター値、温度、圧力)、短い手書きコメント(「バルブ3から漏れ—修理フラグ済み」)が組み合わされています。最新のAIはこれら3つすべてを読み取ります。チェックボックスは視覚パターン認識で検出され、数値フィールドは高精度で抽出され、手書きコメントは記録保存用に文字起こしされます。チェックボックス検出はこの3つの中で最も信頼性が低くなっています。なぜ最高のモデルでもチェック済みボックスを見逃すのか、そして注意すべき失敗パターンについて詳しくは、AIが手書きフォームを読み取ってもチェック済みボックスを見逃す理由をご覧ください。Redditのr/computervisionで公開された実際のテストでは、あるユーザーが乱雑な現場技術者の手書き文字が含まれる75件の検査レポート(225ページ)を処理しました。専門のAIモデルはフィールドの約85%で構造化データの抽出に成功しましたが、一般的なクラウドOCR APIは筆記体のコメントでかなり苦戦しました。
手書きタイムシート。時間給労働者、建設現場の作業員、現場スタッフは今でも手書きのタイムシートを提出します。氏名、日付、日ごとの労働時間、ジョブコード、合計などです。タイムシートのグリッドレイアウトはAIにとって有利です。各セルには単一のデータポイントが含まれ、列ヘッダーが意味的な文脈を提供し、コンテンツのほとんどは数字です。AIは時間エントリを列ごとに抽出し、日付、時間、ジョブコードの関係を保持します。課題は算術です。「8.5」のような手書きの数字は、筆跡の明瞭さによって「8.5」「8.3」「8.8」と誤読される可能性があります。合計を日次合計と照合することで、ほとんどのエラーを検出できます。給与計算処理については、給与計算用の手書きタイムシートのバッチ処理をご覧ください。
手書きの医療フォームと受付書類。患者問診票、同意書、臨床メモは、多くの診療現場で今も紙ベースです。ここでの手書きの課題は、一般的なAIモデルが知らない可能性のある医療用語や略語によってさらに複雑になります。専門の医療用手書き文字認識は、ドメイン固有の語彙でトレーニングすることで、より良い結果を達成します。医療用手書きに対する標準的なAI OCRは、約70〜80%の精度を達成します。これは最初のパスとして使用できますが、エラーが結果に影響を与える臨床データには人間による検証が必要です。
よくある質問
AIは乱雑な手書き文字を読めますか?
部分的に可能です。AIは中程度に乱雑な手書き文字を65〜75%の精度で処理できます。これは手作業を減らすには十分ですが、レビューなしで頼るには不十分です。人間でも解釈が分かれるような本当に判読不能な走り書きは、現在のAIの能力を超えています。実用的な基準は次のとおりです。同じ手書き文字を読んだ2人の人間が内容に同意する場合、AIもおそらく正しく読めます。人間が同意しない場合、AIは誤って推測します。
AIは古い筆記体の手書き文字を読めますか?
時代とスタイルによって異なります。現代の筆記体(1950年以降、英語)は十分にカバーされています。IAM手書き文字データベースやその他のトレーニングデータセットは、このスタイルを広範囲に使用しています。19世紀のカッパープレート体、ドイツ語のクレント体/ジュッターリーン体、華麗なカリグラフィーははるかに困難です。Transkribusのような特定の手書きスタイルでトレーニングできる専門ツールは、一般的なAIモデルよりも歴史的な筆記体をうまく処理します。家族の手紙や歴史的アーカイブをデジタル化する場合は、モデルのトレーニングや手動レビューに時間を投資することを想定してください。
スマホで撮影した写真でも手書きOCRは機能しますか?
はい、機能します。現在ではスマホ写真が最も一般的な入力形式となっています。重要なのは写真の品質です。正面からの角度、均一な照明、影がないこと、実効解像度が200 DPI以上であること。手書き文書をスマホで適切に撮影した場合、フラットベッドスキャンと比較して精度の差は3〜5ポイント以内に収まります。2024年以降、AIモデルが実世界の画像アーティファクトの処理に優れてきたことで、スマホ写真とスキャンの差は大幅に縮まっています。
AIは手書きフォームからテキストを書き起こすだけでなく、構造化データを抽出できますか?
はい、できます。これこそが最新のAI抽出と基本的な手書きテキスト書き起こしの違いです。生のテキストブロック(「請求書 #1042 日付 3/15/26 合計 $847.50」)を出力する代わりに、構造化抽出では各値をそれぞれの列に配置します。「請求書番号:1042」「日付:3/15/26」「合計:$847.50」のように、スプレッドシート、会計システム、データベースにそのままインポートできる形式です。これはカスタム列抽出によって実現されます。抽出したい列名を定義すると、AIがテンプレートの位置に一致させるのではなく、意味的に理解して各値を見つけ出し抽出します。この仕組みの詳細については、AI手書き文字認識とは何か、その仕組みに関する記事をご覧ください。
AIは英語以外の言語の手書き文字も読めますか?
はい、ただし条件付きです。ラテン文字を使用する言語(フランス語、スペイン語、ドイツ語、ポルトガル語、イタリア語)は十分にサポートされており、英語と比較して精度の差は5〜10ポイント以内です。例えばAWS Textractは、英語の手書き文字を明示的にサポートし、印刷テキストのサポートはスペイン語、ポルトガル語、フランス語、ドイツ語、イタリア語に拡張されています。非ラテン文字(アラビア語、中国語の手書き文字、日本語、キリル文字の筆記体)は改善されつつありますが、依然として遅れを取っており、精度の低下とエラーの増加が予想されます。複数言語が混在する文書の場合、AIモデルは両方の言語がラテン文字を使用していれば言語切り替えを適切に処理できますが、文字体系が異なる場合(例:日本語の手書きフォームへの英語の注釈)は苦戦します。
AI手書き文字認識は人間の文字起こしと比べてどうですか?
明確で整った手書き文字の場合、AIは人間の精度に匹敵するか、それを上回ります。人間も文字起こしの際に誤りを犯すもので、きれいなテキストでも約2〜5%の誤り率があります。乱雑な筆記体の場合、書き手のスタイルを知っている人間の方が依然としてAIより優れています。2025年にDigital Scientists(Mailchimp R&D)が発表したケーススタディでは、訓練済みLSTMニューラルネットワークを使用して、読みやすい手書き文字で85%、読みにくい手書き文字で60%の精度が報告されました。これは、同じ手書き文字を初めて目にする不慣れな人間の読者とほぼ同等です。AIの主な利点は速度です。人間が15〜20分かかる2ページの手書き文書を、AIは30秒未満で処理します。
Tesseractのような無料OCRツールを手書き文字に使えますか?
いいえ、手書き文字には使えません。Tesseractは印刷テキスト用に設計されており、手書き文字ではせいぜい20〜40%の精度しか達成できません。IAM手書き文字ベンチマークでは、Tesseractの文字誤り率(CER)は12.5%で、8文字に1文字の割合で誤りが発生します。筆記体では、単語誤り率(WER)が95%を超えます。EasyOCRのような無料ツールは、整った手書き文字で60〜70%とわずかに優れていますが、無料エンジンと最新のAI(GPT-5、Claude、Gemini、Azure)との差は非常に大きいです。「無料」のOCRは、最初から高性能なAIツールを使うよりも、手作業での修正に多くのコストがかかることがよくあります。詳細な比較については、AI手書き文字認識と従来のOCRの比較をご覧ください。
2026年のAI手書き文字認識は、実際のワークフローを変革できるほど優れています。ただし、文書の品質に合わせて期待値を調整することが前提です。構造化されたフォーム上の活字体のブロック体や整った筆記体なら、AIはあなたの時間を大幅に節約してくれます。乱雑な現場メモ、劣化したカーボンコピー、華麗な歴史的筆記体なら、AIは役立ちますが、人間の確認が依然として必要です。正しい問いかけは「AIは手書き文字を読めるか?」ではなく、「AIは私の手書き文字を、私の文書で読めるか?」です。それを確かめる唯一の方法は、実際のサンプルで試してみることです。
手書き文字だけでなく、AIが文書をどのように処理するかについてより広く理解するには、AI文書抽出とは何か、その仕組みから始めてください。特に手書きの点検フォームを扱っている場合は、手書き点検フォームの抽出と精度に関するガイドをご覧ください。また、精度の低い結果のトラブルシューティングについては、手書き文字抽出の失敗パターンと修正方法の記事で、最も一般的な問題とその解決策を解説しています。