Kann KI Handschrift aus Fotos lesen?
Ja — hier ist die Genauigkeit
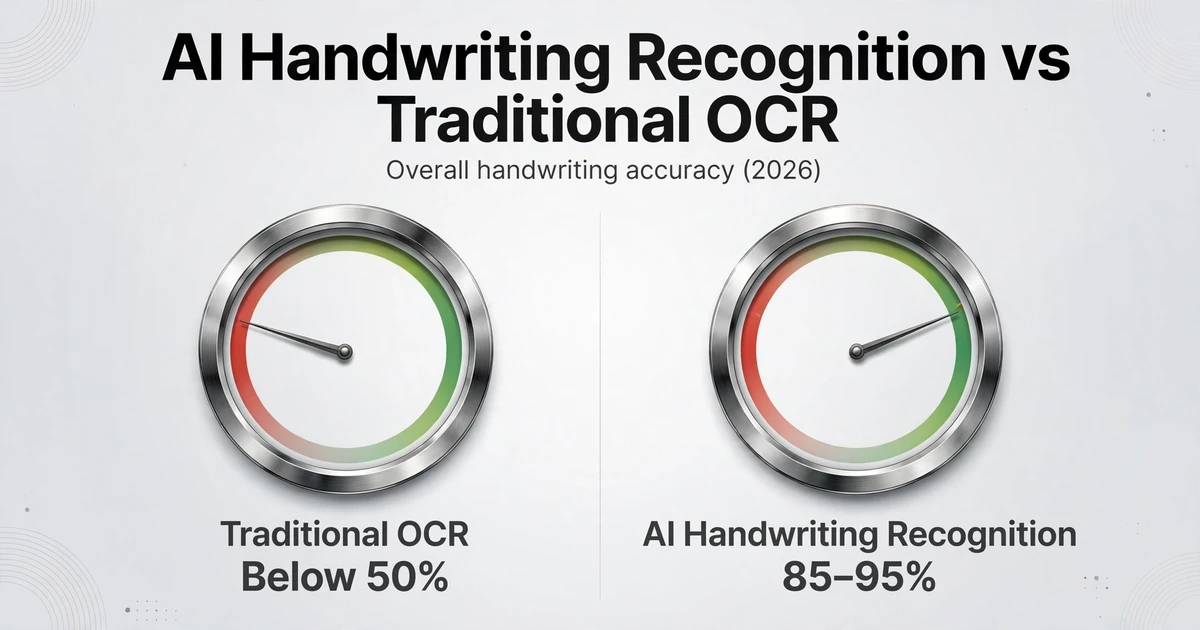
Ja. Moderne KI-Visionsmodelle können Handschrift bei Bildern angemessener Qualität mit 85–95 % Genauigkeit lesen — deutlich besser als traditionelles OCR, das bei Schreibschrift unter 50 % fällt und bei unordentlicher Schrift oft völlig versagt. Die Lücke ist nicht klein: Es ist der Unterschied zwischen nutzbaren Daten und Kauderwelsch. Doch Genauigkeit ist keine einzelne Zahl — sie hängt stark vom Handschrifttyp ab. Handschriftliche Druckbuchstaben liegen nahe 95 %. Saubere Schreibschrift erreicht etwa 85 %. Unordentliche Schreibschrift fällt auf 65–75 %. Schwer lesbares Gekritzel? Für jedes Modell auf dem Markt noch immer eine Herausforderung.
Wo das einzuordnen ist: Diese Seite ist die Genauigkeitsreferenz für „Kann KI ... lesen“-Fragen, mit Zahlen aufgeschlüsselt nach Handschrifttyp. Zur Definition der Technologie siehe was KI-Handschrifterkennung ist; wie sie im Hintergrund funktioniert, siehe wie Handschrifterkennung funktioniert.
Die wichtigsten Erkenntnisse
- Traditionelles OCR macht 95 von je 100 Schreibschrift-Wörtern falsch — seine Architektur wurde für getrennte Druckbuchstaben gebaut, und Schreibschrift verbindet jeden Buchstaben von Natur aus.
- KI-Visionsmodelle drehen den gesamten Ansatz um, indem sie Seiten so lesen, wie Sie eine handschriftliche Notiz lesen — sie nutzen die Beschriftung „Invoice Number“ als Kontext, um jedes mehrdeutige Zeichen eindeutig zu bestimmen.
- Die 30-Punkte-Genauigkeitslücke zwischen Druckbuchstaben mit 95 % und unordentlichen Feldnotizen mit 65 % ist die ehrliche Zahl, die kein Anbieter auf seine Landingpage schreibt.
Wie gut KI heute Handschrift liest
Die KI-Handschrifterkennung hat sich in etwa drei Jahren von „größtenteils nutzlos“ zu „produktionstauglich“ entwickelt – aber die Genauigkeit variiert stark je nach Handschrifttyp, und zu wissen, wo Ihre Dokumente auf diesem Spektrum liegen, ist der Unterschied zwischen einem funktionierenden Workflow und einem frustrierenden.
Im Jahr 2023 scheiterten selbst die besten KI-Modelle an Schreibschrift. Bis 2026 sieht das Bild anders aus. Auf der IAM Handwriting Database – einem standardisierten akademischen Benchmark mit 13.353 Textzeilen von 657 verschiedenen Schreibern – erreichen die besten Modelle heute Zeichenfehlerraten (CER) unter 2 %. Das bedeutet weniger als 2 falsche Zeichen pro 100 gelesenen Zeichen. GPT-5 führt mit etwa 1,22 % CER, gefolgt von Claude Opus 4.7 mit ~1,31 % und Gemini 3 mit ~1,44 % (codesota.com, 2026-Benchmark). Microsoft Azure Document Intelligence liefert ~1,8 % CER mit dem Bonus strukturierter Ausgaben mit Begrenzungsrahmen – nützlich für Formulare.
Das ist das akademische Bild. Aber die Genauigkeit in der Praxis variiert enorm je nach Schreibstil. Hier ist, was unabhängige Benchmarks und Praktikerberichte (AIMultiple 2026; Businessware Technologies 2026; codesota.com 2026) uns sagen:
| Handschrifttyp | KI-Genauigkeit (2026) | Traditionelle OCR | Anmerkungen |
|---|---|---|---|
| Handschriftliche Druckbuchstaben (Druckbuchstaben) | 90–95 % | 60–80 % | Saubere, getrennte Zeichen. Azure erreicht ~95 % bei sauberen Druckbuchstaben. |
| Saubere Schreibschrift | 80–88 % | 30–50 % | Verbundene Buchstaben, aber konsistenter Stil. GPT-4.1 erzielte ~85 % bei sauberer einseitiger Schreibschrift. |
| Unordentliche Schreibschrift | 65–75 % | 10–25 % | Inkonsistente Buchstabenformen, variierende Neigung, Mehrdeutigkeit auf Wortebene. |
| Schwer lesbar / beschädigt | 45–60 % | <10 % | Stark stilisierte Schrift, verblasste Durchschläge, überlappender Text. |
Dies sind praktische, nutzbare Genauigkeitswerte nach Handschrifttyp – was Sie von aktuellen KI-Tools bei echten Fotos und Scans erwarten können. Die zugrunde liegenden Zeichenfehlerraten (CER/WER) hinter diesen Zahlen und wie sich die Lücke zur traditionellen OCR vergrößert, je schlechter die Schrift wird, sind Thema unseres Deep Dives zu wie Handschrifterkennung funktioniert. Und da selbst eine hohe Zeichengenauigkeit immer noch falsche Summen bedeuten kann, lesen Sie unsere Analyse zu warum 90 % CER immer noch falsche Summen bedeutet.
Die unteren beiden Zeilen erklären, warum die meisten Tools die Handschriftgenauigkeit nicht erwähnen. Eine Zahl unter 70 % ist schwer zu vermarkten. Aber das ist die Realität. Wenn Ihre Dokumente überwiegend handschriftliche Druckbuchstaben oder saubere Schreibschrift sind, wird KI Ihnen gute Dienste leisten. Wenn es sich um unordentliche Feldnotizen von 12 verschiedenen Technikern handelt, rechnen Sie damit, Ergebnisse zu überprüfen.
Der Benchmark, der die Kluft zwischen KI und traditioneller OCR am besten veranschaulicht, stammt aus einem unabhängigen Test von 2026 (codesota.com): Tesseract — die am weitesten verbreitete Open-Source-OCR-Engine — erreicht eine Zeichenfehlerrate (CER) von 12,5 % auf dem IAM-Handschriftdatensatz. Das ist ein Fehler pro 8 Zeichen. Im WER-Benchmark von handwritingocr.com 2026 erzielte Tesseract eine Wortfehlerrate von 95,4 % — das bedeutet, dass es bei Schreibschrift fast jedes Wort falsch erkennt. Das ist kein Abstimmungsproblem; Tesseract wurde für gedruckten Text entwickelt. Sein Zeichensegmentierungsansatz geht davon aus, dass Buchstaben getrennt sind — eine Annahme, die Schreibschrift in jeder Zeile bricht.
Was KI-Handschrifterkennung richtig macht
KI glänzt dort, wo Handschrift Struktur folgt — Formulare mit beschrifteten Feldern, konsistente Formate und Schreiben, das auf dafür vorgesehene Bereiche beschränkt ist.
Traditionelle OCR funktioniert, indem sie eine Seite in einzelne Zeichen segmentiert — jeden Buchstaben isolieren, mit einer bekannten Form abgleichen und das Ergebnis ausgeben. Schreibschrift bricht dieses Modell vollständig. Zeichen verbinden sich, verschmelzen und verzerren sich auf eine Weise, die segmentierungsbasierte Engines nicht trennen können. Moderne KI verfolgt den gegenteiligen Ansatz: Sie betrachtet die gesamte Seite so, wie es ein Mensch tut, und nutzt Kontext, um Mehrdeutigkeiten aufzulösen. Eine handgeschriebene „1“ und ein handgeschriebenes „l“ können isoliert betrachtet visuell identisch sein, aber eine KI, die versteht, dass das Feld ein Dollar-Betrag ist, kann sie unterscheiden — traditionelle OCR kann das nicht.
Strukturierte Formulare mit beschrifteten Feldern sind der Bereich, in dem KI-Handschrifterkennung am hellsten glänzt. Wenn ein Feld mit „Rechnungsnummer“ oder „Datum“ beschriftet ist, nutzen Vision-Language-Modelle diese Beschriftung als semantischen Anker — sie wissen, welche Art von Inhalt sie in diesem Bereich erwarten. Dies ist derselbe Mechanismus, der hinter der benutzerdefinierten Spaltenextraktion steckt: Sie definieren, welche Daten Sie möchten (Spaltennamen wie „Gesamt“, „Lieferantenname“, „Datum“), und die KI lokalisiert jeden Wert, indem sie versteht, was er bedeutet, nicht wo er auf der Seite steht. Die KI liest das gesamte Dokument, gleicht Feldbeschriftungen mit nahegelegenen handschriftlichen Inhalten ab und extrahiert strukturierte Daten — selbst wenn sich Feldpositionen zwischen Dokumenten unterscheiden.
Handschriftliche Druckbuchstaben und Blockschrift sind für KI-Modelle inzwischen ein gelöstes Problem. Forschung von Businessware Technologies (2026) bestätigte, dass moderne große Sprachmodelle bei sauberer Blockschrift eine nahezu menschliche Genauigkeit erreichen. Eine separate Praktiker-Überprüfung von 2025 ergab, dass Azure Document Intelligence bei sauberen Druckbuchstaben ~95 % erreicht — nahe an seiner Leistung bei gedrucktem Text. Wenn jemand in Großbuchstaben-Blockschrift mit dunklem Stift auf weißem Papier schreibt, liest die KI das zuverlässig.
Konsistente Dokumente mit einem einzelnen Schreiber schneiden ebenfalls gut ab. Wenn dieselbe Person einen Batch von Lieferscheinen oder Inspektionsformularen ausfüllt, lernen KI-Modelle die Schreibmuster des Schreibers implizit über Seiten hinweg. In einem Benchmark mit 100 handschriftlichen Schreibschriftproben, die von einem festen Satz von Mitwirkenden verfasst wurden, erreichten die besten Modelle semantische Ähnlichkeitswerte, die für den Produktionseinsatz hoch genug sind (AIMultiple, 2026). Die entscheidende Variable ist nicht die Anzahl der Schreiber — es ist, ob jeder Schreiber innerhalb seiner eigenen Dokumente konsistent ist.
Englischsprachige Handschrift hat die meisten Trainingsdaten und die stärkste Modellleistung. Die Unterstützung für lateinische Schriften (Französisch, Spanisch, Deutsch, Portugiesisch) ist ebenfalls solide, obwohl die Genauigkeit bei nicht-englischer Handschrift um 5–10 Prozentpunkte sinkt. Nicht-lateinische Schriften (Arabisch, Chinesisch, japanische handgeschriebene Zeichen, kyrillische Schreibschrift) verbessern sich, bleiben aber zurück — dies ist weiterhin ein Bereich aktiver Forschung und kein gelöstes Problem.
Wo KI-Handerkennung noch Schwächen hat
Die ehrliche Liste der Einschränkungen ist wichtiger als die Fähigkeiten – denn Überversprechen ist der schnellste Weg, Vertrauen zu verlieren, wenn jemand sein erstes Dokument hochlädt und schlechte Ergebnisse erhält.
Stark beschädigte Dokumente – verblasste Tinte, vergilbtes Papier, Durchschläge, Kopien dritter Generation – verringern die Genauigkeit drastisch. Handschrift, die bereits für Menschen schwer lesbar ist, wird für KI nahezu unmöglich. Blasse Bleistiftstriche, wassergeschädigte Tinte und Dokumente, bei denen Text von der Rückseite durchscheint, verstärken die Fehler. Ein Reddit-Review von 2025 auf r/computervision dokumentierte dies genau: Ein Nutzer testete 75 Inspektionsberichte (225 Seiten) mit unordentlicher Handschrift verschiedener Außendiensttechniker. Allgemeine KI-Modelle lieferten bei sauberen Seiten brauchbare Ergebnisse, versagten aber bei beschädigten durchgängig. Spezialisierte Handschrift-OCR-Tools verarbeiteten dieselben beschädigten Seiten deutlich besser – ein Beleg dafür, dass eine auf Handschrift abgestimmte Modellarchitektur bei schwierigen Dokumenten wichtiger ist als rohe KI-Fähigkeit.
Stark stilisierte Schreibschrift und ungewöhnliche Schriften bleiben schwierig. Kupferstich aus dem 19. Jahrhundert, deutsche Sütterlinschrift und kunstvolle Kalligrafie liegen außerhalb der Trainingsverteilung der meisten kommerziellen Modelle. Der codesota 2026 Benchmark stellte fest, dass selbst GPT-5s 1,22 % CER – die Beste ihrer Klasse – für standardmäßige englische Schreibschrift aus dem IAM-Datensatz gilt, nicht für historische oder stark stilisierte Schriften. Spezialwerkzeuge wie Transkribus, die das Training eigener Modelle auf bestimmte Handschriftstile erlauben, decken diese Nische ab, erfordern aber einen erheblichen Einrichtungsaufwand.
Kontextdrift über mehrere Seiten ist ein subtiles, aber reales Problem. GPT-4.1 erreichte ~85 % Genauigkeit bei sauberen einseitigen Handschriften, fiel aber auf ~75 % bei unordentlicheren narrativen Abschnitten und weiter auf ~65 % auf der dritten Seite mehrseitiger Dokumente (Praxisbericht 2025). Das Modell beginnt, Fortsetzungen zu halluzinieren – Text zu erfinden, der nicht da ist – während der Kontext zunimmt. Dies ist eine bekannte Einschränkung aktueller Vision-Language-Modellarchitekturen, an der aktiv gearbeitet wird.
Zahlen und Geldbeträge verdienen besondere Vorsicht. Eine verlesene „3" als „8" oder „5" als „6" bei einem Dollarbetrag ist ein weitaus kostspieligerer Fehler als ein falsch geschriebenes Wort. Bei unordentlichen handschriftlichen Beträgen ist eine Überprüfung unerlässlich – KI ermittelt die richtige Zahl bei klarer Handschrift in etwa 80–85 % der Fälle, aber das bedeutet, dass bei schwierigen Proben immer noch 1 von 6 Beträgen falsch sein kann. Für Finanzdokumente lautet der praktische Workflow: KI alles extrahieren lassen, dann alle Währungsfelder stichprobenartig prüfen.
Gemischte gedruckte und handschriftliche Inhalte auf derselben Seite können Modelle verwirren, die nicht speziell dafür ausgelegt sind. Ein Formular, bei dem gedruckte Feldbezeichnungen neben handschriftlichen Antworten stehen, ist der Standardfall – und funktioniert gut. Aber ein gedrucktes Dokument, das mit handschriftlichen Anmerkungen, Randnotizen und Korrekturen bedeckt ist, fordert das Layoutverständnis heraus. Die KI kann gedruckten und handschriftlichen Text zu einem einzigen Strom zusammenführen oder falsch zuordnen, welcher Text zu welchem Feld gehört.
So erzielen Sie die besten Ergebnisse beim KI-Lesen von Handschrift
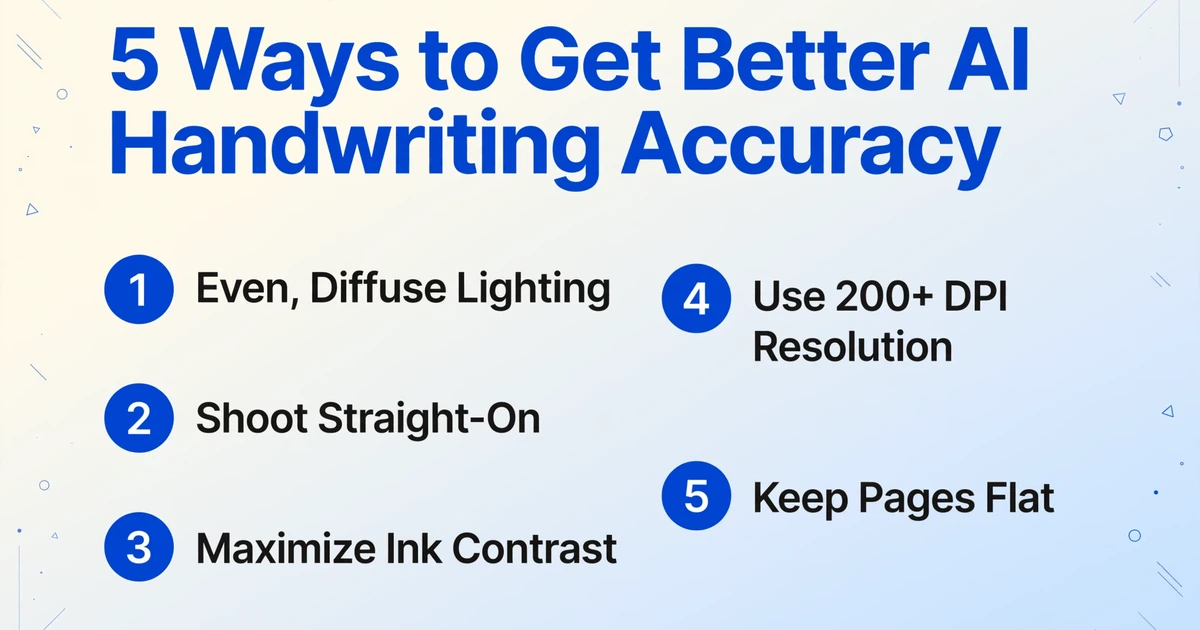
Der größte Hebel, den Sie selbst in der Hand haben, ist die Fotoqualität. Ein gut beleuchtetes, frontal aufgenommenes Foto mit hoher Auflösung kann eine grenzwertige Handschriftprobe in den nutzbaren Bereich bringen – ganz ohne Modell-Upgrade.
1. Gleichmäßiges, diffuses Licht verwenden. Schatten auf einer Seite erzeugen künstliche Kontrastkanten, die KI-Modelle verwirren. Natürliches Tageslicht vom Fenster ist ideal. Bei künstlichem Licht positionieren Sie zwei Lichtquellen in einem 45-Grad-Winkel, um Schatten zu vermeiden. Vermeiden Sie direktes Blitzlicht – es erzeugt Überstrahlungen, die die Tinte auswaschen.
2. Frontal fotografieren, nicht schräg. Perspektivverzerrungen durch schräge Fotos zwingen die KI, die Seite vor dem Lesen zu entzerren – ein zusätzlicher Verarbeitungsschritt, bei dem sich Fehler häufen. Halten Sie das Telefon parallel zum Dokument. Die meisten modernen Kamera-Apps haben einen Dokumentenscan-Modus, der die Perspektive automatisch korrigiert; nutzen Sie ihn.
3. Kontrast zwischen Tinte und Papier maximieren. Dunkelblaue oder schwarze Tinte auf weißem Papier ist ideal. Heller Bleistift, rote Tinte auf farbigem Papier oder blasse Füllertinte reduzieren die Genauigkeit. Wenn Sie die Eingabe kontrollieren (z. B. Außendienstmitarbeiter, die Formulare ausfüllen), schreiben Sie dunkle Kugelschreiber vor – das ist die günstigste Genauigkeitsverbesserung, die es gibt.
4. Eine Auflösung von mindestens 200 DPI verwenden. Für eine Standardseite im Letter-Format bedeutet das etwa 1700 x 2200 Pixel – mit jedem Smartphone der letzten fünf Jahre problemlos machbar. Unter 150 DPI verschwimmen die Zeichenstriche und die Genauigkeit sinkt stark. Über 300 DPI bringt für moderne KI-Modelle nur noch wenig zusätzlichen Nutzen, hilft aber bei sehr kleiner Handschrift.
5. Die Seite flach und faltenfrei halten. Knicke und Falten erzeugen geometrische Verzerrungen, die die Zeichenformen brechen. Wenn ein Dokument gefaltet war, legen Sie es vor dem Fotografieren einige Stunden unter ein Buch – oder verwenden Sie einen Scanner. Gescannte Dokumente schneiden bei derselben Handschriftprobe durchweg 3–8 Prozentpunkte besser ab als Handyfotos.
Praxisbeispiele: Dokumente, bei denen KI Handschrift liest
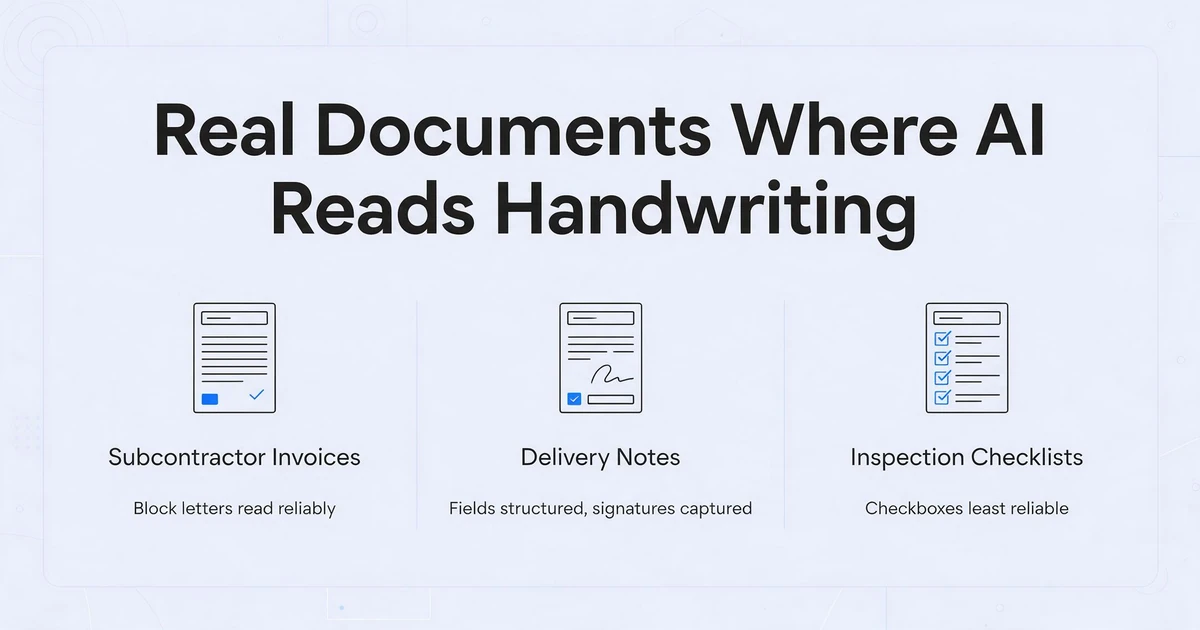
Um die Genauigkeit von KI beim Lesen von Handschrift zu verstehen, lohnt ein Blick auf die Dokumente, die Menschen tatsächlich verarbeiten – und was dabei passiert.
Handschriftliche Rechnungen von Subunternehmern. Bau-, Handwerks- und Außendienstbetriebe erhalten auch heute noch täglich handschriftliche Rechnungen – ein Klempner notiert Einsatzadresse, Arbeitsstunden, Material und Gesamtsumme auf einem Durchschreibblock. Diese Rechnungen kombinieren gedrucktes Briefpapier mit handschriftlichen Positionen. KI kommt damit gut zurecht: Gedruckter Text liefert Layout-Anker, der handschriftliche Inhalt besteht meist aus Druckbuchstaben oder sauberer Schreibschrift, und Feldbezeichnungen wie „Gesamtsumme" und „Datum" sind konsistent. Ein Tool mit benutzerdefinierter Spaltenextraktion kann die handschriftlichen Beträge direkt in strukturierte Spalten übernehmen – Stunden, Stundensatz, Material, Gesamtsumme – ganz ohne manuelles Abtippen. Mehr zu diesem Szenario finden Sie in unserem Leitfaden zum Extrahieren von Daten aus handschriftlichen Subunternehmer-Rechnungen.
Feldnotizen und Zustellnachweise. Fahrer und Kurierdienste füllen Lieferscheine von Hand aus – Empfängername, gelieferte Artikel, Datum, Unterschrift. Diese Formulare reisen im Führerhaus mit, werden gefaltet und kommen Tage später mit Kaffeeflecken im Büro an. Die Handschrift ist selten sauber, aber die Felder sind strukturiert: ein Unterschriftsfeld, ein Datumsfeld, eine Mengenspalte. KI liest die Druckbuchstaben-Felder zuverlässig; Unterschriften werden als Präsenzindikator erfasst (wurde unterschrieben? ja/nein), nicht als Text gelesen. Für Logistikteams, die täglich Dutzende Lieferscheine verarbeiten, kann die Batch-KI-Extraktion Stunden manueller Eingabe sparen. Eine detaillierte Anleitung finden Sie in unserem Artikel zur Batch-Verarbeitung handschriftlicher Lieferscheine.
Inspektionschecklisten vor Ort. Sicherheitsprüfer, Qualitätskontrollteams und Wartungstrupps füllen Papierchecklisten im Außeneinsatz aus – oft unter Bedingungen, in denen ein Tablet unpraktisch ist. Diese Formulare kombinieren Kontrollkästchen (angekreuzt/nicht angekreuzt), numerische Werte (Zählerstände, Temperaturen, Drücke) und kurze handschriftliche Kommentare („Leck an Ventil 3 – zur Reparatur gemeldet"). Moderne KI liest alle drei: Kontrollkästchen per visueller Mustererkennung, Zahlenfelder mit hoher Genauigkeit und handschriftliche Kommentare für die Dokumentation. Die Erkennung von Kontrollkästchen ist dabei am unzuverlässigsten – warum selbst die besten Modelle ein angekreuztes Kästchen übersehen und welche Fehlermuster zu beachten sind, erfahren Sie in Warum KI handschriftliche Formulare liest, aber ein angekreuztes Kästchen übersieht. In einem realen Test auf Reddit r/computervision verarbeitete ein Nutzer 75 Inspektionsberichte (225 Seiten) mit unordentlicher Handschrift von Feldtechnikern – spezialisierte KI-Modelle extrahierten bei ca. 85 % der Felder strukturierte Daten, während allgemeine Cloud-OCR-APIs bei Schreibschrift-Kommentaren deutlich zu kämpfen hatten.
Handschriftliche Stundenzettel. Stundenlohnarbeiter, Baukolonnen und Außendienstmitarbeiter reichen weiterhin handschriftliche Stundenzettel ein — Name, Daten, Stunden pro Tag, Auftragscodes, Summen. Das Rasterlayout eines Stundenzettels hilft der KI: Jede Zelle enthält einen einzelnen Datenpunkt, die Spaltenüberschriften liefern semantischen Kontext, und der Inhalt besteht überwiegend aus Zahlen. Die KI extrahiert Zeiteinträge Spalte für Spalte und bewahrt dabei die Beziehung zwischen Datum, Stunden und Auftragscode. Die Herausforderung liegt in der Arithmetik — handschriftliche Zahlen wie „8.5“ können je nach Lesbarkeit der Handschrift als „8.5“, „8.3“ oder „8.8“ fehlgelesen werden. Das stichprobenartige Abgleichen der Summen mit den Tagessummen fängt die meisten Fehler ab. Für die Lohnabrechnung siehe Batch-Verarbeitung handschriftlicher Stundenzettel für die Lohnabrechnung.
Handschriftliche medizinische Formulare und Aufnahmedokumente. Patientenaufnahmebögen, Einwilligungsdokumente und klinische Notizen sind in vielen Praxen weiterhin papierbasiert. Die Herausforderung der Handschrift wird hier durch medizinische Terminologie und Abkürzungen verstärkt, die allgemeinen KI-Modellen möglicherweise nicht bekannt sind. Spezialisierte medizinische Handschrifterkennung erzielt bessere Ergebnisse, indem sie mit domänenspezifischem Vokabular trainiert wird. Standard-KI-OCR erreicht bei medizinischer Handschrift eine Genauigkeit von etwa 70–80 % — als erster Durchlauf brauchbar, aber für klinische Daten, bei denen Fehler Konsequenzen haben, ist eine menschliche Überprüfung erforderlich.
Häufig gestellte Fragen
Kann KI unleserliche Handschrift lesen?
Teilweise. KI verarbeitet mäßig unleserliche Handschrift mit 65–75 % Genauigkeit — genug, um manuelle Arbeit zu reduzieren, aber nicht genug, um ohne Überprüfung darauf zu vertrauen. Wirklich unleserliches Gekritzel — die Art, über die sich selbst Menschen streiten — bleibt außerhalb der derzeitigen KI-Fähigkeiten. Die praktische Schwelle: Wenn zwei verschiedene Personen, die dieselbe Handschrift lesen, sich darüber einig sind, was dort steht, wird die KI es wahrscheinlich richtig erkennen. Wenn sich Menschen uneinig sind, wird die KI falsch raten.
Kann KI alte Schreibschrift lesen?
Das hängt von der Epoche und dem Stil ab. Moderne Schreibschrift (nach 1950, Englisch) ist gut abgedeckt — die IAM-Datenbank und andere Trainingsdatensätze verwenden diesen Stil umfassend. Kupferstichschrift aus dem 19. Jahrhundert, deutsches Kurrent/Sütterlin und verzierte Kalligrafie sind viel schwieriger. Spezialwerkzeuge wie Transkribus, die auf bestimmte Handschriftstile trainiert werden können, verarbeiten historische Schriften besser als allgemeine KI-Modelle. Wenn Sie Familienbriefe oder historische Archive digitalisieren, sollten Sie Zeit in das Modelltraining oder die manuelle Überprüfung investieren.
Funktioniert Handschriften-OCR mit Fotos, die mit einem Telefon aufgenommen wurden?
Ja – und Telefonfotos sind inzwischen die häufigste Eingabeart. Entscheidend ist die Fotoqualität: gerade Aufnahme, gleichmäßige Beleuchtung, keine Schatten, mindestens 200 DPI effektive Auflösung. Ein gut aufgenommenes Telefonfoto eines handschriftlichen Dokuments erreicht eine Genauigkeit innerhalb von 3–5 Prozentpunkten eines Flachbettscans. Der Abstand zwischen Telefonfotos und Scans hat sich seit 2024 deutlich verringert, da KI-Modelle besser darin geworden sind, mit realen Bildartefakten umzugehen.
Kann KI strukturierte Daten aus handschriftlichen Formularen extrahieren, nicht nur den Text transkribieren?
Ja – genau das unterscheidet moderne KI-Extraktion von einfacher Handschrift-zu-Text-Transkription. Statt eines rohen Textblocks („Rechnung #1042 Datum 15.03.26 Gesamt 847,50 $“) platziert die strukturierte Extraktion jeden Wert in einer eigenen Spalte – „Rechnungsnummer: 1042“, „Datum: 15.03.26“, „Gesamt: 847,50 $“ – bereit für den Import in eine Tabellenkalkulation, ein Buchhaltungssystem oder eine Datenbank. Dies wird durch benutzerdefinierte Spaltenextraktion erreicht: Sie definieren die gewünschten Spaltennamen, und die KI lokalisiert und extrahiert jeden Wert, indem sie dessen semantische Bedeutung versteht – nicht durch Abgleich einer Vorlagenposition. Eine ausführlichere Erklärung dieses Mechanismus finden Sie in unserem Artikel Was KI-Handschrifterkennung ist und wie sie funktioniert.
Kann KI Handschrift in anderen Sprachen als Englisch lesen?
Ja, mit Einschränkungen. Sprachen mit lateinischer Schrift (Französisch, Spanisch, Deutsch, Portugiesisch, Italienisch) werden gut unterstützt und erreichen eine Genauigkeit innerhalb von 5–10 Prozentpunkten des Englischen. AWS Textract unterstützt beispielsweise explizit Handschrift auf Englisch, wobei die Unterstützung für Druckschrift auf Spanisch, Portugiesisch, Französisch, Deutsch und Italienisch ausgeweitet ist. Nicht-lateinische Schriften (Arabisch, chinesische handschriftliche Zeichen, Japanisch, kyrillische Schreibschrift) verbessern sich, hinken aber hinterher – erwarten Sie geringere Genauigkeit und häufigere Fehler. Bei gemischtsprachigen Dokumenten bewältigen KI-Modelle den Sprachwechsel recht gut, wenn beide Sprachen die lateinische Schrift verwenden, haben aber Schwierigkeiten, wenn sich die Schriften unterscheiden (z. B. englische Anmerkungen auf einem japanischen handschriftlichen Formular).
Wie schneidet KI-Handschrifterkennung im Vergleich zu einem menschlichen Transkribenten ab?
Bei klarer, sauberer Handschrift erreicht die KI die Genauigkeit eines Menschen oder übertrifft sie — auch Menschen machen Transkriptionsfehler, bei sauberem Text etwa 2–5 %. Bei unordentlicher Schreibschrift ist ein Mensch, der den Schreibstil des Autors kennt, der KI weiterhin überlegen. Eine Fallstudie von Digital Scientists (Mailchimp R&D) aus dem Jahr 2025 berichtete von 85 % Genauigkeit bei lesbarer Handschrift und 60 % bei schlechter Handschrift mit einem trainierten LSTM-Neuronalen Netz — in etwa vergleichbar mit einem ungeübten menschlichen Leser, der dieselbe Handschrift zum ersten Mal sieht. Der entscheidende Vorteil der KI ist die Geschwindigkeit: Ein zweiseitiges handschriftliches Dokument, für dessen Transkription ein Mensch 15–20 Minuten benötigt, wird von der KI in unter 30 Sekunden verarbeitet.
Kann ich kostenlose OCR-Tools wie Tesseract für Handschrift verwenden?
Nein — nicht für Handschrift. Tesseract wurde für gedruckten Text entwickelt und erreicht bei Handschrift bestenfalls 20–40 % Genauigkeit. Beim IAM-Handschrift-Benchmark erzielt Tesseract eine Zeichenfehlerrate von 12,5 % — etwa ein Fehler pro 8 Zeichen — und bei Schreibschrift übersteigt seine Wortfehlerrate 95 %. Kostenlose Tools wie EasyOCR schneiden bei sauberer Handschrift mit 60–70 % etwas besser ab, aber die Lücke zwischen kostenlosen Engines und moderner KI (GPT-5, Claude, Gemini, Azure) ist enorm. Die „kostenlose“ OCR kostet oft mehr an manueller Korrekturarbeit, als von Anfang an ein leistungsfähiges KI-Tool zu verwenden. Für einen detaillierten Vergleich siehe KI-Handschrifterkennung vs. traditionelle OCR.
KI-Handschrifterkennung ist 2026 gut genug, um reale Arbeitsabläufe zu verändern — aber nur, wenn Sie Ihre Erwartungen an die Qualität Ihrer Dokumente anpassen. Handschriftliche Druckbuchstaben und saubere Schreibschrift auf strukturierten Formularen? Die KI spart Ihnen Stunden. Unordentliche Feldnotizen, beschädigte Durchschläge und kunstvolle historische Schriften? Die KI hilft, aber Sie werden weiterhin einen Menschen im Prozess benötigen. Die richtige Frage ist nicht „Kann KI Handschrift lesen?“ — sondern „Kann KI meine Handschrift auf meinen Dokumenten lesen?“ Der einzige Weg, das herauszufinden, ist ein Test mit einer echten Probe.
Für ein breiteres Verständnis davon, wie KI Dokumente verarbeitet — nicht nur Handschrift — beginnen Sie mit was KI-Dokumentextraktion ist und wie sie funktioniert. Wenn Sie speziell mit handschriftlichen Inspektionsformularen zu tun haben, lesen Sie unseren Leitfaden zur Extraktion und Genauigkeit handschriftlicher Inspektionsformulare. Und wenn Sie Probleme mit schlechten Ergebnissen beheben möchten, behandelt unser Artikel über Fehlermodi und Lösungen bei der Handschriftextraktion die häufigsten Probleme und deren Lösungen.