O Trabalho em Lote Antes de Todo CMMS:
Processando Anos de Registros de Manutenção
O gargalo em uma migração de CMMS quase nunca é o software. O fornecedor configura o sistema em uma semana; a hierarquia de ativos é carregada em uma tarde. O que atrasa o lançamento é a pilha de histórico de manutenção em livros de registro, pastas e fotos de celular que precisa ser transformada em uma planilha antes que o novo sistema possa ser confiável com uma única ordem de serviço. Todo guia de implementação de CMMS trata essa pilha como algo dado — "reúna, revise e limpe seus dados" — sem nunca responder à pergunta que realmente trava as equipes: como, exatamente, centenas de páginas de papel se tornam linhas prontas para importação?
Principais Conclusões
- Um acúmulo de manutenção de dois anos são 25–40 horas de digitação antes que o botão de importação do seu CMMS faça qualquer coisa — uma semana inteira de trabalho que todo plano de migração acidentalmente orça em zero.
- A transcrição manual não apenas leva tempo — ela cria ativos fantasmas quando "AHU-01" e "Air Handler 1" entram como duas máquinas, corrompendo o CMMS desde a primeira importação.
- O processamento em lote define suas colunas uma vez e lê cada página de livro de registro, foto de celular e formulário digitalizado contra as mesmas regras — 18× mais rápido e a deduplicação acontece na mesma passada.
A Matemática da Migração: Anos de Registros vs. Sua Data de Entrada em Produção
A data de entrada em produção de um CMMS é um prazo, mas o trabalho que determina se você vai cumpri-lo é o lote de registros históricos que precisa ser estruturado antes de o sistema entrar em produção. Esse trabalho é medido em páginas e horas, e quase ninguém o inclui no orçamento.
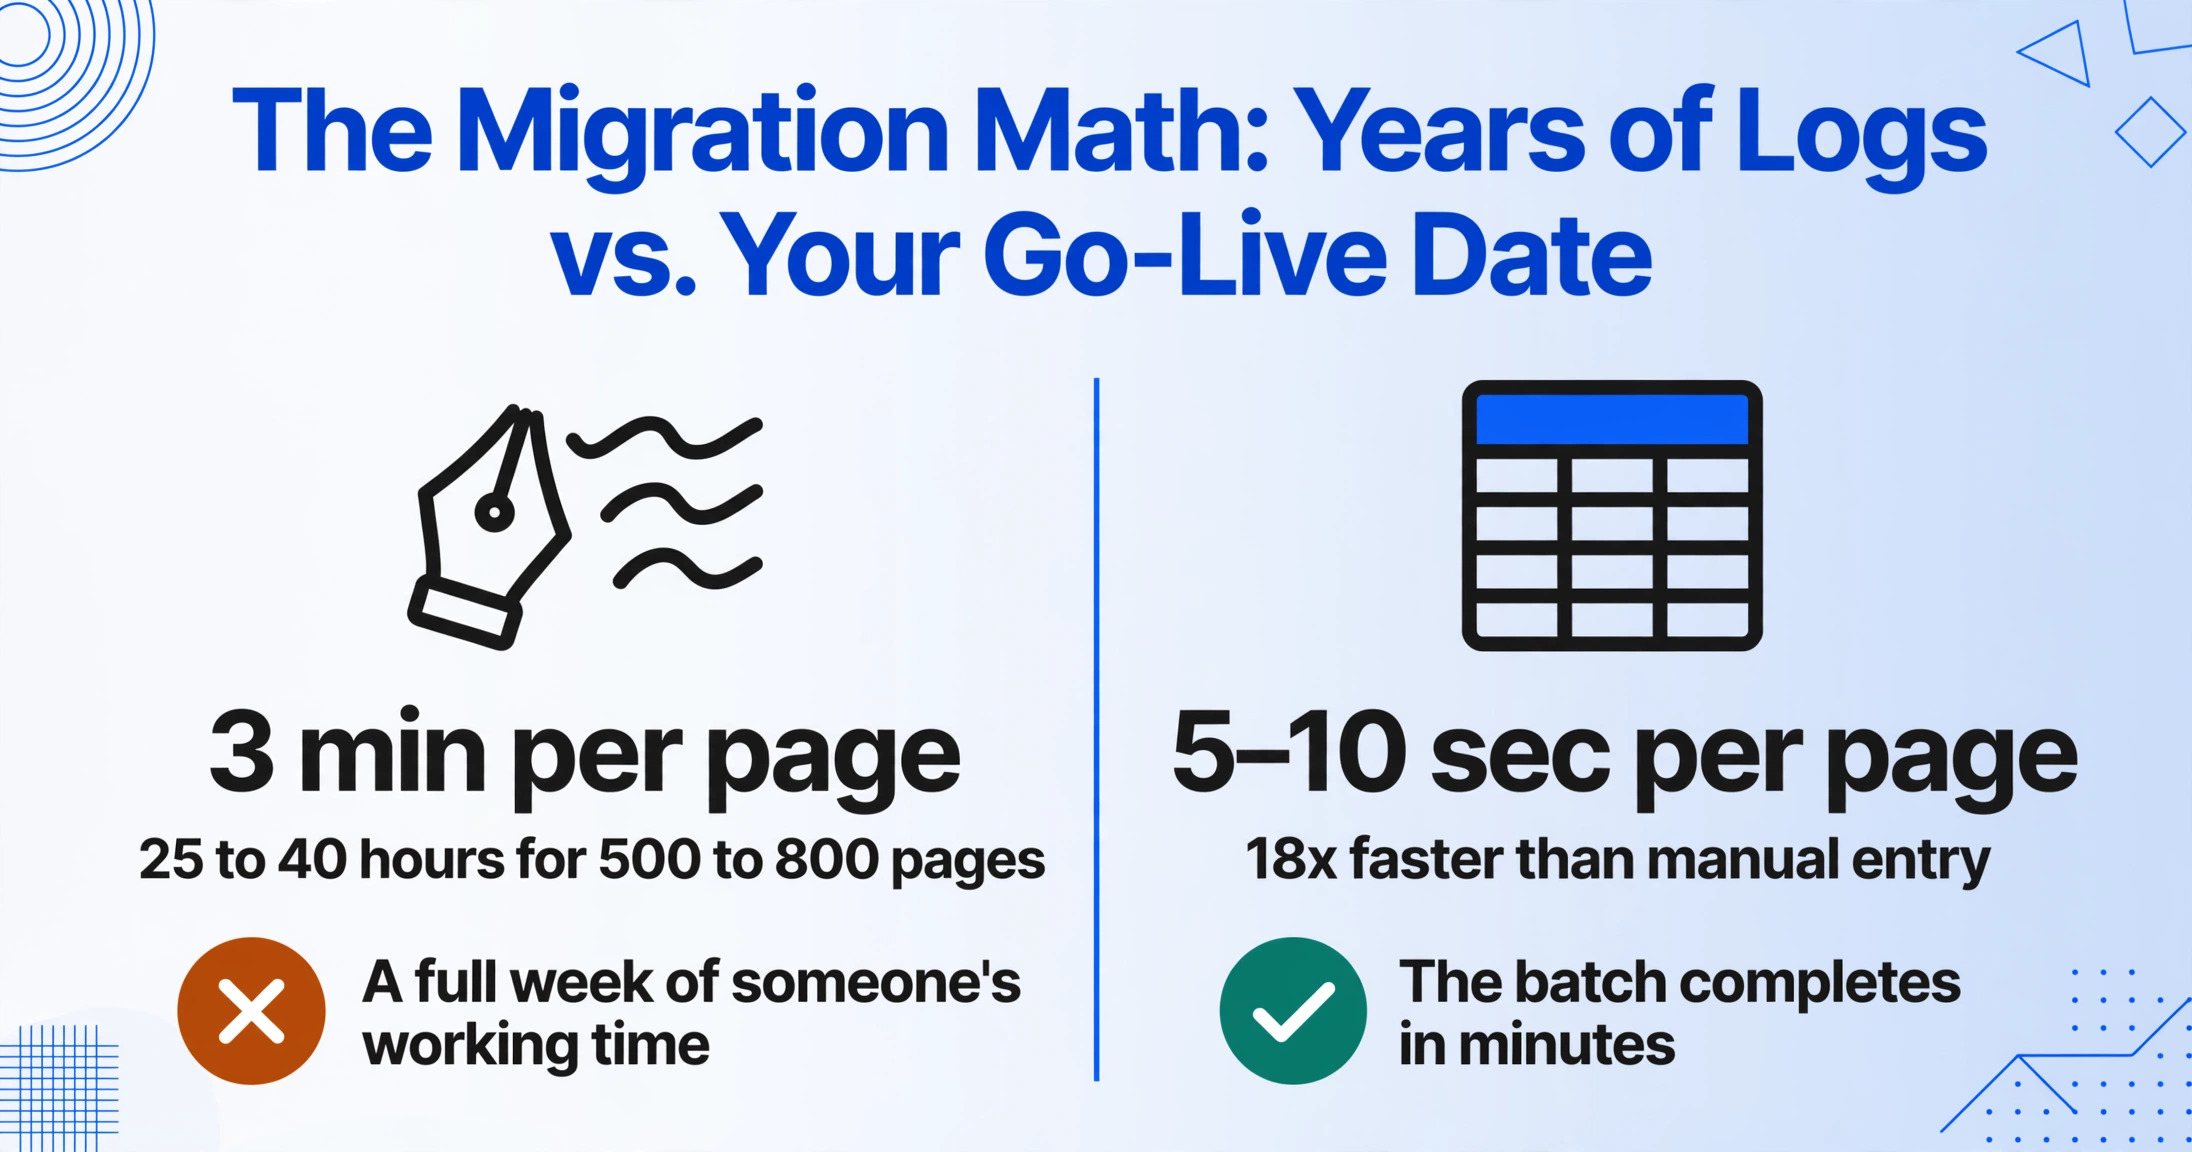
Faça as contas para uma instalação pequena: 30 equipamentos, cada um com um registro de logbook para cada serviço ou inspeção ao longo de três anos. Isso dá aproximadamente 500 a 800 páginas de registros, cada uma com nome do equipamento, data, descrição da tarefa, horas do medidor, peças usadas e anotações manuscritas do técnico. A 3 minutos por página que a transcrição manual realmente leva — digitar a data, o ID do ativo, a tarefa, as anotações, conferir a caligrafia — uma pessoa está olhando para 25 a 40 horas de pura entrada de dados antes que uma única linha possa ser importada. Isso não é um sábado; é uma semana inteira de trabalho de alguém, e é o melhor cenário, porque pressupõe que os registros sejam legíveis.
Os riscos de fazer essa entrada mal feita são quantificados pela Gartner, que estima que a má qualidade de dados custa às organizações pelo menos US$ 12,9 milhões por ano em média. Para um departamento de manutenção, o mecanismo é simples: nomes de ativos com erros de digitação dividem uma máquina em dois registros, datas erradas fazem os intervalos de PM se desviarem, e uma linha ruim importada para um CMMS é pior do que nenhuma linha, porque o sistema agora reporta os dados ruins como fato. A limpeza que todo guia de CMMS exige não é uma melhor prática abstrata — é a consequência direta de transcrever centenas de páginas manualmente.
É por isso que a pergunta na mente do autor original em um tópico amplamente compartilhado no r/manufacturing sobre rastreamento de manutenção é a pergunta que a maioria das instalações enfrenta antes de qualquer compra de CMMS: "As pessoas realmente mantêm registros perfeitos em algum lugar? Conheço alguns softwares, mas parecem caros e inchados para o caso de uso deles, ou todo mundo está apenas fazendo alguma versão de Excel + papel + textos e torcendo para o melhor?" A resposta que a maioria das equipes descobre é: os registros existem, o software é acessível, e a lacuna entre eles é a entrada de dados.
A Etapa que Todo Guia de CMMS Ignora
Leia a documentação de importação de qualquer CMMS moderno e você notará o mesmo padrão: a ferramenta torna a importação rápida e fácil, desde que os dados já estejam em uma planilha. A parte difícil — produzir essa planilha a partir de anos de registros não estruturados — simplesmente não faz parte do produto.
Os limites de importação tornam isso concreto. O Limble permite 2.000 tarefas concluídas por importação em lote de um arquivo CSV ou XLSX. O UpKeep limita importações de ordens de serviço a 2.000 linhas por upload. Fiix e MaintainX ambos exigem um modelo CSV com formatos de data e mapeamentos de campos específicos. Nenhum deles lerá uma foto de diário de bordo, interpretará um "lubrifiquei todos os 3 rolamentos da bomba" escrito à mão e o transformará em uma linha com formato de data compatível. Essa etapa de conversão é totalmente sua — e é a única etapa que todo tutorial de CMMS ignora, porque os fornecedores presumem que você já a fez.
As ferramentas que os profissionais realmente usam para manutenção — IBM Maximo, SAP PM, Fiix, UpKeep, Limble, eMaint, Cryotos — todas aceitam importações em lote de CSV/XLSX com mapeamento de colunas. Elas diferem em limites e formatos, mas compartilham um requisito: linhas limpas, consistentes e estruturadas. O que significa que o trabalho real de uma migração de CMMS não é escolher o software. É processar em lote os registros históricos na planilha que a importação espera.
É exatamente isso que a extração em lote faz: ela converte a pilha de registros em linhas estruturadas antes que o CMMS as veja, fechando a lacuna que os fornecedores deixam aberta. O restante deste artigo aborda os três desafios que só aparecem quando você processa centenas de registros de uma vez — regras de nomenclatura, mesclagem e exceções — e um fluxo de trabalho que lida com todos os três.
Desafio em Lote nº 1: Regras de Nomenclatura em Décadas de Registros
Uma importação de CMMS criará facilmente dois ativos para uma mesma máquina se os registros grafarem seu nome de duas formas. O primeiro desafio do processamento em lote é impor consistência de nomenclatura em registros que nunca foram escritos pensando em consistência.
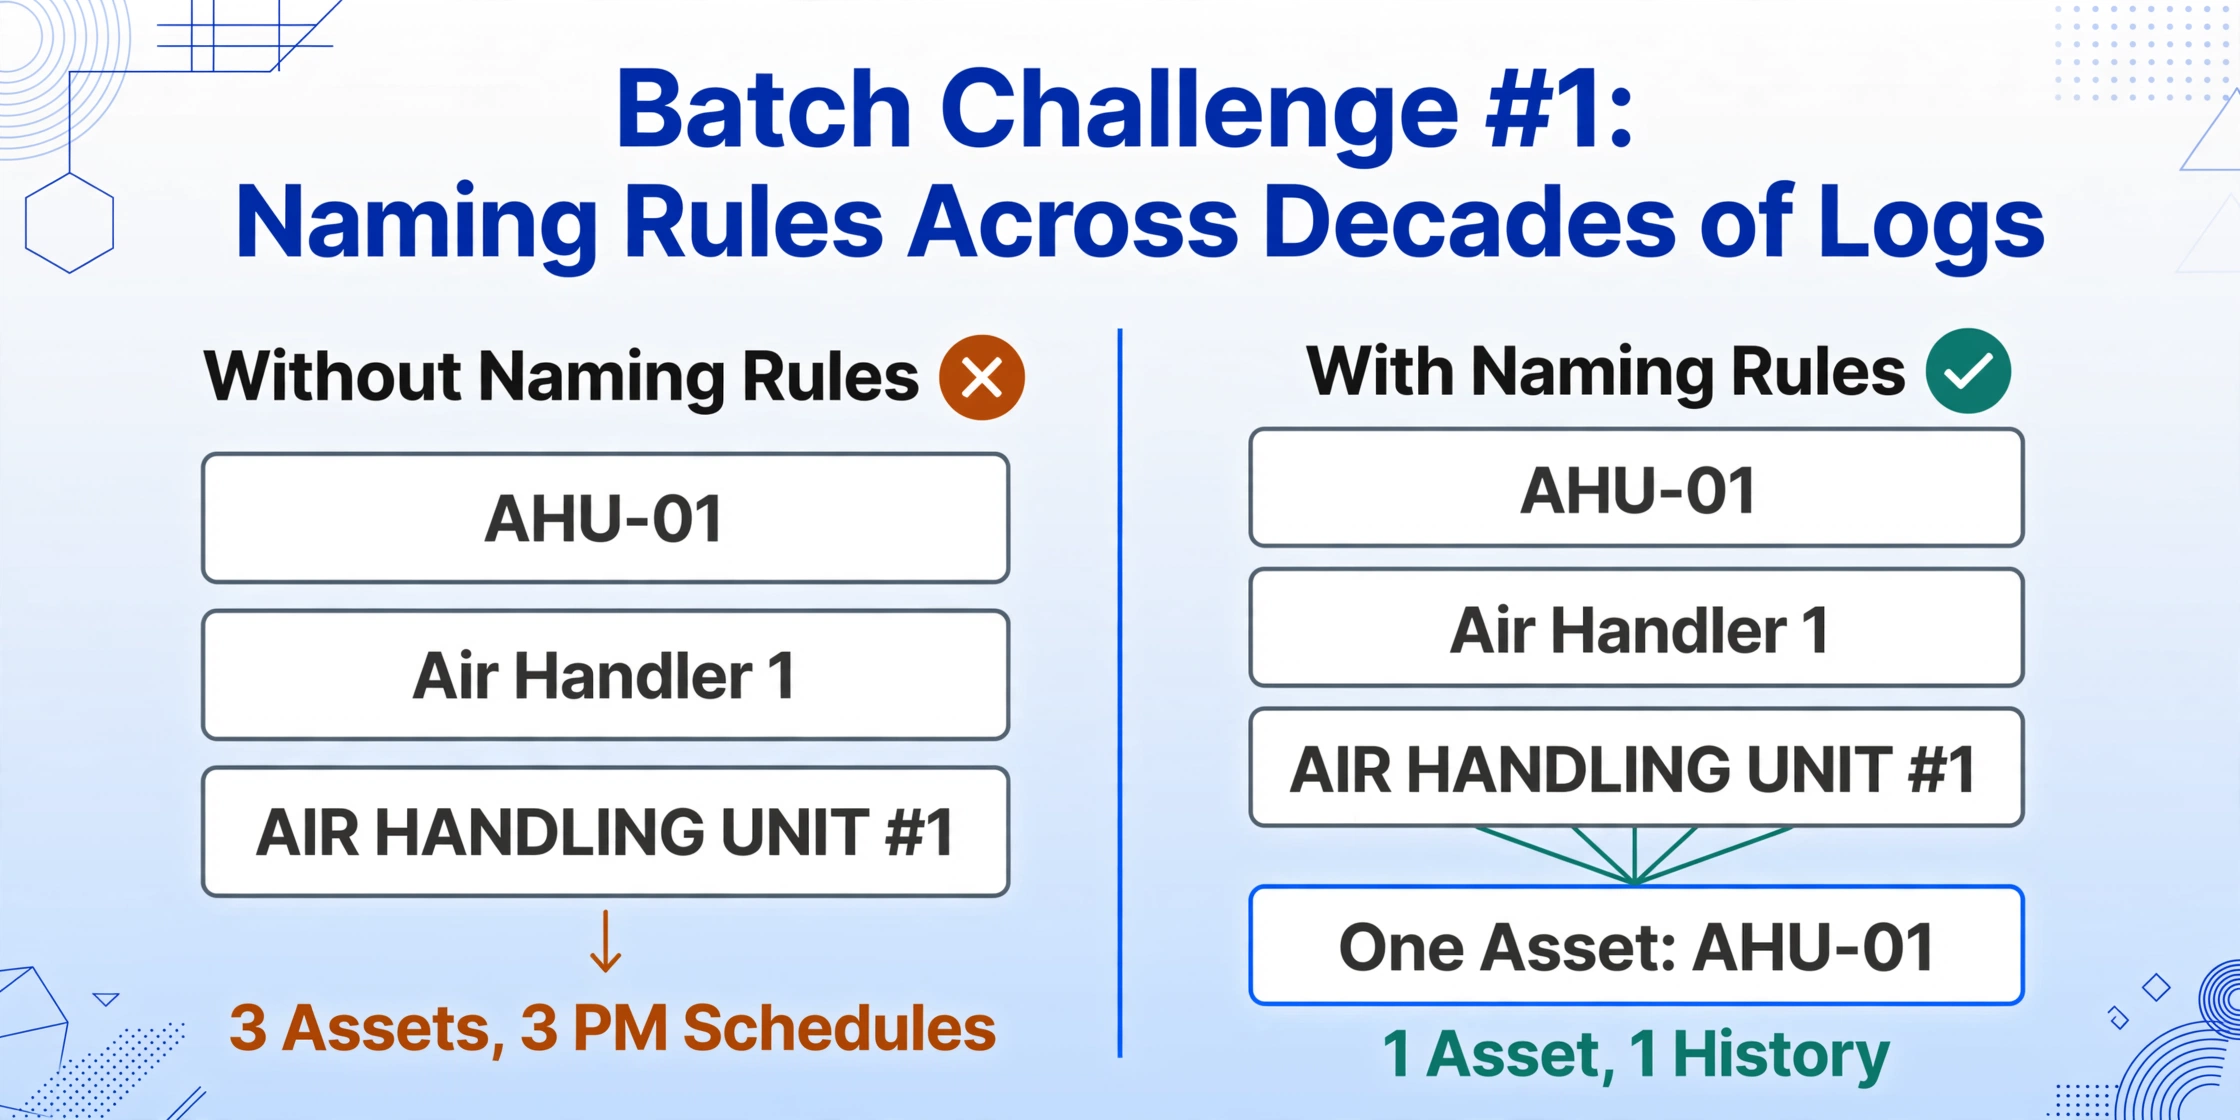
Este é o clássico problema do "ativo fantasma". Um técnico escreve "AHU-01" no livro de registro; outro escreve "Air Handler 1"; uma lista de verificação de manutenção do fornecedor diz "AIR HANDLING UNIT #1." Todos os três são a mesma unidade de cobertura, mas uma importação de CMMS os trata como três ativos — três históricos de manutenção, três cronogramas de manutenção, três registros de peças sobressalentes. Os guias de migração de HVAC que de fato discutem isso alertam que "AHU-01" e "Air Handler 1" são o mesmo ativo e devem ser deduplicados antes da importação, porque a nomenclatura consistente evita exatamente esse problema. É a diferença entre uma importação limpa e um sistema que começa sua vida errado.
O processamento em lote é onde as regras de nomenclatura são aplicadas de forma econômica, porque você as define uma vez e as aplica a cada página da pilha. Em um fluxo de extração, você nomeia as colunas que deseja — "ID do Ativo", "Data do Serviço", "Tarefa Executada", "Peças Usadas" — e a IA localiza cada valor em cada registro entendendo o que o campo significa, não combinando uma posição fixa na página. Isso é Extração de Colunas Personalizadas, e é independente de formato: as mesmas definições de coluna funcionam em listas de verificação de manutenção impressas, páginas de livro de registro manuscritas e fotos de celular de etiquetas de equipamentos, porque a extração lê pelo significado, não pelo layout.
Para o problema de nomenclatura especificamente, uma coluna inferida faz a normalização durante a extração. Você adiciona uma coluna como "ID do Ativo (padronizar para o formato: AHU-01, PUMP-02, CONV-03)" e a IA lê qualquer identificador que apareça em cada página — "Air Handler 1", "air handling unit #1", "AHU-1" — e gera o código padronizado em cada linha. A deduplicação que os guias de CMMS descrevem como uma etapa manual de limpeza acontece na mesma passada da extração, antes que os dados cheguem ao arquivo de importação.
Se sua instalação está em uma indústria regulamentada, há um padrão com o qual se alinhar aqui. ISO 14224, o padrão internacional para coleta e troca de dados de confiabilidade e manutenção, foi escrito para o setor de petróleo e gás, mas seu padrão central se aplica em qualquer lugar: defina um conjunto mínimo de dados, colete-o em um formato padronizado e registre modos de falha distintamente de suas causas. Até uma instalação modesta pode adotar essa disciplina — códigos fixos de ativos, tipos padronizados de tarefas, campos consistentes de data — e aplicá-la no nível do lote em vez de esperar que cada técnico escreva de forma consistente por acaso.
Desafio de Lote #2: Mesclando Páginas Manuscritas, Fotos e Planilhas Antigas em Uma Única Tabela
A segunda coisa que só aparece em escala é a mistura de formatos. Um backlog de três anos raramente é um formato único — são checklists de PM impressas em uma pasta, um caderno espiral com anotações manuscritas, uma pasta de fotos do celular de antes de uma regra sobre registro, e talvez um arquivo Excel antigo que um ex-gerente começou. Uma ferramenta de documento único força você a lidar com cada formato de forma diferente. O processamento em lote é especificamente o fluxo de trabalho para enviar todos juntos e mesclar os resultados em uma única tabela — uma linha por entrada de registro, em todas as pastas, todos os cadernos, todos os locais, independentemente do formato de origem.
A mesclagem funciona porque a extração é orientada por colunas, não por modelos. Defina suas colunas uma vez — ID do Ativo, Data, Tarefa, Horas do Medidor, Técnico, Peças Usadas, Descobertas — e a IA lê cada página com base nessas mesmas definições. Um livro de registro manuscrito e uma checklist de PM impressa produzem linhas com estrutura idêntica, que é exatamente o que um modelo de importação de CMMS exige. A saída vai para uma única planilha onde cada linha já está no formato que a importação espera.
Para coleta com vários técnicos ou vários locais, o problema prático é reunir as páginas em primeiro lugar. Um Link de Coleta — um link de upload compartilhável que permite que qualquer pessoa envie arquivos para sua fila de processamento sem conta — coleta fotos de todos os técnicos e todos os locais em um só lugar, em vez de perseguir livros de registro pela instalação. Um link, uma fila, um lote.
Experimente em uma página do seu próprio acervo — sem necessidade de modelo, basta enviar e nomear suas colunas:
Os arquivos são processados com segurança e não são armazenados.
Desafío de Lote #3: Qué Sucede Cuando una Página es Ilegible
En un lote de cientos de páginas, algunas estarán manchadas, algunas tendrán manchas de café, y algunas estarán escritas con una letra que solo su autor podría leer. Un flujo de trabajo de lote realista espera excepciones — no finge que cada página se extrae perfectamente.
La escritura a mano es la limitación honesta aquí. Las entradas de libros de registro impresos y las formas mixtas impresas más escritas a mano se extraen de manera confiable, porque la IA se ancla en las etiquetas impresas e interpreta los valores escritos a mano en contexto. Las letras de molde legibles funcionan bien. La cursiva, las manchas fuertes y las fotos de muy bajo contraste reducen la precisión. La cifra de precisión del 99% que cita ImageToTable.ai se aplica a datos de tablas impresas; la precisión de la escritura a mano depende de la legibilidad. Cualquiera que prometa lo contrario no está siendo honesto contigo.
Lo que el procesamiento por lotes cambia es cómo manejas las excepciones. En lugar de descubrir una página mala tres meses después de un despliegue de CMMS, revisas la salida del lote antes de importar. Modo de Revisión te permite pasar el cursor sobre cualquier celda extraída y ver el punto exacto en el registro original de donde provino el valor — un bbox dibujado en la imagen, para que verifiques si la IA leyó la escritura a mano correcta, no si confías en la herramienta en general. Un lote escaneado de 500 páginas que tomaría días verificar manualmente se convierte en una verificación puntual de las filas marcadas, porque el paso de verificación se dirige a las celdas que importan en lugar de cada pulsación de tecla.
Para páginas que genuinamente no se pueden leer: vuelve a fotografiarlas con mejor luz, o déjalas fuera del lote y marca el registro del equipo en consecuencia. Una importación honesta que omite algunas entradas ilegibles es mejor que una deshonesta que las fabrica. El CMMS no nota la diferencia; el equipo para el que programa el mantenimiento preventivo sí.
El Flujo de Trabajo por Lotes: De la Pila de Registros al Archivo de Importación CMMS
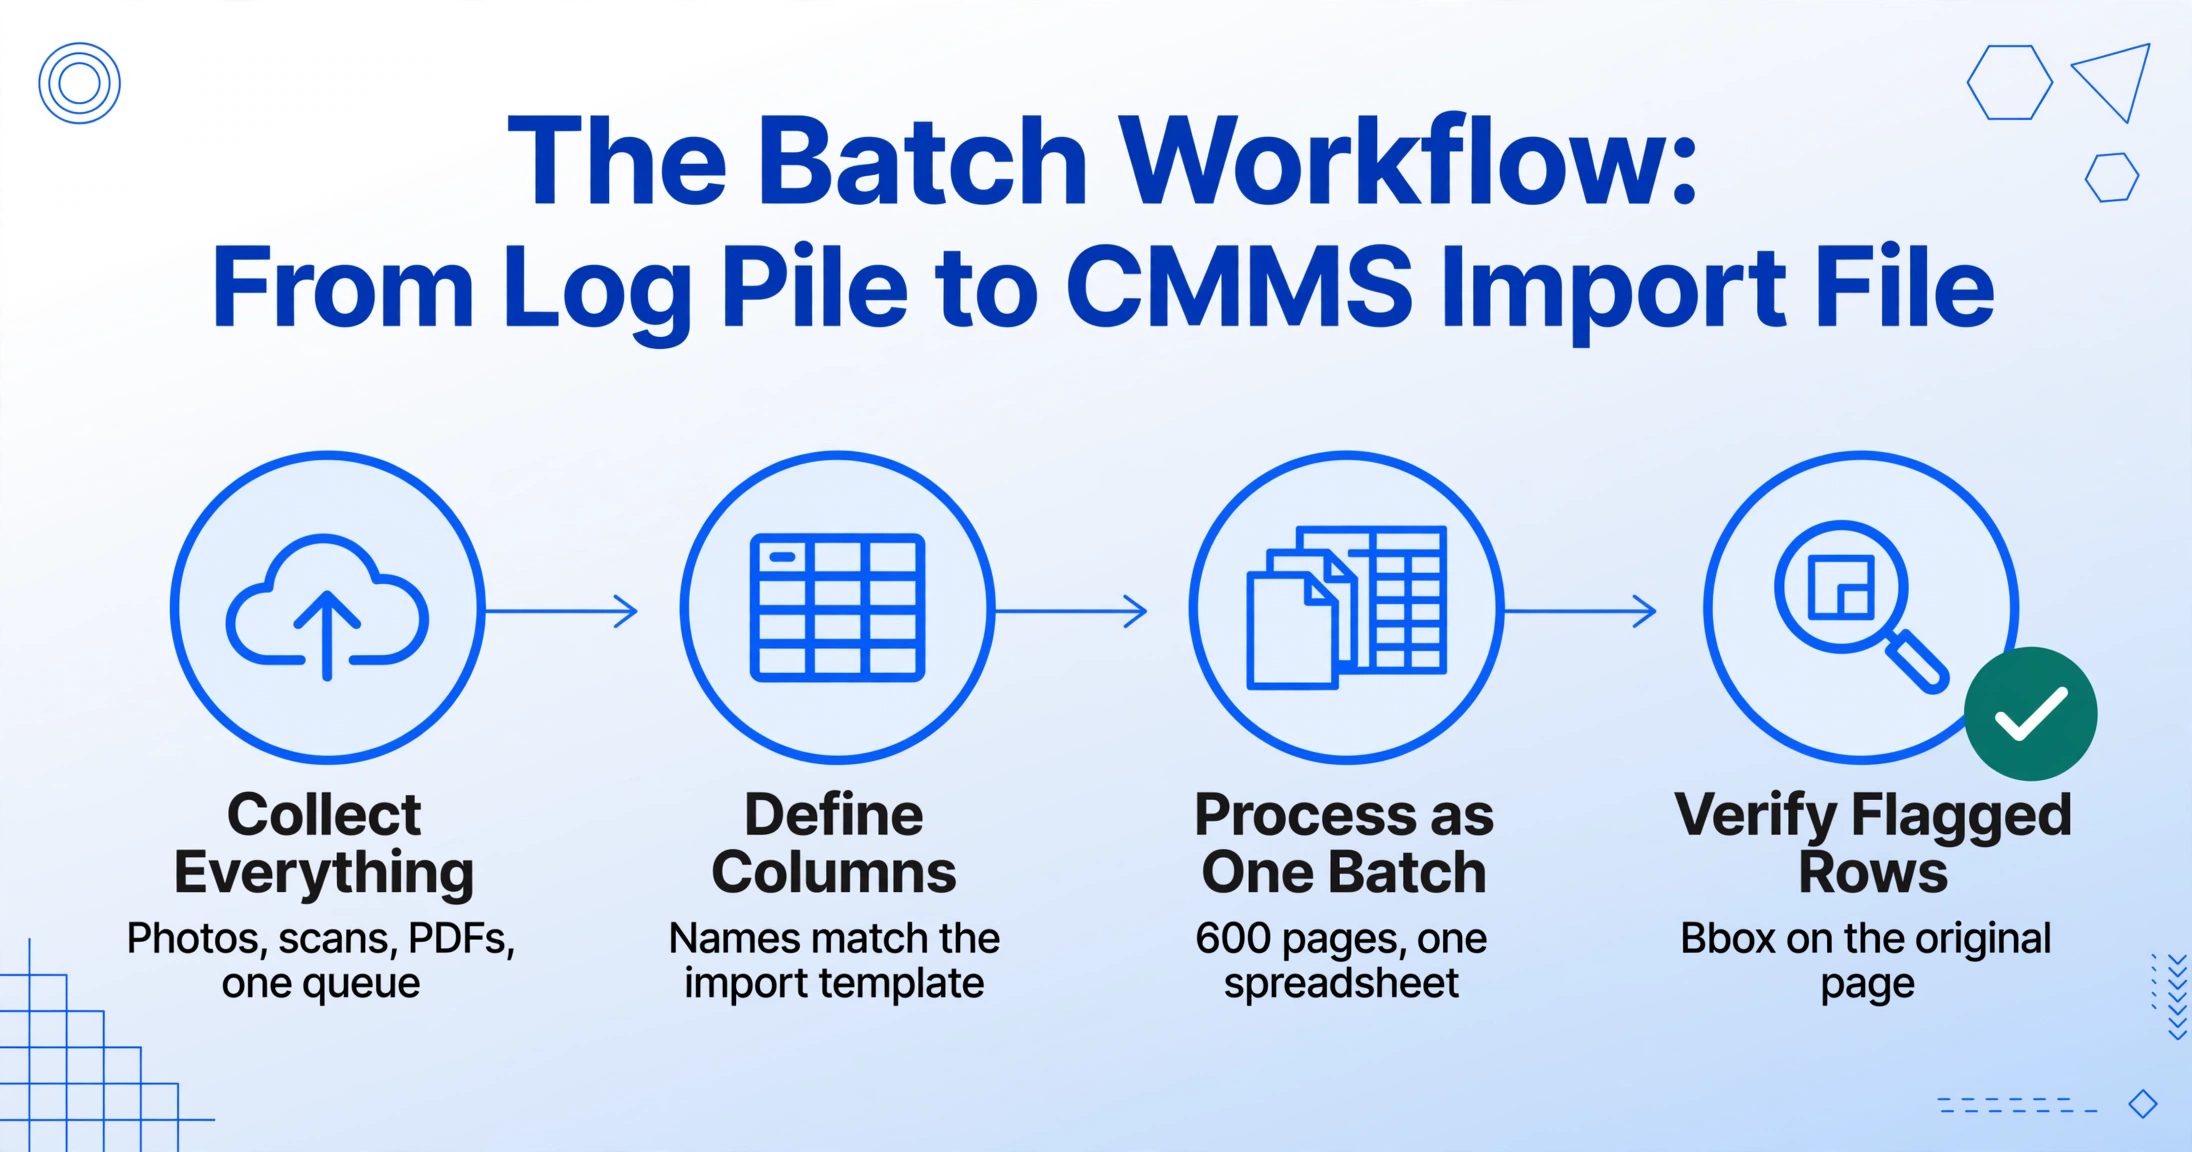
Aquí está el flujo de trabajo de extremo a extremo que maneja los tres desafíos en una sola pasada — diseñado para la persona cuya fecha de lanzamiento está a tres semanas y cuyos registros están en una carpeta.
Para equipes que já gerenciam seu acompanhamento diário em uma planilha em vez de um CMMS, o mesmo lote alimenta a planilha que já usam — o fluxo de foto para planilha funciona de forma idêntica quando o destino é uma pasta de trabalho de rastreamento em vez de um arquivo de importação. E o ponto de partida — transformar um único registro em linhas estruturadas — é o fluxo de extração passo a passo abordado separadamente; este artigo é o que acontece quando você multiplica esse fluxo por centenas de páginas.
O que migrar e o que arquivar
Você não precisa digitalizar uma década de registros para ter uma implantação de CMMS bem-sucedida. O consenso do setor é de 12 a 24 meses de histórico de manutenção para ativos críticos — e a disciplina de decidir o que fica fora do sistema faz parte de manter limpos os dados que entram.
A tentação de migrar tudo é compreensível — os dados são preciosos, e descartar histórico parece desperdício. Mas um CMMS cheio de 10 anos de registros inconsistentes tem desempenho pior do que um com dois anos de registros limpos. As orientações de implementação de CMMS recomendam consistentemente migrar aproximadamente os últimos 12 a 24 meses de histórico de manutenção, arquivar o restante como referência somente leitura e priorizar primeiro os 20% mais críticos dos ativos — a regra 80/20 que coloca os ativos mais importantes no sistema com a maior qualidade de dados, em vez de uma importação uniformemente superficial de tudo.
O processamento em lote apoia essa fase naturalmente: você pode executar primeiro os registros dos ativos críticos como um lote limpo, verificá-los, importá-los e entrar em produção no prazo — depois processar os ativos restantes em passadas de acompanhamento. A entrada em produção não espera o backlog completo; o backlog completo vira uma série de lotes em vez de um projeto avassalador.
É também aqui que os riscos de qualidade de dados se tornam concretos. ISO 55001:2024, a norma certificável para sistemas de gestão de ativos, trata informações de ativos documentadas e confiáveis como um requisito central — a revisão de 2024 reforçou a ênfase na qualidade de dados e na gestão do conhecimento. O compêndio de Melhores Práticas da SMRP, com as 70+ métricas padrão do setor de manutenção, não pode ser calculado sem histórico estruturado: porcentagem de manutenção planejada, conformidade com PM, tempo médio entre falhas — cada uma delas é uma consulta sobre linhas limpas e consistentes. Histórico ruim ou ausente não apenas parece ruim em uma auditoria; torna todo o programa de medição incalculável.
Perguntas Frequentes
Quantas páginas de registro de manutenção posso processar em lote de uma vez?
O processamento em lote é projetado para volume — envie centenas de páginas em um único lote e a IA as processa juntas em uma única tabela mesclada. O limite prático está no lado da saída: a maioria dos imports de CMMS limita a 2.000 linhas por upload (Limble e UpKeep fazem isso), então para acervos muito grandes você divide a exportação em blocos abaixo do limite. Um acervo de dois anos que levaria uma semana para um funcionário digitar vira uma única tarde de processamento e revisão.
A extração lerá nossos registros manuscritos com precisão suficiente para um CMMS?
Escrita legível é extraída de forma confiável — letras de forma e caracteres separados especialmente, e formulários mistos impressos e manuscritos funcionam bem porque a IA se ancora em rótulos impressos e lê os valores no contexto. Cursiva, borrões intensos e fotos de baixo contraste reduzem a precisão. É por isso que a etapa de verificação existe: você revisa células sinalizadas contra a página original em vez de confiar em cada valor cegamente. Para um sistema sujeito a conformidade como um CMMS, essa revisão é o equilíbrio certo — é muito mais rápida que a transcrição e captura os erros que importam.
Nosso CMMS tem seu próprio modelo de importação. A planilha extraída corresponde a ele?
Sim, porque você controla os nomes das colunas. A Extração de Colunas Personalizadas usa os nomes que você digita como cabeçalhos de saída, então você nomeia suas colunas para corresponder ao modelo de importação do CMMS — ID do Ativo, Concluído Em, Descrição da Tarefa e assim por diante. A padronização de datas e números acontece durante a extração, então as linhas saem no formato que o import espera, em vez do que o livro de registro usava.
Nossos registros são uma mistura de formulários impressos, páginas manuscritas e planilhas antigas. Precisamos de um processo diferente para cada um?
Não. Como a extração é orientada por colunas em vez de modelos, as mesmas definições de coluna funcionam em listas de verificação impressas, páginas de livro de registro manuscritas e fotos de celular. Planilhas digitais antigas que você já tem podem ser exportadas como PDFs e incluídas no mesmo lote, o que também normaliza sua formatação na mesma estrutura de saída.
Como evitamos ativos duplicados após a importação?
Duas camadas: primeiro, adicione uma coluna inferida durante a extração que padroniza os identificadores de ativos — a IA lê "AHU-01", "Air Handler 1" e "unidade de tratamento de ar nº 1" e gera um código consistente por linha. Segundo, execute uma tabela dinâmica rápida na coluna de ID do ativo extraída antes da importação para confirmar que cada linha corresponde a um ativo existente. Ambos levam minutos e previnem o problema de ativos fantasmas que corrompe o histórico de manutenção na origem.
Isso substitui o próprio CMMS?
Não — ele alimenta o CMMS. A extração converte os registros históricos na planilha estruturada e limpa que qualquer importação de CMMS exige. Ele resolve a etapa que os fornecedores deixam para você: transformar anos de papel e fotos em linhas prontas para importação. Uma vez que o histórico está inserido, o CMMS assume o agendamento, as ordens de serviço e os relatórios exatamente como projetado.
A percepção para levar à sua migração é esta: um CMMS é tão bom quanto o histórico que você dá a ele, e o histórico é tão bom quanto o lote que o digitalizou. Os limites de importação e modelos que seu fornecedor fornece não são a parte difícil — a parte difícil é a pilha de registros na pasta, e é exatamente essa parte que um fluxo de trabalho em lote foi projetado para eliminar.