El trabajo por lotes antes de cada CMMS:
Procesar años de registros de mantenimiento
El cuello de botella en una migración a CMMS casi nunca es el software. El proveedor configura el sistema en una semana; la jerarquía de activos se carga en una tarde. Lo que retrasa el lanzamiento es el montón de historial de mantenimiento en libros de registro, carpetas y fotos del teléfono que debe convertirse en una hoja de cálculo antes de que el nuevo sistema pueda confiarse con una sola orden de trabajo. Cada guía de implementación de CMMS trata ese montón como algo dado — "recopila, revisa y limpia tus datos" — sin responder la pregunta que realmente detiene a los equipos: ¿cómo, exactamente, cientos de páginas de papel se convierten en filas listas para importar?
Conclusiones clave
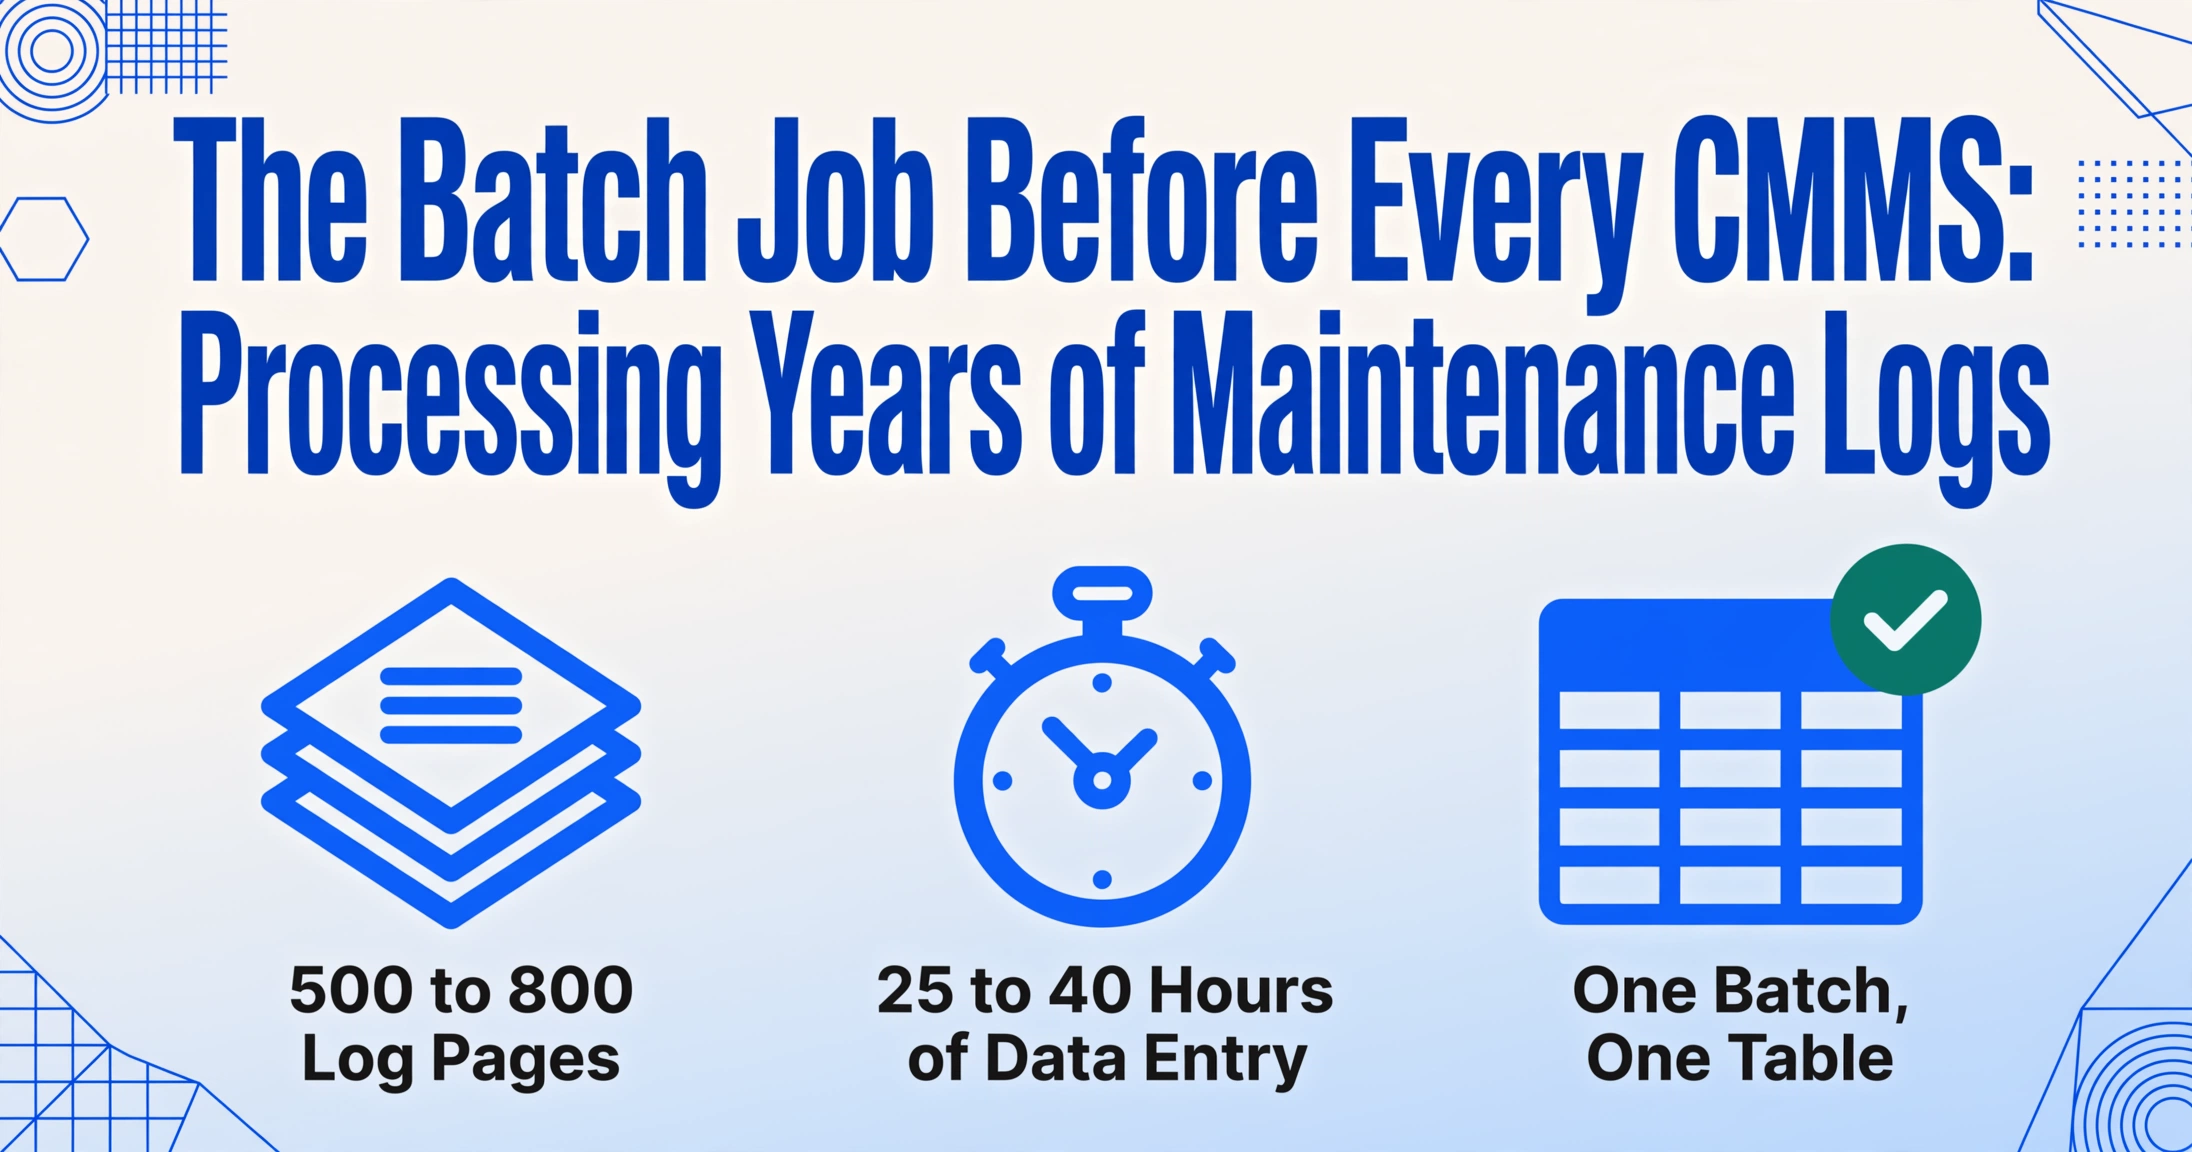
- Un atraso de mantenimiento de dos años son 25–40 horas de escritura antes de que tu botón de importación de CMMS haga algo — una semana laboral completa que cada plan de migración presupuesta accidentalmente en cero.
- La transcripción manual no solo toma tiempo — crea activos fantasma cuando "AHU-01" y "Air Handler 1" entran como dos máquinas, corrompiendo el CMMS desde la primera importación.
- El procesamiento por lotes define tus columnas una vez y lee cada página de libro de registro, foto del teléfono y formulario escaneado con las mismas reglas — 18× más rápido y la deduplicación ocurre en la misma pasada.
Las matemáticas de la migración: años de registros frente a tu fecha de puesta en marcha
La fecha de puesta en marcha de un CMMS es un plazo, pero el trabajo que determina si lo cumples es el lote de registros históricos que debe estructurarse antes de que el sistema entre en funcionamiento. Ese trabajo se mide en páginas y horas, y casi nadie lo presupuesta.
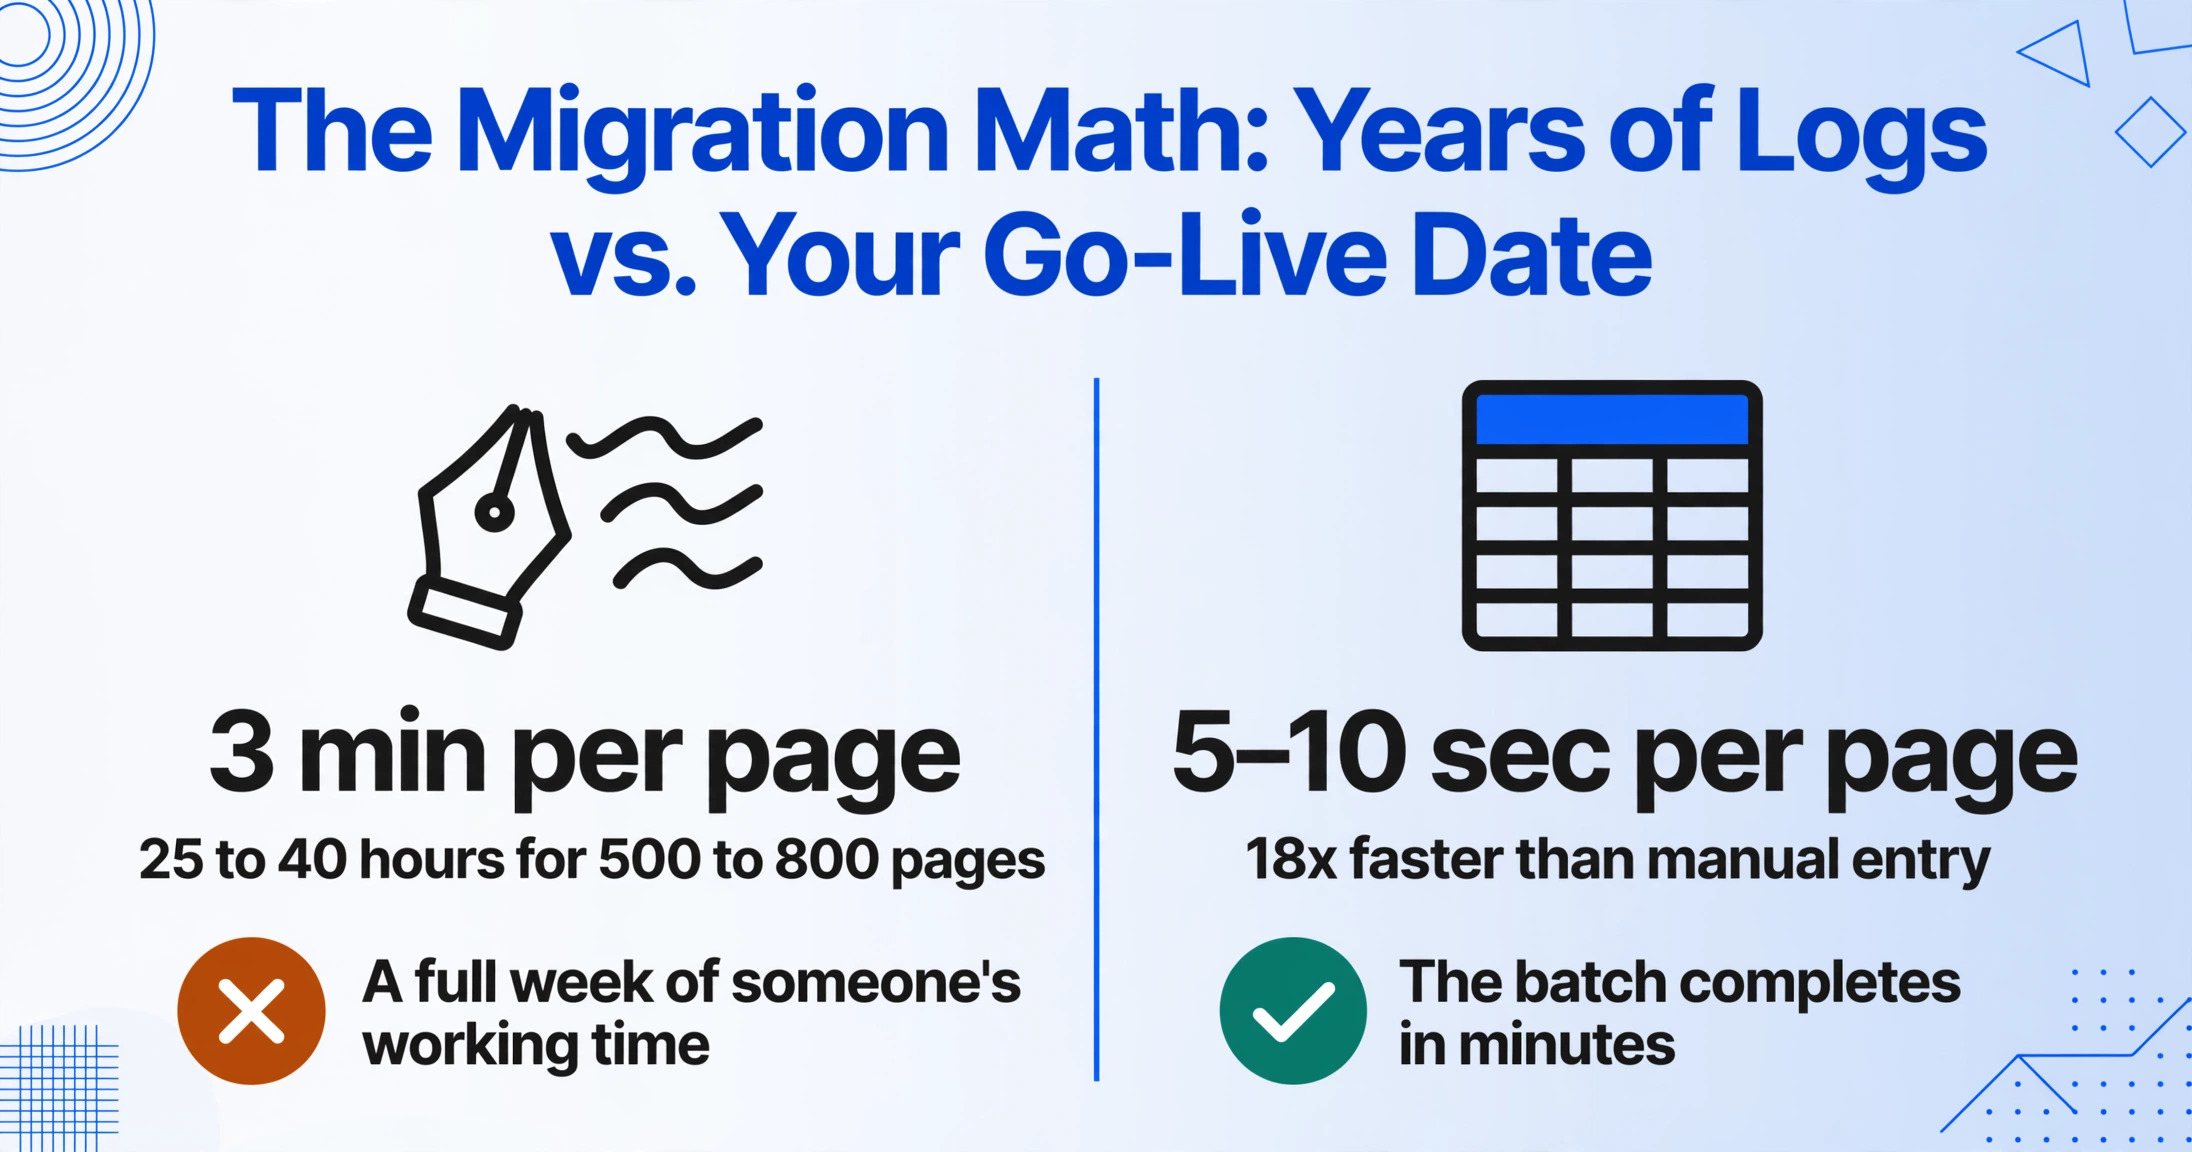
Haz las cuentas en una instalación pequeña: 30 equipos, cada uno con una entrada de registro para cada servicio o inspección durante tres años. Eso son aproximadamente 500 a 800 páginas de registro, cada una con el nombre del equipo, una fecha, una descripción de la tarea, horas de medidor, piezas utilizadas y las notas manuscritas de un técnico. A los 3 minutos por página que realmente toma la transcripción manual — escribir la fecha, el ID del activo, la tarea, las notas, revisar la letra — una persona está mirando de 25 a 40 horas de pura entrada de datos antes de que se pueda importar una sola fila. Eso no es un sábado; es una semana completa de tiempo de trabajo de alguien, y es el mejor caso, porque asume que los registros son legibles.
Las consecuencias de hacer esa entrada mal se cuantifican en Gartner, que estima que la mala calidad de los datos cuesta a las organizaciones al menos $12.9 millones por año en promedio. Para un departamento de mantenimiento, el mecanismo es simple: nombres de activos mal escritos dividen una máquina en dos registros, fechas incorrectas hacen que los intervalos de mantenimiento preventivo se desvíen, y una fila mala importada a un CMMS es peor que ninguna fila, porque el sistema ahora reporta los datos malos como un hecho. La limpieza que toda guía de CMMS exige no es una mejor práctica abstracta — es la consecuencia directa de transcribir cientos de páginas a mano.
Por eso la pregunta en la mente del autor original en un hilo ampliamente compartido de r/manufacturing sobre el seguimiento de mantenimiento es la pregunta que la mayoría de las instalaciones enfrentan antes de cualquier compra de CMMS: "¿La gente realmente mantiene registros perfectos en algún lugar? Conozco algunos softwares, pero parecen demasiado caros y pesados para su caso de uso, ¿o todos están haciendo alguna versión de Excel + papel + mensajes y esperando lo mejor?" La respuesta que la mayoría de los equipos descubre es: los registros existen, el software es asequible, y la brecha entre ellos es la entrada de datos.
El paso que toda guía de CMMS omite
Lee la documentación de importación de cualquier CMMS moderno y notarás el mismo patrón: la herramienta hace que importar sea rápido y fácil, siempre que los datos ya estén en una hoja de cálculo. La parte difícil — generar esa hoja de cálculo a partir de años de registros no estructurados — simplemente no es parte del producto.
Los límites de importación lo hacen concreto. Limble permite 2,000 tareas completadas por importación masiva desde un archivo CSV o XLSX. UpKeep limita las importaciones de órdenes de trabajo a 2,000 filas por carga. Fiix y MaintainX ambos requieren una plantilla CSV con formatos de fecha y asignaciones de campos específicos. Ninguno de ellos leerá una foto de un cuaderno de registro, interpretará un "engrasé los 3 cojinetes de la bomba" escrito a mano y lo convertirá en una fila con un formato de fecha compatible. Ese paso de conversión recae completamente en ti — y es el paso que toda guía de CMMS omite, porque los proveedores asumen que ya lo hiciste.
Las herramientas con las que los profesionales realmente gestionan su mantenimiento — IBM Maximo, SAP PM, Fiix, UpKeep, Limble, eMaint, Cryotos — todas aceptan importaciones masivas de CSV/XLSX con asignación de columnas. Difieren en límites y formatos, pero comparten un requisito: filas limpias, consistentes y estructuradas. Lo que significa que el trabajo real de una migración de CMMS no es elegir el software. Es procesar por lotes los registros históricos en la hoja de cálculo que la importación espera.
Eso es exactamente lo que hace la extracción por lotes: convierte el montón de registros en filas estructuradas antes de que el CMMS los vea, cerrando la brecha que los proveedores dejan abierta. El resto de este artículo cubre los tres desafíos que solo aparecen cuando procesas cientos de registros a la vez — reglas de nomenclatura, fusión y excepciones — y un flujo de trabajo que maneja los tres.
Desafío de Lote #1: Reglas de Nomenclatura a Través de Décadas de Registros
Una importación de CMMS creará felizmente dos activos para una misma máquina si los registros escriben su nombre de dos maneras. El primer desafío del procesamiento por lotes es imponer la consistencia en la nomenclatura a través de registros que nunca fueron escritos pensando en la consistencia.
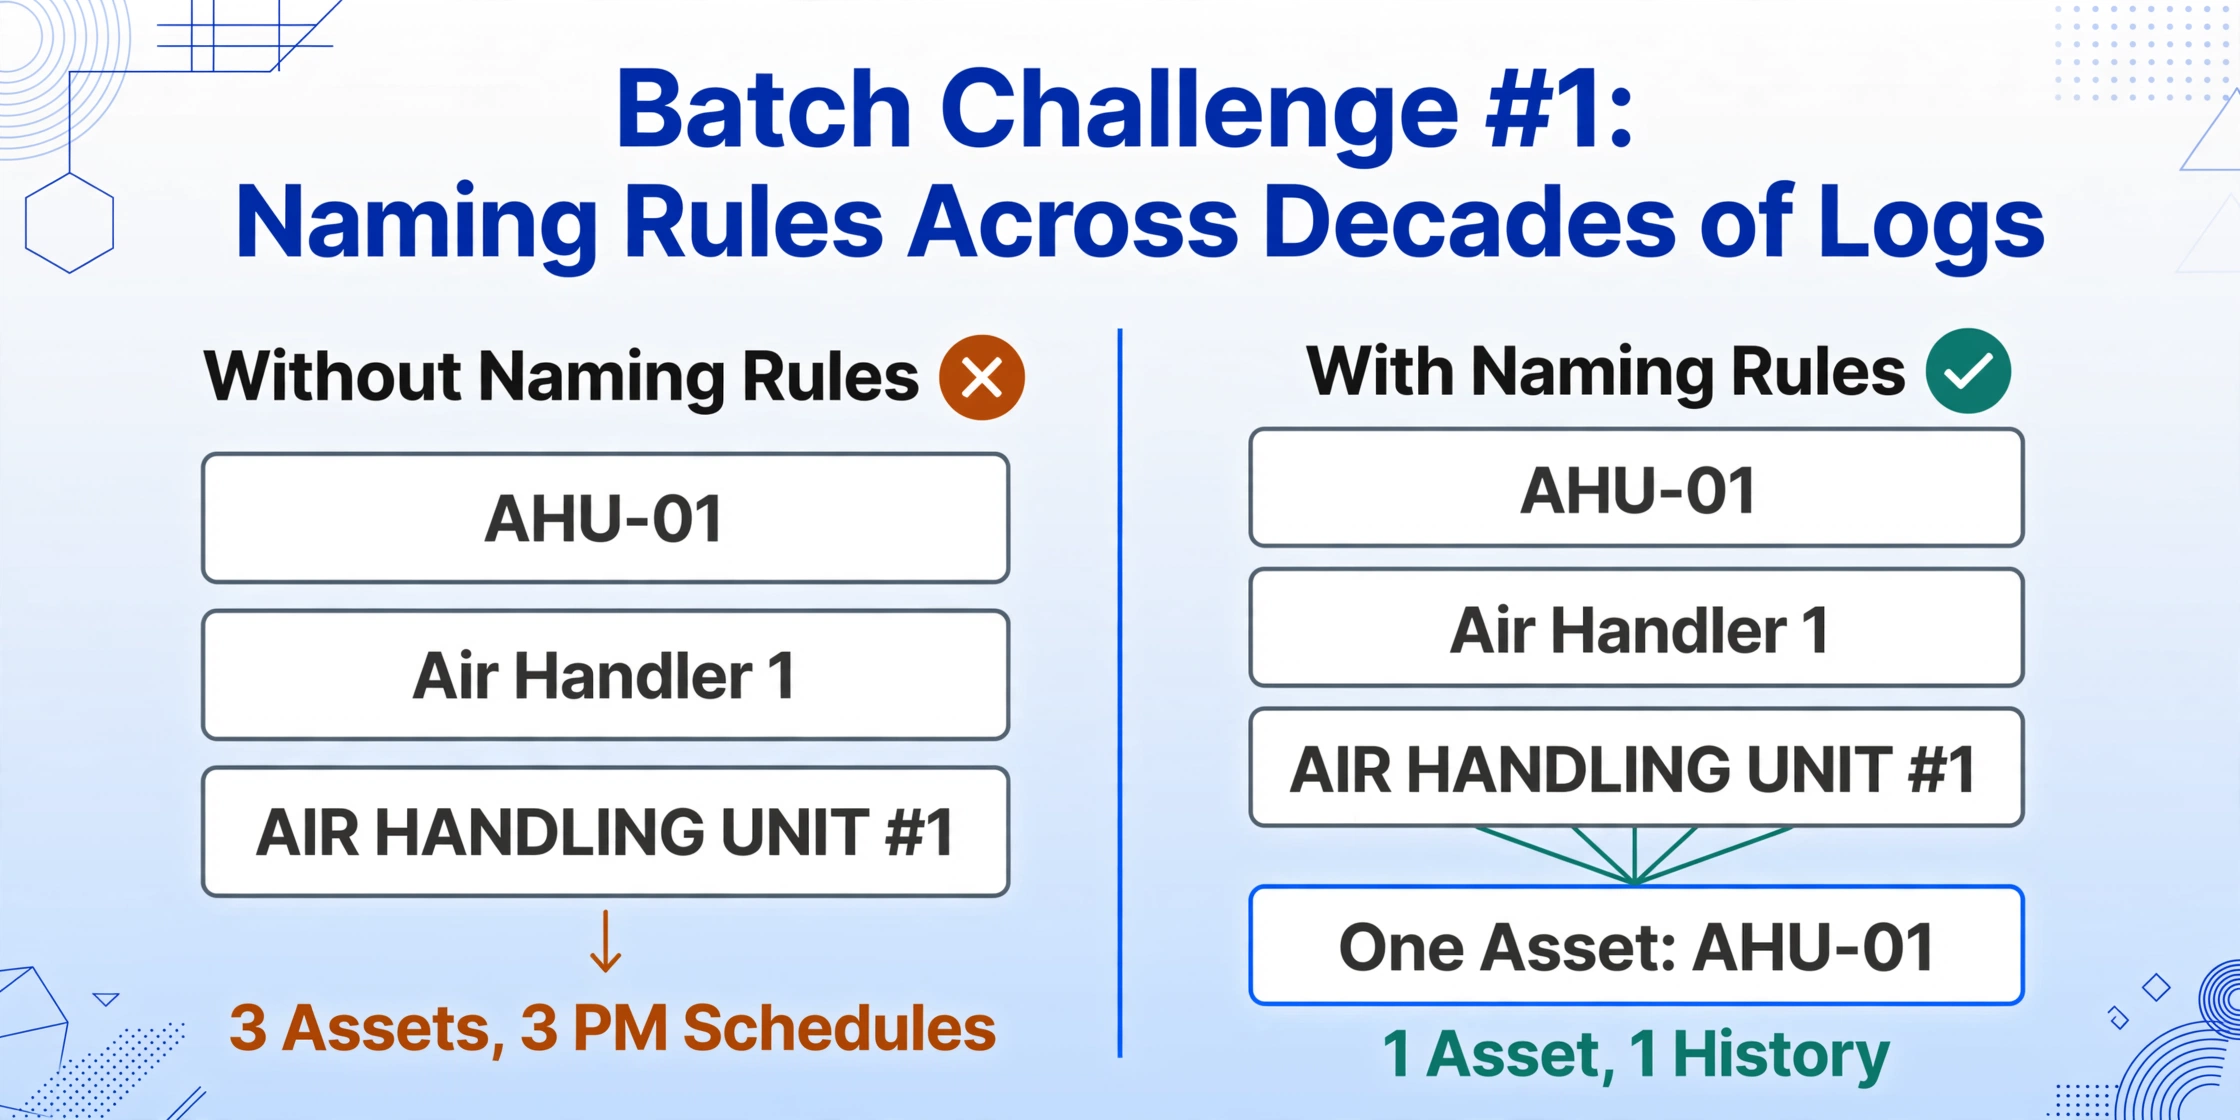
Este es el clásico problema del "activo fantasma". Un técnico escribe "AHU-01" en el libro de registro; otro escribe "Air Handler 1"; una lista de verificación de mantenimiento preventivo del proveedor dice "AIR HANDLING UNIT #1." Los tres son la misma unidad de techo, pero una importación de CMMS los trata como tres activos: tres historiales de mantenimiento, tres programas de mantenimiento preventivo, tres registros de repuestos. Las guías de migración de HVAC que sí abordan esto advierten que "AHU-01" y "Air Handler 1" son el mismo activo y deben deduplicarse antes de la importación, porque una nomenclatura consistente previene exactamente este problema. Es la diferencia entre una importación limpia y un sistema que comienza su vida mal.
El procesamiento por lotes es donde las reglas de nomenclatura se aplican de manera económica, porque las defines una vez y las aplicas a cada página del montón. En un flujo de trabajo de extracción, nombras las columnas que deseas — "ID de Activo," "Fecha de Servicio," "Tarea Realizada," "Repuestos Utilizados" — y la IA localiza cada valor en cada registro al entender lo que significa el campo, no al coincidir con una posición fija en la página. Eso es Extracción de Columnas Personalizadas, y es independiente del formato: las mismas definiciones de columna funcionan en listas de verificación de mantenimiento preventivo impresas, páginas de libros de registro escritas a mano y fotos de teléfono de etiquetas de equipo, porque la extracción lee por significado en lugar de por diseño.
Para el problema de nomenclatura específicamente, una columna inferida realiza la normalización durante la extracción. Agregas una columna como "ID de Activo (estandarizar al formato: AHU-01, PUMP-02, CONV-03)" y la IA lee cualquier identificador que aparezca en cada página — "Air Handler 1," "air handling unit #1," "AHU-1" — y genera el código estandarizado en cada fila. La deduplicación que las guías de CMMS describen como un paso de limpieza manual ocurre en la misma pasada que la extracción, antes de que los datos lleguen al archivo de importación.
Si tu instalación está en una industria regulada, hay un estándar con el cual alinearse aquí. ISO 14224, el estándar internacional para la recopilación e intercambio de datos de confiabilidad y mantenimiento, fue escrito para el sector de petróleo y gas, pero su patrón central se aplica en cualquier lugar: define un conjunto mínimo de datos, recopílalo en un formato estandarizado y registra los modos de falla de manera distinta a sus causas. Incluso una instalación modesta puede tomar prestada esa disciplina — códigos de activo fijos, tipos de tarea estandarizados, campos de fecha consistentes — y aplicarla a nivel de lote en lugar de esperar que cada técnico escriba de manera consistente por casualidad.
Desafío por lotes n.º 2: fusionar páginas manuscritas, fotos y hojas de cálculo antiguas en una sola tabla
Lo segundo que solo sale a la luz a escala es la mezcla de formatos. Un atraso de tres años rara vez es un único formato ordenado: son listas de verificación de mantenimiento impresas en una carpeta, un cuaderno espiral con anotaciones a mano, una carpeta de fotos del teléfono de antes de que existiera una regla sobre el registro, y quizás un antiguo archivo de Excel que inició un antiguo gerente. Una herramienta de documento único te obliga a manejar cada formato de manera diferente. El procesamiento por lotes es específicamente el flujo de trabajo para subirlos todos juntos y fusionar los resultados en una sola tabla — una fila por entrada de registro, en cada carpeta, cada cuaderno, cada sitio, sin importar el formato de origen.
La fusión funciona porque la extracción está impulsada por columnas, no por plantillas. Define tus columnas una vez — ID de activo, fecha, tarea, horas de medidor, técnico, piezas utilizadas, hallazgos — y la IA lee cada página con esas mismas definiciones. Un libro de registro dibujado a mano y una lista de verificación de mantenimiento impresa producen filas con estructura idéntica, que es exactamente lo que requiere una plantilla de importación de CMMS. El resultado llega a una sola hoja de cálculo donde cada fila ya tiene la forma que la importación espera.
Para la recopilación con varios técnicos o en varios sitios, el problema práctico es reunir las páginas en primer lugar. Un Enlace de Recopilación — un enlace de carga compartible que permite a cualquiera enviar archivos a tu cola de procesamiento sin una cuenta — recopila fotos de cada técnico y cada sitio en un solo lugar, en lugar de perseguir libros de registro por las instalaciones. Un enlace, una cola, un lote.
Pruébalo con una página de tu propio montón de registros — no se necesita plantilla, solo sube y nombra tus columnas:
Los archivos se procesan de forma segura y no se almacenan.
Desafío de Lote #3: Qué Sucede Cuando una Página es Ilegible
En un lote de cientos de páginas, algunas estarán manchadas, otras tendrán manchas de café, y algunas estarán escritas con una letra que solo su autor podría leer. Un flujo de trabajo de lote realista espera excepciones — no finge que cada página se extrae perfectamente.
La escritura a mano es la limitación honesta aquí. Las entradas de registro impresas y los formularios mixtos impresos más escritos a mano se extraen de manera confiable, porque la IA se ancla en las etiquetas impresas e interpreta los valores escritos a mano en contexto. Las letras mayúsculas legibles funcionan bien. La escritura cursiva, las manchas fuertes y las fotos de muy bajo contraste reducen la precisión. La cifra de precisión del 99% que cita ImageToTable.ai se aplica a datos de tablas impresas; la precisión de la escritura a mano depende de la legibilidad. Cualquiera que prometa lo contrario no está siendo honesto con usted.
Lo que cambia el procesamiento por lotes es cómo maneja las excepciones. En lugar de descubrir una página mala tres meses después de la implementación del CMMS, usted revisa la salida del lote antes de la importación. Modo de Revisión le permite pasar el cursor sobre cualquier celda extraída y ver el punto exacto en el registro original de donde proviene el valor — un cuadro delimitador dibujado en la imagen, para que verifique si la IA leyó la escritura correcta, no si confía en la herramienta en general. Un lote escaneado de 500 páginas que tomaría días verificar manualmente se convierte en una verificación puntual de las filas marcadas, porque el paso de verificación se dirige a las celdas que importan en lugar de cada pulsación de tecla.
Para páginas que genuinamente no se pueden leer: vuelva a fotografiarlas con mejor luz, o déjelas fuera del lote y marque el registro del equipo en consecuencia. Una importación honesta que omite algunas entradas ilegibles es mejor que una deshonesta que las fabrica. El CMMS no conoce la diferencia; el equipo para el que programa el mantenimiento preventivo sí.
El Flujo de Trabajo por Lotes: Del Montón de Registros al Archivo de Importación CMMS
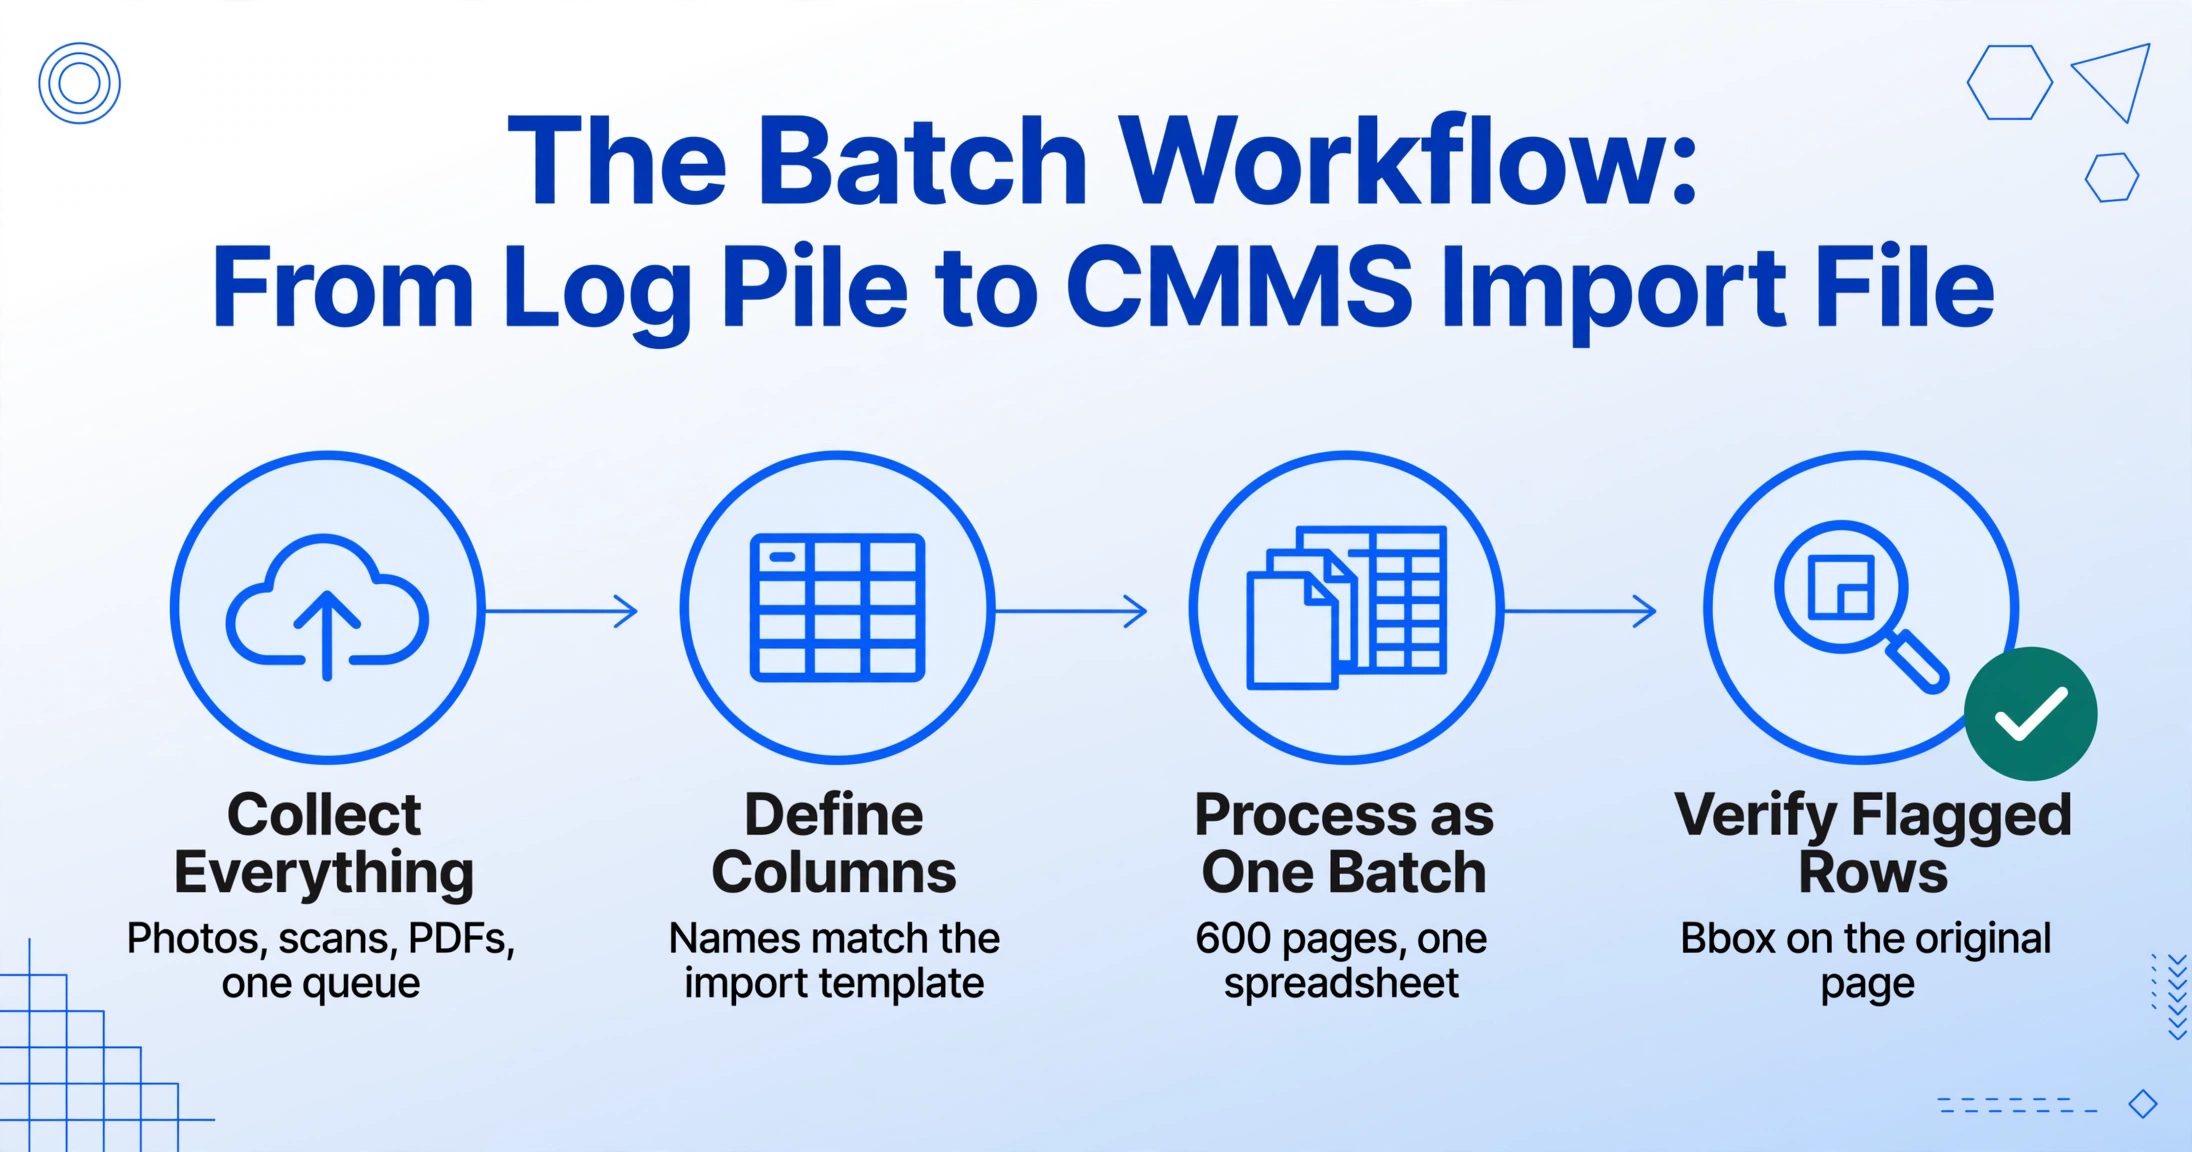
Aquí está el flujo de trabajo de extremo a extremo que maneja los tres desafíos en una sola pasada — diseñado para la persona cuya fecha de lanzamiento está a tres semanas y cuyos registros están en una carpeta.
Para equipos que ya gestionan su seguimiento diario en una hoja de cálculo en lugar de un CMMS, el mismo lote alimenta la hoja que ya usan — el flujo de foto a hoja de cálculo funciona de manera idéntica cuando el destino es un libro de seguimiento en lugar de un archivo de importación. Y el punto de partida — convertir un solo registro en filas estructuradas — es el flujo de extracción paso a paso cubierto por separado; este artículo es lo que sucede cuando multiplicas ese flujo por cientos de páginas.
Qué migrar y qué archivar
No es necesario digitalizar una década de registros para lograr una puesta en marcha exitosa del CMMS. El consenso de la industria es de 12 a 24 meses de historial de mantenimiento para los activos críticos — y la disciplina de decidir qué queda fuera del sistema es parte de mantener limpios los datos que entran.
La tentación de migrarlo todo es comprensible — los datos son valiosos, y desechar el historial parece un desperdicio. Pero un CMMS lleno de 10 años de registros inconsistentes rinde peor que uno con dos años de registros limpios. Las guías de implementación de CMMS recomiendan consistentemente migrar aproximadamente los últimos 12 a 24 meses de historial de mantenimiento, archivar el resto como referencia de solo lectura, y priorizar primero el 20% más crítico de los activos — la regla 80/20 que incorpora al sistema los activos más importantes con la mayor calidad de datos, en lugar de una importación uniformemente superficial de todo.
El procesamiento por lotes respalda esta segmentación de forma natural: puede ejecutar primero los libros de registro de activos críticos como un lote limpio, verificarlos, importarlos y ponerlos en marcha a tiempo — luego procesar los activos restantes en pasadas posteriores. La puesta en marcha no espera por el backlog completo; el backlog completo se convierte en una serie de lotes en lugar de un proyecto abrumador.
Aquí es también donde la calidad de los datos se vuelve crucial. ISO 55001:2024, el estándar certificable para sistemas de gestión de activos, trata la información documentada y confiable de activos como un requisito central — la revisión de 2024 reforzó el énfasis en la calidad de datos y la gestión del conocimiento. El compendio de Mejores Prácticas del SMRP, las más de 70 métricas estándar de la industria de mantenimiento, no pueden calcularse sin un historial estructurado: porcentaje de mantenimiento planificado, cumplimiento de PM, tiempo medio entre fallas — cada una es una consulta sobre filas limpias y consistentes. Un historial deficiente o ausente no solo se ve mal en una auditoría; hace que todo el programa de medición sea incalculable.
Preguntas frecuentes
¿Cuántas páginas de registro de mantenimiento puedo procesar a la vez de forma realista?
El procesamiento por lotes está diseñado para volumen: suba cientos de páginas en un solo lote y la IA las procesa juntas en una única tabla combinada. El límite práctico está en la salida: la mayoría de las importaciones de CMMS tienen un tope de 2,000 filas por carga (Limble y UpKeep ambos lo hacen), así que para acumulaciones muy grandes se divide la exportación en partes bajo el límite. Un retraso de dos años que le tomaría a un oficinista una semana escribir se convierte en una sola tarde de procesamiento y revisión.
¿La extracción leerá nuestros registros escritos a mano con suficiente precisión para un CMMS?
La escritura legible se extrae de manera confiable — letras de molde y caracteres separados especialmente, y los formularios mixtos impresos y manuscritos funcionan bien porque la IA se ancla en las etiquetas impresas y lee los valores en contexto. La escritura cursiva, las manchas fuertes y las fotos de bajo contraste reducen la precisión. Por eso existe el paso de verificación: usted revisa las celdas marcadas contra la página original en lugar de confiar ciegamente en cada valor. Para un sistema sujeto a cumplimiento como un CMMS, esa revisión es el equilibrio correcto — es mucho más rápido que la transcripción y detecta los errores que importan.
Nuestro CMMS tiene su propia plantilla de importación. ¿La hoja de cálculo extraída coincide con ella?
Sí, porque usted controla los nombres de las columnas. La Extracción de Columnas Personalizadas usa los nombres que usted escribe como encabezados de salida, así que nombre sus columnas para que coincidan con la plantilla de importación del CMMS — ID de Activo, Completado el, Descripción de la Tarea, y así sucesivamente. La estandarización de fechas y números ocurre durante la extracción, así que las filas salen en el formato que la importación espera en lugar de lo que usaba el libro de registro.
Nuestros registros son una mezcla de formularios impresos, páginas manuscritas y hojas de cálculo antiguas. ¿Necesitamos un proceso diferente para cada uno?
No. Debido a que la extracción está impulsada por columnas en lugar de plantillas, las mismas definiciones de columnas funcionan en listas de verificación impresas, páginas de libros de registro manuscritas y fotos de teléfono. Las hojas de cálculo digitales antiguas que ya tiene pueden exportarse como PDFs e incluirse en el mismo lote, lo que también normaliza su formato en la misma estructura de salida.
¿Cómo evitamos activos duplicados después de la importación?
Dos capas: primero, agregue una columna inferida durante la extracción que estandarice los identificadores de activos — la IA lee "AHU-01," "Air Handler 1," y "air handling unit #1" y genera un código consistente por fila. Segundo, ejecute una tabla dinámica rápida en la columna de ID de activo extraída antes de la importación para confirmar que cada fila corresponda a un activo existente. Ambos toman minutos y previenen el problema de activos fantasma que corrompe el historial de mantenimiento en su origen.
¿Esto reemplaza el CMMS en sí?
No — alimenta el CMMS. La extracción convierte los registros históricos en la hoja de cálculo estructurada y limpia que cualquier importación de CMMS requiere. Resuelve el paso que los proveedores le dejan a usted: convertir años de papel y fotos en filas listas para importar. Una vez que el historial está dentro, el CMMS se encarga de la programación, órdenes de trabajo e informes exactamente como fue diseñado.
La idea clave para tu migración es esta: un CMMS es tan bueno como el historial que le des, y el historial es tan bueno como el lote que lo digitalizó. Los límites de importación y plantillas que tu proveedor ofrece no son la parte difícil — la parte difícil es el montón de registros en la carpeta, y esa es precisamente la parte que un flujo de trabajo por lotes está diseñado para eliminar.