Le traitement par lots avant chaque GMAO :
des années de journaux de maintenance
Le goulot d'étranglement d'une migration vers une GMAO n'est presque jamais le logiciel. Le fournisseur configure le système en une semaine ; la hiérarchie des actifs se charge en un après-midi. Ce qui retarde la mise en service, c'est la pile d'historique de maintenance dans les registres, les classeurs et les photos de téléphone qui doit être transformée en feuille de calcul avant que le nouveau système puisse être fiable pour un seul ordre de travail. Chaque guide de mise en œuvre de GMAO traite cette pile comme une évidence — « rassemblez, examinez et nettoyez vos données » — sans jamais répondre à la question qui bloque réellement les équipes : comment, exactement, des centaines de pages papier deviennent-elles des lignes prêtes à importer ?
Points clés à retenir
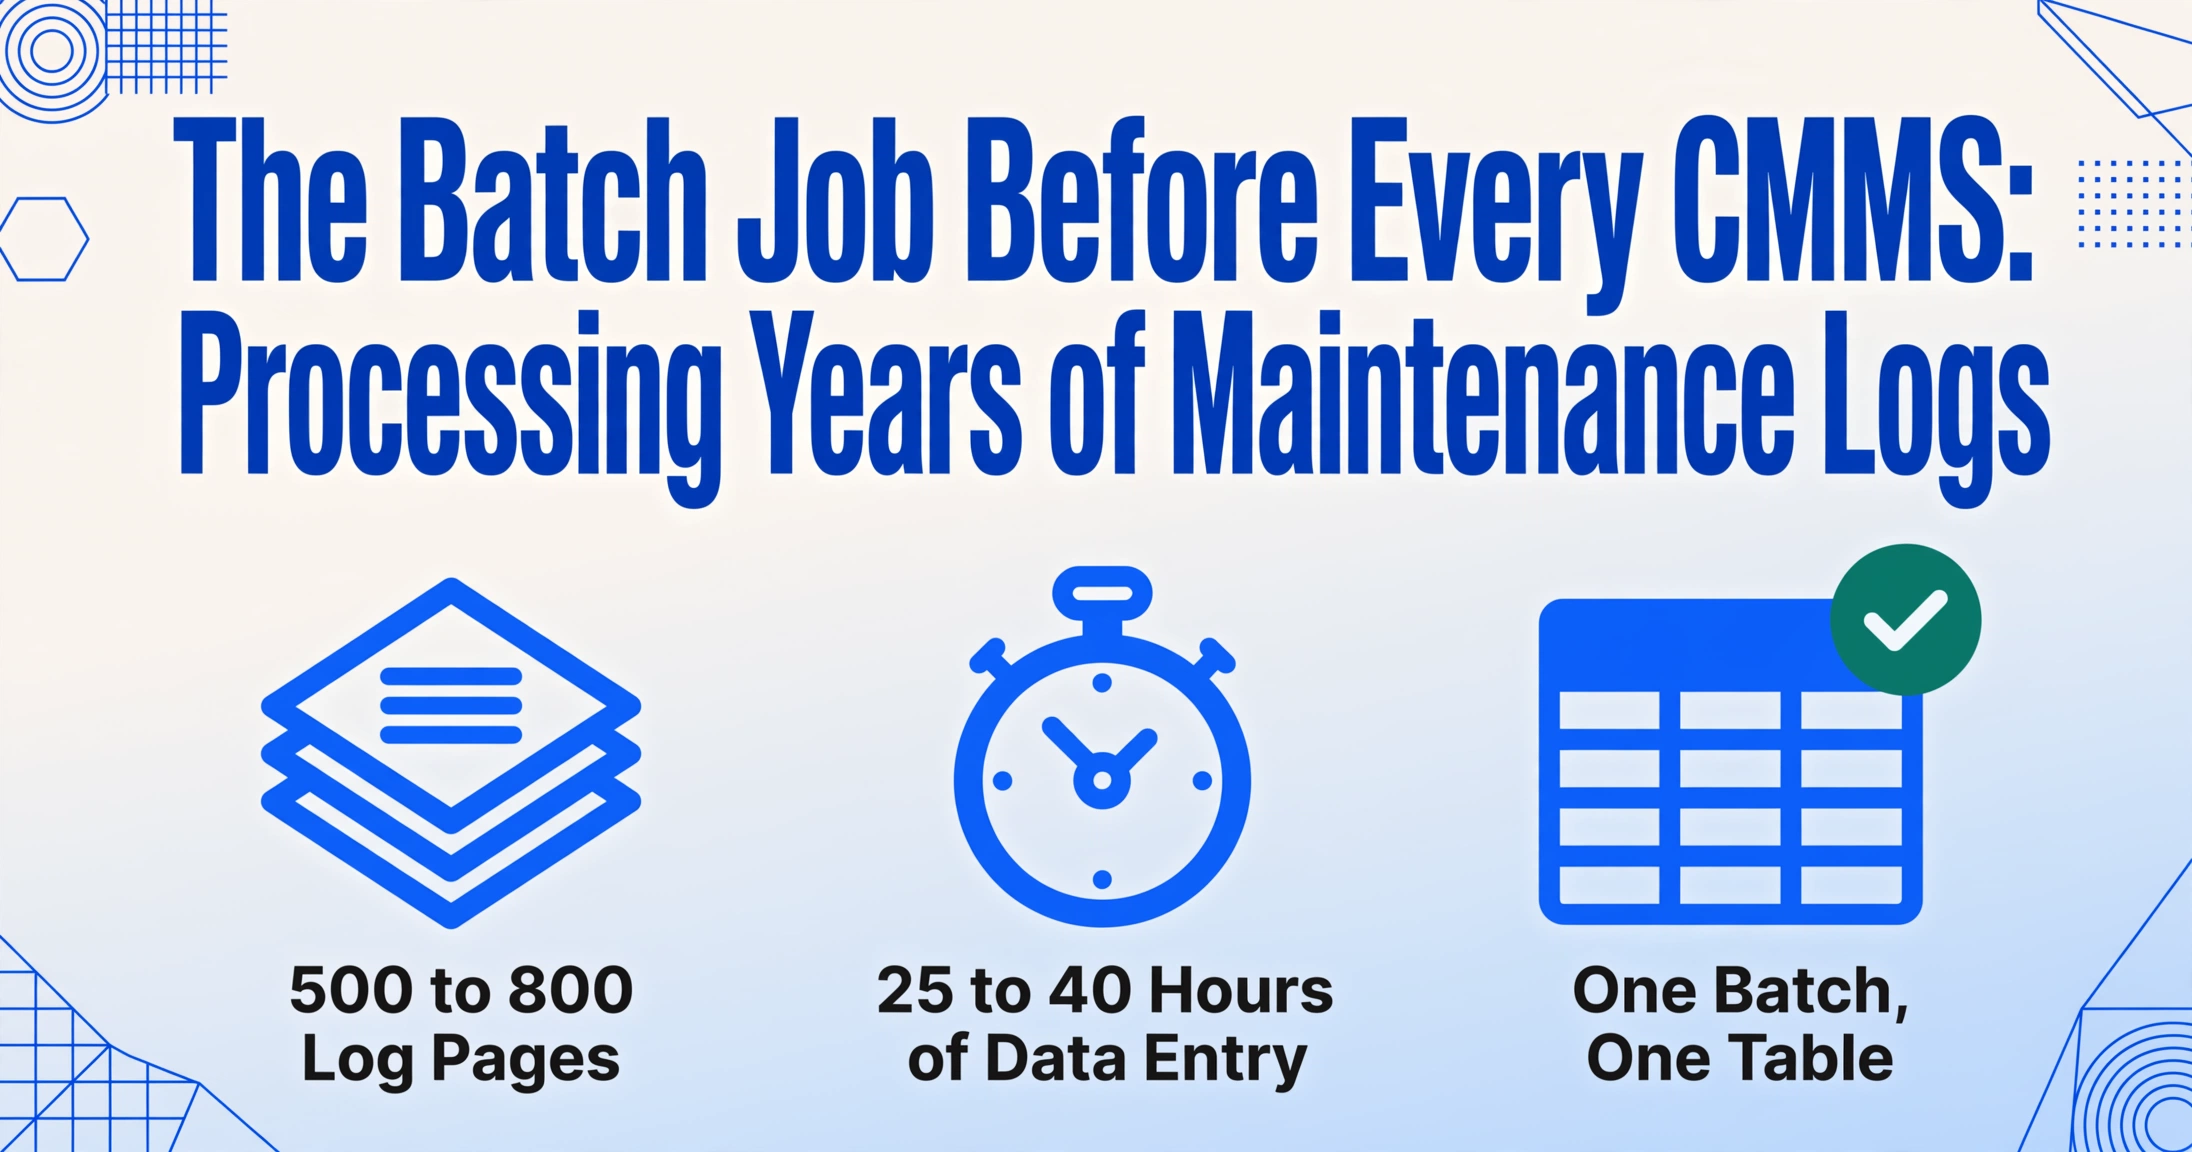
- Un arriéré de maintenance de deux ans représente 25 à 40 heures de saisie avant que votre bouton d'importation GMAO ne fasse quoi que ce soit — une semaine de travail complète que chaque plan de migration budgétise par accident à zéro.
- La transcription manuelle ne prend pas seulement du temps — elle crée des actifs fantômes lorsque « AHU-01 » et « Air Handler 1 » entrent comme deux machines, corrompant la GMAO dès la première importation.
- Le traitement par lots définit vos colonnes une fois et lit chaque page de registre, photo de téléphone et formulaire scanné selon les mêmes règles — 18× plus rapide, et la déduplication se fait dans le même passage.
Les calculs de migration : des années de journaux contre votre date de mise en service
Une date de mise en service d'un GMAO est une échéance, mais le travail qui détermine si vous l'atteignez est le lot de journaux historiques qui doit être structuré avant que le système ne soit mis en service. Ce travail se mesure en pages et en heures, et presque personne ne le budgète.
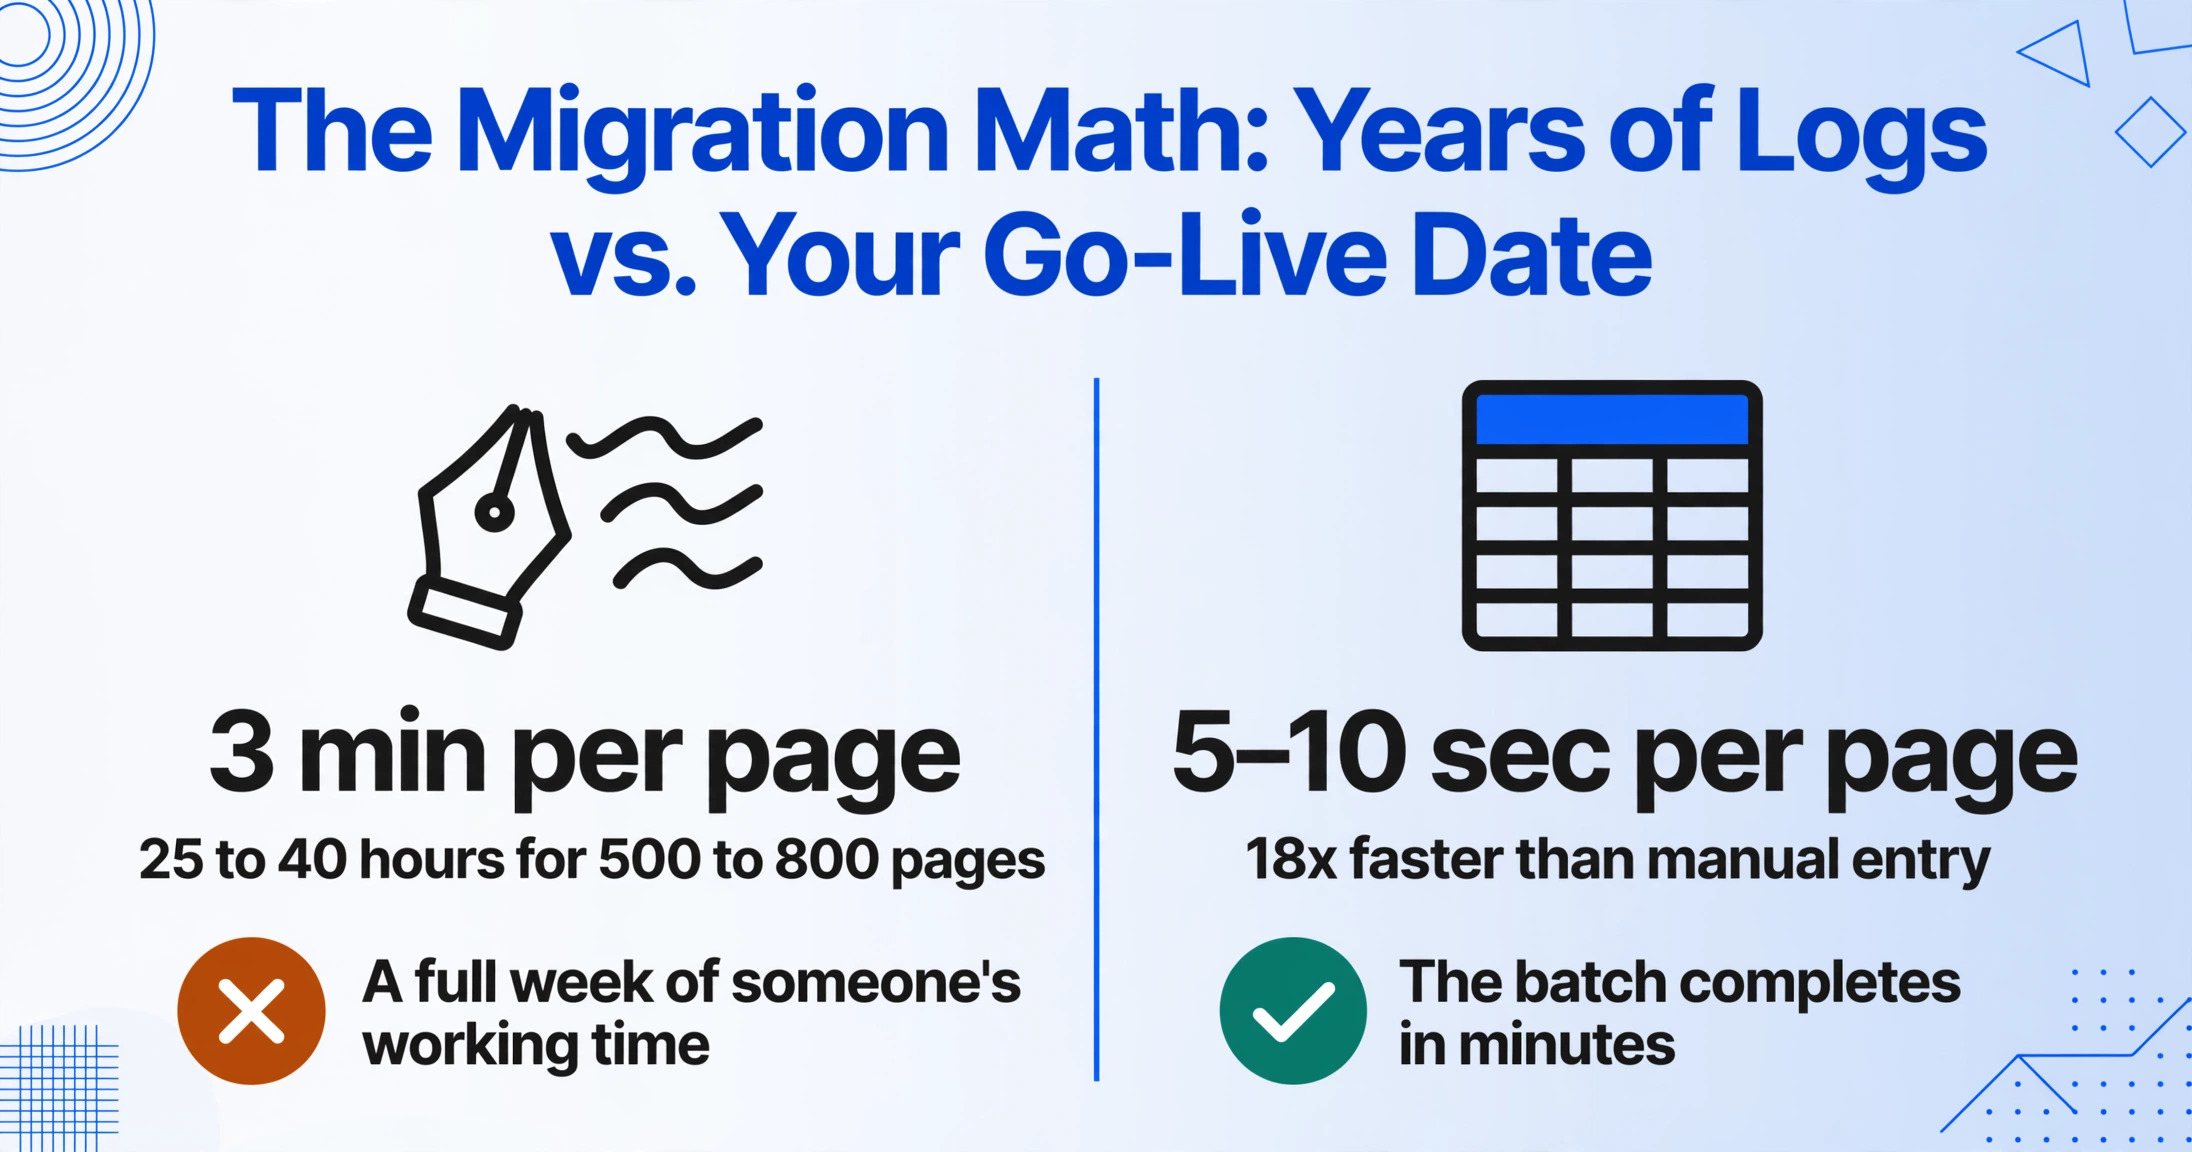
Faites le calcul pour une petite installation : 30 équipements, chacun avec une entrée de journal pour chaque intervention ou inspection sur trois ans. Cela représente environ 500 à 800 pages de journaux, chacune contenant un nom d'équipement, une date, une description de tâche, des heures moteur, des pièces utilisées et les notes manuscrites d'un technicien. Au rythme de 3 minutes par page que prend réellement la transcription manuelle — saisir la date, l'identifiant de l'actif, la tâche, les notes, vérifier l'écriture — une personne est confrontée à 25 à 40 heures de pure saisie de données avant qu'une seule ligne puisse être importée. Ce n'est pas un samedi ; c'est une semaine complète de temps de travail de quelqu'un, et c'est le meilleur des cas, car cela suppose que les journaux soient lisibles.
Les enjeux d'une mauvaise saisie sont quantifiés par Gartner, qui estime que la mauvaise qualité des données coûte aux organisations au moins 12,9 millions de dollars par an en moyenne. Pour un service de maintenance, le mécanisme est simple : des noms d'actifs mal orthographiés divisent une machine en deux enregistrements, des dates erronées font dériver les intervalles de maintenance préventive, et une mauvaise ligne importée dans un GMAO est pire qu'aucune ligne, car le système rapporte désormais les mauvaises données comme des faits. Le nettoyage que chaque guide GMAO exige n'est pas une bonne pratique abstraite — c'est la conséquence directe de la transcription manuelle de centaines de pages.
C'est pourquoi la question qui préoccupe l'auteur du message original dans un fil r/manufacturing largement partagé sur le suivi de la maintenance est la question que la plupart des installations se posent avant tout achat de GMAO : « Les gens tiennent-ils vraiment des journaux parfaits quelque part ? Je connais certains logiciels, mais cela semble trop cher et trop lourd pour leur cas d'usage, ou est-ce que tout le monde fait juste une version d'Excel + papier + SMS en espérant que ça marche ? » La réponse que la plupart des équipes découvrent est : les journaux existent, le logiciel est abordable, et l'écart entre les deux est la saisie de données.
L'étape que tous les guides CMMS oublient
Lisez la documentation d'importation de n'importe quel CMMS moderne et vous remarquerez le même schéma : l'outil rend l'importation rapide et facile, à condition que les données se trouvent déjà dans un tableur. La partie difficile — produire ce tableur à partir d'années d'enregistrements non structurés — ne fait tout simplement pas partie du produit.
Les limites d'importation rendent cela concret. Limble autorise 2 000 tâches terminées par import en masse à partir d'un fichier CSV ou XLSX. UpKeep plafonne les importations d'ordres de travail à 2 000 lignes par téléchargement. Fiix et MaintainX exigent tous deux un modèle CSV avec des formats de date et des correspondances de champs spécifiques. Aucun d'entre eux ne lira une photo de journal, n'analysera un « graissage des 3 roulements de pompe » écrit à la main et ne le transformera en une ligne avec un format de date conforme. Cette étape de conversion repose entièrement sur vous — et c'est l'étape que chaque tutoriel CMMS oublie, car les fournisseurs supposent que vous l'avez déjà faite.
Les outils sur lesquels les praticiens s'appuient réellement pour leur maintenance — IBM Maximo, SAP PM, Fiix, UpKeep, Limble, eMaint, Cryotos — acceptent tous les imports CSV/XLSX en masse avec correspondance de colonnes. Ils diffèrent par leurs limites et leurs formats, mais partagent une exigence : des lignes propres, cohérentes et structurées. Le vrai travail d'une migration CMMS ne consiste donc pas à choisir un logiciel. Il consiste à traiter par lots les journaux historiques dans le tableur que l'import attend.
C'est exactement ce que fait l'extraction par lots : elle convertit la pile de journaux en lignes structurées avant que le CMMS ne les voie, comblant ainsi le vide que les fournisseurs laissent ouvert. Le reste de cet article couvre les trois défis qui n'apparaissent que lorsque vous traitez des centaines de journaux à la fois — règles de nommage, fusion et exceptions — et un flux de travail qui gère les trois.
Défi de lot n°1 : Règles de dénomination sur des décennies de journaux
Un import CMMS créera volontiers deux actifs pour une seule machine si les journaux écrivent son nom de deux façons. Le premier défi du traitement par lots est d'imposer une cohérence de dénomination sur des enregistrements qui n'ont jamais été rédigés avec cette cohérence en tête.
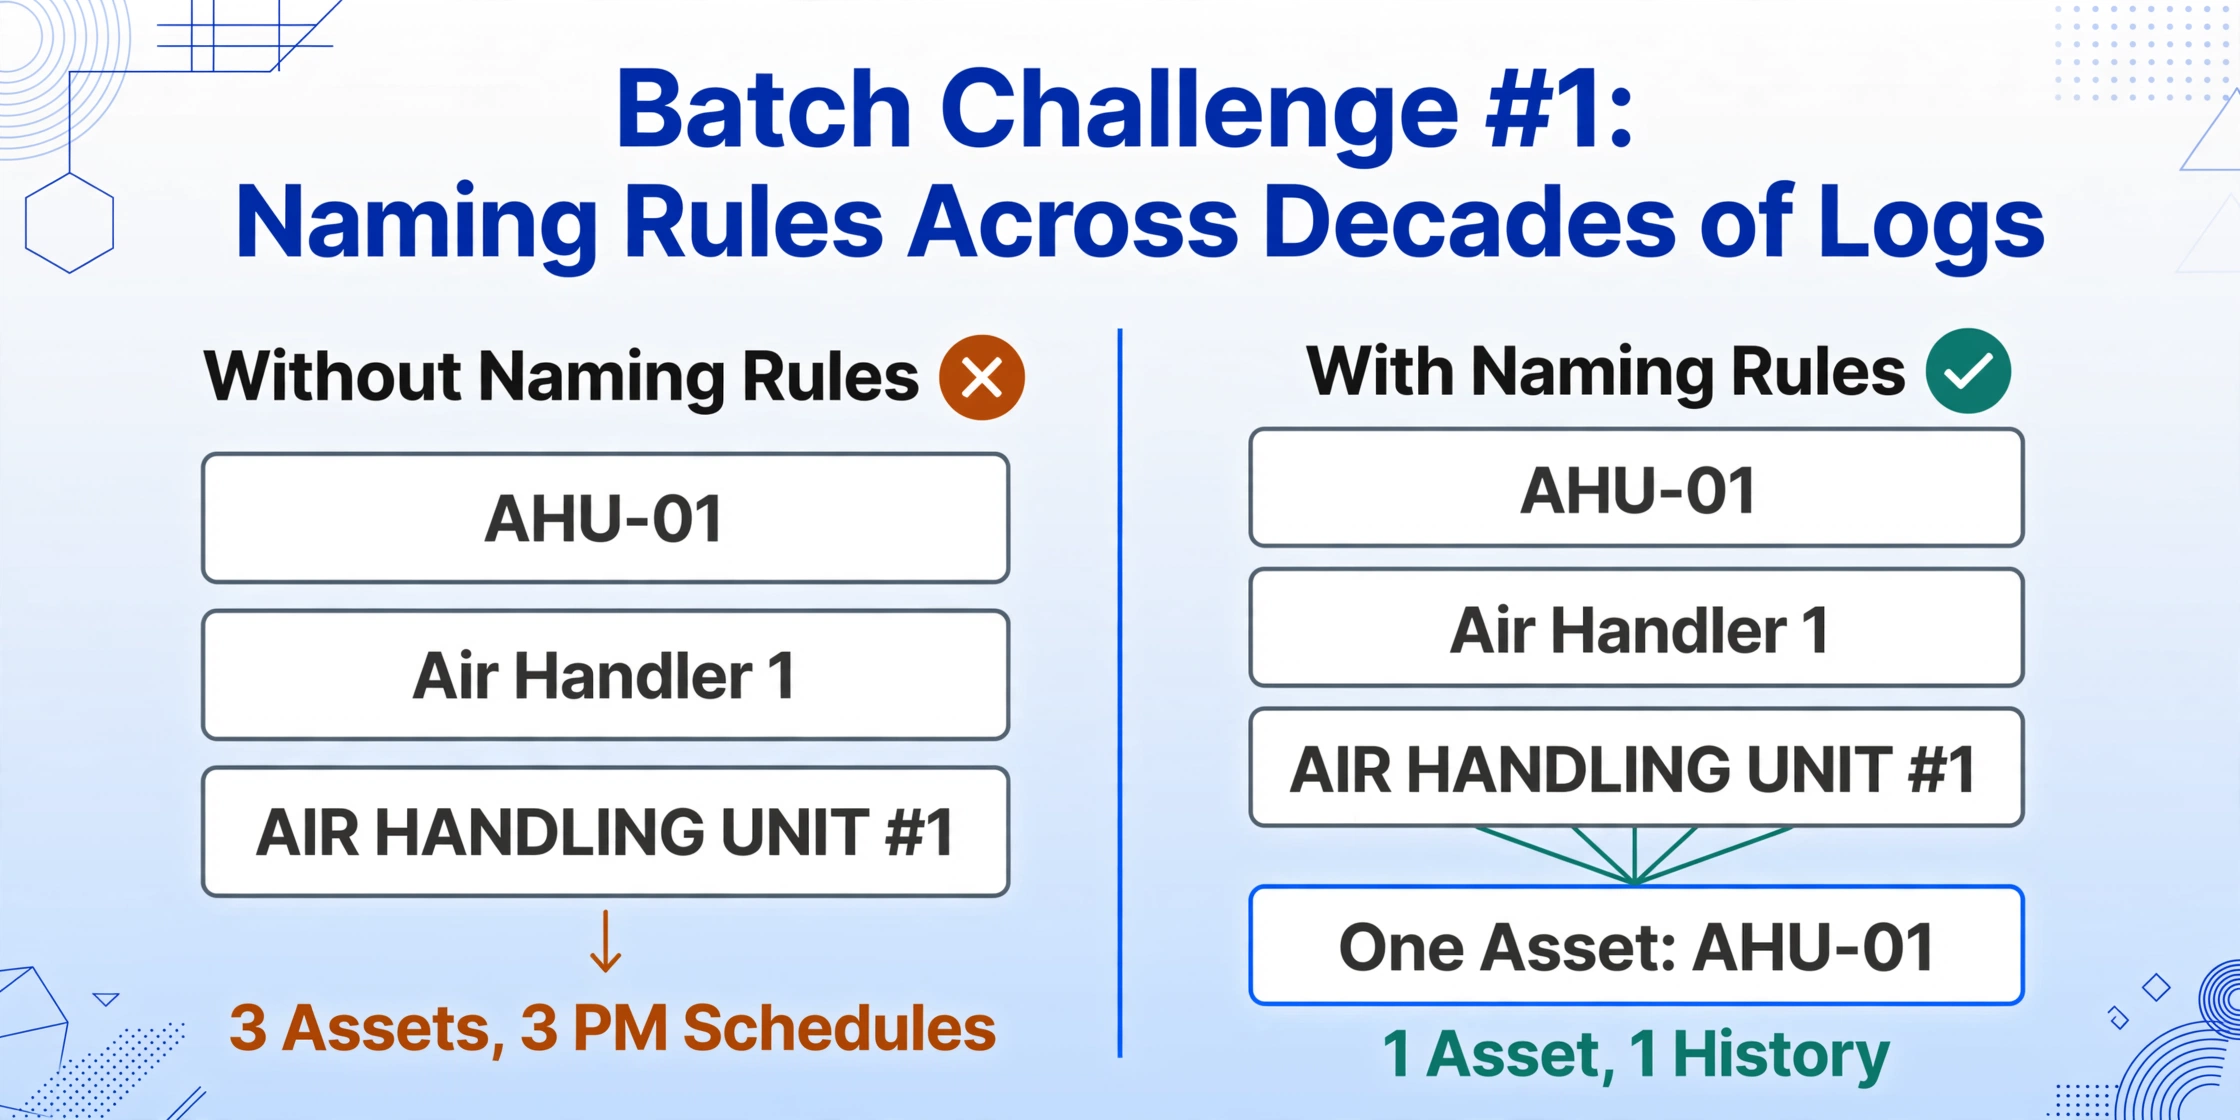
C'est le problème classique de l'« actif fantôme ». Un technicien écrit « AHU-01 » dans le journal ; un autre écrit « Air Handler 1 » ; une liste de contrôle de maintenance préventive du fournisseur indique « AIR HANDLING UNIT #1 ». Les trois désignent la même unité de toiture, mais un import CMMS les traite comme trois actifs — trois historiques de maintenance, trois calendriers de maintenance préventive, trois fiches de pièces détachées. Les guides de migration CVC qui abordent ce sujet avertissent que « AHU-01 » et « Air Handler 1 » sont le même actif et doivent être dédupliqués avant l'import, car une dénomination cohérente évite précisément ce problème. C'est la différence entre un import propre et un système qui commence sa vie du mauvais pied.
Le traitement par lots est l'endroit où les règles de dénomination sont appliquées à moindre coût, car vous les définissez une fois et les appliquez à chaque page de la pile. Dans un flux d'extraction, vous nommez les colonnes souhaitées — « ID d'actif », « Date de service », « Tâche effectuée », « Pièces utilisées » — et l'IA localise chaque valeur dans chaque journal en comprenant ce que signifie le champ, et non en correspondant à une position fixe sur la page. C'est l'Extraction de colonnes personnalisées, et elle est indépendante du format : les mêmes définitions de colonnes fonctionnent sur des listes de contrôle de maintenance préventive imprimées, des pages de journal manuscrites et des photos de téléphone d'étiquettes d'équipement, car l'extraction lit le sens plutôt que la mise en page.
Pour le problème de dénomination spécifiquement, une colonne inférée effectue la normalisation pendant l'extraction. Vous ajoutez une colonne comme « ID d'actif (normaliser au format : AHU-01, PUMP-02, CONV-03) » et l'IA lit tout identifiant apparaissant sur chaque page — « Air Handler 1 », « air handling unit #1 », « AHU-1 » — et génère le code normalisé dans chaque ligne. La déduplication que les guides CMMS décrivent comme une étape de nettoyage manuel se produit dans la même passe que l'extraction, avant que les données n'atteignent le fichier d'import.
Si votre installation est dans un secteur réglementé, il existe une norme à laquelle s'aligner ici. ISO 14224, la norme internationale pour la collecte et l'échange de données de fiabilité et de maintenance, a été rédigée pour le secteur pétrolier et gazier, mais son modèle de base s'applique partout : définir un ensemble de données minimal, le collecter dans un format normalisé et enregistrer les modes de défaillance distinctement de leurs causes. Même une installation modeste peut emprunter cette discipline — codes d'actifs fixes, types de tâches normalisés, champs de date cohérents — et l'appliquer au niveau du lot au lieu d'espérer que chaque technicien écrive de manière cohérente.
Défi lot n°2 : fusionner des pages manuscrites, des photos et d'anciens tableurs en un seul tableau
La deuxième chose qui n'apparaît qu'à grande échelle, c'est le mélange des formats. Un arriéré de trois ans est rarement un format unique et soigné — ce sont des listes de contrôle PM imprimées dans un classeur, un carnet à spirale avec des entrées manuscrites, un dossier de photos prises au téléphone avant qu'une règle sur la journalisation ne soit établie, et peut-être un ancien fichier Excel qu'un ancien manager avait commencé. Un outil mono-document vous oblige à traiter chaque format différemment. Le traitement par lots est précisément le flux de travail pour tout téléverser ensemble et fusionner les résultats en un seul tableau — une ligne par entrée de journal, à travers chaque classeur, chaque carnet, chaque site, quel que soit le format source.
La fusion fonctionne parce que l'extraction est pilotée par les colonnes plutôt que par les modèles. Définissez vos colonnes une fois — ID d'actif, Date, Tâche, Heures compteur, Technicien, Pièces utilisées, Constatations — et l'IA lit chaque page selon ces mêmes définitions. Un journal manuscrit et une liste de contrôle PM imprimée produisent des lignes à la structure identique, ce qui est exactement ce qu'un modèle d'importation CMMS exige. Le résultat atterrit dans un tableur unique où chaque ligne a déjà la forme attendue pour l'importation.
Pour la collecte multi-techniciens ou multi-sites, le problème pratique est de rassembler les pages en premier lieu. Un Lien de collecte — un lien de téléversement partageable qui permet à quiconque d'envoyer des fichiers dans votre file de traitement sans compte — recueille les photos de chaque technicien et de chaque site en un seul endroit, au lieu de courir après les journaux dans tout le site. Un lien, une file, un lot.
Essayez-le sur une page de votre propre pile de journaux — aucun préréglage nécessaire, il suffit de téléverser et de nommer vos colonnes :
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Défi de lot n° 3 : que se passe-t-il lorsqu’une page est illisible
Dans un lot de centaines de pages, certaines seront tachées, d’autres auront des traces de café, et d’autres encore seront écrites d’une main que seul leur auteur pourrait déchiffrer. Un flux de travail par lots réaliste s’attend à des exceptions — il ne prétend pas que chaque page s’extrait parfaitement.
L’écriture manuscrite est la limite honnête ici. Les entrées de journal imprimées et les formulaires mixtes imprimés et manuscrits s’extraient de manière fiable, car l’IA s’appuie sur les étiquettes imprimées et interprète les valeurs manuscrites en contexte. Les lettres majuscules lisibles fonctionnent bien. L’écriture cursive, les taches importantes et les photos à très faible contraste réduisent la précision. Le chiffre de précision de 99 % cité par ImageToTable.ai s’applique aux données de tableaux imprimés ; la précision de l’écriture manuscrite dépend de la lisibilité. Quiconque promet autre chose ne vous dit pas la vérité.
Ce que le traitement par lots change, c’est la façon de gérer les exceptions. Au lieu de découvrir une mauvaise page trois mois après le déploiement d’un CMMS, vous examinez la sortie du lot avant l’importation. Le mode Révision vous permet de survoler n’importe quelle cellule extraite et de voir l’endroit exact sur le journal d’origine d’où provient la valeur — un cadre englobant dessiné sur l’image, afin que vous vérifiiez si l’IA a lu la bonne écriture, et non si vous faites confiance à l’outil en général. Un lot scanné de 500 pages qui prendrait des jours à vérifier manuellement devient une vérification ponctuelle des lignes signalées, car l’étape de vérification cible les cellules importantes plutôt que chaque frappe.
Pour les pages véritablement illisibles : reprenez-les en photo avec un meilleur éclairage, ou laissez-les hors du lot et marquez la fiche d’équipement en conséquence. Une importation honnête qui omet quelques entrées illisibles vaut mieux qu’une importation malhonnête qui les invente. Le CMMS ne fait pas la différence ; c’est l’équipement pour lequel il planifie la maintenance préventive qui la fait.
Le flux de travail par lots : du tas de journaux au fichier d’importation CMMS
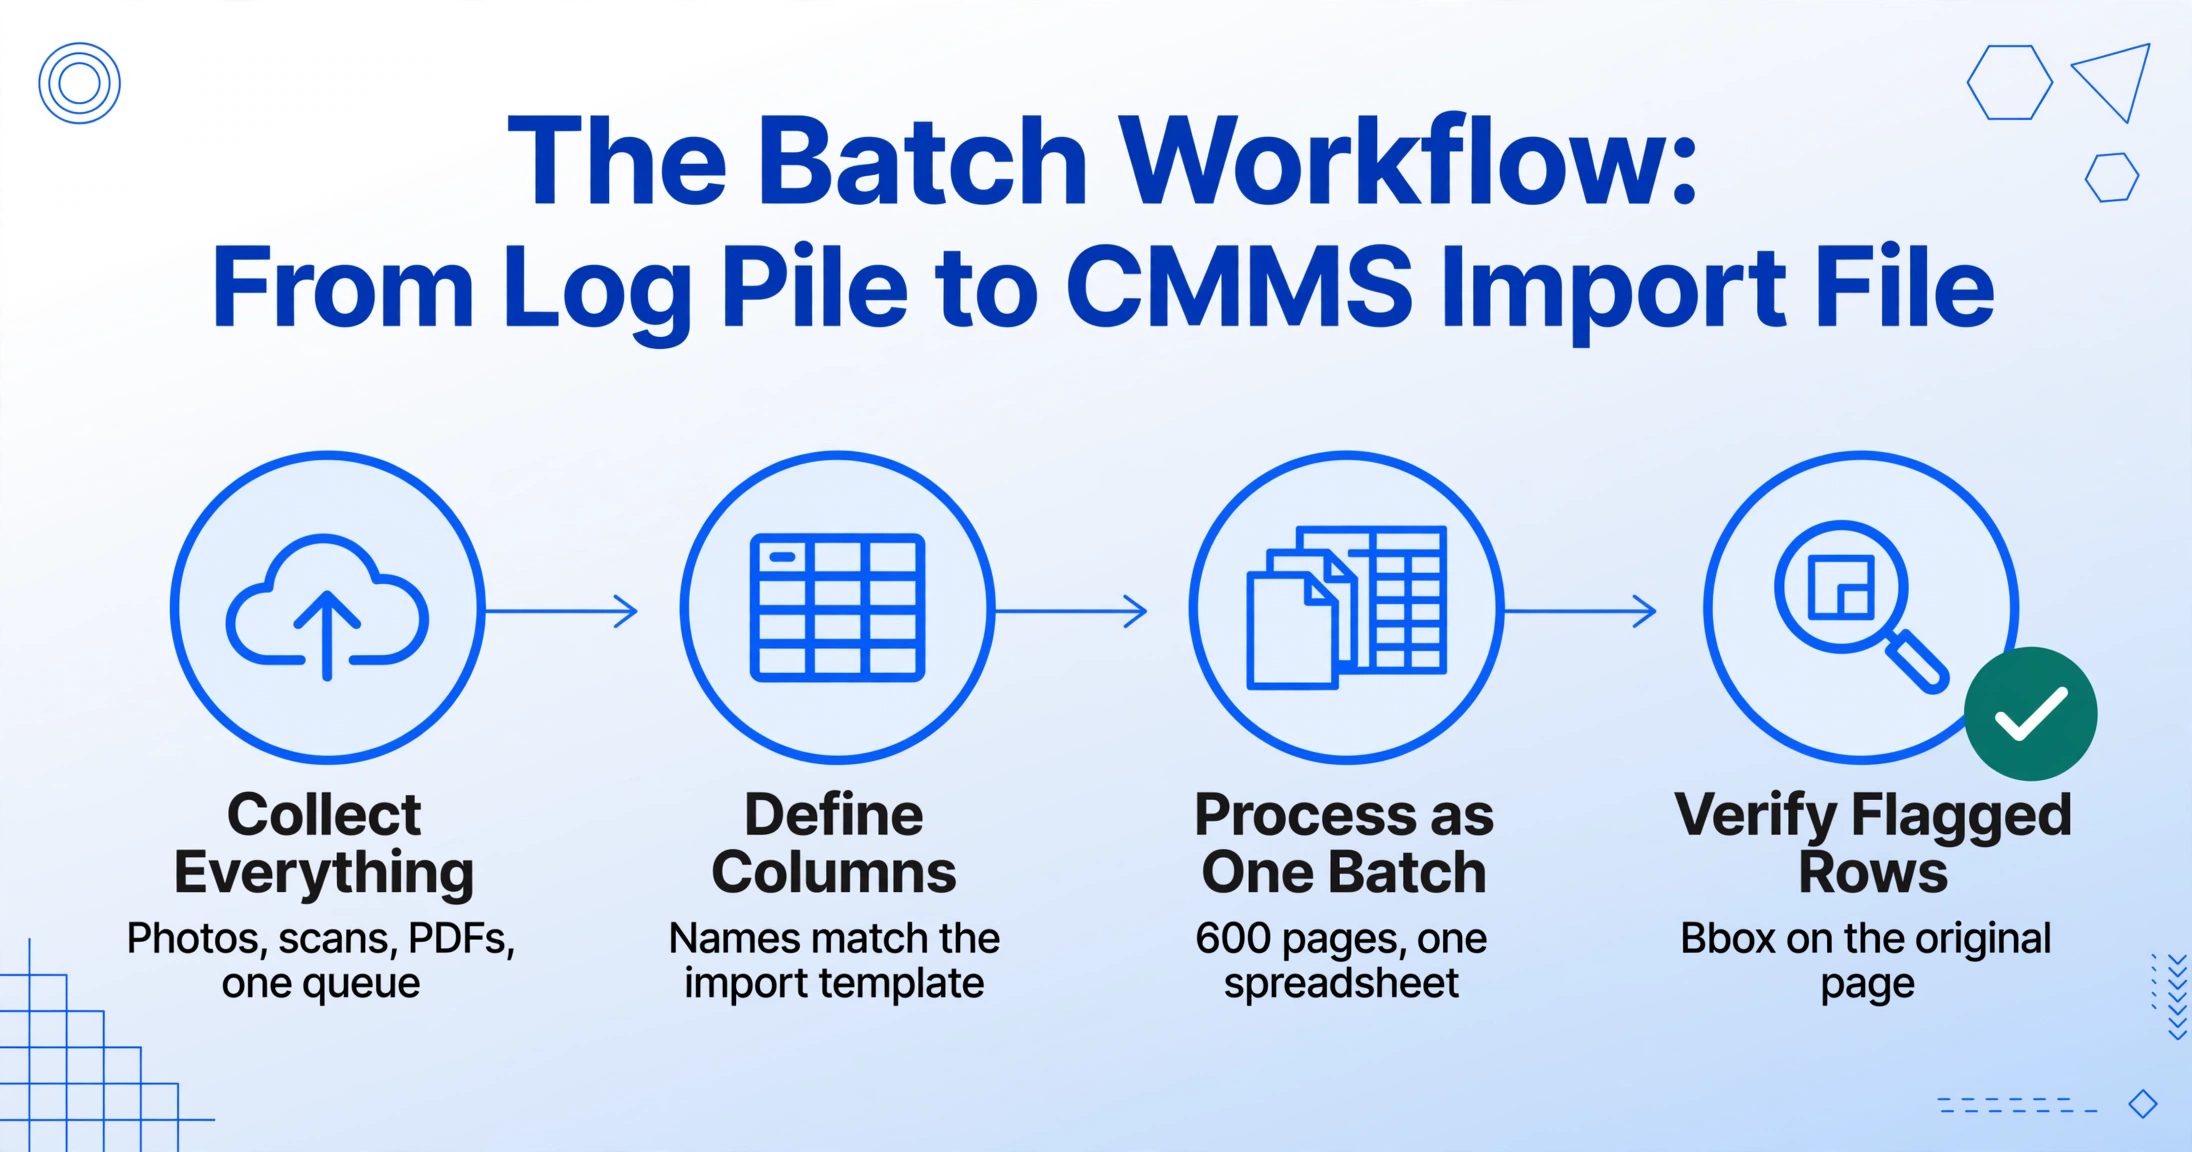
Voici le flux de travail de bout en bout qui gère les trois défis en une seule passe — conçu pour la personne dont la date de mise en service est dans trois semaines et dont les journaux sont dans un classeur.
Pour les équipes qui gèrent déjà leur suivi quotidien dans un tableur plutôt que dans une GMAO, le même lot alimente la feuille qu'elles utilisent déjà — le flux photo-vers-tableur fonctionne à l'identique lorsque la destination est un classeur de suivi plutôt qu'un fichier d'importation. Et le point de départ — transformer un seul journal en lignes structurées — est le flux de travail d'extraction étape par étape traité séparément ; cet article décrit ce qui se passe lorsque vous multipliez ce flux par des centaines de pages.
Que migrer et que conserver en archive
Vous n'avez pas besoin de numériser une décennie de journaux pour réussir la mise en service de votre CMMS. Le consensus du secteur est de 12 à 24 mois d'historique de maintenance pour les actifs critiques — et la discipline consistant à décider ce qui reste hors du système fait partie du maintien de la propreté des données qui y entrent.
La tentation de tout migrer est compréhensible — les données sont précieuses, et jeter l'historique semble être un gaspillage. Mais un CMMS rempli de 10 ans d'enregistrements incohérents est moins performant qu'un CMMS rempli de deux ans d'enregistrements propres. Les recommandations de mise en œuvre d'un CMMS suggèrent systématiquement de migrer environ les 12 à 24 derniers mois d'historique de maintenance, d'archiver le reste comme référence en lecture seule, et de prioriser les 20 % d'actifs les plus critiques en premier — la règle des 80/20 qui intègre les actifs les plus importants dans le système avec la meilleure qualité de données, au lieu d'une importation uniformément superficielle de tout.
Le traitement par lots soutient naturellement ce phasage : vous pouvez d'abord traiter les journaux des actifs critiques comme un lot propre, les vérifier, les importer, et démarrer à temps — puis traiter les actifs restants par lots lors des passes suivantes. La mise en service n'attend pas le backlog complet ; le backlog complet devient une série de lots au lieu d'un projet écrasant.
C'est aussi là que les enjeux de qualité des données se concrétisent. ISO 55001:2024, la norme certifiable pour les systèmes de gestion d'actifs, considère les informations documentées et fiables sur les actifs comme une exigence fondamentale — la révision de 2024 a renforcé l'accent sur la qualité des données et la gestion des connaissances. Le recueil des meilleures pratiques SMRP, les plus de 70 métriques standard de l'industrie de la maintenance, ne peuvent pas être calculées sans un historique structuré : pourcentage de maintenance planifiée, conformité PM, temps moyen entre pannes — chacune d'elles est une requête sur des lignes propres et cohérentes. Un historique mauvais ou manquant n'est pas seulement mauvais lors d'un audit ; il rend tout le programme de mesure incalculable.
FAQ
Combien de pages de journal de maintenance puis-je traiter en lot, de manière réaliste ?
Le traitement par lots est conçu pour le volume — téléversez des centaines de pages en un seul lot et l'IA les traite ensemble en un seul tableau fusionné. La limite pratique se situe côté sortie : la plupart des imports CMMS plafonnent à 2 000 lignes par téléversement (Limble et UpKeep le font tous deux), donc pour de très gros arriérés, vous divisez l'export en lots sous la limite. Un arriéré de deux ans qui prendrait une semaine à un commis à saisir devient un après-midi de traitement et de vérification.
L'extraction lira-t-elle nos journaux manuscrits avec assez de précision pour un CMMS ?
Une écriture lisible s'extrait de manière fiable — les lettres en capitales et les caractères séparés surtout, et les formulaires mixtes imprimés et manuscrits fonctionnent bien car l'IA s'ancre sur les étiquettes imprimées et lit les valeurs en contexte. L'écriture cursive, les taches importantes et les photos à faible contraste réduisent la précision. C'est pourquoi l'étape de vérification existe : vous examinez les cellules signalées par rapport à la page d'origine plutôt que de faire confiance aveuglément à chaque valeur. Pour un système soumis à la conformité comme un CMMS, cette vérification est le bon compromis — c'est bien plus rapide que la transcription et cela attrape les erreurs qui comptent.
Notre CMMS a son propre modèle d'import. La feuille de calcul extraite lui correspond-elle ?
Oui, car vous contrôlez les noms de colonnes. L'extraction de colonnes personnalisées utilise les noms que vous saisissez comme en-têtes de sortie, vous nommez donc vos colonnes pour correspondre au modèle d'import du CMMS — ID d'actif, Date d'achèvement, Description de la tâche, etc. La normalisation des dates et des nombres se fait pendant l'extraction, donc les lignes sortent dans le format attendu par l'import plutôt que dans celui utilisé par le journal.
Nos journaux sont un mélange de formulaires imprimés, de pages manuscrites et d'anciennes feuilles de calcul. Faut-il un processus différent pour chacun ?
Non. Comme l'extraction est pilotée par les colonnes plutôt que par les modèles, les mêmes définitions de colonnes fonctionnent pour les listes de contrôle imprimées, les pages de journal manuscrites et les photos de téléphone. Les anciennes feuilles de calcul numériques que vous possédez déjà peuvent être exportées en PDF et incluses dans le même lot, ce qui normalise également leur formatage dans la même structure de sortie.
Comment éviter les doublons d'actifs après l'importation ?
Deux niveaux : d'abord, ajoutez une colonne inférée lors de l'extraction qui standardise les identifiants d'actifs — l'IA lit « AHU-01 », « Air Handler 1 » et « air handling unit #1 » et génère un code cohérent par ligne. Ensuite, exécutez un tableau croisé dynamique rapide sur la colonne ID d'actif extraite avant l'importation pour confirmer que chaque ligne correspond à un actif existant. Les deux étapes prennent quelques minutes et évitent le problème des actifs fantômes qui corrompt l'historique de maintenance à la source.
Est-ce que cela remplace le CMMS lui-même ?
Non — cela alimente le CMMS. L'extraction convertit les journaux historiques en feuille de calcul structurée et propre que toute importation CMMS exige. Cela résout l'étape que les fournisseurs vous laissent : transformer des années de papier et de photos en lignes prêtes à importer. Une fois l'historique intégré, le CMMS prend en charge la planification, les ordres de travail et les rapports exactement comme prévu.
L'idée à garder pour votre migration est la suivante : une GMAO ne vaut que ce que vaut l'historique que vous lui donnez, et l'historique ne vaut que ce que vaut le lot qui l'a numérisé. Les limites d'importation et les modèles fournis par votre fournisseur ne sont pas la partie difficile — la partie difficile, c'est la pile de journaux dans le classeur, et c'est précisément cette partie qu'un flux de travail par lots est conçu pour éliminer.