すべてのCMMSの前にあるバッチジョブ:
何年分もの保守ログの処理
CMMS移行のボトルネックは、ほとんどの場合ソフトウェアではありません。ベンダーは1週間でシステムをセットアップし、資産階層は半日で読み込まれます。本稼働を遅らせるのは、ログブック、バインダー、スマホの写真に眠っている保守履歴の山です。新しいシステムが1件の作業指示書を信頼して処理できるようになる前に、これをスプレッドシートに変換しなければなりません。CMMS導入ガイドはどこも、この山を「データを収集、レビュー、クリーンアップする」という前提で扱いますが、チームが実際に立ち往生する疑問には答えていません。つまり、何百ページもの紙の記録を、具体的にどうやってインポート可能な行に変換するのか、ということです。
重要なポイント
- 2年分の保守バックログは、CMMSのインポートボタンが機能する前に25~40時間のタイピングが必要です。これは、すべての移行計画がうっかりゼロと見積もっている、丸々1週間分の作業です。
- 手動での転記は時間がかかるだけでなく、「AHU-01」と「Air Handler 1」が別々の2台の機械として登録され、最初のインポートからCMMSを汚染するゴーストアセットを生み出します。
- バッチ処理では、列を一度定義するだけで、すべてのログブックページ、スマホの写真、スキャンしたフォームを同じルールで読み取ります。18倍高速で、重複排除も同じパスで行われます。
移行の計算:何年分のログと本稼働日の関係
CMMSの本稼働日は締め切りですが、その日を守れるかどうかを左右するのは、システム稼働前に構造化しなければならない過去のログの山です。その作業はページ数と時間で測られるものであり、ほとんど誰も予算を組んでいません。
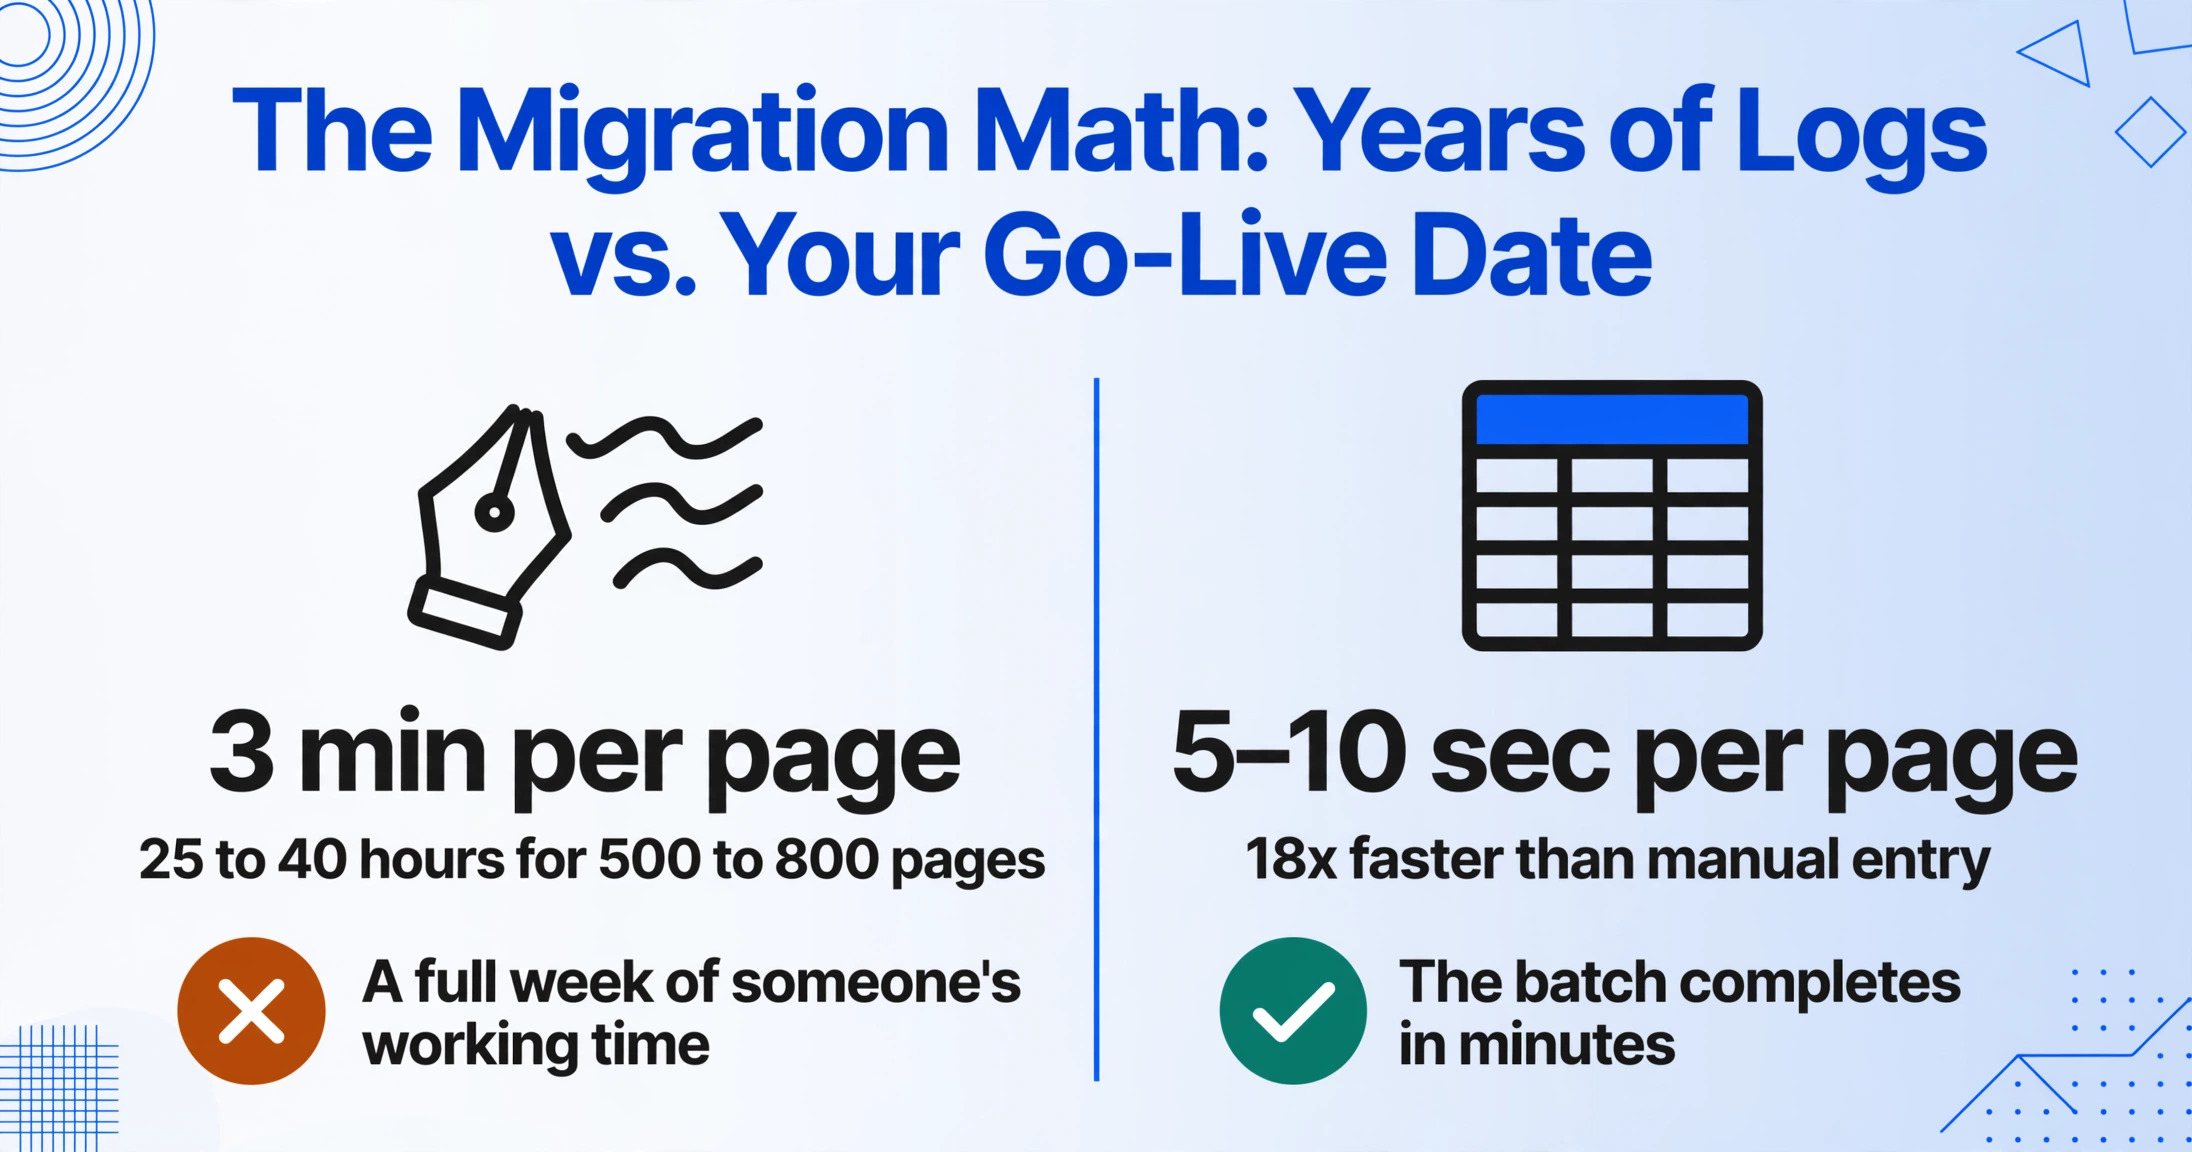
小規模な施設で計算してみましょう。30台の設備があり、それぞれに3年分のサービス点検・検査のログブックがあるとします。それはおよそ500〜800ページのログになり、各ページには設備名、日付、作業内容、メーター時間、使用部品、技術者の手書きメモが含まれます。手入力に実際にかかる1ページあたり3分 — 日付、資産ID、作業内容、メモを入力し、手書きを解読する時間 — を考えると、1行でもインポートする前に、1人で25〜40時間の純粋なデータ入力が必要になります。それは土曜日1日では済みません。1週間分の労働時間であり、しかもログが判読できるという最良のケースです。
その入力を誤った場合のリスクは、ガートナーが、低品質なデータにより組織は平均して年間少なくとも$12.9 millionの損失を被ると推定していることからも明らかです。保守部門にとってその仕組みは単純です。資産名の綴り間違いで1台の機械が2つのレコードに分かれ、日付の誤りでPM間隔がずれ、CMMSに取り込まれた不良行は行がないより悪い結果をもたらします。なぜならシステムが誤ったデータを事実として報告するからです。あらゆるCMMSガイドが求めるクレンジングは抽象的なベストプラクティスではなく、何百ページもの手書き転記の直接的な結果なのです。
だからこそ、保守管理に関する広く共有されたr/manufacturingスレッドで投稿者が抱いた疑問は、ほとんどの施設がCMMS導入前に直面する疑問なのです:「みんな本当にどこかで完璧なログをつけているのでしょうか?いくつかソフトウェアを知っていますが、彼らの用途には高すぎて重すぎるように思えます。それとも皆、Excel+紙+テキストの組み合わせでやっていて、うまくいくことを願っているだけなのでしょうか?」 多くのチームが気づく答えはこうです。ログは存在し、ソフトウェアは手頃で、その間を埋めるのがデータ入力なのです。
すべてのCMMSガイドが飛ばすステップ
最新のCMMSのインポートドキュメントを読むと、同じパターンに気づくでしょう。データがすでにスプレッドシートにあれば、ツールはインポートを速く簡単にしてくれます。難しい部分、つまり何年分もの非構造化記録からそのスプレッドシートを作り出すことは、製品の範囲外なのです。
インポート制限はこれを具体的に示しています。Limbleは一括インポートあたり2,000件の完了タスクを許可しており、CSVまたはXLSXファイルからです。UpKeepは作業指示書のインポートをアップロードあたり2,000行に制限しています。FiixとMaintainXはどちらも、特定の日付形式とフィールドマッピングを備えたCSVテンプレートを必要とします。どれもログブックの写真を読み取り、手書きの「3つのポンプベアリングすべてにグリースを塗布」を解析して、準拠した日付形式の行に変換することはできません。その変換ステップは完全にあなた次第です。そして、それはすべてのCMMSチュートリアルが飛ばす唯一のステップです。ベンダーはあなたがすでにそれを済ませていると想定しているからです。
実務者が実際にメンテナンスを実行しているツール — IBM Maximo、SAP PM、Fiix、UpKeep、Limble、eMaint、Cryotos — はすべて、列マッピング付きのバルクCSV/XLSXインポートを受け入れます。制限や形式は異なりますが、共通の要件があります。それは、クリーンで一貫性のある構造化された行です。つまり、CMMS移行の実際の作業はソフトウェアを選ぶことではありません。インポートが期待するスプレッドシートに履歴ログをバッチ処理することです。
それがまさにバッチ抽出が行うことです。ログの山を、CMMSが目にする前に構造化された行に変換し、ベンダーが残したギャップを埋めます。この記事の残りでは、一度に数百件のログを処理するときにのみ現れる3つの課題 — 命名規則、マージ、例外 — と、そのすべてを処理するワークフローについて説明します。
バッチチャレンジ #1: 何十年分ものログにわたる命名規則
CMMSインポートは、ログにマシンの名前が2通り書かれていると、1台のマシンに対して2つの資産を作成してしまいます。バッチ処理の最初の課題は、一貫性を念頭に置かずに書かれた記録全体に、命名の一貫性を強制することです。
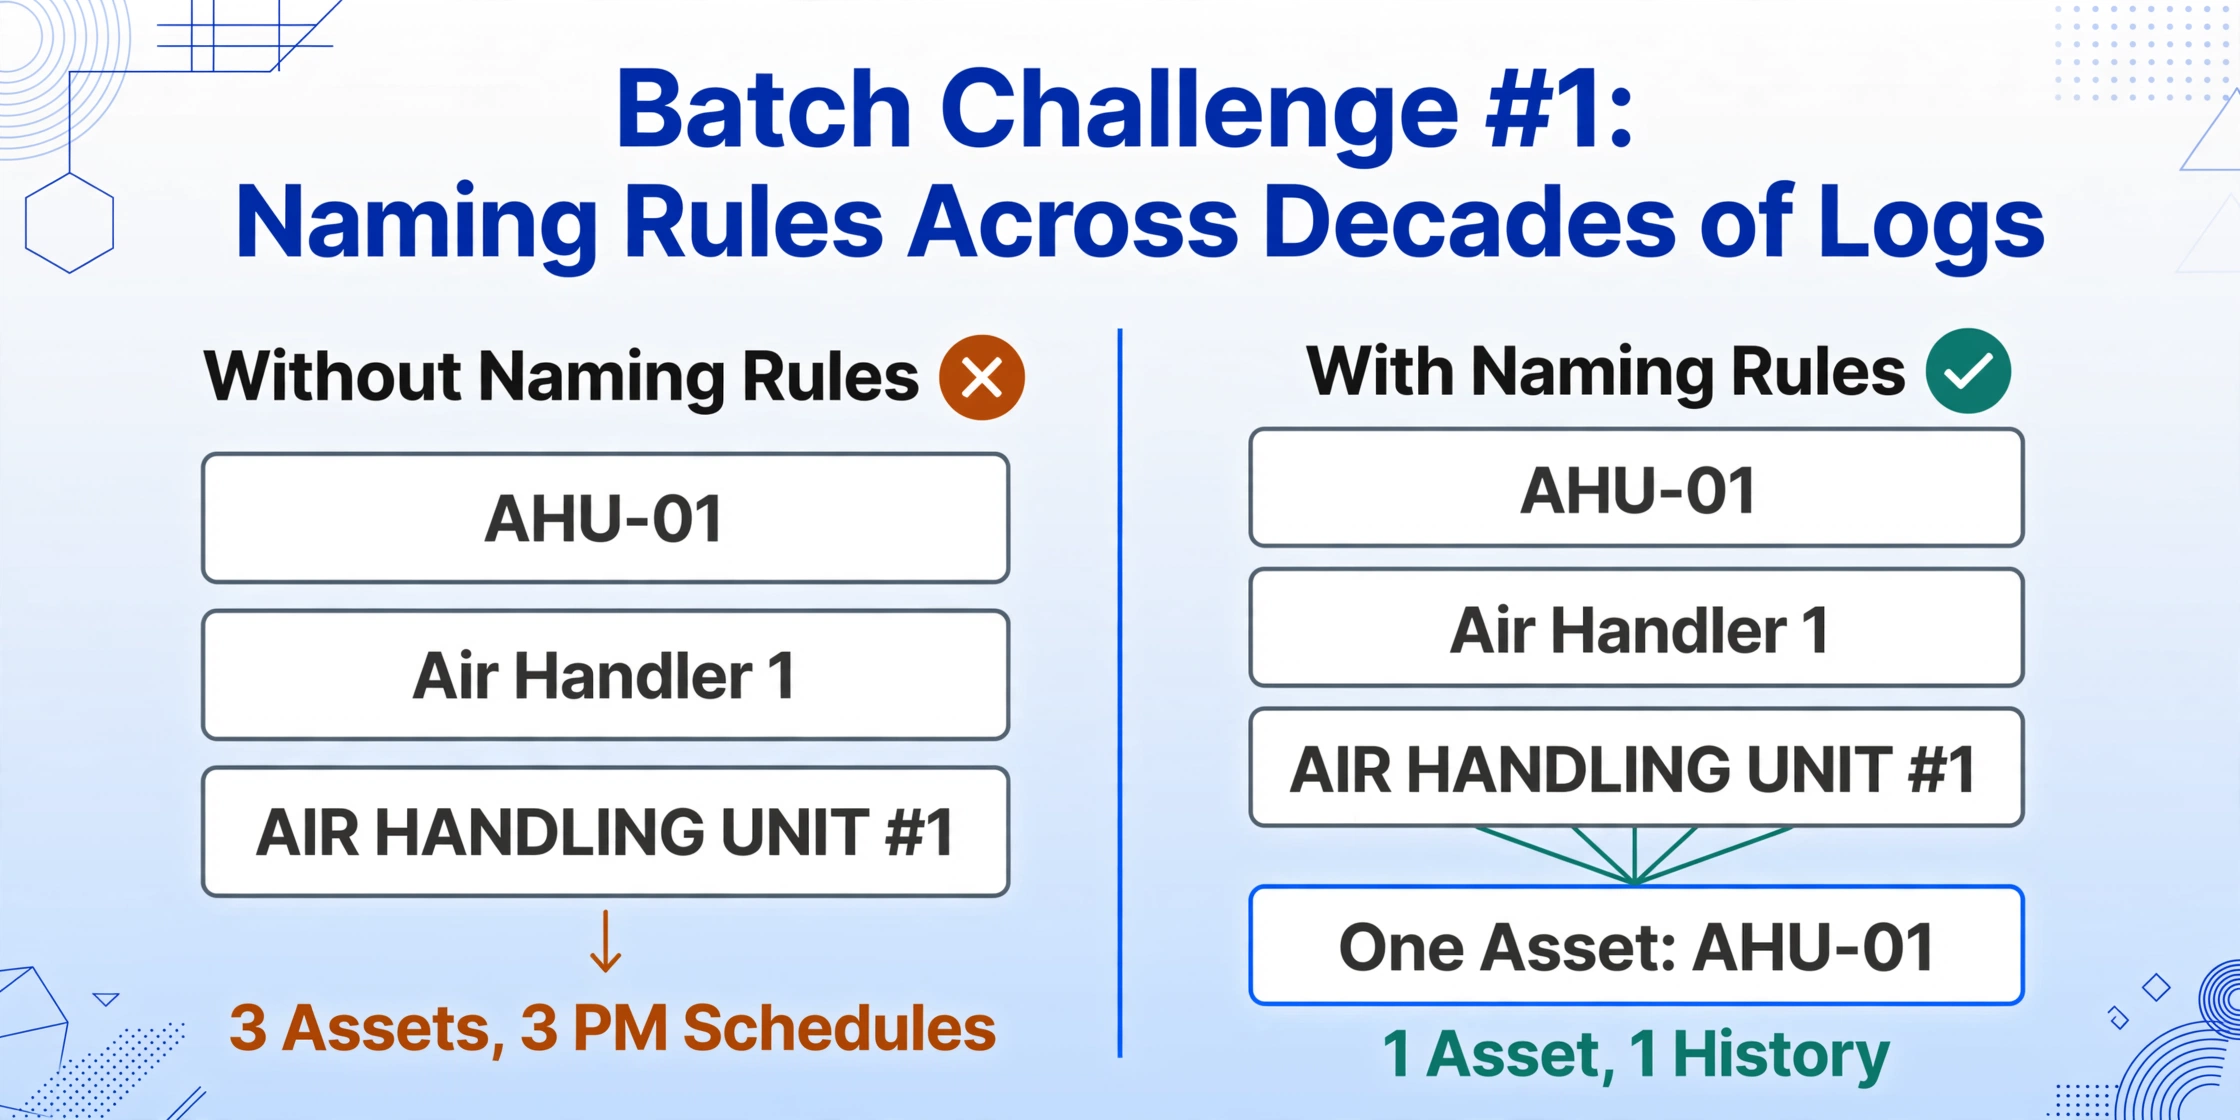
これは典型的な「ゴーストアセット」問題です。ある技術者がログブックに「AHU-01」と書き、別の技術者は「Air Handler 1」と書きます。ベンダーのPMチェックリストには「AIR HANDLING UNIT #1」とあります。これらはすべて同じ屋上ユニットですが、CMMSインポートはそれらを3つの資産として扱います。つまり、3つの保守履歴、3つのPMスケジュール、3つのスペアパーツ記録が作成されます。この問題について論じているHVAC移行ガイドは、「AHU-01」と「Air Handler 1」は同じ資産であり、インポート前に重複排除する必要があると警告しています。なぜなら、一貫した命名がまさにこの問題を防ぐからです。これは、クリーンなインポートと、最初から間違った状態で始まるシステムの違いです。
バッチ処理は、命名規則を低コストで強制できる場所です。ルールを一度定義すれば、山積みのすべてのページに適用できるからです。抽出ワークフローでは、「資産ID」「サービス日付」「実施タスク」「使用部品」など、必要な列に名前を付けます。AIは、ページ上の固定位置に一致させるのではなく、フィールドの意味を理解することで、各ログ内の各値を特定します。これがカスタム列抽出であり、フォーマット非依存です。同じ列定義が、印刷されたPMチェックリスト、手書きのログブックページ、機器タグの電話写真にも機能します。抽出がレイアウトではなく意味を読み取るからです。
命名問題に特化して言えば、推論列が抽出中に正規化を行います。「資産ID(形式に標準化: AHU-01、PUMP-02、CONV-03)」のような列を追加すると、AIは各ページに表示される識別子(「Air Handler 1」「air handling unit #1」「AHU-1」など)を読み取り、すべての行で標準化されたコードを出力します。CMMSガイドが手動のクリーンアップ手順として説明している重複排除は、データがインポートファイルに到達する前に、抽出と同じパスで実行されます。
施設が規制産業にある場合、ここで整合すべき標準があります。ISO 14224は、信頼性および保守データの収集と交換に関する国際標準であり、石油・ガス部門向けに書かれましたが、その中核パターンはどこにでも適用できます。最小データセットを定義し、標準化された形式で収集し、故障モードをその原因と明確に区別して記録します。控えめな施設でも、その規律(固定資産コード、標準化されたタスクタイプ、一貫した日付フィールド)を借用し、各技術者がたまたま一貫して書くことを期待するのではなく、バッチレベルでそれを強制できます。
バッチチャレンジ #2: 手書きページ、写真、古いスプレッドシートを1つのテーブルに統合
規模が大きくなって初めて表面化する2つ目の問題は、フォーマットの混在です。3年分のバックログが整然とした単一フォーマットであることはほとんどありません。バインダーに綴じられた印刷済みの予防保全チェックリスト、手書きの記入があるスパイラルノート、ログ記録のルールができる前に撮影されたスマホ写真のフォルダ、そして以前の管理者が作成した古いExcelファイルなどが混在しています。単一ドキュメント用ツールでは、フォーマットごとに異なる処理を強いられます。バッチ処理とは、それらすべてをまとめてアップロードし、結果を1つのテーブルに統合するためのワークフローです — バインダー、ノート、サイトを問わず、すべてのログエントリを1行として、ソースフォーマットに関係なく統合します。
統合が機能するのは、抽出がテンプレート駆動ではなく列駆動だからです。列を一度定義するだけで — 資産ID、日付、タスク、メーター時間、技術者、使用部品、所見 — AIはすべてのページを同じ定義に照らして読み取ります。手書きのログブックも印刷済みの予防保全チェックリストも、同一構造の行を生成するため、CMMSインポートテンプレートが要求する形式に正確に一致します。出力は単一のスプレッドシートにまとめられ、各行はインポートが期待する形にすでに整っています。
複数の技術者や複数サイトでの収集では、そもそもページを集めることが実際的な問題になります。コレクションリンク — アカウントなしで誰でもファイルを処理キューにプッシュできる共有可能なアップロードリンク — を使用すれば、施設内のログブックを追いかける代わりに、すべての技術者とすべてのサイトからの写真を1か所に集められます。1つのリンク、1つのキュー、1つのバッチです。
自分のログの山から1ページを試してみてください — プリセットは不要で、アップロードして列に名前を付けるだけです:
ファイルは安全に処理され、保存されません。
バッチチャレンジ #3: ページが読み取れない場合の対処
何百ページもあるバッチの中には、汚れていたり、コーヒーで染みていたり、書いた本人にしか読めない筆跡のページもあるものです。現実的なバッチワークフローは例外を想定しています — すべてのページが完璧に抽出できるとは考えていません。
ここで正直に認めるべき限界は手書き文字です。印刷されたログブックの記入項目や、印刷と手書きが混在するフォームは、AIが印刷されたラベルを基準に手書きの値を文脈から解釈するため、確実に抽出できます。読みやすいブロック体は良好に機能します。筆記体、ひどい汚れ、コントラストが非常に低い写真は精度を下げます。ImageToTable.aiが挙げる99%の精度は印刷された表データに適用されるもので、手書きの精度は読みやすさに依存します。それ以外を約束する人は、あなたに正直ではありません。
バッチ処理が変えるのは、例外への対処方法です。CMMS導入の3か月後に不良ページを発見する代わりに、インポート前にバッチ出力をレビューします。レビューモードでは、抽出された任意のセルにホバーすると、元のログでその値が取得された正確な位置を確認できます — 画像上に描画されたバウンディングボックスで、AIが正しい手書き文字を読み取ったかを確認できるのです。手作業での検証に数日かかる500ページのスキャンバッチも、フラグが付いた行のスポットチェックで済みます。検証ステップがすべてのキーストロークではなく、重要なセルを対象にするからです。
本当に読み取れないページについては、照明を改善して再撮影するか、バッチから除外して設備記録にその旨を記載してください。読み取れない項目をいくつか省略した正直なインポートは、捏造した不誠実なインポートに勝ります。CMMSはその違いを認識しませんが、予防保全のスケジュール対象となる設備は認識します。
バッチワークフロー: ログの山からCMMSインポートファイルへ
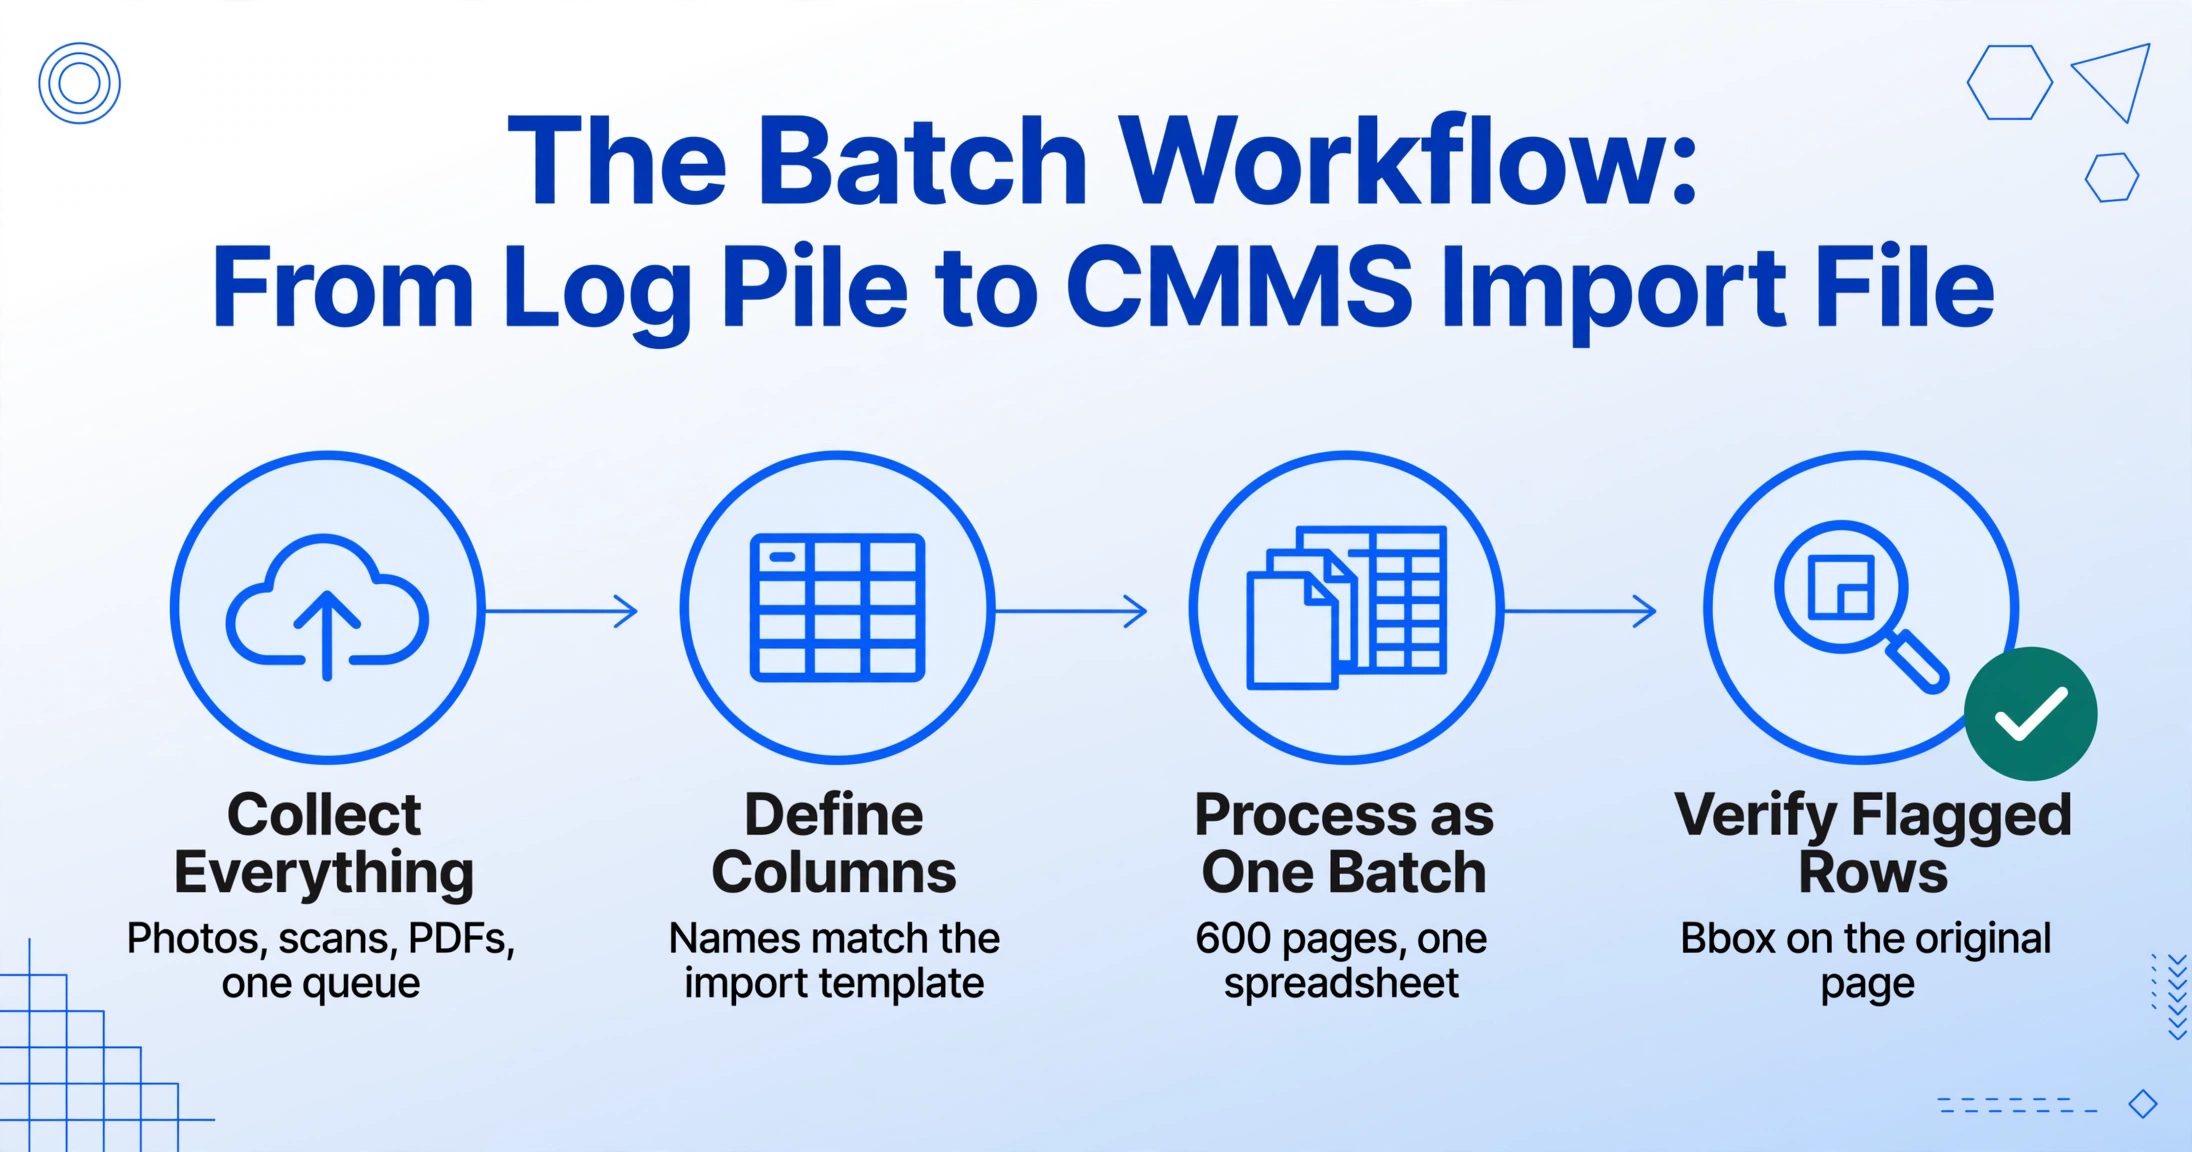
ここに、3つのチャレンジすべてを1回のパスで処理するエンドツーエンドのワークフローを示します — 本稼働まで3週間で、ログがバインダーに綴じられている人向けに設計されています。
日々の追跡をCMMSではなくスプレッドシートで行っているチームにとっては、同じバッチが既存のシートにそのまま反映されます。写真からスプレッドシートへのパイプラインは、宛先がインポートファイルではなく追跡用ワークブックの場合も同様に機能します。そして出発点である「単一のログを構造化された行に変換する」ことは、ステップバイステップの抽出ワークフローで別途説明しています。この記事は、そのワークフローを数百ページに適用した場合の内容です。
移行するものとアーカイブするもの
CMMSの本稼働を成功させるために、10年分のログをデジタル化する必要はありません。業界のコンセンサスは、重要資産の保守履歴は12〜24ヶ月分で十分であり、システムに入れないものを決める規律こそが、入れるデータをクリーンに保つことの一部です。
すべてを移行したいという誘惑は理解できます。データは貴重であり、履歴を捨てるのは無駄に感じられます。しかし、10年分の一貫性のない記録で満たされたCMMSは、2年分のクリーンな記録で満たされたものよりも性能が劣ります。CMMS導入ガイダンスは一貫して、保守履歴の直近12〜24ヶ月分を移行し、残りは読み取り専用の参照としてアーカイブし、最も重要な20%の資産を優先的に移行することを推奨しています。これは80/20のルールで、最も重要な資産を最高のデータ品質でシステムに取り込む一方で、すべてを均一に浅くインポートすることを避けます。
バッチ処理はこの段階的アプローチを自然にサポートします。まず重要資産のログブックをクリーンなバッチとして実行し、検証してインポートし、予定通りに本稼働できます。その後、残りの資産をフォローアップのパスでバッチ処理します。本稼働は完全なバックログを待つ必要はありません。バックログ全体は、一つの圧倒的なプロジェクトではなく、一連のバッチになります。
ここでデータ品質の重要性が明確になります。ISO 55001:2024は、資産管理システムの認証可能な規格であり、文書化され信頼できる資産情報を中核要件として扱います。2024年の改訂では、データ品質とナレッジマネジメントへの重点が強化されました。SMRPベストプラクティス集は、保守業界の70以上の標準メトリクスを提供しますが、構造化された履歴がなければ計算できません。計画保全率、PMコンプライアンス、平均故障間隔など、すべてがクリーンで一貫性のある行に対するクエリです。不良または欠落した履歴は、監査で見栄えが悪いだけでなく、測定プログラム全体を計算不能にします。
FAQ
保守ログのページは、一度に現実的に何ページまでバッチ処理できますか?
バッチ処理は大量データ向けに設計されています。一度に数百ページをアップロードすると、AIがそれらをまとめて1つの結合テーブルに処理します。実際の上限は出力側にあります。ほとんどのCMMSインポートはアップロードあたり2,000行が上限です(LimbleとUpKeepの両方がそう)。そのため、非常に大きなバックログでは、上限未満のチャンクに分割してエクスポートします。事務員が1週間かけて入力する2年分のバックログが、1回の午後の処理とレビューで完了します。
手書きのログはCMMSに十分な精度で読み取れますか?
読みやすい手書きは確実に抽出できます。特にブロック体や分離された文字は精度が高く、印刷と手書きが混在したフォームも、AIが印刷されたラベルを基準に文脈から値を読み取るため、うまく機能します。筆記体、ひどい汚れ、コントラストの低い写真は精度を下げます。そのため検証ステップが存在します。フラグが付いたセルを元のページと照合して確認するので、すべての値を盲目的に信頼する必要はありません。CMMSのようなコンプライアンス重視のシステムでは、この検証は適切なトレードオフです。手作業の転記よりはるかに速く、重要なエラーを検出できます。
当社のCMMSには独自のインポートテンプレートがあります。抽出されたスプレッドシートはそれに一致しますか?
はい、列名を自分で指定できるからです。カスタム列抽出では、入力した名前が出力ヘッダーになります。CMMSのインポートテンプレートに合わせて列名を指定してください。たとえば、資産ID、完了日、タスク説明などです。日付と数値の標準化は抽出中に行われるため、ログブックで使用されていた形式ではなく、インポートが期待する形式で行が出力されます。
当社のログは、印刷フォーム、手書きページ、古いスプレッドシートが混在しています。それぞれに異なるプロセスが必要ですか?
いいえ。抽出はテンプレート駆動ではなく列駆動であるため、同じ列定義が印刷チェックリスト、手書きのログブックページ、スマートフォンの写真のすべてで機能します。既存のデジタルスプレッドシートはPDFとしてエクスポートして同じバッチに含めることができ、それによりフォーマットも同じ出力構造に正規化されます。
インポート後に重複した資産を避けるにはどうすればよいですか?
2つの対策があります。1つ目は、抽出時に推論列を追加して資産識別子を標準化することです。AIが「AHU-01」「Air Handler 1」「air handling unit #1」を読み取り、行ごとに1つの一貫したコードを出力します。2つ目は、インポート前に抽出した資産ID列で簡単なピボットを実行し、すべての行が既存の資産にマッピングされていることを確認することです。どちらも数分で完了し、メンテナンス履歴を根本から壊すゴーストアセット問題を防ぎます。
これはCMMS自体を置き換えるものですか?
いいえ、CMMSにデータを供給するものです。抽出により、過去のログがCMMSのインポートに必要な構造化されたクリーンなスプレッドシートに変換されます。ベンダーがユーザーに任せているステップ、つまり何年分もの紙と写真をインポート可能な行に変換する作業を解決します。履歴が取り込まれた後は、CMMSが設計どおりにスケジュール、作業指示書、レポートを管理します。
移行に臨む際に心に留めておくべき洞察はこれです:CMMSは、与えられた履歴と同じくらいの価値しかなく、その履歴は、それをデジタル化したバッチと同じくらいの価値しかありません。 ベンダーが提供するインポート制限やテンプレートは難しい部分ではありません。難しいのはバインダーに眠っているログの山であり、まさにその部分こそ、バッチワークフローが排除するために作られたものです。