1か月分の手書きタイムシートを
一括で給与計算用に変換
米国給与協会によると、紙のタイムトラッキングに依存している組織では、手作業による転記ミスが給与全体の1%から8%を占めると報告されています。Davis-Baconプロジェクトで法定賃金を得ている50人の現場作業員チームの場合、この範囲は給与期間ごとに数千ドルに相当します。さらに、手書きの解読やADPやQuickBooksへのデータ再入力に費やす時間も加わります。
バッチ処理のタイムシート処理が単一ドキュメント抽出と異なる問題である理由
1枚の手書きタイムシートからデータを抽出することは、認識の課題です。40枚からデータを抽出すること — 異なる現場作業員から収集され、異なるフォームに記入され、異なる筆跡と様々な記入度合いがある — は一貫性、統合、検証の課題です。バッチ処理のボトルネックは手書きの読み取りではありません。最終的なスプレッドシートの40行すべてが実際に揃っていることを確認し、給与ソフトウェアがインポートを拒否しないようにすることです。
2018年のConstrucTech調査によると、建設会社の約40%が依然として紙ベースの勤怠管理システムを使用しています。Causewayによる英国の調査では、建設会社に限定するとその数は約60%に近いことが判明しました。これらは紙を望んでいる会社ではなく、現場の状況によりデジタル打刻が実用的でない会社です:遠隔の作業現場では携帯電話の電波がなく、作業員は毎日複数の場所を巡回し、下請け業者は会社のソフトウェアシステムに登録されていません。紙のタイムシートは存在します。問題は月末にそれらをどう処理するかです。
単一ドキュメント抽出は「AIがこの1枚を読めるか?」と問います。バッチ処理は「AIが、ADPのインポートパーサーが17行目を日付形式の不一致で、23行目を残業列が数値を期待しているのに空白であることで拒否しないスプレッドシートを生成できるか?」と問います。これらは根本的に異なるエンジニアリング上の問題です。
バッチ処理の手書きタイムシートを特に困難にする3つの問題
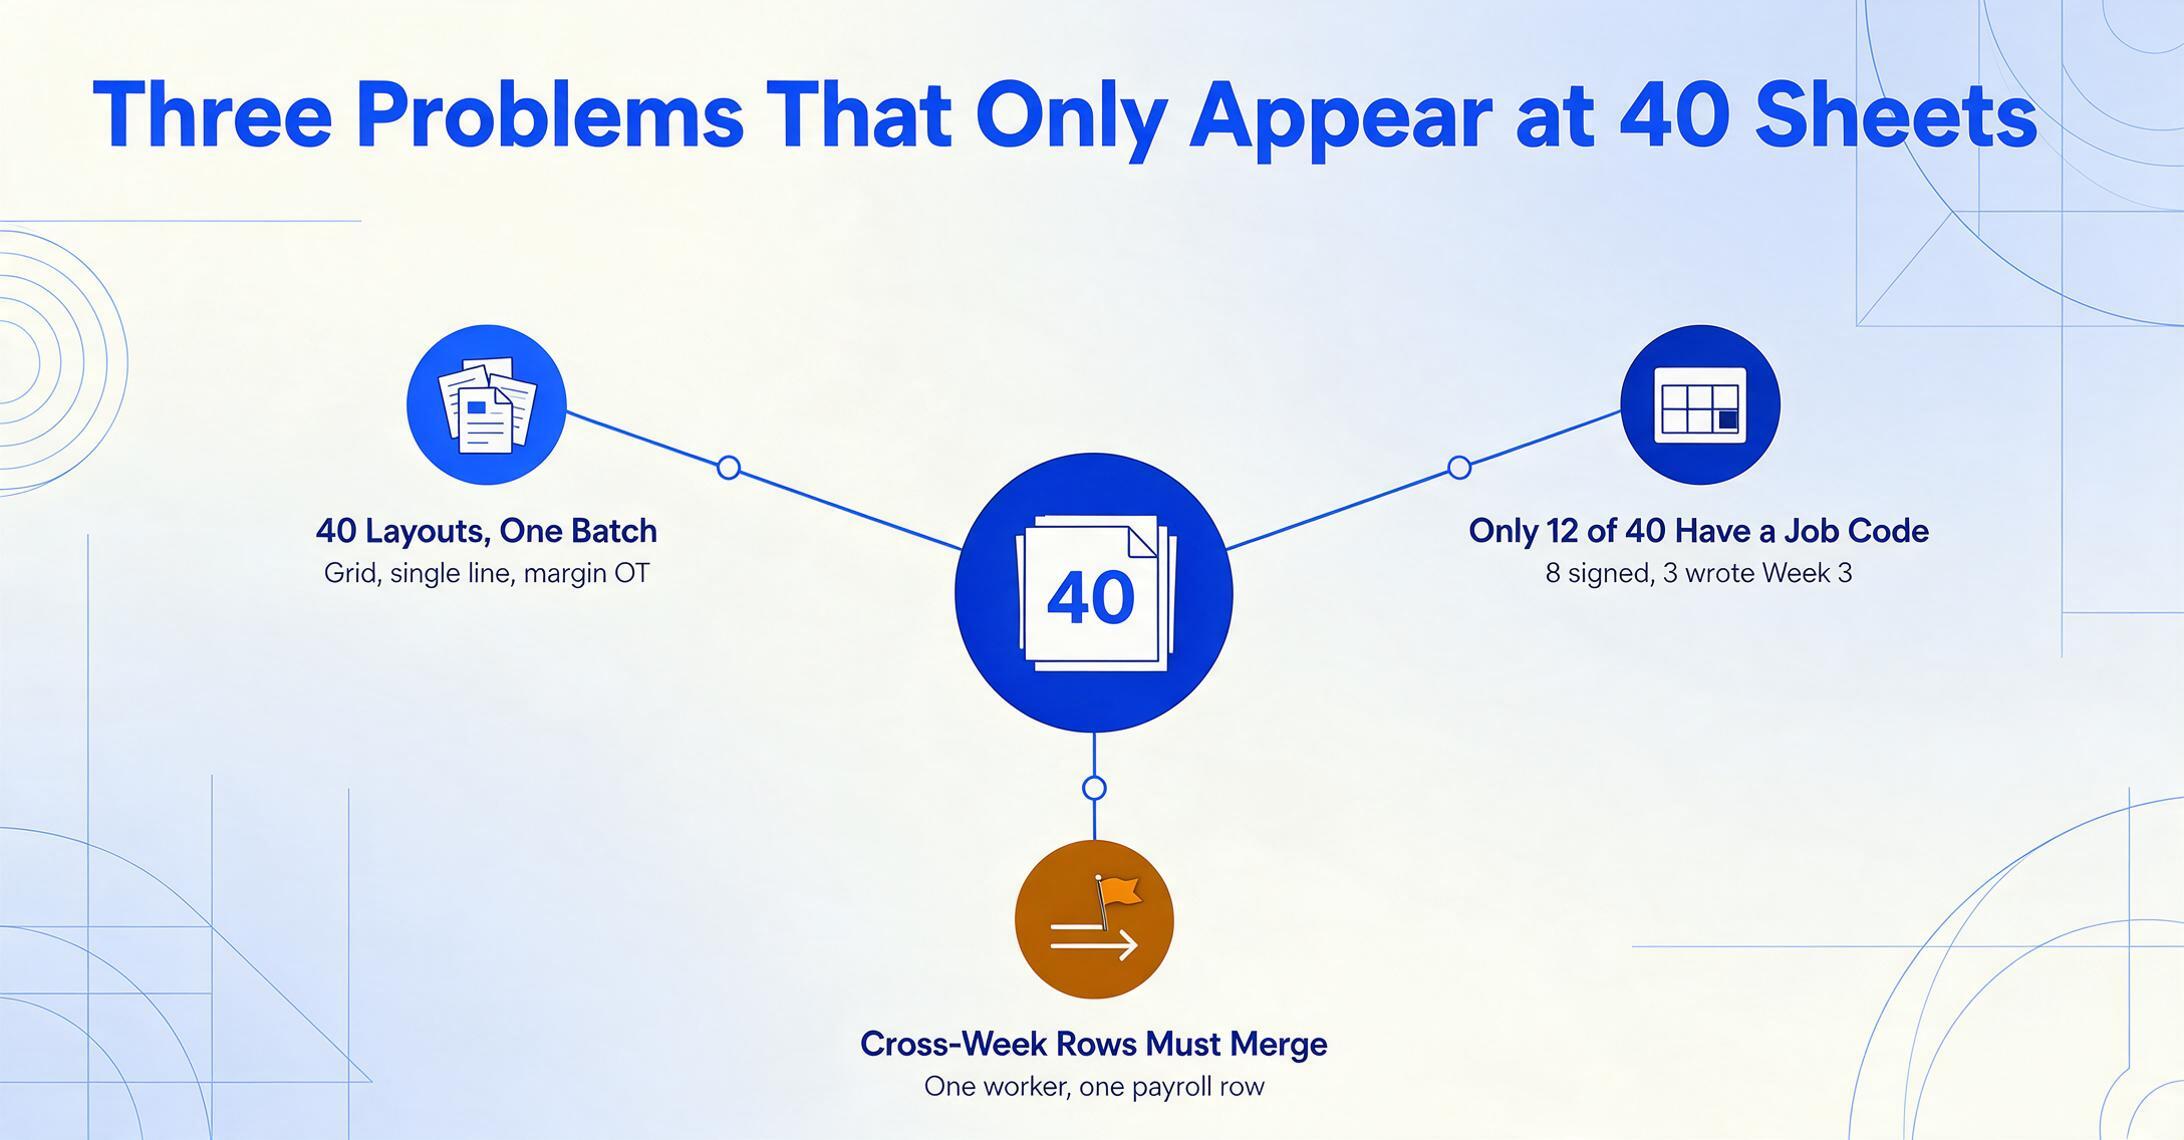
1枚のタイムシートを処理する場合、すべてのフィールドを手動で目視確認できます。月次給与処理の40枚のシートでは、単一ドキュメントのワークフローでは決して発生しない3つの構造的な問題が浮上します:
1. 作業者や週ごとにフォーマットが不統一
現場作業員Aは月曜〜日曜の列と日次合計があるグリッドに時間を記入します。作業員Bは「月8 火7.5 水8 木休 金6」と1行にまとめて書きます。作業員Cは会社指定の印刷フォームを使いますが、残業用の列がないため余白に残業時間を書きます。どのフォーマットも「間違い」ではありません。しかし、テンプレートベースのOCRツールで同じバッチ内の3種類すべてを処理しようとするところで、ほとんどのシステムが破綻します。テンプレートベースのツールは各フォーマットのフィールド位置を事前に定義する必要があり、バッチ自動化の目的を損なうことになります。
2. シートによって存在するフィールドが異なる
40枚のタイムシートのうち、12枚には作業コード列があり、8枚には承認済みの上司サイン欄があり、3枚には日付がなく週番号(「第3週」)だけが書かれています。抽出ワークフローがすべてのシートにすべてのフィールドがある前提で動くと、給与ソフトがエラーと解釈する欠落のあるスプレッドシートが生成されます。EYの2022年HR処理リスク&コスト調査によると、平均的な組織は給与期間ごとに15件の修正を行っており、その大半の根本原因はフィールドの欠落や不統一です。
3. 週をまたぐデータ統合が給与の見えないエラーを生む
最も危険なバッチエラーは、目に見える抽出失敗ではなく、気づかない統合エラーです。作業員が週の途中で現場を変更したため、同じ給与期間に2枚の別々のタイムシートを提出した場合、両方のシートの抽出は完璧に機能します。しかし、給与スプレッドシートに統合すると、その作業員の時間が異なる作業コードで2行に表示されます。給与ソフトがこれらを別々にインポートすると、残業計算が誤ります。FLSAの残業は1週間の全現場の合計時間に基づくものであり、現場ごとの合計ではないからです。これはフォーマットの問題ではなく、コンプライアンス上の責任問題です。
公正労働基準法(FLSA)に基づき、雇用主は非免除従業員全員について、毎日の労働時間と各労働週の総労働時間の記録を保持する義務があります。バッチ処理で同じ作業員の時間を複数のシートにまたがって統合する場合、最終的なスプレッドシートがFLSAで要求される合計を正確に反映していることを確認することは任意ではなく、故意の違反1件につき最大$10,000の罰金が科される法的義務です。
給与計算ソフトが受け付けるために、給与スプレッドシートに本当に必要なもの
ほとんどの給与システムは「抽出したデータなら何でも」受け付けてくれるわけではありません。特定の列構造、日付形式、フィールドタイプを期待しており、一致しない行は黙って拒否されたり、誤って処理されたりします。主要プラットフォームの要件は次のとおりです。
| 必須フィールド | ADP RUN | Gusto | QuickBooks Payroll |
|---|---|---|---|
| 従業員識別子 | 従業員ID(数値) | メールアドレスまたは従業員番号 | 従業員の表示名 |
| 日付形式 | MM/DD/YYYY | YYYY-MM-DD | MM/DD/YYYY |
| 時間フィールド | 小数のみ(7:30ではなく7.5) | 小数またはHH:MM | HH:MMまたは小数 |
| 支給コード | 各行に必須 | 支給タイプが必須 | 給与項目が必須 |
| 残業 | 別の支給コード | 自動計算または手動 | 別の明細行 |
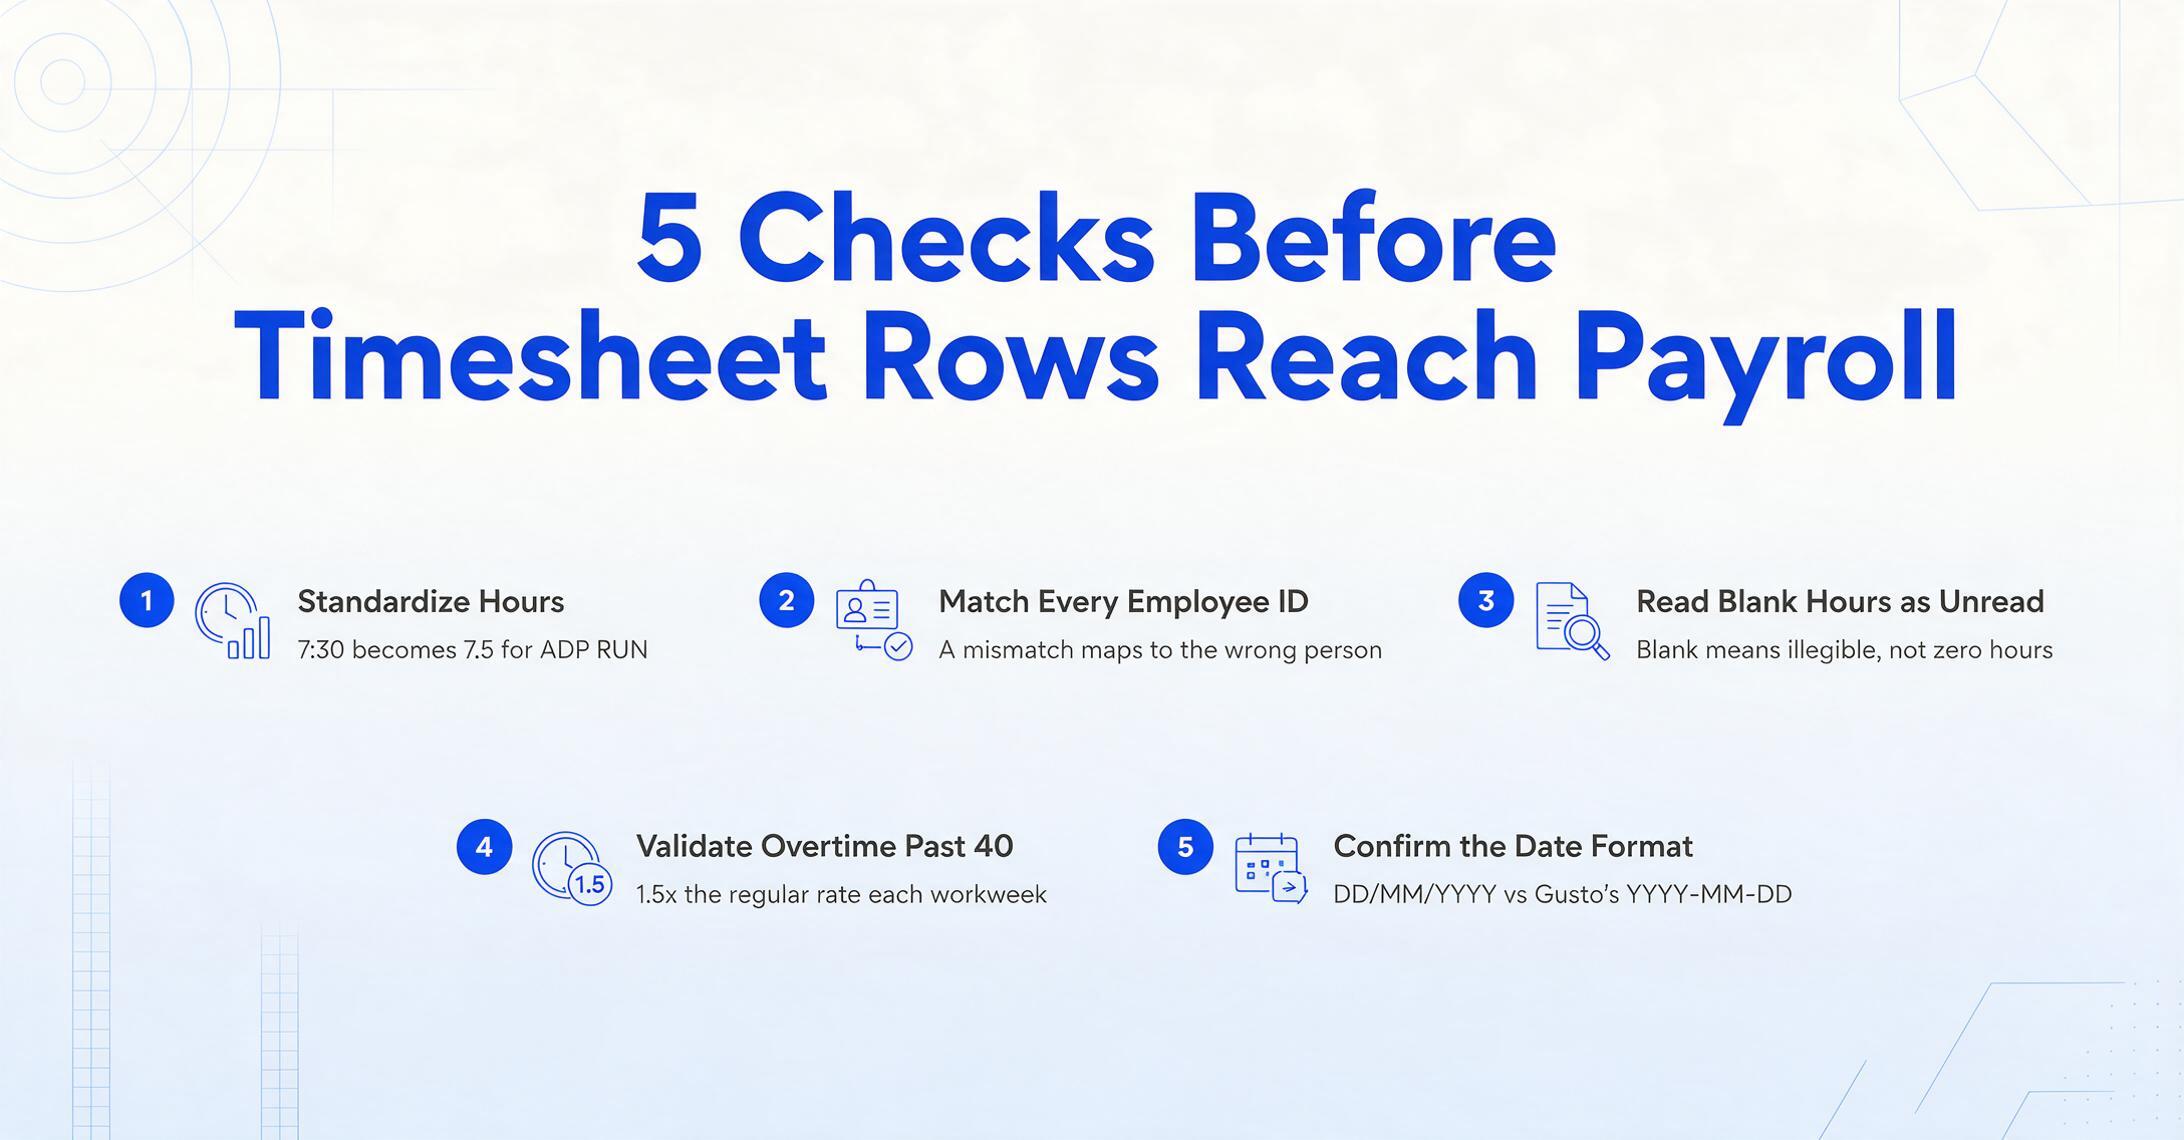
この表は、「データを抽出するだけ」では不十分な理由を示しています。現場作業員Aが「7:30」と書いても、ADPが「7.5」を期待している場合、インポートファイルが使えるようになる前に、40枚すべてのシートで時間を標準化する必要があります。同様に、建設チームがDavis-Bacon賃金プロジェクトに参加している場合、時間だけでなく、作業員の分類コードや福利厚生の内訳も必要です。これらのデータは、タイムシートのヘッダー、本文、別の署名済み証明書ページに分散している可能性があります。
建設業者にとって、リスクはさらに高くなります。WH-347認定給与計算書には、従業員の分類、分類ごとの時間、基本賃金率、残業率、福利厚生を含める必要があります。ある建設会計事務所は、紙ベースの認定給与計算を「エラーの温床」と表現しました。すべてのフィールドを手書きのシートから政府のフォームに手作業で再入力する必要があるからです。
テンプレートなしで列名抽出がフォーマットの多様性を処理する方法
タイムシート用のOCRツールのほとんどはテンプレートマッチングで動作します。サンプルフォームの「時間」フィールドにボックスを描き、そのツールは以降のすべてのシートでその正確な位置を探します。これは、すべての作業員が同じ印刷フォームを提出する場合に機能します。しかし、40人の現場作業員が40種類の異なるシートを使用する場合(印刷されたもの、ノート用紙に手書きされたもの、現場のトレーラーのテーブルで斜めから撮影されたものなど)には、完全に機能しません。
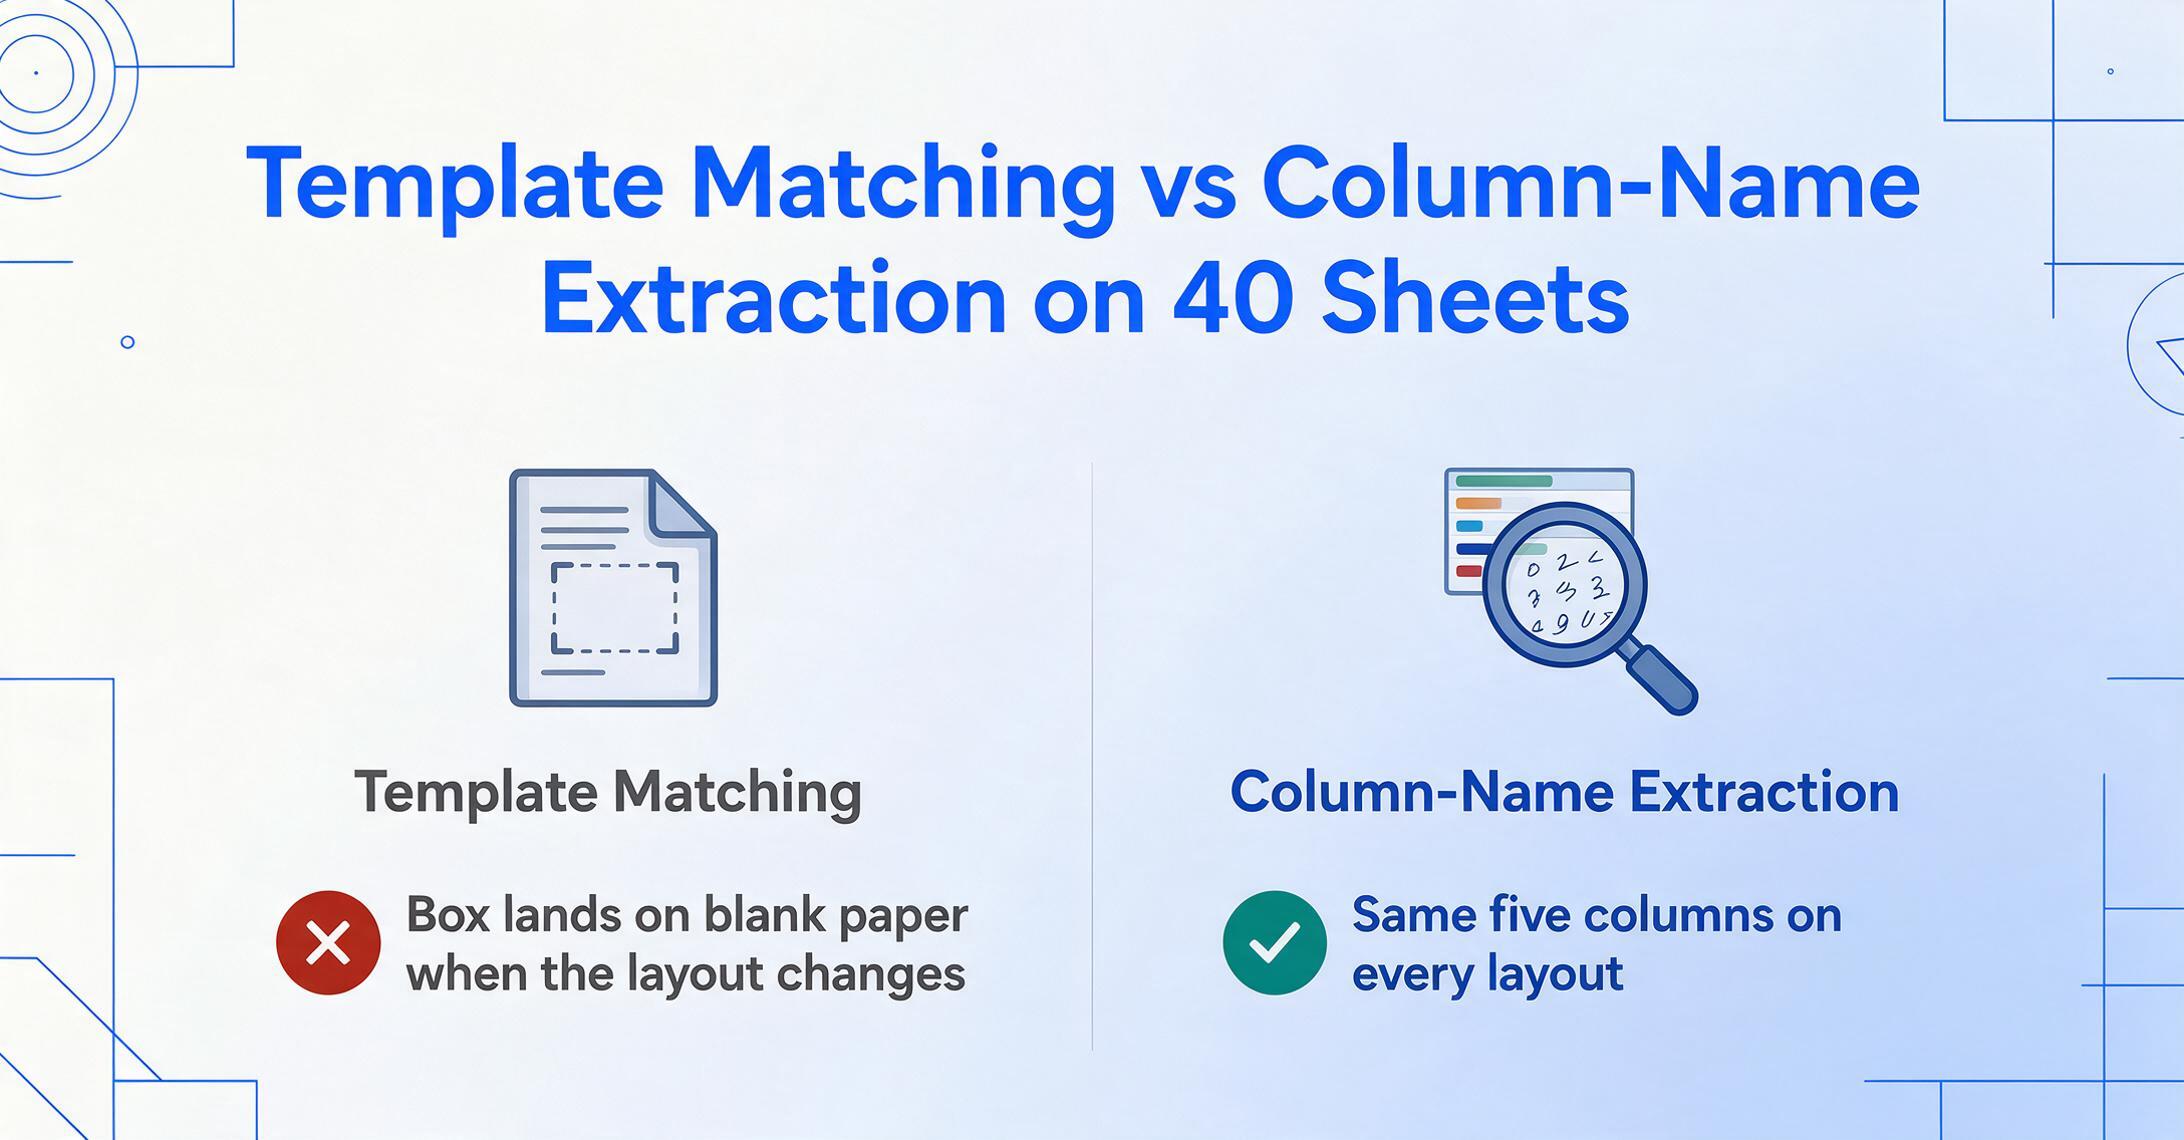
ImageToTable.aiは根本的に異なるアプローチを使用します:列名抽出です。フィールドの位置を定義する代わりに、フィールドの意味を定義します。出力スプレッドシートに必要な列ヘッダー(従業員名、日付、通常時間、残業、作業コード)を入力すると、AIのビジョンモデルは、値がどこにあるかではなく、何を意味するかを理解して、各ページの対応する値を特定します。これは、AI手書き文字認識がExcelにデータを抽出する方法に関するガイドで詳しく説明されているのと同じメカニズムです。モデルは、フォントデータベースに対して文字形状を照合するのではなく、文脈を理解することで手書き文字を読み取ります。
このアプローチは、フォーマットの多様性の問題を直接解決します。作業員Aのグリッド形式と作業員Bの単一行形式は、AIがレイアウトではなく意味内容を見ているため、同じ列名構造で処理されます。各シートに存在するフィールドは、バッチ全体で想定されるのではなく、シートごとに決定されます。
ファイルは安全に処理され、保存されません。
40枚のタイムシートをTo Tableモードに一括アップロードし、Name、Week Ending、Daily Hours、Overtime、Job Codeなどの列を指定すると、タイムシート1枚につき1行のデータを持つ単一の結合スプレッドシートが出力されます。結果はExcel(XLSX)またはCSVとしてダウンロードでき、ADP、Gusto、QuickBooks Payrollが直接インポートできる形式です。
複数の現場を管理するHRチームにとって、コレクションリンクはさらなる効率化をもたらします。共有可能なリンク(例:/c/xxxx)を生成し、現場監督やサイトスーパーバイザーに送信します。彼らはリンクを開き、確認コードを入力して、タイムシートの写真を直接あなたの処理キューにアップロードできます。登録もソフトウェアのインストールも不要です。ファイルはあなたのアカウントに保存され、バッチ抽出の準備が整います。
エッジケースへの対応:欠落フィールド、残業の分割、判読不能なエントリ
エッジケースへの対策なしにバッチ処理を行うと、一見正しく見えるスプレッドシートでも、給与計算実行後にしか気づかないエラーが含まれることがあります。実際に問題を引き起こすシナリオと、それぞれへの対処法を以下に示します。
日付フィールドの欠落
作業員が日付の代わりに「第3週」と書いた場合、AIがDate列に一致する値を見つけられないと、出力のセルは空白になります。これは推測せずに問題を明示する正しい動作であり、レビューステップで問題を検出できます。日付の欠落が頻繁に発生する場合は、計算カラムを使用してDate Status (if Date is blank, output "CHECK", otherwise output "OK")のような列を追加できます。これは、給与ソフトウェアに到達する前に関連行にフラグを立てる条件付きルールです。
残業が誤った場所に記載されている場合
一部の作業員は通常時間と同じセルに残業時間を「8 + 2 OT」のように書きます。別の列に書く人もいれば、残業列がなく欄外に書く人もいます。AIが手書きフォームと構造化フィールドをどのように読み取るかの解説で説明したように、ビジョンモデルは文書全体を総合的に読み取ります。「OT」とラベル付けされた列の数字と、欄外に走り書きされた同じ数字を区別できます。AIは見つけたものを抽出し、存在しない値を推測することはありません。
完全に判読不能な手書き文字
ここで正直な限界が重要になります。AIによる手書き文字認識は大幅に進歩していますが(AI手書き文字テキスト変換の完全ガイドで詳しく説明)、中には人間でも本当に読めない手書き文字もあります。AIが解決できない文字に遭遇すると、出力セルは空白になるか、部分的な読み取り結果が含まれ、これも手動レビューの対象としてフラグが立てられます。これは、給与データを静かに破損させる、自信はあるが誤った推測よりも望ましい結果です。
複数の作業現場からの重複エントリ
同じ従業員が同じ週に異なる作業現場の2つの別々のタイムシートに記載されている場合、インポートファイルは行を結合するか(FLSA残業計算用)、異なる作業コードで分離したままにするか(プロジェクトコスト追跡用)のいずれかを行う必要があります。バッチ出力は各タイムシートを個別の行として保持するため、Excelで集計してからインポートするか、ジョブコスト計算用に詳細な行レベルのデータを保持するかを選択できます。
抽出データから給与インポートへ:ラストマイルを埋める
データ抽出はスプレッドシートを生成します。給与ソフトウェアは検証済みのインポートファイルを必要とします。この2つの状態の間のギャップが、多くのバッチ処理ワークフローが静かに失敗する場所です。以下は、一般的な失敗ポイントをカバーするチェックリストです:
IRSは雇用主に対し、納税期限後少なくとも4年間の給与記録の保管を義務付けており、タイムシートはFLSAに基づき少なくとも2年間の保管が求められます。抽出されたスプレッドシートはデジタル記録となり、ダウンロード、アーカイブ、監査が可能です。これは、紙のコピーをキャビネットに保管するよりも、コンプライアンス上大きな改善となります。
よくある質問
AIは筆記体で書かれたタイムシートを読めますか?
はい、ただし活字体の場合と同じ注意点が適用されます。読みやすさが重要です。ビジョンモデルは個々の文字をなぞるのではなく、単語全体の形と文脈を理解して筆記体を読み取ります。明確で一貫性のあるつながった筆記体は、通常、確実に抽出されます。高度に装飾された筆記体や急いで書かれた筆記体(人間の給与担当者でも問題と判断するようなもの)は、部分的または空白の結果になることがあります。出力セルが空白であることは、確認が必要であるというシグナルであり、黙ってエラーになるわけではありません。
同じバッチ内で作業員がまったく異なるタイムシート形式を使用している場合はどうなりますか?
まさにそのシナリオこそ、列名抽出がテンプレートベースのツールより優れている点です。AIは位置ではなく意味で値を特定するため、1回のアップロードで5つの異なるタイムシート形式が1つの統合スプレッドシートになります。唯一の制約は、各タイムシートに要求するデータが含まれていることです。作業員Dのシートに残業列がない場合、その行のフィールドは空白になります。これは正しい動作です。
バッチ処理は建設業の認定給与(WH-347)に使えますか?
バッチ抽出は、手書きの日次ログやタイムシートから、従業員名、分類、1日あたりの時間、合計時間、賃金率、控除など、Form WH-347に必要なデータポイントを取得できます。ただし、認定給与レポートには、2ページ目に署名済みのコンプライアンス声明が含まれる特定の政府フォームが必要です。抽出されたデータはフォームに入力されますが、認定署名のステップは手動のままです。出力スプレッドシートは、WH-347を生成する認定給与ソフトウェアの入力ソースとして使用でき、再入力の手間を削減できます。
修正や取り消し線のあるタイムシートはどう処理すればよいですか?
AIは文書を視覚的に表示されたまま読み取ります。作業員が「8」を取り消して上に「6.5」と書いた場合、モデルは通常、取り消し線の付いた値ではなく、表示されている最終値(6.5)を解釈します。ただし、修正が元の値と同じくらい太い場合など、過度に書き直されたセルはモデルを混乱させる可能性があります。その場合、出力が2つの値の間で切り替わったり、空白になったりすることがあります。これらはまさに、給与にインポートする前に手動で確認すべき行です。
スマホのカメラで撮影したタイムシートの写真を処理できますか?
はい。JPG、PNG、PDFの入力に対応しており、スマホのカメラ写真も含まれます。斜めからの撮影や不均一な照明(現場ではよくあることです)の写真もビジョンモデルで処理されますが、品質は精度に影響します。平らで明るい場所で撮影した写真は、トラックのダッシュボードに立てかけたクリップボードの影や傾きのある写真よりも、抽出結果が良くなります。現場作業員が定期的にタイムシートのスマホ写真を提出する場合、コレクションリンクを使えば、スマホから直接処理キューにアップロードできます。
手書きタイムシートのバッチ処理での現実的な精度はどのくらいですか?
単一の数値はありません。精度は手書きの質、写真の質、フォームの複雑さによって異なります。当社のコアエンジンは、印刷された表データで最大99%の精度を達成しています。手書き文字認識はそれより低く、ばらつきがあります。きれいなフォームに書かれた明瞭なブロック体は、くしゃくしゃの用紙に書かれた急いだ筆記体よりも成功率が高いです。バッチ処理のワークフローはこのばらつきを考慮しています。フラグが付いたセルや空白のセルだけを確認し、すべての行を確認する必要はありません。これが「おかしな箇所の3行を確認する」と「40枚すべてを最初から再入力する」の違いです。
1か月分の紙のタイムシートを1つの給与計算用スプレッドシートに
1か月分の手書きタイムシートをアップロードし、列を一度定義するだけで、給与計算用スプレッドシートを数分で書き出せます。数時間かかりません。
無料で試す — サインアップ不要最初のタイムシートをアップロードして、抽出の様子をライブで確認できます。クレジットカードは不要です。