Processe em Lote um Mês de
Folhas de Ponto Manuscritas para a Folha de Pagamento
A American Payroll Association informa que os erros de transcrição manual consomem entre 1% e 8% da folha de pagamento total em organizações que ainda dependem do registro de horas em papel. Para uma equipe de campo de 50 funcionários que ganam salário predominante em um projeto Davis-Bacon, esse intervalo se traduz em milhares de dólares por período de pagamento — antes de contar as horas gastas decifrando a escrita manual e redigitando dados no ADP ou QuickBooks.
Por que o Processamento em Lote de Folhas de Ponto é um Problema Diferente da Extração de Documento Único
Extrair dados de uma folha de ponto manuscrita é um desafio de reconhecimento. Extrair dados de 40 delas — coletadas de diferentes trabalhadores de campo, escritas em formulários diferentes, com estilos de caligrafia variados e níveis de completude diversos — é um desafio de consistência, mesclagem e validação. O gargalo no processamento em lote não é ler a caligrafia. É garantir que todas as 40 linhas da sua planilha final realmente se alinhem, para que o seu software de folha de pagamento não rejeite a importação.
De acordo com um estudo da ConstrucTech de 2018, aproximadamente 40% das empresas de construção ainda usam sistemas de ponto baseados em papel. Pesquisas do Reino Unido da Causeway descobriram que esse número chega a cerca de 60% entre empresas de construção especificamente. Essas não são empresas que querem papel — são empresas onde as condições de campo tornam o registro digital inviável: sem sinal de celular em canteiros remotos, equipes que se revezam em vários locais diariamente, subcontratados que não estão no sistema de software da empresa. As folhas de ponto em papel existem. A questão é o que fazer com elas no final do mês.
A extração de documento único pergunta: "a IA consegue ler esta única folha?" O processamento em lote pergunta: "a IA consegue produzir uma planilha onde o parser de importação do ADP não rejeite a linha 17 porque o formato da data não corresponde, e a linha 23 porque a coluna de horas extras está vazia quando esperava um número?" Esses são problemas de engenharia fundamentalmente diferentes.
Os Três Problemas Que Tornam Folhas de Ponto Manuscritas em Lote Exclusivamente Difíceis
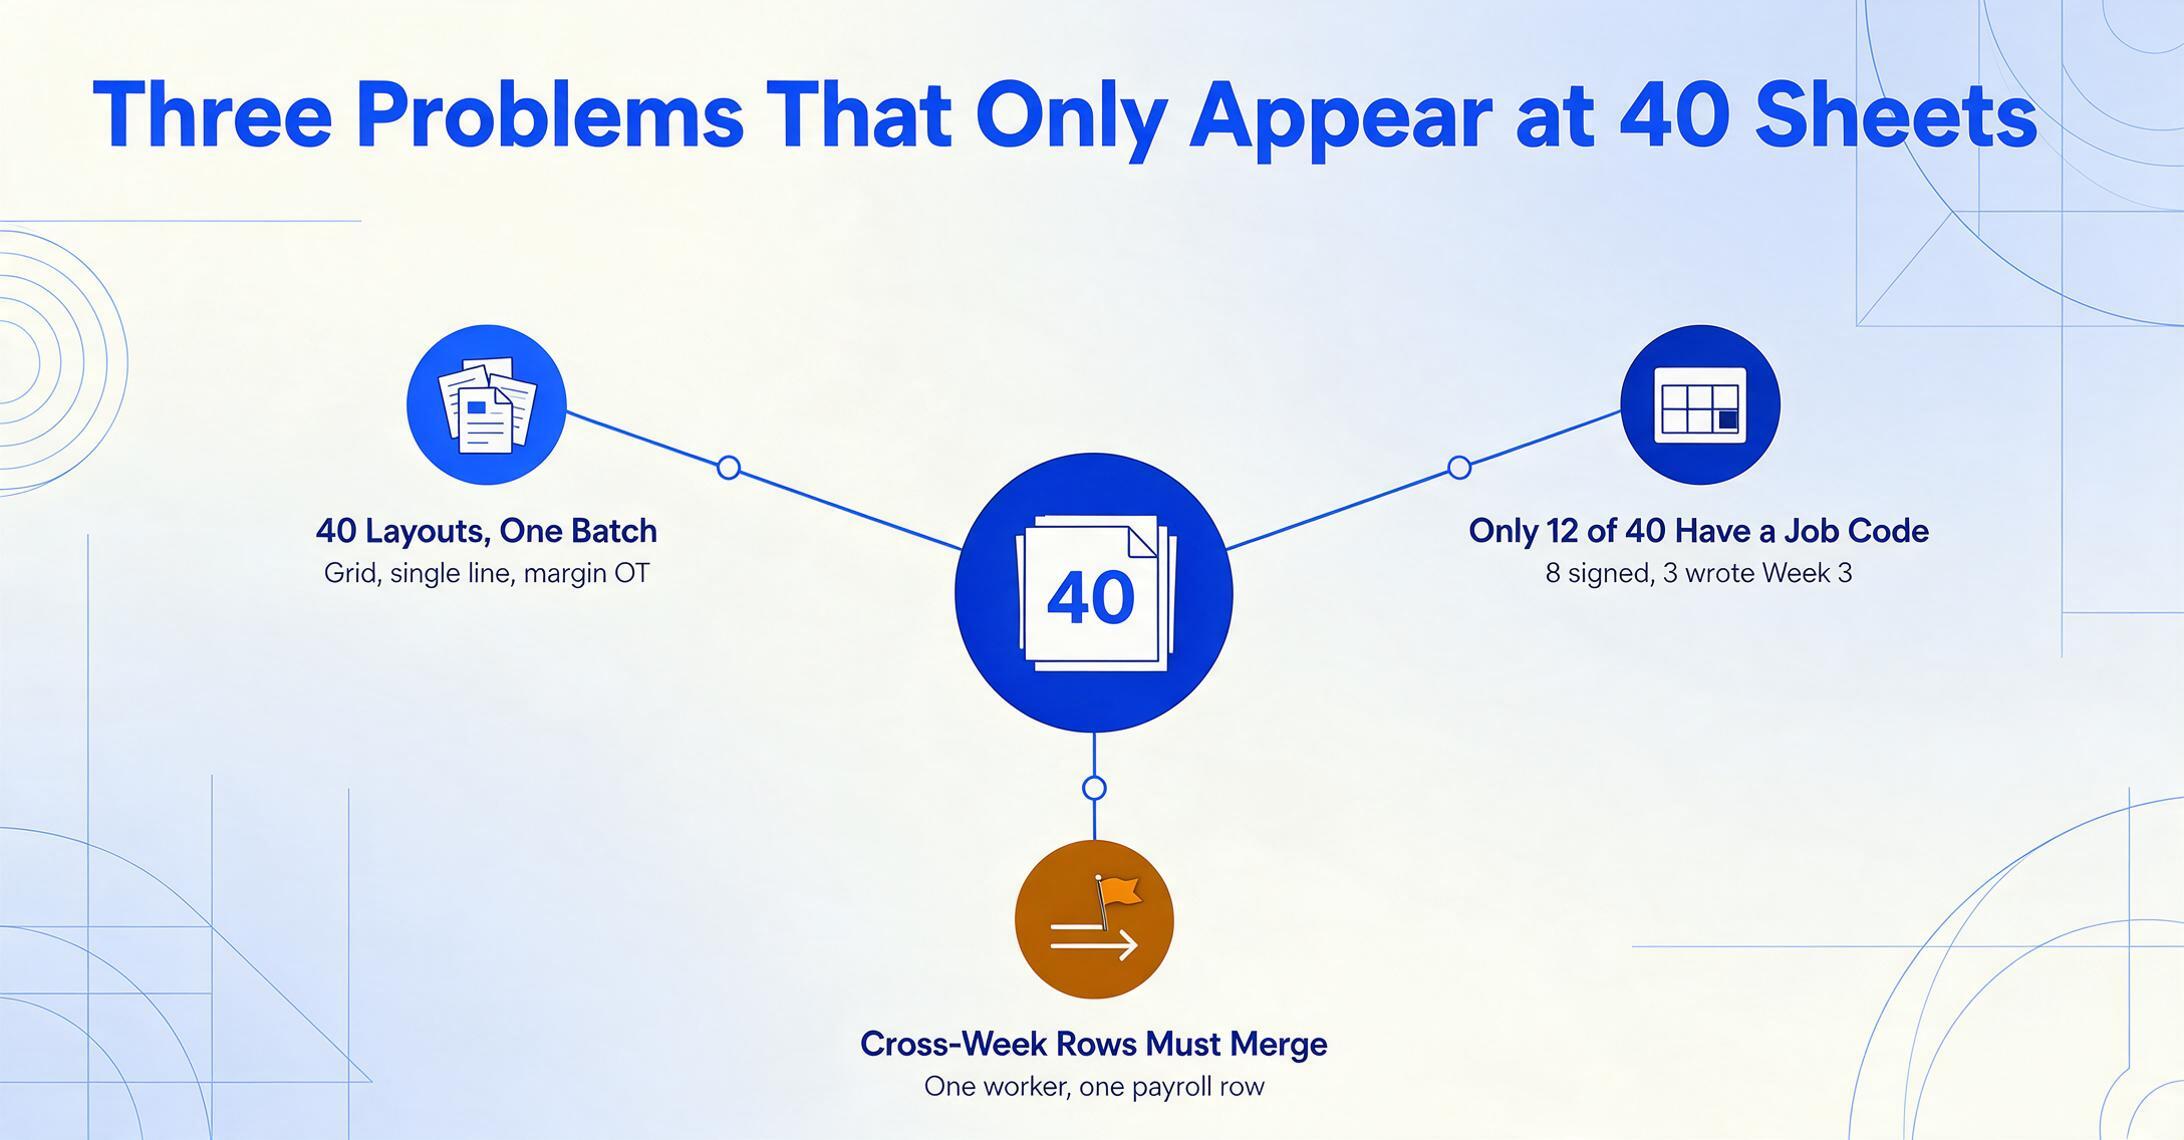
Ao processar uma única folha de ponto, você pode verificar manualmente cada campo. Com 40 folhas de um ciclo mensal de folha de pagamento, três problemas estruturais surgem que fluxos de trabalho de documento único nunca encontram:
1. Inconsistência de formato entre trabalhadores e semanas
O trabalhador de campo A registra as horas em uma grade com colunas de lunes a domingo e um total diário. O trabalhador B simplesmente escreve "Mon 8 Tue 7.5 Wed 8 Thu off Fri 6" em uma única linha. O trabalhador C usa um formulário impresso da empresa, mas escreve as horas extras na margem porque não há coluna designada para elas. Nenhuno destos formatos é "incorrecto" — mas esperar que qualquer herramienta de OCR baseada em modelos processe os três no mesmo lote é onde a maioria dos sistemas falha. As herramientas baseadas em modelos exigem que você predefina as posições dos campos para cada formato, o que anula o propósito da automação em lote.
2. Campos que existem em algumas folhas, mas não em outras
Em uma pilha de 40 folhas de ponto, 12 têm uma columna de código do trabalho, 8 incluyen una firma de supervisor con aprobación de horas, e 3 não têm a data — o trabalhador escreveu o número da semana ("Semana 3") em seu lugar. Se seu fluxo de extração assume que cada campo existe em cada folha, você produz uma planilha com lacunas que o software de folha de pagamento interpreta como erros. A pesquisa de 2022 sobre Riscos e Custos de Processamento de RH da EY descobriu que a organização média faz 15 correções por período de folha de pagamento — e campos ausentes ou inconsistentes são a causa raíz da maioria delas.
3. A fusión de dados entre semanas cria erros silenciosos na folha de pagamento
O erro de lote mais perigoso não é uma falha de extração que você ve — é um erro de fusión que você não ve. Um trabalhador envia duas folhas de ponto separadas para o mesmo período de pagamento porque mudou de local de trabalho no meio da semana. A extração funciona perfeitamente em ambas as folhas, mas quando você as funde em sua planilha de folha de pagamento, as horas do trabalhador aparecem em duas linhas sob códigos de trabalho diferentes. Se seu software de folha de pagamento importa estas separadamente, ele calcula as horas extras incorretamente — porque as horas extras da FLSA são baseadas no total de horas em todos os locais em uma única semana de trabalho, não em totais por local. Esta é uma responsabilidade de conformidade, não apenas um problema de formato.
De acordo com a Lei de Normas Justas de Trabalho, os empregadores devem manter registros das horas trabalhadas cada dia e do total de horas trabalhadas cada semana de trabalho para cada empregado não isento. Quando o processamento em lote funde as horas do mesmo trabalhador em várias folhas, verificar que a planilha final reflete com precisão os totais exigidos pela FLSA não é opcional — é uma obrigação legal com penalidades que chegan a $10.000 por violação intencional.
O que sua planilha de folha de pagamento realmente precisa — antes que o software a aceite
A maioria dos sistemas de folha de pagamento não aceita "quaisquer dados que você extraiu". Eles esperam estruturas de colunas específicas, formatos de data e tipos de campos — e rejeitarão silenciosamente ou processarán incorretamente as linhas que não correspondem. Aqui está o que as principais plataformas exigem:
| Campo obrigatório | ADP RUN | Gusto | QuickBooks Payroll |
|---|---|---|---|
| Identificador do funcionário | ID do funcionário (numérico) | E-mail ou nº de funcionário | Nome de exibição do funcionário |
| Formato de data | MM/DD/AAAA | AAAA-MM-DD | MM/DD/AAAA |
| Campo de horas | Só decimal (7,5, não 7:30) | Decimal ou HH:MM | HH:MM ou decimal |
| Código de ganhos | Obligatorio por linha | Tipo de ganho obrigatório | Item de folha de pagamento obrigatório |
| Horas extras | Código de ganhos separado | Calculado automaticamente ou manual | Item de linha separado |
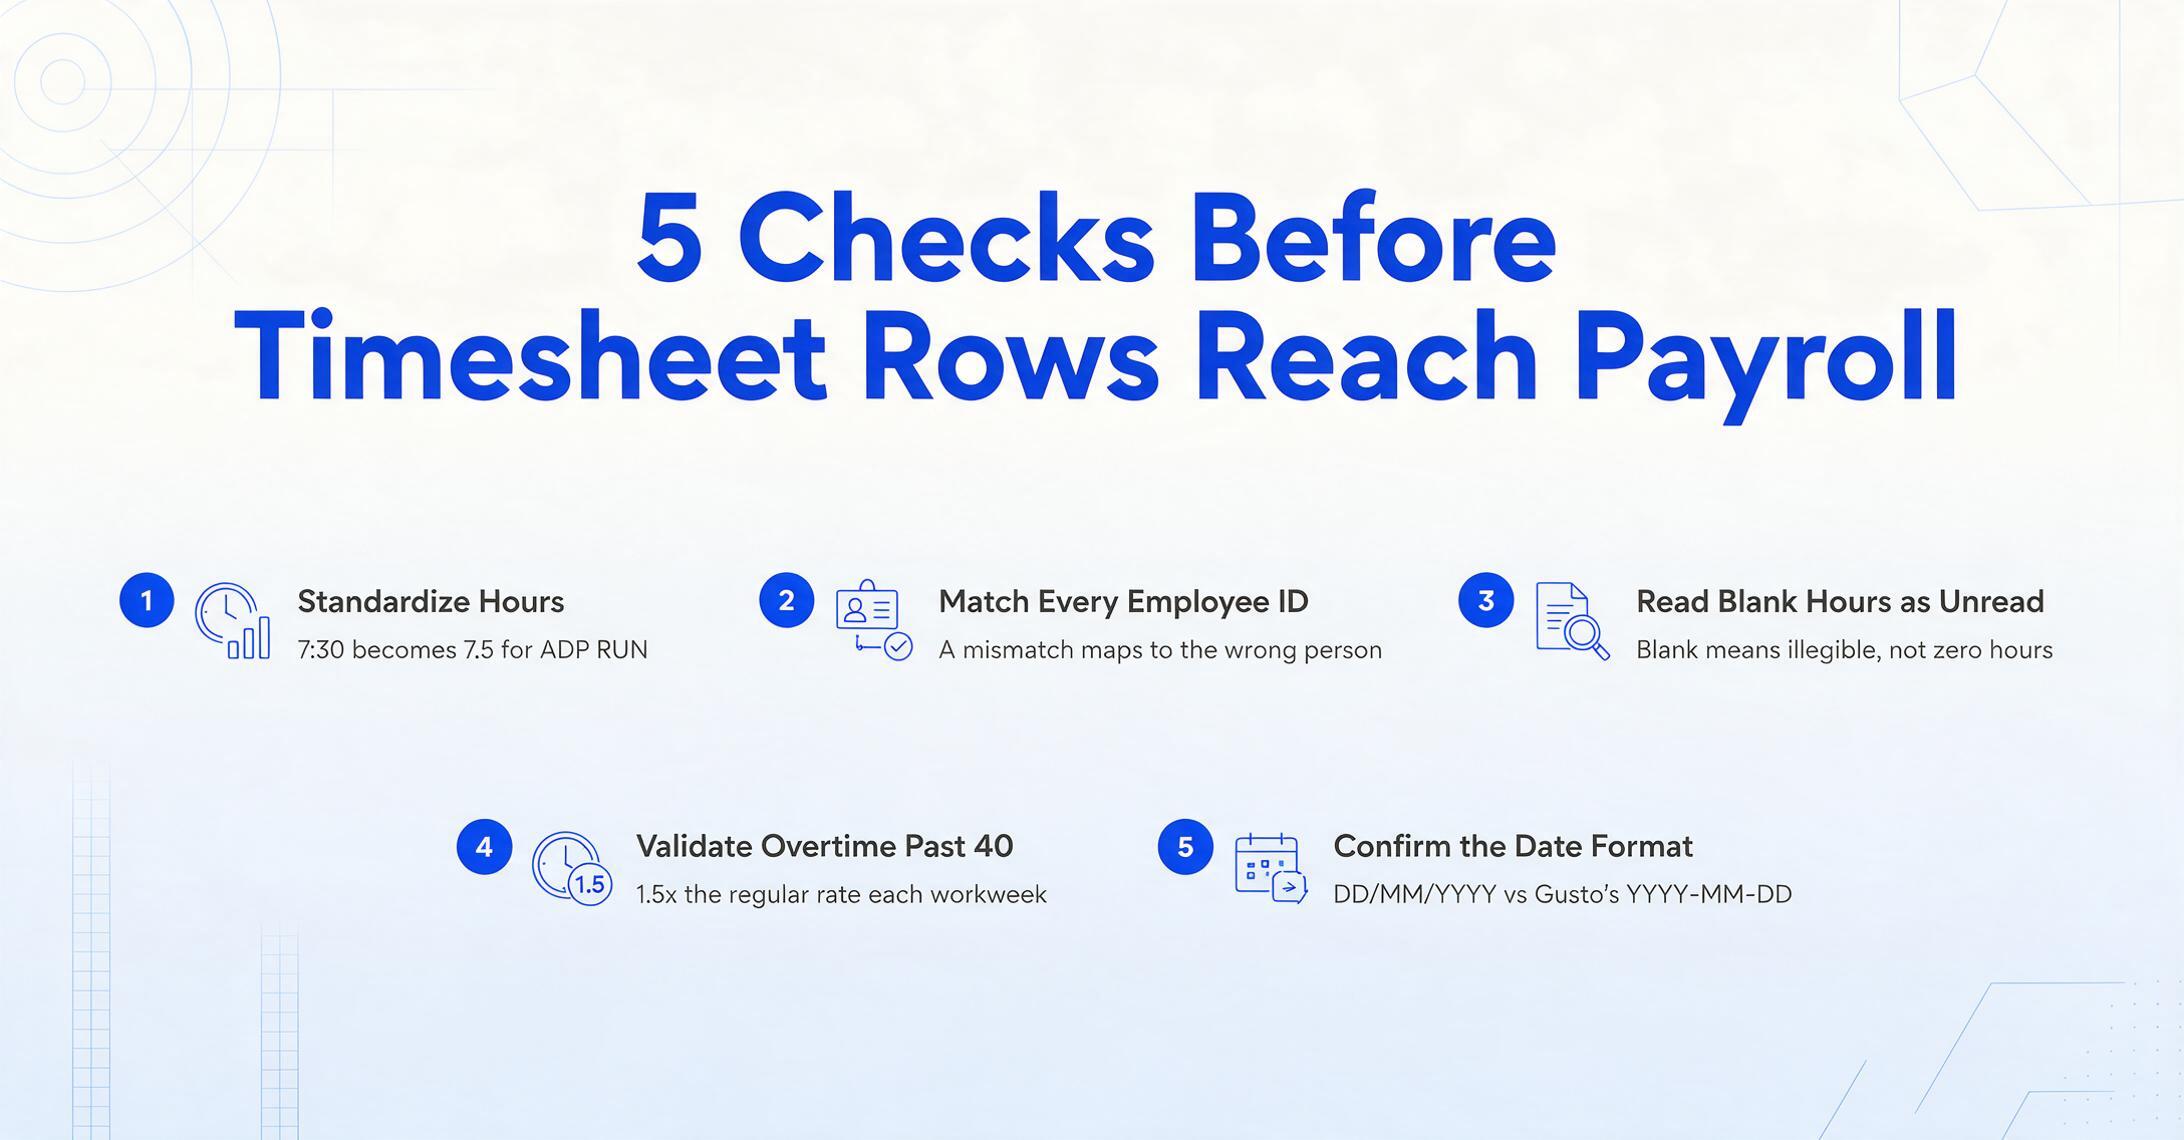
Esta tabela explica por que "simplemente extraer los datos" não basta. Se o trabalhador de campo A escreve "7:30" mas ADP espera "7,5", sua extração precisa padronizar as horas em todas as 40 planillas antes que o arquivo de importação seja utilizável. De forma similar, se uma equipe de construção está em um projeto de salário vigente Davis-Bacon, você precisa não só das horas, mas também dos códigos de classificação do trabalhador e dos desgloses de beneficios complementarios — dados que podem estar distribuidos entre o cabeçalho da folha de ponto, o corpo e uma página separada de certificación firmada.
Para contratistas de construção, o que está em jogo é maior: o formulário de folha de pagamento certificada WH-347 deve incluir a classificação do funcionário, horas por classificação, tarifa base, tarifa de horas extras e beneficios complementarios. A folha de pagamento certificada em papel foi descrita por uma firma de contabilidade de construção como "una receta para errores" porque cada campo deve ser reescrito manualmente desde planillas manuscritas até o formulario do governo.
Como a Extração de Nomes de Colunas Lida com a Variedade de Formatos Sem Modelos
A maioria das ferramentas de OCR para folhas de ponto funciona por correspondência de modelos: você desenha uma caixa ao redor do campo "Horas" em um formulário de amostra, e a ferramenta procura nessa posição exata em todas as folhas seguintes. Isso funciona se todos os trabalhadores entregarem o mesmo formulário impresso. Falha completamente quando 40 trabalhadores de campo usam 40 folhas diferentes — algumas impressas, algumas escritas em papel de caderno, algumas fotografadas em ângulo sobre uma mesa de trailer no canteiro de obras.
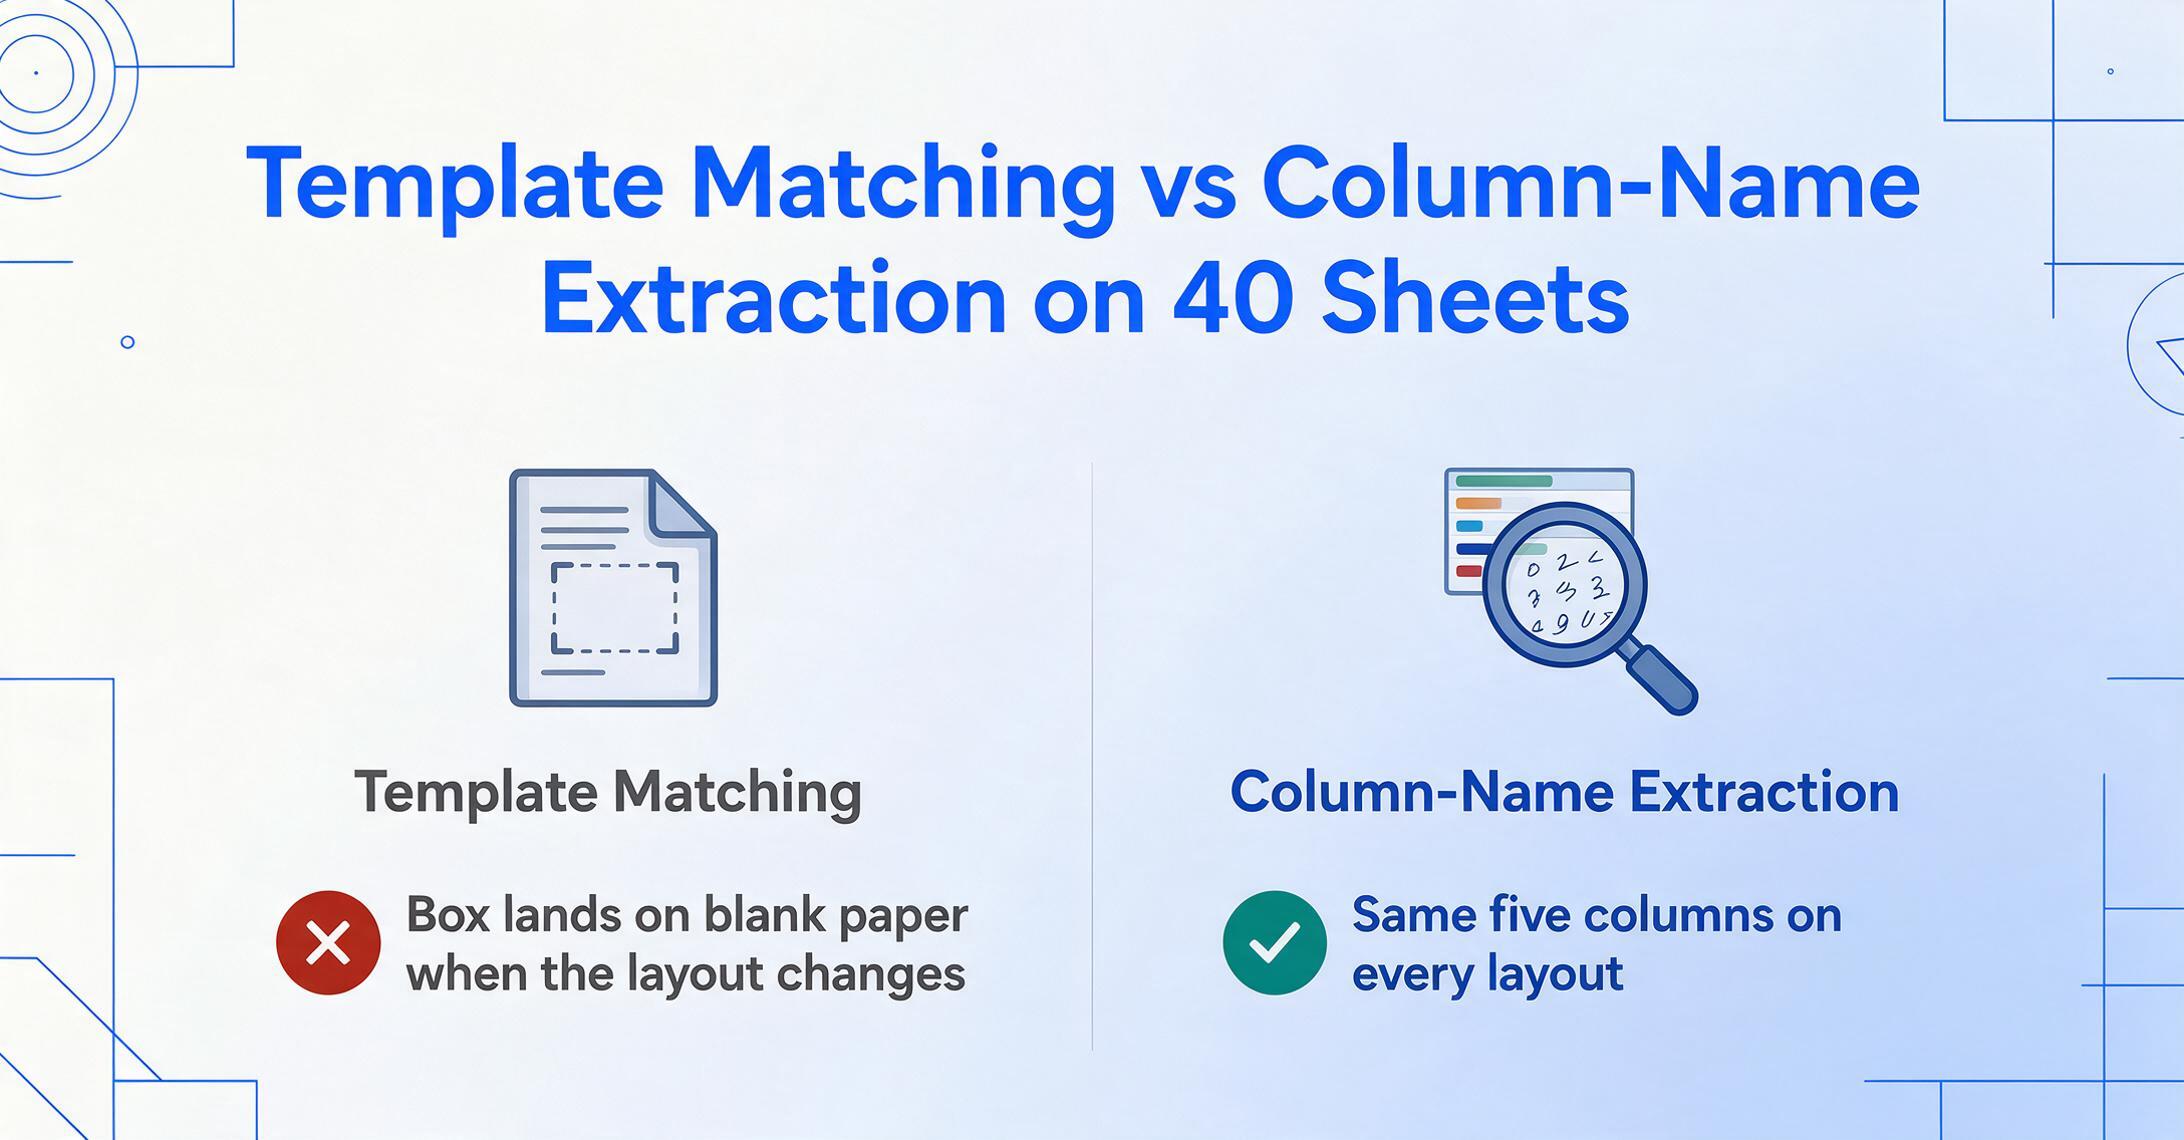
O ImageToTable.ai usa uma abordagem fundamentalmente diferente: extração de nomes de colunas. Em vez de definir posições de campos, você define significados de campos — você digita os cabeçalhos de coluna que deseja em sua planilha de saída (Nome do Funcionário, Data, Horas Regulares, Horas Extras, Código do Trabalho), e o modelo de visão da IA localiza os valores correspondentes em qualquer lugar de cada página, entendendo o que eles significam, não onde estão. Este é o mesmo mecanismo explicado em detalhes em nosso guia sobre como o reconhecimento de escrita manual por IA extrai dados para o Excel — o modelo lê a escrita manual entendendo o contexto, não comparando formatos de caracteres com um banco de fontes.
Essa abordagem resolve diretamente o problema da variedade de formatos. O formato de grade do Trabalhador A e o formato de linha única do Trabalhador B são processados pela mesma estrutura de nomes de colunas, porque a IA não está olhando para o layout — está olhando para o conteúdo semântico. Quais campos existem em cada folha são determinados por folha, não presumidos em todo o lote.
Os arquivos são processados com segurança e não são armazenados.
Ao enviar 40 folhas de ponto em lote para o modo To Table e especificar colunas como Name, Week Ending, Daily Hours, Overtime e Job Code, a saída é uma única planilha mesclada com uma linha por folha de ponto. Você pode então baixar o resultado como Excel (XLSX) ou CSV — formatos que ADP, Gusto e QuickBooks Payroll podem importar diretamente.
Para equipes de RH que gerenciam equipes de campo em vários locais de trabalho, o link de coleta adiciona outra camada de eficiência: você gera um link compartilhável (como /c/xxxx) e o envia para encarregados ou supervisores de obra. Eles abrem o link, inserem um código de verificação e enviam fotos das folhas de ponto diretamente para sua fila de processamento — sem registro, sem instalação de software no lado deles. Os arquivos chegam na sua conta, prontos para extração em lote.
Lidando com Casos Extremos: Campos Ausentes, Divisão de Horas Extras e Entradas Ilegaíveis
O processamento em lote sem um plano para casos extremos gera planilhas que parecem corretas à primeira vista, mas contêm erros que você só descobre depois que a folha de pagamento é processada. Aqui estão os cenários que causam problemas reais e como lidar com cada um:
Campos de Data Ausentes
Um trabalhador escreve "Semana 3" em vez de uma data. Quando a IA não consegue localizar um valor correspondente à coluna Date, a célula na sua saída ficará em branco — o que é o comportamento correto, pois sinaliza o problema em vez de adivinhar. Sua etapa de revisão detecta isso. Para datas ausentes recorrentes, as colunas calculadas permitem adicionar uma coluna como Date Status (se Date estiver em branco, gerar "CHECK", caso contrário gerar "OK") — uma regra condicional que sinaliza linhas problemáticas antes que cheguem ao software de folha de pagamento.
Horas Extras no Lugar Errado
Alguns trabalhadores escrevem horas extras na mesma célula das horas regulares: "8 + 2 OT". Outros escrevem em uma coluna separada. Alguns não têm coluna de horas extras e as colocam na margem. Como abordamos em nosso explicador sobre como a IA lê formulários manuscritos e campos estruturados, os modelos de visão leem documentos inteiros de forma holística — eles conseguem distinguir um número em uma coluna rotulada como "OT" do mesmo número rabiscado na margem. A IA extrai o que encontra; ela não inventa valores onde não existem.
Caligrafia Totalmente Ilegível
É aqui que a limitação honesta importa. Embora o reconhecimento de caligrafia por IA tenha avançado consideravelmente — como detalhado em nosso guia completo de conversão de caligrafia para texto por IA — algumas caligrafias são genuinamente ilegíveis até para um humano. Quando a IA encontra caracteres que não consegue resolver, a célula de saída ficará em branco ou conterá uma leitura parcial, o que novamente sinaliza a entrada para revisão manual. Isso é preferível a uma suposição confiante, porém errada, que corrompe silenciosamente sua folha de pagamento.
Entradas Duplicadas de Múltiplos Locais de Trabalho
Quando o mesmo funcionário aparece em duas folhas de ponto separadas para diferentes locais de trabalho na mesma semana, o arquivo de importação precisa mesclar as linhas (para cálculo de horas extras da FLSA) ou mantê-las separadas com códigos de trabalho distintos (para rastreamento de custos do projeto). A saída do lote preserva cada folha de ponto como uma linha distinta, dando a você a opção de agregar no Excel antes da importação ou manter os dados granulares em nível de linha para o custeio do trabalho.
De Dados Extraídos para Importação na Folha de Pagamento: Fechando a Última Milha
A extração de dados produz uma planilha. O software de folha de pagamento exige um arquivo de importação validado. A lacuna entre esses dois estados é onde a maioria dos fluxos de trabalho em lote falha silenciosamente. Aqui está uma lista de verificação que cobre os pontos de falha comuns:
Perguntas Frequentes
A IA consegue ler folhas de ponto escritas em letra cursiva?
Sim, com a mesma ressalva que se aplica à escrita de forma: a legibilidade importa. O modelo de visão lê cursiva entendendo a forma e o contexto de palavras inteiras, não traçando letras individuais. Escrita cursiva conectada, clara e consistente normalmente é extraída de forma confiável. Cursiva muito estilizada ou apressada — do tipo que até um funcionário de folha de pagamento humano sinalizaria — pode produzir resultados parciais ou em branco. A célula de saída em branco é um sinal de que precisa de revisão, não um erro silencioso.
E se os trabalhadores usarem formatos de folha de ponto completamente diferentes no mesmo lote?
Esse é exatamente o cenário em que a extração por nome de coluna supera ferramentas baseadas em modelo. Como a IA localiza valores pelo significado, e não pela posição, cinco formatos diferentes de folha de ponto em um único upload produzem uma planilha unificada. A única restrição: cada folha de ponto deve conter os dados que você está solicitando. Se a folha do Trabalhador D não tiver coluna de horas extras, esse campo ficará em branco na linha dele — o que é o comportamento correto.
O processamento em lote funciona para folha de pagamento certificada da construção (WH-347)?
A extração em lote pode capturar os dados necessários para o Formulário WH-347 — nome do funcionário, classificação, horas por dia, total de horas, taxa de pagamento e deduções — de diários manuscritos e folhas de ponto. No entanto, relatórios de folha de pagamento certificada exigem um formulário governamental específico com uma Declaração de Conformidade assinada na página 2. Os dados extraídos alimentam o formulário, mas a etapa de assinatura de certificação permanece manual. A planilha de saída pode servir como fonte de entrada para software de folha de pagamento certificada que gera o WH-347, reduzindo a etapa de redigitação.
Como lidar com folhas de ponto que têm correções ou entradas riscadas?
A IA lê o documento como ele aparece visualmente. Se um trabalhador riscou "8" e escreveu "6,5" acima, o modelo normalmente interpreta o valor final visível (6,5), não o riscado. No entanto, células muito sobrescritas — onde a correção é tão forte quanto o original — podem confundir o modelo. Nesses casos, a saída pode alternar entre os dois valores ou produzir um espaço em branco. Essas são exatamente as linhas a revisar manualmente antes de importar para a folha de pagamento.
Posso processar fotos de folhas de ponto tiradas com a câmera do celular?
Sim. A ferramenta aceita entradas JPG, PNG e PDF, incluindo fotos tiradas com a câmera do celular. Fotos tiradas em ângulo ou com iluminação irregular (comuns em canteiros de obras) são processadas pelo modelo de visão, mas a qualidade afeta a precisão — uma foto plana e bem iluminada produz melhores resultados de extração do que uma foto sombreada e inclinada tirada de uma prancheta apoiada no painel de uma caminhonete. Se suas equipes de campo enviam regularmente fotos de folhas de ponto pelo celular, um Link de coleta permite que elas façam upload diretamente dos seus celulares para a sua fila de processamento.
Qual é a precisão realista em um lote de folhas de ponto manuscritas?
Não há um número único, pois a precisão varia conforme a qualidade da caligrafia, a qualidade da foto e a complexidade do formulário. Nosso mecanismo principal alcança até 99% de precisão em dados de tabelas impressas. O reconhecimento de manuscritos é menor e variável — letra de forma clara em um formulário limpo tem uma taxa de sucesso maior do que cursiva apressada em uma folha amassada. O fluxo de trabalho em lote leva essa variabilidade em conta: você revisa células sinalizadas ou vazias, não todas as linhas. Essa é a diferença entre "verificar as 3 linhas onde algo parece errado" e "redigitar todas as 40 folhas do zero."
Transforme um Mês de Folhas de Ponto em Papel em uma Única Planilha de Folha de Pagamento
Envie um mês de folhas de ponto manuscritas, defina suas colunas uma vez e exporte uma planilha pronta para folha de pagamento — em minutos, não horas.
Experimente Gratis — Sem Registro NecessárioEnvie sua primeira folha de ponto e veja a extração ao vivo. Não é necessário cartão de crédito.