Der Batch-Job vor jedem CMMS:
Jahre an Wartungsprotokollen verarbeiten
Der Engpass bei einer CMMS-Migration ist fast nie die Software. Der Anbieter richtet das System in einer Woche ein; die Anlagenhierarchie lädt an einem Nachmittag. Was den Go-Live aufhält, ist der Berg an Wartungshistorie in Logbüchern, Ordnern und Handyfotos, der in eine Tabelle verwandelt werden muss, bevor das neue System mit einem einzigen Arbeitsauftrag betraut werden kann. Jeder CMMS-Implementierungsleitfaden behandelt diesen Berg als gegeben – „Daten sammeln, prüfen und bereinigen" – ohne je die Frage zu beantworten, die Teams tatsächlich stoppt: Wie genau werden Hunderte Papierseiten zu importbereiten Zeilen?
Wichtigste Erkenntnisse
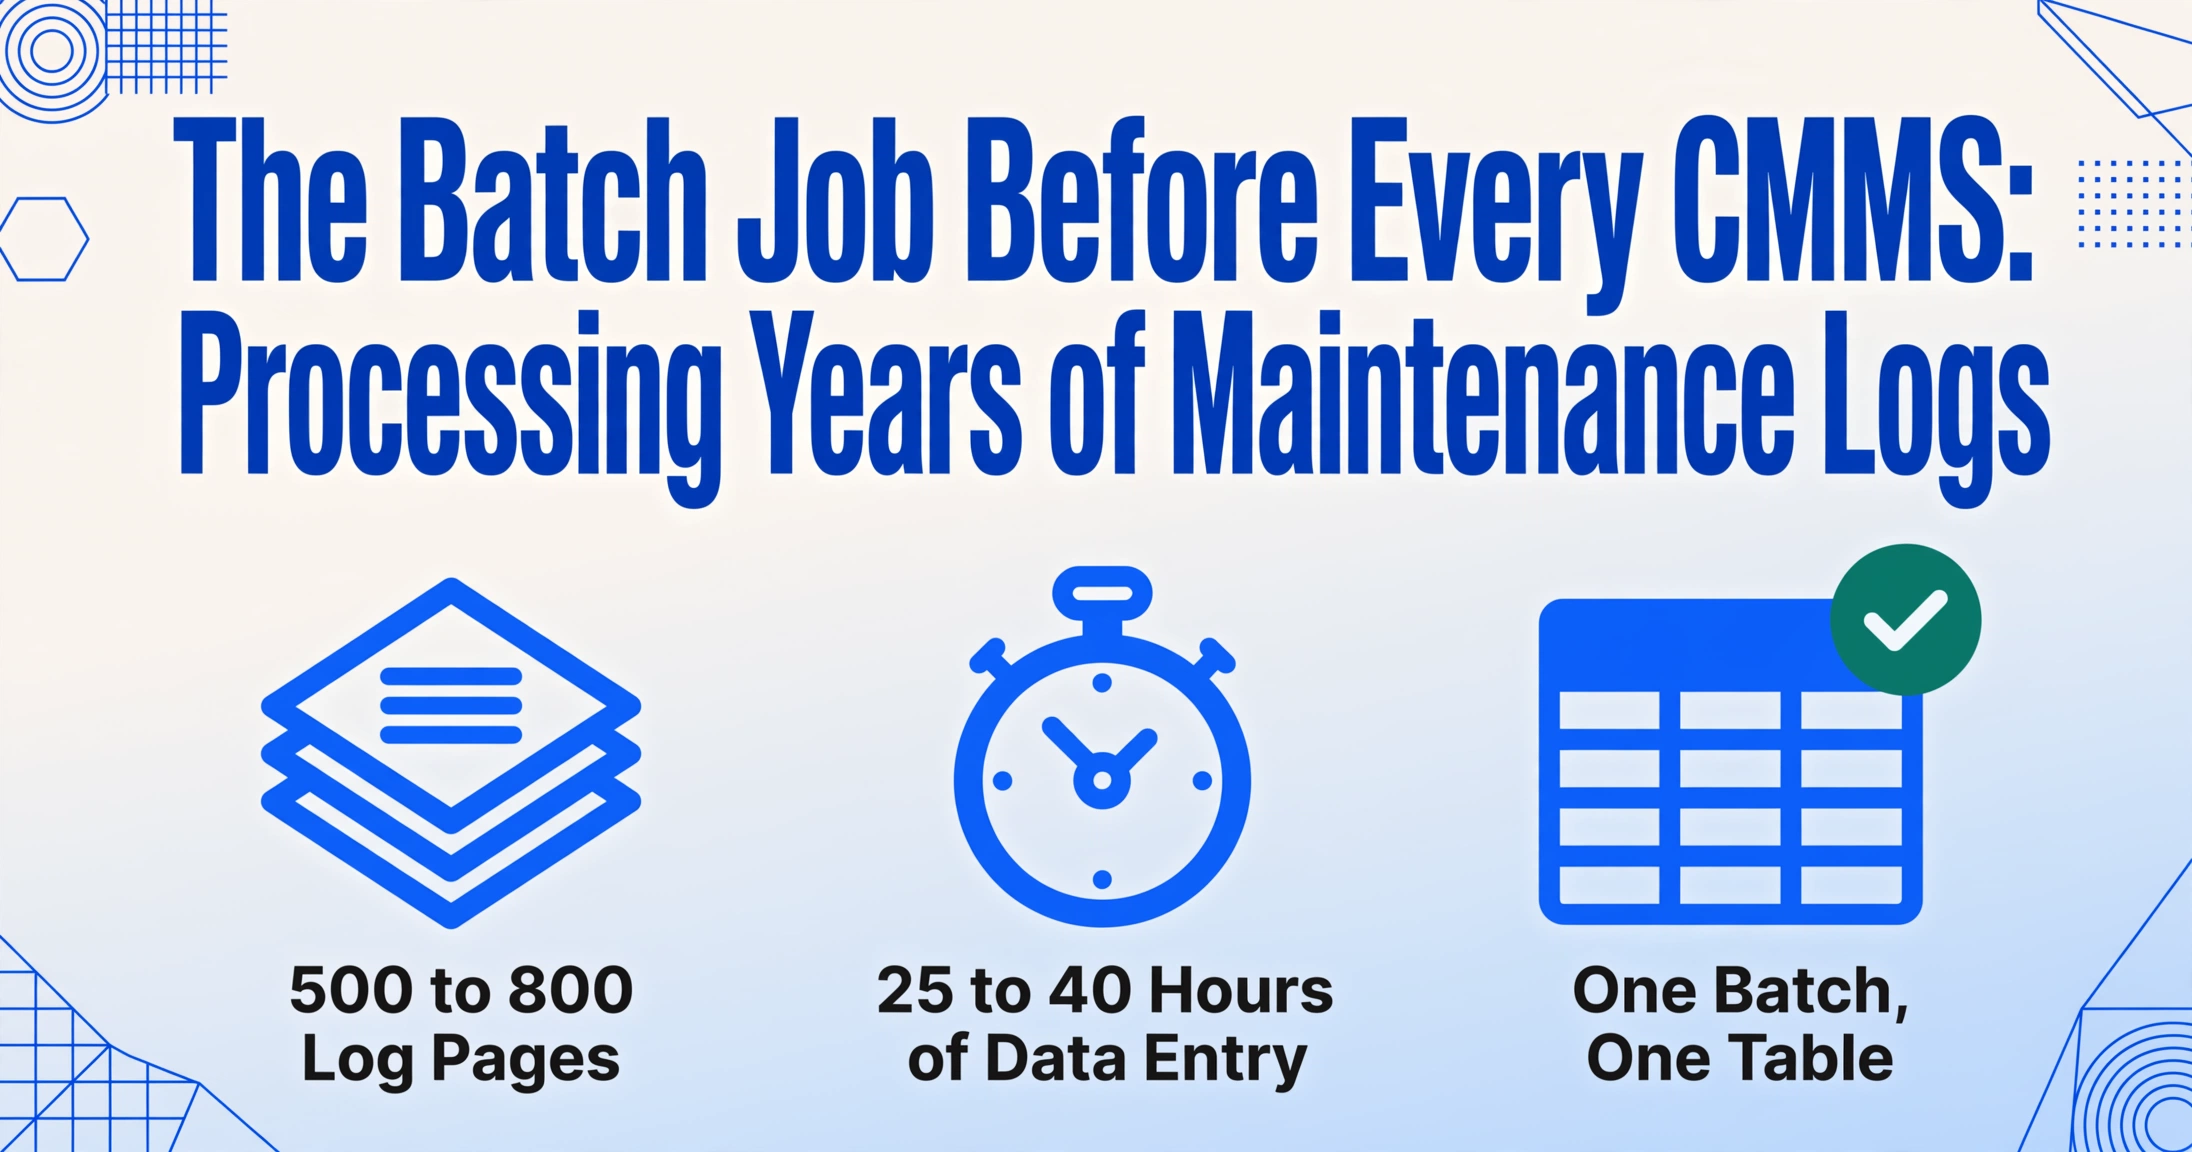
- Ein zweijähriger Wartungsrückstand bedeutet 25–40 Stunden Tipparbeit, bevor Ihr CMMS-Import-Button etwas tut – eine volle Arbeitswoche, die jeder Migrationsplan versehentlich mit null Stunden ansetzt.
- Manuelle Transkription kostet nicht nur Zeit – sie erzeugt Geister-Assets, wenn „AHU-01" und „Air Handler 1" als zwei Maschinen eingehen und das CMMS ab dem ersten Import korrumpieren.
- Batch-Verarbeitung definiert Ihre Spalten einmal und liest jede Logbuchseite, jedes Handyfoto und jede gescannte Formularseite nach denselben Regeln – 18× schneller, und die Deduplizierung erfolgt im selben Durchgang.
Die Migrations-Mathematik: Jahre an Protokollen vs. Ihr Go-Live-Datum
Ein CMMS-Go-Live-Datum ist eine Frist, aber die Arbeit, die darüber entscheidet, ob Sie sie einhalten, ist der Stapel historischer Protokolle, der strukturiert werden muss, bevor das System live geht. Diese Arbeit wird in Seiten und Stunden gemessen, und fast niemand plant sie ein.
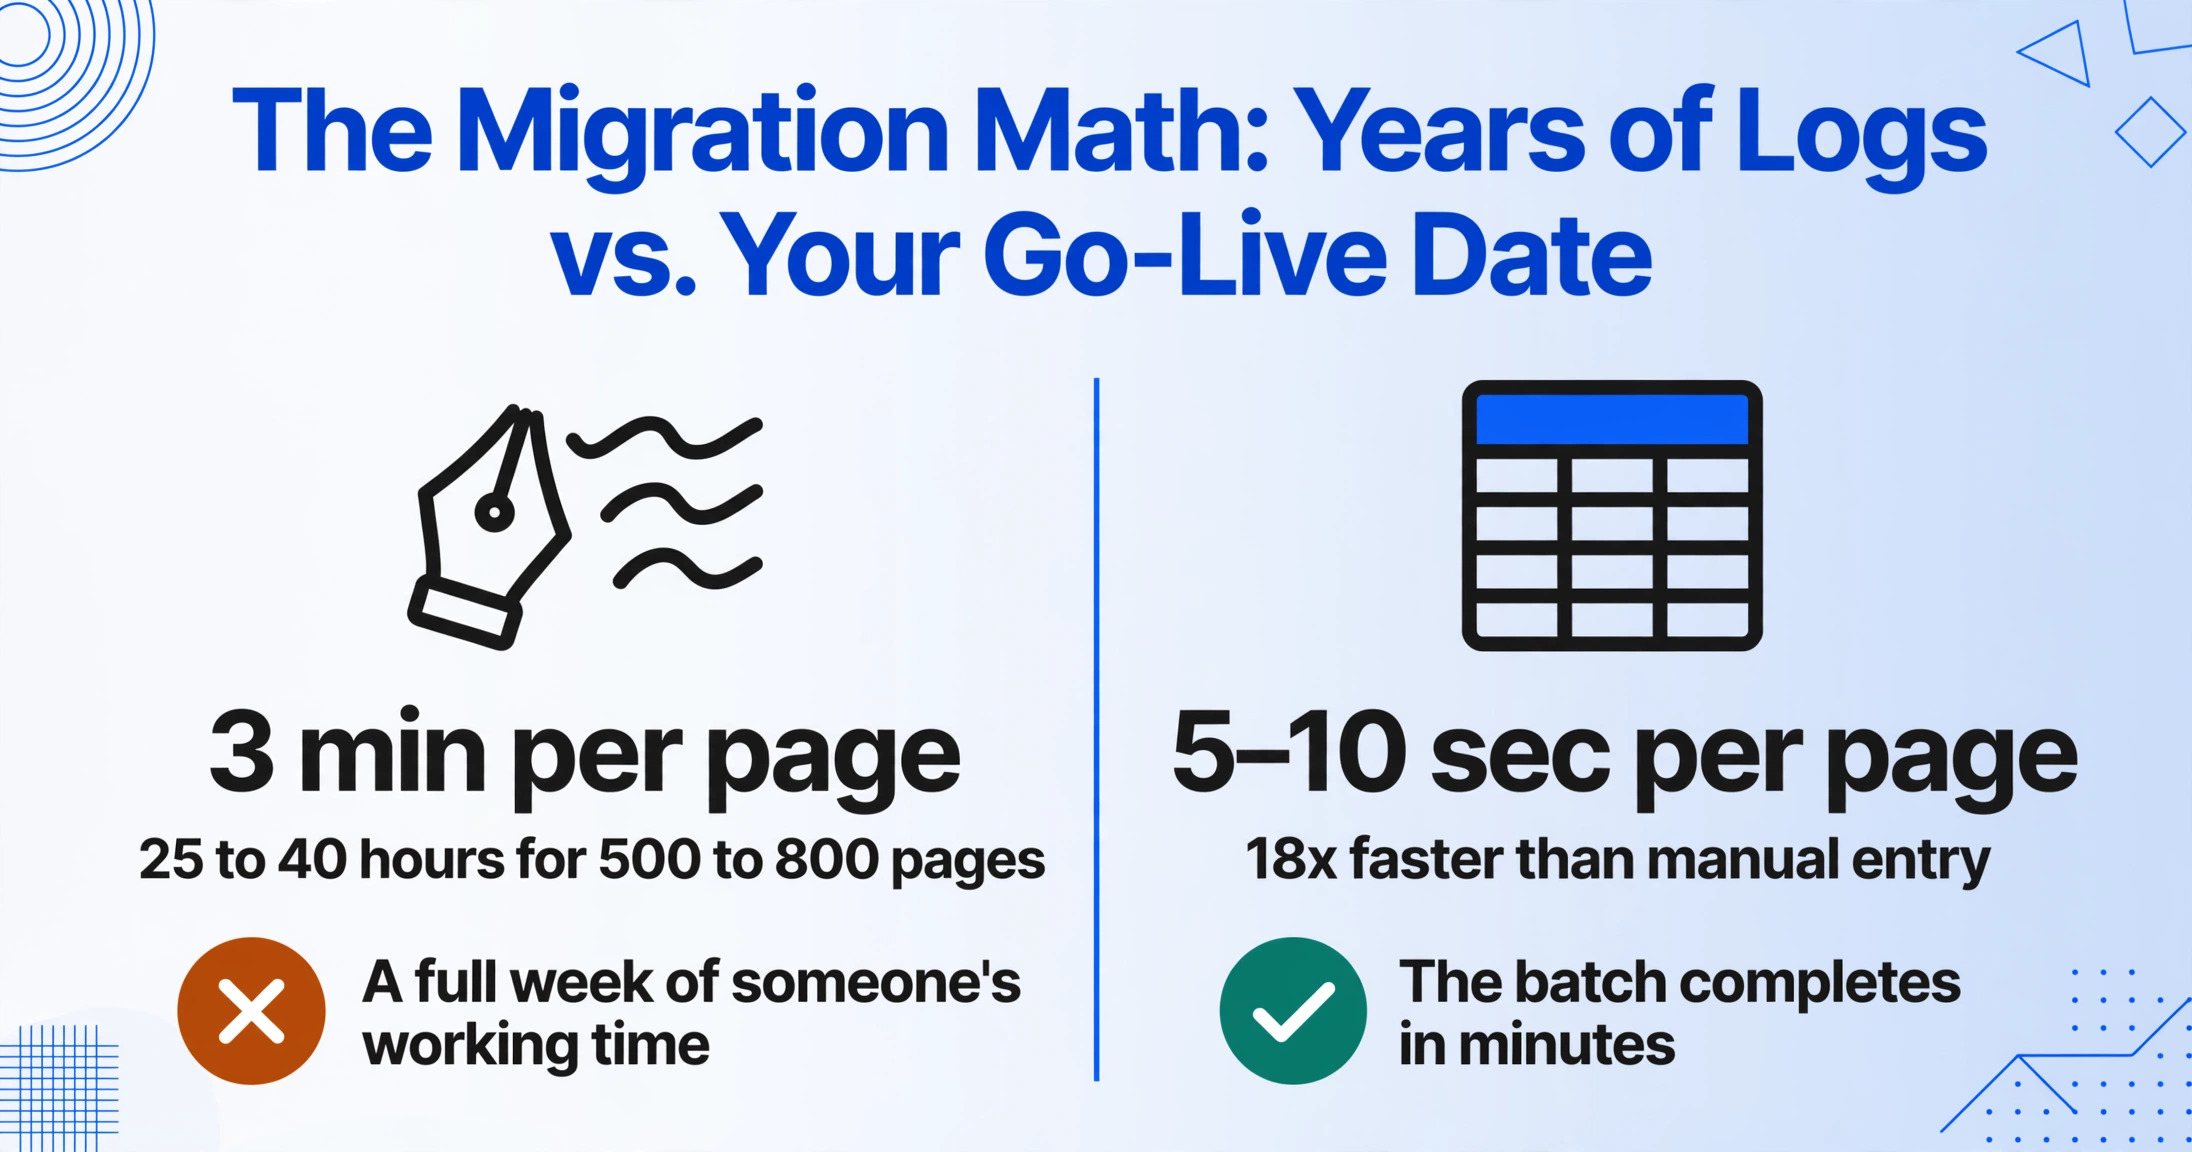
Rechnen Sie es für eine kleine Anlage durch: 30 Geräte, jeweils mit einem Logbucheintrag für jede Wartung oder Inspektion über drei Jahre. Das sind grob 500 bis 800 Protokollseiten, jede mit Gerätename, Datum, Aufgabenbeschreibung, Betriebsstunden, verwendeten Teilen und handschriftlichen Notizen des Technikers. Bei den 3 Minuten pro Seite, die manuelle Transkription tatsächlich dauert – Datum tippen, Anlagen-ID, Aufgabe, Notizen, Handschrift entziffern –, blickt eine Person auf 25 bis 40 Stunden reine Dateneingabe, bevor auch nur eine Zeile importiert werden kann. Das ist kein Samstag; das ist eine volle Arbeitswoche, und es ist der beste Fall, denn er setzt voraus, dass die Protokolle lesbar sind.
Was eine schlecht ausgeführte Eingabe kostet, beziffert Gartner, das schätzt, dass schlechte Datenqualität Unternehmen im Schnitt mindestens 12,9 Millionen US-Dollar pro Jahr kostet. Für eine Instandhaltungsabteilung ist der Mechanismus einfach: falsch geschriebene Anlagennamen spalten eine Maschine in zwei Datensätze, falsche Daten lassen PM-Intervalle driften, und eine fehlerhafte Zeile, die in ein CMMS importiert wird, ist schlimmer als keine Zeile, weil das System die schlechten Daten nun als Tatsache meldet. Die Bereinigung, die jeder CMMS-Leitfaden fordert, ist keine abstrakte Best Practice – sie ist die direkte Folge davon, Hunderte von Seiten von Hand zu transkribieren.
Deshalb ist die Frage, die den ursprünglichen Poster in einem viel geteilten r/manufacturing-Thread zur Wartungsverfolgung umtreibt, die Frage, vor der die meisten Anlagen vor jedem CMMS-Kauf stehen: „Führen die Leute wirklich irgendwo perfekte Protokolle? Ich kenne ein paar Softwares, aber die scheinen für ihren Zweck zu teuer und überladen, oder macht einfach jeder irgendeine Version von Excel + Papier + Texten und hofft auf das Beste?" Die Antwort, die die meisten Teams entdecken, lautet: Die Protokolle existieren, die Software ist erschwinglich, und die Lücke dazwischen ist die Dateneingabe.
Der Schritt, den jeder CMMS-Leitfaden auslässt
Lesen Sie die Importdokumentation eines modernen CMMS und Sie werden dasselbe Muster bemerken: Das Tool macht den Import schnell und einfach, vorausgesetzt, die Daten liegen bereits in einer Tabelle vor. Der schwierige Teil — das Erstellen dieser Tabelle aus jahrelangen unstrukturierten Aufzeichnungen — ist schlicht nicht Teil des Produkts.
Die Importlimits machen das konkret. Limble erlaubt 2.000 abgeschlossene Aufgaben pro Massenimport aus einer CSV- oder XLSX-Datei. UpKeep begrenzt Arbeitsauftrag-Importe auf 2.000 Zeilen pro Upload. Fiix und MaintainX verlangen beide eine CSV-Vorlage mit bestimmten Datumsformaten und Feldzuordnungen. Keines davon liest ein Logbuchfoto, parst ein handschriftliches „alle 3 Pumpenlager geschmiert" und wandelt es in eine Zeile mit einem konformen Datumsformat um. Dieser Konvertierungsschritt liegt vollständig bei Ihnen — und es ist der eine Schritt, den jedes CMMS-Tutorial auslässt, weil die Anbieter annehmen, dass Sie ihn bereits erledigt haben.
Die Tools, mit denen Praktiker ihre Instandhaltung tatsächlich betreiben — IBM Maximo, SAP PM, Fiix, UpKeep, Limble, eMaint, Cryotos — akzeptieren alle Massenimporte als CSV/XLSX mit Spaltenzuordnung. Sie unterscheiden sich in Limits und Formaten, teilen aber eine Anforderung: saubere, konsistente, strukturierte Zeilen. Das bedeutet, die eigentliche Arbeit einer CMMS-Migration ist nicht die Softwareauswahl. Es ist die Batch-Verarbeitung der historischen Logs in die Tabelle, die der Import erwartet.
Genau das leistet die Batch-Extraktion: Sie wandelt den Log-Bestand in strukturierte Zeilen um, bevor das CMMS sie je sieht, und schließt damit die Lücke, die die Anbieter offen lassen. Der Rest dieses Artikels behandelt die drei Herausforderungen, die erst auftauchen, wenn Sie Hunderte von Logs auf einmal verarbeiten — Namensregeln, Zusammenführung und Ausnahmen — sowie einen Workflow, der alle drei bewältigt.
Batch-Herausforderung Nr. 1: Namensregeln über Jahrzehnte alter Protokolle
Ein CMMS-Import erstellt problemlos zwei Anlagen für eine Maschine, wenn die Protokolle ihren Namen auf zwei Arten schreiben. Die erste Herausforderung der Batch-Verarbeitung besteht darin, Namenskonsistenz über Datensätze hinweg durchzusetzen, die nie mit Blick auf Konsistenz geschrieben wurden.
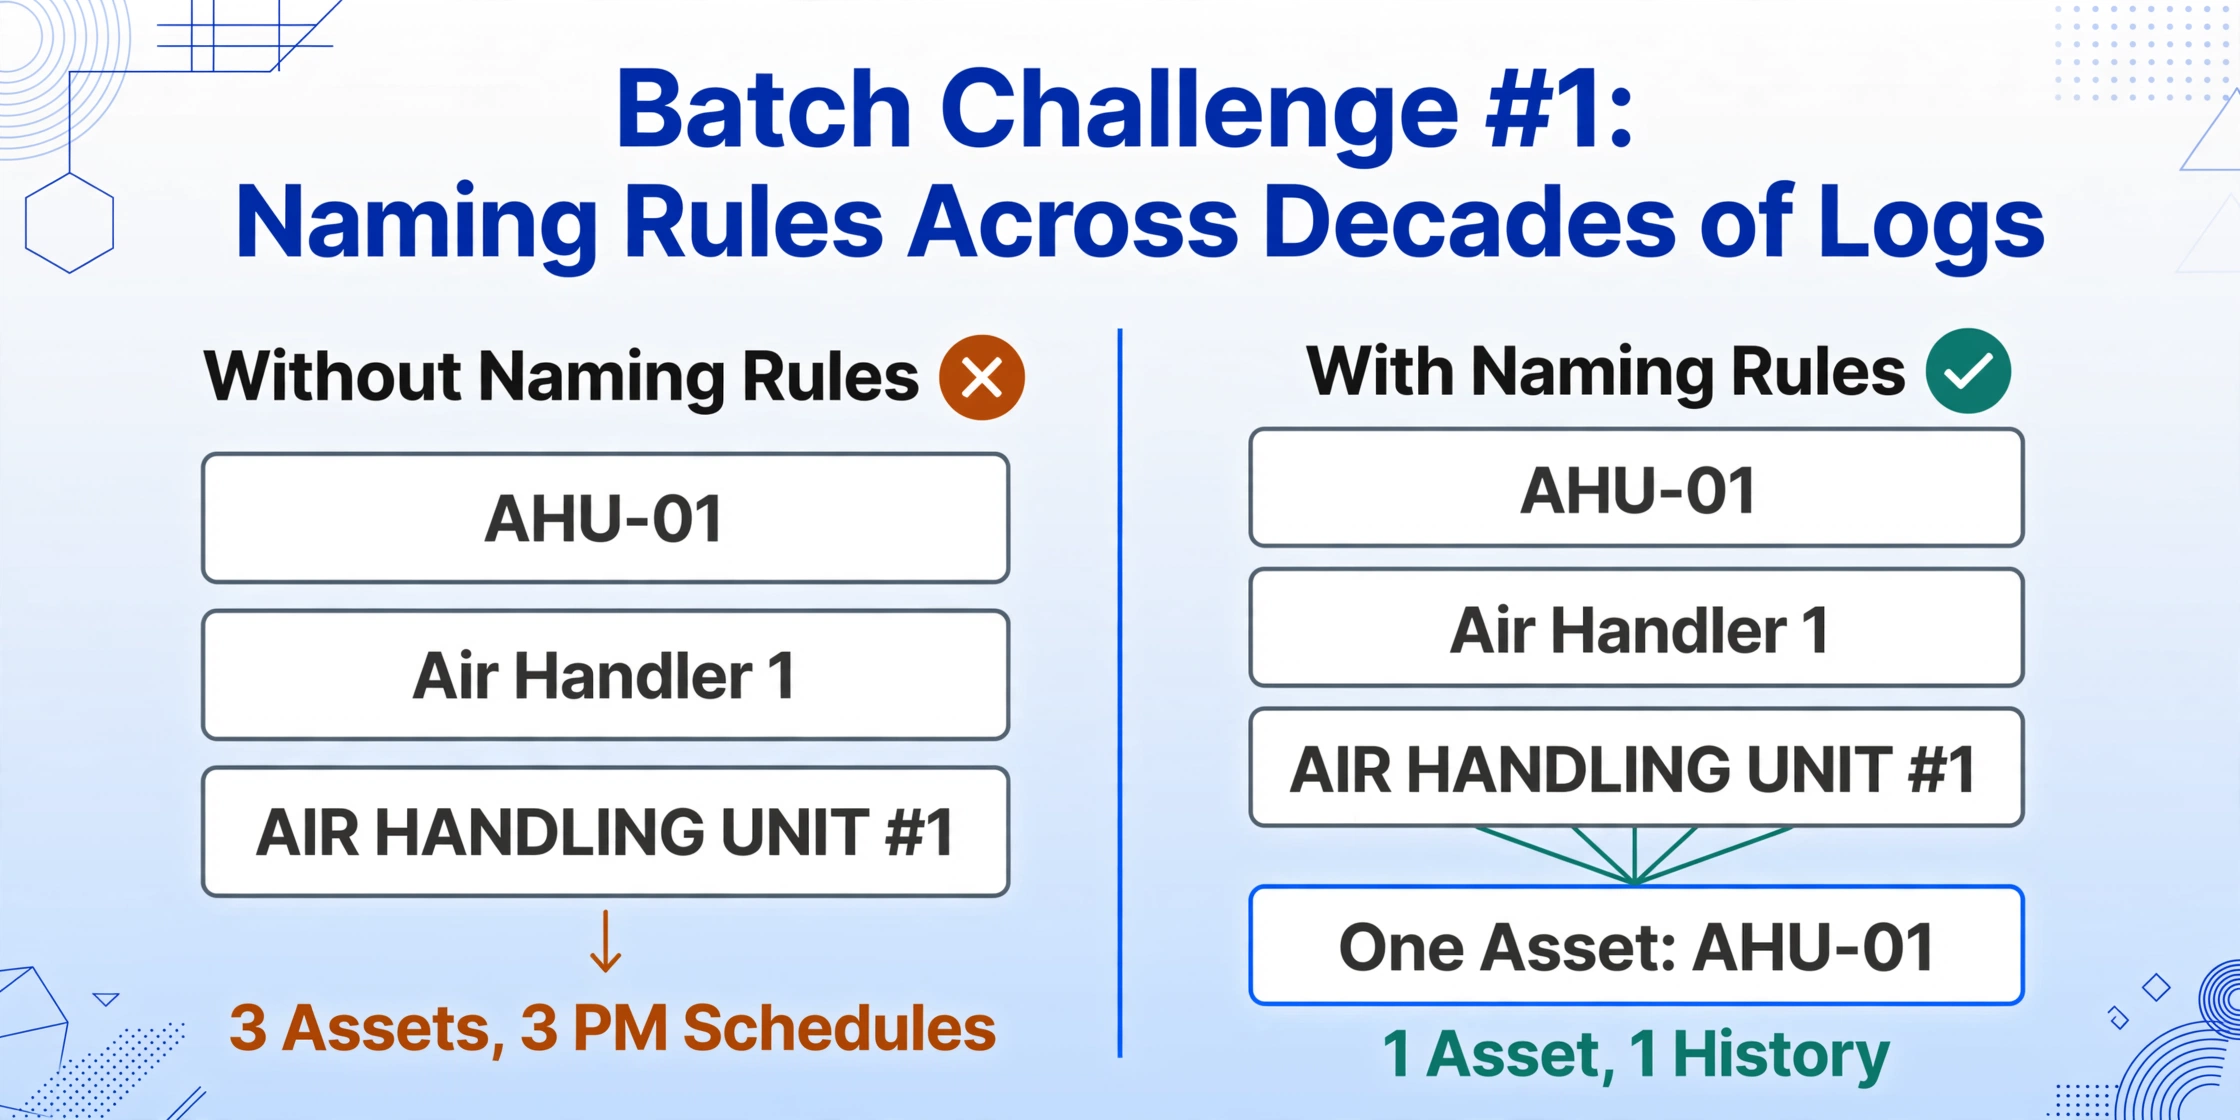
Dies ist das klassische Problem der „Geisteranlage". Ein Techniker schreibt „AHU-01" ins Logbuch; ein anderer schreibt „Air Handler 1"; eine PM-Checkliste des Herstellers sagt „AIR HANDLING UNIT #1". Alle drei sind dasselbe Dachgerät, aber ein CMMS-Import behandelt sie als drei Anlagen – drei Wartungshistorien, drei PM-Pläne, drei Ersatzteilaufzeichnungen. Die HLK-Migrationsleitfäden, die dies doch thematisieren, warnen, dass „AHU-01" und „Air Handler 1" dieselbe Anlage sind und vor dem Import dedupliziert werden müssen, denn konsistente Benennung verhindert genau dieses Problem. Es ist der Unterschied zwischen einem sauberen Import und einem System, das von Anfang an falsch startet.
Die Batch-Verarbeitung ist der Ort, an dem Namensregeln günstig durchgesetzt werden, weil man sie einmal definiert und auf jede Seite im Stapel anwendet. In einem Extraktions-Workflow benennt man die gewünschten Spalten – „Anlagen-ID", „Servicedatum", „Durchgeführte Aufgabe", „Verwendete Teile" – und die KI lokalisiert jeden Wert in jedem Protokoll, indem sie versteht, was das Feld bedeutet, statt eine feste Position auf der Seite abzugleichen. Das ist Benutzerdefinierte Spaltenextraktion, und sie ist formatunabhängig: Dieselben Spaltendefinitionen funktionieren auf gedruckten PM-Checklisten, handgeschriebenen Logbuchseiten und Handyfotos von Anlagenschildern, weil die Extraktion nach Bedeutung statt nach Layout liest.
Speziell für das Namensproblem übernimmt eine abgeleitete Spalte die Normalisierung während der Extraktion. Man fügt eine Spalte wie „Anlagen-ID (standardisieren auf Format: AHU-01, PUMP-02, CONV-03)" hinzu und die KI liest, welche Kennung auch immer auf jeder Seite erscheint – „Air Handler 1", „air handling unit #1", „AHU-1" – und gibt den standardisierten Code in jeder Zeile aus. Die Deduplizierung, die CMMS-Leitfäden als manuellen Bereinigungsschritt beschreiben, erfolgt im selben Durchgang wie die Extraktion, bevor die Daten die Importdatei erreichen.
Wenn Ihre Einrichtung in einer regulierten Branche tätig ist, gibt es hier einen Standard, an dem man sich orientieren kann. ISO 14224, der internationale Standard für die Erfassung und den Austausch von Zuverlässigkeits- und Wartungsdaten, wurde für den Öl- und Gassektor geschrieben, aber sein Kernmuster gilt überall: ein Mindestdatenset definieren, es in einem standardisierten Format erfassen und Fehlermodi getrennt von ihren Ursachen aufzeichnen. Selbst eine bescheidene Einrichtung kann sich diese Disziplin ausleihen – feste Anlagencodes, standardisierte Aufgabentypen, konsistente Datumsfelder – und sie auf Batch-Ebene durchsetzen, statt zu hoffen, dass jeder Techniker zufällig konsistent schreibt.
Batch-Herausforderung #2: Handschriftliche Seiten, Fotos und alte Tabellen in einer Tabelle zusammenführen
Das Zweite, was erst im großen Maßstab sichtbar wird, ist die Mischung der Formate. Ein Rückstand von drei Jahren ist selten ein einziges aufgeräumtes Format – es sind gedruckte PM-Checklisten in einem Ordner, ein Spiralnotizbuch mit handschriftlichen Einträgen, ein Ordner mit Handyfotos aus der Zeit vor einer Protokollregel und vielleicht eine alte Excel-Datei, die ein früherer Manager angelegt hat. Ein Einzeldokument-Tool zwingt dich, jedes Format anders zu behandeln. Batch-Verarbeitung ist genau der Workflow, um alle zusammen hochzuladen und die Ergebnisse in einer Tabelle zusammenzuführen – eine Zeile pro Protokolleintrag, über jeden Ordner, jedes Notizbuch, jeden Standort hinweg, unabhängig vom Quellformat.
Das Zusammenführen funktioniert, weil die Extraktion spaltenbasiert und nicht vorlagenbasiert ist. Definiere deine Spalten einmal – Asset-ID, Datum, Aufgabe, Betriebsstunden, Techniker, verwendete Teile, Befunde – und die KI liest jede Seite anhand derselben Definitionen. Ein handgezeichnetes Logbuch und eine gedruckte PM-Checkliste erzeugen Zeilen mit identischer Struktur, genau das, was ein CMMS-Importtemplate erfordert. Die Ausgabe landet in einer einzigen Tabelle, in der jede Zeile bereits die Form hat, die der Import erwartet.
Bei der Erfassung durch mehrere Techniker oder an mehreren Standorten ist das praktische Problem, die Seiten überhaupt erst zu sammeln. Ein Sammellink – ein teilbarer Upload-Link, mit dem jeder ohne Konto Dateien in deine Verarbeitungswarteschlange schieben kann – sammelt Fotos von jedem Techniker und jedem Standort an einem Ort, statt Logbücher durch die Einrichtung zu jagen. Ein Link, eine Warteschlange, ein Batch.
Probiere es mit einer Seite aus deinem eigenen Logstapel aus – keine Vorlage nötig, einfach hochladen und deine Spalten benennen:
Dateien werden sicher verarbeitet und nicht gespeichert.
Batch-Herausforderung #3: Was passiert, wenn eine Seite unlesbar ist
In einem Batch mit Hunderten von Seiten sind manche verschmiert, manche haben Kaffeeflecken und manche sind in einer Handschrift verfasst, die nur der Autor selbst lesen kann. Ein realistischer Batch-Workflow rechnet mit Ausnahmen – er tut nicht so, als würde jede Seite perfekt extrahiert.
Handschrift ist hier die ehrliche Einschränkung. Gedruckte Logbucheinträge und gemischte Formulare mit Druck und Handschrift werden zuverlässig extrahiert, weil die KI sich an den gedruckten Beschriftungen orientiert und die handschriftlichen Werte im Kontext interpretiert. Lesbare Druckschrift funktioniert gut. Schreibschrift, starkes Verschmieren und kontrastarme Fotos verringern die Genauigkeit. Die von ImageToTable.ai genannte 99-%-Genauigkeit bezieht sich auf gedruckte Tabellendaten; die Genauigkeit bei Handschrift hängt von der Lesbarkeit ab. Wer etwas anderes verspricht, ist nicht ehrlich zu Ihnen.
Was die Batch-Verarbeitung ändert, ist der Umgang mit den Ausnahmen. Statt drei Monate nach der Einführung des CMMS eine schlechte Seite zu entdecken, prüfen Sie die Batch-Ausgabe vor dem Import. Review-Modus lässt Sie über jede extrahierte Zelle fahren und die genaue Stelle im Original-Log sehen, aus der der Wert stammt – eine Bounding-Box auf dem Bild, damit Sie prüfen können, ob die KI die richtige Handschrift gelesen hat, und nicht, ob Sie dem Tool generell vertrauen. Ein gescannter Batch von 500 Seiten, dessen manuelle Prüfung Tage dauern würde, wird zur Stichprobenprüfung der markierten Zeilen, weil der Prüfschritt die relevanten Zellen gezielt ansteuert, statt jeden Tastendruck zu kontrollieren.
Für Seiten, die wirklich nicht lesbar sind: Fotografieren Sie sie bei besserem Licht neu oder lassen Sie sie aus dem Batch heraus und kennzeichnen Sie den Gerätedatensatz entsprechend. Ein ehrlicher Import, der ein paar unlesbare Einträge weglässt, ist besser als ein unehrlicher, der sie erfindet. Das CMMS merkt den Unterschied nicht; die Ausrüstung, für die es Wartungsarbeiten plant, schon.
Der Batch-Workflow: Vom Log-Stapel zur CMMS-Importdatei
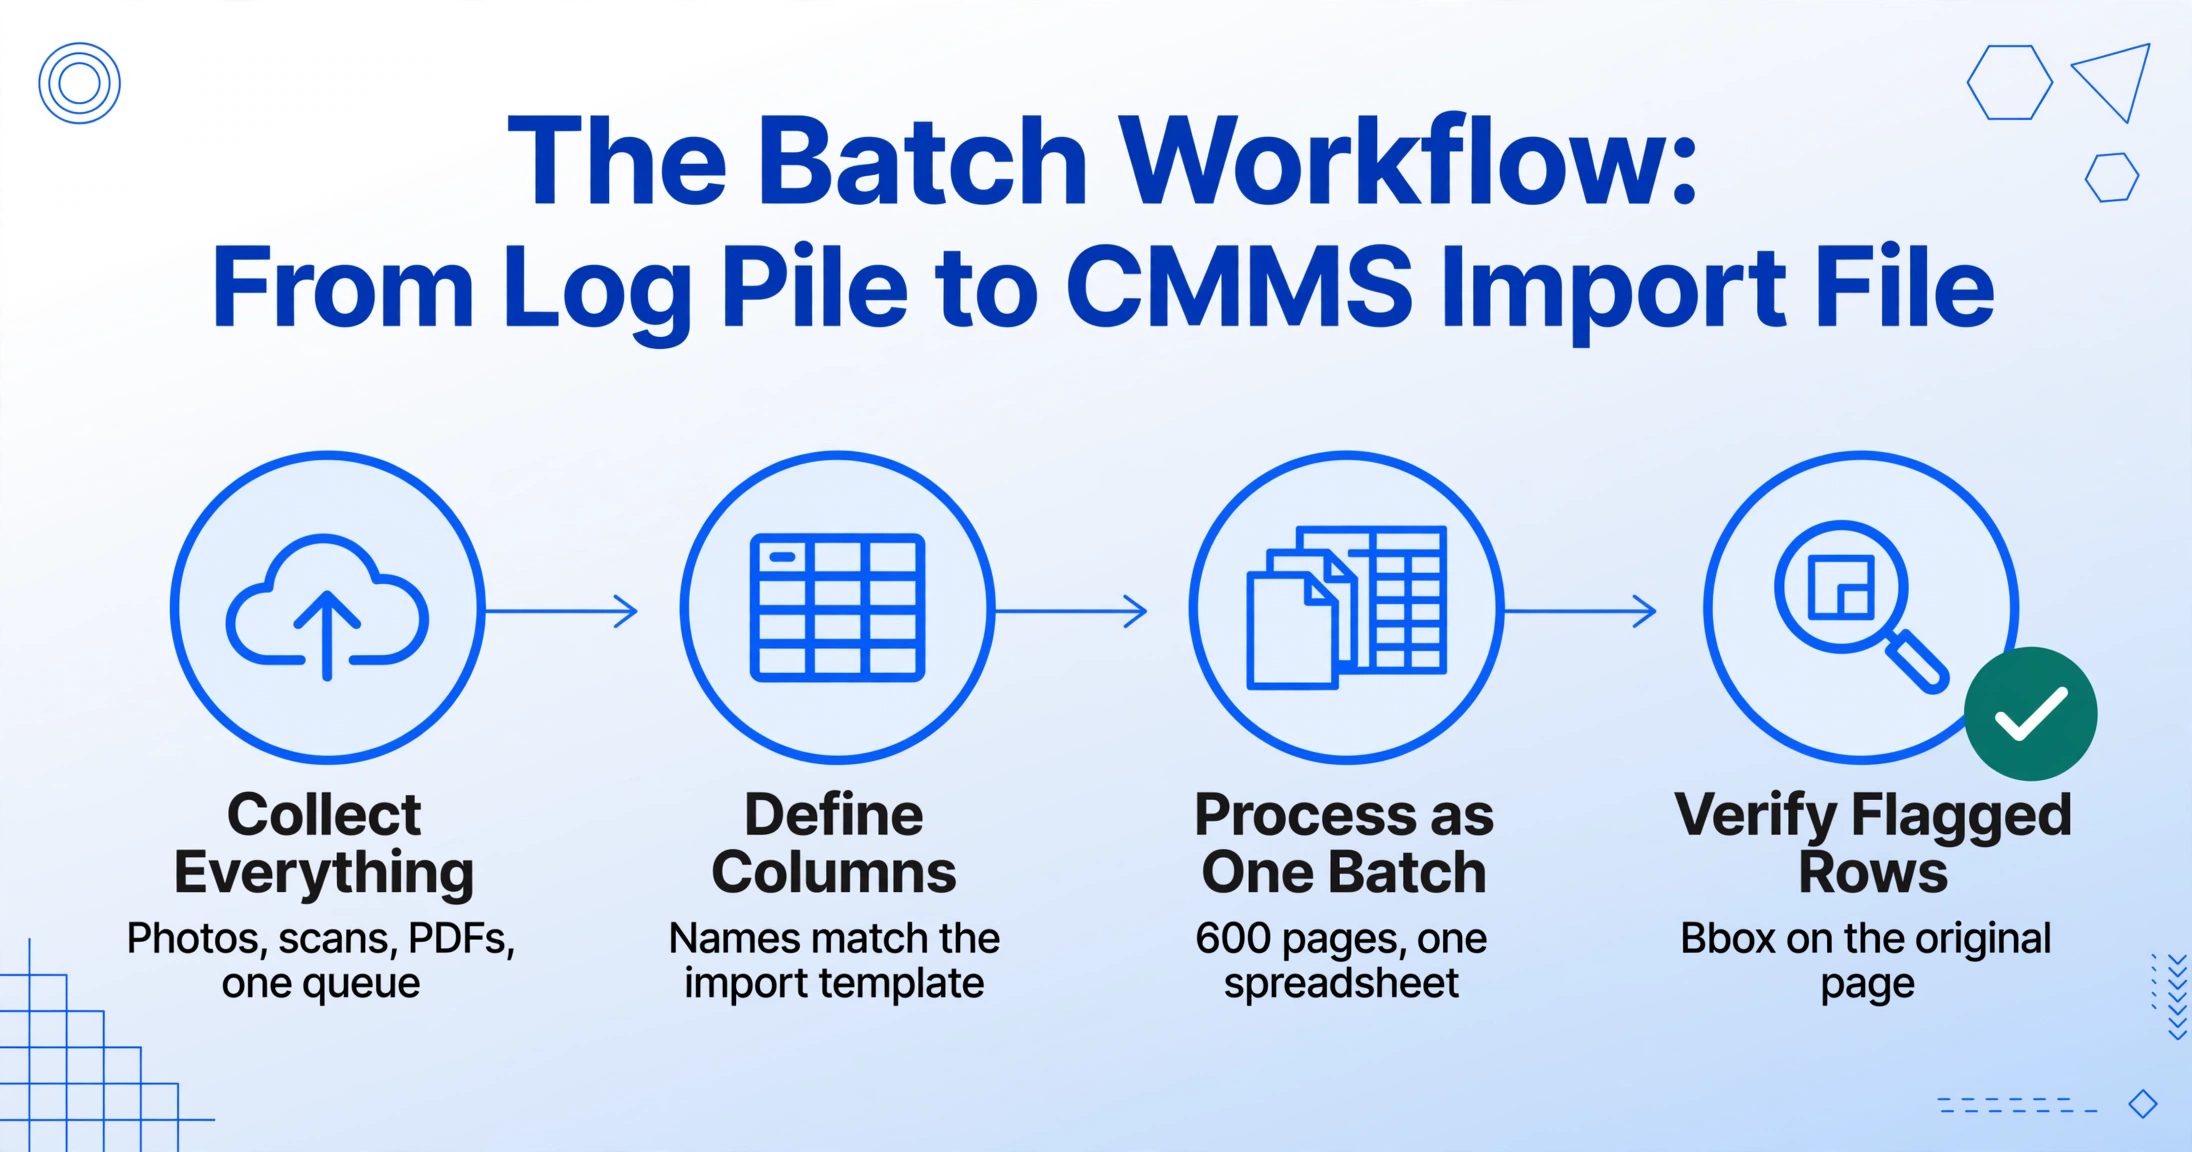
Hier ist der durchgängige Workflow, der alle drei Herausforderungen in einem Durchgang bewältigt – entwickelt für die Person, deren Go-live-Datum in drei Wochen ist und deren Logs in einem Ordner liegen.
Für Teams, die ihre tägliche Nachverfolgung bereits in einer Tabellenkalkulation statt in einem CMMS führen, speist derselbe Batch das Blatt, das sie bereits nutzen – die Foto-zu-Tabellenkalkulation-Pipeline funktioniert identisch, wenn das Ziel ein Tracking-Arbeitsbuch statt einer Importdatei ist. Und der Ausgangspunkt – ein einzelnes Log in strukturierte Zeilen zu verwandeln – ist der separat behandelte Schritt-für-Schritt-Extraktionsworkflow; dieser Artikel beschreibt, was passiert, wenn Sie diesen Workflow mit Hunderten von Seiten multiplizieren.
Was migriert und was archiviert werden sollte
Sie müssen nicht ein Jahrzehnt an Protokollen digitalisieren, um ein erfolgreiches CMMS-Go-live zu erreichen. Der Branchenkonsens liegt bei 12 bis 24 Monaten Wartungshistorie für kritische Anlagen – und die Disziplin, zu entscheiden, was außerhalb des Systems bleibt, ist Teil der Sauberkeit der Daten, die hineinkommen.
Die Versuchung, alles zu migrieren, ist verständlich – die Daten sind wertvoll, und das Verwerfen von Historie fühlt sich verschwenderisch an. Aber ein CMMS mit 10 Jahren inkonsistenter Aufzeichnungen schneidet schlechter ab als eines mit zwei Jahren sauberer Daten. Die CMMS-Implementierungsempfehlungen raten durchgängig dazu, etwa die letzten 12 bis 24 Monate Wartungshistorie zu migrieren, den Rest als schreibgeschützte Referenz zu archivieren und die kritischsten 20 % der Anlagen zuerst zu priorisieren – die 80/20-Regel, die die wichtigsten Anlagen mit höchster Datenqualität ins System bringt, statt eines gleichmäßig flachen Imports von allem.
Die Batch-Verarbeitung unterstützt diese Phaseneinteilung natürlich: Sie können zuerst die Logbücher der kritischen Anlagen als sauberen Batch ausführen, sie verifizieren, importieren und pünktlich live gehen – dann die restlichen Anlagen in Folge-Batches verarbeiten. Das Go-live wartet nicht auf den gesamten Rückstand; der gesamte Rückstand wird zu einer Reihe von Batches statt zu einem überwältigenden Projekt.
Hier zeigen sich auch die Datenqualitäts-Risiken. ISO 55001:2024, der zertifizierbare Standard für Asset-Management-Systeme, behandelt dokumentierte, zuverlässige Asset-Informationen als Kernanforderung – die Revision von 2024 hat den Schwerpunkt auf Datenqualität und Wissensmanagement verstärkt. Das SMRP-Best-Practices-Kompendium, die 70+ Standardkennzahlen der Wartungsbranche, kann ohne strukturierte Historie überhaupt nicht berechnet werden: geplanter Wartungsanteil, PM-Compliance, mittlere Betriebsdauer zwischen Ausfällen – jede einzelne Kennzahl ist eine Abfrage über saubere, konsistente Zeilen. Schlechte oder fehlende Historie sieht nicht nur in einem Audit schlecht aus; sie macht das gesamte Messprogramm unberechenbar.
FAQ
Wie viele Wartungsprotokollseiten kann ich realistisch auf einmal stapelweise verarbeiten?
Die Stapelverarbeitung ist auf Volumen ausgelegt – laden Sie Hunderte von Seiten in einem Batch hoch, und die KI verarbeitet sie gemeinsam zu einer einzigen zusammengeführten Tabelle. Die praktische Obergrenze liegt auf der Ausgabeseite: Die meisten CMMS-Importe begrenzen Uploads auf 2.000 Zeilen (Limble und UpKeep tun dies beide). Für sehr große Rückstände teilen Sie den Export in Blöcke unter dem Limit auf. Ein zweijähriger Rückstand, für dessen Abtippen ein Sachbearbeiter eine Woche bräuchte, wird zu einem einzigen Nachmittag Verarbeitung und Prüfung.
Erkennt die Extraktion unsere handschriftlichen Protokolle genau genug für ein CMMS?
Lesbare Handschrift wird zuverlässig extrahiert – insbesondere Blockschrift und getrennte Zeichen. Gemischte gedruckte und handschriftliche Formulare funktionieren gut, da die KI sich an gedruckten Beschriftungen orientiert und die Werte im Kontext liest. Kursivschrift, starke Verschmutzungen und kontrastarme Fotos verringern die Genauigkeit. Deshalb gibt es den Prüfschritt: Sie überprüfen markierte Zellen gegen die Originalseite, statt jedem Wert blind zu vertrauen. Für ein compliance-pflichtiges System wie ein CMMS ist diese Prüfung der richtige Kompromiss – sie ist viel schneller als manuelle Übertragung und fängt die entscheidenden Fehler ab.
Unser CMMS hat eine eigene Importvorlage. Entspricht die extrahierte Tabelle dieser?
Ja, denn Sie kontrollieren die Spaltennamen. Benutzerdefinierte Spaltenextraktion verwendet die von Ihnen eingegebenen Namen als Ausgabeüberschriften. Sie benennen Ihre Spalten also passend zur CMMS-Importvorlage – Asset-ID, Abgeschlossen am, Aufgabenbeschreibung usw. Datums- und Zahlenstandardisierung erfolgt während der Extraktion, sodass die Zeilen im erwarteten Importformat ausgegeben werden, nicht in dem Format des Logbuchs.
Unsere Protokolle sind eine Mischung aus gedruckten Formularen, handschriftlichen Seiten und alten Tabellen. Brauchen wir für jede einen anderen Prozess?
Nein. Da die Extraktion spaltenbasiert und nicht vorlagenbasiert ist, funktionieren dieselben Spaltendefinitionen für gedruckte Checklisten, handschriftliche Logbuchseiten und Handyfotos. Alte digitale Tabellen, die Sie bereits haben, können als PDFs exportiert und in denselben Batch aufgenommen werden, wodurch auch deren Formatierung in dieselbe Ausgabestruktur normalisiert wird.
Wie vermeiden wir doppelte Assets nach dem Import?
Zwei Ebenen: Zuerst fügen wir während der Extraktion eine abgeleitete Spalte hinzu, die Asset-Identifikatoren standardisiert – die KI liest „AHU-01", „Air Handler 1" und „air handling unit #1" und gibt einen einheitlichen Code pro Zeile aus. Zweitens führen wir vor dem Import eine schnelle Pivot-Analyse der extrahierten Asset-ID-Spalte durch, um sicherzustellen, dass jede Zeile einem vorhandenen Asset zugeordnet ist. Beides dauert nur Minuten und verhindert das Geister-Asset-Problem, das die Wartungshistorie an der Quelle beschädigt.
Ersetzt dies das CMMS selbst?
Nein – es speist das CMMS. Die Extraktion wandelt die historischen Protokolle in die strukturierte, saubere Tabelle um, die jeder CMMS-Import erfordert. Es löst den Schritt, den die Anbieter Ihnen überlassen: Jahre aus Papier und Fotos in importierbare Zeilen zu verwandeln. Sobald die Historie drin ist, übernimmt das CMMS Planung, Arbeitsaufträge und Berichterstattung genau wie vorgesehen.
Die Erkenntnis, die Sie in Ihre Migration mitnehmen sollten, ist diese: Ein CMMS ist nur so gut wie die Historie, die Sie ihm geben, und die Historie ist nur so gut wie der Batch, der sie digitalisiert hat. Die Import-Limits und Vorlagen Ihres Anbieters sind nicht der schwierige Teil – der schwierige Teil ist der Stapel Protokolle im Ordner, und genau dieser Teil ist es, den ein Batch-Workflow beseitigen soll.