レシートデータを抽出する方法
フォーマットがすべて異なる場合
Upworkの調査によると、2023年には6,400万人のアメリカ人(労働力の38%)がフリーランスとして働き、経済に1.3兆ドルを貢献しました。r/Bookkeepingやr/smallbusinessなどのフォーラムでは、同じ不満が繰り返し見られます。レシートのデータ入力は終わりのない経理作業です。r/smallbusinessのあるRedditユーザーは率直にこう述べています。「一番の頭痛の種は請求書です。とにかく…全部です。メールから取り出して、詳細を帳簿に入力して、追跡して。ひどいものです。」経費追跡プラットフォームが集計した業界データによると、フリーランスはレシートの整理に月4〜6時間を費やしており、さらに薄れた感熱紙や誤って保管されたフォルダで失われた分は含まれていません。問題はレシート抽出ツールが存在しないことではありません。ほとんどのツールが、すべてのレシートは同じ見た目だと想定していることです。
主なポイント
- 同じようにレシートを印刷する店舗は2つとしてなく、あなたのスプレッドシートのためにレイアウトを標準化してくれる店舗は皆無です。
- 20店舗 × テンプレート設定15分 = 5時間の設定作業 — しかも作成したテンプレートは、その店舗がPOSシステムを更新した瞬間に使えなくなります。
- セマンティック抽出は、テキストがどこにあるかではなく、何を意味するかを読み取ります。そのため、1組の列名で「合計」「日付」「店舗」をあらゆるレシートフォーマット上でテンプレートなしに自動的に見つけ出します。
レシートテンプレートが必ず破綻する理由 — そしてそれが想像以上に重要な理由
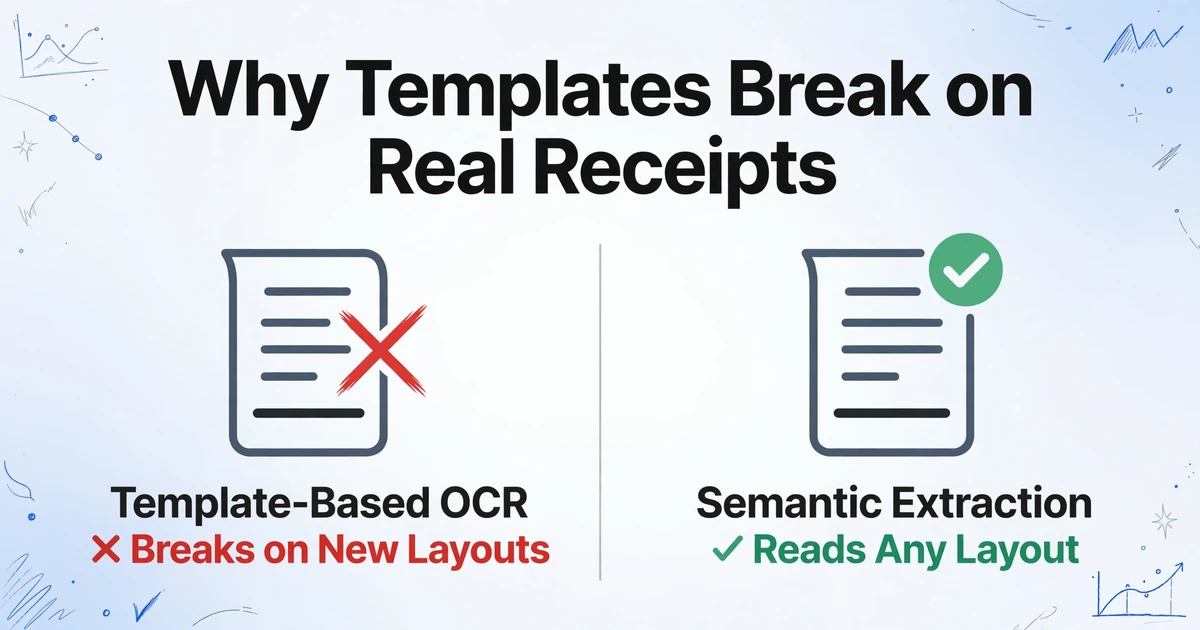
店舗ごとにレシートの印刷形式は異なります。これは些細な不便ではなく、ほとんどのレシート抽出ツールが一貫しない結果を生む根本原因です。Walmartのレシートは、SKU別の明細、途中の小計、下部のバーコードを備えた長い縦長の帯です。地元の喫茶店は、短縮された店名、税の内訳なし、QRコード付きの3インチのSquareレシートを印刷します。レストランのレシートには明細行、チップ欄、時には推奨チップ表があります。Home Depotのレシートは、請負業者向け価格、ジョブ番号、返品ポリシーの文言が記載された2フィートにわたる紙です。これらの形式はどれも互いに似ていません。
テンプレートベースの抽出 — ほとんどの従来型OCRツールが採用するアプローチ — は、ページ上のどこにデータがあるかを記憶することで機能します。1つのHome Depotレシートのレイアウトで学習させると、「合計は右下隅にある」と学習します。次に、合計が中央左にあるWalmartのレシートを投入すると、テンプレートは破綻します。利用する店舗ごとに個別のテンプレートが必要になり、その店舗がPOSシステムを更新するたびにテンプレートはまた壊れます。r/Bookkeepingのあるユーザーは、レシートのデータ入力に関するスレッドでこの不満をこう表現しています。「カード支出ツール:docyt、divvy、Expensify、dext — これらの多くはあなたが探している機能を備えています。」この推奨リストは示唆的です。ユーザーは5つの異なるツールを行き来しています。どれも形式の多様性の問題を単独できれいに処理できないからです。
形式の多様性はニッチな例外ではありません。15の異なるサプライヤー — さらにガソリンスタンド、金物店、オフィス用品チェーン、オンラインマーケットプレイス — で買い物をする中小企業の経営者は、毎月15〜25種類の異なるレシートレイアウトに遭遇します。それぞれが日付、合計、税、店名、明細行を異なる配置で示しています。テンプレートベースのアプローチはこの現実に対応できません。設定した3店舗では機能しますが、残りの12店舗では失敗します。
形式の多様性の問題は構造的なものであり、技術的なものではありません。 OCRの精度が十分でないのではなく、位置ベースのアプローチがすべてのレシートを同じレイアウトの変種として扱うことが問題です。しかし実世界のレシートは変種ではありません。共通の座標系を持たない、何百もの異なるPOSシステムによる独立して設計されたドキュメントなのです。
セマンティック抽出が従来とどう違うのか — そして、なぜあらゆるレシートを読み取れるのか
レイアウトに一切依存しない、根本的に異なるレシート抽出のアプローチがあります。それはセマンティック抽出と呼ばれ、人間がレシートを読むのと同じように機能します。つまり、各テキストがどこにあるかではなく、何を意味するかを理解するのです。
レシートを見るとき、あなたは座標を探しているのではありません。意味を探しているのです。「下部近くにあり、ドル記号が付いていて、その上に『Total』という言葉がある数字 — それが合計だ」と。AIを活用したセマンティック抽出も同じことを行います。特定のレシートレイアウトでトレーニングされるのではなく、文書タイプとしてのレシートの言語と構造を理解するようトレーニングされています。「Subtotal」「Tax」「Total」「Change Due」「Payment Method」が標準的なレシートの概念であることを認識します。日付は日付、金額は金額、店舗名は通常上部にあることを理解しています。レシートを読むのです — 単にOCRするだけではありません。
これを可能にするのがカスタム列抽出です。スプレッドシートに必要な列を定義します — 「Merchant」「Date」「Total」「Tax」「Category」— するとAIは、それらの列名の意味を理解することで、各レシート上の各値を特定します。抽出は、「Total」がHome Depotのレシートの右下にあるか、Walmartのレシートの中央左にあるかを気にしません。位置ではなく意味で「Total」を見つけます。このアプローチはテンプレート不要です。どの店舗のテンプレートも作成・維持する必要はありません。列名を一度設定すれば、あらゆる店舗、あらゆるPOSシステム、あらゆるフォーマットの、処理するすべてのレシートで機能します。
テンプレートベースのOCRとの対比は、何かがどこにあったかを覚えることと、何かが何であるかを理解することの違いです。テンプレートベースのツールはこう言います。「合計は座標(450, 820)にあります」。セマンティック抽出はこう言います。「合計は『Total』という言葉の前にドル記号が付いた数字です — このページのどこにあっても見つけ出します」。2番目のアプローチはフォーマットの変更に耐えます。1番目のアプローチは何も耐えられません。
テンプレート不要のレシート抽出の仕組み — ステップバイステップ
テンプレートを使わずにレシートデータをスプレッドシートへ抽出するワークフローは、セットアップ工程がない分、テンプレート方式よりもシンプルです。ここでは、その全体の流れを説明します。
ステップ1: レシートをアップロードします。紙のレシートの写真、PDF、メールのレシートのスクリーンショット、またはそれらを混在させたものをドロップします。バッチアップロードに対応しているため、15の異なる店舗からの50枚のレシートなど、1ヶ月分を一度にアップロードできます。このツールはJPG、PNG、PDF、WebPに対応しているので、スマートフォンで写真を撮る場合でも、メールの添付ファイルを保存する場合でも、フォーマット変換の手間はありません。
ステップ2: 抽出したい内容を定義します。ここで、テンプレートの代わりにカスタム列抽出を使用します。店舗ごとにレイアウトルールを作成する代わりに、必要なものに一致する列名を入力します。レシート抽出の場合、一般的な列セットは次のようになります:
- 販売元 — 店舗またはベンダー名
- 日付 — 取引日
- 合計 — 支払われた最終金額
- 税額 — 消費税額(別途表示されている場合)
- 支払い方法 — 現金、クレジット、デビット
- カテゴリ — 経費カテゴリ(オプション: 事務用品 / 食事 / 出張 / 備品 / 光熱費 / その他)
最後の列 — カテゴリ — は、推論列と呼ばれる機能を使用します。AIがレシートの内容を読み取り(レストランのレシートには食べ物の品目が、Office Depotのレシートには事務用品が表示されます)、「カテゴリ」というラベルのフィールドがどのレシートにもないにもかかわらず、自動的に正しいカテゴリを割り当てます。つまり、抽出と分類が1回のパスで行われ、データをスプレッドシートに抽出してから各行を手動で分類する必要はありません。
ファイルは安全に処理され、保存されません。
ステップ3: 確認してエクスポートします。AIが各レシートを処理し、スプレッドシートの列に入力します。結果はテーブルに表示され、必要に応じて確認・修正し、Excel(XLSX)、CSV、またはJSONとしてエクスポートできます。スプレッドシートの各行は1つのレシートに対応し、各列は定義したフィールドの1つに対応します。販売元名、日付、合計、税額、支払い方法、自動分類されたカテゴリ — すべて、テンプレートに触れたり、セルを1つも手入力することなく入力されます。
1ページの処理には約5〜10秒かかります。これは、レシートを探す時間、スプレッドシートを開く時間、各フィールドを入力する時間、元のレシートと照合する時間を含めると1枚あたり平均約3分かかる手入力と比べて、およそ18倍高速です。
あらゆるレシートから抽出できるデータと、抽出できないデータ
セマンティック抽出は、ほとんどのレシートに記載されている標準的なフィールドを読み取ります。以下が確実に抽出できる項目と、実際の限界です。
常に抽出可能: 加盟店名、取引日、支払総額、支払い方法(印字されている場合)、消費税(別行で記載されている場合)。これらのフィールドはほぼすべてのレシートに存在し、日付は日付らしく、金額は金額らしく、加盟店名は常に文書の上部にあるというセマンティックなパターンによって一貫して認識できます。
通常抽出可能: 明細項目(商品説明、数量、単価、明細合計)。明細項目の精度はレシートの印字品質に依存します。明確な行形式で印字された全国チェーンの鮮明なレシートは高い精度で抽出できます。AIは各行を独立した単位として読み取り、数量を説明や価格と照合します。7-Elevenの色あせた感熱レシートで商品説明が8文字に切り詰められている場合、明細項目の抽出精度は低下します。これは正直に認めるべき限界です。抽出精度は元画像の品質に左右され、感熱紙の劣化はソフトウェアの問題ではなく物理的な問題なのです。
推論列で抽出可能: 経費カテゴリ、業務目的フラグ、業者タイプ分類。これらはレシートに印字されておらず、AIがレシートの内容から推論します。Shellのレシートで燃料購入があれば「旅費」に分類されます。Staplesのレシートで事務用品の明細があれば「事務用品」に分類されます。レストランのレシートで食事の購入があれば「食事」に分類されます。計算列は抽出中に計算を実行することもできます。例えば、小計から合計を差し引いてチップ額を計算したり、明細の合計が印字された合計と一致するかを照合したりできます。
確実には抽出できないもの: 色あせたレシートへの手書きのチップ、テキストが物理的に欠落している破れたレシート、文字が判読できないほど丸められたレシート。AIは従来のOCRよりも手書きをうまく処理できます。テンプレートベースのツールでは処理できない手書きの合計や加盟店メモも読み取りますが、存在しないテキストを復元することはできません。40%物理的に破損したレシートでは60%の抽出しかできません。出力では不完全なフィールドにフラグが立てられ、どのレシートに手動でのフォローアップが必要かがわかります。
バッチ処理:20店舗の混在レシートを1つのスプレッドシートに
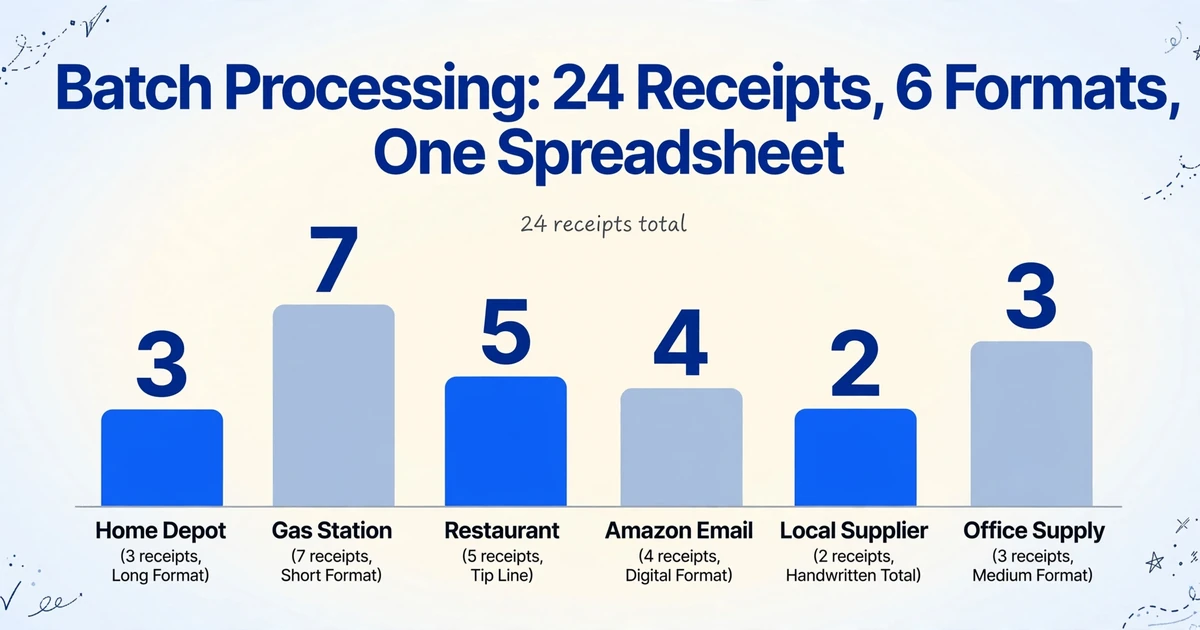
フォーマットの多様性の問題は、レシートをまとめて処理するときに最も顕著になります。1か月分の経費には次のようなものが含まれるかもしれません:Home Depotのレシート3枚(長いフォーマット、請負業者向けレイアウト)、ガソリンスタンドのレシート7枚(短いフォーマット、税の内訳なし)、レストランのレシート5枚(チップ欄付きの明細行)、Amazonのメールレシート4枚(デジタル、整ったフォーマット)、地元サプライヤーのレシート2枚(手書きの合計)、オフィス用品のレシート3枚(中程度のフォーマット、項目別)。これは6つの異なるレイアウトファミリーにまたがる24枚のレシートであり、各ファミリー内でも個々の店舗が独自のバリエーションを持つ場合があります。
バッチ処理とは、これらのレシートをすべて一度に処理し、1つの統合されたスプレッドシートを取得する機能です。フォルダ全体をアップロードし(24枚のレシートすべてを1回のドラッグアンドドロップで)、列名を一度定義するだけで、AIが各レシートを個別に処理し、フォーマットに関係なくすべてに同じ意味抽出ロジックを適用します。出力は1つのExcelファイルで、各行がレシート、各列が定義したフィールドであり、元のレシートのフォーマットは抽出の品質に影響しません。
このバッチ機能はレシート処理の経済性を変えます。24枚のレシートを手作業で1枚3分かけて処理すると72分かかります。意味抽出を使ったバッチ処理では、アップロードと確認に約2~4分かかります。節約効果は毎月積み重なります:月100枚のレシートを処理する小規模事業者は、1年間で約55時間を節約でき、レシートのデータ入力からほぼ7営業日分を取り戻せます。
複数の人からレシートを集める必要がある事業者——経費レシートを提出する従業員、現場の購入レシートを送る請負業者、書類を提供する顧客——にとって、コレクションリンクはメールのやり取りを不要にします。共有可能なリンクを生成し、レシートを提出する必要がある人に送ると、そのアップロードは直接処理キューに入ります。提出者はアカウントを必要としません。リンクを開き、短い確認コードを入力してアップロードするだけです。すべてのレシートがあなたのバッチに入り、同じ列定義が適用された同じスプレッドシートに処理される準備が整います。
バッチ処理がフォーマットの多様性をどう扱うか
| レシートの取得元 | フォーマットタイプ | テンプレート方式 | セマンティック方式 |
|---|---|---|---|
| Walmart | 縦長のストリップ型、SKUレベル | Walmart専用テンプレートが必要 | フィールドの意味で読み取る — テンプレート不要 |
| 地元のコーヒーショップ(Square POS) | 短い省略名 | Square専用テンプレートが必要 | フィールドの意味で読み取る — テンプレート不要 |
| レストラン | 明細行+チップ欄 | レストラン専用テンプレートが必要 | フィールドの意味で読み取る — テンプレート不要 |
| Home Depot(Pro) | 長いフォーマット、ジョブ番号付き | Home Depot専用テンプレートが必要 | フィールドの意味で読み取る — テンプレート不要 |
| Amazon(メールPDF) | デジタル請求書レイアウト | Amazon専用テンプレートが必要 | フィールドの意味で読み取る — テンプレート不要 |
| 手書きの仕入先レシート | 不規則・可変レイアウト | テンプレートは不可能 — 完全に破綻 | 手書き+フィールドの意味を読み取る |
レシートデータをIRS対応にする:ルールが実際に求めるもの
レシートデータをスプレッドシートに入れることは、方程式の半分にすぎません。残りの半分は、必要になったときに記録がIRSの審査に耐えられるようにすることです。多くの小規模事業主は、IRSが1997年からデジタルレシートを公式に認めていることを知りません — そして、そのルールは一般に信じられているよりもずっとシンプルです。
IRS Publication 463(旅費・贈答費・自動車費)とIRS Revenue Procedure 97-22がその枠組みを定めています。デジタルレシート — スキャンコピー、スマホでの撮影、メールのレシートを含む — は、読み取れ、完全で、必要な保存期間中に取り出せる限り、紙の原本と同じ法的効力を持ちます。標準的な保存期間は申告日から3年間で、所得が25%以上過少申告された場合は6年間、貸倒れや無価値証券に関する請求は7年間に延長されます。
有効なレシートには何が記載されている必要があるのでしょうか?5つの要素です:販売者名、取引日、支払金額、購入内容の説明、そして(判別できる場合)支払方法。業務用の食事については、業務目的と、同席者の氏名および業務上の関係も必要です。$75ルール — Treasury Regulation § 1.274-5(c)(2)(iii) — は、$75以上の経費には証拠書類が明示的に必要であり、クレジットカード明細書だけでは業務経費を証明するのに不十分であると定めています。$75未満でも記録は必要ですが — 経費ログやカレンダーへの記載で足りる場合があります — 書類の負担は軽くなります。
実用的な結論: レシートデータをスプレッドシートに抽出することは、単に時間を節約するだけではありません。IRSが求める「経費の発生日と同時期またはその前後に」作成された文書という要件を満たす、同時期のデジタル記録を作成することでもあります。業者名、日付、金額、説明、カテゴリを含むスプレッドシートの行と、元のレシートのデジタルコピーがあれば、まさにIRSが求めているものになります。色あせた感熱紙のレシートが詰まった靴箱は、まさにそうではありません。
テンプレート不要のレシート抽出にかかるコスト — そして何を置き換えるのか
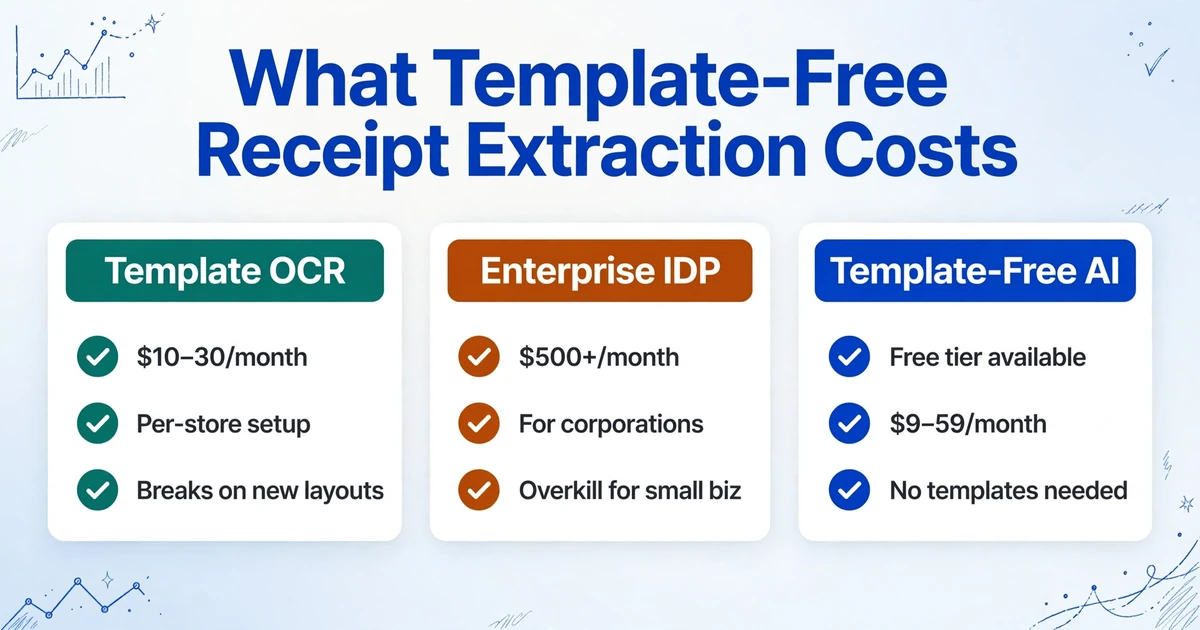
レシート抽出ツールは幅広い価格帯に存在し、その違いは基盤となる技術に対応しています。テンプレートベースのOCRツールは、多くの場合、より低い価格帯(月額$10〜$30)から始まりますが、店舗ごとのテンプレート設定が必要で、その設定時間が節約分を食いつぶしてしまいます。エンタープライズIDPプラットフォーム(Intelligent Document Processing)は月額$500以上かかることもあり、専任の導入チームを持つ企業向けに設計されており、月に80枚のレシートを処理する個人事業主向けではありません。
テンプレート不要のAI抽出ツールは、別のカテゴリに属します。たとえばImageToTable.aiは、ご自身のレシートで抽出をテストできる無料プランを提供しており、その後は月額$9(Basic)、月額$19(Pro)、月額$59(Max)の有料プランがあります。クレジット制なので、使わない定額サブスクリプションではなく、処理した分だけ支払うことになります。
損益分岐点の計算は、一度やってみる価値があります。手作業のレシート処理に月4時間を要し、時給$32.23(2026年4月時点のBLSの米国平均賃金)とすると、毎月$129分の時間を使っていることになります。これを30分に短縮する月額$9のツールは、レシートを紛失しなくなったことで見逃さなくなる控除を考慮する前の時点で、人件費だけで毎月$97を節約できます。月100枚のレシートであれば、人件費、取り戻した控除、CPAの準備時間の削減による年間節約額は、通常$1,500〜$3,000に達します。
これは会計ソフトを置き換える話ではありません。QuickBooks、Xero、Waveは、引き続き帳簿の本拠地です。ExpensifyとDextは、経費精算のワークフローとレシートから会計への同期を担います。テンプレート不要の抽出は、それらすべての手前にあるギャップを埋めます。つまり、レシートの写真を、下流のツールが取り込める構造化データに変換するのです。これは、下流のすべてを速くする入力ステップです。
レシート抽出は記帳の代替ではありません。それは、すべてのレシート、毎月、毎年積み重なる手動データ入力の30秒のマイクロトランザクションの代替です。テンプレートベースのツールが排除できない目に見えないコストであり、その理由はフォーマットの多様性という問題がアーキテクチャに組み込まれているからです。
レシート抽出に関するよくある質問
色あせた感熱紙レシートでも抽出は機能しますか?
色あせの程度によります。感熱紙は通常の保管条件下で6〜12か月かけて劣化します。熱、日光、さらにはバインダーのプラスチックカバーも色あせを加速させます。文字が肉眼でかすかに見える程度であれば、AI抽出が読み取れることがよくあります。モデルが従来のOCRよりも高い解像度で視覚パターンを解釈するためです。レシートが完全に真っ白になっている場合、もはや存在しないテキストを復元できるソフトウェアはありません。回避策は簡単です。感熱紙が劣化する前に、レシートを受け取ったらすぐにデジタル化(写真撮影またはスキャン)してください。デジタル化されれば、データは永続的に残ります。
レシートからの明細項目抽出の精度はどのくらいですか?
明細項目の精度は、レシートの品質とレイアウトの複雑さによって異なります。大手小売店の整った明細グリッド形式のクリーンなレシートは、明瞭に印刷されたテキストで95%〜99%の高い精度で抽出されます。コンビニエンスストアのPOSシステムによる8文字の略称商品名、複数列レイアウト、物理的な損傷があるレシートは精度が低くなります。抽出は同じバッチ内で混合形式を処理します。高品質のレシートはほぼ完璧に抽出され、低品質のレシートはレビュー用にフラグが立てられます。バッチ全体を受け入れるか拒否するかを強制されることはありません。個々の行は、残りを再処理することなく修正できます。
レシート抽出で税務目的の経費を自動分類できますか?
はい、推論列を使用して可能です。プリセットオプション(例:「飲食費/旅費/事務用品/設備費/光熱費/その他」)を持つカテゴリ列を定義すると、AIが各レシートの内容を読み取り、適切なカテゴリを割り当てます。レストランのレシートは「飲食費」、ガソリンスタンドのレシートは「旅費」、Staplesのレシートは「事務用品」になります。これは簿記担当者やCPAの判断を置き換えるものではありません。境界事例は存在します(クライアントとの食事は「飲食費」か「マーケティング費」か?)。最終的な分類判断はお客様に委ねられます。しかし、手作業の時間の大部分を占める、カテゴリが明確なレシートの80%を処理します。
10種類の異なる店舗からのレシートを1つのバッチで処理できますか?
はい — それがテンプレート不要の抽出の中心的なユースケースです。Walmart、Home Depot、Amazon、お近くのコーヒーショップ、Shell、Staples、レストラン、手書きの仕入先レシート、そして他の3つの店舗からのレシートを1つのバッチでアップロードしてください。列名を一度定義するだけで、AIがどの店舗が発行したかにかかわらず、すべてのレシートから同じフィールドを抽出します。出力は、レシートごとに1行が入った1つのスプレッドシートで、10以上のフォーマットすべてからデータが入力されます。
IRSはデジタルコピーのレシートを受け入れますか?
はい、1997年から受け入れています。IRS Revenue Procedure 97-22は、デジタル記録を紙の原本と法的に同等と正式に認めました。スキャンしたレシート、スマートフォンで撮影した写真、メールのレシートのPDFはすべて、紙の原本と同じ効力を持ちます — 読みやすく、完全で、必要な保存期間(通常3年、状況によっては最長7年)を通じて取得可能であることが条件です。必要な5つの要素は、販売者名、日付、金額、説明、および(該当する場合)支払い方法です。5つの要素すべてのスプレッドシート抽出を元のレシート画像と一緒に保存すれば、文書化基準を上回ります。
すべてのレシートをテンプレート問題として扱うのをやめると何が変わるか
実際のレシートのフォーマットの多様性はなくなりません。すべてのPOSシステムは異なる方法で印刷します。店舗のアップデートのたびにレイアウトが変わります。新しい加盟店はこれまで見たことのないフォーマットを導入します。この多様性はレシート環境の恒久的な特徴であり、テンプレートベースの抽出が、OCR精度の向上では決して解決できない限界に達する理由です。
テンプレートベースからセマンティック抽出への移行は、各レシートを記憶すべき独自のレイアウトとして扱うことと、すべてのレシートを理解すべき同じ文書タイプのインスタンスとして扱うことの違いです。一方のアプローチは設定する店舗数に応じて拡張します。もう一方は処理するレシート数に応じて拡張します — そして、これまで遭遇したことのない店舗の最初のレシートでも機能します。レイアウトではなくレシートの意味を読むからです。
15の異なる加盟店から月に40枚のレシートを処理するフリーランサーにとっても、25の異なる仕入先から月に120枚のレシートを処理する小規模事業主にとっても、計算は同じです:買い物をするすべての店舗のテンプレートを構築・維持するか、テンプレートを必要としない方法を使用するかのどちらかです。2番目の選択肢は、しばらく前から技術的に可能でした。フォーマットの多様性の問題が、それを必要にしただけです。
ご自身のレシートでお試しください — 無料プランは1か月分の処理に十分な容量をカバーしており、その違いを実際にご確認いただけます。異なる店舗の数枚のレシートから始めて、手動で入力する場合と出力を比較してください。日々扱っているフォーマットの多様性が最良のテストケースです。