So extrahieren Sie Belegdaten
wenn jedes Format anders ist
Eine Upwork-Studie ergab, dass 64 Millionen Amerikaner — 38 % der Erwerbsbevölkerung — im Jahr 2023 freiberuflich tätig waren und 1,3 Billionen $ zur Wirtschaft beitrugen. In Foren wie r/Bookkeeping und r/smallbusiness taucht immer wieder dieselbe Beschwerde auf: Die Eingabe von Belegdaten ist die Buchhaltungsaufgabe, die nie endet. Ein Reddit-Nutzer auf r/smallbusiness brachte es auf den Punkt — „Mein größtes Kopfzerbrechen sind Rechnungen. Einfach ... alle. Sie aus meiner E-Mail zu holen, die Details in meine Bücher zu tippen, sie zu verfolgen. Es ist furchtbar." Branchendaten, die von Ausgabenverfolgungsplattformen zusammengestellt wurden, zeigen, dass Freiberufler 4 bis 6 Stunden pro Monat damit verbringen, Belege manuell zu organisieren — und das ohne diejenigen, die durch verblasstes Thermopapier oder falsch abgelegte Ordner verloren gehen. Das Problem ist nicht, dass es keine Beleg-Extraktionstools gibt. Es ist, dass die meisten davon ausgehen, dass jeder Beleg gleich aussieht.
Die wichtigsten Erkenntnisse
- Keine zwei Läden drucken Belege gleich — und genau keiner davon wird jemals sein Layout für Ihre Tabelle standardisieren.
- 20 Händler × 15 Minuten Vorlageneinrichtung = 5 Stunden Konfiguration — und die gerade erstellte Vorlage bricht in dem Moment, in dem dieser Laden sein POS-System aktualisiert.
- Semantische Extraktion liest, was jeder Textabschnitt bedeutet, nicht wo er steht — so findet ein Satz von Spaltennamen automatisch „Total", „Date" und „Merchant" in jedem Belegformat ohne eine einzige Vorlage.
Warum Belegvorlagen immer versagen — und warum das wichtiger ist, als Sie denken
Jedes Geschäft druckt Belege anders. Das ist kein kleines Ärgernis — es ist die Hauptursache dafür, dass die meisten Belegextraktions-Tools inkonsistente Ergebnisse liefern. Ein Walmart-Beleg ist ein langer vertikaler Streifen mit aufgelisteten SKUs, laufenden Zwischensummen und einem Barcode am unteren Rand. Ein lokaler Coffeeshop druckt einen 3 Zoll großen Square-Beleg mit abgekürztem Händlernamen, ohne Steueraufschlüsselung und mit QR-Code. Ein Restaurantbeleg hat Einzelposten, eine Trinkgeldzeile und manchmal eine vorgeschlagene Trinkgeldtabelle. Ein Home Depot-Beleg zieht sich über zwei Fuß Papier mit Handwerkerpreisen, Auftragsnummern und Rückgabebedingungen. Keines dieser Formate ähnelt dem anderen auch nur im Geringsten.
Vorlagenbasierte Extraktion — der Ansatz der meisten traditionellen OCR-Tools — funktioniert, indem sie sich merkt, wo Daten auf einer Seite stehen. Sie trainieren sie auf ein Home Depot-Beleglayout, und sie lernt: „Die Summe steht unten rechts." Dann geben Sie ihr einen Walmart-Beleg, bei dem die Summe mittig links steht, und die Vorlage bricht. Sie bräuchten eine separate Vorlage für jedes Geschäft, in dem Sie einkaufen — und jedes Mal, wenn das Geschäft sein POS-System aktualisiert, bricht die Vorlage erneut. Ein r/Bookkeeping-Nutzer brachte die Frustration in einem Thread zur Belegerfassung auf den Punkt: „Card spend tools: docyt, divvy, Expensify, dext — viele davon haben die Funktionen, die Sie suchen." Die Empfehlungsliste ist aufschlussreich: Nutzer springen zwischen fünf verschiedenen Tools hin und her, weil keines das Problem der Formatvielfalt allein sauber löst.
Die Formatvielfalt ist kein Nischen-Sonderfall. Ein Kleinunternehmer, der bei 15 verschiedenen Lieferanten einkauft — plus Tankstellen, Baumärkte, Bürobedarfsketten und Online-Marktplätze — trifft jeden Monat auf 15 bis 25 verschiedene Beleglayouts. Jedes positioniert Datum, Summe, Steuer, Händlername und Einzelposten in einer anderen Anordnung. Ein vorlagenbasierter Ansatz skaliert nicht mit dieser Realität. Er funktioniert für die drei Geschäfte, die Sie konfiguriert haben. Er versagt bei den anderen 12.
Das Problem der Formatvielfalt ist strukturell, nicht technisch. Es liegt nicht daran, dass OCR nicht genau genug wäre — sondern daran, dass ein positionsbasierter Ansatz jeden Beleg als Variante desselben Layouts behandelt, und reale Belege sind keine Varianten. Es sind eigenständig gestaltete Dokumente aus Hunderten verschiedener POS-Systeme ohne gemeinsames Koordinatensystem.
Was semantische Extraktion anders macht – und warum sie jede Quittung liest
Es gibt einen grundlegend anderen Ansatz zur Quittungsextraktion, der überhaupt nicht vom Layout abhängt. Er heißt semantische Extraktion und funktioniert so, wie ein Mensch eine Quittung liest – indem er versteht, was jeder Textabschnitt bedeutet, nicht wo er steht.
Wenn Sie eine Quittung betrachten, suchen Sie nicht nach Koordinaten. Sie suchen nach Bedeutung: „Diese Zahl unten mit einem Dollarzeichen und dem Wort ‚Total‘ darüber – das ist die Summe.“ KI-gestützte semantische Extraktion macht dasselbe. Statt auf bestimmte Quittungslayouts trainiert zu sein, ist sie darauf trainiert, die Sprache und Struktur von Quittungen als Dokumenttyp zu verstehen. Sie weiß, dass „Zwischensumme“, „Steuer“, „Gesamt“, „Rückgeld“ und „Zahlungsmethode“ Standardkonzepte von Quittungen sind. Sie weiß, dass ein Datum ein Datum ist, ein Dollarbetrag ein Dollarbetrag ist und ein Händlername normalerweise oben steht. Sie liest die Quittung – sie führt nicht nur eine OCR durch.
Das ermöglicht die Benutzerdefinierte Spaltenextraktion. Sie definieren die Spalten, die Sie in Ihrer Tabelle möchten – „Händler“, „Datum“, „Gesamt“, „Steuer“, „Kategorie“ – und die KI findet jeden Wert auf jeder Quittung, indem sie versteht, was diese Spaltennamen bedeuten. Die Extraktion kümmert es nicht, ob „Gesamt“ in der unteren rechten Ecke einer Home Depot-Quittung oder in der Mitte links einer Walmart-Quittung steht. Sie findet „Gesamt“ über die Bedeutung, nicht über die Position. Dieser Ansatz ist ohne Vorlage: Sie erstellen und pflegen keine Vorlage für ein Geschäft. Sie richten Ihre Spaltennamen einmal ein, und sie funktionieren für jede Quittung, die Sie je verarbeiten – von jedem Geschäft, jedem POS-System, jedem Format.
Der Unterschied zur vorlagenbasierten OCR ist der Unterschied zwischen sich zu merken, wo etwas war, und zu verstehen, was etwas ist. Vorlagenbasierte Tools sagen: „Die Summe befindet sich an den Koordinaten (450, 820).“ Semantische Extraktion sagt: „Die Summe ist die Zahl mit einem Dollarzeichen, vor der das Wort ‚Gesamt‘ steht – ich finde sie, wo auch immer sie auf dieser bestimmten Seite steht.“ Der zweite Ansatz übersteht Formatänderungen. Der erste Ansatz übersteht nichts.
So funktioniert die vorlagenfreie Beleg-Erfassung Schritt für Schritt
Der Workflow zur Erfassung von Belegdaten in eine Tabelle ohne Vorlagen ist einfacher als die vorlagenbasierte Alternative, da es keine Einrichtungsphase gibt. So funktioniert der gesamte Ablauf.
Schritt 1: Belege hochladen. Laden Sie Fotos von Papierbelegen, PDFs, Screenshots von E-Mail-Belegen oder eine Mischung aus allen dreien hoch. Mit Stapel-Uploads können Sie einen ganzen Monat auf einmal hochladen – 50 Belege von 15 verschiedenen Geschäften – in einem einzigen Vorgang. Das Tool akzeptiert JPG, PNG, PDF und WebP. Egal, ob Sie Fotos mit Ihrem Telefon machen oder E-Mail-Anhänge speichern, es gibt keinen Formatkonvertierungsschritt.
Schritt 2: Definieren, was Sie extrahieren möchten. Hier ersetzt die Benutzerdefinierte Spaltenextraktion die Vorlagen. Statt Layout-Regeln pro Geschäft zu erstellen, geben Sie die Spaltennamen ein, die Ihren Anforderungen entsprechen. Für die Belegerfassung sieht ein typischer Spaltensatz so aus:
- Händler – Geschäfts- oder Lieferantenname
- Datum – Transaktionsdatum
- Gesamtbetrag – Endbetrag, der bezahlt wurde
- Steuer – Umsatzsteuerbetrag (falls separat ausgewiesen)
- Zahlungsmethode – Bargeld, Kreditkarte, Debitkarte
- Kategorie – Ausgabenkategorie (Optionen: Bürobedarf / Mahlzeiten / Reisen / Ausrüstung / Nebenkosten / Sonstiges)
Die letzte Spalte – Kategorie – nutzt eine Funktion namens abgeleitete Spalte. Die KI liest den Beleginhalt (ein Restaurantbeleg zeigt Lebensmittel, ein Office-Depot-Beleg zeigt Bürobedarf) und weist automatisch die richtige Kategorie zu, obwohl kein Beleg ein Feld mit der Bezeichnung „Kategorie" hat. Das bedeutet, dass Extraktion und Klassifizierung in einem einzigen Durchlauf erfolgen – Sie extrahieren keine Daten in eine Tabelle und kategorisieren danach manuell jede Zeile.
Dateien werden sicher verarbeitet und nicht gespeichert.
Schritt 3: Prüfen und exportieren. Die KI verarbeitet jeden Beleg und füllt Ihre Tabellenspalten. Die Ergebnisse erscheinen in einer Tabelle, in der Sie sie prüfen, bei Bedarf korrigieren und dann als Excel (XLSX), CSV oder JSON exportieren können. Jede Zeile in der Tabelle entspricht einem Beleg, und jede Spalte entspricht einem der von Ihnen definierten Felder. Händlername, Datum, Gesamtbetrag, Steuer, Zahlungsmethode und die automatisch klassifizierte Kategorie – alles ausgefüllt, ohne eine einzige Vorlage anzufassen oder eine einzige Zelle manuell zu tippen.
Die Verarbeitung einer Seite dauert etwa 5 bis 10 Sekunden – ungefähr 18-mal schneller als die manuelle Eingabe, die im Durchschnitt etwa 3 Minuten pro Beleg dauert, wenn man die Zeit zum Auffinden des Belegs, das Öffnen der Tabelle, das Eintippen jedes Feldes und das Überprüfen der Eingabe gegen das Original mit einrechnet.
Welche Daten Sie aus jedem Beleg extrahieren können – und welche nicht
Die semantische Extraktion liest die Standardfelder, die auf den meisten Belegen erscheinen. Hier ist, was zuverlässig extrahierbar ist – und wo die Grenzen in der Praxis liegen.
Immer extrahierbar: Händlername, Transaktionsdatum, gezahlter Gesamtbetrag, Zahlungsmethode (sofern aufgedruckt) und Umsatzsteuer (sofern als separate Zeile ausgewiesen). Diese Felder erscheinen auf praktisch jedem Beleg und sind anhand ihrer semantischen Muster konsistent erkennbar – Daten sehen wie Daten aus, Geldbeträge wie Geldbeträge, und Händlernamen stehen immer oben im Dokument.
Meist extrahierbar: Einzelposten (Produktbeschreibungen, Mengen, Einzelpreise, Positionssummen). Die Genauigkeit der Einzelposten hängt von der Druckqualität des Belegs ab. Ein gestochen scharfer Beleg einer nationalen Kette mit klarer Zeilenformatierung wird mit hoher Genauigkeit extrahiert – die KI liest jede Zeile als separate Einheit und ordnet Mengen Beschreibungen und Preisen zu. Ein verblasster Thermo-Beleg von 7-Eleven, bei dem Artikelbeschreibungen auf 8 Zeichen gekürzt sind, führt zu weniger zuverlässiger Einzelposten-Extraktion. Das ist eine Einschränkung, bei der man ehrlich sein sollte: Die Extraktion ist nur so gut wie das Quellbild, und die Degradierung von Thermopapier ist ein physisches Problem, kein Softwareproblem.
Mit abgeleiteter Spalte extrahierbar: Ausgabenkategorie, Flags für geschäftlichen Zweck und Klassifizierung des Anbietertyps. Diese sind nicht auf dem Beleg aufgedruckt – die KI leitet sie aus dem Inhalt des Belegs ab. Ein Beleg von Shell mit einem Kraftstoffkauf wird als „Reise“ kategorisiert. Ein Beleg von Staples mit Büroartikel-Einzelposten wird als „Bürobedarf“ kategorisiert. Ein Beleg eines Restaurants mit einem Essenskauf wird als „Mahlzeiten“ kategorisiert. Berechnete Spalte können während der Extraktion auch Berechnungen durchführen – zum Beispiel die Berechnung des Trinkgeldbetrags durch Subtraktion der Zwischensumme vom Gesamtbetrag oder den Abgleich, ob die Summe der Einzelposten mit dem aufgedruckten Gesamtbetrag übereinstimmt.
Nicht zuverlässig extrahierbar: Handschriftliche Trinkgelder auf verblassten Belegen, teilweise zerrissene Belege, bei denen Text physisch fehlt, und Belege, die so zerknüllt wurden, dass der Text unleserlich ist. KI kann Handschrift besser verarbeiten als herkömmliche OCR – sie liest handschriftliche Gesamtbeträge und Händlernotizen, die vorlagenbasierte Tools nicht lesen können –, aber sie kann Text nicht wiederherstellen, der nicht vorhanden ist. Ein Beleg, der zu 40 % physisch zerstört ist, ergibt eine Extraktion von 60 %. Die Ausgabe kennzeichnet unvollständige Felder, und Sie wissen, welche Belege eine manuelle Nachbearbeitung benötigen.
Batch-First-Verarbeitung: Gemischte Belege aus 20 Geschäften, eine Tabelle
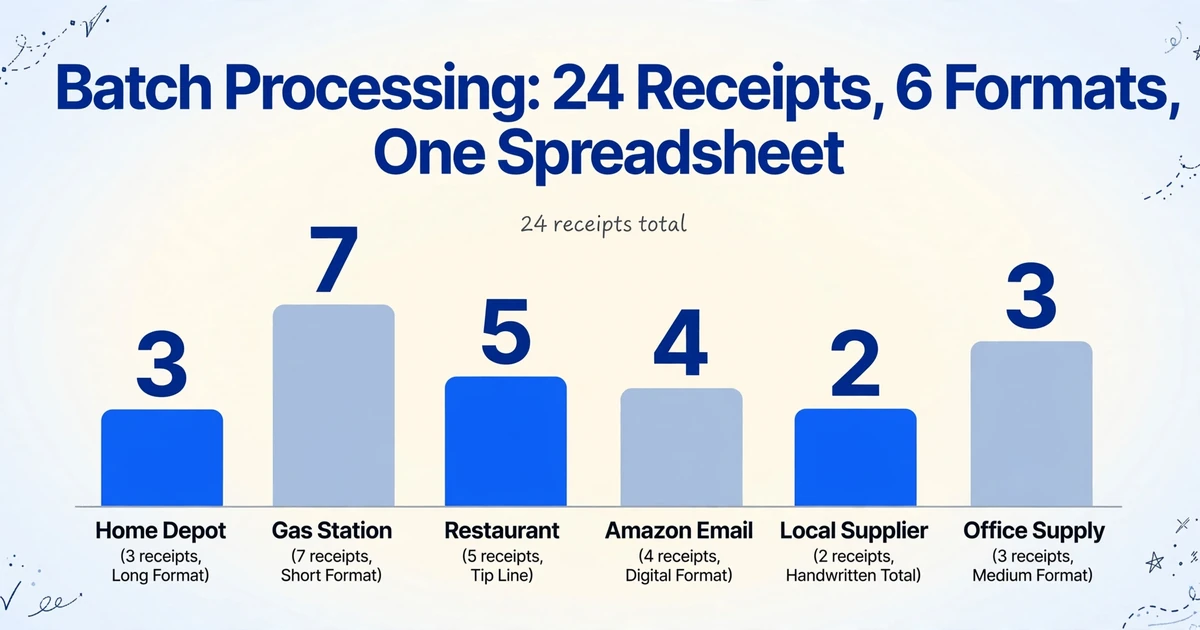
Das Problem der Formatvielfalt wird am deutlichsten, wenn Sie Belege in großen Mengen verarbeiten. Die Ausgaben eines Monats könnten umfassen: 3 Home Depot-Belege (Langformat, Auftragnehmer-Layout), 7 Tankstellenbelege (Kurzformat, keine Steueraufschlüsselung), 5 Restaurantbelege (Positionen mit Trinkgeldzeile), 4 Amazon E-Mail-Belege (digital, sauberes Format), 2 Belege lokaler Lieferanten (handschriftliche Summen) und 3 Bürobedarfsbelege (mittleres Format, aufgeschlüsselt). Das sind 24 Belege aus 6 verschiedenen Layout-Familien — und innerhalb jeder Familie können einzelne Geschäfte eigene Variationen haben.
Batch-First-Verarbeitung ist die Fähigkeit, alle diese Belege auf einmal zu verarbeiten und eine einheitliche Tabelle zurückzubekommen. Sie laden den gesamten Ordner hoch — alle 24 Belege per Drag-and-Drop — definieren Ihre Spaltennamen einmal, und die AI verarbeitet jeden Beleg einzeln und wendet dieselbe semantische Extraktionslogik auf alle an, unabhängig vom Format. Das Ergebnis ist eine einzelne Excel-Datei, in der jede Zeile ein Beleg ist, jede Spalte ein von Ihnen definiertes Feld, und das Format des Originalbelegs für die Qualität der Extraktion irrelevant ist.
Diese Batch-Fähigkeit verändert die Wirtschaftlichkeit der Belegverarbeitung. 24 Belege manuell zu je 3 Minuten zu verarbeiten dauert 72 Minuten. Die Verarbeitung als Batch mit semantischer Extraktion erfordert etwa 2 bis 4 Minuten für Upload und Prüfung. Die Einsparungen summieren sich monatlich: Über ein Jahr spart ein Kleinunternehmen, das 100 Belege pro Monat verarbeitet, etwa 55 Stunden — fast sieben volle Arbeitstage, die von der Belegerfassung zurückgewonnen werden.
Für Unternehmen, die Belege von mehreren Personen sammeln müssen — Mitarbeiter, die Spesenbelege einreichen, Auftragnehmer, die Einkaufsbelege von der Baustelle senden, Kunden, die Dokumentation bereitstellen — beseitigt der Sammellink das Hin- und Herschicken per E-Mail. Sie erstellen einen teilbaren Link, senden ihn an die Personen, die Belege einreichen müssen, und deren Uploads landen direkt in Ihrer Verarbeitungswarteschlange. Die einreichende Person benötigt kein Konto. Sie öffnet den Link, gibt einen kurzen Verifizierungscode ein und lädt hoch. Jeder Beleg landet in Ihrem Batch und kann in dieselbe Tabelle mit denselben Spaltendefinitionen verarbeitet werden.
So bewältigt die Batch-Verarbeitung Formatvielfalt
| Belegquelle | Formattyp | Vorlagenansatz | Semantischer Ansatz |
|---|---|---|---|
| Walmart | Langer vertikaler Streifen, SKU-Ebene | Benötigt Walmart-spezifische Vorlage | Liest nach Feldbedeutung – keine Vorlage nötig |
| Lokales Café (Square POS) | Kurz, abgekürzte Namen | Benötigt Square-spezifische Vorlage | Liest nach Feldbedeutung – keine Vorlage nötig |
| Restaurant | Positionen + Trinkgeldzeile | Benötigt restaurant-spezifische Vorlage | Liest nach Feldbedeutung – keine Vorlage nötig |
| Home Depot (Pro) | Langes Format, Auftragsnummern | Benötigt Home Depot-spezifische Vorlage | Liest nach Feldbedeutung – keine Vorlage nötig |
| Amazon (E-Mail-PDF) | Digitales Rechnungslayout | Benötigt Amazon-spezifische Vorlage | Liest nach Feldbedeutung – keine Vorlage nötig |
| Handschriftlicher Lieferantenbeleg | Unregelmäßig, variables Layout | Vorlage unmöglich – scheitert vollständig | Liest Handschrift + Feldbedeutung |
Belegdaten IRS-konform machen: Was die Regeln tatsächlich verlangen
Belegdaten in eine Tabelle zu bringen ist nur die halbe Miete. Die andere Hälfte ist sicherzustellen, dass Ihre Aufzeichnungen einer IRS-Prüfung standhalten, falls nötig. Die meisten Kleinunternehmer wissen nicht, dass die IRS digitale Belege offiziell seit 1997 akzeptiert – und die Regeln sind einfacher, als allgemein angenommen.
IRS Publication 463 (Reise-, Geschenk- und Kfz-Kosten) und IRS Revenue Procedure 97-22 legen den Rahmen fest. Digitale Belege – einschließlich gescannter Kopien, mit dem Handy aufgenommener Fotos und E-Mail-Belege – haben dieselbe rechtliche Gültigkeit wie Papieroriginale, sofern sie lesbar, vollständig und während des erforderlichen Aufbewahrungszeitraums abrufbar sind. Der Standard-Aufbewahrungszeitraum beträgt 3 Jahre ab dem Datum der Steuererklärung, verlängert sich auf 6 Jahre, wenn Einkünfte um mehr als 25 % zu niedrig angegeben wurden, und auf 7 Jahre bei Ansprüchen im Zusammenhang mit uneinbringlichen Forderungen oder wertlosen Wertpapieren.
Was muss ein gültiger Beleg zeigen? Fünf Elemente: Name des Verkäufers, Transaktionsdatum, gezahlter Betrag, Beschreibung des Gekauften und (sofern erkennbar) die Zahlungsmethode. Bei Geschäftsessen benötigen Sie außerdem den geschäftlichen Zweck sowie die Namen und Geschäftsbeziehungen der anwesenden Personen. Die $75-Regel – Treasury Regulation § 1.274-5(c)(2)(iii) – besagt, dass Belege für Ausgaben ab $75 ausdrücklich erforderlich sind und ein Kreditkartenabrechnung allein nicht ausreicht, um eine Geschäftsausgabe nachzuweisen. Unter $75 benötigen Sie weiterhin Aufzeichnungen – ein Vermerk in Ihrem Ausgabenprotokoll oder Kalendereintrag kann genügen – aber die Belegpflicht ist geringer.
Die praktische Erkenntnis: Das Extrahieren von Belegdaten in eine Tabelle spart nicht nur Zeit. Es schafft eine zeitnahe digitale Aufzeichnung — eine, die die Anforderung des IRS erfüllt, dass Dokumentation „at or near the time of the expense" erstellt wird. Eine Tabellenzeile mit Händler, Datum, Betrag, Beschreibung und Kategorie, gestützt auf eine digitale Kopie des Originalbelegs, ist genau das, was der IRS verlangt. Eine Schuhschachtel voller verblasster Thermopapier-Belege ist genau das, was er nicht verlangt.
Was Template-Free-Belegextraktion kostet — und was sie ersetzt
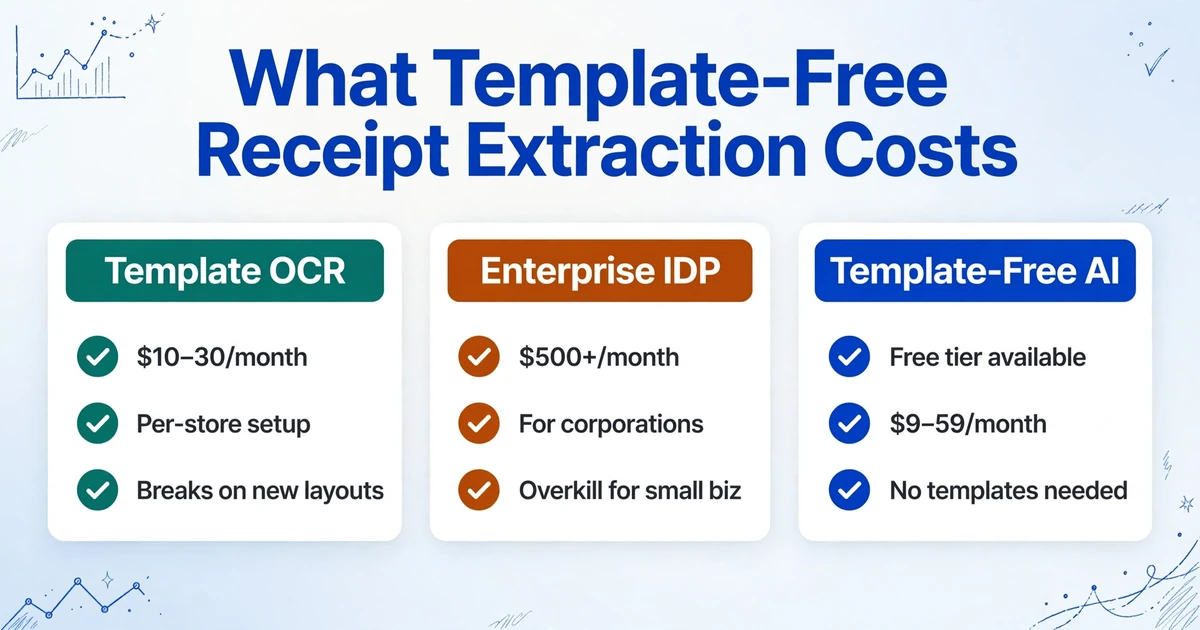
Belegextraktions-Tools gibt es über ein breites Preisspektrum, und die Unterschiede entsprechen der zugrunde liegenden Technologie. Vorlagenbasierte OCR-Tools beginnen oft bei niedrigeren Preisen — $10 bis $30 pro Monat — erfordern aber die Einrichtung einer Vorlage pro Geschäft, die die Ersparnis durch Konfigurationszeit wieder auffrisst. Enterprise-IDP-Plattformen (Intelligent Document Processing) können $500+ pro Monat kosten und sind für Unternehmen mit dedizierten Implementierungsteams konzipiert, nicht für Einzelunternehmer, die 80 Belege im Monat verarbeiten.
Template-Free-AI-Extraktionstools fallen in eine andere Kategorie. ImageToTable.ai bietet zum Beispiel eine kostenlose Stufe, mit der Sie die Extraktion an Ihren eigenen Belegen testen können, gefolgt von kostenpflichtigen Plänen für $9/Monat (Basic), $19/Monat (Pro) und $59/Monat (Max) — credit-basiert, sodass Sie für das bezahlen, was Sie verarbeiten, statt für ein Pauschalabo, das in ruhigen Monaten ungenutzt bleibt.
Die Break-even-Rechnung lohnt sich. Wenn die manuelle Belegverarbeitung Sie 4 Stunden im Monat kostet bei $32.23/Stunde (der BLS-Durchschnittslohn in den USA Stand April 2026), sind das $129 Ihrer Zeit jeden Monat. Ein Tool für $9/Monat, das dies auf 30 Minuten reduziert, spart Ihnen allein an Arbeitszeit $97 pro Monat — noch bevor Sie Abzüge berücksichtigen, die Sie nicht mehr verpassen, weil Belege nicht verloren gingen. Bei 100 Belegen pro Monat liegen die jährlichen Einsparungen bei Arbeitszeit, zurückgewonnenen Abzügen und reduziertem CPA-Vorbereitungsaufwand typischerweise zwischen $1,500 und $3,000.
Hier geht es nicht darum, Ihre Buchhaltungssoftware zu ersetzen. QuickBooks, Xero und Wave bleiben dort, wo Ihre Bücher geführt werden. Expensify und Dext übernehmen Spesenabrechnungs-Workflows und die Synchronisierung von Belegen zur Buchhaltung. Template-Free-Extraktion füllt die Lücke, die vor all dem liegt: ein Foto eines Belegs in strukturierte Daten zu verwandeln, die diese nachgelagerten Tools aufnehmen können. Es ist der Eingabeschritt, der alles Nachgelagerte schneller macht.
Belegextraktion ist kein Ersatz für die Buchhaltung. Sie ist ein Ersatz für die 30-Sekunden-Mikrotransaktionen manueller Dateneingabe, die sich über jeden Beleg, jeden Monat, jedes Jahr summieren — die unsichtbaren Kosten, die vorlagenbasierte Tools nicht beseitigen können, weil das Problem der Formatvielfalt in ihrer Architektur verankert ist.
Häufig gestellte Fragen zur Belegerfassung
Funktioniert die Belegerfassung mit verblassten Thermorollen-Belegen?
Das hängt davon ab, wie stark der Beleg verblasst ist. Thermopapier zersetzt sich bei normaler Lagerung innerhalb von 6 bis 12 Monaten — Hitze, Sonnenlicht und sogar die Plastikhüllen in manchen Ordnern beschleunigen das Verblassen. Wenn der Text für das menschliche Auge noch sichtbar, aber schwach ist, kann die KI-Erfassung ihn oft lesen, da das Modell visuelle Muster mit höherer Auflösung interpretiert als herkömmliche OCR. Wenn der Beleg vollständig blank ist, kann keine Software Text wiederherstellen, der nicht mehr existiert. Die Lösung ist einfach: Digitalisieren Sie Belege (Foto oder Scan) sofort nach Erhalt, bevor das Thermopapier Zeit hat, sich zu zersetzen. Einmal digitalisiert, sind die Daten dauerhaft.
Wie genau ist die Einzelposten-Erfassung aus Belegen?
Die Genauigkeit der Einzelposten variiert je nach Belegqualität und Layout-Komplexität. Saubere Belege von nationalen Einzelhändlern mit gut formatierten Artikelrastern werden mit hoher Genauigkeit erfasst — 95 % bis 99 % bei klar gedrucktem Text. Belege mit abgekürzten Artikelnamen (8-Zeichen-Beschreibungen von POS-Systemen im Convenience-Store), mehrspaltigen Layouts oder physischen Schäden ergeben eine geringere Genauigkeit. Die Erfassung verarbeitet gemischte Formate im selben Batch: Hochwertige Belege erhalten nahezu perfekte Erfassungen, und minderwertige Belege werden zur Überprüfung markiert. Sie müssen nicht den gesamten Batch annehmen oder ablehnen — einzelne Zeilen können korrigiert werden, ohne den Rest erneut zu verarbeiten.
Kann die Belegerfassung Ausgaben für Steuerzwecke automatisch kategorisieren?
Ja, über abgeleitete Spalten. Durch die Definition einer Kategoriespalte mit voreingestellten Optionen (z. B. „Mahlzeiten / Reisen / Bürobedarf / Ausrüstung / Nebenkosten / Sonstiges") liest die KI den Inhalt jedes Belegs und weist die passende Kategorie zu. Ein Restaurantbeleg erhält „Mahlzeiten". Ein Tankstellenbeleg erhält „Reisen". Ein Staples-Beleg erhält „Bürobedarf". Dies ersetzt nicht das Urteilsvermögen eines Buchhalters oder CPA — Grenzfälle existieren (ist ein Essen mit einem Kunden „Mahlzeiten" oder „Marketing"?), und die endgültige Kategorisierungsentscheidung liegt bei Ihnen. Aber es übernimmt die 80 % der Belege mit eindeutigen Kategorien, was den Großteil der manuellen Zeit ausmacht.
Kann ich Belege von 10 verschiedenen Geschäften in einem Batch verarbeiten?
Ja – genau dafür ist die Extraktion ohne Vorlage gedacht. Laden Sie Belege von Walmart, Home Depot, Amazon, Ihrem lokalen Café, Shell, Staples, einem Restaurant, einem handschriftlichen Lieferantenbeleg und drei weiteren Geschäften in einem Batch hoch. Definieren Sie Ihre Spaltennamen einmal. Die KI extrahiert dieselben Felder aus jedem Beleg, unabhängig davon, welches Geschäft ihn gedruckt hat. Das Ergebnis ist eine Tabelle mit einer Zeile pro Beleg, befüllt aus allen 10+ Formaten.
Anerkennt der IRS digitale Kopien von Belegen?
Ja, seit 1997. IRS Revenue Procedure 97-22 hat digitale Aufzeichnungen offiziell als rechtlich gleichwertig mit Papieroriginalen anerkannt. Ein gescannter Beleg, ein mit dem Handy aufgenommenes Foto oder eine PDF eines E-Mail-Belegs haben dasselbe Gewicht wie das Papieroriginal – sofern sie lesbar, vollständig und während des gesamten Aufbewahrungszeitraums (in der Regel 3 Jahre, in bestimmten Fällen bis zu 7 Jahre) abrufbar sind. Die fünf erforderlichen Elemente sind Händlername, Datum, Betrag, Beschreibung und (sofern zutreffend) Zahlungsmethode. Eine Tabellenextraktion aller fünf Elemente, zusammen mit dem Originalbelegbild gespeichert, übertrifft den Dokumentationsstandard.
Was sich ändert, wenn Sie jeden Beleg nicht mehr als Vorlagenproblem behandeln
Die Formatvielfalt realer Belege wird nicht verschwinden. Jedes POS-System druckt anders. Jedes Geschäfts-Update mischt das Layout neu. Jeder neue Händler bringt ein Format mit, das Sie noch nie gesehen haben. Diese Vielfalt ist ein dauerhaftes Merkmal der Beleglandschaft – und sie ist der Grund, warum die vorlagenbasierte Extraktion an eine Grenze stößt, die keine noch so große Verbesserung der OCR-Genauigkeit beheben kann.
Der Wechsel von vorlagenbasierter zu semantischer Extraktion ist der Unterschied zwischen der Behandlung jedes Belegs als einzigartiges Layout, das man sich merken muss, und der Behandlung aller Belege als Instanzen desselben Dokumenttyps, den es zu verstehen gilt. Ein Ansatz skaliert mit der Anzahl der Geschäfte, die Sie konfigurieren. Der andere skaliert mit der Anzahl der Belege, die Sie verarbeiten – und er funktioniert beim ersten Beleg eines Geschäfts, das Sie noch nie gesehen haben, weil er die Bedeutung des Belegs liest, nicht sein Layout.
Für den Freiberufler, der 40 Belege pro Monat von 15 verschiedenen Händlern verarbeitet, oder den Kleinunternehmer, der 120 Belege pro Monat von 25 verschiedenen Lieferanten verarbeitet, ist die Rechnung dieselbe: Sie können entweder Vorlagen für jedes Geschäft erstellen und pflegen, bei dem Sie einkaufen, oder Sie verwenden eine Methode, die keine benötigt. Die zweite Option ist seit einiger Zeit technisch möglich. Das Problem der Formatvielfalt hat sie nur notwendig gemacht.
Probieren Sie es mit Ihren eigenen Belegen aus – der kostenlose Tarif deckt genug Volumen ab, um einen Monat zu verarbeiten und den Unterschied selbst zu sehen. Beginnen Sie mit ein paar Belegen aus verschiedenen Geschäften und vergleichen Sie die Ausgabe mit dem, was Sie manuell eingeben würden. Die Formatvielfalt, mit der Sie täglich umgehen, ist der beste Testfall.