Comment extraire les données de reçus
quand chaque format est différent
Une étude Upwork a révélé que 64 millions d'Américains — 38 % de la population active — ont exercé une activité indépendante en 2023, contribuant à hauteur de 1 300 milliards de dollars à l'économie. Sur des forums comme r/Bookkeeping et r/smallbusiness, la même plainte revient sans cesse : la saisie des données de reçus est la tâche comptable qui ne finit jamais. Un utilisateur de Reddit sur r/smallbusiness l'a dit sans détour — « Mon plus gros casse-tête, ce sont les factures. Toutes, sans exception. Les récupérer dans mes e-mails, saisir les détails dans ma comptabilité, les suivre. C'est infernal. » Les données sectorielles agrégées par les plateformes de suivi des dépenses montrent que les indépendants passent 4 à 6 heures par mois à organiser manuellement leurs reçus — sans compter ceux perdus à cause du papier thermique qui s'efface ou des dossiers mal classés. Le problème n'est pas que les outils d'extraction de reçus n'existent pas. C'est que la plupart supposent que tous les reçus se ressemblent.
Points clés
- Deux magasins n'impriment jamais leurs reçus de la même façon — et aucun d'entre eux ne standardisera jamais sa mise en page pour votre tableau.
- 20 commerçants × 15 minutes de configuration de modèle chacun = 5 heures de paramétrage — et le modèle que vous venez de créer se casse dès que ce magasin met à jour son système POS.
- L'extraction sémantique lit ce que signifie chaque bloc de texte, et non où il se trouve — ainsi, un seul ensemble de noms de colonnes trouve automatiquement « Total », « Date » et « Merchant » sur chaque format de reçu, sans le moindre modèle.
Pourquoi les modèles de reçus échouent toujours — et pourquoi c'est plus important que vous ne le pensez
Chaque magasin imprime ses reçus différemment. Ce n'est pas un simple désagrément — c'est la cause profonde des résultats incohérents de la plupart des outils d'extraction de reçus. Un reçu Walmart est une longue bande verticale avec des SKU détaillés, des sous-totaux courants et un code-barres en bas. Un café de quartier imprime un reçu Square de 3 pouces avec un nom de commerçant abrégé, aucune ventilation de taxe et un QR code. Un reçu de restaurant comporte des lignes d'articles, une ligne de pourboire et parfois un tableau de gratifications suggérées. Un reçu Home Depot s'étend sur deux pieds de papier avec des tarifs contractuels, des numéros de chantier et le texte de la politique de retour. Aucun de ces formats ne ressemble aux autres.
L'extraction basée sur un modèle — l'approche utilisée par la plupart des outils OCR traditionnels — fonctionne en mémorisant l'emplacement des données sur une page. Vous l'entraînez sur une mise en page de reçu Home Depot, et elle apprend que « le total est dans le coin inférieur droit ». Puis vous lui soumettez un reçu Walmart où le total est au milieu à gauche, et le modèle échoue. Il vous faudrait un modèle distinct pour chaque magasin où vous achetez — et chaque fois qu'un magasin met à jour son système POS, le modèle échoue à nouveau. Un utilisateur de r/Bookkeeping a résumé cette frustration dans un fil sur la saisie des données de reçus : « Outils de dépenses par carte : docyt, divvy, Expensify, dext — beaucoup d'entre eux ont les fonctionnalités que vous recherchez. » La liste de recommandations est révélatrice : les utilisateurs naviguent entre cinq outils différents parce qu'aucun ne gère proprement le problème de la variété des formats à lui seul.
La variété des formats n'est pas un cas isolé. Un propriétaire de petite entreprise qui achète auprès de 15 fournisseurs différents — plus les stations-service, les quincailleries, les chaînes de fournitures de bureau et les places de marché en ligne — rencontre 15 à 25 mises en page de reçus distinctes chaque mois. Chacune positionne la date, le total, la taxe, le nom du commerçant et les lignes d'articles selon un agencement différent. Une approche basée sur un modèle ne passe pas à l'échelle face à cette réalité. Elle fonctionne pour les trois magasins que vous avez configurés. Elle échoue pour les 12 autres.
Le problème de la variété des formats est structurel, pas technique. Ce n'est pas que l'OCR n'est pas assez précis — c'est qu'une approche basée sur la position traite chaque reçu comme une variante de la même mise en page, alors que les reçus réels ne sont pas des variantes. Ce sont des documents conçus indépendamment par des centaines de systèmes POS différents, sans système de coordonnées commun.
Ce que l'extraction sémantique fait différemment — et pourquoi elle lit n'importe quel reçu
Il existe une approche fondamentalement différente de l'extraction de reçus qui ne dépend pas du tout de la mise en page. On l'appelle extraction sémantique, et elle fonctionne comme un humain qui lit un reçu — en comprenant ce que chaque morceau de texte signifie, pas où il se trouve.
Quand vous regardez un reçu, vous ne cherchez pas des coordonnées. Vous cherchez du sens : « Ce nombre en bas avec un signe dollar et le mot "Total" au-dessus — c'est le total. » L'extraction sémantique basée sur l'IA fait la même chose. Au lieu d'être entraînée sur des mises en page de reçus spécifiques, elle est entraînée à comprendre le langage et la structure des reçus en tant que type de document. Elle sait que « Sous-total », « Taxe », « Total », « Monnaie rendue » et « Mode de paiement » sont des concepts standard des reçus. Elle sait qu'une date est une date, qu'un montant en dollars est un montant en dollars, et qu'un nom de marchand est généralement en haut. Elle lit le reçu — elle ne se contente pas de l'OCRiser.
C'est ce que permet l'Extraction de colonnes personnalisées. Vous définissez les colonnes que vous voulez dans votre feuille de calcul — « Marchand », « Date », « Total », « Taxe », « Catégorie » — et l'IA localise chaque valeur sur chaque reçu en comprenant ce que ces noms de colonnes signifient. L'extraction ne se soucie pas de savoir si « Total » se trouve dans le coin inférieur droit d'un reçu Home Depot ou au milieu à gauche d'un reçu Walmart. Elle trouve « Total » par le sens, pas par la position. Cette approche est sans modèle : vous ne créez ni ne maintenez de modèle pour aucun magasin. Vous configurez vos noms de colonnes une fois, et ils fonctionnent sur chaque reçu que vous traitez — de n'importe quel magasin, n'importe quel système POS, n'importe quel format.
Le contraste avec l'OCR basé sur des modèles est la différence entre se souvenir d'où quelque chose était et comprendre ce que quelque chose est. Les outils basés sur des modèles disent : « Le total est aux coordonnées (450, 820). » L'extraction sémantique dit : « Le total est le nombre avec un signe dollar précédé du mot "Total" — je le trouverai où qu'il se trouve sur cette page particulière. » La deuxième approche survit aux changements de format. La première ne survit à rien.
Comment fonctionne l'extraction de reçus sans modèle — Étape par étape
Le processus d'extraction de données de reçus dans une feuille de calcul sans modèle est plus simple que l'alternative basée sur des modèles, car il n'y a pas de phase de configuration. Voici comment cela fonctionne de bout en bout.
Étape 1 : Téléversez vos reçus. Importez des photos de reçus papier, des PDF, des captures d'écran de reçus par e-mail, ou un mélange des trois. Les téléversements par lots vous permettent d'importer un mois entier — 50 reçus de 15 magasins différents — en une seule action. L'outil accepte JPG, PNG, PDF et WebP, donc que vous preniez des photos avec votre téléphone ou que vous enregistriez des pièces jointes, aucune étape de conversion de format n'est nécessaire.
Étape 2 : Définissez ce que vous voulez extraire. C'est ici que l'Extraction de colonnes personnalisées remplace les modèles. Au lieu de créer des règles de mise en page par magasin, vous saisissez les noms de colonnes correspondant à vos besoins. Pour l'extraction de reçus, un ensemble de colonnes typique ressemble à :
- Marchand — Nom du magasin ou du fournisseur
- Date — Date de la transaction
- Total — Montant final payé
- Taxe — Montant de la taxe de vente (si indiqué séparément)
- Mode de paiement — Espèces, crédit, débit
- Catégorie — Catégorie de dépense (options : Fournitures de bureau / Repas / Déplacements / Équipement / Services publics / Autre)
La dernière colonne — Catégorie — utilise une fonctionnalité appelée colonne inférée. L'IA lit le contenu du reçu (un reçu de restaurant montre des articles alimentaires, un reçu d'Office Depot montre des fournitures) et attribue automatiquement la bonne catégorie, même si aucun reçu ne comporte un champ intitulé « Catégorie ». Cela signifie que l'extraction et la classification se font en une seule passe — vous n'extrayez pas les données dans une feuille de calcul puis catégorisez manuellement chaque ligne ensuite.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Étape 3 : Vérifiez et exportez. L'IA traite chaque reçu et remplit les colonnes de votre feuille de calcul. Les résultats apparaissent dans un tableau où vous pouvez vérifier, corriger si nécessaire, puis exporter en Excel (XLSX), CSV ou JSON. Chaque ligne de la feuille de calcul correspond à un reçu, et chaque colonne correspond à l'un des champs que vous avez définis. Le nom du marchand, la date, le total, la taxe, le mode de paiement et la catégorie auto-classifiée — tout est rempli sans toucher à un seul modèle ni saisir une seule cellule.
Le traitement d'une page prend environ 5 à 10 secondes — soit environ 18 fois plus vite que la saisie manuelle, qui prend en moyenne environ 3 minutes par reçu, en incluant le temps de trouver le reçu, d'ouvrir le tableur, de saisir chaque champ et de vérifier votre saisie par rapport à l'original.
Quelles données vous pouvez extraire de n'importe quel reçu — et ce que vous ne pouvez pas
L'extraction sémantique lit les champs standard qui apparaissent sur la plupart des reçus. Voici ce qui est fiablement extractible — et où se situent les limites du monde réel.
Toujours extractible : Nom du marchand, date de transaction, montant total payé, mode de paiement (lorsqu'il est imprimé) et taxe de vente (lorsqu'elle est détaillée sur une ligne séparée). Ces champs apparaissent sur pratiquement tous les reçus et sont systématiquement reconnaissables par leurs schémas sémantiques — les dates ressemblent à des dates, les montants en dollars ressemblent à des montants en dollars, et les noms de marchands sont toujours en haut du document.
Généralement extractible : Lignes d'articles (descriptions de produits, quantités, prix unitaires, totaux de ligne). La précision des lignes d'articles dépend de la qualité d'impression du reçu. Un reçu net d'une chaîne nationale avec un formatage clair des lignes s'extrait avec une grande précision — l'IA lit chaque ligne comme une unité séparée, en faisant correspondre les quantités aux descriptions et aux prix. Un reçu thermique délavé d'un 7-Eleven où les descriptions d'articles sont tronquées à 8 caractères produit une extraction de lignes d'articles moins fiable. C'est une limite dont il faut être honnête : l'extraction n'est aussi bonne que l'image source, et la dégradation du papier thermique est un problème physique, pas un problème logiciel.
Extractible avec des colonnes inférées : Catégorie de dépense, indicateurs d'objectif professionnel et classification du type de fournisseur. Ces éléments ne sont pas imprimés sur le reçu — l'IA les déduit du contenu du reçu. Un reçu de Shell avec un achat de carburant est catégorisé comme « Voyage ». Un reçu de Staples avec des lignes d'articles de fournitures de bureau est catégorisé comme « Fournitures de bureau ». Un reçu d'un restaurant avec un achat de repas est catégorisé comme « Repas ». Les colonnes calculées peuvent également effectuer des calculs pendant l'extraction — par exemple, calculer le montant du pourboire en soustrayant le sous-total du total, ou vérifier si la somme des lignes d'articles correspond au total imprimé.
Non fiablement extractible : Pourboires manuscrits sur des reçus délavés, reçus partiellement déchirés où le texte est physiquement manquant, et reçus froissés au point que le texte est illisible. L'IA gère mieux l'écriture manuscrite que l'OCR traditionnel — elle lit les totaux manuscrits et les notes du marchand que les outils basés sur des modèles ne peuvent pas — mais elle ne peut pas récupérer un texte qui n'existe pas. Un reçu détruit physiquement à 40 % produira une extraction à 60 %. La sortie signalera les champs incomplets, et vous saurez quels reçus nécessitent un suivi manuel.
Traitement par lots : reçus mixtes de 20 magasins, un seul tableur
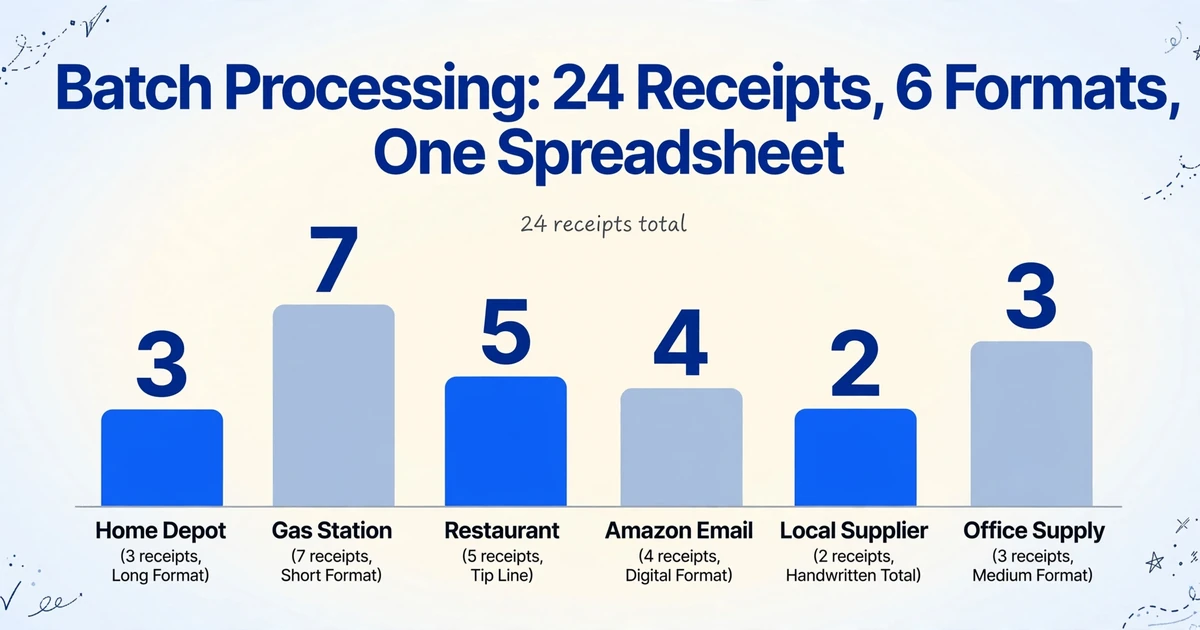
Le problème de la variété des formats devient le plus visible lorsque vous traitez des reçus en masse. Les dépenses d'un mois peuvent inclure : 3 reçus Home Depot (format long, disposition pour entrepreneurs), 7 reçus de station-service (format court, sans détail des taxes), 5 reçus de restaurant (lignes détaillées avec ligne de pourboire), 4 reçus par e-mail Amazon (numériques, mise en forme propre), 2 reçus de fournisseur local (totaux manuscrits) et 3 reçus de fournitures de bureau (format moyen, détaillé). Cela fait 24 reçus répartis en 6 familles de mise en page distinctes — et au sein de chaque famille, les magasins individuels peuvent avoir leurs propres variantes.
Le traitement par lots est la capacité de traiter tous ces reçus en une seule fois et d'obtenir un tableur unifié en retour. Vous téléversez le dossier entier — les 24 reçus en un seul glisser-déposer — vous définissez vos noms de colonnes une fois, et l'AI traite chaque reçu individuellement, en appliquant la même logique d'extraction sémantique à tous, quel que soit le format. Le résultat est un seul fichier Excel où chaque ligne est un reçu, chaque colonne est un champ que vous avez défini, et le format du reçu d'origine n'a aucune incidence sur la qualité de l'extraction.
Cette capacité de traitement par lots change l'économie du traitement des reçus. Traiter 24 reçus manuellement à 3 minutes chacun prend 72 minutes. Les traiter en lot avec extraction sémantique prend environ 2 à 4 minutes de téléversement et de vérification. Les économies se cumulent chaque mois : sur un an, une petite entreprise traitant 100 reçus par mois économise environ 55 heures — près de sept journées de travail complètes récupérées sur la saisie des données de reçus.
Pour les entreprises qui doivent collecter des reçus auprès de plusieurs personnes — employés soumettant des reçus de frais, sous-traitants envoyant des reçus d'achats sur chantier, clients fournissant des justificatifs — Lien de collecte élimine les allers-retours par e-mail. Vous générez un lien partageable, l'envoyez aux personnes qui doivent soumettre des reçus, et leurs téléversements arrivent directement dans votre file de traitement. La personne qui soumet n'a pas besoin de compte. Elle ouvre le lien, saisit un court code de vérification et téléverse. Chaque reçu aboutit dans votre lot, prêt à être traité dans le même tableur avec les mêmes définitions de colonnes appliquées.
Comment le traitement par lots gère la variété des formats
| Source du reçu | Type de format | Approche par modèle | Approche sémantique |
|---|---|---|---|
| Walmart | Longue bande verticale, niveau SKU | Nécessite un modèle spécifique à Walmart | Lit par signification des champs — aucun modèle requis |
| Café local (Square POS) | Noms courts et abrégés | Nécessite un modèle spécifique à Square | Lit par signification des champs — aucun modèle requis |
| Restaurant | Lignes d'articles + ligne de pourboire | Nécessite un modèle spécifique aux restaurants | Lit par signification des champs — aucun modèle requis |
| Home Depot (Pro) | Format long, numéros de chantier | Nécessite un modèle spécifique à Home Depot | Lit par signification des champs — aucun modèle requis |
| Amazon (PDF par e-mail) | Mise en page de facture numérique | Nécessite un modèle spécifique à Amazon | Lit par signification des champs — aucun modèle requis |
| Reçu manuscrit d'un fournisseur | Irrégulier, mise en page variable | Modèle impossible — échoue complètement | Lit l'écriture manuscrite + la signification des champs |
Rendre les données de reçus conformes à l'IRS : ce que les règles exigent réellement
Intégrer les données de reçus dans une feuille de calcul ne représente que la moitié de l'équation. L'autre moitié consiste à s'assurer que vos dossiers résistent à un examen de l'IRS si nécessaire. La plupart des petits entrepreneurs ignorent que l'IRS accepte officiellement les reçus numériques depuis 1997 — et les règles sont plus simples qu'on ne le croit généralement.
IRS Publication 463 (Dépenses de voyage, de cadeaux et de voiture) et IRS Revenue Procedure 97-22 établissent le cadre. Les reçus numériques — y compris les copies numérisées, les photos prises avec votre téléphone et les reçus par e-mail — ont la même valeur juridique que les originaux papier, à condition qu'ils soient lisibles, complets et récupérables pendant la durée de conservation requise. La période de conservation standard est de 3 ans à compter de la date de dépôt de votre déclaration, prolongée à 6 ans si le revenu a été sous-déclaré de plus de 25 %, et à 7 ans pour les demandes liées à des créances irrécouvrables ou à des titres sans valeur.
Que doit montrer un reçu valide ? Cinq éléments : le nom du fournisseur, la date de la transaction, le montant payé, la description de ce qui a été acheté et (lorsque c'est discernable) le mode de paiement. Pour les repas d'affaires, vous devez également indiquer l'objet professionnel et les noms et relations professionnelles des personnes présentes. La règle des 75 $ — Treasury Regulation § 1.274-5(c)(2)(iii) — stipule qu'une preuve documentaire est explicitement requise pour les dépenses de 75 $ ou plus, et qu'un relevé de carte de crédit seul ne suffit pas à prouver une dépense professionnelle. En dessous de 75 $, vous devez toujours tenir des registres — une mention dans votre journal de dépenses ou une entrée de calendrier peut suffire — mais la charge documentaire est moindre.
À retenir : extraire les données de reçus vers un tableur ne fait pas que gagner du temps. Cela crée un enregistrement numérique contemporain — qui satisfait à l'exigence de l'IRS selon laquelle la documentation doit être créée « au moment de la dépense ou peu après ». Une ligne de tableur avec commerçant, date, montant, description et catégorie, appuyée par une copie numérique du reçu original, correspond exactement à ce que l'IRS demande. Une boîte à chaussures remplie de reçus en papier thermique délavés correspond exactement à ce qu'il ne demande pas.
Ce que coûte l'extraction de reçus sans modèle — et ce qu'elle remplace
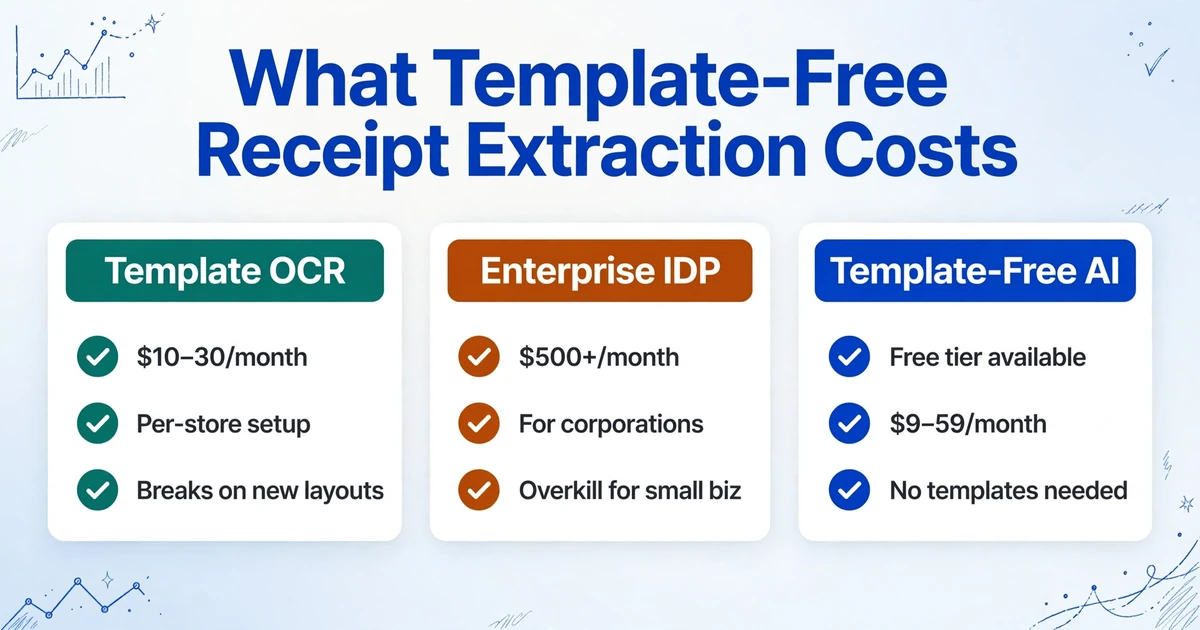
Les outils d'extraction de reçus couvrent un large éventail de prix, et les différences correspondent à la technologie sous-jacente. Les outils d'OCR par modèle commencent souvent à des tarifs plus bas — 10 à 30 $ par mois — mais exigent une configuration de modèle par magasin qui engloutit les économies en temps de paramétrage. Les plateformes IDP d'entreprise (Intelligent Document Processing) peuvent coûter plus de 500 $ par mois et sont conçues pour des grandes sociétés dotées d'équipes de mise en œuvre dédiées, pas pour un travailleur indépendant traitant 80 reçus par mois.
Les outils d'extraction par AI sans modèle appartiennent à une autre catégorie. ImageToTable.ai, par exemple, propose une offre gratuite qui vous permet de tester l'extraction sur vos propres reçus, puis des forfaits payants à 9 $/mois (Basic), 19 $/mois (Pro) et 59 $/mois (Max) — basés sur des Credits, vous payez donc ce que vous traitez plutôt qu'un abonnement fixe inutilisé pendant les mois creux.
Le calcul du seuil de rentabilité mérite d'être fait. Si le traitement manuel des reçus vous coûte 4 heures par mois à 32,23 $/heure (le salaire moyen américain selon le BLS en avril 2026), cela représente 129 $ de votre temps chaque mois. Un outil à 9 $/mois qui réduit cela à 30 minutes vous fait économiser 97 $ par mois rien qu'en main-d'œuvre — avant même de compter les déductions que vous ne manquez plus parce que les reçus ne se sont pas perdus. À 100 reçus par mois, les économies annuelles sur la main-d'œuvre, les déductions récupérées et le temps de préparation CPA réduit vont généralement de 1 500 $ à 3 000 $.
Il ne s'agit pas de remplacer votre logiciel de comptabilité. QuickBooks, Xero et Wave restent l'endroit où vivent vos livres. Expensify et Dext gèrent les flux de notes de frais et la synchronisation reçus-comptabilité. L'extraction sans modèle comble le vide qui précède tout cela : transformer la photo d'un reçu en données structurées que ces outils en aval peuvent ingérer. C'est l'étape d'entrée qui accélère tout ce qui suit.
L'extraction de reçus ne remplace pas la tenue de comptabilité. Elle remplace les micro-transactions de 30 secondes de saisie manuelle qui s'accumulent pour chaque reçu, chaque mois, chaque année — le coût invisible que les outils par modèle ne peuvent pas éliminer parce que le problème de la variété des formats est ancré dans leur architecture.
Questions fréquentes sur l’extraction de reçus
L’extraction de reçus fonctionne-t-elle avec les reçus en papier thermique décolorés ?
Cela dépend du degré de décoloration du reçu. Le papier thermique se dégrade en 6 à 12 mois dans des conditions de stockage normales — la chaleur, la lumière du soleil et même les pochettes en plastique de certains classeurs accélèrent la décoloration. Si le texte est encore visible à l’œil nu mais faible, l’extraction par IA peut souvent le lire, car le modèle interprète les motifs visuels à une résolution plus élevée que l’OCR traditionnel. Si le reçu est devenu complètement blanc, aucun logiciel ne peut récupérer un texte qui n’existe plus. La solution est simple : numérisez les reçus (photo ou scan) dès que vous les recevez, avant que le papier thermique n’ait le temps de se dégrader. Une fois numérisées, les données sont permanentes.
Quelle est la précision de l’extraction des lignes d’articles des reçus ?
La précision des lignes d’articles varie selon la qualité du reçu et la complexité de sa mise en page. Les reçus propres des grands détaillants nationaux, avec des grilles d’articles bien formatées, sont extraits avec une grande précision — 95 % à 99 % pour un texte clairement imprimé. Les reçus avec des noms d’articles abrégés (descriptions de 8 caractères provenant des systèmes de point de vente des dépanneurs), des mises en page multi-colonnes ou des dommages physiques produisent une précision moindre. L’extraction gère les formats mixtes dans le même lot : les reçus de haute qualité obtiennent des extractions quasi parfaites, et les reçus de basse qualité sont signalés pour révision. Vous n’êtes pas obligé d’accepter ou de rejeter tout le lot — les lignes individuelles peuvent être corrigées sans retraiter le reste.
L’extraction de reçus peut-elle catégoriser automatiquement les dépenses à des fins fiscales ?
Oui, grâce aux colonnes inférées. En définissant une colonne Catégorie avec des options prédéfinies (par exemple, « Repas / Déplacements / Fournitures de bureau / Équipement / Services publics / Autre »), l’IA lit le contenu de chaque reçu et attribue la catégorie appropriée. Un reçu de restaurant obtient « Repas ». Un reçu de station-service obtient « Déplacements ». Un reçu de Staples obtient « Fournitures de bureau ». Cela ne remplace pas le jugement d’un comptable ou d’un CPA — il existe des cas limites (un repas avec un client est-il « Repas » ou « Marketing » ?), et la décision finale de catégorisation vous appartient. Mais cela gère les 80 % de reçus dont les catégories sont sans ambiguïté, ce qui représente l’essentiel du temps manuel.
Puis-je traiter des reçus de 10 magasins différents en un seul lot ?
Oui — c'est l'utilisation principale de l'extraction sans modèle. Téléversez des reçus de Walmart, Home Depot, Amazon, votre café de quartier, Shell, Staples, un restaurant, un reçu manuscrit d'un fournisseur et trois autres magasins en un seul lot. Définissez vos noms de colonnes une seule fois. L'IA extrait les mêmes champs de chaque reçu, quel que soit le magasin qui l'a imprimé. Le résultat est une feuille de calcul avec une ligne par reçu, remplie à partir de plus de 10 formats.
L'IRS accepte-t-il les copies numériques des reçus ?
Oui, depuis 1997. L'IRS Revenue Procedure 97-22 a officiellement reconnu les enregistrements numériques comme légalement équivalents aux originaux papier. Un reçu scanné, une photo prise avec votre téléphone ou un PDF d'un reçu par e-mail ont tous la même valeur que l'original papier — à condition qu'ils soient lisibles, complets et récupérables pendant la période de conservation requise (généralement 3 ans, jusqu'à 7 ans dans certaines situations). Les cinq éléments requis sont le nom du vendeur, la date, le montant, la description et (le cas échéant) le mode de paiement. Un extrait de feuille de calcul contenant les cinq éléments, stocké avec l'image du reçu original, dépasse la norme de documentation.
Ce qui change lorsque vous cessez de traiter chaque reçu comme un problème de modèle
La variété des formats des reçus réels ne va pas disparaître. Chaque système POS imprime différemment. Chaque mise à jour de magasin réorganise la mise en page. Chaque nouveau commerçant introduit un format que vous n'avez jamais vu auparavant. Cette variété est une caractéristique permanente du paysage des reçus — et c'est la raison pour laquelle l'extraction basée sur des modèles atteint un plafond qu'aucune amélioration de la précision de l'OCR ne peut corriger.
Le passage de l'extraction basée sur des modèles à l'extraction sémantique est la différence entre traiter chaque reçu comme une mise en page unique à mémoriser et traiter tous les reçus comme des instances du même type de document à comprendre. Une approche évolue avec le nombre de magasins que vous configurez. L'autre évolue avec le nombre de reçus que vous traitez — et elle fonctionne dès le premier reçu d'un magasin que vous n'avez jamais rencontré auparavant, car elle lit la signification du reçu, pas sa mise en page.
Pour le travailleur indépendant qui traite 40 reçus par mois provenant de 15 commerçants différents, ou le propriétaire de petite entreprise qui traite 120 reçus par mois provenant de 25 fournisseurs différents, le calcul est le même : vous pouvez soit créer et maintenir des modèles pour chaque magasin où vous faites vos achats, soit utiliser une méthode qui n'en a pas besoin. La deuxième option est techniquement possible depuis un certain temps. Le problème de la variété des formats l'a simplement rendue nécessaire.
Essayez avec vos propres reçus — le niveau gratuit couvre suffisamment de volume pour traiter un mois de reçus et constater la différence par vous-même. Commencez avec quelques reçus de différents magasins et comparez le résultat à ce que vous saisiriez manuellement. La variété des formats que vous traitez au quotidien est le meilleur cas de test.