多言語抽出の精度が低下するのはなぜ?
3つのシナリオと具体的な修正方法
英語の請求書は96%の精度で抽出できます。同じツールでドイツ語の請求書を処理すると88%に低下します。そのドイツ語のヘッダーにフランス語の明細行が加わると、精度は80%近くまで下がります。これはAIの性能不足ではなく、特定可能な原因を持つ言語密度の問題です。
重要なポイント
- 英語では96%でも、ドイツ語の請求書では88%に低下します。これはツールのドイツ語処理能力が弱いからではなく、文書内に4つの言語が混在し、それらが1回の認識処理で共有されているためです。
- CJK文書は英語の同等文書の2倍のトークンを消費するため、各フィールドに同じ注意を払う前にモデルのコンテキストウィンドウが埋まってしまいます。
- フィールド単位・文書単位・混在スクリプトフィールド単位のいずれで診断するかという1つの問いで、3つのシナリオのどれに該当するかが分かります。そして3つの修正方法のいずれもツールの切り替えではありません。
パターンはいつも同じです。英語の文書でテストすると魔法のような結果が得られ、実際の文書に切り替えると——3カ国のサプライヤーからの請求書、2種類の文字体系で書かれた住所の配送ラベル、節の途中で言語が切り替わる契約書——精度が低下します。壊滅的ではありませんが、ツールが本当に機能しているのか疑問に思う程度には低下します。
機能しています。問題は、何を求めているかです。単一の英語の請求書は均一な入力です。1つの言語、1つの文字体系、1つの読み方向。フランス語の明細項目とスペイン語の支払条件が混在するドイツ語の請求書は、同じカテゴリの問題ではありません——精度はそれを反映します。3つの異なるシナリオのどれに該当するかを理解することが、何を修正すべきかを知ることと、間違ったものを責めることの違いです。
このガイドでは、精度低下が発生する最も一般的な3つのシナリオ、文書がどのシナリオに該当するかの見分け方、それぞれへの対処法を説明します。視覚AIが複数の言語をアーキテクチャレベルでどのように処理するかの概要については、AIは1つの文書内の複数の言語を読めるかを参照してください——この記事はその背景を前提とし、トラブルシューティング側に焦点を当てています。
シナリオ1:単一文書内の複数言語
これは精度低下の最も一般的な原因であり、ユーザーが通常気づいていないシナリオです。文書は「ドイツ語」ですが——ヘッダーは英語(会社名と住所)、明細項目はドイツ語の製品説明とフランス語の原材料名が混在し、フッターには法務チームが前四半期に選んだ言語で法的な定型文が含まれています。
ほとんどのAIビジョンモデルは、ページ全体を単一の視覚コンテキストとして処理します。従来のOCRのように「言語を切り替える」のではなく、すべてを一度に読み取り、各文字の文字体系を同じ推論パスの中で解決します。これは事前選択された言語パックを必要とするOCRエンジンに対する利点ですが、微妙な問題も生み出します:異なる言語のテキストが同じ視野内に現れると、モデルは文字境界、特殊文字(é、ü、ñ、ß)、文脈依存の字形を同時に解決する必要があるため、文字の信頼度が低下します。
単一の多言語請求書で実際に起こることは次のとおりです:
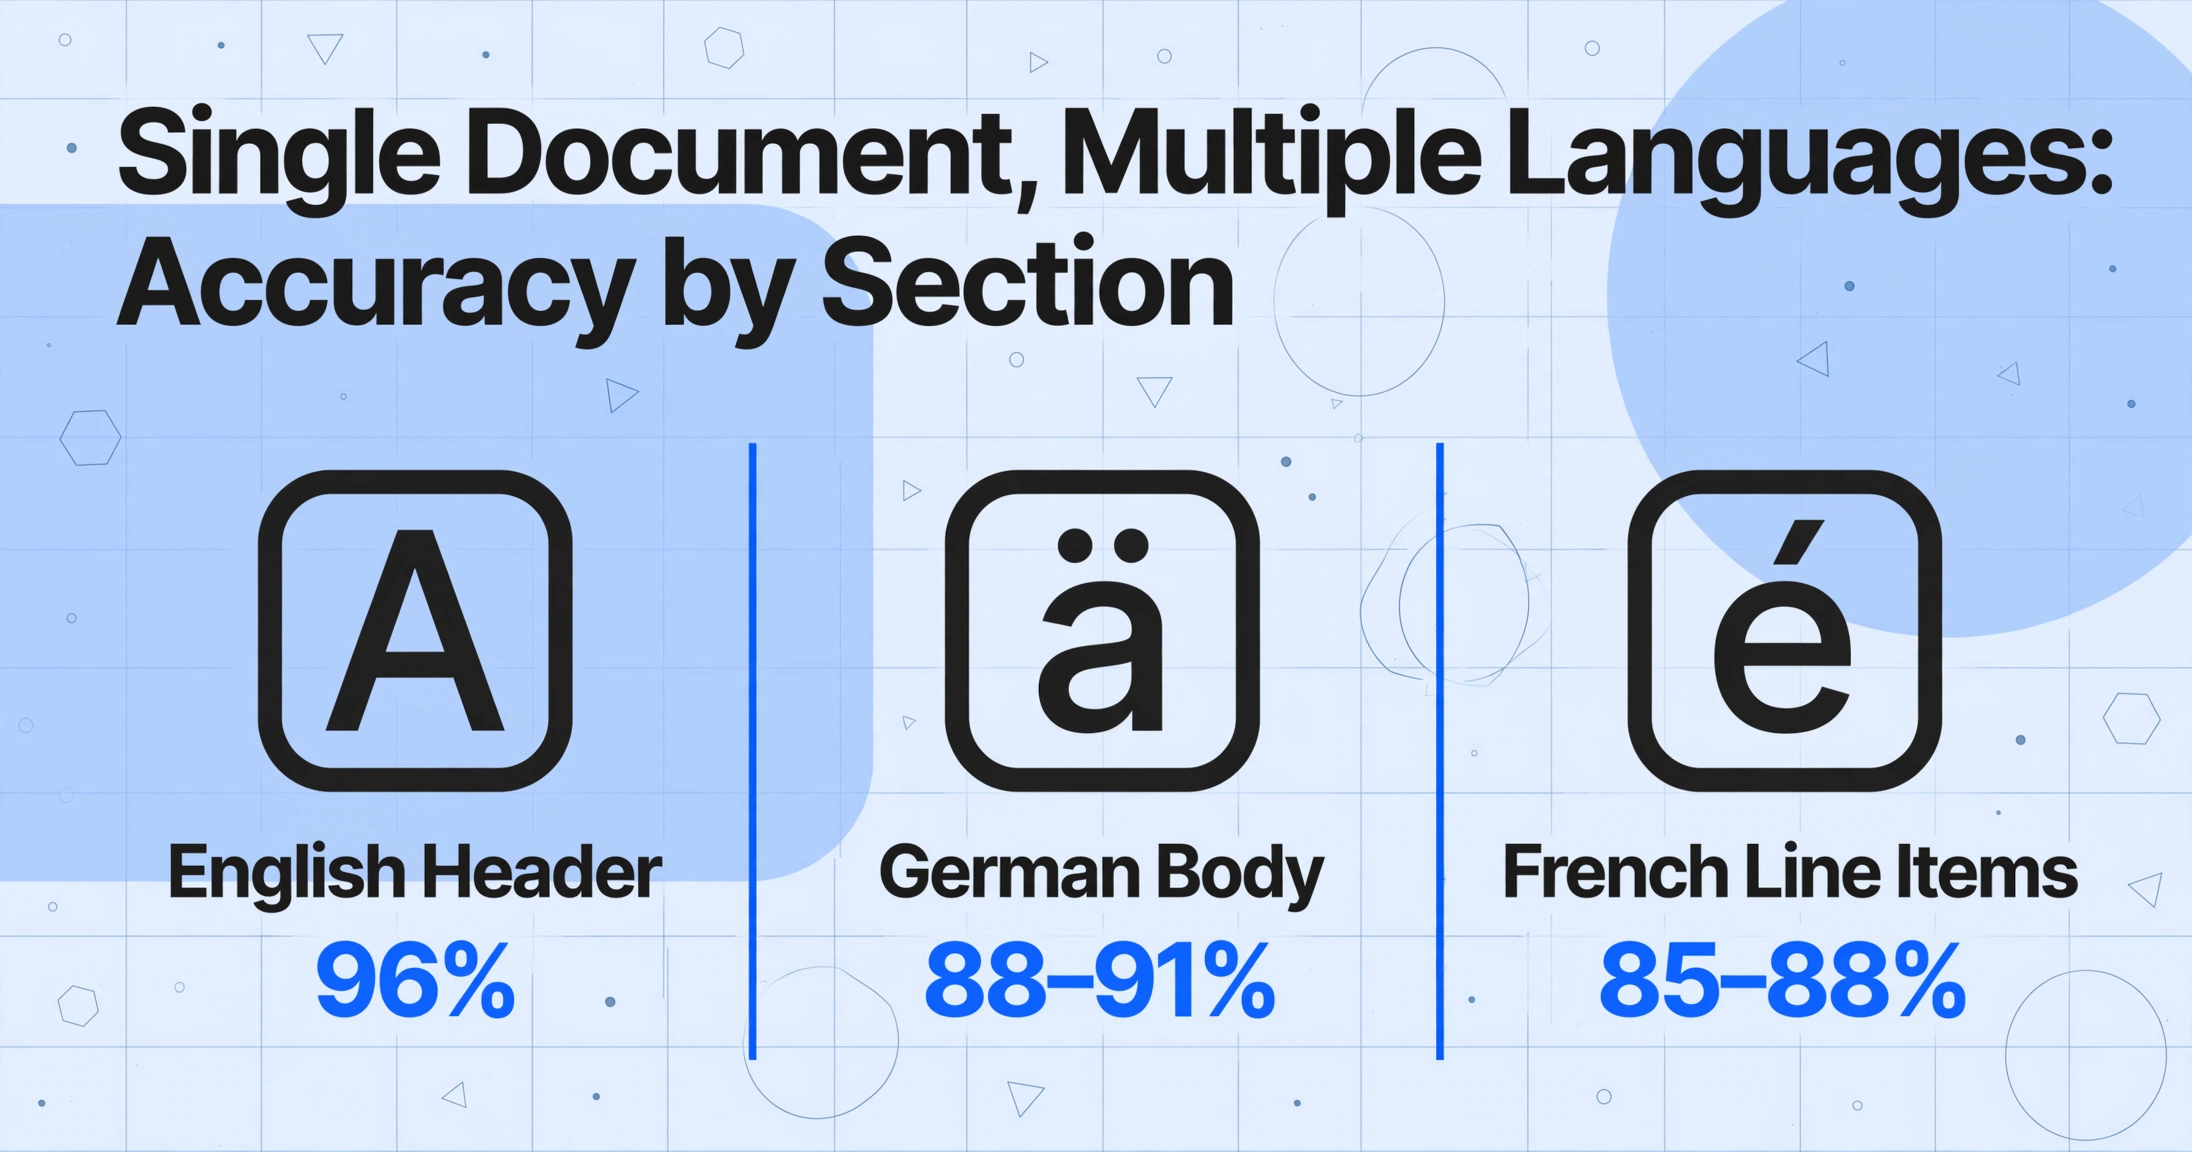
- 英語ヘッダー(会社名、住所)— 精度96%。モデルが最も強い領域です。
- ドイツ語本文(ウムラウト付きの項目説明、「€」通貨、ドイツ語の日付形式)— 精度88〜91%。ウムラウト(ä、ö、ü)が欠落または置換されます。「14.03.2026」が英語の「03/14/2026」と混同されます。
- フランス語の明細項目(アクセント付き文字:é、è、ê、œ)— 精度85〜88%。混在グリフ行のアクセントでエラーが蓄積され、「générique」のような単語が「generique」や「g6n6rique」になります。
- スペイン語の支払条件(ñと逆さ疑問符・感嘆符)— 精度82〜87%。モデルはフッターに到達するまでに、ドイツ語とフランス語のセクションで文字解決のリソースを使い果たしています。
これらは最悪のケースの数字ではありません。3つのラテン文字言語を切り替える文書では一般的な数字です。同じアルファベットを共有しながらも、特殊文字、日付形式、通貨表記が異なります。
診断: 同じ文書内でフィールドごとの精度が異なる場合(日付はベンダー名より信頼性が高く、数字はきれいでもアクセント付き文字が壊れているなど)、シナリオ1の可能性が高いです。
修正: 全ページOCRの代わりにカスタム列抽出を使用してください。特定の出力列(「仕入先名」「請求日」「合計金額」など)を定義すると、AIはページ上のすべての文字を均等に処理しようとするのではなく、意味的にそれらの値を探すことに集中します。「合計金額(EUR)」という列は、周囲のテキストがドイツ語、フランス語、スペイン語のいずれであっても、通貨記号の近くの数字を探すようにモデルに指示します。列ベースの抽出が文書タイプを超えてどのように機能するか詳しくは、AI文書抽出の仕組みと列定義が重要な理由をご覧ください。
文書が複数のラテン文字言語を混在させている場合、修正策はほぼ常に「より良いモデル」ではなく「より良い抽出戦略」です。AIに「すべてを読み取る」と指示するのではなく、必要なフィールドを正確に指定してください。複数言語の文書における生のOCRとターゲット列抽出の精度差は、通常5〜10%です。
シナリオ2: 文字体系の違い — ラテン文字 vs. CJK vs. アラビア文字
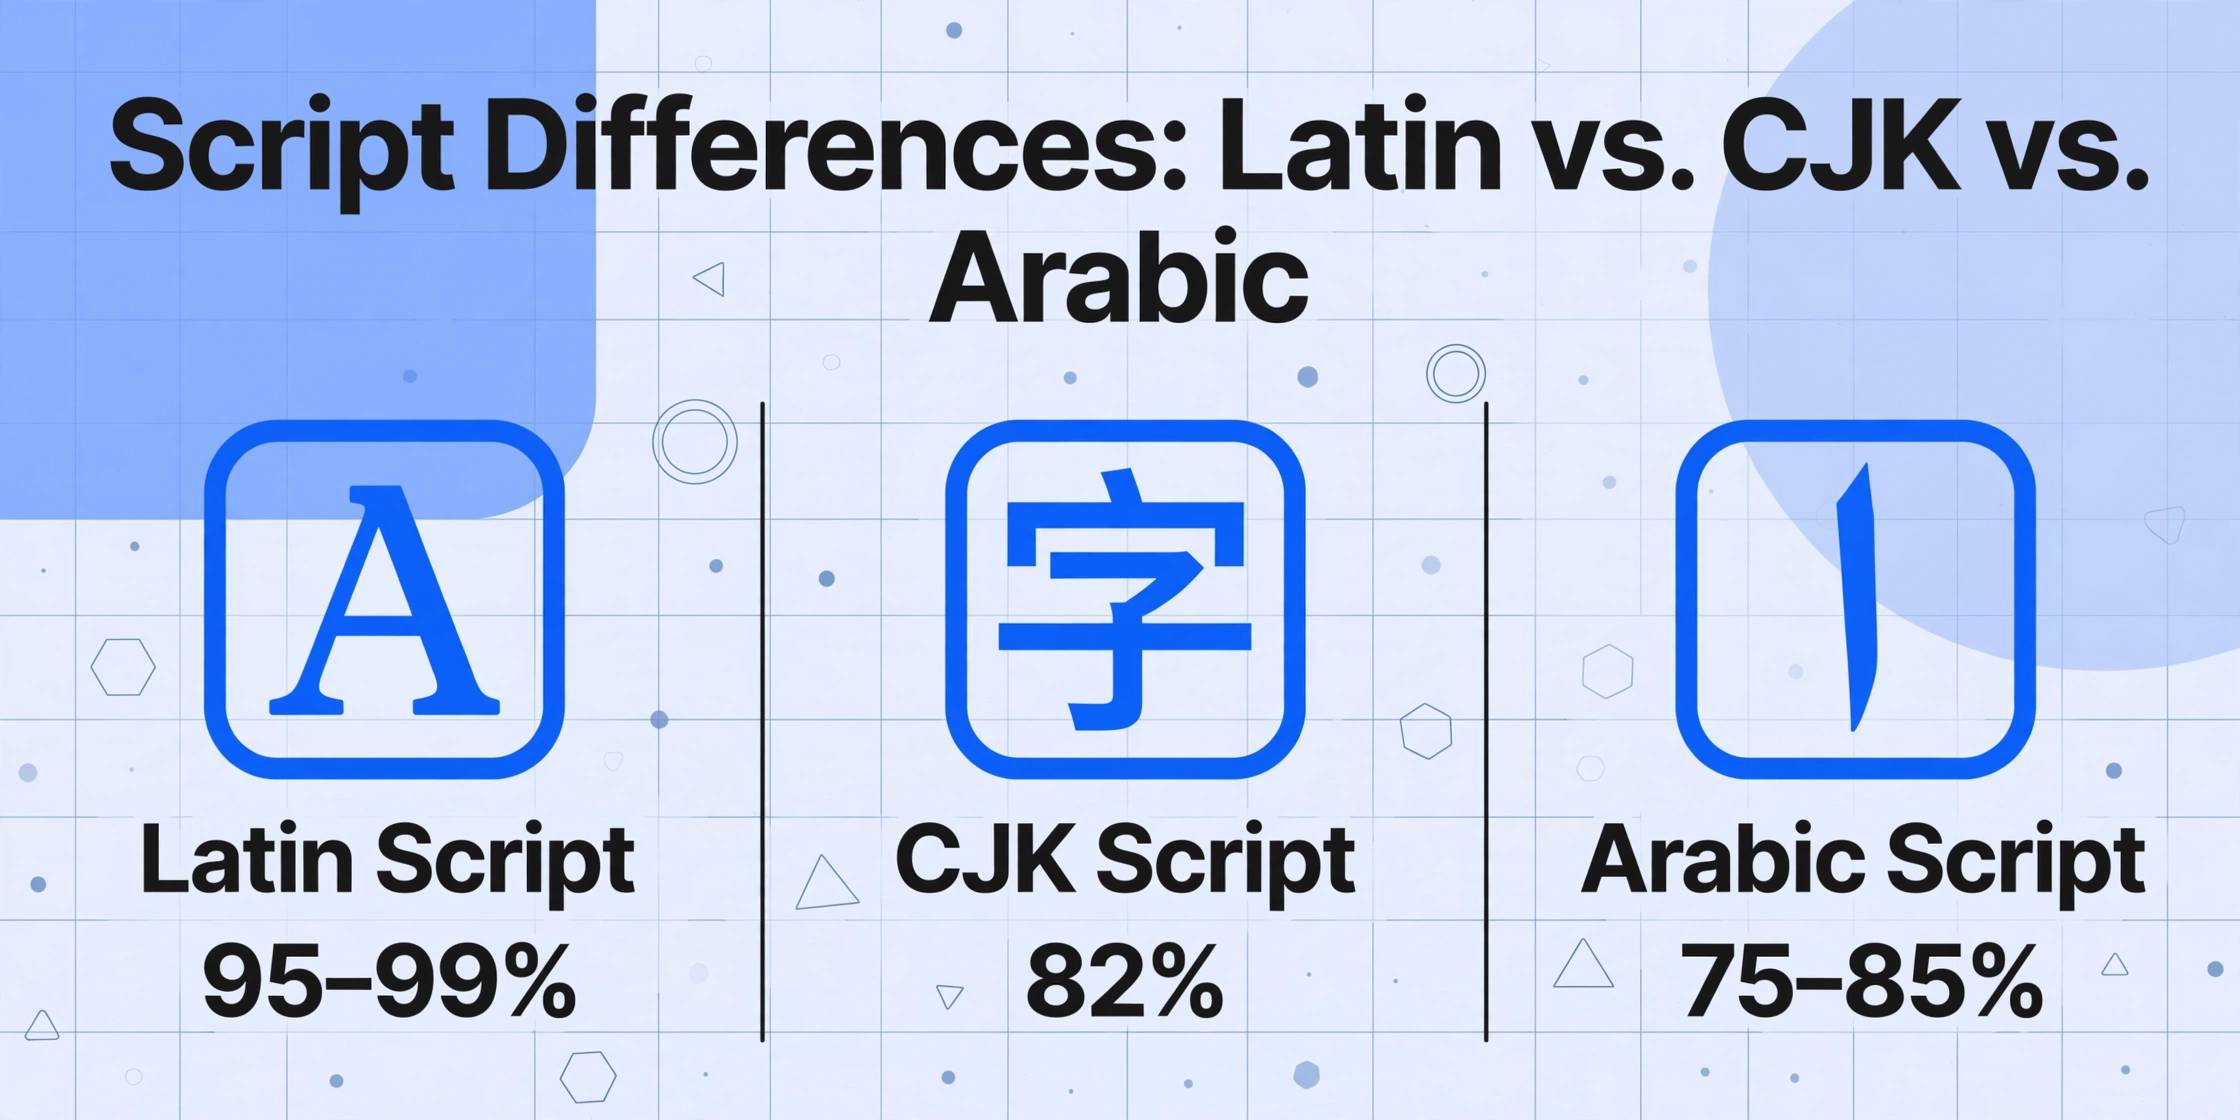
ここで精度の低下は「煩わしい」から「ワークフローを壊す」レベルに達します。英語の請求書は96%で抽出され、日本語の請求書は82%で抽出されます。日本語の文書の品質が低いからではなく、文字体系が視覚モデルに挑む方法が根本的に異なるからです。
ラテン文字(英語、フランス語、ドイツ語、スペイン語、ポルトガル語、イタリア語、オランダ語)は、26文字のアルファベット、左から右への読み方向、豊富なトレーニングデータを共有しています。これらは現代の視覚AIにとって解決済みの問題であり、きれいな印刷ラテン文字の精度は一貫して95〜99%に達します。
CJK文字(中国語、日本語、韓国語)は難易度が異なる層です。日本語の1つの文には、漢字(数千の中国起源の文字)、ひらがな(46の音声文字)、カタカナ(外来語用の46の音声文字)、英語用のラテン文字、アラビア数字をすべて1行に含めることができます。日本語の同じ意味内容は英語の約2倍のトークンを消費するため、モデルはCJK文書でコンテキストウィンドウをより速く満たし、フィールドごとに利用できる情報が少なくなります。この密度問題の実用的な例については、日本語のレシートデータをExcelに抽出するに関する記事をご覧ください。
アラビア語とヘブライ語は、右から左への方向性という課題を追加します。モデルは読み方向が反転することを検出し、テキストブロックごとに正しく適用し、アラビア語の4位置文字形(文字が単語の先頭、中間、末尾、または単独で現れるかによって形が変わる)を処理する必要があります。印刷されたアラビア語文書の精度は75〜85%の範囲です。これはモデルがアラビア語の文字に特に弱いからではなく、RTLの組版規則が左から右へのスクリプトとは異なる視覚的解析問題を生み出すためです。
診断:英語の文書が95%以上で抽出でき、非ラテン文字の文書が一貫して10〜20%低い場合(1つの文書だけでなく、複数の文書にわたって)— それはシナリオ2に該当します。
修正:ここでは2つのアプローチが有効です。まず、処理する特定のスクリプトに対するツールの言語サポートを確認します。「100以上の言語をサポート」と主張するすべてのツールが、すべてのスクリプトで同等にトレーニングされているわけではありません。一部のビジョンモデルは、ラテン語データに不均衡にトレーニングされており、CJKとアラビア語はより小さな二次コーパスとして追加されています。モデルのトレーニングデータに必要なスクリプトファミリーが含まれているかどうかを具体的に確認してください。次に、ツールのデモ画像ではなく、実際の文書の代表的なサンプルでテストします。ベンダーの日本語のデモ請求書は、完璧なコントラストを持つクリーンなデジタル作成画像です。2019年にスキャンした日本語の請求書で、サプライヤー名の上に色あせたスタンプがある場合は、まったく異なる認識問題です。
シナリオ3:同一フィールド内の混在スクリプト
これは最も難しいケースであり、ほとんどのドキュメントが省略しているケースです。文書の単一フィールドに複数のスクリプトの文字が含まれています。「ABC-1234-안전밸브」のような部品番号(英字、アラビア数字、韓国語ハングル)。「株式会社Yamada (Osaka Branch)」と読めるサプライヤー名フィールド。「2026年03月14日」と書かれた日付フィールド— CJKテキストに埋め込まれたアラビア数字。
ビジョンモデルは、各文字クラスターを独立して認識し、それらを一貫した文字列に組み立てることで、混在スクリプトフィールドを処理します。しかし、このプロセスには、混在スクリプトシナリオに固有のいくつかの障害モードが導入されます:
- スクリプト境界の誤検出:モデルは、あるスクリプトが終わり、別のスクリプトが始まる場所を誤って判断します。視覚的にCJK表意文字に似ている韓国語のハングル文字が誤ったスクリプトグループに分類され、後続の文字が誤った認識コンテキストで解析される可能性があります。
- 文字の置換:スクリプト間で似た文字が交換されます。ラテン文字の「A」、キリル文字の「А」、ギリシャ文字の「Α」は視覚的にほぼ同一ですが、異なるUnicode文字です。ラテン文字の「A」を含む製品コードがキリル文字の「А」として出力される可能性があります— 視覚的に同一で、意味的に間違っており、正しく見えるためスポットチェックでは検出できません。
- 混在LTR/RTLフィールドでの方向の混乱:アラビア語の会社名の後に括弧内の英語の登録番号が続くと、モデルが正しく順序付けする必要がある双方向文字列が作成されます。「(ABC-1234 شركة")」の代わりに「شركة (ABC-1234)」のような出力が一般的です— 両方の文字が存在しますが、読み順が逆になっています。
診断:抽出されたデータが視覚的にもっともらしく見えるが、既知の参照と照合すると失敗する場合— すべての正しい文字があるように見えるがERPと一致しない部品番号、または人間の目視検査は通過するがルックアップ失敗を引き起こすサプライヤー名— シナリオ3が原因である可能性が高いです。
修正: 言語ヒントによる前処理で、混在スクリプトのエラーを大幅に削減できます。多くのビジョンモデルは言語を自動検出しますが、抽出コンテキストを明示的に固定することで効果が高まります。対応ツールでは、「この文書の主要言語は韓国語で、英語の製品コードが埋め込まれている」といったヒントを渡すことで、モデルがスクリプトの境界を認識エラーとして扱わずに期待できるようになります。精度が重要なフィールド(税ID、部品番号、登録コード)では、言語別スポットチェック検証が最も信頼できる防御策です。データを抽出したら、非ラテン文字部分とラテン文字部分を分けて検証します。参照データベース(ERP、CRM、仕入先リスト)があれば、抽出値を照合することで、目視では決して見つけられない文字置換エラーを検出できます。
どのシナリオに該当するかを診断する方法
多言語文書で精度の低下に気づいたら、他の設定を変更する前に、次の3つの質問で診断してください。
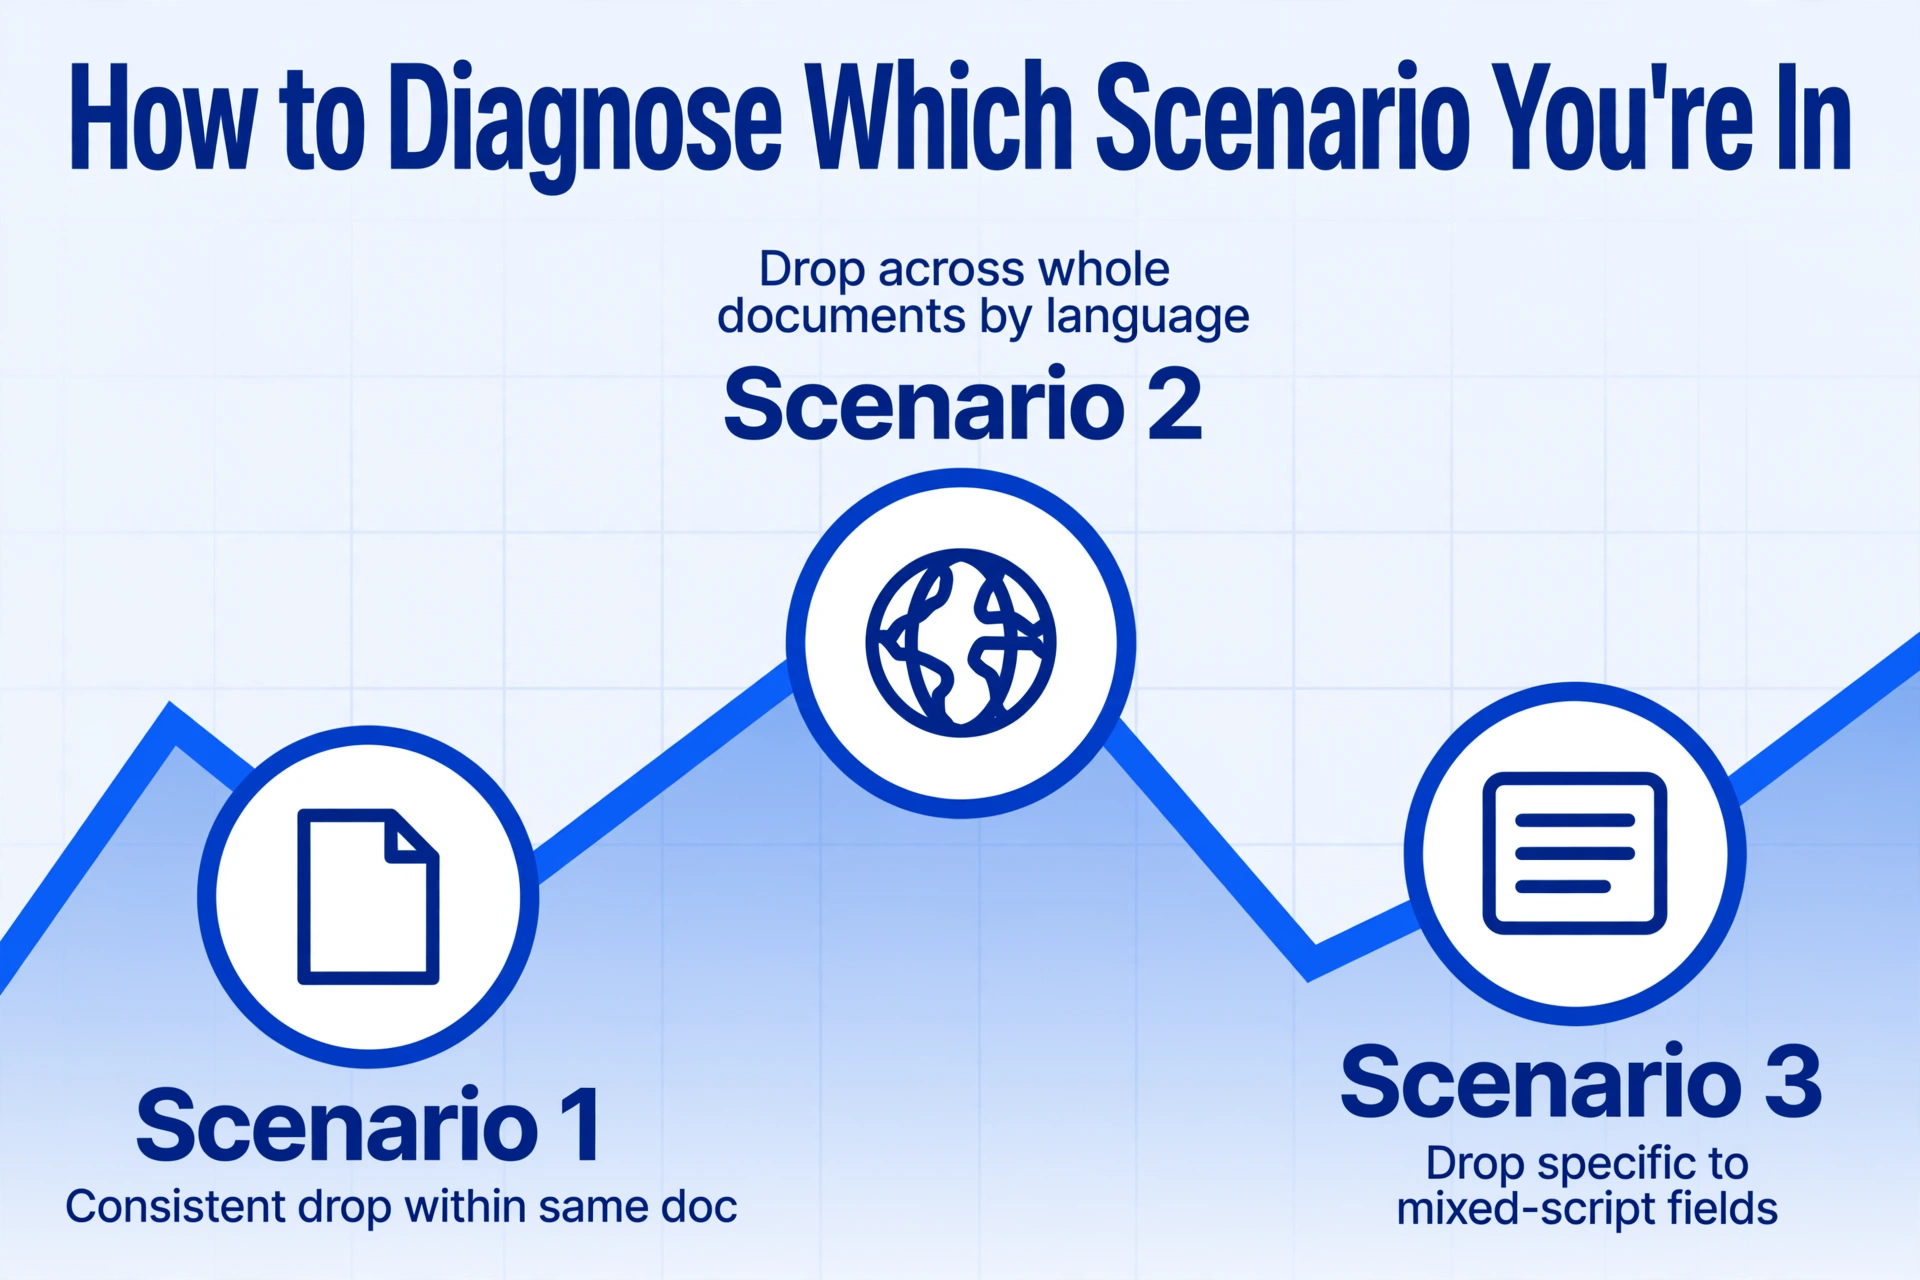
- 精度の低下は、同じ文書内で言語を問わず一貫していますか? 英語のフィールドは常に正確で、フランス語やウムラウトを含むフィールドが同じ文書内で一貫して劣化している場合 → シナリオ1。セマンティックなフィールド定義を用いた列ベースの抽出を試してください。
- 精度の低下は、言語ファミリーごとに文書全体で一貫していますか? 内容に関係なく、すべての日本語文書がすべての英語文書より抽出精度が低い場合 → シナリオ2。そのスクリプトに対するツールのトレーニングデータのカバレッジを確認してください。
- 精度の低下は、混在スクリプトを含む特定のフィールドに限られていますか? 仕入先名は正確なのに、漢字やアラビア文字が埋め込まれた部品番号でエラーが多い場合 → シナリオ3。前処理の言語ヒントを追加し、フィールドごとの照合を実装してください。
これらの3つのシナリオは重複することがよくあります。1つのページに、異なるスクリプト(シナリオ2)にわたる複数の言語(シナリオ1)と、混在スクリプトのフィールド(シナリオ3)が含まれることがあります。診断の質問は、どのレイヤーを最初に修正すべきかを示します。間違ったレイヤーを修正すると時間の無駄になるからです。 シナリオ2に該当する場合、列の改善(シナリオ1の修正)をいくら行っても精度のギャップは回復しません。モデルにはより良いプロンプトではなく、異なるトレーニングカバレッジが必要です。
予防策:多言語の精度低下を抑える3つの習慣
シナリオを特定したら、以下の習慣で新しい文書タイプや言語でも同じ問題が再発するのを防げます。
1. 可能な場合はスクリプトファミリーごとに文書を分ける。 毎日200件の請求書を処理していて、そのうち150件がラテン文字系言語、50件がCJKだとします。これらを別々にバッチ処理すれば、独立した2つの精度ベースラインが得られます。ラテン文字系の抽出精度が95%以上、CJKが82%であることが分かります。CJKバッチが突然70%に落ちたら、すぐに気づけます。混在させると、全体平均が93%から90%に下がっても誰もエスカレーションしません。
2. 言語ごとの検証サンプルを維持する。 処理する各言語ファミリーについて、代表的な文書を5〜10件選びます。抽出ワークフローを更新したりツールを切り替えたりするたびに、検証セットを実行して言語ごとの精度を比較します。これにより、本番環境に到達する前にリグレッションを検出できます。ラテン文字系の精度を2%向上させてもCJKの精度を8%低下させるツールは、多言語ワークフローにとって正味の改善とは言えません。
3. 言語ごとに異なるフィールドレベルの信頼度しきい値を使用する。 同じ文書の英語フィールドとアラビア語フィールドに同じ「信頼度が90%を超えたら受け入れる」ルールを適用しないでください。英語では90%の信頼度しきい値が厳しすぎるかもしれません(すべてが通過する)が、同じしきい値をアラビア語に適用するとすべての抽出が拒否される可能性があります。検証サンプルの結果に基づいて言語ごとのしきい値を設定します(アラビア語75%、ラテン文字系90%、CJK 80%)。しきい値を下回るものは黙って受け入れるのではなく、手動レビューに回します。
エスカレーションのタイミング — 手動処理が必要なケース
この記事で最も重要なのは正直さです。 Vision AIは言語を問わず非常に高い能力を持っていますが、プロンプトの調整や前処理をいくら行っても精度のギャップを本番レベルまで埋められない境界条件があります。
- 異なるスクリプトファミリーにまたがる4言語以上の文書。 同じページに英語(ラテン文字)、アラビア語(RTL)、日本語(CJK縦書き+横書き)、韓国語(CJK横書き)が含まれる文書は、現在のビジョンモデルの能力の限界にあります。単一言語のベースラインから5〜15%の精度低下が予想されます。
- 同じ文または表セル内のRTL/LTR混在。 アラビア語と英語が括弧関係で同じ行に現れる場合(例:契約条項の「البند (Item) 4.2」)、双方向解析によって構造エラーが発生し、前処理のヒントでは部分的にしか修正できません。
- 非ラテン文字での手書きコンテンツ。 手書きだけでも印刷テキストと比較して精度が15〜30%低下します。そこに第二言語が加わると(手書きの日本語に手書きのアラビア数字)、複合効果でほとんどの抽出が使用可能なしきい値を下回ります。これらの文書は印刷部分のAI抽出には依然として有効ですが、手書きフィールドは例外ではなくデフォルトのワークフローとして手動入力に回すべきです。
- 低リソース言語の組み合わせ。 タイ語/アラビア語、スワヒリ語/キリル文字、ビルマ語/英語 — どちらの言語もビジョンモデルのトレーニングにおいて個別には高リソースではない組み合わせです。これらの文書の精度下限は、英語/スペイン語や英語/中国語のようなカバレッジの高い組み合わせよりも低くなります。
実用的なワークフロー:AI抽出は多言語データの80〜90%を自動処理します。残りの10〜20% — 混在スクリプト文書の高リスク項目、RTL/LTR混在テキストの重要な数値項目、手書きの非ラテン文字入力 — は、完全な手動入力より速く、最も難しいケースでAIを信頼するより信頼性の高い、人間によるレビューステップに回されます。
FAQ
AI抽出ツールが英語の請求書では優れた結果を出すのに、ドイツ語やフランス語では劣るのはなぜですか?
これは通常、シナリオ1です。英語の文書は、スクリプトの曖昧さがない単一言語の入力です。ドイツ語やフランス語の文書には、視覚モデルが標準的なラテン文字のバリエーションとして扱う特殊文字(Umlauts、アクセント記号)が含まれている可能性が高く、これらのバリエーションは、アクセントのない文字よりもトレーニングデータに出現する頻度が低いため、信頼度が低くなります。英語と他のラテン文字言語の間の精度ギャップは通常5〜8%で、顕著ですが、モデルをページ全体のOCRではなく特定のフィールドに集中させる列ベースの抽出で修正可能です。
文書を先に単一言語に変換することで、多言語抽出の精度を向上できますか?
確実にはできません。抽出前の機械翻訳は、別のエラーレイヤーを導入します — 翻訳されたテキストから抽出することになり、フィールドラベル、数値形式、文書構造が失われる可能性があります。元の文書には、作成者が意図したレイアウトとデータが含まれています。抽出は、翻訳版ではなく元の文書を読むときに最も効果的に機能します。より良いアプローチは、セマンティック列定義を使用して元の文書から抽出し、その後、ダウンストリームシステムが必要とする言語に関係なく、抽出されたデータを検証することです。
AIは処理前に文書に含まれる言語を知っている必要がありますか?
検出に関しては不要です — 最新の視覚モデルは、ページを読む一環としてスクリプトと言語を自動的に検出します。ただし、コンテキストに関しては必要です — 文書に珍しい言語の組み合わせや混在スクリプトのフィールドが含まれている場合、言語ヒント(例:「この文書には韓国語と英語が含まれ、アラビア数字が埋め込まれています」)を提供すると、モデルが認識リソースをより効率的に割り当てるため、二次言語部分の精度が3〜7%向上します。
同じツールでラテン文字文書とCJK文書を処理した場合、精度にどの程度の差が出ますか?
同程度の品質の印刷文書であれば、同じツールでもCJKの精度はラテン文字より8~15%低くなると想定してください。これはツールの品質問題ではなく、文字数(26 vs 数千)、意味単位あたりのトークン消費量(2倍)、学習データ量の根本的な違いを反映したものです。英語で97%のスコアを出すツールが日本語で83%であれば、現在のビジョンAIの水準としては正常なパフォーマンスです。
言語ごとに異なるAI抽出ツールを使うべきですか?
文書が複数の文字体系ファミリーにまたがる場合(同じ文字体系内の複数言語ではなく)、特定の地域スクリプトに最適化されたツールを使うことで、言語ごとの精度を高められます。例えばPaddleOCRは、学習データがCJK中心であるため、汎用ビジョンモデルよりもCJK文書で優れた性能を発揮します。ただし、複数ツールの管理はワークフローの複雑さを招き、精度向上のメリットを上回る可能性があります。有効なアプローチの一つは、汎用ビジョンAIツールを全言語の一次抽出器として使い、一次ツールの信頼度が閾値を下回った場合のみ、特定スクリプトの文書を専門のフォールバックエンジンに振り分ける方法です。
単一ラテン文字文書と多言語文書の間の精度低下は、技術の失敗ではありません。それは予測可能で、診断可能で、大部分は修正可能なギャップです。診断の問いから始め、該当するシナリオに応じた修正を適用し、現在のビジョンモデルがまだ学習中のエッジケースには手動レビューを残してください。ご自身の多言語文書でテストし、どのシナリオが該当するか確認してください。