Warum sinkt die Genauigkeit meiner mehrsprachigen Extraktion?
3 Szenarien & konkrete Lösungen
Ihre englische Rechnung wird mit 96 % Genauigkeit extrahiert. Dasselbe Tool fällt bei einer deutschen Rechnung auf 88 %. Fügen Sie französische Positionen zum deutschen Kopf hinzu, sind es nur noch rund 80 %. Das ist kein Versagen der KI – es ist ein Sprachdichteproblem mit konkreten, behebbaren Ursachen.
Die wichtigsten Erkenntnisse
- 96 % auf Englisch fallen auf 88 % bei Ihrer deutschen Rechnung – nicht weil das Tool bei Deutsch schwächer ist, sondern weil Ihr Dokument heimlich vier Sprachen in einem einzigen Erkennungsdurchlauf enthält.
- Ein CJK-Dokument verbraucht doppelt so viele Tokens wie sein englisches Pendant und füllt den Kontextrahmen des Modells, bevor es jedem Feld die gleiche Aufmerksamkeit widmen kann.
- Eine Diagnosefrage – pro Feld, pro Dokument oder pro gemischt-schriftlichem Feld – zeigt Ihnen, in welchem der drei Szenarien Sie sich befinden, und keine der drei Lösungen besteht darin, das Tool zu wechseln.
Das Muster ist immer dasselbe: Sie testen mit englischen Dokumenten, erzielen Ergebnisse, die sich wie Magie anfühlen, und wechseln dann zu Ihrer echten Dokumentmischung – Rechnungen von Lieferanten aus drei Ländern, Versandetiketten mit Adressen in zwei Schriften, Verträge, die mitten im Satz die Sprache wechseln – und die Genauigkeit sinkt. Nicht katastrophal, aber genug, dass Sie sich fragen, ob das Tool wirklich funktioniert.
Es funktioniert. Die Frage ist, was Sie von ihm verlangen. Eine einzelne englische Rechnung ist eine einheitliche Eingabe: eine Sprache, eine Schrift, eine Leserichtung. Eine deutsche Rechnung mit französischen Positionszeilen und spanischen Zahlungsbedingungen ist nicht dieselbe Kategorie von Problem – und die Genauigkeit spiegelt das wider. Zu verstehen, mit welchem von drei verschiedenen Szenarien Sie es zu tun haben, ist der Unterschied zwischen zu wissen, was zu beheben ist, und dem falschen Ding die Schuld zu geben.
Dieser Leitfaden behandelt die drei häufigsten Szenarien für Genauigkeitsabfälle, wie Sie erkennen, welches auf Ihre Dokumente zutrifft, und was Sie jeweils tun können. Für einen breiteren Überblick darüber, wie Vision-KI mehrere Sprachen auf architektonischer Ebene verarbeitet, siehe kann KI mehrere Sprachen in einem Dokument lesen – dieser Artikel setzt dieses Hintergrundwissen voraus und konzentriert sich auf die Fehlerbehebungsseite.
Szenario 1: Einzelnes Dokument, mehrere Sprachen
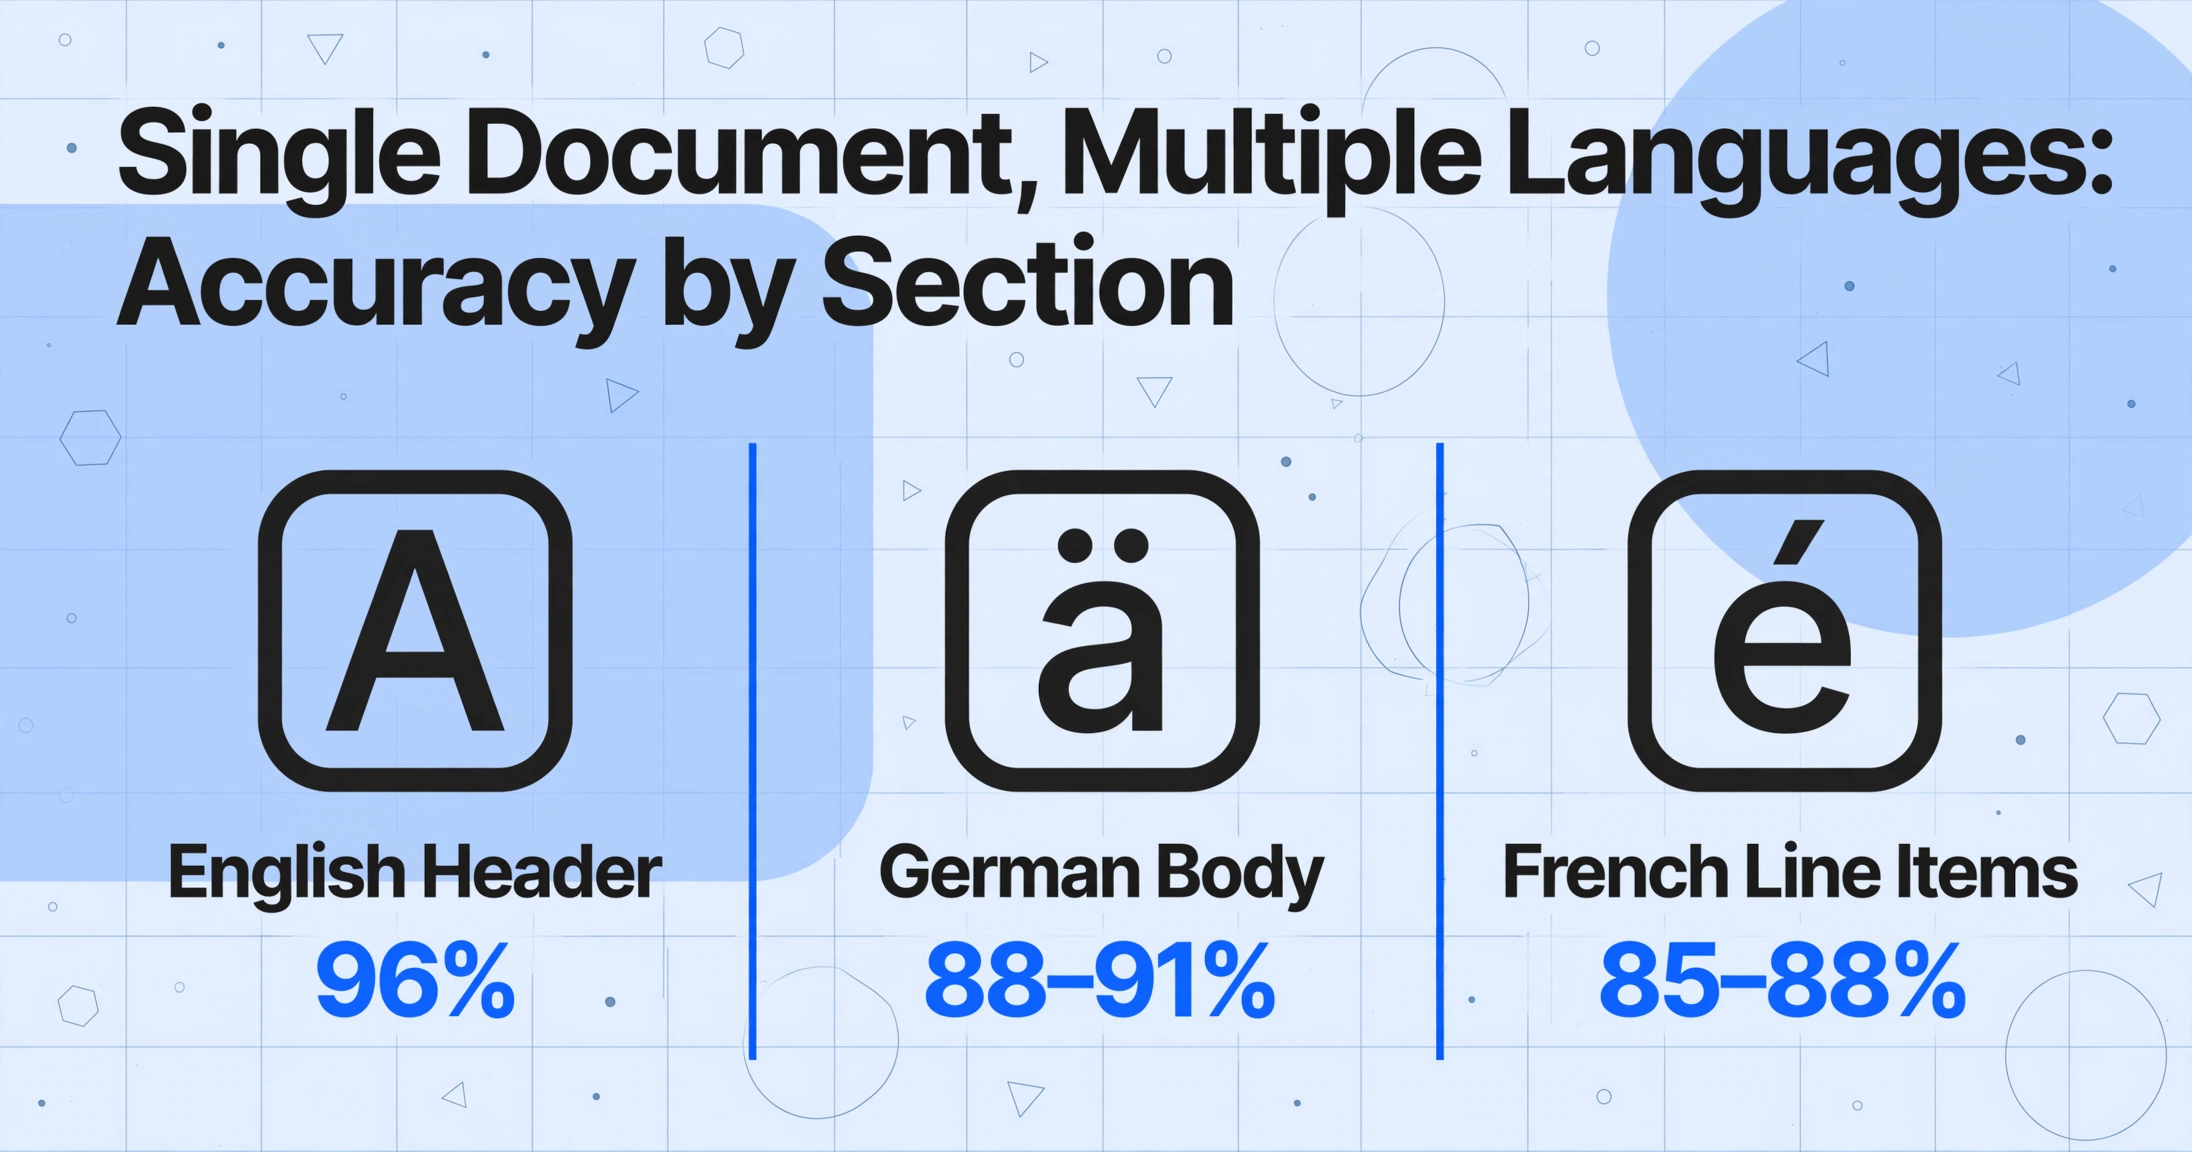
Dies ist die häufigste Ursache für Genauigkeitsabfälle – und diejenige, bei der Nutzer typischerweise nicht erkennen, dass sie damit zu tun haben. Ihr Dokument ist „auf Deutsch" – aber der Kopfbereich ist auf Englisch (Firmenname und Adresse), die Positionszeilen mischen deutsche Produktbeschreibungen mit französischen Zutatenbezeichnungen, und die Fußzeile enthält rechtliche Standardtexte in der Sprache, die die Rechtsabteilung letztes Quartal gewählt hat.
Die meisten KI-Vision-Modelle verarbeiten die gesamte Seite als einen einzigen visuellen Kontext. Sie „wechseln" nicht die Sprache wie herkömmliche OCR – sie lesen alles auf einmal und bestimmen die Schrift jedes Zeichens als Teil desselben Inferenzdurchlaufs. Das ist ein Vorteil gegenüber OCR-Engines, die ein vorab ausgewähltes Sprachpaket benötigen, erzeugt aber ein subtiles Problem: Wenn Text in verschiedenen Sprachen im selben visuellen Feld erscheint, sinkt die Zeichenkonfidenz des Modells, weil es gleichzeitig Schriftsystemgrenzen, Sonderzeichen (é, ü, ñ, ß) und kontextabhängige Buchstabenformen auflösen muss.
So sieht das in der Praxis bei einer einzelnen mehrsprachigen Rechnung aus:
- Englischer Kopfbereich (Firmenname, Adresse) – 96 % Genauigkeit. Das Modell ist in seinem stärksten Bereich.
- Deutscher Hauptteil (Artikelbeschreibungen mit Umlauten, „€"-Währung, deutsches Datumsformat) – 88–91 % Genauigkeit. Umlaute (ä, ö, ü) werden weggelassen oder ersetzt; „14.03.2026" wird mit dem englischen „03/14/2026" verwechselt.
- Französische Positionszeilen (Zeichen mit Akzenten: é, è, ê, œ) – 85–88 % Genauigkeit. Akzente auf Zeilen mit gemischten Glyphen summieren Fehler; ein Wort wie „générique" wird zu „generique" oder „g6n6rique".
- Spanische Zahlungsbedingungen (ñ und invertierte Satzzeichen) – 82–87 % Genauigkeit. Das Modell hat sein Zeichenauflösungsbudget bereits für die deutschen und französischen Abschnitte aufgebraucht, bevor es die Fußzeile erreicht.
Das sind keine Worst-Case-Zahlen. Sie sind typisch für ein Dokument, das zwischen drei lateinischen Schriftsystemen wechselt – alle teilen dasselbe Alphabet, unterscheiden sich jedoch bei Sonderzeichen, Datumsformaten und Währungsnotationen.
Diagnose: Wenn Ihre Genauigkeit pro Feld innerhalb desselben Dokuments variiert – Daten zuverlässiger sind als Lieferantennamen oder Zahlen sauber sind, während akzentuierte Zeichen beschädigt werden – befinden Sie sich wahrscheinlich in Szenario 1.
Lösung: Verwenden Sie Benutzerdefinierte Spaltenextraktion anstelle von OCR für die gesamte Seite. Wenn Sie spezifische Ausgabespalten definieren (wie „Lieferantenname“, „Rechnungsdatum“, „Gesamtbetrag“), konzentriert sich die KI darauf, diese Werte anhand der semantischen Bedeutung zu finden, anstatt zu versuchen, jedes Zeichen auf der Seite gleichmäßig zu verarbeiten. Eine Spalte namens „Gesamtbetrag (EUR)“ sagt dem Modell, dass es nach einer Zahl in der Nähe eines Währungssymbols suchen soll, unabhängig davon, ob der umgebende Text Deutsch, Französisch oder Spanisch ist. Für einen tieferen Einblick, wie spaltenbasierte Extraktion über Dokumenttypen hinweg funktioniert, siehe wie KI-Dokumentextraktion funktioniert und warum Spaltendefinition wichtig ist.
Wenn Ihr Dokument mehrere lateinische Schriftsysteme mischt, ist die Lösung fast nie ein besseres Modell – sondern eine bessere Extraktionsstrategie. Sagen Sie der KI nicht „alles lesen“, sondern geben Sie genau an, welche Felder Sie benötigen. Der Genauigkeitsunterschied zwischen roher OCR und gezielter Spaltenextraktion bei einem gemischtsprachigen Dokument beträgt typischerweise 5–10 %.
Szenario 2: Schriftunterschiede – Lateinisch vs. CJK vs. Arabisch
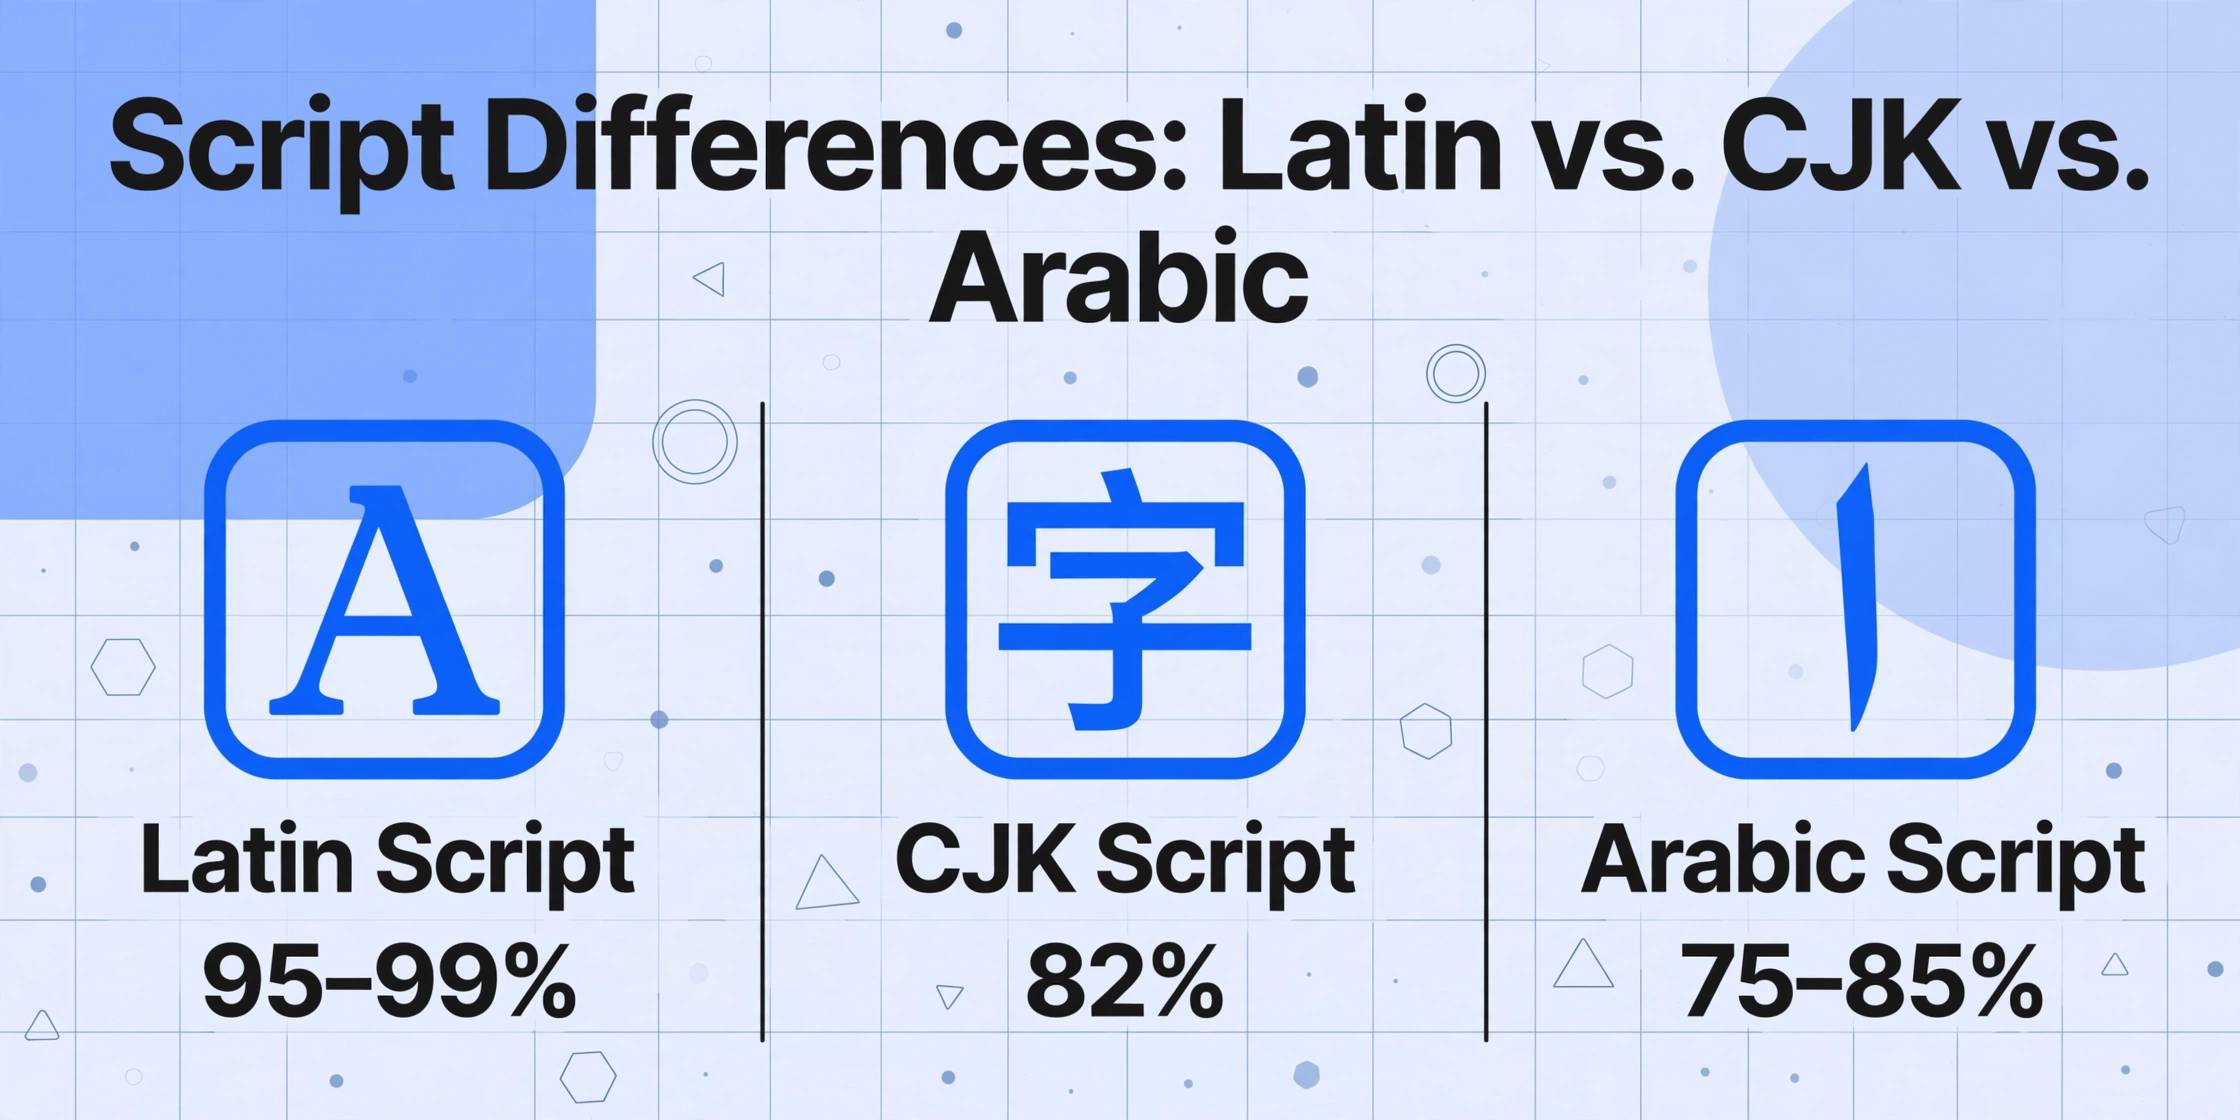
Hier überschreiten Genauigkeitsabfälle die Grenze von „lästig“ zu „workflow-unterbrechend“. Eine englische Rechnung wird mit 96 % extrahiert und eine japanische mit 82 % – nicht weil das japanische Dokument von geringerer Qualität ist, sondern weil sich die Schriftsysteme grundlegend darin unterscheiden, wie sie Vision-Modelle herausfordern.
Lateinische Schriften (Englisch, Französisch, Deutsch, Spanisch, Portugiesisch, Italienisch, Niederländisch) teilen ein 26-Zeichen-Alphabet, eine Leserichtung von links nach rechts und reichlich Trainingsdaten. Sie sind ein gelöstes Problem für moderne Vision-KI – die Genauigkeit bei sauberem gedrucktem lateinischem Text erreicht durchgängig 95–99 %.
CJK-Schriften (Chinesisch, Japanisch, Koreanisch) sind eine andere Schwierigkeitsstufe. Ein einziger japanischer Satz kann Kanji (Tausende chinesischstämmige Zeichen), Hiragana (46 phonetische Zeichen), Katakana (46 phonetische Zeichen für Lehnwörter), lateinische Zeichen für englische Begriffe und arabische Ziffern enthalten – alles in einer Zeile. Derselbe semantische Inhalt auf Japanisch verbraucht etwa das 2-fache an Tokens im Vergleich zum englischen Äquivalent, was bedeutet, dass das Modell seinen Kontextfenster bei CJK-Dokumenten schneller füllt und weniger Informationen pro Feld zur Verfügung hat. Ein praktisches Beispiel für dieses Dichteproblem finden Sie in unserer Abdeckung zum Extrahieren japanischer Belegdaten in Excel.
Arabisch und Hebräisch bringen die Herausforderung der Rechts-nach-links-Ausrichtung mit sich. Das Modell muss erkennen, dass sich die Leserichtung umkehrt, sie korrekt auf jeden Textblock anwenden und die vier Positionen der arabischen Buchstabenformen berücksichtigen (ein Buchstabe ändert seine Form, je nachdem, ob er am Anfang, in der Mitte, am Ende oder isoliert in einem Wort steht). Die Genauigkeit bei gedruckten arabischen Dokumenten liegt zwischen 75–85 % – nicht weil das Modell bei arabischen Zeichen speziell schwach ist, sondern weil die RTL-typografischen Konventionen ein anderes visuelles Parsing-Problem darstellen als links-nach-rechts-Schriften.
Diagnose: Wenn Ihre englischen Dokumente mit 95 %+ extrahiert werden und nicht-lateinische Dokumente durchgängig 10–20 % niedriger liegen – über verschiedene Dokumente hinweg, nicht nur bei einem –, dann befinden Sie sich in Szenario 2.
Behebung: Zwei Ansätze funktionieren hier. Erstens: Überprüfen Sie die Sprachunterstützung des Tools für die spezifische Schrift, die Sie verarbeiten. Nicht alle Tools, die „Unterstützung für 100+ Sprachen“ behaupten, trainieren gleichermaßen auf allen Schriften. Einige Vision-Modelle sind überproportional auf lateinischen Daten trainiert, wobei CJK und Arabisch als kleinerer sekundärer Korpus hinzugefügt wurden. Fragen Sie gezielt, ob die Trainingsdaten des Modells die benötigte Schriftfamilie enthalten. Zweitens: Testen Sie mit einer repräsentativen Stichprobe Ihrer tatsächlichen Dokumente, nicht mit den Demo-Bildern des Tools. Eine Demo-Rechnung eines Anbieters auf Japanisch ist ein sauberes, digital erstelltes Bild mit perfektem Kontrast – Ihre gescannte japanische Rechnung von 2019 mit einem verblassten Stempel über dem Lieferantennamen ist ein ganz anderes Erkennungsproblem.
Szenario 3: Gemischte Schriften im selben Feld
Dies ist der schwierigste Fall – und der, den die meisten Dokumentationen überspringen. Ein einzelnes Feld in Ihrem Dokument enthält Zeichen aus mehreren Schriften. Eine Teilenummer wie „ABC-1234-안전밸브“ (englische Buchstaben, arabische Ziffern, koreanisches Hangul). Ein Lieferantenname-Feld, das „株式会社Yamada (Osaka Branch)“ lautet. Ein Datumsfeld, das als „2026年03月14日“ geschrieben ist – arabische Ziffern eingebettet in CJK-Text.
Vision-Modelle verarbeiten Felder mit gemischten Schriften, indem sie jede Zeichen-Cluster unabhängig erkennen und zu einer kohärenten Zeichenkette zusammenfügen. Dieser Prozess führt jedoch zu mehreren Fehlermodi, die spezifisch für Szenarien mit gemischten Schriften sind:
- Fehlerkennung der Schriftgrenzen: Das Modell beurteilt fälschlicherweise, wo eine Schrift endet und eine andere beginnt. Ein koreanisches Hangul-Zeichen, das einem CJK-Ideogramm visuell ähnelt, kann der falschen Schriftgruppe zugeordnet werden, wodurch die folgenden Zeichen mit dem falschen Erkennungskontext geparst werden.
- Zeichensubstitution: Ähnlich aussehende Zeichen aus verschiedenen Schriften werden vertauscht. Der lateinische Buchstabe „A“, das kyrillische „А“ und das griechische „Α“ sind visuell nahezu identisch, aber unterschiedliche Unicode-Zeichen. Ein Produktcode, der ein lateinisches „A“ enthält, könnte als kyrillisches „А“ ausgegeben werden – visuell identisch, semantisch falsch und bei einer Stichprobenprüfung nicht erkennbar, weil es korrekt aussieht.
- Richtungsverwirrung in gemischten LTR/RTL-Feldern: Ein arabischer Firmenname, gefolgt von einer englischen Registrierungsnummer in Klammern, erzeugt eine bidirektionale Zeichenkette, die das Modell korrekt anordnen muss. Eine Ausgabe wie „(ABC-1234 شركة“) statt „شركة (ABC-1234)“ ist häufig – beide Zeichen sind vorhanden, aber die Lesereihenfolge ist umgekehrt.
Diagnose: Wenn Ihre extrahierten Daten visuell plausibel aussehen, aber gegen eine bekannte Referenz fehlschlagen – eine Teilenummer, die alle richtigen Zeichen zu haben scheint, aber nicht zu Ihrem ERP passt, oder ein Lieferantenname, der bei einem menschlichen Blick besteht, aber einen Lookup-Fehler verursacht –, dann ist Szenario 3 die wahrscheinliche Ursache.
Behebung: Vorverarbeitung mit Sprachhinweisen reduziert Fehler bei gemischten Schriftsystemen erheblich. Während die meisten Vision-Modelle die Sprache automatisch erkennen, hilft eine explizite Verankerung des Extraktionskontexts. In Tools, die dies unterstützen, signalisiert ein Hinweis wie „die Hauptsprache dieses Dokuments ist Koreanisch mit eingebetteten englischen Produktcodes“ dem Modell, Schriftgrenzen zu erwarten, statt sie als Erkennungsfehler zu behandeln. Für Felder, bei denen Genauigkeit entscheidend ist – Steuer-IDs, Teilenummern, Registrierungscodes – ist die sprachspezifische Stichprobenvalidierung der zuverlässigste Schutz: Extrahieren Sie die Daten und überprüfen Sie dann den nicht-lateinischen Teil getrennt vom lateinischen Teil. Wenn Sie eine Referenzdatenbank haben (ERP, CRM, Lieferantenliste), deckt der Abgleich extrahierter Werte Zeichensubstitutionsfehler auf, die keine noch so genaue Sichtprüfung finden würde.
So diagnostizieren Sie, in welchem Szenario Sie sich befinden
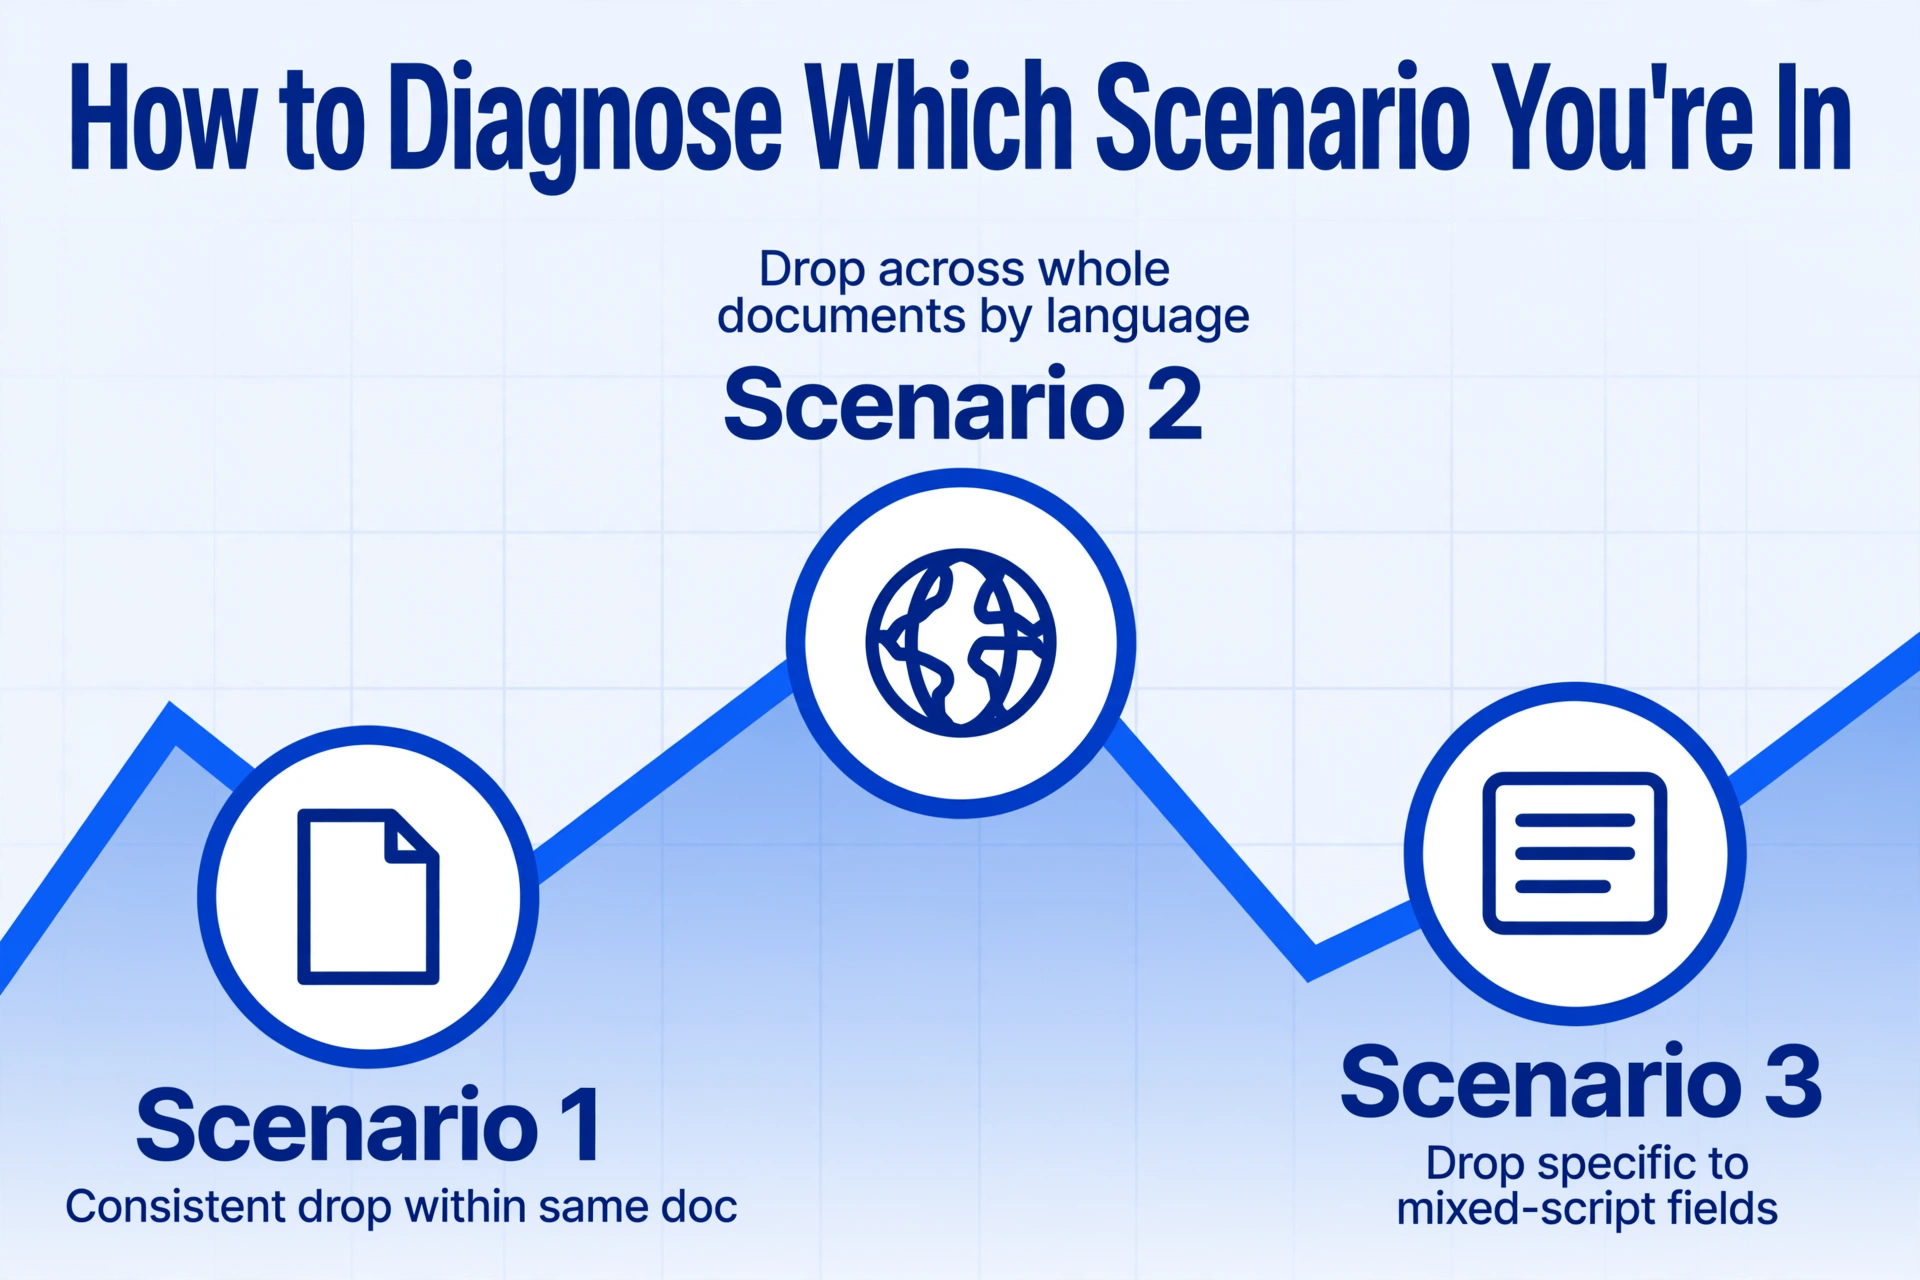
Wenn Sie feststellen, dass die Genauigkeit bei mehrsprachigen Dokumenten nachlässt, führen Sie diese Drei-Fragen-Diagnose durch, bevor Sie etwas anderes ändern:
- Ist der Genauigkeitsverlust innerhalb desselben Dokuments über Sprachen hinweg konsistent? Wenn Ihre englischen Felder immer sauber sind und Ihre französischen/Umlaut-Felder im selben Dokument durchweg schlechter sind → Szenario 1. Versuchen Sie spaltenbasierte Extraktion mit semantischen Felddefinitionen.
- Ist der Verlust über ganze Dokumente hinweg nach Sprachfamilie konsistent? Wenn jedes japanische Dokument schlechter extrahiert wird als jedes englische Dokument, unabhängig vom Inhalt → Szenario 2. Prüfen Sie die Abdeckung der Trainingsdaten des Tools für die jeweilige Schrift.
- Ist der Verlust auf bestimmte Felder mit gemischtem Schriftsystem beschränkt? Wenn Lieferantennamen einwandfrei sind, aber Teilenummern mit eingebettetem Kanji oder Arabisch fehleranfällig sind → Szenario 3. Fügen Sie Vorverarbeitungs-Sprachhinweise hinzu und implementieren Sie feldbezogene Querverweise.
Diese drei Szenarien überlappen sich häufig – ein Dokument kann mehrere Sprachen (Szenario 1) in verschiedenen Schriftsystemen (Szenario 2) mit gemischten Schriftfeldern (Szenario 3) auf derselben Seite enthalten. Die Diagnosefrage zeigt, welche Ebene Sie zuerst beheben sollten, denn die falsche Ebene zu beheben kostet Zeit. Wenn Sie sich in Szenario 2 befinden, wird keine noch so gute Spaltenoptimierung (Szenario-1-Lösung) den Genauigkeitsunterschied ausgleichen – das Modell benötigt andere Trainingsdaten, nicht einen besseren Prompt.
Vorbeugung: Drei Gewohnheiten, die Genauigkeitsverluste bei mehreren Sprachen reduzieren
Sobald Sie Ihr Szenario identifiziert haben, verhindern diese Praktiken, dass dasselbe Problem bei neuen Dokumenttypen und Sprachen erneut auftritt:
1. Trennen Sie Dokumente nach Möglichkeit nach Schriftsystem-Familien. Wenn Sie täglich 200 Rechnungen verarbeiten – 150 in Sprachen mit lateinischer Schrift und 50 in CJK –, erhalten Sie durch getrennte Stapel zwei unabhängige Genauigkeits-Baselines. Sie wissen, dass die Extraktion bei lateinischer Schrift bei über 95 % und bei CJK bei 82 % liegt. Wenn ein CJK-Stapel plötzlich auf 70 % fällt, bemerken Sie das sofort. In einem gemischten Stapel könnte der Gesamtdurchschnitt von 93 % auf 90 % fallen, und niemand eskaliert.
2. Pflegen Sie sprachspezifische Verifikationsstichproben. Wählen Sie 5–10 repräsentative Dokumente für jede Sprachfamilie, die Sie verarbeiten. Führen Sie bei jeder Aktualisierung Ihres Extraktions-Workflows oder bei einem Tool-Wechsel die Verifikationsstichprobe durch und vergleichen Sie die Genauigkeit pro Sprache. So erkennen Sie Regressionen, bevor sie in die Produktion gelangen. Ein Tool, das die lateinische Genauigkeit um 2 % verbessert, aber die CJK-Genauigkeit um 8 % verschlechtert, ist für einen mehrsprachigen Workflow keine Nettoverbesserung.
3. Verwenden Sie feldspezifische Konfidenzschwellen, die je nach Sprache variieren. Wenden Sie nicht dieselbe Regel „akzeptieren, wenn Konfidenz > 90 %“ auf englische und arabische Felder aus demselben Dokument an. Eine Konfidenzschwelle von 90 % bei Englisch könnte zu streng sein (alles besteht), während dieselbe Schwelle bei Arabisch jede Extraktion ablehnen könnte. Legen Sie sprachspezifische Schwellen fest, die auf den Ergebnissen Ihrer Verifikationsstichproben basieren – Arabisch 75 %, Latein 90 %, CJK 80 % – und leiten Sie alles unterhalb der Schwelle zur manuellen Überprüfung weiter, anstatt es stillschweigend zu akzeptieren.
Wann Sie eskalieren sollten – was weiterhin manuell bearbeitet werden muss
Ehrlichkeit ist hier wichtiger als an jeder anderen Stelle dieses Artikels. Vision-KI ist über Sprachen hinweg bemerkenswert leistungsfähig, aber es gibt Randbedingungen, bei denen kein noch so großes Prompt-Tuning oder Preprocessing die Genauigkeitslücke auf Produktionsniveau schließen kann.
- Dokumente mit vier oder mehr Sprachen aus verschiedenen Schriftsystem-Familien. Ein Dokument, das Englisch, Arabisch (RTL), Japanisch (CJK vertikal + horizontal) und Koreanisch (CJK horizontal) – alles auf derselben Seite – enthält, liegt am Rande der aktuellen Fähigkeiten von Vision-Modellen. Erwarten Sie einen Genauigkeitsabfall von 5–15 % gegenüber der einsprachigen Baseline.
- Gemischtes RTL/LTR innerhalb desselben Satzes oder derselben Tabellenzelle. Wenn Arabisch und Englisch in derselben Zeile mit einer parenthetischen Beziehung erscheinen (z. B. „البند (Item) 4.2“ in einer Vertragsklausel), erzeugt die bidirektionale Analyse strukturelle Fehler, die Preprocessing-Hinweise nur teilweise beheben.
- Handschriftlicher Inhalt in einer nicht-lateinischen Schrift. Handschrift allein senkt die Genauigkeit um 15–30 % im Vergleich zu gedrucktem Text. Kommt eine zweite Sprache hinzu – handschriftliche arabische Ziffern in handschriftlichem Japanisch –, führt der kumulative Effekt dazu, dass die meisten Extraktionen unterhalb brauchbarer Schwellenwerte liegen. Diese Dokumente profitieren weiterhin von der KI-Extraktion für die gedruckten Teile, aber die handschriftlichen Felder sollten als Standard-Workflow zur manuellen Eingabe geleitet werden, nicht als Ausnahme.
- Sprachpaarungen mit geringen Ressourcen. Thailändisch/Arabisch, Swahili/Kyrillisch, Burmesisch/Englisch – Paare, bei denen keine der beiden Sprachen einzeln über hohe Ressourcen für das Training von Vision-Modellen verfügt. Die Genauigkeitsuntergrenze für diese Dokumente ist niedriger als bei gut abgedeckten Paarungen wie Englisch/Spanisch oder Englisch/Chinesisch.
Der praktische Arbeitsablauf: Die KI-Extraktion übernimmt 80–90 % der mehrsprachigen Daten automatisch. Die restlichen 10–20 % — risikoreiche Felder in Dokumenten mit gemischten Schriftsystemen, kritische Zahlenfelder in gemischtem RTL/LTR-Text und handschriftliche Einträge in nicht-lateinischen Schriften — werden an einen menschlichen Prüfschritt weitergeleitet, der schneller ist als vollständige manuelle Eingabe und zuverlässiger als die KI bei den schwierigsten Fällen zu vertrauen.
FAQ
Warum funktioniert mein KI-Extraktionstool bei englischen Rechnungen gut, aber schlechter bei deutschen oder französischen?
Dies ist typischerweise Szenario 1. Das englische Dokument ist eine einsprachige Eingabe ohne Schriftsystem-Mehrdeutigkeit. Das deutsche oder französische Dokument enthält wahrscheinlich Sonderzeichen (Umlaute, Akzente), die das Vision-Modell als Variationen der Standard-Lateinbuchstaben behandelt — und diese Variationen haben eine geringere Konfidenz, da sie in den Trainingsdaten seltener vorkommen als Buchstaben ohne Akzente. Die Genauigkeitslücke zwischen Englisch und anderen lateinischen Sprachen liegt normalerweise bei 5–8 % — spürbar, aber behebbar mit spaltenbasierter Extraktion, die das Modell auf bestimmte Felder fokussiert statt auf vollständige OCR der gesamten Seite.
Kann ich die Genauigkeit der mehrsprachigen Extraktion verbessern, indem ich Dokumente zuerst in eine einzelne Sprache konvertiere?
Nicht zuverlässig. Maschinelle Übersetzung vor der Extraktion fügt eine separate Fehlerebene hinzu — Sie extrahieren dann aus übersetztem Text, der Feldbezeichnungen, Zahlenformate und Dokumentstruktur verlieren kann. Das Originaldokument enthält die vom Autor beabsichtigte Gestaltung und Daten. Die Extraktion funktioniert am besten, wenn sie das Original liest, nicht eine übersetzte Version. Der bessere Ansatz ist, aus dem Originaldokument mit semantischen Spaltendefinitionen zu extrahieren und die extrahierten Daten anschließend gegen die Sprache zu validieren, die Ihr nachgelagertes System benötigt.
Muss die KI wissen, welche Sprachen im Dokument enthalten sind, bevor sie es verarbeitet?
Nein für die Erkennung — moderne Vision-Modelle erkennen Schriftsysteme und Sprachen automatisch als Teil des Seitenlesens. Aber ja für den Kontext — wenn Ihr Dokument eine seltene Sprachkombination oder Felder mit gemischten Schriftsystemen enthält, verbessert ein Sprachhinweis (z. B. „dieses Dokument enthält Koreanisch und Englisch mit eingebetteten arabischen Ziffern“) die Genauigkeit um 3–7 % bei den Teilen in der sekundären Sprache, da das Modell die Erkennungsressourcen effizienter zuweist.
Wie groß ist der erwartete Genauigkeitsunterschied zwischen lateinischen und CJK-Dokumenten beim selben Tool?
Bei sauberen Druckdokumenten ähnlicher Qualität ist mit einer 8–15 % niedrigeren CJK-Genauigkeit im Vergleich zu lateinischen Texten zu rechnen. Dies ist kein Qualitätsproblem des Tools – es spiegelt den grundlegenden Unterschied im Zeichenvorrat (26 vs. Tausende), Token-Verbrauch (2× pro semantischer Einheit) und Trainingsdatenvolumen wider. Ein Tool, das bei Englisch 97 % erreicht, aber bei Japanisch nur 83 %, arbeitet für den aktuellen Stand der Bild-KI normal.
Sollte ich für verschiedene Sprachen unterschiedliche KI-Extraktionstools verwenden?
Wenn Ihr Dokumentenmix mehrere Schriftsysteme umfasst (nicht nur mehrere Sprachen innerhalb desselben Schriftsystems), können Sie durch den Einsatz von Tools, die für bestimmte regionale Schriften optimiert sind, eine höhere sprachspezifische Genauigkeit erzielen. PaddleOCR beispielsweise liefert bei CJK-Dokumenten bessere Ergebnisse als universelle Bildmodelle, da seine Trainingsdaten überwiegend aus CJK bestehen. Die Verwaltung mehrerer Tools bringt jedoch Workflow-Komplexität mit sich, die den Genauigkeitsgewinn für die meisten Teams überwiegen kann. Ein bewährter Ansatz: Verwenden Sie ein universelles Bild-KI-Tool als primären Extraktor für alle Sprachen und leiten Sie Dokumente in bestimmten Schriften nur dann an spezialisierte Fallback-Engines weiter, wenn die Konfidenz des primären Tools unter einen Schwellenwert fällt.
Der Genauigkeitsabfall zwischen einem einzelnen lateinischen Dokument und einem mehrsprachigen Dokument ist kein Technologieversagen – es ist eine vorhersehbare, diagnostizierbare und weitgehend behebbare Lücke. Beginnen Sie mit der diagnostischen Frage, wenden Sie die Lösung für Ihr Szenario an und reservieren Sie die manuelle Prüfung für die Randfälle, bei denen aktuelle Bildmodelle noch lernen. Testen Sie an Ihren eigenen mehrsprachigen Dokumenten und sehen Sie, welches Szenario auf Ihren Workflow zutrifft.