Por que a precisão da extração em vários idiomas está caindo?
3 cenários e correções específicas
Sua fatura em inglês é extraída com 96% de precisão. A mesma ferramenta em uma fatura em alemão cai para 88%. Adicione itens de linha em francês ao cabeçalho em alemão e o resultado fica perto de 80%. Isso não é falha da IA — é um problema de densidade de idiomas com causas específicas e solucionáveis.
Principais Conclusões
- 96% em inglês cai para 88% na sua fatura em alemão — não porque a ferramenta é mais fraca em alemão, mas porque seu documento contém secretamente quatro idiomas compartilhando uma única passagem de reconhecimento.
- Um documento CJK consome o dobro de tokens em relação ao equivalente em inglês, preenchendo a janela de contexto do modelo antes que ele possa dar a mesma atenção a cada campo.
- Uma pergunta de diagnóstico — por campo, por documento ou por campo de escrita mista — indica em qual dos três cenários você está, e nenhuma das três correções envolve trocar de ferramenta.
O padrão é sempre o mesmo: você testa em documentos em inglês, obtém resultados que parecem mágica, depois muda para sua mistura real de documentos — faturas de fornecedores em três países, etiquetas de envio com endereços em dois alfabetos, contratos que mudam de idioma no meio de uma cláusula — e a precisão cai. Não de forma catastrófica, mas o suficiente para você começar a se perguntar se a ferramenta realmente funciona.
Ela funciona. A questão é o que você está pedindo que ela faça. Uma única fatura em inglês é uma entrada uniforme: um idioma, um alfabeto, uma direção de leitura. Uma fatura alemã com itens de linha em francês e condições de pagamento em espanhol não é a mesma categoria de problema — e a precisão reflete isso. Entender qual dos três cenários distintos você está enfrentando é a diferença entre saber o que corrigir e culpar a coisa errada.
Este guia aborda os três cenários mais comuns de queda de precisão, como identificar qual deles está acontecendo com seus documentos e o que fazer em cada caso. Para uma visão geral mais ampla de como a IA de visão lida com vários idiomas no nível arquitetônico, veja a IA consegue ler vários idiomas em um único documento — este artigo pressupõe esse conhecimento e foca no lado da solução de problemas.
Cenário 1: Documento Único, Vários Idiomas
Esta é a causa mais comum de queda de precisão, e geralmente os usuários não percebem que estão lidando com ela. Seu documento está "em alemão" — mas o cabeçalho está em inglês (nome e endereço da empresa), os itens de linha misturam descrições de produtos em alemão com nomes de ingredientes em francês, e o rodapé contém texto jurídico padrão no idioma que o departamento jurídico corporativo escolheu no último trimestre.
A maioria dos modelos de IA de visão processa a página inteira como um único contexto visual. Eles não "alternam de idioma" como o OCR tradicional faz — eles leem tudo de uma vez e determinam o alfabeto de cada caractere como parte da mesma passagem de inferência. Isso é uma vantagem sobre os mecanismos de OCR que exigem um pacote de idioma pré-selecionado, mas cria um problema sutil: quando textos em idiomas diferentes aparecem no mesmo campo visual, a confiança do modelo nos caracteres cai porque ele precisa resolver simultaneamente limites de alfabeto, caracteres especiais (é, ü, ñ, ß) e formatos de letras dependentes do contexto.
Veja o que acontece na prática em uma única fatura multilíngue:
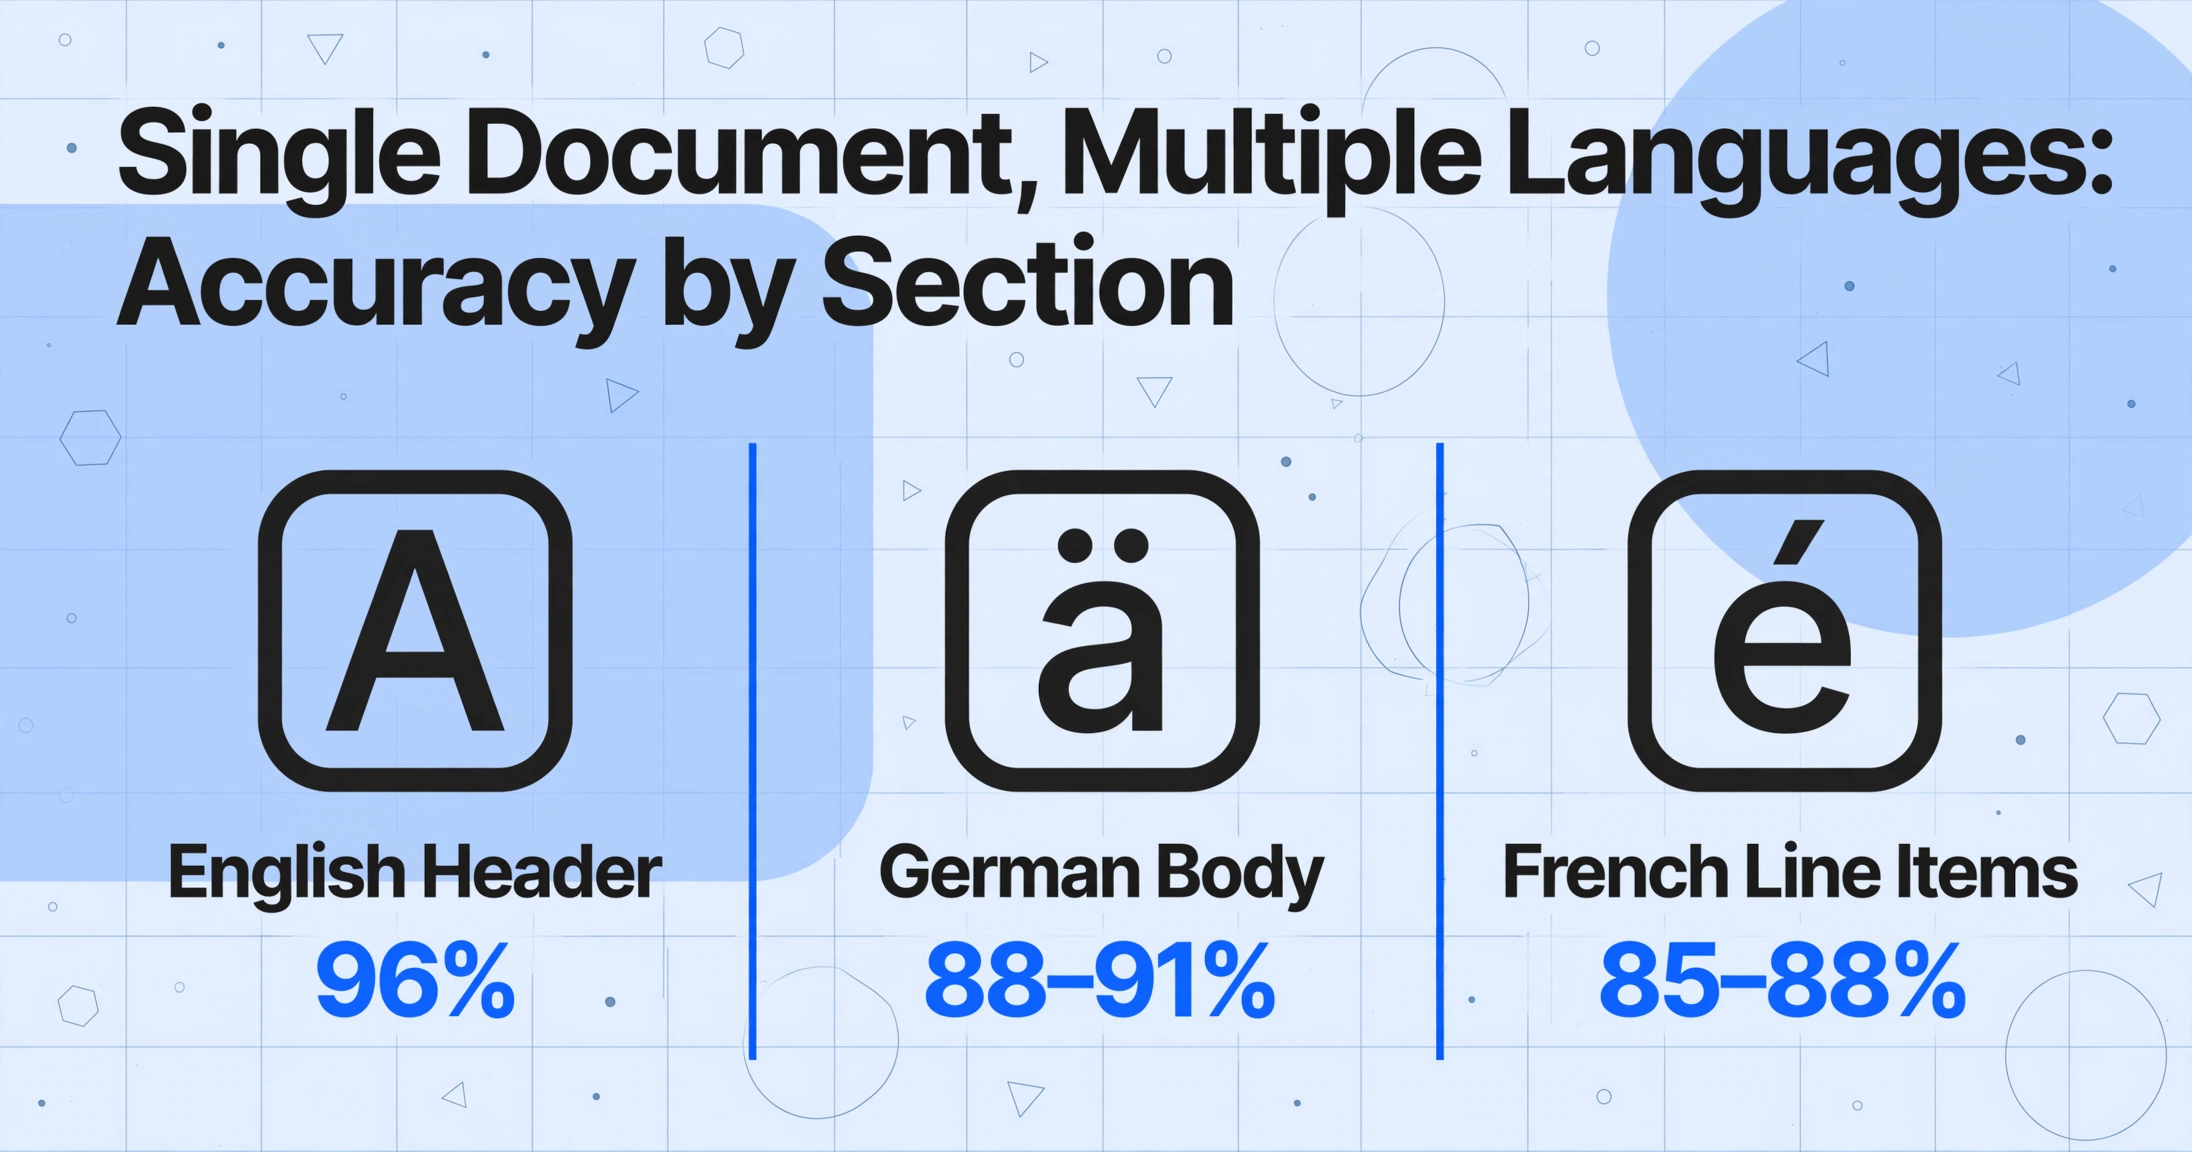
- Cabeçalho em inglês (nome da empresa, endereço) — 96% de precisão. O modelo está em seu regime mais forte.
- Corpo em alemão (descrições de itens com Umlauts, moeda "€", formato de data alemão) — 88–91% de precisão. Umlauts (ä, ö, ü) são omitidos ou substituídos; "14.03.2026" é confundido com o formato inglês "03/14/2026."
- Itens de linha em francês (caracteres acentuados: é, è, ê, œ) — 85–88% de precisão. Acentos em linhas com glifos mistos acumulam erros; uma palavra como "générique" vira "generique" ou "g6n6rique."
- Condições de pagamento em espanhol (ñ e pontuação invertida) — 82–87% de precisão. O modelo já gastou seu orçamento de resolução de caracteres nas seções em alemão e francês quando chega ao rodapé.
Esses não são números de pior caso. São típicos para um documento que alterna entre três idiomas de escrita latina — todos compartilhando o mesmo alfabeto, mas divergindo em caracteres especiais, formatos de data e notações de moeda.
Diagnóstico: Se a precisão por campo varia dentro do mesmo documento — datas sendo mais confiáveis que nomes de fornecedores, ou números limpos enquanto caracteres acentuados são corrompidos — você provavelmente está no Cenário 1.
Solução: Use Extração de Colunas Personalizadas em vez de OCR de página inteira. Ao definir colunas de saída específicas (como "Nome do Fornecedor", "Data da Fatura", "Valor Total"), a IA foca em encontrar esses valores por significado semântico, em vez de tentar processar cada caractere da página igualmente. Uma coluna chamada "Valor Total (EUR)" diz ao modelo para procurar um número próximo a um símbolo de moeda, independentemente de o texto ao redor estar em alemão, francês ou espanhol. Para um olhar mais aprofundado sobre como a extração baseada em colunas funciona em diferentes tipos de documento, veja como a extração de documentos por IA funciona e por que a definição de colunas importa.
Se o seu documento mistura vários idiomas de escrita latina, a solução quase nunca é um modelo melhor — é uma estratégia de extração melhor. Em vez de dizer à IA para "ler tudo", diga exatamente quais campos você precisa. A diferença de precisão entre OCR bruto e extração direcionada por colunas em um documento multilíngue é tipicamente de 5–10%.
Cenário 2: Diferenças de Escrita — Latim vs. CJK vs. Árabe
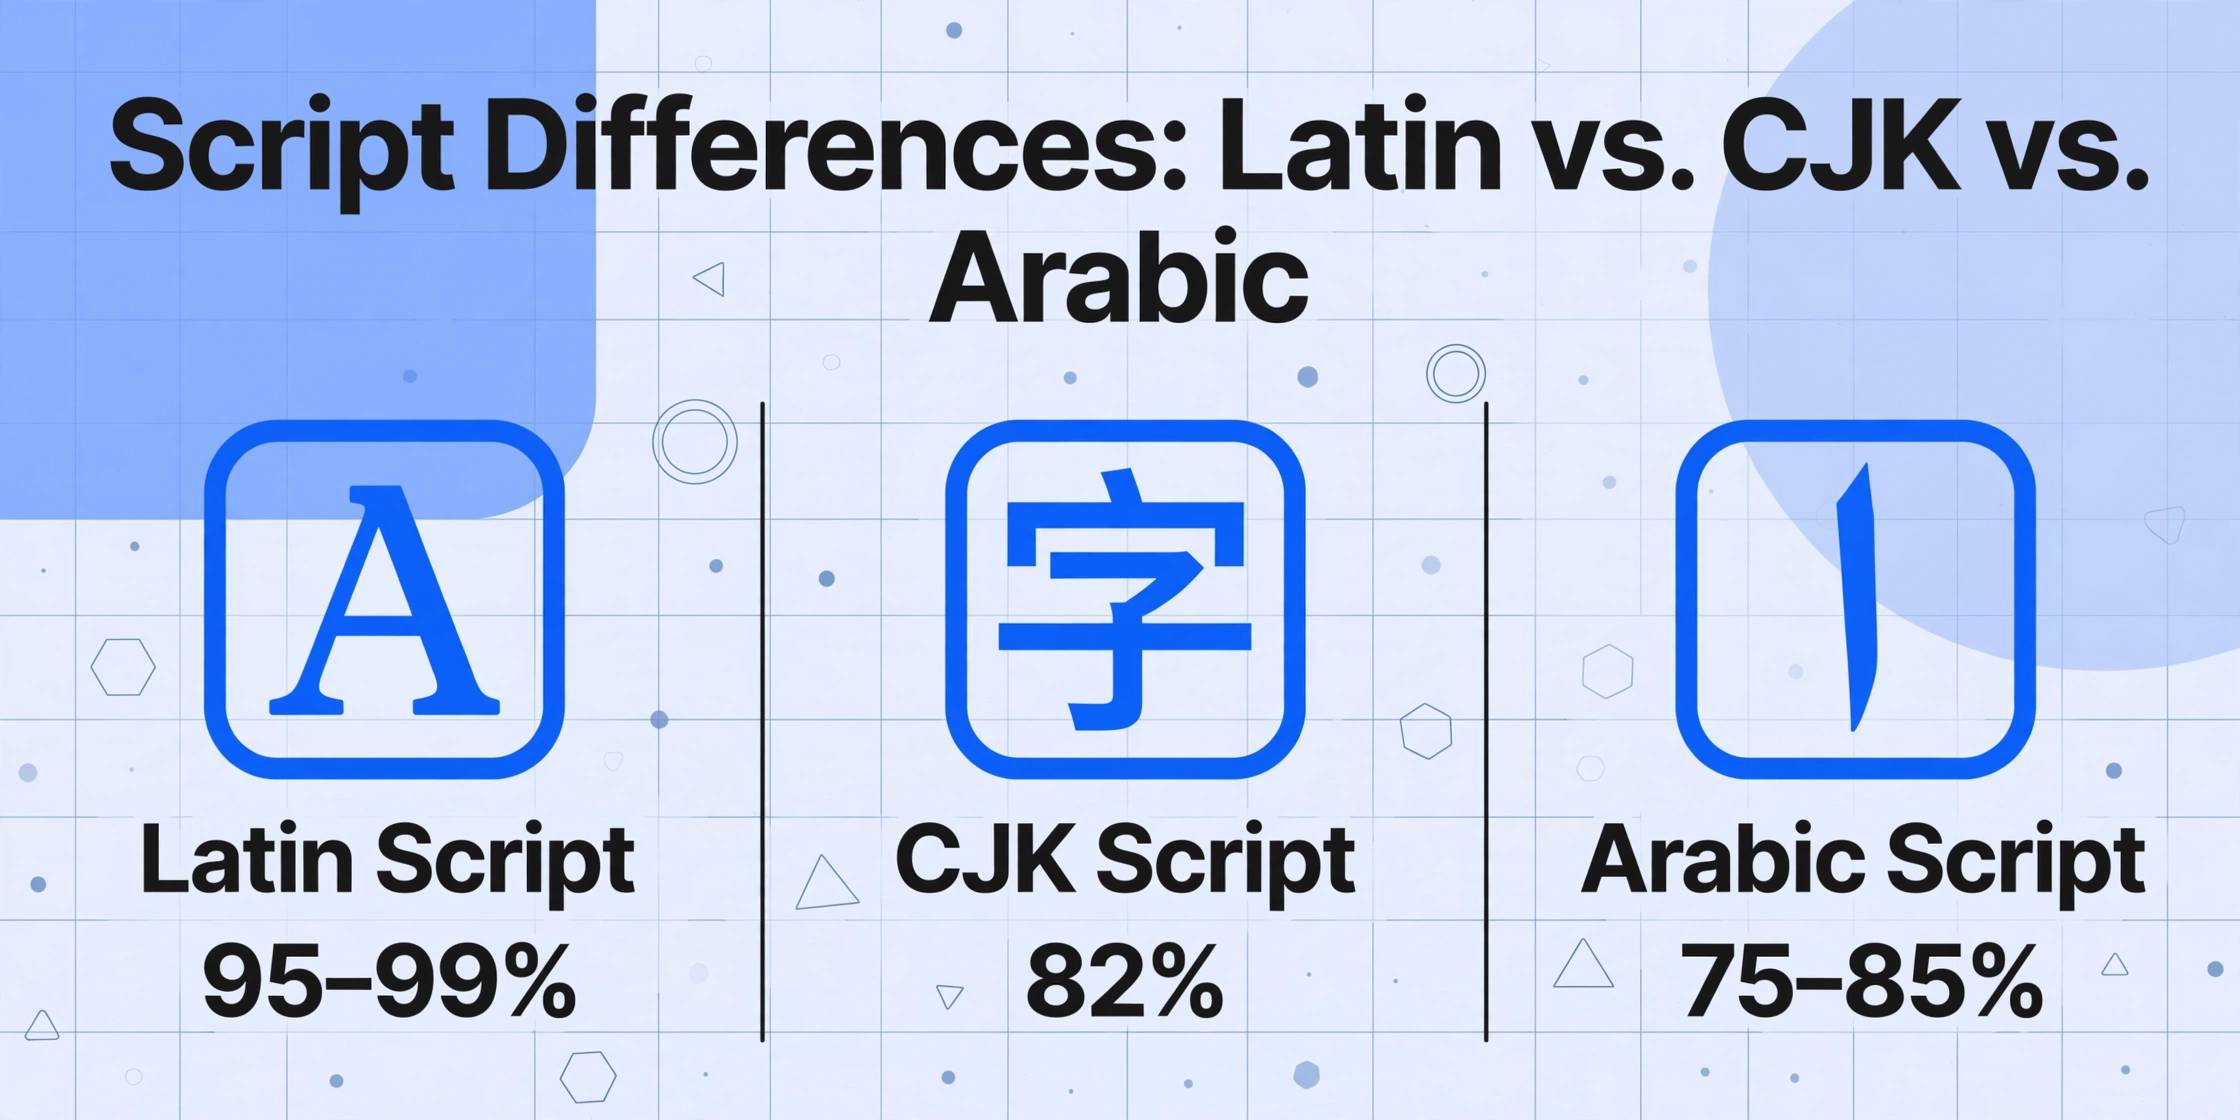
É aqui que as quedas de precisão cruzam a linha de "irritante" para "quebra de fluxo de trabalho". Uma fatura em inglês extrai a 96% e uma fatura em japonês extrai a 82% — não porque o documento japonês é de menor qualidade, mas porque as famílias de escrita são fundamentalmente diferentes em como desafiam os modelos de visão.
Escritas latinas (inglês, francês, alemão, espanhol, português, italiano, holandês) compartilham um alfabeto de 26 caracteres, direção de leitura da esquerda para a direita e abundantes dados de treinamento. São um problema resolvido para a IA de visão moderna — a precisão em texto latino impresso limpo atinge consistentemente 95–99%.
Escritas CJK (chinês, japonês, coreano) são um nível diferente de dificuldade. Uma única frase em japonês pode conter Kanji (milhares de caracteres de origem chinesa), Hiragana (46 caracteres fonéticos), Katakana (46 caracteres fonéticos para palavras emprestadas), caracteres latinos para termos em inglês e numerais arábicos — tudo em uma linha. O mesmo conteúdo semântico em japonês consome aproximadamente 2× os tokens do seu equivalente em inglês, o que significa que o modelo preenche sua janela de contexto mais rápido em documentos CJK e tem menos informação disponível por campo. Para um exemplo prático desse problema de densidade, veja nossa cobertura sobre extração de dados de recibos japoneses para Excel.
Árabe e hebreo adicionam o desafío da direção da direita para a esquerda. O modelo deve detectar que a direção de leitura se inverte, aplicá-la corretamente por bloco de texto e lidar com as quatro posições das formas das letras árabes (uma letra muda de forma dependendo de si aparece no início, meio, fim ou isolada em uma palavra). A precisão em documentos árabes impressos varia de 75–85% — não porque o modelo seja fraco especificamente em caracteres árabes, mas porque as convenções tipográficas RTL criam um problema de parsing visual diferente dos scripts da esquerda para a direita.
Diagnóstico: Se seus documentos em inglês são extraídos com 95%+ de precisão e documentos não latinos consistentemente ficam 10–20% mais baixos — em diferentes documentos, não apenas um — você está no Scenario 2.
Solução: Duas abordagens funcionam aqui. Primeiro, verifique o suporte de idiomas da ferramenta para o script específico que você está processando. Nem todas as ferramentas que afirmam "suporte para 100+ idiomas" treinan igualmente em todos os scripts. Alguns modelos de visão são desproporcionalmente treinados em dados latinos, com CJK e árabe adicionados como um corpus secundário menor. Pergunte especificamente se os dados de treinamento do modelo incluyen a família de scripts que você precisa. Segundo, teste com uma muestra representativa de seus documentos reais, não com as imagens de demonstração da ferramenta. Uma factura de demonstração de um fornecedor em japonês será uma imagem limpa, criada digitalmente, com contraste perfeito — sua factura japonesa escaneada de 2019 com um carimbo desvanecido sobre o nome do fornecedor é um problema de reconhecimento muito diferente.
Scenario 3: Scripts Mistos no Mesmo Campo
Este é o caso mais difícil — e o que a maioria da documentação omite. Um único campo em seu documento contém caracteres de múltiples scripts. Um número de peça como "ABC-1234-안전밸브" (letras inglesas, números arábigos, Hangul coreano). Um campo de nome de fornecedor que lee "株式会社Yamada (Osaka Branch)." Um campo de data escrito como "2026年03月14日" — números arábigos embebidos em texto CJK.
Os modelos de visão lidam com campos de scripts mistos reconociendo cada cluster de caracteres independentemente e ensamblándolos em uma string coerente. Mas este processo introduce vários modos de fallo específicos para escenarios de scripts mistos:
- Detección incorrecta de límites de script: O modelo julga incorrectamente onde termina um script e começa outro. Um carácter Hangul coreano que visualmente se assemela a um ideograma CJK pode ser classificado no grupo de script errado, fazendo que os caracteres seguintes sejam parseados com o contexto de reconhecimento errado.
- Substitución de caracteres: Caracteres que se parecen entre scripts são intercambiados. A letra latina "A," a cirílica "А," e a grega "Α" são visualmente quase idénticas, mas são caracteres Unicode diferentes. Um código de produto que contenga a latina "A" poderia ser emitido como a cirílica "А" — visualmente idéntico, semanticamente errado e indetectable em uma verificação rápida porque parece correto.
- Confusión de direção em campos mistos LTR/RTL: Um nome de empresa árabe seguido de um número de registro inglês entre paréntesis cria uma string bidireccional que o modelo deve ordenar corretamente. Uma saída como "(ABC-1234 شركة") em vez de "شركة (ABC-1234)" é comum — ambos caracteres estão presentes, mas a ordem de leitura está invertida.
Diagnóstico: Se seus dados extraídos parecen visualmente plausibles, mas falham contra uma referencia conhecida — um número de peça que parece ter todos os caracteres corretos, mas não coincide com seu ERP, ou um nome de fornecedor que passa uma revisão humana, mas causa uma falha de lookup — o Scenario 3 é a causa provável.
Correção: Pré-processamento com dicas de idioma reduz significativamente erros de scripts mistos. Embora a maioria dos modelos de visão detecte idiomas automaticamente, ancorar explicitamente o contexto de extração ajuda. Em ferramentas que suportam isso, passar uma dica como "o idioma principal deste documento é coreano com códigos de produto em inglês incorporados" diz ao modelo para esperar limites de script em vez de tratá-los como erros de reconhecimento. Para campos onde a precisão é crítica — IDs fiscais, números de peça, códigos de registro — validação por amostragem por idioma é a salvaguarda mais confiável: extraia os dados e verifique a parte não latina separadamente da parte latina. Se você tiver um banco de dados de referência (ERP, CRM, lista de fornecedores), a referência cruzada dos valores extraídos detecta erros de substituição de caracteres que nenhuma inspeção visual encontrará.
Como Diagnosticar em Qual Cenário Você Está
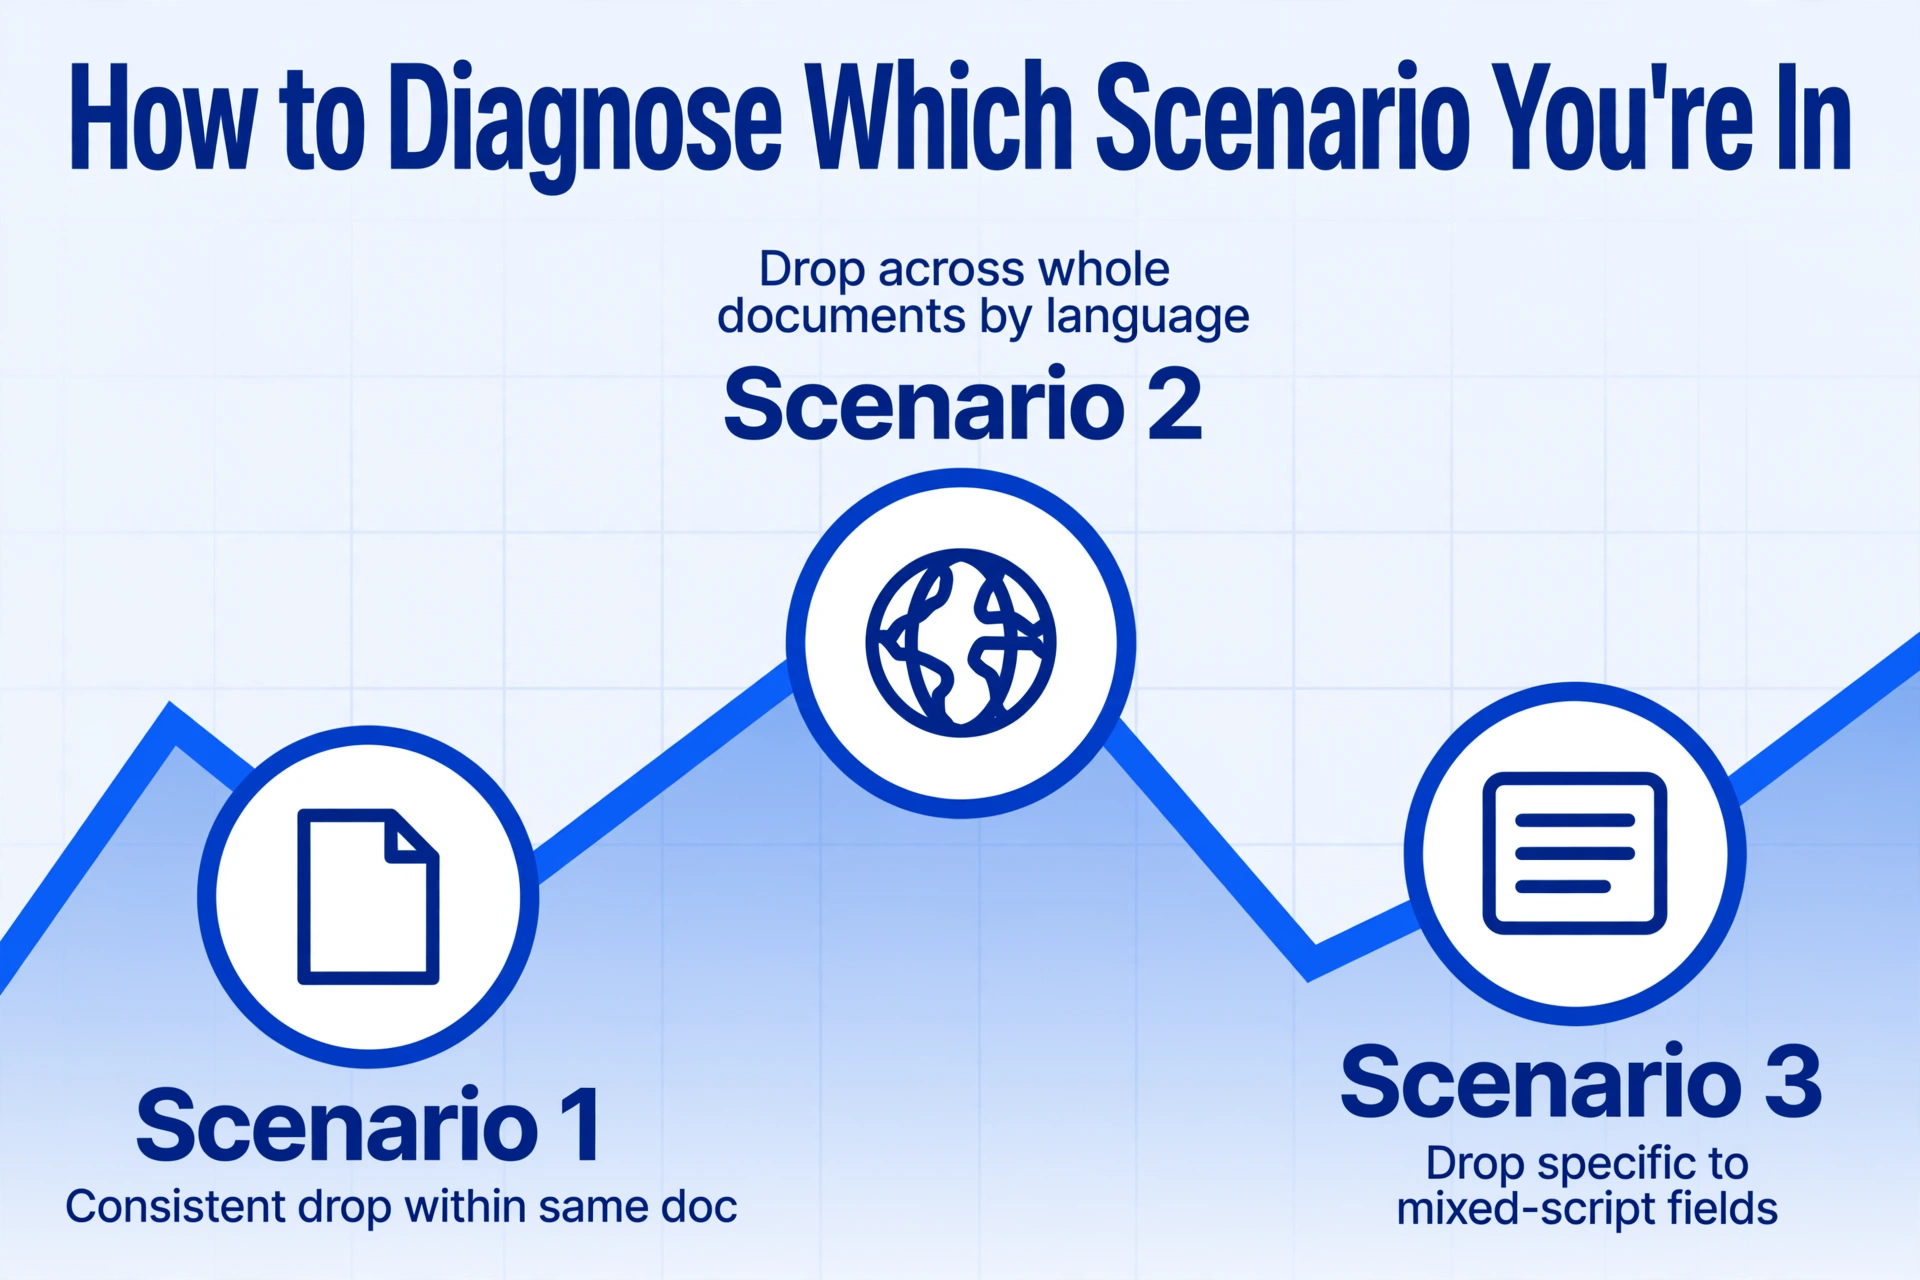
Ao notar queda de precisão em documentos multilíngues, faça este diagnóstico de três perguntas antes de mudar qualquer outra coisa:
- A queda de precisão é consistente entre idiomas, mas no mesmo documento? Se seus campos em inglês estão sempre limpos e seus campos em francês/Umlaut estão consistentemente degradados no mesmo documento → Cenário 1. Tente extração baseada em colunas com definições de campos semânticos.
- A queda é consistente em documentos inteiros por família de idiomas? Se todo documento em japonês extrai pior que todo documento em inglês, independentemente do conteúdo → Cenário 2. Verifique a cobertura dos dados de treinamento da ferramenta para o script específico.
- A queda é específica para certos campos com conteúdo de scripts mistos? Se nomes de fornecedores estão corretos, mas números de peça com Kanji ou árabe incorporados são propensos a erros → Cenário 3. Adicione dicas de idioma no pré-processamento e implemente referência cruzada por campo.
Esses três cenários frequentemente se sobrepõem — um documento pode conter vários idiomas (Cenário 1) em diferentes scripts (Cenário 2) com campos de scripts mistos (Cenário 3) na mesma página. A pergunta de diagnóstico indica qual camada corrigir primeiro, porque corrigir a camada errada desperdiça tempo. Se você está no Cenário 2, nenhum refinamento de coluna (correção do Cenário 1) recuperará a lacuna de precisão — o modelo precisa de cobertura de treinamento diferente, não de um prompt melhor.
Prevenção: três hábitos que reducen quedas de precisão em vários idiomas
Uma vez identificado seu cenário, estas práticas evitam que o mesmo problema se repita em novos tipos de documentos e idiomas:
1. Separe os documentos por família de script quando possível. Se você processa 200 faturas diariamente — 150 em idiomas com script latino e 50 em CJK — processá-los separadamente dá duas linhas de base de precisão independentes. Você sabe que a extração em script latino funciona a 95%+ e a CJK a 82%. Se um lote CJK cae de repente a 70%, você nota imediatamente. Misturados em um lote, a média geral pode cair de 93% a 90% e ninguém escala.
2. Mantenga muestras de verificação por idioma. Escolha 5–10 documentos representativos para cada família de idiomas que você processa. Toda vez que atualice seu fluxo de extração ou cambie de ferramenta, execute o conjunto de verificação e compare a precisão por idioma. Isso detecta regressions antes de chegar à produção. Uma ferramenta que melhorou a precisão em latino em 2% mas degradou a precisão CJK em 8% não é uma melhora neta para um fluxo de trabalho multilíngüe.
3. Use limiares de confianza a nível de campo que variam por idioma. Não aplique a mesma regra "aceptar si confianza > 90%" a campos em inglês e árabe do mesmo documento. Um limiar de confianza de 90% em inglês pode ser demasiado estricto (todo passa), enquanto o mesmo limiar em árabe pode rechazar toda extracción. Establezca limiares por idioma informados pelos resultados de sua muestra de verificación — árabe 75%, latino 90%, CJK 80% — e envie qualquer coisa abaixo do limiar a revisão manual em vez de aceptarla silenciosamente.
Quando escalar — o que ainda requer manejo manual
La honestidad importa aquí más que en cualquier otra parte deste artigo. A IA de visão é notavelmente capaz em vários idiomas, mas há condições de contorno onde nenhuna quantidade de ajuste de prompt ou preprocesamiento cerrará a brecha de precisão até níveis de produção.
- Documentos com quatro ou más idiomas que abarcan diferentes familias de script. Um documento que contenga inglês, árabe (RTL), japonês (CJK vertical + horizontal) e coreano (CJK horizontal) — todos na mesma página — está no limite das capacidades atuais dos modelos de visão. Espere uma queda de precisão de 5–15% em relação à linha de base de um único idioma.
- RTL/LTR misturados dentro da mesma frase ou célula de tabela. Quando árabe e inglês aparecen na mesma linha com uma relação parentética (por exemplo, "البند (Item) 4.2" em uma cláusula de contrato), o parsing bidireccional cria erros estruturais que as pistas de preprocesamiento só corrigem parcialmente.
- Contenido manuscrito em script não latino. A escrita manual sozinha reduz a precisão 15–30% em comparação com texto impresso. Adicione um segundo idioma por cima — números arábigos manuscritos em japonês manuscrito — e o efeito composto coloca a maioria das extracciones abaixo dos limiares utilizables. Estes documentos ainda se benefician da extracción por IA para as partes impressas, mas os campos manuscritos devem ser enviados para entrada manual como fluxo de trabalho padrão, não como excepción.
- Parejas de idiomas de baixo recurso. Tailandés/árabe, suajili/cirílico, birmano/inglés — parejas onde nenhuno dos idiomas é individualmente de alto recurso para o treinamento de modelos de visão. O piso de precisión para estes documentos é menor que para parejas bem cobertas como inglês/español ou inglês/chino.
O fluxo de trabalho prático: a extração por IA lida automaticamente com 80–90% dos dados multilíngues. Os 10–20% restantes — campos de alto risco em documentos com scripts mistos, campos numéricos críticos em texto misto RTL/LTR e entradas manuscritas em alfabetos não latinos — são encaminhados para uma etapa de revisão humana que é mais rápida que a entrada manual completa e mais confiável do que confiar na IA nos casos mais difíceis.
FAQ
Por que minha ferramenta de extração por IA funciona muito bem em faturas em inglês, mas pior em alemão ou francês?
Isso é tipicamente o Cenário 1. O documento em inglês é uma entrada de idioma único, sem ambiguidade de script. O documento em alemão ou francês provavelmente contém caracteres especiais (Umlauts, acentos) que o modelo de visão trata como variações das letras latinas padrão — e essas variações têm menor confiança porque aparecem com menos frequência nos dados de treinamento do que caracteres sem acento. A diferença de precisão entre o inglês e outros idiomas de escrita latina é geralmente de 5–8% — perceptível, mas corrigível com extração baseada em colunas, que foca o modelo em campos específicos em vez de OCR de página inteira.
Posso melhorar a precisão da extração multilíngue convertendo os documentos para um único idioma primeiro?
Não de forma confiável. A tradução automática antes da extração introduz uma camada de erro separada — você está extraindo de texto traduzido, que pode perder rótulos de campos, formatos numéricos e a estrutura do documento. O documento original contém o layout e os dados pretendidos pelo autor. A extração funciona melhor quando lê o original, não uma versão traduzida. A melhor abordagem é extrair do documento original usando definições semânticas de colunas e, em seguida, validar os dados extraídos contra o idioma exigido pelo seu sistema downstream.
A IA precisa saber quais idiomas estão no documento antes do processamento?
Não para detecção — modelos modernos de visão detectam scripts e idiomas automaticamente ao ler a página. Mas sim para contexto — se o seu documento contém uma combinação rara de idiomas ou campos com scripts mistos, fornecer uma dica de idioma (por exemplo, "este documento contém coreano e inglês com numerais arábicos incorporados") melhora a precisão em 3–7% nas partes do idioma secundário, porque o modelo aloca recursos de reconhecimento de forma mais eficiente.
Qual a diferença de precisão esperada entre documentos em alfabeto latino e CJK usando a mesma ferramenta?
Para documentos impressos limpos de qualidade similar, espere que a precisão CJK seja 8–15% menor que a precisão latina na mesma ferramenta. Isso não é um problema de qualidade da ferramenta — reflete a diferença fundamental no inventário de caracteres (26 vs milhares), consumo de tokens (2× por unidade semântica) e volume de dados de treinamento. Uma ferramenta com 97% de acerto em inglês que obtém 83% em japonês está performando dentro do normal para o estado atual da IA de visão.
Devo usar ferramentas de extração de IA diferentes para idiomas diferentes?
Se sua combinação de documentos abrange múltiplas famílias de escrita (não apenas múltiplos idiomas dentro da mesma família), você pode obter maior precisão por idioma usando ferramentas otimizadas para scripts regionais específicos. O PaddleOCR, por exemplo, performa melhor em documentos CJK do que modelos de visão de uso geral porque seus dados de treinamento são focados em CJK. No entanto, gerenciar múltiplas ferramentas introduz complexidade no fluxo de trabalho que pode superar o ganho de precisão para a maioria das equipes. Uma abordagem que funciona bem: use uma ferramenta de IA de visão de uso geral como extrator principal para todos os idiomas, depois direcione documentos em scripts específicos para mecanismos especializados de fallback apenas quando a confiança da ferramenta principal cair abaixo do limite.
A queda de precisão entre um único documento em alfabeto latino e um documento multilíngue não é uma falha da tecnologia — é uma lacuna previsível, diagnosticável e amplamente corrigível. Comece com a pergunta diagnóstica, aplique a correção para o cenário encontrado e reserve a revisão manual para os casos extremos onde os modelos de visão atuais ainda estão aprendendo. Teste em seus próprios documentos multilíngues e veja qual cenário se aplica ao seu fluxo de trabalho.