Pourquoi la précision de mon extraction multilingue chute-t-elle ?
3 scénarios et correctifs spécifiques
Votre facture en anglais est extraite avec une précision de 96 %. Le même outil sur une facture en allemand tombe à 88 %. Ajoutez des lignes en français à cet en-tête allemand et vous approchez les 80 %. Ce n'est pas l'IA qui échoue — c'est un problème de densité linguistique avec des causes spécifiques et traitables.
Points clés à retenir
- 96 % en anglais tombe à 88 % sur votre facture en allemand — non pas parce que l'outil est moins performant en allemand, mais parce que votre document contient secrètement quatre langues partageant une seule passe de reconnaissance.
- Un document CJK consomme le double de jetons par rapport à son équivalent en anglais, remplissant la fenêtre de contexte du modèle avant qu'il ne puisse accorder la même attention à chaque champ.
- Une seule question de diagnostic — par champ, par document ou par champ à écriture mixte — vous indique lequel des trois scénarios vous concerne, et aucun des trois correctifs n'implique de changer d'outil.
Le schéma est toujours le même : vous testez sur des documents en anglais, obtenez des résultats qui semblent magiques, puis passez à votre mélange de documents réels — des factures de fournisseurs de trois pays, des étiquettes d'expédition avec des adresses dans deux écritures, des contrats qui changent de langue en pleine clause — et la précision chute. Pas de manière catastrophique, mais suffisamment pour que vous commenciez à vous demander si l'outil fonctionne réellement.
Il fonctionne. La question est de savoir ce que vous lui demandez de faire. Une facture anglaise unique est une entrée uniforme : une langue, une écriture, un sens de lecture. Une facture allemande avec des lignes d'articles en français et des conditions de paiement en espagnol n'est pas la même catégorie de problème — et la précision le reflète. Comprendre lequel de trois scénarios distincts vous concerne fait la différence entre savoir quoi corriger et blâmer la mauvaise chose.
Ce guide couvre les trois scénarios les plus courants de baisse de précision, comment identifier celui qui affecte vos documents, et quoi faire pour chacun. Pour une vue d'ensemble plus large sur la façon dont l'IA de vision gère plusieurs langues au niveau architectural, voir l'IA peut-elle lire plusieurs langues dans un seul document — cet article suppose ces connaissances de base et se concentre sur le côté dépannage.
Scénario 1 : Document unique, plusieurs langues
C'est la cause la plus courante de baisse de précision, et celle dont les utilisateurs ne réalisent généralement pas qu'ils sont confrontés. Votre document est « en allemand » — mais l'en-tête est en anglais (nom et adresse de l'entreprise), les lignes d'articles mélangent des descriptions de produits allemandes avec des noms d'ingrédients français, et le pied de page contient des mentions légales dans la langue que l'équipe juridique de l'entreprise a choisie le trimestre dernier.
La plupart des modèles d'IA de vision traitent la page entière comme un contexte visuel unique. Ils ne « changent pas de langue » comme le fait l'OCR traditionnel — ils lisent tout à la fois et déterminent l'écriture de chaque caractère dans le cadre de la même passe d'inférence. C'est un avantage par rapport aux moteurs d'OCR qui nécessitent un pack de langues présélectionné, mais cela crée un problème subtil : lorsque du texte dans différentes langues apparaît dans le même champ visuel, la confiance du modèle dans les caractères diminue car il doit simultanément résoudre les limites d'écriture, les caractères spéciaux (é, ü, ñ, ß) et les formes de lettres dépendantes du contexte.
Voici ce qui se passe en pratique sur une seule facture multilingue :
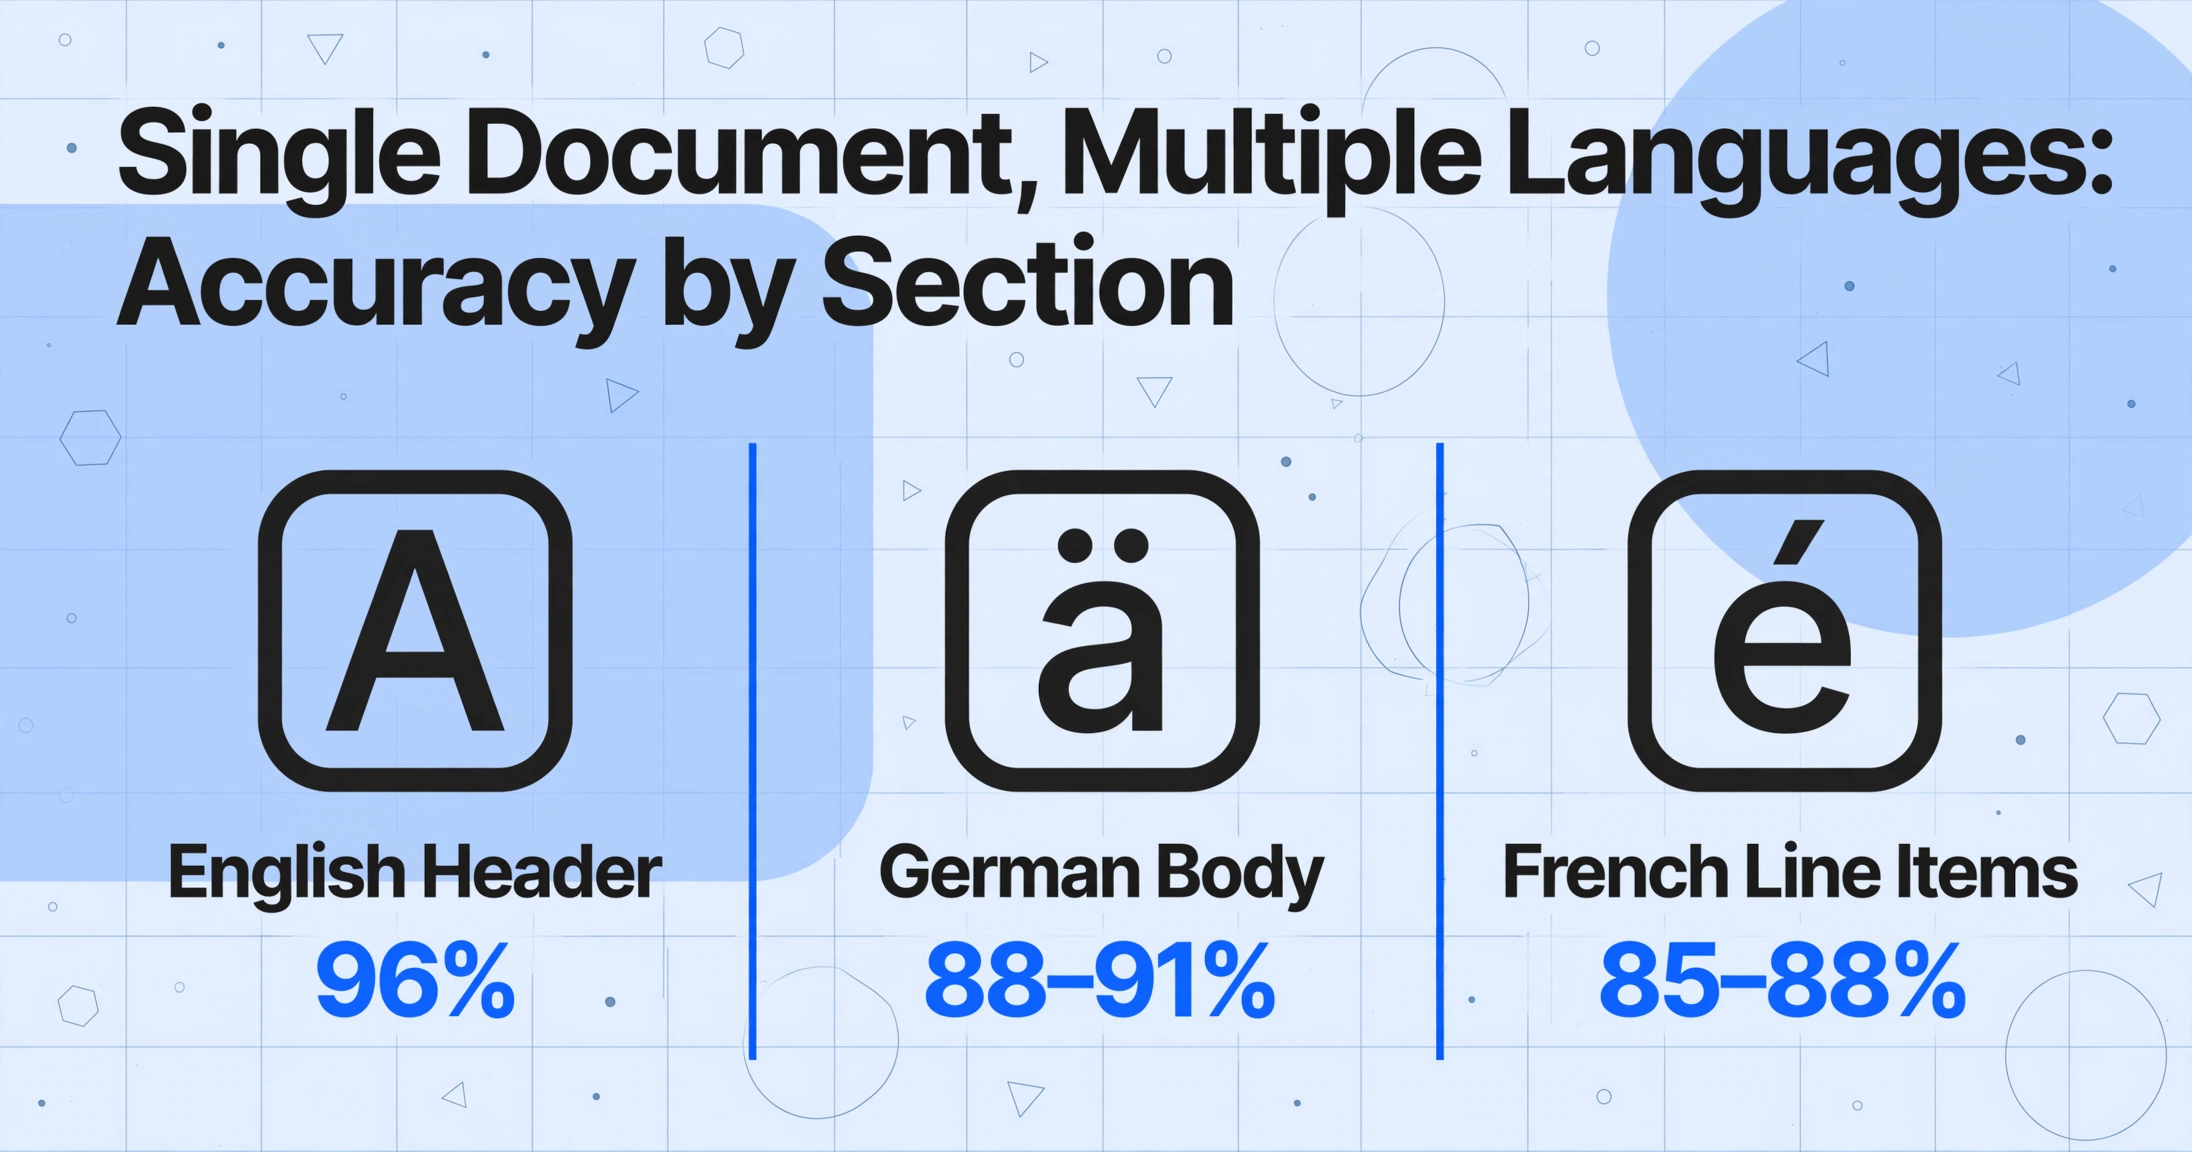
- En-tête anglais (nom de l'entreprise, adresse) — précision de 96 %. Le modèle est dans son régime le plus fort.
- Corps allemand (descriptions d'articles avec trémas, symbole « € », format de date allemand) — précision de 88 à 91 %. Les trémas (ä, ö, ü) sont supprimés ou remplacés ; « 14.03.2026 » est confondu avec le format anglais « 03/14/2026 ».
- Lignes d'articles françaises (caractères accentués : é, è, ê, œ) — précision de 85 à 88 %. Les accents sur les lignes à glyphes mixtes accumulent les erreurs ; un mot comme « générique » devient « generique » ou « g6n6rique ».
- Conditions de paiement espagnoles (ñ et ponctuation inversée) — précision de 82 à 87 %. Le modèle a déjà épuisé son budget de résolution de caractères sur les sections allemande et française au moment d'atteindre le pied de page.
Il ne s'agit pas de chiffres pessimistes. Ils sont typiques pour un document qui alterne entre trois langues à écriture latine — partageant toutes le même alphabet mais divergeant sur les caractères spéciaux, les formats de date et les notations monétaires.
Diagnostic : Si la précision par champ varie au sein d'un même document — les dates étant plus fiables que les noms de fournisseurs, ou les chiffres étant propres tandis que les caractères accentués sont corrompus — vous êtes probablement dans le scénario 1.
Correctif : Utilisez l'Extraction de colonnes personnalisées au lieu de l'OCR pleine page. Lorsque vous définissez des colonnes de sortie spécifiques (comme « Nom du fournisseur », « Date de facture », « Montant total »), l'IA se concentre sur la recherche de ces valeurs par sens sémantique plutôt que de tenter de traiter chaque caractère de la page de manière égale. Une colonne nommée « Montant total (EUR) » indique au modèle de chercher un nombre près d'un symbole monétaire, quel que soit le contexte linguistique environnant (allemand, français ou espagnol). Pour un aperçu plus approfondi du fonctionnement de l'extraction par colonnes selon les types de documents, consultez comment fonctionne l'extraction de données par IA et pourquoi la définition des colonnes est importante.
Si votre document mélange plusieurs langues à écriture latine, la solution n'est presque jamais un meilleur modèle — c'est une meilleure stratégie d'extraction. Au lieu de demander à l'IA de « tout lire », indiquez-lui exactement les champs dont vous avez besoin. La différence de précision entre l'OCR brut et l'extraction ciblée par colonnes sur un document multilingue est généralement de 5 à 10 %.
Scénario 2 : Différences d'écriture — Latin vs CJK vs Arabe
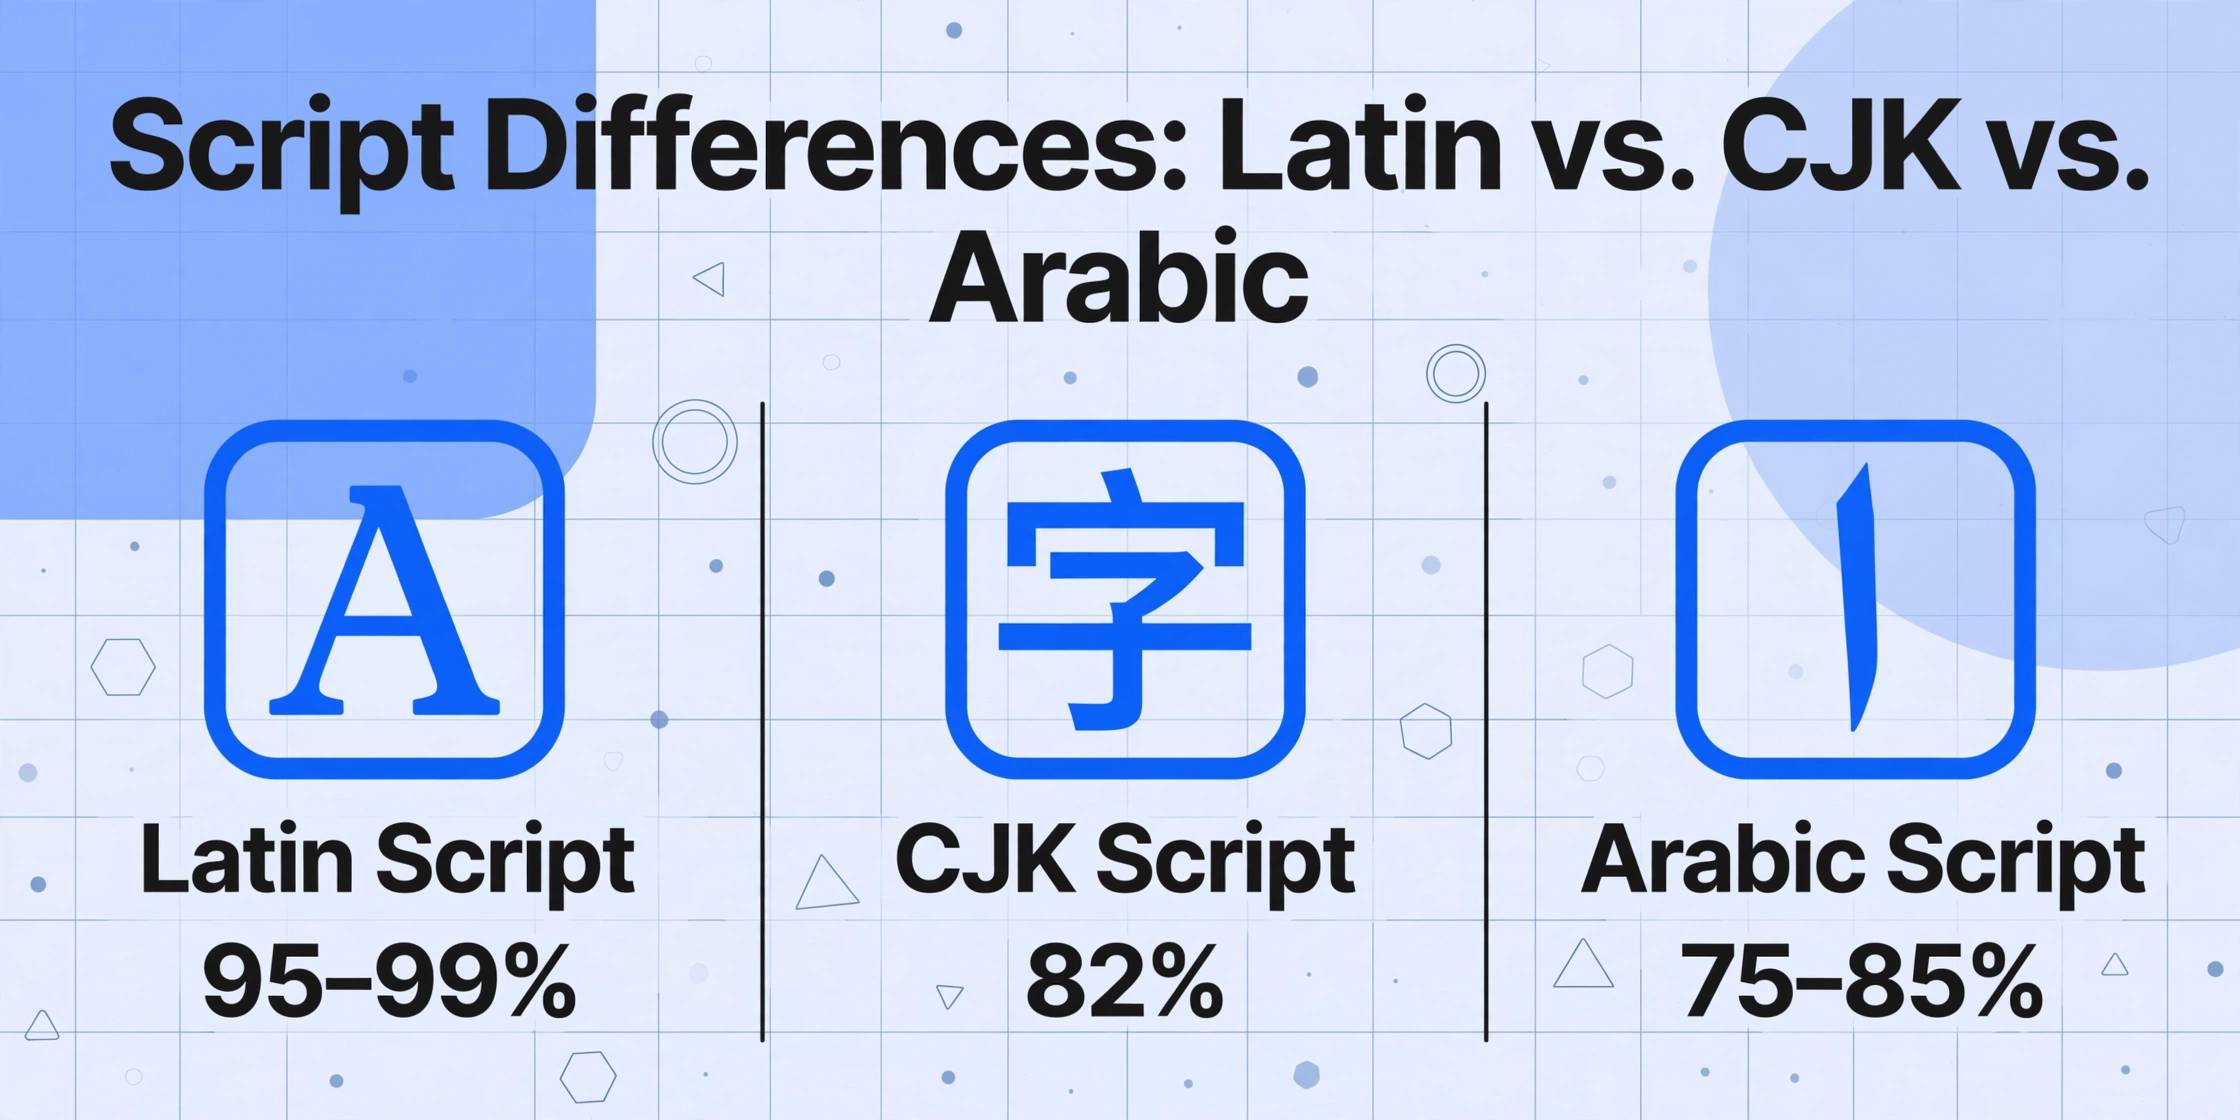
C'est là que les baisses de précision passent de « gênantes » à « perturbatrices pour le flux de travail ». Une facture anglaise s'extrait à 96 % et une facture japonaise à 82 % — non pas parce que le document japonais est de moindre qualité, mais parce que les familles d'écriture diffèrent fondamentalement dans la manière dont elles défient les modèles de vision.
Les écritures latines (anglais, français, allemand, espagnol, portugais, italien, néerlandais) partagent un alphabet de 26 caractères, un sens de lecture de gauche à droite et une abondance de données d'entraînement. Elles constituent un problème résolu pour l'IA de vision moderne — la précision sur du texte latin imprimé propre atteint systématiquement 95 à 99 %.
Les écritures CJK (chinois, japonais, coréen) représentent un niveau de difficulté différent. Une seule phrase japonaise peut contenir des Kanji (des milliers de caractères d'origine chinoise), des Hiragana (46 caractères phonétiques), des Katakana (46 caractères phonétiques pour les mots d'emprunt), des caractères latins pour les termes anglais et des chiffres arabes — le tout sur une seule ligne. Le même contenu sémantique en japonais consomme environ 2× les tokens de son équivalent anglais, ce qui signifie que le modèle remplit sa fenêtre de contexte plus rapidement sur les documents CJK et dispose de moins d'informations par champ. Pour un exemple pratique de ce problème de densité, consultez notre couverture de l'extraction de données de reçus japonais vers Excel.
L'arabe et l'hébreu ajoutent le défi du sens de lecture de droite à gauche. Le modèle doit détecter que le sens de lecture s'inverse, l'appliquer correctement à chaque bloc de texte, et gérer les formes de lettres à quatre positions de l'arabe (une lettre change de forme selon qu'elle apparaît au début, au milieu, à la fin ou isolée dans un mot). La précision sur les documents arabes imprimés varie de 75 à 85 % — non pas parce que le modèle est faible sur les caractères arabes en particulier, mais parce que les conventions typographiques RTL créent un problème d'analyse visuelle différent de celui des écritures de gauche à droite.
Diagnostic : Si vos documents en anglais sont extraits à 95 % ou plus et que les documents non latins obtiennent systématiquement 10 à 20 % de moins — sur différents documents, pas seulement un seul — vous êtes dans le scénario 2.
Correctif : Deux approches fonctionnent ici. Premièrement, vérifiez la prise en charge linguistique de l'outil pour l'écriture spécifique que vous traitez. Tous les outils qui prétendent prendre en charge « plus de 100 langues » ne sont pas entraînés de manière égale sur toutes les écritures. Certains modèles de vision sont entraînés de manière disproportionnée sur des données latines, avec le CJK et l'arabe ajoutés comme corpus secondaire plus restreint. Demandez précisément si les données d'entraînement du modèle incluent la famille d'écritures dont vous avez besoin. Deuxièmement, testez avec un échantillon représentatif de vos documents réels, pas avec les images de démonstration de l'outil. Une facture de démonstration en japonais d'un fournisseur sera une image propre, créée numériquement, avec un contraste parfait — votre facture japonaise scannée de 2019 avec un tampon estompé sur le nom du fournisseur est un problème de reconnaissance très différent.
Scénario 3 : écritures mixtes dans le même champ
C'est le cas le plus difficile — et celui que la plupart des documentations omettent. Un seul champ de votre document contient des caractères de plusieurs écritures. Un numéro de pièce comme « ABC-1234-안전밸브 » (lettres anglaises, chiffres arabes, hangul coréen). Un champ de nom de fournisseur qui indique « 株式会社Yamada (Osaka Branch) ». Un champ de date écrit « 2026年03月14日 » — des chiffres arabes intégrés dans du texte CJK.
Les modèles de vision traitent les champs à écritures mixtes en reconnaissant chaque groupe de caractères indépendamment et en les assemblant en une chaîne cohérente. Mais ce processus introduit plusieurs modes de défaillance spécifiques aux scénarios d'écritures mixtes :
- Erreur de détection des limites d'écriture : Le modèle juge incorrectement où une écriture se termine et où une autre commence. Un caractère hangul coréen qui ressemble visuellement à un idéogramme CJK peut être classé dans le mauvais groupe d'écriture, ce qui fait que les caractères suivants sont analysés avec le mauvais contexte de reconnaissance.
- Substitution de caractères : Des caractères visuellement similaires entre différentes écritures sont échangés. La lettre latine « A », le « А » cyrillique et le « Α » grec sont visuellement presque identiques mais sont des caractères Unicode différents. Un code produit contenant un « A » latin pourrait être généré comme un « А » cyrillique — visuellement identique, sémantiquement faux, et indétectable lors d'une vérification rapide car cela semble correct.
- Confusion de direction dans les champs mixtes LTR/RTL : Un nom d'entreprise arabe suivi d'un numéro d'enregistrement anglais entre parenthèses crée une chaîne bidirectionnelle que le modèle doit ordonner correctement. Une sortie comme « (ABC-1234 شركة » au lieu de « شركة (ABC-1234) » est courante — les deux caractères sont présents, mais l'ordre de lecture est inversé.
Diagnostic : Si vos données extraites semblent visuellement plausibles mais échouent par rapport à une référence connue — un numéro de pièce qui semble contenir tous les bons caractères mais ne correspond pas à votre ERP, ou un nom de fournisseur qui passe un contrôle humain rapide mais provoque un échec de recherche — le scénario 3 en est probablement la cause.
Correctif : Prétraitement avec indications de langue réduit considérablement les erreurs de mélange de scripts. Bien que la plupart des modèles de vision détectent automatiquement la langue, ancrer explicitement le contexte d'extraction aide. Dans les outils qui le permettent, passer une indication comme « la langue principale de ce document est le coréen avec des codes produit anglais intégrés » indique au modèle de s'attendre à des frontières de scripts plutôt que de les traiter comme des erreurs de reconnaissance. Pour les champs où la précision est critique — numéros d'identification fiscale, numéros de pièces, codes d'enregistrement — la validation par échantillonnage par langue est la protection la plus fiable : extrayez les données, puis vérifiez la partie non latine séparément de la partie latine. Si vous disposez d'une base de données de référence (ERP, CRM, liste de fournisseurs), la recoupement des valeurs extraites détecte les erreurs de substitution de caractères qu'aucune inspection visuelle ne révélera.
Comment diagnostiquer votre scénario
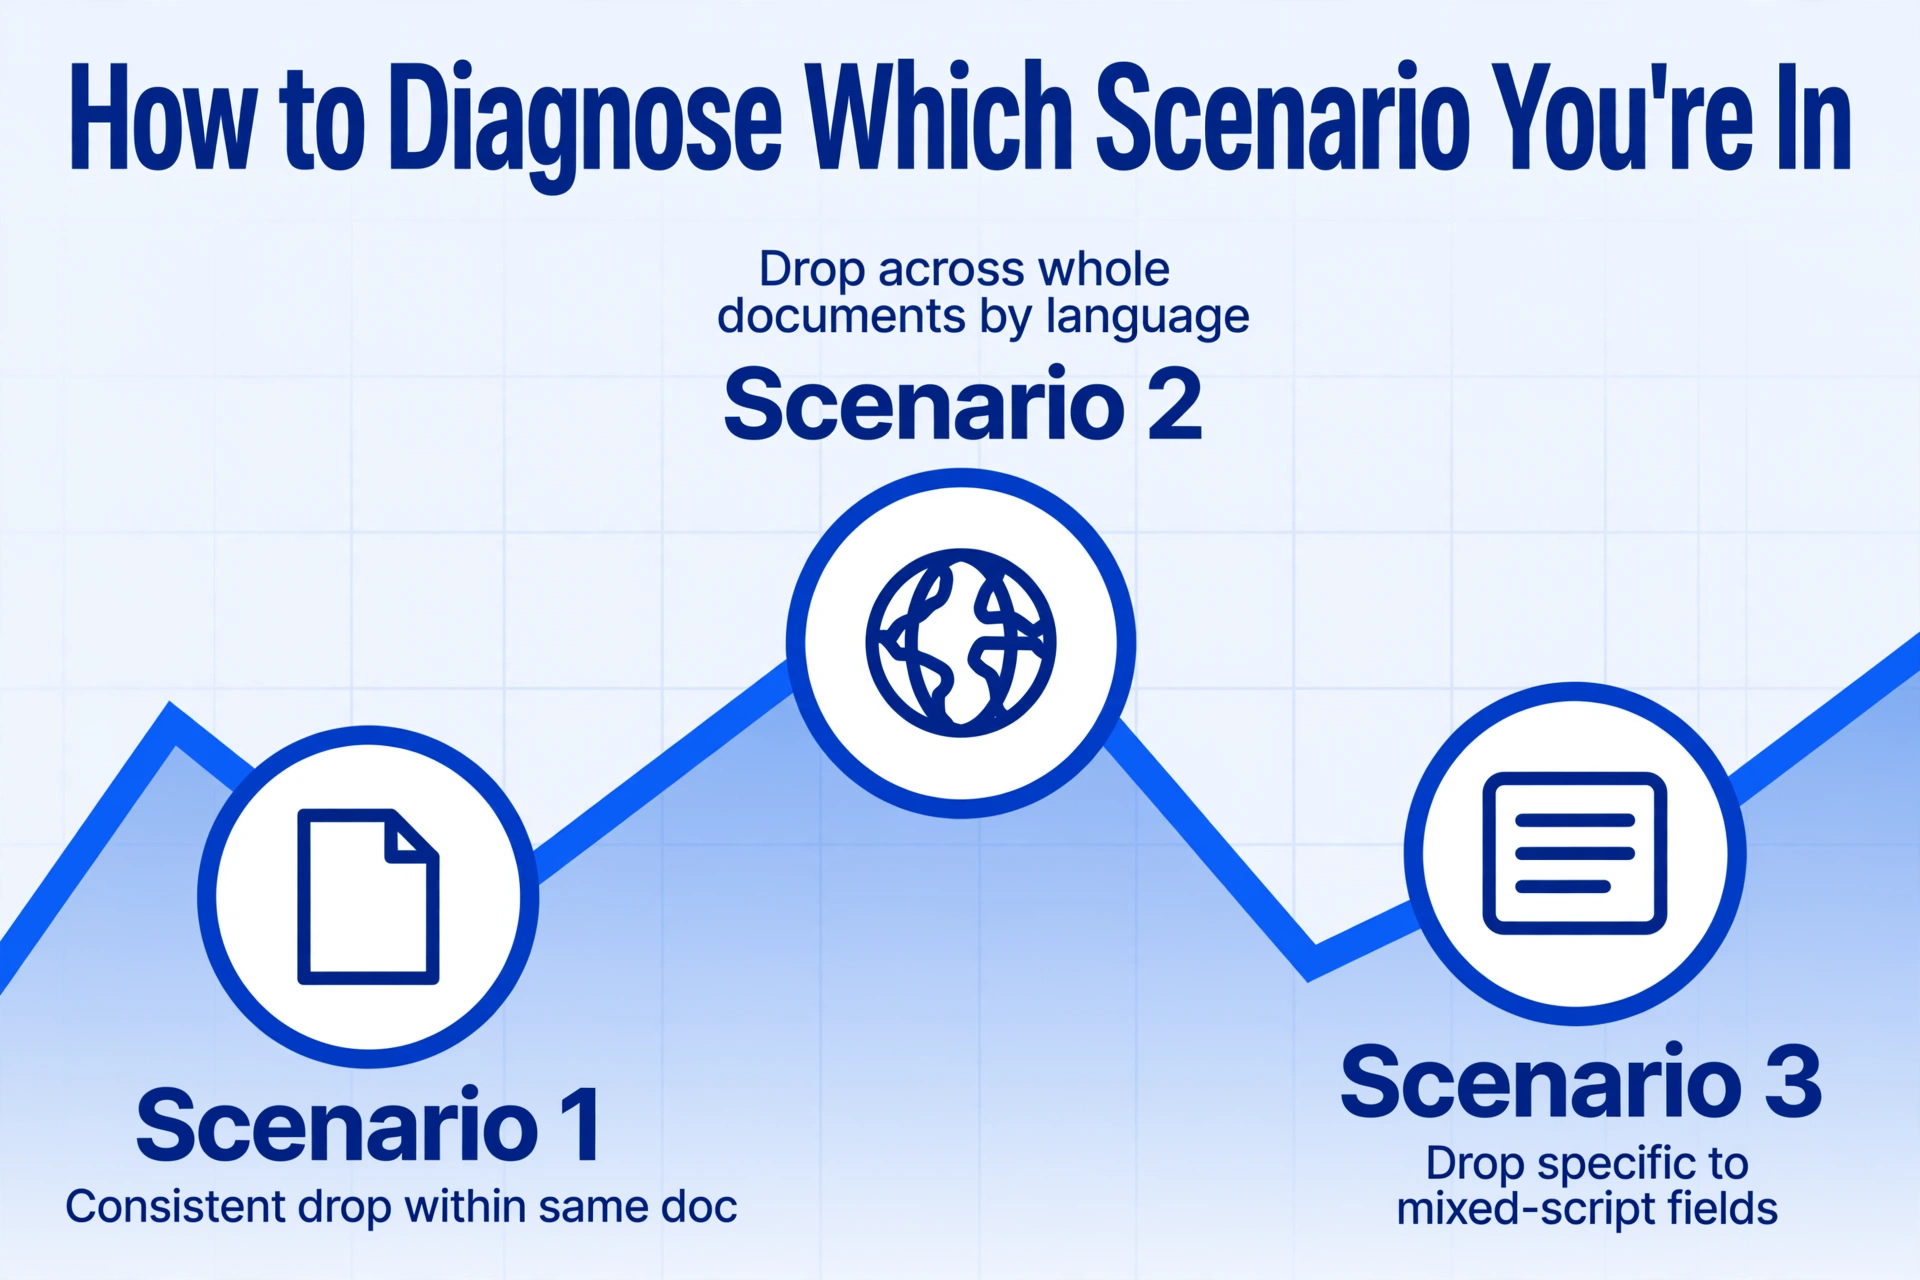
Lorsque vous constatez une baisse de précision sur des documents multilingues, suivez ce diagnostic en trois questions avant de modifier quoi que ce soit :
- La baisse de précision est-elle constante entre les langues mais au sein du même document ? Si vos champs en anglais sont toujours propres et vos champs en français/avec trémas sont systématiquement dégradés dans le même document → Scénario 1. Essayez l'extraction par colonnes avec des définitions de champs sémantiques.
- La baisse est-elle constante sur des documents entiers par famille de langues ? Si chaque document japonais s'extrait moins bien que chaque document anglais, quel que soit le contenu → Scénario 2. Vérifiez la couverture des données d'entraînement de l'outil pour le script spécifique.
- La baisse est-elle spécifique à certains champs contenant du contenu à scripts mixtes ? Si les noms de fournisseurs sont corrects mais que les numéros de pièces avec Kanji ou arabe intégrés sont sujets aux erreurs → Scénario 3. Ajoutez des indications de langue en prétraitement et mettez en place un recoupement par champ.
Ces trois scénarios se chevauchent souvent — un document peut contenir plusieurs langues (Scénario 1) sur différents scripts (Scénario 2) avec des champs à scripts mixtes (Scénario 3) sur la même page. La question de diagnostic vous indique quelle couche corriger en premier, car corriger la mauvaise couche fait perdre du temps. Si vous êtes dans le Scénario 2, aucun raffinement de colonnes (correctif du Scénario 1) ne comblera l'écart de précision — le modèle a besoin d'une couverture d'entraînement différente, pas d'une meilleure invite.
Prévention : trois habitudes pour réduire les baisses de précision multilingue
Une fois votre scénario identifié, ces pratiques empêchent le même problème de se reproduire sur de nouveaux types de documents et de langues :
1. Séparez les documents par famille d'écriture lorsque c'est possible. Si vous traitez 200 factures par jour — 150 en langues à écriture latine et 50 en CJK — les traiter séparément vous donne deux références de précision indépendantes. Vous savez que l'extraction en écriture latine fonctionne à 95 % et plus, et le CJK à 82 %. Si un lot CJK chute soudainement à 70 %, vous le remarquez immédiatement. Mélangés dans un seul lot, la moyenne globale pourrait passer de 93 % à 90 % sans que personne ne donne l'alerte.
2. Maintenez des échantillons de vérification par langue. Choisissez 5 à 10 documents représentatifs pour chaque famille de langues que vous traitez. À chaque mise à jour de votre flux d'extraction ou changement d'outil, exécutez l'ensemble de vérification et comparez la précision par langue. Cela détecte les régressions avant qu'elles n'atteignent la production. Un outil qui améliore la précision du latin de 2 % mais dégrade celle du CJK de 8 % n'est pas une amélioration nette pour un flux multilingue.
3. Utilisez des seuils de confiance au niveau des champs qui varient selon la langue. N'appliquez pas la même règle « accepter si confiance > 90 % » aux champs anglais et arabes du même document. Un seuil de confiance de 90 % sur l'anglais pourrait être trop strict (tout passe), tandis que le même seuil sur l'arabe pourrait rejeter chaque extraction. Définissez des seuils par langue en vous basant sur les résultats de vos échantillons de vérification — arabe 75 %, latin 90 %, CJK 80 % — et orientez tout ce qui est sous le seuil vers une relecture manuelle plutôt que de l'accepter silencieusement.
Quand faire remonter — ce qui nécessite encore une gestion manuelle
L'honnêteté compte ici plus qu'ailleurs dans cet article. La vision par IA est remarquablement performante toutes langues confondues, mais il existe des conditions limites où aucun réglage de prompt ni prétraitement ne comblera l'écart de précision jusqu'aux niveaux de production.
- Documents avec quatre langues ou plus couvrant différentes familles d'écriture. Un document contenant de l'anglais, de l'arabe (RTL), du japonais (CJK vertical + horizontal) et du coréen (CJK horizontal) — tous sur la même page — est à la limite des capacités actuelles des modèles de vision. Attendez-vous à une baisse de précision de 5 à 15 % par rapport à la référence monolingue.
- Mélange RTL/LTR dans la même phrase ou cellule de tableau. Lorsque l'arabe et l'anglais apparaissent sur la même ligne avec une relation parenthétique (par exemple, « البند (Item) 4.2 » dans une clause contractuelle), l'analyse bidirectionnelle crée des erreurs structurelles que les indices de prétraitement ne corrigent que partiellement.
- Contenu manuscrit dans une écriture non latine. L'écriture manuscrite seule fait chuter la précision de 15 à 30 % par rapport au texte imprimé. Ajoutez une deuxième langue par-dessus — des chiffres arabes manuscrits dans du japonais manuscrit — et l'effet cumulatif place la plupart des extractions sous les seuils utilisables. Ces documents bénéficient toujours de l'extraction par IA pour les parties imprimées, mais les champs manuscrits doivent être orientés vers une saisie manuelle par défaut, et non par exception.
- Paires de langues à faibles ressources. Thaï/arabe, swahili/cyrillique, birman/anglais — des paires où aucune langue n'est individuellement riche en ressources pour l'entraînement des modèles de vision. Le plancher de précision pour ces documents est plus bas que pour des paires bien couvertes comme anglais/espagnol ou anglais/chinois.
Le flux de travail pratique : l'extraction par IA traite automatiquement 80 à 90 % des données multilingues. Les 10 à 20 % restants — champs à haut risque dans les documents à écritures mixtes, champs numériques critiques dans les textes mixtes RTL/LTR et entrées manuscrites non latines — sont orientés vers une étape de vérification humaine, plus rapide qu'une saisie manuelle complète et plus fiable que de se fier à l'IA sur les cas les plus difficiles.
FAQ
Pourquoi mon outil d'extraction par IA fonctionne très bien sur les factures anglaises, mais moins bien sur les factures allemandes ou françaises ?
C'est généralement le scénario 1. Le document anglais est une entrée monolingue sans ambiguïté d'écriture. Le document allemand ou français contient probablement des caractères spéciaux (trémas, accents) que le modèle de vision traite comme des variantes des lettres latines standard — et ces variantes ont une confiance plus faible car elles apparaissent moins fréquemment dans les données d'entraînement que les caractères non accentués. L'écart de précision entre l'anglais et les autres langues à écriture latine est généralement de 5 à 8 % — perceptible mais corrigeable grâce à une extraction par colonnes qui concentre le modèle sur des champs spécifiques plutôt que sur une OCR de page entière.
Puis-je améliorer la précision de l'extraction multilingue en convertissant d'abord les documents dans une seule langue ?
Pas de manière fiable. La traduction automatique avant extraction introduit une couche d'erreur distincte — vous extrayez alors à partir d'un texte traduit, qui peut perdre les libellés de champs, les formats numériques et la structure du document. Le document original contient la mise en page et les données voulues par l'auteur. L'extraction fonctionne mieux lorsqu'elle lit l'original, pas une version traduite. La meilleure approche consiste à extraire du document original à l'aide de définitions de colonnes sémantiques, puis à valider les données extraites par rapport à la langue requise par votre système en aval.
L'IA doit-elle savoir quelles langues sont présentes dans le document avant le traitement ?
Non pour la détection — les modèles de vision modernes détectent automatiquement les écritures et les langues en lisant la page. Mais oui pour le contexte — si votre document contient une combinaison de langues rares ou des champs à écritures mixtes, fournir une indication de langue (par exemple, « ce document contient du coréen et de l'anglais avec des chiffres arabes intégrés ») améliore la précision de 3 à 7 % sur les portions en langue secondaire, car le modèle alloue ses ressources de reconnaissance plus efficacement.
Quelle différence de précision attendre entre les documents en alphabet latin et en CJK avec le même outil ?
Pour des documents imprimés propres de qualité similaire, attendez-vous à une précision CJK inférieure de 8 à 15 % par rapport au latin sur le même outil. Ce n'est pas un problème de qualité de l'outil — cela reflète la différence fondamentale d'inventaire de caractères (26 contre des milliers), de consommation de tokens (2× par unité sémantique) et de volume de données d'entraînement. Un outil obtenant 97 % en anglais et 83 % en japonais fonctionne normalement pour l'état actuel de l'IA visuelle.
Dois-je utiliser différents outils d'extraction IA pour différentes langues ?
Si votre mélange de documents couvre plusieurs familles d'écritures (pas seulement plusieurs langues au sein d'une même famille), vous pouvez obtenir une meilleure précision par langue en utilisant des outils optimisés pour des écritures régionales spécifiques. PaddleOCR, par exemple, est plus performant sur les documents CJK que les modèles de vision généralistes car ses données d'entraînement sont majoritairement CJK. Cependant, gérer plusieurs outils complexifie le flux de travail, ce qui peut l'emporter sur le gain de précision pour la plupart des équipes. Une approche efficace : utiliser un outil d'IA visuelle généraliste comme extracteur principal pour toutes les langues, puis rediriger les documents dans des écritures spécifiques vers des moteurs spécialisés de secours uniquement lorsque la confiance de l'outil principal tombe sous un seuil.
La baisse de précision entre un document en alphabet latin unique et un document multilingue n'est pas un échec de la technologie — c'est un écart prévisible, diagnosticable et largement corrigible. Commencez par la question de diagnostic, appliquez la correction pour le scénario rencontré, et réservez la relecture manuelle pour les cas limites où les modèles de vision actuels apprennent encore. Testez sur vos propres documents multilingues et voyez quel scénario s'applique à votre flux de travail.