¿Por qué baja la precisión de mi extracción multilingüe?
3 escenarios y soluciones específicas
Su factura en inglés se extrae con un 96 % de precisión. La misma herramienta en una factura alemana baja al 88 %. Añada líneas de artículos en francés a ese encabezado alemán y se acerca al 80 %. Esto no es un fallo de la IA: es un problema de densidad lingüística con causas específicas y solucionables.
Conclusiones clave
- El 96 % en inglés baja al 88 % en su factura alemana, no porque la herramienta sea más débil en alemán, sino porque su documento contiene en secreto cuatro idiomas que comparten una sola pasada de reconocimiento.
- Un documento CJK consume el doble de tokens que su equivalente en inglés, llenando la ventana de contexto del modelo antes de que pueda prestar la misma atención a cada campo.
- Una pregunta de diagnóstico —por campo, por documento o por campo de escritura mixta— le indica en cuál de los tres escenarios se encuentra, y ninguna de las tres soluciones implica cambiar de herramienta.
El patrón es siempre el mismo: prueba con documentos en inglés, obtiene resultados que parecen magia, luego cambia a su mezcla real de documentos — facturas de proveedores de tres países, etiquetas de envío con direcciones en dos escrituras, contratos que cambian de idioma a mitad de cláusula — y la precisión baja. No de forma catastrófica, pero lo suficiente para que empiece a preguntarse si la herramienta realmente funciona.
Sí funciona. La cuestión es qué le está pidiendo que haga. Una factura inglesa única es una entrada uniforme: un idioma, una escritura, una dirección de lectura. Una factura alemana con líneas de artículos en francés y condiciones de pago en español no es la misma categoría de problema — y la precisión lo refleja. Entender cuál de los tres escenarios distintos está manejando es la diferencia entre saber qué corregir y culpar a lo equivocado.
Esta guía cubre los tres escenarios más comunes de caída de precisión, cómo saber cuál está ocurriendo con sus documentos y qué hacer con cada uno. Para una visión general más amplia de cómo la IA de visión maneja múltiples idiomas a nivel arquitectónico, consulte ¿puede la IA leer varios idiomas en un solo documento? — este artículo asume ese contexto y se centra en el lado de la resolución de problemas.
Escenario 1: Documento único, varios idiomas
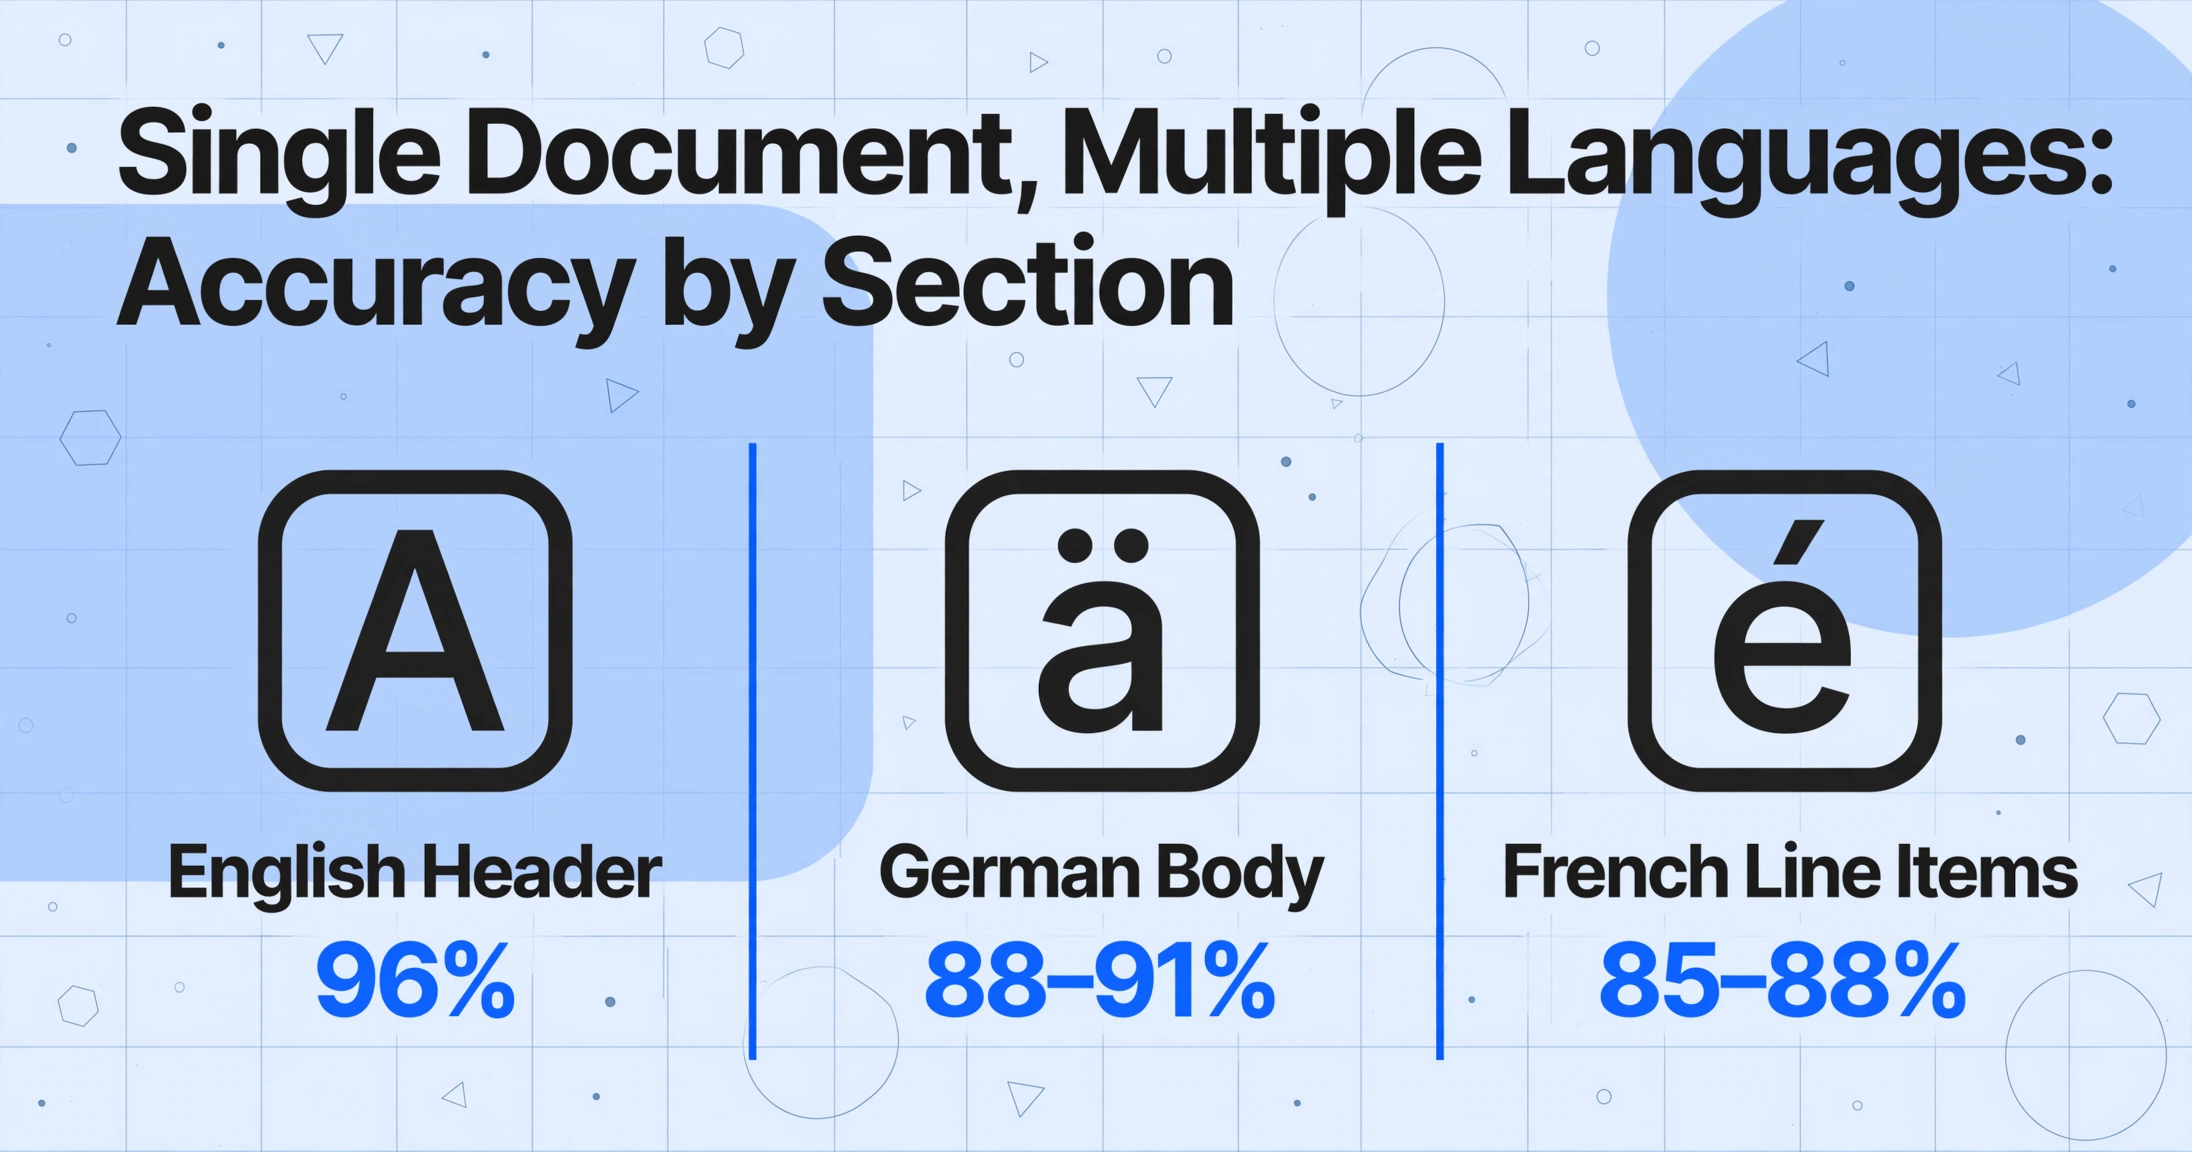
Esta es la causa más común de caída de precisión, y la que los usuarios normalmente no se dan cuenta de que están manejando. Su documento está "en alemán" — pero el encabezado está en inglés (nombre y dirección de la empresa), las líneas de artículos mezclan descripciones de productos en alemán con nombres de ingredientes en francés, y el pie de página contiene texto legal estándar en el idioma que el equipo legal corporativo eligió el último trimestre.
La mayoría de los modelos de IA de visión procesan toda la página como un único contexto visual. No "cambian de idioma" como lo hace el OCR tradicional — leen todo a la vez y determinan la escritura de cada carácter como parte de la misma pasada de inferencia. Esto es una ventaja sobre los motores de OCR que requieren un paquete de idioma preseleccionado, pero crea un problema sutil: cuando texto en diferentes idiomas aparece en el mismo campo visual, la confianza del modelo en los caracteres baja porque debe resolver simultáneamente los límites de escritura, los caracteres especiales (é, ü, ñ, ß) y las formas de letras dependientes del contexto.
Esto es lo que ocurre en la práctica con una sola factura multilingüe:
- Encabezado en inglés (nombre de empresa, dirección) — 96% de precisión. El modelo está en su régimen más fuerte.
- Cuerpo en alemán (descripciones de artículos con diéresis, moneda "€", formato de fecha alemán) — 88–91% de precisión. Las diéresis (ä, ö, ü) se omiten o se sustituyen; "14.03.2026" se confunde con el inglés "03/14/2026".
- Líneas de artículos en francés (caracteres acentuados: é, è, ê, œ) — 85–88% de precisión. Los acentos en líneas con glifos mixtos acumulan errores; una palabra como "générique" se convierte en "generique" o "g6n6rique".
- Condiciones de pago en español (ñ y puntuación invertida) — 82–87% de precisión. El modelo ya ha gastado su presupuesto de resolución de caracteres en las secciones en alemán y francés cuando llega al pie de página.
Estos no son los peores casos posibles. Son típicos de un documento que alterna entre tres idiomas de escritura latina, todos con el mismo alfabeto pero con diferencias en caracteres especiales, formatos de fecha y notaciones de moneda.
Diagnóstico: Si la precisión por campo varía dentro del mismo documento — las fechas son más confiables que los nombres de proveedores, o los números están limpios mientras los caracteres acentuados aparecen corruptos — probablemente se encuentra en el Escenario 1.
Solución: Use la Extracción de Columnas Personalizadas en lugar del OCR de página completa. Cuando define columnas de salida específicas (como "Nombre del proveedor", "Fecha de factura", "Monto total"), la IA se enfoca en encontrar esos valores por significado semántico en lugar de intentar procesar cada carácter de la página por igual. Una columna llamada "Monto total (EUR)" le indica al modelo que busque un número cerca de un símbolo de moneda, sin importar si el texto circundante está en alemán, francés o español. Para un análisis más profundo de cómo funciona la extracción por columnas en distintos tipos de documentos, consulte cómo funciona la extracción de documentos con IA y por qué la definición de columnas es importante.
Si su documento combina varios idiomas de escritura latina, la solución casi nunca es un mejor modelo — es una mejor estrategia de extracción. En lugar de decirle a la IA que "lea todo", indíquele exactamente qué campos necesita. La diferencia de precisión entre el OCR bruto y la extracción dirigida por columnas en un documento multilingüe suele ser del 5–10%.
Escenario 2: Diferencias de escritura — latina vs. CJK vs. árabe
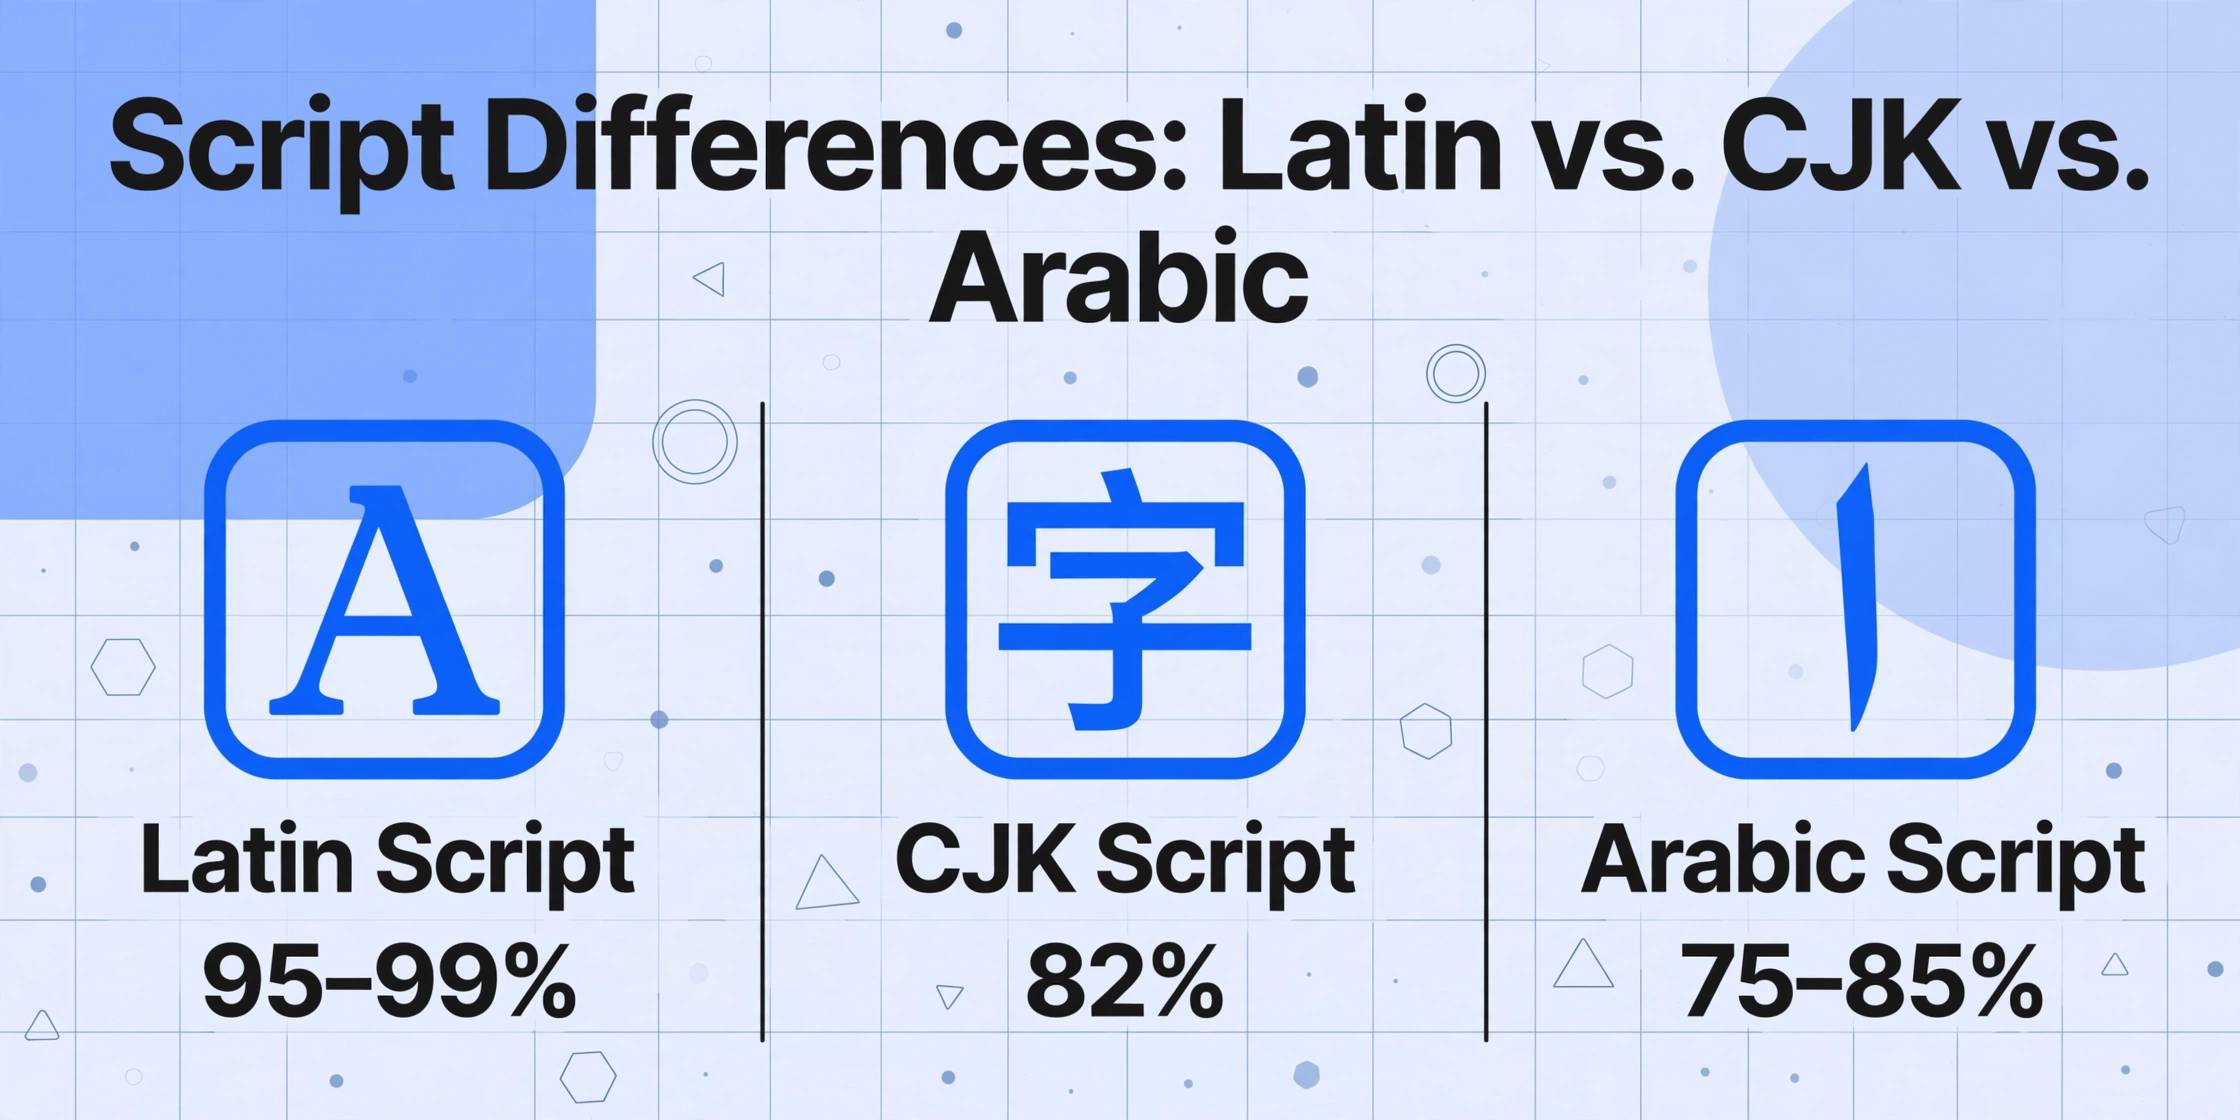
Aquí es donde las caídas de precisión cruzan la línea de "molestas" a "que interrumpen el flujo de trabajo". Una factura en inglés se extrae con un 96% de precisión y una factura en japonés con un 82% — no porque el documento japonés sea de menor calidad, sino porque las familias de escritura son fundamentalmente diferentes en cómo desafían a los modelos de visión.
Las escrituras latinas (inglés, francés, alemán, español, portugués, italiano, neerlandés) comparten un alfabeto de 26 caracteres, dirección de lectura de izquierda a derecha y abundantes datos de entrenamiento. Son un problema resuelto para la IA de visión moderna — la precisión en texto latino impreso limpio alcanza consistentemente el 95–99%.
Las escrituras CJK (chino, japonés, coreano) son un nivel diferente de dificultad. Una sola oración en japonés puede contener kanji (miles de caracteres de origen chino), hiragana (46 caracteres fonéticos), katakana (46 caracteres fonéticos para préstamos lingüísticos), caracteres latinos para términos en inglés y numerales arábigos — todo en una sola línea. El mismo contenido semántico en japonés consume aproximadamente 2× los tokens de su equivalente en inglés, lo que significa que el modelo llena su ventana de contexto más rápido en documentos CJK y tiene menos información disponible por campo. Para un ejemplo práctico de este problema de densidad, consulte nuestra cobertura sobre extracción de datos de recibos japoneses a Excel.
El árabe y el hebreo añaden el desafío de la dirección de derecha a izquierda. El modelo debe detectar que la dirección de lectura se invierte, aplicarla correctamente en cada bloque de texto y manejar las formas de letras en cuatro posiciones del árabe (una letra cambia de forma según aparezca al inicio, en medio, al final o aislada en una palabra). La precisión en documentos árabes impresos oscila entre el 75 y el 85 % — no porque el modelo sea débil específicamente con los caracteres árabes, sino porque las convenciones tipográficas RTL crean un problema de análisis visual diferente al de las escrituras de izquierda a derecha.
Diagnóstico: Si sus documentos en inglés se extraen con un 95 % o más de precisión y los documentos no latinos quedan sistemáticamente entre un 10 y un 20 % por debajo — en distintos documentos, no solo en uno —, usted se encuentra en el Escenario 2.
Solución: Dos enfoques funcionan aquí. Primero, verifique la compatibilidad lingüística de la herramienta con la escritura específica que está procesando. No todas las herramientas que afirman tener "compatibilidad con más de 100 idiomas" entrenan por igual en todas las escrituras. Algunos modelos de visión están entrenados de forma desproporcionada con datos latinos, con CJK y árabe añadidos como un corpus secundario más pequeño. Pregunte específicamente si los datos de entrenamiento del modelo incluyen la familia de escritura que usted necesita. Segundo, pruebe con una muestra representativa de sus documentos reales, no con las imágenes de demostración de la herramienta. Una factura de demostración del proveedor en japonés será una imagen limpia creada digitalmente con contraste perfecto — su factura japonesa escaneada de 2019 con un sello desvaído sobre el nombre del proveedor es un problema de reconocimiento muy diferente.
Escenario 3: Escrituras mixtas en el mismo campo
Este es el caso más difícil — y el que la mayoría de la documentación omite. Un solo campo de su documento contiene caracteres de múltiples escrituras. Un número de pieza como "ABC-1234-안전밸브" (letras inglesas, numerales arábigos, hangul coreano). Un campo de nombre de proveedor que dice "株式会社Yamada (Osaka Branch)". Un campo de fecha escrito como "2026年03月14日" — numerales arábigos incrustados en texto CJK.
Los modelos de visión manejan campos de escritura mixta reconociendo cada grupo de caracteres de forma independiente y ensamblándolos en una cadena coherente. Pero este proceso introduce varios modos de fallo específicos de los escenarios de escritura mixta:
- Detección incorrecta de límites entre escrituras: El modelo juzga incorrectamente dónde termina una escritura y comienza otra. Un carácter hangul coreano que se parece visualmente a un ideograma CJK puede clasificarse en el grupo de escritura equivocado, lo que provoca que los caracteres siguientes se analicen con el contexto de reconocimiento incorrecto.
- Sustitución de caracteres: Los caracteres de apariencia similar entre escrituras se intercambian. La letra latina "A", la cirílica "А" y la griega "Α" son visualmente casi idénticas, pero son caracteres Unicode diferentes. Un código de producto que contenga la "A" latina podría emitirse como "А" cirílica — visualmente idéntico, semánticamente incorrecto e indetectable en una verificación rápida porque parece correcto.
- Confusión de dirección en campos mixtos LTR/RTL: Un nombre de empresa árabe seguido de un número de registro inglés entre paréntesis crea una cadena bidireccional que el modelo debe ordenar correctamente. Una salida como "(ABC-1234 شركة") en lugar de "شركة (ABC-1234)" es común — ambos caracteres están presentes, pero el orden de lectura está invertido.
Diagnóstico: Si sus datos extraídos parecen visualmente plausibles pero fallan contra una referencia conocida — un número de pieza que parece tener todos los caracteres correctos pero no coincide con su ERP, o un nombre de proveedor que pasa una revisión humana pero provoca un fallo de búsqueda —, el Escenario 3 es la causa probable.
Corrección: Preprocesamiento con indicaciones de idioma reduce significativamente los errores de escritura mixta. Aunque la mayoría de los modelos de visión detectan el idioma automáticamente, anclar explícitamente el contexto de extracción ayuda. En herramientas que lo admiten, pasar una indicación como «el idioma principal de este documento es coreano con códigos de producto en inglés incrustados» le dice al modelo que espere límites de escritura en lugar de tratarlos como errores de reconocimiento. Para campos donde la precisión es crítica — ID de impuestos, números de pieza, códigos de registro — la validación de verificación puntual por idioma es el salvaguarda más confiable: extraiga los datos y luego verifique la porción no latina por separado de la porción latina. Si tiene una base de datos de referencia (ERP, CRM, lista de proveedores), la verificación cruzada de los valores extraídos detecta errores de sustitución de caracteres que ninguna inspección visual encontrará.
Cómo Diagnosticar en Qué Escenario Se Encuentra
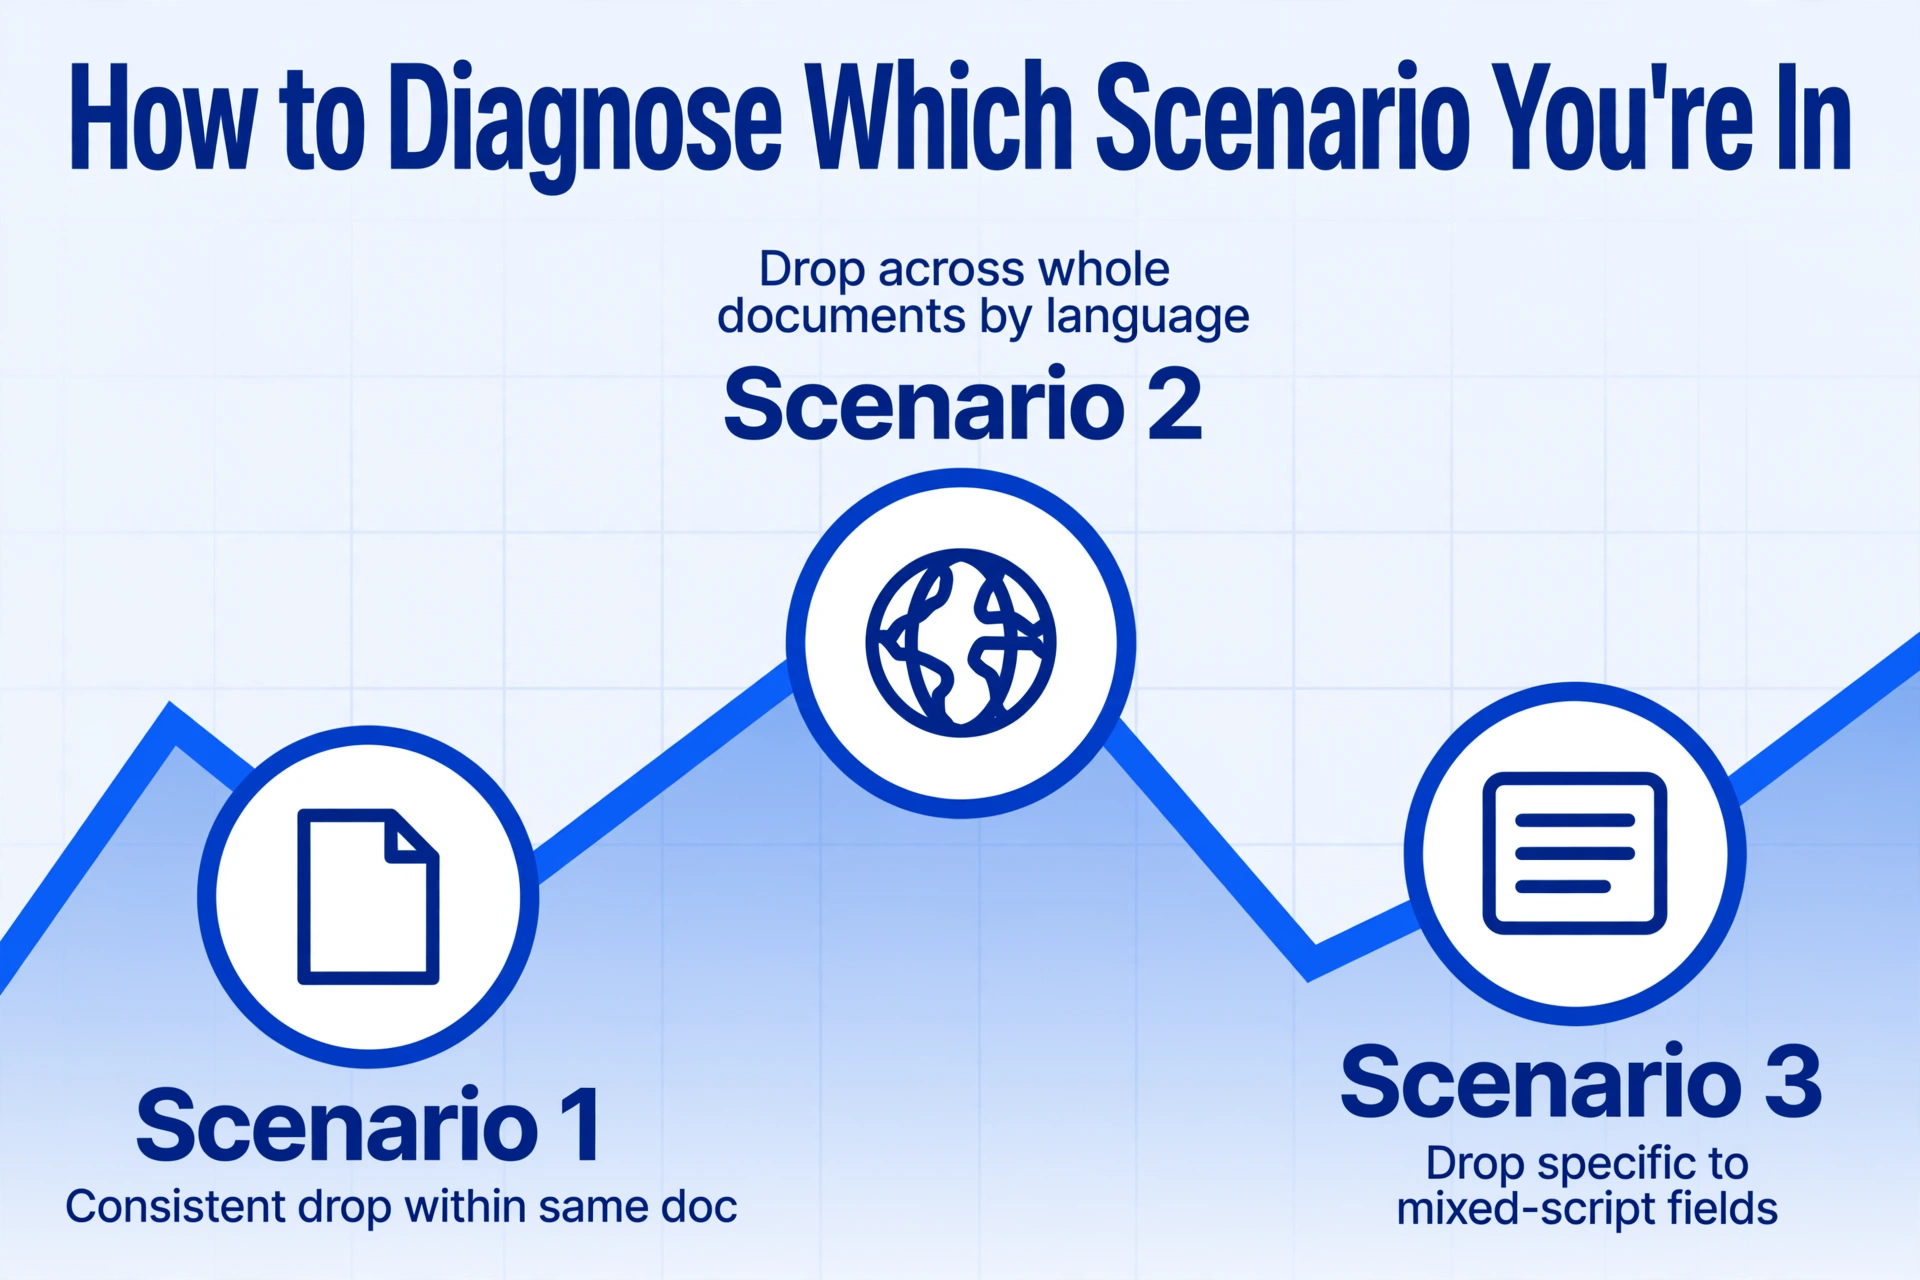
Cuando note que la precisión disminuye en documentos multilingües, realice este diagnóstico de tres preguntas antes de cambiar cualquier otra cosa:
- ¿La caída de precisión es consistente entre idiomas pero dentro del mismo documento? Si sus campos en inglés siempre están limpios y sus campos en francés/con diéresis están consistentemente degradados en el mismo documento → Escenario 1. Pruebe la extracción basada en columnas con definiciones de campos semánticos.
- ¿La caída es consistente en documentos completos según la familia de idiomas? Si cada documento en japonés se extrae peor que cada documento en inglés, independientemente del contenido → Escenario 2. Verifique la cobertura de datos de entrenamiento de la herramienta para la escritura específica.
- ¿La caída es específica de ciertos campos que contienen contenido de escritura mixta? Si los nombres de proveedores están bien pero los números de pieza con Kanji o árabe incrustado son propensos a errores → Escenario 3. Agregue indicaciones de idioma en el preprocesamiento e implemente la verificación cruzada por campo.
Estos tres escenarios a menudo se superponen — un documento puede contener múltiples idiomas (Escenario 1) en diferentes escrituras (Escenario 2) con campos de escritura mixta (Escenario 3) en la misma página. La pregunta de diagnóstico le indica qué capa corregir primero, porque corregir la capa equivocada pierde tiempo. Si se encuentra en el Escenario 2, ningún refinamiento de columnas (solución del Escenario 1) recuperará la brecha de precisión — el modelo necesita una cobertura de entrenamiento diferente, no un mejor prompt.
Prevención: tres hábitos que reducen las caídas de precisión en entornos multilingües
Una vez que haya identificado su escenario, estas prácticas evitan que el mismo problema se repita en nuevos tipos de documentos e idiomas:
1. Separe los documentos por familia de escritura cuando sea posible. Si procesa 200 facturas al día — 150 en idiomas de escritura latina y 50 en CJK — procesarlas por separado le brinda dos líneas base de precisión independientes. Usted sabe que la extracción en escritura latina funciona al 95% o más y la CJK al 82%. Si un lote CJK cae repentinamente al 70%, lo nota de inmediato. Mezcladas en un solo lote, el promedio general podría caer del 93% al 90% y nadie lo escalaría.
2. Mantenga muestras de verificación por idioma. Seleccione de 5 a 10 documentos representativos para cada familia de idiomas que procese. Cada vez que actualice su flujo de extracción o cambie de herramienta, ejecute el conjunto de verificación y compare la precisión por idioma. Esto detecta regresiones antes de que lleguen a producción. Una herramienta que mejoró la precisión en latín un 2% pero degradó la precisión en CJK un 8% no es una mejora neta para un flujo de trabajo multilingüe.
3. Use umbrales de confianza a nivel de campo que varíen según el idioma. No aplique la misma regla de «aceptar si la confianza es > 90%» a campos en inglés y en árabe del mismo documento. Un umbral de confianza del 90% en inglés podría ser demasiado estricto (todo pasa), mientras que el mismo umbral en árabe podría rechazar todas las extracciones. Establezca umbrales por idioma basados en los resultados de sus muestras de verificación — árabe 75%, latín 90%, CJK 80% — y envíe todo lo que esté por debajo del umbral a revisión manual en lugar de aceptarlo silenciosamente.
Cuándo escalar — lo que aún requiere manejo manual
La honestidad importa aquí más que en cualquier otra parte de este artículo. La IA de visión es notablemente capaz en varios idiomas, pero existen condiciones límite donde ningún ajuste de instrucciones ni preprocesamiento cerrará la brecha de precisión hasta niveles de producción.
- Documentos con cuatro o más idiomas de diferentes familias de escritura. Un documento que contiene inglés, árabe (RTL), japonés (CJK vertical + horizontal) y coreano (CJK horizontal) — todo en la misma página — está en el límite de las capacidades actuales de los modelos de visión. Espere una caída de precisión del 5–15% respecto a la línea base de un solo idioma.
- RTL/LTR mixto dentro de la misma oración o celda de tabla. Cuando el árabe y el inglés aparecen en la misma línea con una relación parentética (p. ej., «البند (Item) 4.2» en una cláusula contractual), el análisis bidireccional crea errores estructurales que las sugerencias de preprocesamiento solo corrigen parcialmente.
- Contenido manuscrito en una escritura no latina. La escritura manual por sí sola reduce la precisión entre un 15 y un 30% en comparación con el texto impreso. Añada un segundo idioma encima — numerales árabes manuscritos en japonés manuscrito — y el efecto combinado deja la mayoría de las extracciones por debajo de los umbrales utilizables. Estos documentos aún se benefician de la extracción con IA para las partes impresas, pero los campos manuscritos deben enviarse a entrada manual como flujo predeterminado, no como excepción.
- Combinaciones de idiomas de bajos recursos. Tailandés/árabe, suajili/cirílico, birmano/inglés — combinaciones donde ninguno de los idiomas es individualmente de altos recursos para el entrenamiento de modelos de visión. El piso de precisión para estos documentos es más bajo que para combinaciones bien cubiertas como inglés/español o inglés/chino.
El flujo de trabajo práctico: la extracción con IA maneja automáticamente el 80–90% de los datos multilingües. El 10–20% restante — campos de alto riesgo en documentos con escritura mixta, campos numéricos críticos en texto mixto RTL/LTR y entradas manuscritas no latinas — se deriva a un paso de revisión humana que es más rápido que la entrada manual completa y más confiable que confiar en la IA para los casos más difíciles.
Preguntas frecuentes
¿Por qué mi herramienta de extracción con IA funciona muy bien con facturas en inglés, pero peor con las alemanas o francesas?
Esto suele ser el Escenario 1. El documento en inglés es una entrada de un solo idioma sin ambigüedad de escritura. El documento en alemán o francés probablemente contiene caracteres especiales (diéresis, acentos) que el modelo de visión trata como variaciones de las letras latinas estándar — y esas variaciones tienen menor confianza porque aparecen con menos frecuencia en los datos de entrenamiento que los caracteres sin acentos. La brecha de precisión entre el inglés y otros idiomas con escritura latina suele ser del 5–8% — notable pero corregible con extracción basada en columnas que enfoca el modelo en campos específicos en lugar de OCR de página completa.
¿Puedo mejorar la precisión de la extracción multilingüe convirtiendo primero los documentos a un solo idioma?
No de manera confiable. La traducción automática antes de la extracción introduce una capa de error separada — ahora está extrayendo de texto traducido, que puede perder etiquetas de campos, formatos numéricos y la estructura del documento. El documento original contiene el diseño y los datos que el autor pretendía. La extracción funciona mejor cuando lee el original, no una versión traducida. El mejor enfoque es extraer del documento original usando definiciones de columnas semánticas y luego validar los datos extraídos contra el idioma que requiera su sistema posterior.
¿La IA necesita saber qué idiomas están en el documento antes de procesarlo?
No para la detección — los modelos de visión modernos detectan escrituras e idiomas automáticamente como parte de la lectura de la página. Pero sí para el contexto — si su documento contiene una combinación de idiomas poco común o campos con escritura mixta, proporcionar una pista de idioma (por ejemplo, "este documento contiene coreano e inglés con números arábigos integrados") mejora la precisión en un 3–7% en las partes del idioma secundario porque el modelo asigna los recursos de reconocimiento de manera más eficiente.
¿Cuál es la diferencia de precisión esperada entre documentos en alfabeto latino y CJK con la misma herramienta?
Para documentos impresos limpios de calidad similar, espere que la precisión en CJK sea entre un 8 y 15 % menor que en alfabeto latino con la misma herramienta. Esto no es un problema de calidad de la herramienta, sino que refleja la diferencia fundamental en el inventario de caracteres (26 frente a miles), el consumo de tokens (2× por unidad semántica) y el volumen de datos de entrenamiento. Una herramienta que obtiene un 97 % en inglés y un 83 % en japonés está rindiendo con normalidad para el estado actual de la IA de visión.
¿Debería usar diferentes herramientas de extracción de IA para distintos idiomas?
Si su combinación de documentos abarca varias familias de escritura (no solo varios idiomas dentro de la misma familia), puede lograr una mayor precisión por idioma usando herramientas optimizadas para escrituras regionales específicas. PaddleOCR, por ejemplo, funciona mejor en documentos CJK que los modelos de visión de uso general porque sus datos de entrenamiento son predominantemente CJK. Sin embargo, gestionar múltiples herramientas añade complejidad al flujo de trabajo que puede superar la ganancia en precisión para la mayoría de los equipos. Un enfoque que funciona bien: use una herramienta de IA de visión de uso general como extractor principal para todos los idiomas, luego enrute documentos en escrituras específicas a motores especializados de respaldo solo cuando la confianza de la herramienta principal caiga por debajo del umbral.
La caída de precisión entre un documento en alfabeto latino y un documento multilingüe no es un fallo de la tecnología, sino una brecha predecible, diagnosticable y en gran medida solucionable. Empiece con la pregunta de diagnóstico, aplique la solución para el escenario que encuentre y reserve la revisión manual para los casos límite donde los modelos de visión actuales aún están aprendiendo. Pruebe con sus propios documentos multilingües y vea qué escenario se aplica a su flujo de trabajo.