日本のPO・請求書照合が想定以上に頻繁に破綻する理由
多くの調達チームが予算化していないコスト
中堅の日本の製造業者は、毎月27日に53件の仕入先請求書を受け取る。経理チームは共有ドライブのフォルダを開く。中には、過去4週間に調達部門からメールで送られてきた47通のPDF発注書、倉庫でスキャンされて誰も名前を付けていないサブフォルダに置かれた31枚の紙の納品書、そして請求書の明細行の約60%に、フォルダのどこかに存在する発注番号が記載されている。残りの40%は、電話、LINEメッセージ、またはすでに退職した上司によって発注された注文を参照している。その後に行われる照合プロセスは、実質3営業日を消費する。誰かが仕事が遅いからではない。同じ取引を記述する3つの文書が、そもそも同じ言語で話すように設計されていないからだ。
重要ポイント
- 経理部門の時間の30%が書類検証に費やされている。そして三点照合が破綻するのは、データが間違っているからではなく、1本のボルトが発注書では「SUS304 M8×30」、納品書では「ステンレスボルト M8」、請求書では「BT-0842」と呼ばれているからだ。
- スプレッドシートは照合問題を解決しなかった。問題を静かにしただけであり、スキップすることを覚えたすべての#N/Aの背後には、実際の価格差異か、同じ品目が互換性のない3つの方法で記述されているかのどちらかが隠れている。
- 3つの文書すべてを、位置ではなく意味によって同一の列に抽出すれば、三点照合は本来あるべき単純な比較になる。毎月まるまる1週間を吸収する照合作業ではなくなる。
3つの書類、1つの取引——そして共有されないデータモデル
三点照合(santen totsugō)は購買業務における普遍的な安全策です。支払いを実行する前に、注文したもの、サプライヤーが納品したもの、そして請求されたものがすべて同じ取引を指していることを確認します。公正取引委員会が所管する下請代金支払遅延等防止法は、2026年の中小受託取引適正化法(通称:取適法)によって強化され、下請事業者に発行されるすべての発注書に、納入場所、支払条件・締日、検査完了日などの特定項目の記載を義務付けており、発注書を取引の法的な基点としています。理論上、照合の流れは「発注書 → 納品書 → 請求書 → 支払い」という直線的です。しかし実際には、形式、タイムライン、名称の3つが衝突する場となります。
核心的な問題は、照合作業が面倒だということではありません。3つの書類はそれぞれ異なるシステム、異なるタイミング、異なる読者を想定して生成され、どれも同じ識別子を使用していないという点にあります。購買管理者は、社内の仕入先マスターに紐づいた構造化フィールドを持つ発注書を、OBIC7やSAP Japanなどの自社ERPで作成します。サプライヤーは、自社の内部製品コードを使用し、数量を手書きした紙の納品書とともに商品を出荷します。2週間後、サプライヤーの請求部門が、多くの場合さらに別のシステム(freeeやMoneyForwardなどのクラウドサービス)から、発注書とも納品書とも文言が一致しない明細行を含む請求書を発行します。3つの書類。1つの取引。3つの互換性のないデータ表現。
日本CFO協会の報告によると、経理部門の作業時間の約30%が書類の確認と照合作業に費やされています。月間200件のサプライヤー注文を処理する購買チームでは、これは毎月約60時間——丸1週間半——に相当し、より良い条件の交渉やサプライヤー関係の管理ではなく、3枚の紙に書かれた3つの数字が同じものを指していると確認する機械的な作業に費やされていることになります。
照合が実際に崩れる箇所 — 4つの失敗モード
三点照合は単一のチェックではありません。個別の比較の連続であり、それぞれが人為的ミスとは無関係の理由で独立して失敗し得ます。その理由を理解することは、症状への対処と構造への対処の違いを生みます。
1. 数量不一致:発注内容と一致しない納品
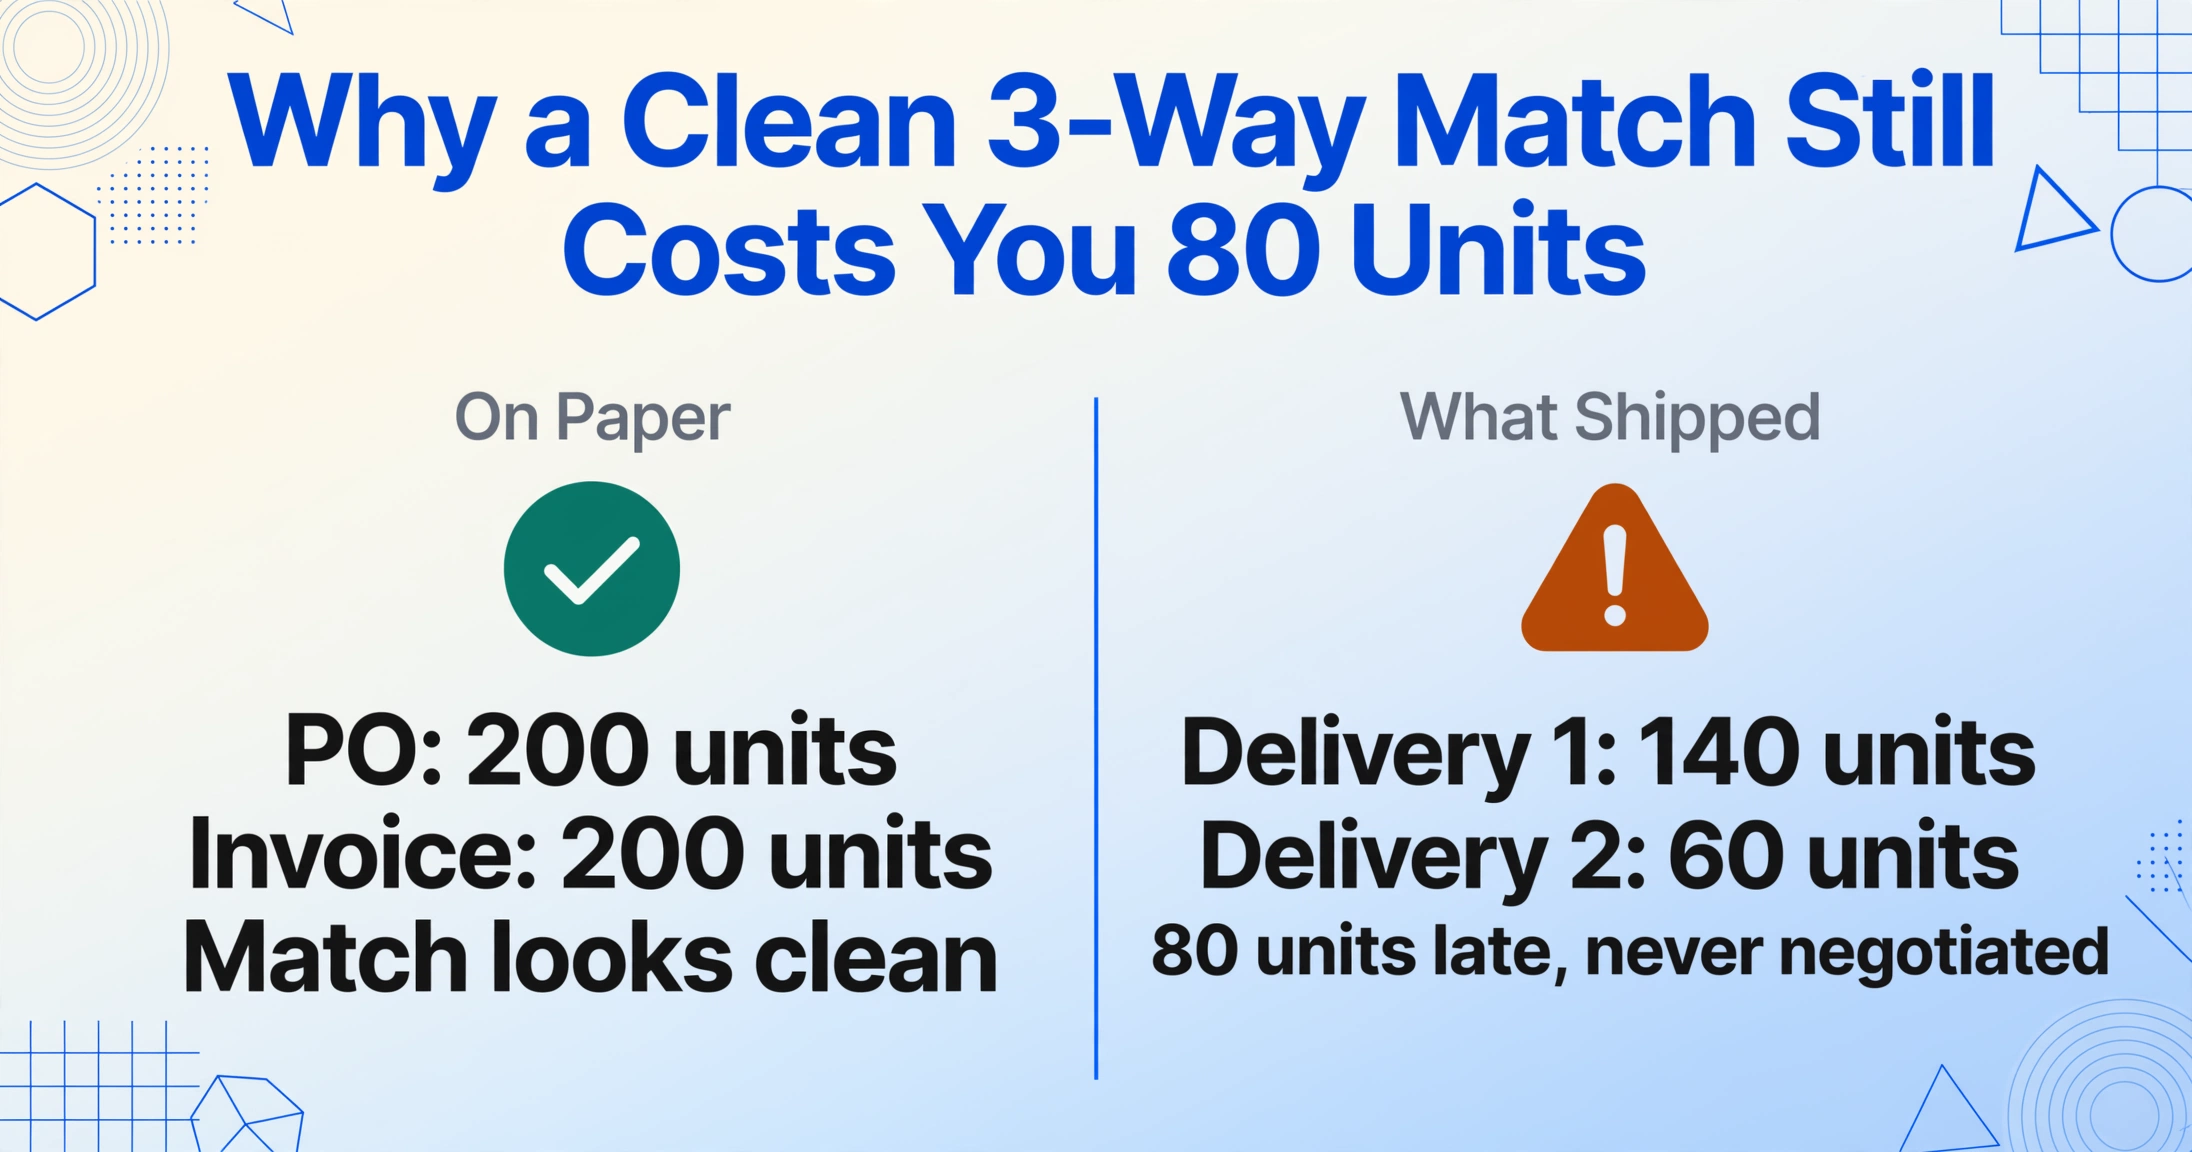
サプライヤーがM10六角ボルト200ユニットの発注書を確認します。最初の納品で140ユニット、2週間後に60ユニットを出荷します。最初の納品書には140と記載されています。2枚目には60と記載されています。2回目の納品後に発行された請求書には200と記載されています。請求書を基に作業する買掛金チームは200ユニットを確認し、発注書の200と照合します。照合は問題なく見えます。しかし、それらのユニットのうち80ユニットはプロジェクトの期限後に到着し、未使用のままとなり、価格調整として交渉されるべきものでした。
分納(部分納品)は、日本の調達における照合エラーの最も一般的な原因です。そして、納品書が梱包箱の中に紙で同梱され、経理ではなく倉庫が管理することで、問題はさらに複雑になります。請求書が買掛金部門に届く頃には、2回の出荷分の納品書は別々のファイルの山に分かれ、異なる解像度でスキャンされ、あるいは単に紛失している可能性があります。照合が失敗するのは、データが間違っているからではなく、データが2つの物理文書に断片化されており、それを接続するシステムが存在しないからです。
2. 消費税率の変更 — 請求書の税率と発注書の税率が異なる場合
日本の消費税は、2019年10月の増税以降、標準税率10%と、食品・飲料に対する軽減税率8%の2段階方式がとられている。適用される税率は、発注日ではなく納品日によって決まる。8%税率の時期に発注書が発行されても、税率が10%に変わった後に商品が納品された場合、請求書は法的に10%税率を反映しなければならない。発注書には依然として8%と記載されている。2つの文書の合計は一致することはなく、その差はエラーではなく税法によるものだ。
税率変更時以外でも、異なる品目に異なる税率が適用される場合 — 事務用品(10%)と包装食品(8%)の混載出荷など — 請求書の合計を発注書の合計と機械的に比較するには、両方の文書を明細行ごとに分解する必要がある。手作業の買掛金チームはこの分解を省略し、合計のみを確認することが多い。その結果、消費税の誤分類は税務調査で指摘されるまで検出されずに通過してしまう。
3. 発注書と請求書で異なる支払条件
日本のB2B支払条件は、正確でありながら誤読されやすい慣行に従っている。締日と支払期間の組み合わせだ。典型的な条件は「20日締め翌月末払い」— 当月20日までの取引を翌月末までに支払う — と読める。発注書には、下請法の要件に従い、この条件が明記されている。しかし、仕入先の請求システムが「10日締め翌々月末払い」をデフォルトとしている場合、締日も支払期間も異なる。仕入先の請求書に記載された支払期日が発注書の条件と一致しない場合、その請求書は技術的に不適合であり、仕入先の記載条件で支払うと、契約上必要な時期より丸1ヶ月早く資金を放出することになりかねない。
支払条件の照合チェックでは、買掛金チームが2つの異なる文書の短いテキスト欄を読み、比較する必要がある。条件が数値ではないため、VLOOKUPでは自動化できない作業だ。実際には、ほとんどの手動照合ワークフローはこのチェックを完全に省略し、数量と合計に焦点を当てている。支払条件の検証を省略すると、中規模メーカーは毎月の買掛金の2〜3%に相当する回避可能な早期資金流出を被ると、日本の中小企業を支援する調達コンサルタントは推定している。その資金は買い手の口座ではなく仕入先の口座に丸1ヶ月留まり、すべての取引で倍増する。
下請法は、買い手がすべての発注書に支払条件を明記することを義務付けており、条件外での支払いは — 意図的でなくても — 公正取引委員会が不適合と解釈し得る監査証跡を作り出す。しかし、この不一致を検出する検証ステップこそ、ほとんどの調達チームが実用的に自動化する手段を持たないステップなのだ。
4. 文書が1つ欠けている場合 — 3点のうち1つが存在しないケース
すべての仕入先取引で、3点の文書が揃うわけではない。電話注文、長年の取引先へのLINEでの連絡、部門責任者が口頭で承認した急ぎの購入 — こうした取引では、発注書が誰かの記憶の中にしか存在しない。日本の中小企業では、発注書の文化は運用というより理想に近い。中小企業庁の2023年の調査によると、10万円未満の中小企業取引の40%以上が正式な発注書なしで行われている。こうした取引の照合は、発注番号が記載されていない納品書と、注文日が記載されているかどうかも不明な請求書から始まる。
文書が1つ欠けている場合、買掛金担当チームは2つの選択肢に直面する。文書の追跡調査をしながら支払いを遅らせるか、2点照合(請求書と納品書、または請求書と発注書のみ)に基づいて承認し、リスクを受け入れるか。ほとんどのチームは後者を選ぶ。過失ではなく、すでに生産ラインに載っている商品の仕入先への支払いを滞らせることを避けるためだ。その結果、社内統制フレームワーク — 3点照合の本来の目的 — は、3つの文書がすべて揃う取引の一部にしか適用されない。
スプレッドシートの罠 — Excelが問題を小さくするのではなく、見えにくくする理由
照合の混乱に対する標準的な対応はスプレッドシートだ。ERPから発注書データをエクスポートする。納品書データを2枚目のシートに手入力する。仕入先のPDFから請求書データをインポートする。発注番号でVLOOKUPを書く。不一致にフラグを立てる。一致したものを承認する。次へ進む。
このワークフローは機能する — 最終的に支払うべき取引のリストが生成されるという意味では。しかし、スプレッドシートは複雑さを吸収するだけで、解決はしないという点で失敗している。発注番号でのVLOOKUPは、3つの文書すべてに同じ発注番号が記載されている場合にのみ機能する。実際には、発注番号フィールドは最も信頼性の高い識別子だが、仕入先の請求システムが発注番号を切り詰めたり、部門コードのプレフィックスを追加したり、倉庫が別のシステムから出荷明細を印刷したために納品書に発注番号が記載されていない場合には、それでも失敗する。
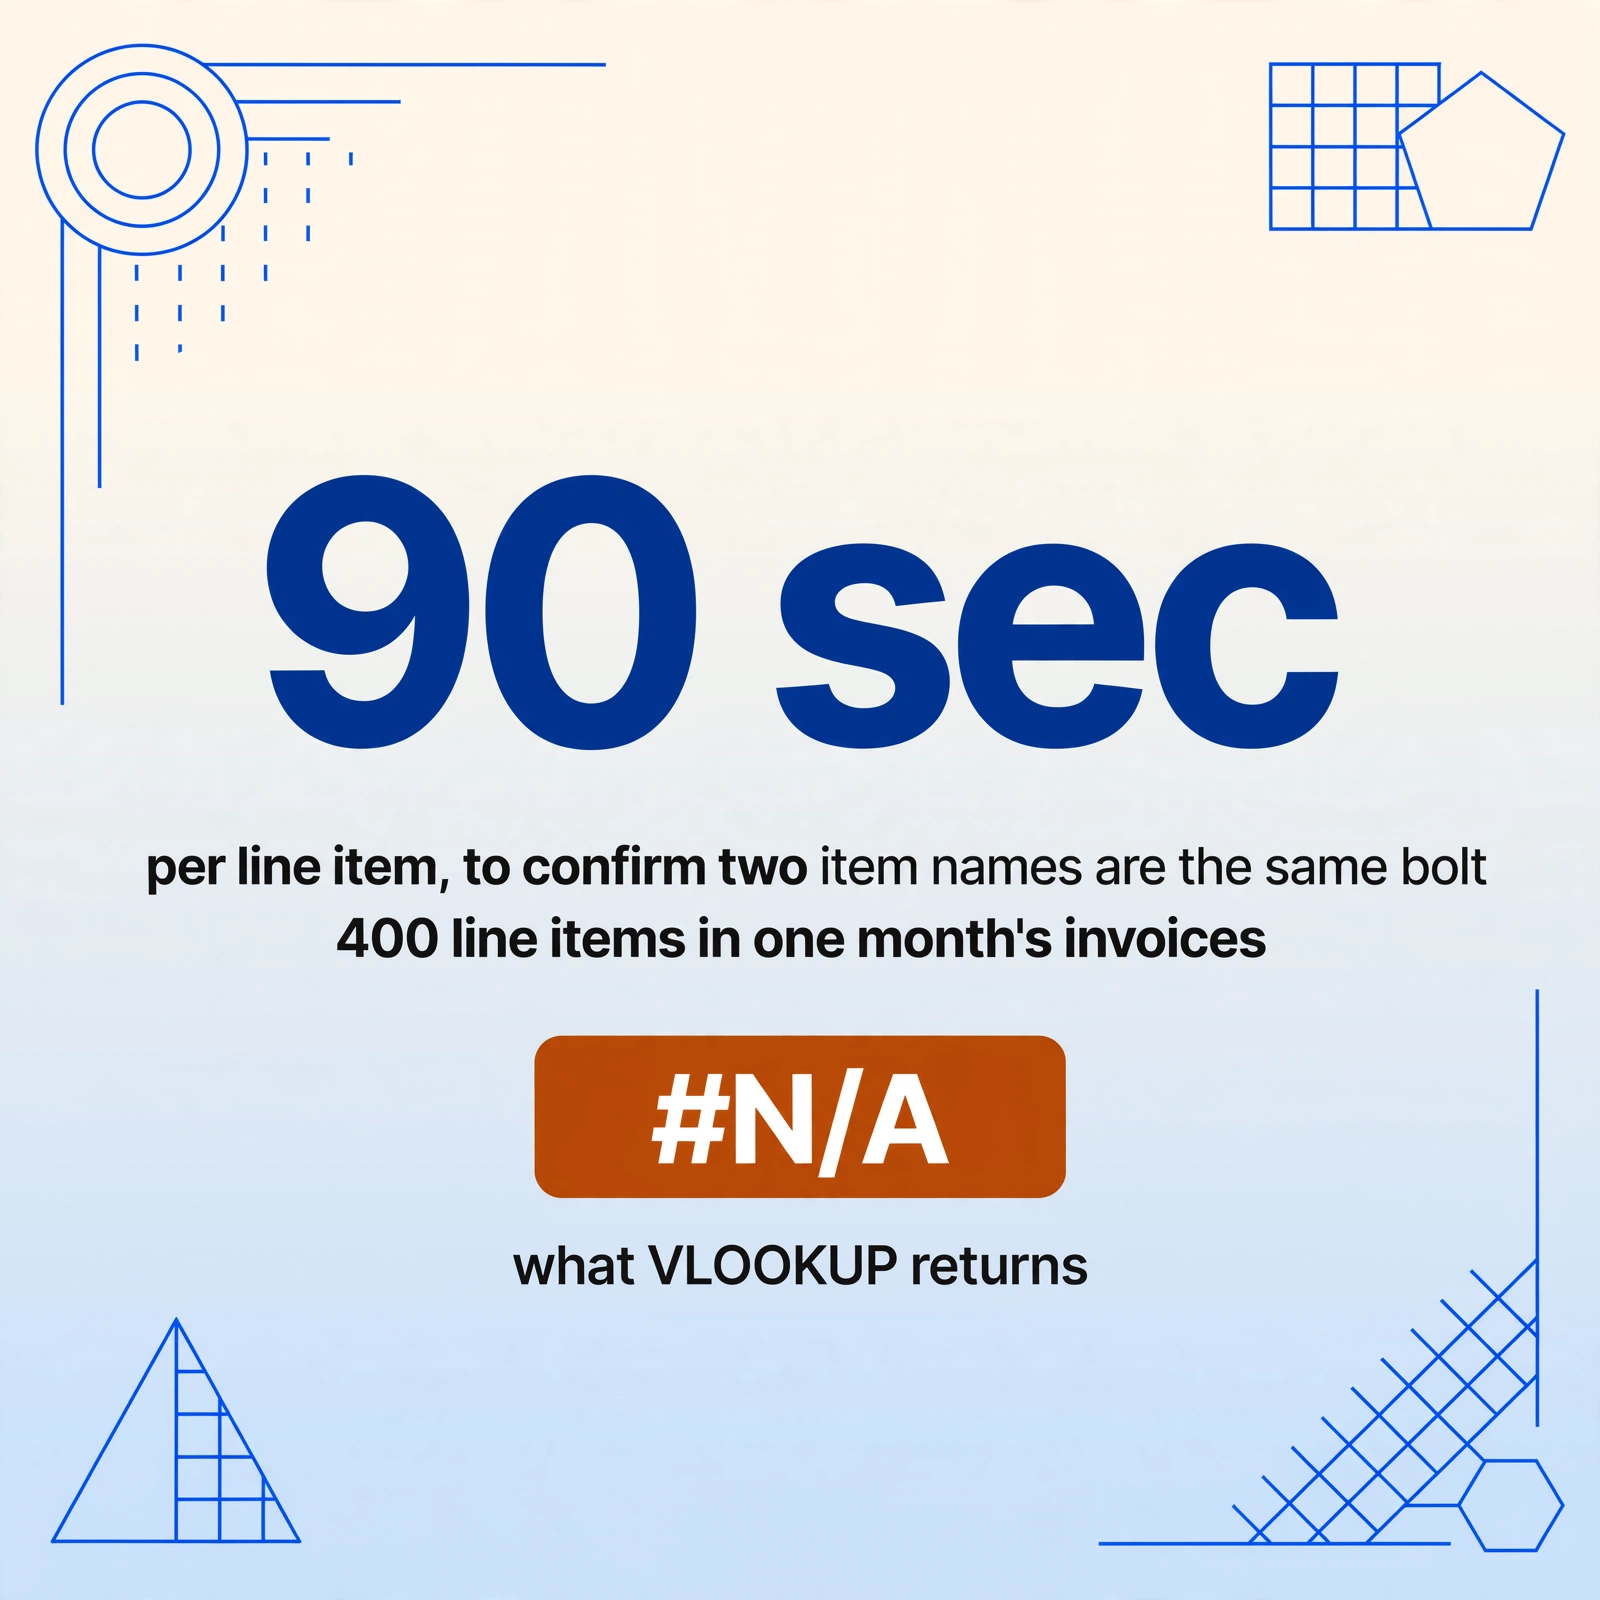
しかし、発注番号は簡単なフィールドだ。本当のスプレッドシートの罠は、品目レベルの照合にある。発注書に「SUS304 M8×30 六角ボルト」と記載されたボルトが、納品書には「ステンレスボルト M8×30」、請求書には「部品コード BT-0842 六角穴付ボルト M8 L=30」と記載されている。3つとも同じ物理的な品目を指している。しかし、テキストとしてはどれも一致しない。VLOOKUPは#N/Aを返し、買掛金担当者は3つの文書を開いて、これらが実際に同じボルトであることを目視で確認する — 1明細あたり90秒かかり、月間の請求書には400明細ある。
ファイルは安全に処理され、保存されることはありません。
スプレッドシートは失敗しない。むしろ、照合が完了したとチームに錯覚させてしまう。実際には、すべての#N/Aは、調査が必要な実際の不一致か、命名の不整合による誤った不一致のいずれかを隠している。時間の経過とともに、チームは照合基準を緩めることで適応する。発注番号と合計金額で照合し、明細チェックを省略し、大きな差異のみにフラグを立てる。この適応は合理的である。代替案は未処理の請求書の無限のキューだからだ。しかし、これは実質的に三点照合が1.5点照合に格下げされたことを意味し、ACFEの推定では、組織は年間収益の約5%を不正行為で失っており、その多くは脆弱な請求書管理を通過している。
発注書データをスプレッドシートに取り込む方法の詳細な手順については、日本の発注書データをExcelに抽出するガイドを参照してください。このハブ記事では、発注書の項目別の構造と、各項目を構造化された行に変換する方法を説明しています。バッチ処理の対応については、50社の仕入先発注書を単一の調達ダッシュボードにバッチ処理するで、照合を毎月の雑務から構造的なボトルネックに変えるスケーリングの側面を取り上げています。また、データがスプレッドシートに入った後の完全なExcel照合ワークフロー(XLOOKUP結合と分納追跡)については、製造業における仕入先請求書と発注書の照合ガイドを参照してください。
意味的抽出が照合の方程式を変える理由
スプレッドシートのアプローチは、データがすでに構造化されていることを前提としている。「発注番号」「品名」「単価」がデータベース上にきれいなフィールドとして存在しているという前提である。しかし実際の出発点は3つのPDFであり、場合によっては紙の納品書のスキャン画像も含まれ、それぞれが独自のレイアウトと語彙を持っている。照合を行う前に、誰かがそれらのPDFを行と列に変換しなければならない。ボトルネックは実際にはこの変換ステップに存在する。
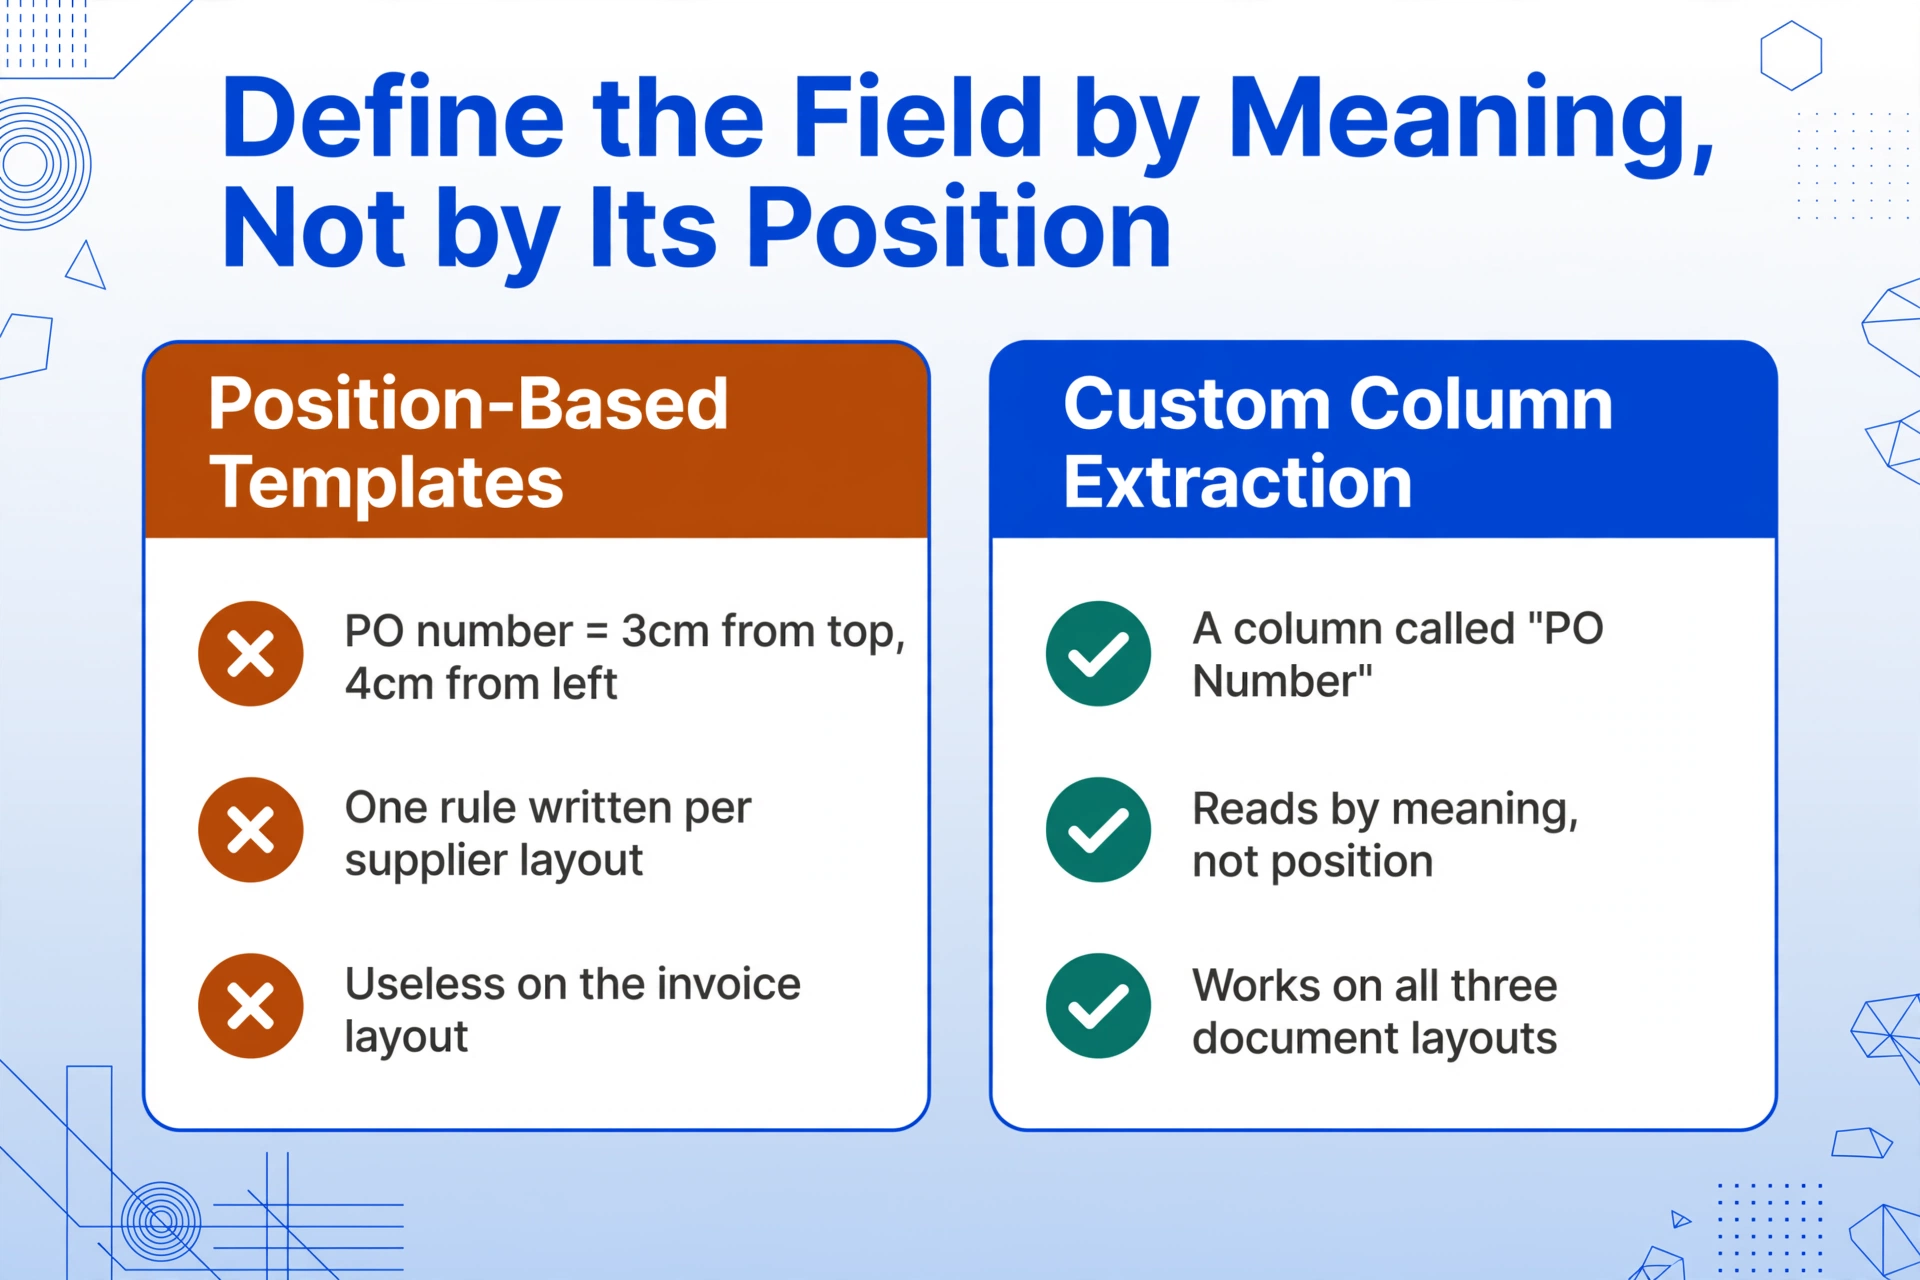
従来のOCRツールは、ページ上の各フィールドの位置を特定することで変換を試みる。「発注番号は上から3cm、左から4cm」というように。これはサプライヤーごとのフォーマットに定義する必要があるゾーンテンプレートか、レイアウトが変わると破綻するルールベースのパーサーを用いる。このアプローチは構造的な理由で照合問題に失敗する。3つの文書は完全に異なるレイアウトを持つからだ。発注番号は発注書PDFのヘッダーボックスにあり、納品書にはまったく存在しない可能性があり、請求書では参照番号フィールドに存在する。発注書レイアウト用に書かれた位置ベースの抽出ルールは、請求書レイアウトには役に立たない。
意味的抽出 — カスタム列抽出が可能にするアプローチ — は論理を逆転させる。各文書のフィールドがどこにあるかを定義する代わりに、何を欲しいかを定義する。「発注番号」という列、「品名」という列、「数量」という列を定義する。AIは各文書を読み取り、値の意味を理解して位置を特定する。ページ上のどこに現れるか、どのようにラベル付けされているかは関係ない。発注番号が枠付きヘッダーにあるFAX送信された発注書も、「ご注文番号」フィールドに同じ番号が現れるPDF請求書も、同じ列を返す。AIが座標ではなく意味で照合しているからだ。
これにより照合ワークフローは「3つの文書を3つの異なるスプレッドシートに変換してから照合する」から「3つの文書すべてを同じ列構造に抽出してから比較する」へと変わる。比較ステップは真のスプレッドシート操作になる。各文書が何を意味しているかを理解したAIによって列が生成されたため、発注番号列のルックアップが実際に一致を返す。人間が各文書の内容を書き写した場合とは異なる。
この同じ構造的問題 — 同じ財務的現実を記述しているが互換性のない形式を持つ文書間での手動照合 — は、日本以外の文脈でも現れる。我々のオーストラリアのBAS申告における手動照合問題の分析では、四半期ごとのGSTデータを銀行明細書、請求書、ATOフォームの間で照合する必要がある際に、中小企業が類似の課題に直面することを検証している。これはまた、製造業の買掛金における三点照合の失敗率を世界的に押し上げる同じ要因でもある。三点照合が製造業の買掛金にチームが認める以上に悪影響を与える理由を参照されたい。
よくある質問
三点照合とは何ですか。また、日本の購買業務でなぜ必要ですか。
三点照合は、発注書、納品書、請求書を照合し、発注、納品、請求のすべてが同一の取引であることを確認します。公正取引委員会の下請代金支払遅延等防止法では、下請事業者に発行するすべての発注書に特定の項目の記載が義務付けられており、この照合プロセスは、過払い、二重払い、未納品の支払いを防ぐための重要な内部統制です。
データが正しいのに、発注書と請求書の照合が失敗するのはなぜですか。
書類によって、同じ品目に異なる識別子が使用されているためです。例えば、一本のステンレスボルトが、発注書では「SUS304 M8×30」、納品書では「ステンレスボルト M8」、請求書では「BT-0842」と記載されている場合があります。データ自体は正しく、すべて同じ物理的な品目を指していますが、VLOOKUPのようなテキストベースの照合ツールでは、文字列が異なるため不一致と判定されます。分納、消費税率の違い、支払条件の不一致がこの問題をさらに複雑にしています。
仕入先の書式を変更せずに、三点照合を自動化できますか。
はい。重要なのは、位置ではなく意味に基づいてデータを抽出することです。抽出エンジンが「発注番号を取得」「品目名を取得」という列定義を読み取ると、レイアウトやラベルに関係なく、各書類から該当する値を検索します。仕入先は既存の書式をそのまま使い続けることができ、抽出ステップで出力を一貫した列構造に正規化し、その正規化されたデータに基づいて照合が行われます。
3つの書類のうち1つが欠けている場合はどうなりますか。
これは実際には最も一般的なシナリオです。電話注文、LINEメッセージ、口頭での承認などにより、正式な発注書なしで取引が発生します。書類が不足している場合、多くの買掛金部門はデフォルトで2者間照合(請求書と納品書、または請求書と発注書)を行います。これは迅速ですが、検証の層が一つ減ります。最善の対策は、書類作成のハードルを可能な限り低くすることです。購買管理者が手書きの注文メモをスキャンし、正式な発注書と同じ構造化された形式に抽出できれば、正式なプロセスを経ていなくても証跡が残ります。
消費税だけが税関連の照合問題ですか?
消費税は、複数税率(10%標準、8%軽減税率)が適用されるため、1枚の請求書に異なる税率の品目が含まれることがあり、税関連の不一致の最も一般的な原因です。しかし、これだけではありません。輸入取引では、発注書には記載されないものの、船積書類に現れる関税が発生します。日本企業のグローバルサプライチェーン内での国境を越えた取引では、移転価格調整が行われ、元の発注書に対応する明細がないまま請求書の合計額に影響を与えることがあります。
これはエンタープライズERPシステムが既に処理しているものとどう違うのですか?
SAP JapanやOBIC7などのエンタープライズERPは三点照合モジュールを提供していますが、照合が行われる前にデータがシステム内にあることが必要です。ギャップはデータ入力の段階にあります。SAPの照合エンジンは、メールの受信箱にPDFとして保存された請求書を照合することはできません。ERPは比較を自動化しますが、非構造化文書からの抽出は自動化しません。既にERPを導入している企業にとって、ボトルネックは照合モジュールの上流、つまり納品書と請求書のデータを最初にERPに取り込む段階にあります。
構造的な洞察は、照合が失敗するのは比較が難しいからではなく、データが比較エンジンが読み取れない形式で届くからだということです。形式変換のステップを修正すれば、照合ステップはERPが本来実行するように設計された単純な操作になります。