銀行フィード開始前のXero期間は、
依然としてCSV作業です
銀行口座をXeroに接続すると、フィードはその日以降の取引のダウンロードを開始します。接続前の月は遅れているのではなく、そもそも要求されていなかったのです。クライアントの帳簿を遡って整える簿記担当者にとって、その固定された期間の履歴は明細書PDFからしか得られず、それらのPDFをXeroが実際に受け付けるファイルに変換する作業こそが、多くのインポートガイドが省略しているステップです。
重要ポイント
- 銀行フィードがスキップした月は、あなたが引き起こした失敗ではありません。フィードは接続した日に開始され、それ以前の分はそもそも要求されていなかったのです。
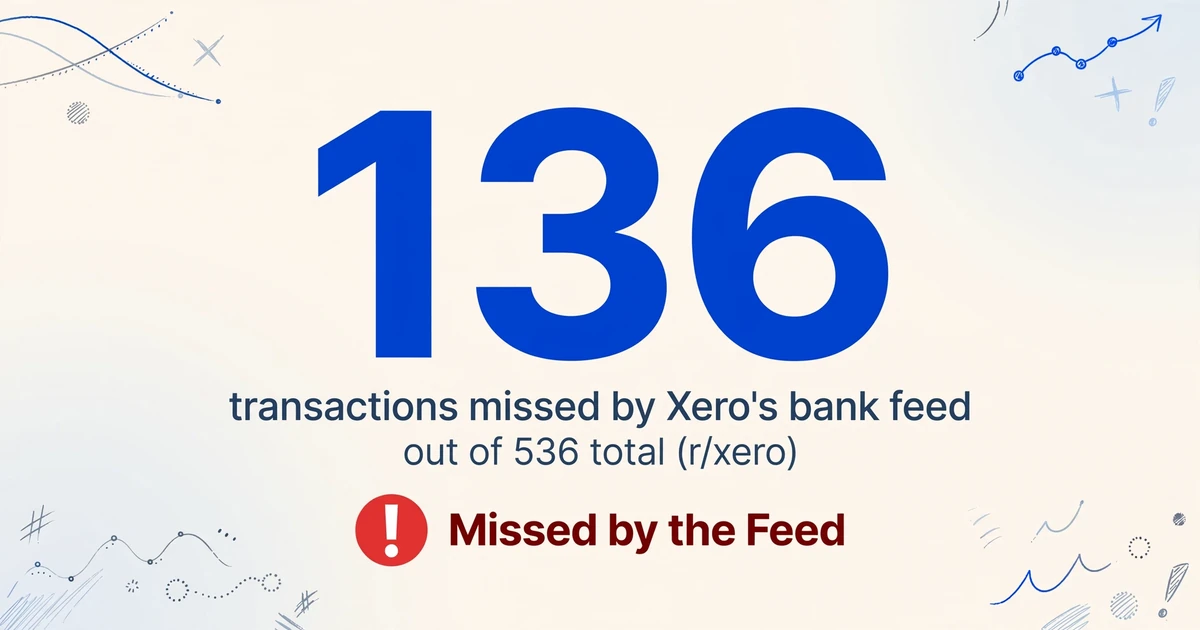
- ある会計士は、クライアントの取引536件のうち136件が、フィードが対象とする期間外だったためにスキップされるのを目の当たりにしました。
- したがって、解決策は、フィードの最初の行がどこにあるかを確認し、Xeroが期待する列名を設定し、古い明細書をインポート可能な1つのCSVに統合することです。
銀行フィードは現在を記録し、過去を静かにスキップする
銀行フィードが答えられる質問は一つだけです。この口座に最近何が入金されたか。口座を接続すると、Xeroは銀行に提供可能な履歴を要求しますが、ほとんどの銀行は過去に遡りません。Intuitも自社製品で同じ制限を明示しており、この動作はフィード全体で標準的です。接続はライブパイプであり、アーカイブではありません。口座接続前に発生した取引は、誰も要求していないため配信されなかったのです。
フィードは口座が開設された日ではなく、接続した日から始まります。その接続前の月はすべてフィードから見えず、何度更新をクリックしても変わりません。
簿記担当者はこの結果を常に目にします。r/xeroでは、ある会計士が、数百件の取引があるクライアントの口座で、フィードが古い取引を単に見ていなかったことを報告しています。「Xeroの銀行フィードは536件の取引のうち136件を見逃しました。90日を超える過去データを見ているため、Xeroは関知しないのです。」その口座で何かが壊れているわけではありません。フィードはフィードとしての役割を正確に果たしているのです。
同じようなギャップを生む要因が他に3つあります。保留中の取引は、銀行が決済するまで表示されません。切断後に再承認されたフィードは、その間の期間を落としたりスキップしたりすることがあります。閉鎖または置き換えられた口座はフィードが完全に停止し、その履歴は明細書の中に残ります。これらの中で実際の故障は1つだけです。残りはライブ接続の正常な境界であり、すべて同じ結論に収束します。フィード以前の期間については、明細書が記録なのです。
Xeroクライアントのキャッチアップに実際に必要な作業
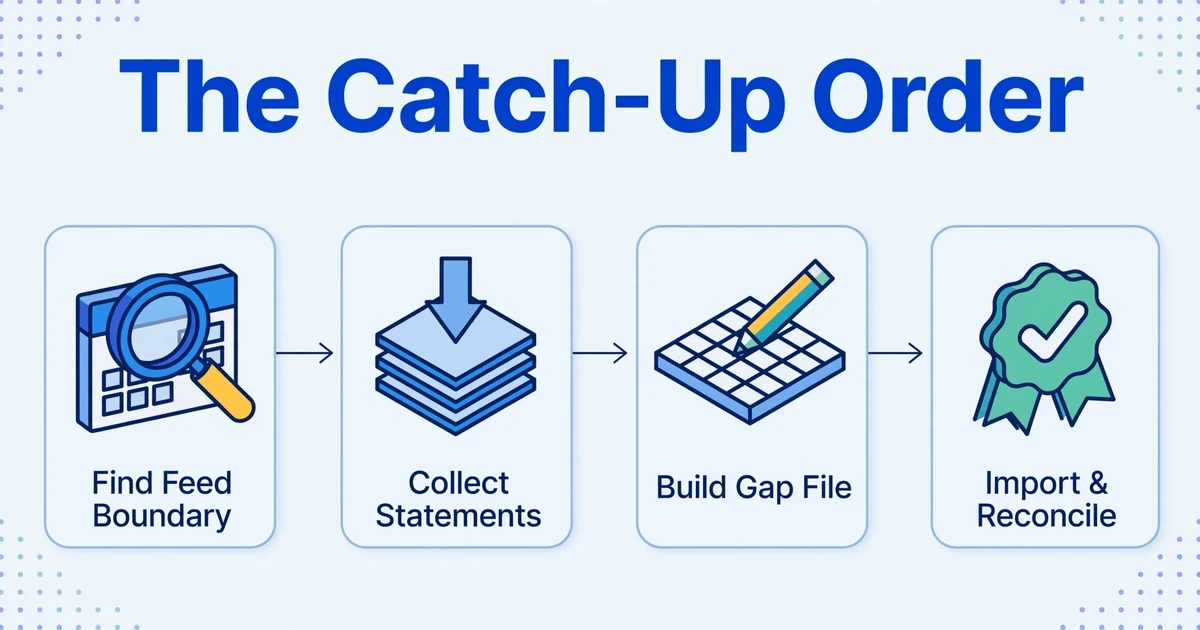
キャッチアップは、開始点と終了点が明確に定まったデータ再構築作業であり、最も重要な判断は、手動履歴がどこで終わり、ライブフィードがどこから始まるかという境界線の設定です。この境界線を誤ると、Xeroがすでに保持している行をインポートすることになり、それが口座に重複が入り込む原因となります。
境界線をクリーンに保つ手順は次のとおりです。
フィードがすでに配信した最古の明細行を見つける
Xeroの銀行口座で、フィードを通じて届いた最初の完全で信頼できる取引を特定します。その日付が境界線となり、手動履歴とライブパイプの引き継ぎポイントにもなります。
履歴を開始したい時点まで、すべての明細書を収集する
各口座について、必要な開始日から境界線の前日までの明細書を集めます。ここでクライアントからの連絡が途絶えることがよくあります。古い書き出しを提供していない銀行や、閉鎖された口座では、PDFしか残っておらず、場合によってはスキャンされたものしかないこともあります。
ギャップ期間のみのインポートファイルを作成する
明細書を、欠落している期間をカバーする単一のファイルに変換し、各取引を1行として扱います。口座ごとに作業を進め、フィードの最初の行より前にファイルが終わるように調整することが、重複を生むオーバーラップを防ぐ方法です。
期間ごとにインポートして照合する
対応するXero銀行口座にインポートし、次の期間に進む前に各月を元の明細書と照合します。照合を随時行うことで、欠落や誤読のある行が、年度末ではなく、その行が属する月に表面化します。
役割の分担も重要です。簿記担当者は境界線とインポートを担当し、クライアントまたは銀行自体が明細書の作成を担当し、銀行は今後も提供する月を担当します。クライアントがクリーンなファイルを入手できない場合、簿記担当者がそれを再構築する必要があります。
これらのいずれも任意の管理業務ではありません。過去の月は法定記録の一部であり、便宜上のものではありません。英国では、HMRCは有限会社に対し、関連する最終会計年度の終了から6年間、事業および会計記録を保持することを義務付けています。元帳の欠落は、事業者が保持する義務のある記録の欠落です。
バックログが単一のXeroアカウントを超える場合、簿記担当者がQuickBooksとXero用に印刷された元帳をデジタル化するか、12か月分の明細書を1つの照合用スプレッドシートにまとめる必要があるときにも、同じ再構築パターンが現れます。ここでの違いは、欠落している期間を定義するものだけです。年度末ではなく、フィードの接続日です。
ギャップがプロセスを壊す箇所
明細書が情報源になると、2つの問題が発生します。1つ目は人的な問題です。明細書を手入力すると遅く、見落としやすいミスが残ります。150行の明細書は数百の入力フィールドに及ぶため、注意深い担当者でも1か月分に誤った金額や入れ替わった日付が残り、それを複数のアカウントにインポートするとエラーがさらに増幅されます。
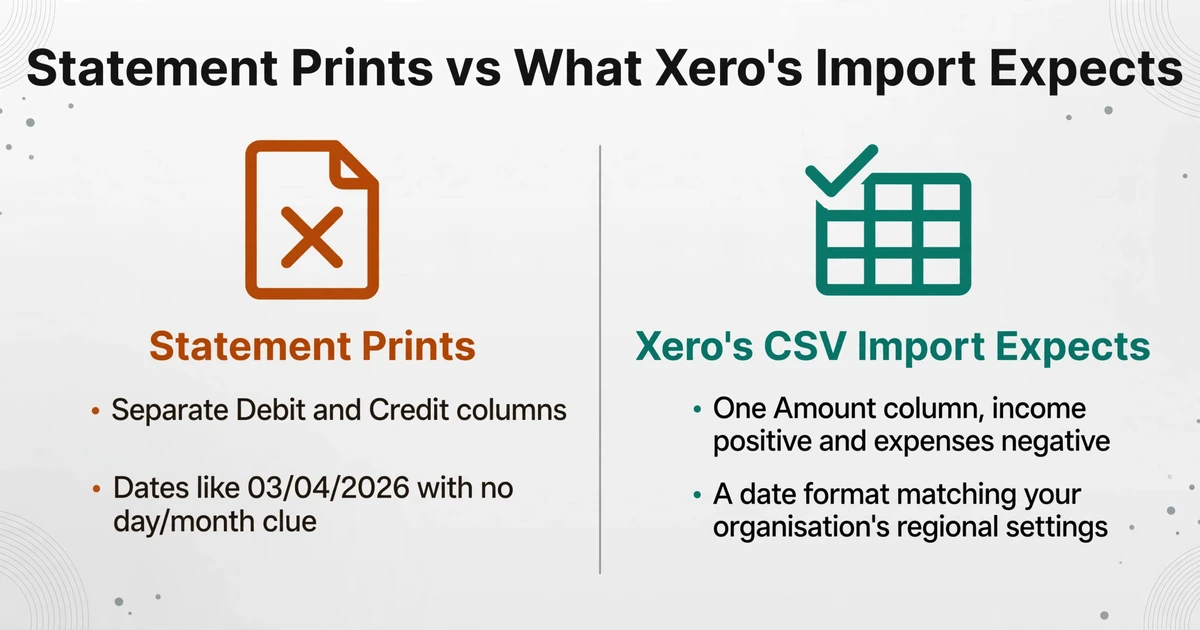
2つ目は形式の問題です。一般的なPDFからCSVへの変換ツールは見えたものをそのままコピーしますが、見えたものはXeroのインポートが求めるものとほとんど一致しません。Xeroの公式インポートガイドは特定の形式を定めています。日付と金額が必須フィールドで、収入と支出は1つの金額列にまとめ、支出はマイナスで表示し、小数点のカンマは使用不可、説明列はXero内ではParticularsの下に配置されます。明細書をそのまま反映する変換ツールは、Xeroが1つを求めるのに2つの金額列を生成したり、通貨記号や桁区切り記号を含むテキスト形式の金額を生成したりします。
| 明細書に印刷されることが多い内容 | XeroのCSVインポートが期待する内容 |
|---|---|
| 借方と貸方の列が分かれている | 1つの金額列で、収入はプラス、支出はマイナス |
| 03/04/2026のような日付で日付か月かの手がかりがない | 組織の地域設定に一致する日付形式 |
$1,234.56のような金額 | 数字のみで、通貨記号や桁区切り記号なし |
| Xeroの取引先に近いが完全には一致しない支払先名 | 正確な取引先名。そうでないとXeroが重複した取引先を作成する |
| 期首残高と期末残高の行 | 除外する。これらは取引ではない |
境界の問題を加えると全体像が完成します。フィードがすでにカバーしている日付にまで及ぶファイルは重複を生み出し、CSVに対するXeroの重複検出は役立ちますが保証はありません。過去1年分をXeroに取り込む作業は、変換速度よりも、正しい形式で行を生成し、誤った行を除外することにあります。
明細書PDFをXeroが求めるCSVに変換する
フィードが取得できなかった月のデータは、まだ明細書PDFに残っています。これらを1つのテーブルに読み込むことができ、行ごとに手入力する必要はありません。この仕組みには名前があり、従来のコンバーターが使うテンプレートOCRとは異なります。それがCustom Column Extractionです。必要なフィールド名を入力すると、AIが固定レイアウトの照合ではなく意味を理解して、ページ上のどこからでも各値を特定します。入力した名前がそのまま出力ファイルのヘッダー行になり、Xeroのインポートマッピングに結果が対応し、匿名の列として届くことがありません。
Xeroが認識する列名を指定します。銀行明細書の場合、有効なセットはDate、Amount、Payee、Description、Referenceです。DescriptionはXero内ではParticularsとして表示され、Payeeは取引先のマッチングに使われるため、銀行の記述をファイルに残しておくと、後の照合が速くなります。Amount列を1つ指定すると、抽出が明細書の借方と貸方の位置を読み取り、Xeroが求める符号付きの単一値にまとめます。元の明細書が借方と貸方を2つの列で印刷しており、確認までそのまま保持したい場合は、代わりにそれらの列名を指定してください。
数値をインポート形式に整えることは、読み取りとは別のステップであり、手作業による修正のほとんどがここで発生します。日付は印刷されたままコピーされるのではなく、抽出時に標準化されるため、インポート段階で確認した形式に列が一致し、曖昧な表記のままになることはありません。金額は通貨記号や桁区切り記号が除去された実数として出力されます。借方と貸方は、Xeroが要求する符号付きの単一列に解決されます。計算列を使えば、スプレッドシートで行うはずだった計算(抽出された数値からの値の導出など)を実行できるため、ファイルは抽出時点で正しい形に整います。
明細書はバッチで届くため、処理もバッチ形式であるべきです。Batch processingとは、全アカウントの全明細書を一度にアップロードし、結果を1つのスプレッドシートにマージする方法で、12個のファイルをダウンロードして手作業で積み重ねる必要はありません。1つのアカウントの明細書が複数ページにわたる場合、Multi-Page Mergeがページをそのアカウントの行に統合し、2ページ目が孤立したテーブルにならないようにします。銀行が毎月のPDFでよく使用するパスワード保護付きの明細書は、保存済みパスワードで自動的にロック解除でき、1つずつ開く必要はありません。このすべての出力について明確にしておくべき点は、それがインポート可能なCSVであり、このツールの役割はそこで終わるということです。
ファイルは安全に処理され、保存されることはありません。
抽出そのものの仕組みをステップごとに知りたい場合は、銀行明細書で従来のOCRが失敗する理由と、AI抽出がそれをどう解決するかで解説しています。フィールドレベルの基礎知識は、銀行明細書データ抽出の完全ガイドをご覧ください。仕訳インポートではなく、後で照合するスプレッドシートが目的なら、同じ変換処理がGoogle Sheetsで構築した照合パイプラインに活かせます。また、銀行明細書PDFをインポート可能なCSVに変換するページでは、ファイル形式の詳細を扱っています。
この作業に適したツールの選び方
多くの簿記担当者は、すでに取り込みツールを所有しています。Hubdocは多くのXeroプランに同梱されており、Dextは請求書やレシートを大量に処理する業務で一般的です。どちらも銀行明細書には対応していますが、欠落した期間を再構築するという特定の作業に特化しているわけではありません。したがって、本当の問題はどのブランドを選ぶかではありません。**他人の1年分の履歴をツールに任せる前に、何をテストすべきか**が重要です。この作業を完遂できるツールと、さらなる修正作業を生むだけのツールを分ける要素は4つあります。
| テストすべき点 | ここで結果を左右する理由 |
|---|---|
| 出力にXeroの名前、日付、金額、支払先、説明、参照がすでに含まれているか? | 列がXeroのマッピング方法に合わせてすでに命名されていれば、インポート手順は確認作業になります。そうでない場合は、インポート前に名前の変更と再フォーマットが必要になり、そこで日付や金額のミスが発生しやすくなります。 |
| 明細書を読み直さずに、値をページ上で検証できるか? | 過去のバッチ処理では、まさにここで行の欠落や誤読が隠れがちです。抽出された数値をクリックして、その出典箇所を確認できる機能があれば、全体の再読込がスポットチェックに変わります。 |
| 月単位ではなく、明細書1枚あたりの料金はいくらか? | 複数アカウントの数年間をバックフィルするのは、一定の流れではなく、一時的なボリュームの急増です。ページ単位の課金では長い明細書が高額になり、サブスクリプションはその急増時には割安でも、その後は無駄になる可能性があります。 |
| 変換後、ファイルはどうなるのか? | 銀行記録を預けることになります。ドキュメントが保存されるのか、保持されるのか、何かのトレーニングに使用されるのかは、作業を中止する正当な理由になります。 |
コストの点は具体的です。PDFからCSVへの変換ツールを比較するr/Bookkeepingのスレッドで、あるユーザーがAutoEntryは銀行およびクレジットカード明細書を1ページあたり3クレジットで処理すると指摘しており、長い履歴があるとすぐにコストがかさむと述べています。同じスレッドでは、HubdocとDextも明細書変換を提供しているものの、回避すべきいくつかの不具合があると指摘されています。料金モデルは確かに異なり、どちらが安いかは、ボリュームが一時的なキャッチアップなのか、継続的なフローなのかによって決まります。
データ取り扱いの点が検索を左右します。この作業に適したツールは、ファイルをどう扱うかを明確に示し、検査できないパイプラインに明細書を送り込むことを要求しないものであるべきです。
適切なテストはブランド認知ではありません。Xero形式の列を生成し、ページ上の数値を検証でき、ボリュームの急増に合理的な価格設定をし、保持するデータについて正直であるかどうかです。
最後の基準は最も議論されていませんが、最も有用です。ツールは本来停止すべき場所で停止するかどうかです。明細書の変換とアカウントの照合は異なる作業であり、これらを混同するツールは、元帳が担うべき部分について過剰に約束することになります。手動と自動の明細書入力の計算をコスト面で先に確認したい場合は、月次コスト比較で数値化しています。
この方法でできないこと
実績のある再構築作業では、過大な約束が最も時間を浪費する原因になるため、対応範囲の境界を明確にすることが、機能リストよりも重要です。
Xeroとの連携や転記は行いません
出力はご自身でインポートするCSVです。Xeroへの自動書き込みは一切行われず、明細行が自動作成されることも、仕訳が転記されることもありません。
分類や照合は行いません
取引を勘定科目コードにマッピングし、元帳と照合し、各期間を照合する作業は、お客様とXero側で行っていただくことになります。変換は構造化された行データまでで完了します。
銀行が発行しなくなった明細書は復元できません
銀行が古い明細書を提供しておらず、誰も保管していない場合、抽出できるものはありません。古い明細書は銀行に請求しなければならない場合があり、一部の金融機関では有料となることがあります。
重複部分とロケール設定の管理はお客様側で行います
フィードの最初の行より前でファイルを切り詰める作業は、自動ではなく手動で行う必要があります。また、CSVを開くスプレッドシートやツールは、それぞれ独自の地域設定に基づく日付と小数点の形式を適用します。
FAQ
Xeroの銀行フィードで、口座を接続する前の取引が表示されないのはなぜですか?
フィードは、接続時点以降に銀行が送信するデータのみを配信するためです。口座を初めて接続すると、Xeroは銀行が提供できる範囲の履歴をリクエストしますが、多くの場合それは数か月分だけで、それより古いデータは取得されません。取引が銀行から消えたわけではなく、単にXeroに送信されていないだけなので、明細書からインポートする必要があります。
CSV銀行明細書のインポートで、Xeroに必要な列は何ですか?
日付と金額が必須フィールドで、インポート手順で日付と金額をマッピングする必要があります。収入と支出は1つの金額列にまとめ、支出はマイナスで-30.00または(30.00)のように記入します。受取人、説明、参照、小切手番号は任意ですが推奨されます。説明はXeroでは「明細」として表示され、受取人は既存の取引先と完全に一致させて、重複を作成しないようにする必要があります。
数年分の明細書を1つのファイルでXeroにインポートできますか?
複数の明細書から1つのファイルを作成することは可能ですが、口座ごと、期間ごとにインポートする方が安全で、各月を元の明細書と照合できます。まずすべてのPDFを変換してから時系列順にインポートする方法も、月間の抜けを元帳に反映される前に見つける実用的な方法です。
銀行フィードがすでにカバーしている期間をインポートするとどうなりますか?
重複が発生します。Xeroは照合中に疑わしい重複をいくつかフラグしますが、インポート自体をブロックするわけではないため、安全な方法は、フィードがすでに配信した最古の明細行を見つけ、履歴ファイルがその日付より前に終わるようにすることです。重複が入ってしまった場合は、照合する前に重複する明細書の行を削除してください。
明細書の抽出は、手入力と比べてどの程度正確ですか?
行を抽出すると手入力に伴う入力ミスがなくなりますが、確認の必要性がなくなるわけではありません。抽出した最初と最後の残高を、明細書に印刷された期首残高と期末残高と比較することが、行の欠落や誤読を最も早く見つける方法です。
DextまたはHubdocは過去データのバックフィルを処理してくれますか?
どちらも銀行明細書を処理できますが、主に請求書や領収書を台帳に取り込むことを目的としており、過去期間は明細書の量が一時的に増えるだけで、通常のワークロードとは異なります。どちらもXeroに取引を転記してくれるわけではなく、境界を自分で設定する必要性がなくなるわけでもありません。重要なのは、ツールがXeroの列形式を生成できるか、ページ上の数値を検証できるか、長い明細書の連続を妥当なコストで処理できるかです。
明細書から再構築する目的は、フィードを実際よりも完全に見せることではありません。ライブ接続は常に一定の期間しか表示されないことを受け入れ、フィードがカバーしなかった月を、最初から最後まで記録している唯一のドキュメントで埋めることです。フィードは現在を処理し続け、明細書は過去を確定させます。
フィードがスキップした月の明細書を集め、Xeroが期待する列に名前を付け、フォルダ全体を1つのインポート可能なCSVに変換します。ご自身の明細書でどのように機能するかをご確認ください。