銀行明細データ抽出の完全ガイド
(2026年版)
銀行明細データ抽出とは、複数ページにわたるPDF明細書(場合によっては10〜15ページ、アカウントの月間取引全体に及ぶ数百行の取引明細)を、日付、説明、借方、貸方、累積残高のすべてがそれぞれの列に1行ずつ並ぶ構造化されたスプレッドシートに変換し、照合にすぐ使える状態にするプロセスです。 これは請求書抽出と同じカテゴリの問題のように聞こえますが、実際は異なります。請求書は単一ページで独立したフィールドを持つものです。一方、銀行明細は連続した取引台帳であり、各行の累積残高はその上の行に依存しています。1件の取引を見逃したり、1つの列がずれたりすると、明細書全体が照合できなくなります。このガイドでは、銀行明細抽出がほとんどのドキュメント抽出よりも難しい理由、現在利用可能な3つの抽出アプローチ、そして実際に信頼できるデータを生成する方法の選び方について解説します。
重要なポイント
- 1年分の事業用銀行明細(3つの口座にわたる月次PDF12件)の手入力には、簿記担当者が40〜60時間かかります。さらに悪いことに、その1時間ごとに1〜4件のエラーが確実に発生し、照合するまで見つかりません。
- 5ページ目で1件の取引を落とすと、74行目以降のすべての累積残高が静かにずれていきます。スプレッドシート全体は目視チェックを通過しますが、唯一重要な計算が合わなくなります。
- 1つの方程式ですべてを検証できます:期首残高+貸方合計−借方合計=期末残高。スプレッドシートを渡す前にこの計算を実行するツールを選べば、静かに破損した銀行データを送り出すことはもうありません。
銀行明細データ抽出とは何か、そして何が特別なのか
銀行明細抽出とは、PDFやスキャンされた銀行明細から取引レベルのデータ(日付、支払先の説明、借方・貸方の金額、累積残高、小切手番号、口座メタデータ)を自動的に抽出し、Excel、CSV、JSONなどの構造化形式に変換するプロセスです。この概念のより詳しい紹介については、銀行明細抽出とは何か、その仕組みをご覧ください。
銀行明細抽出を他の文書抽出タスクと区別するのは、累積残高の制約です。請求書では、各明細項目は独立しています。AIが「事務用品、$42.50」を見逃しても、他の11の明細項目は正しいままです。しかし銀行明細では、すべての取引行に累積残高が含まれており、これは前の残高に現在の取引を加算または減算したものです。抽出パイプラインが5ページ目の取引#73を見落とした場合、行#74以降のすべての累積残高が正しく抽出されたとしても、すべて誤ってしまいます。明細全体が最も基本的な会計検証に合格しません:期首残高 + 総貸方 − 総借方 = 期末残高?
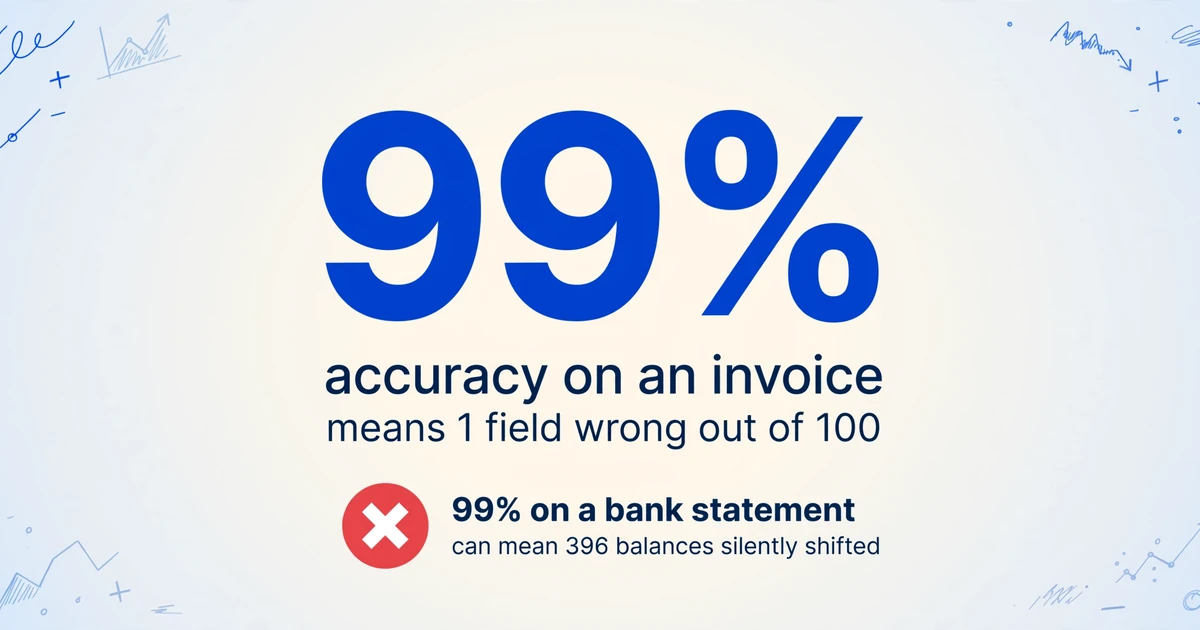
この単一の制約により、銀行明細は自動抽出において最も高い精度要件を持つ文書タイプになります。99%の精度の請求書抽出は100件中1件の誤りを意味し、通常は一目で修正できます。99%の精度の銀行明細抽出は、400行の明細で1件の取引が欠落することを意味し、残りの396件の累積残高がすべて静かにずれてしまう可能性があります。
手動での銀行明細入力がスケールしない理由
ChaseやBank of Americaなどの銀行の12ページに及ぶ事業用当座預金明細書には、簡単に300〜500件の取引が含まれます。経験豊富な簿記担当者でも1時間に80〜100行の入力が限界で、1か月分の明細書だけで3〜5時間かかります。これを12の口座(当座、給与、普通預金、クレジットカード)に掛け合わせると、簿記担当者は毎月1週間を費やし、PDFからQuickBooksやXeroへの数字の入力だけに追われることになります。
コストは人件費だけではありません。手動入力には、訓練を受けたデータ入力スタッフでも1%〜4%の誤り率が記録されており、400行の明細書では4〜16件の誤りが発生します。金額の打ち間違い、1日ずれた日付、説明文の列への誤入力などです。それぞれの誤りが照合の不一致を生み、その発見には当初の入力以上の時間がかかります。簿記担当者は一貫して、データ入力ミスの発見と修正が、入力そのものよりも時間を消費すると報告しています。
速度や誤りを超えた、より深い問題もあります。人間が銀行明細データを入力する場合、明細書を監査可能にする要である累積残高の列は、面倒だからという理由でまったく入力されないか、検証せずに印刷された値をコピーして入力されるかのどちらかです。どちらの方法でも銀行側の誤りは検出できません。すべての累積残高を保持する自動抽出なら、列全体に1つの数式を適用するだけで銀行の計算を検証でき、手動プロセスではスケール規模で到底かなわない精度を実現します。
銀行明細抽出の特有の課題
銀行明細書は、単なる「もう1つの文書タイプ」ではありません。それぞれ単独でも抽出を困難にする4つの課題を併せ持ち、銀行明細書はその4つすべてを同時に抱えているのです。
複数ページにわたる累積残高の連続性
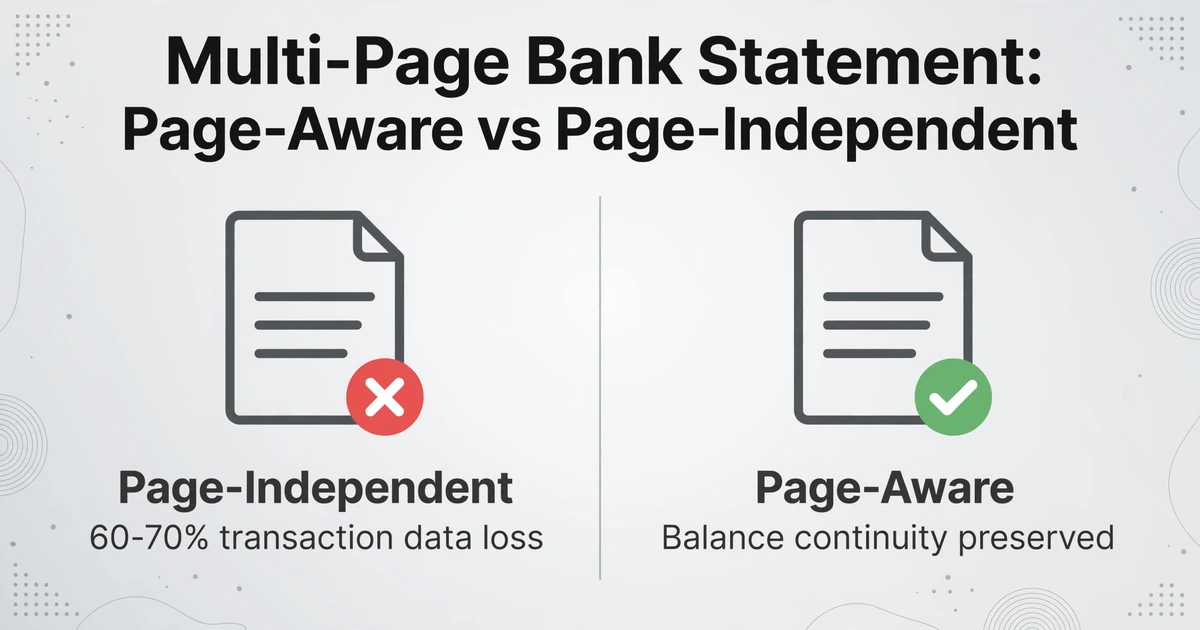
取引テーブルがページ区切りをまたぐ場合、抽出エンジンはテーブルが次のページで最初から始まるのではなく、継続していることを認識する必要があります。これは銀行明細書抽出における最も一般的な失敗モードです。一部のツールは各ページを独立して処理し、3ページ目の最初の取引行を新しいテーブルとして扱うため、2ページ目からの累積残高の連続性が失われます。また、前のページの最後の行を複製するツールもあります。AWS Textract ユーザーは、複数ページの銀行明細書で60〜70%の取引データ損失を報告しています。これは、APIが1ページ目以降でテーブルの抽出を静かに停止するためです。
技術的な要件はページ認識型抽出です。エンジンはページ境界をまたいでテーブルの状態を追跡し、列の整列、残高の連続性、行の順序を、テーブルが15回のページ区切りにまたがる場合でも維持する必要があります。ツールのドキュメントに複数ページの銀行明細書サポートが明示的に記載されていない場合は、機能しないと想定してください。
ImageToTable.ai は、テンプレート設定のマルチページマージでこれを処理します。明細書が複数ページにわたる場合、AIは同じ明細書に属する結果をグループ化し、口座番号などの明細書レベルのフィールドはそれらが存在するページから入力され、その繰り返し情報は出力のすべての行に引き継がれます。ページ間で競合するフィールド値は、設定時に選択したルールに従います。最初の値を保持、最後の値を保持、連結、または別々の行として分割です。ページの断片をエクスポートしてExcelで手動でつなぎ合わせる代わりに、1つの統合された明細書が得られます。
銀行間で根本的に異なるレイアウト
Chase は取引の説明を「DEBIT CARD PURCHASE 04/12 AMAZON.COM ABCD123 REF# 45678」と表示します。Bank of America は「AMAZON.COM*AB12CD3 04/12 PURCHASE 888-555-1234 WA」を使用します。ドイツの Sparkasse の明細書は列を「Buchungstag / Wertstellung / Verwendungszweck / Umsatz」とラベル付けします。フランスのソシエテ・ジェネラルの明細書(relevé de compte)は取引を日付ごとにグループ化し、小計を表示します。英国の Barclays の明細書は借方と貸方を別々の列に分け、米国の明細書とは異なる整列ルールを使用します。
各銀行のレイアウトに解析テンプレートを定義するテンプレートベースの抽出は、この時点で破綻します。中規模の会計事務所は、1か月に30の異なる銀行からの明細書を処理する可能性があります。30の解析テンプレートを作成・維持することは、セットアップコストだけで1年間の手動入力コストを超える可能性があります。ドキュメントを位置ではなく意味的に読み取り、Chase の「Withdrawal」と Bank of America の「Debit」というラベルの列が同じ種類の情報を含むことを理解するAI搭載抽出のみが、少数の銀行フォーマットを超えて拡張できるアプローチです。
小切手番号と複合取引タイプ
小切手番号は特に扱いが難しい項目です。印刷された銀行明細書では、小切手取引が説明欄に「CHECK #1042」のように埋め込まれている場合もあれば、特定の明細書レイアウトにのみ表示される専用の「小切手番号」列に記載される場合もあります。銀行によっては、デジタル明細書に小切手番号をまったく印刷しないところもあります。説明欄を単一のテキストブロックとして処理する抽出エンジンでは、小切手番号を完全に見落としてしまいます。文脈を理解するAIエンジン(説明欄の「CHECK #」の後に続くこの数値は取引金額ではなく小切手番号であると判断する)は、それを専用の列に分離できます。小切手が決済されると、明細書にはほとんど表示されない第二の紙の記録が残ります。受取人とそれが決済する請求書は、小切手画像とその切り取り式控えに記載されており、これは別の小切手送金明細抽出の問題です。
不整合な取引説明
同じAmazonでの購入でも、Chaseの明細書、Bank of Americaの明細書、Capital Oneのクレジットカード、Wells Fargoのビジネス当座預金口座では表示が異なります。同じ銀行内でも、ACH送金、デビットカード購入、電信送金、小切手支払いはそれぞれ異なる説明形式を使用します。取引を分類する必要がある場合(例:「事務用品」「旅費」「光熱費」)、説明が不整合だと、単純なキーワードマッチング(「説明に『Office Depot』が含まれる場合、カテゴリ=『事務用品』」)には、考えられるすべての業者名の表記ゆれに対するルールが必要になります。取引タイプと業者名からカテゴリを推論できるAIは、完全一致の文字列マッチングに頼らず、この継続的なルール保守を排除します。
従来のOCRとAI抽出の比較:銀行明細書に意味理解が必要な理由
従来のOCR(光学文字認識)は、ピクセルを文字に変換することで機能します。スキャンした銀行明細書を読み取り、テキストの文字列を出力しますが、そのテキストの意味は一切理解しません。OCRエンジンは、17行目の4列目にある「$1,247.33」が取引#16以降の累積残高であることを認識しません。そこに文字があることだけを認識します。
OCRを実用的にするには、その上にテンプレートを重ねます。特定の項目が表示されるページ上の領域を定義するのです。「日付列はX=120pxから始まり、幅80pxです」。これは1つの銀行の明細書レイアウトには機能します。しかし、レイアウトが変わるとすぐに機能しなくなります。銀行は定期的に明細書の形式を刷新し、複数の銀行の明細書を処理するからです。
ファイルは安全に処理され、保存されません。
AIを活用した抽出は、根本的に異なるアプローチを取ります。「ページ上のどこに日付の列があるか」ではなく、「このページの何が取引日付のように見えるか」を問いかけます。視覚言語モデルは、人間と同じように文書全体を読み取り、ヘッダーをスキャンして列の意味を特定し、ページをまたいでテーブル構造を追跡し、1列目の「04/12」が日付で、5列目の「$04.12」が金額であることを理解します。この意味ベースの抽出アプローチは、位置を記憶するのではなく意味を理解するものであり、銀行ごとの設定なしで、どの銀行の銀行明細書も処理できる理由です。
ImageToTable.aiはカスタム列抽出を使用します。抽出したい列名(「日付」「説明」「借方」「貸方」「残高」)を入力すると、AIがページ上の位置ではなく意味を理解して各値を特定します。Chaseが来月明細書のレイアウトを変更しても、何も壊れません。これまで見たことのない信用組合の明細書を追加しても、すぐに機能します。テンプレート設定も、トレーニングも、銀行ごとの設定も不要です。
実際の明細書での動作を実践的に確認したい場合は、銀行明細書データをExcelに抽出する手順をご覧ください。また、手入力と自動化のコスト差を比較検討されている場合は、銀行明細書の手入力とAI抽出の比較で、数字を項目ごとに詳しく解説しています。
銀行明細書から抽出する主要フィールド
すべての抽出で全フィールドが必要になるわけではありません。優先度別に整理した、重要なフィールドは以下のとおりです。
| フィールド | 優先度 | 重要な理由 |
|---|---|---|
| 取引日 | 必須 | 取引を時系列に並べます。一部の明細書には取引日と1〜2日異なる入金日(Post Date)があるため、照合にどちらが必要かを把握してください。 |
| 説明 / 支払先 | 必須 | 取引相手を特定します。カテゴリ分類や不正検出に使用されます。銀行間で標準化が最も難しいフィールドです。 |
| 借方金額 | 必須 | 支出です。一部の銀行は単一の金額列に+/−記号を使用し、他の銀行は借方と貸方の列に分けています。抽出エンジンは両方のレイアウトに対応する必要があります。 |
| 貸方金額 | 必須 | 収入です。入金、返金、利息の支払いが該当します。ツールが入金と手数料の返金を区別できない場合、後続のカテゴリ分類が崩れます。 |
| 累積残高 | 必須 | 連続性を確認するフィールドです。期首残高+貸方合計−借方合計=期末残高という検証を可能にするため、すべての行で取得する必要があります。この列が抽出に含まれない場合、出力を検証する機能を失います。 |
| 小切手番号 | 重要 | 小切手の照合に必要です。専用の列に表示される場合も、説明文に埋め込まれている場合もあります。利用可能な場合は、独立した抽出列として含めてください。 |
| 口座番号 | ヘッダー | 明細書レベルのメタデータです。複数の口座の明細書をバッチ処理する際に重要で、各口座の取引を出力で正しくグループ化するためのフィールドです。 |
| 明細期間 | ヘッダー | 明細期間の開始日と終了日です。明細書を月ごとに整理し、期間をまたいだ取引の重複を防ぐために使用されます。 |
| 期首/期末残高 | サマリー | 検証のための端点です。期首残高+貸方合計−借方合計は期末残高と一致する必要があります。この式が成立しない場合、抽出にエラーがあるということです。例外はありません。 |
バッチ処理:明細書1枚からスプレッドシート1つへ
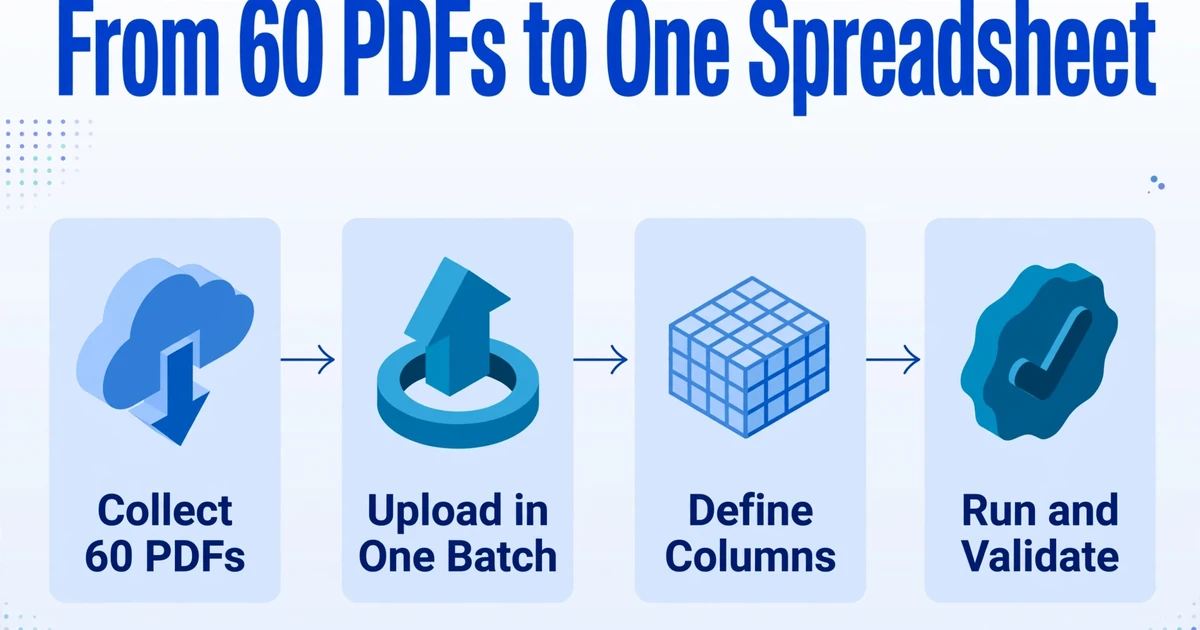
個別の明細書抽出にも価値はあります。しかし、本当の生産性向上はバッチ処理にもたらされます。複数の銀行口座から1年分の月次明細書をアップロードし、全口座・全月のすべての取引が1つの統合テーブルにまとまった単一のスプレッドシートを得ることができます。
年末照合を行う小規模企業における、典型的なバッチワークフローは次のとおりです。
明細書を収集する
照合対象期間の各銀行のオンラインポータルからPDF明細書をダウンロードします。通常は口座ごとに月次明細書12枚です。Chase、BofA、Wells Fargoなど、ほとんどの米国銀行はウェブポータルでPDFダウンロードを提供しています。海外の銀行では、ローカライズされたポータルの操作が必要な場合があります。
1つのバッチでアップロードする
発行銀行やページ数に関係なく、すべてのPDFをアップロードエリアにドラッグします。このツールはPDF、スキャン画像、印刷された明細書のモバイル写真に対応しています。3つの銀行の12か月分、60枚のPDFも1回のアップロードで処理できます。
出力列を定義する
最終的なスプレッドシートに必要な列名を入力します。銀行明細書の場合、標準セットは日付、説明、借方、貸方、残高、および利用可能であれば小切手番号です。入力した列名が出力テーブルのヘッダーになります。
実行して検証する
AIがすべての明細書からすべての取引行を抽出し、単一のテーブルにマージします。出力を信頼する前に、検証を実行してください。期首残高+貸方合計−借方合計=期末残高になるでしょうか?なれば、抽出は完了です。ならなければ、どこを確認すべきか正確にわかります。
エクスポートして照合する
Excelとしてダウンロードし、QuickBooks Online、Xero、またはお使いの会計システムにインポートします。すべての取引が1つの構造化テーブルに含まれていれば、口座ごとにピボットし、日付範囲でフィルタリングし、12枚の個別PDFを相互参照することなく元帳エントリと照合できます。
エクスポートオプションと会計ソフト連携
抽出結果の価値は、それを会計ワークフローに取り込めるかどうかにかかっています。銀行明細書の抽出ツールは、通常3つのエクスポート経路をサポートしています。
Excel(XLSX)ダウンロードは最も汎用的なオプションです。すべての会計プラットフォーム(QuickBooks、Xero、Sage、NetSuite、DATEV、Pennylane)が取引データのExcelインポートに対応しています。ツールがExcelにエクスポートできれば、データをどの会計システムにも取り込めます。CSVも同様に機能しますが、書式が失われ、海外の銀行明細書では文字エンコーディングの問題が発生する可能性があります。
Google Sheetsへの直接連携は、ダウンロードして再インポートする手間を省きます。ImageToTable.aiはGoogle Sheetsのサイドバーアドオンを提供しており、Sheetsから離れることなくアクティブなスプレッドシートにデータを抽出できます。毎月の継続的な照合で、一度きりのエクスポートではなく継続的にワークブックを更新している場合に便利です。
APIおよびウェブフック連携は、より大量のワークフロー向けに利用できます。毎月数百件の明細書を処理する場合、ファイルのアップロードを受け付けて構造化JSONを返すAPIエンドポイントを使えば、抽出結果を会計プラットフォームや融資プラットフォームに直接取り込む自動パイプラインを構築できます。
銀行フィードのギャップ:QuickBooksとXeroは、接続された銀行口座から取引を自動取得する銀行フィードを提供していますが、これらのフィードはIntuitまたはXeroと連携契約を結んでいる銀行のみをカバーしています。中小の地域銀行、信用組合、海外の銀行、レガシー口座はフィードの対象に含まれないことがほとんどです。銀行フィードが機能しない口座については、PDF抽出が明細書からスプレッドシートへの唯一の自動化経路となります。
銀行明細書抽出ツールの選び方
すべての抽出ツールが銀行明細書を同等に処理できるわけではありません。ここでは、一般的な文書抽出ではなく、銀行明細書の抽出に特化して重要な基準を紹介します。
複数ページにわたるテーブルの連続性。これは最も重要な判別基準です。テスト方法:6ページの銀行明細書PDFをアップロードして抽出を実行し、出力で3ページ目の下部の累積残高が4ページ目の1行目の累積残高と一致するか確認してください。ツールがページを独立して処理し、残高がつながらない場合、マーケティングページに何と書いてあっても銀行明細書には適していません。
フォーマット非依存。ツールは事前設定なしでどの銀行の明細書も処理できますか?テンプレートベースのツール(Docparser、Parseur)は銀行のレイアウトごとに解析ルールを定義する必要があります。2〜3行の銀行だけを処理するなら管理可能ですが、15行以上になると実用的ではありません。意味的に抽出するAIベースのツールは、銀行ごとの設定なしでフォーマットの違いに対応できます。
組み込みの照合検証。一部のツールはデータを抽出して渡すだけです。優れたツールには検証チェックが含まれています:期首残高+貸方合計−借方合計=期末残高になるか?答えが「いいえ」の場合、ツールはエクスポート前にフラグを立てるべきです。照合中に差異を発見するのはあなたではなく、ツールの役割です。
バッチ処理とマージ機能。1枚ずつ明細書を処理するのは個人利用には十分です。業務用の簿記では、複数の明細書を1つの出力テーブルにマージするバッチアップロードが必要です。明細書ごとに1つのスプレッドシートファイルを作成するのではありません。マージされた出力には、どの取引がどの銀行口座からのものかを識別できるよう、ソースファイルまたは口座識別子を含める必要があります。
小切手番号の処理。照合ワークフローで決済済み小切手を扱う場合、ツールが専用列または説明フィールドから小切手番号を別のデータ列として抽出できることを確認してください。
これらの基準に沿ったツールの詳細な比較については、2026年 銀行明細書抽出ツールの総合比較をご覧ください。
よくある質問
AIはスキャンまたは撮影された銀行明細書からデータを抽出できますか?
はい。最新のビジョンAIは、スキャンされたPDFや印刷された銀行明細書のスマートフォン写真から、従来のOCRよりも高い精度でデータを読み取ることができます。これは、AIが文脈を理解し、部分的に隠れた文字を推測できるためです。画質は重要です。明るい照明下での鮮明なスマートフォン写真はきれいに抽出されますが、しわくちゃで影のあるサーマル印刷の明細書では数文字失われる可能性があります。抽出エンジンは信頼性の低いフィールドにフラグを立てるため、明細書全体を読み直すことなく、該当箇所を確認できます。
抽出された銀行明細書データが正しいかどうかを確認するにはどうすればよいですか?
最も迅速な検証方法は残高の等式です。期首残高+貸方合計−借方合計=期末残高となります。これが成立すれば、取引レベルのデータは数学的に整合しています。より深く確認するには、ランダムに5〜10件の取引行を元のPDFと照合し、日付、金額、累積残高を比較します。スポットチェックが合格し、残高の等式が成立すれば、抽出結果は照合に十分信頼できます。100.0%完璧な抽出はありませんが、数学的に整合し、スポットチェックに合格した明細書は信頼できます。
明細書が複数ページにわたる場合はどうなりますか?
テーブルは続き、ページごとではなくPDF全体をアップロードします。テンプレート設定でマルチページマージを有効にすると、同じ明細書の結果が1つのレコードにグループ化されます。口座番号やその他の明細書レベルのフィールドは、それらが含まれるページから入力され、取引行は単一の組み立てられたテーブルとしてまとめられます。ページ区切りは、精度の低いツールが取引を落としたり重複させたりする箇所であるため、後で境界行を確認してください。残高の等式で、そのような問題が発生したかどうかをすぐに確認できます。
銀行明細書の抽出は、海外の銀行や英語以外の明細書でも機能しますか?
はい、AIベースの抽出であれば機能します。ドイツのSparkasseの明細書、フランスのソシエテ・ジェネラルのrelevé de compte、日本の銀行取引明細書、米国のChaseの明細書はすべて、日付、説明、金額、残高という同じ基本データモデルを使用しています。多言語ドキュメントでトレーニングされたAIビジョンモデルは、言語に関係なくこれらの構造を認識します。列ヘッダーがドイツ語、フランス語、日本語でも、各列の意味的役割(日付列、借方列、累積残高)は同じです。テンプレートベースのツールは、言語ごとに個別のテンプレートが必要になるため、ここでは苦戦します。
銀行明細書の抽出と銀行フィードの違いは何ですか?
銀行フィード(QuickBooks Bank FeedsやXero Bank Connectionsなど)は、銀行のAPIからリアルタイムで直接取引を取得します。PDFは関与しません。銀行明細書の抽出は、銀行のポータルからダウンロードしたPDF明細書から取引データを読み取ります。銀行フィードは利用可能な場合はより便利ですが、統合契約のある銀行に限定されます。PDF抽出は、明細書を発行するあらゆる銀行(つまりすべての銀行)をカバーします。多くの簿記担当者は、接続されたアカウントにはフィードを、その他にはPDF抽出を使用し、両方を同じ照合ワークブックに統合しています。
AIは銀行明細書の取引を自動的に分類できますか?
部分的に可能です。AIは、加盟店名と金額から取引カテゴリを推測できます。「SHELL OIL 123 MAIN ST」は「自動車/燃料費」に、「ACME PROPERTIES LLCへの毎月$1,247.50」は「家賃」にマッピングされます。ImageToTable.aiの推論列を使用すると、「カテゴリ(オプション:家賃/給与/光熱費/備品/旅費/その他)」のような列を定義でき、AIは抽出中に各取引に最も可能性の高いカテゴリを自動入力します。ただし、分類の精度は取引説明文の品質によって異なります。「ADOBE CREATIVE CLOUD」のような明確なものは、「POS DEBIT 04/12 888-555-1234」よりも確実に分類されます。自動分類の精度は85〜95%と想定し、残りの5〜15%は人間による確認が必要です。
1年分の明細書のバッチ抽出にはどのくらい時間がかかりますか?
月次明細書12件(通常合計50〜150ページ)は、最新のAI抽出エンジンで数分で処理されます。処理速度は1ページあたり約5〜10秒です。アップロードもワークフローの一部です。明細書がすでにPDFとしてパソコンに保存されている場合、アップロードからExcel書き出しまでのバッチ全体がコーヒーブレイク1回分の時間で完了します。同じ量を手入力すると40〜60時間かかることを考えると、ここにROI(投資対効果)があります。
銀行ごとに明細書フォーマット用の別々のテンプレートが必要ですか?
テンプレートベースの抽出ツールの場合、その通りです。銀行ごとの独自レイアウトに対応する解析テンプレートが必要で、銀行が明細書をリニューアルするとテンプレートが使えなくなります。AI搭載のセマンティック抽出の場合、不要です。AIはデータの位置ではなく意味を理解してドキュメントを読み取ります。テンプレート不要の抽出の大きな利点の1つは、セットアップなしでどの銀行のどのフォーマットの明細書でもアップロードできることです。ツールを評価する際、これは6か月後もツールが機能し続けるかを左右する重要な機能です。
銀行明細書抽出ツールはどのファイル形式に対応していますか?
ほとんどのツールはPDF(銀行明細書ダウンロードの標準形式)に加え、JPG、PNG、WebPなどの一般的な画像形式に対応しています。一部のツールは、スキャンしたレガシー明細書用にTIFFにも対応しています。紙の明細書がある場合は、まずスキャンまたは撮影する必要があります。照明が均一な環境でのスマートフォン撮影でも、最新のAIなら抽出可能な結果が得られます。重要な違いは、テキストPDF(銀行ダウンロードの明細書のようにテキストを選択できるもの)とスキャンPDF(紙の画像でOCRが必要なもの)の間にあります。AIベースのツールは両方に対応していますが、OCRのみのツールはスキャンPDFで精度が低下する場合があります。
銀行明細書から全体ではなく特定の取引だけを抽出できますか?
ほとんどの抽出ツールは明細書全体を処理し、すべての取引行を取得します。フィルタリングは抽出後、ExcelやGoogle スプレッドシートで行います。日付範囲、金額範囲、説明文のキーワードで絞り込めます。一部の高度なツールでは、「$500以上の取引のみ抽出」や「借方のみ抽出」などの抽出ルールを定義できますが、ほとんどのユースケースでは、すべてを抽出して後でフィルタリングする方がシンプルで安全です。関連する取引を誤ってスキップするリスクがないからです。
銀行明細の抽出コストは、簿記担当者を雇う場合と比べてどうなのか?
米国のパートタイム簿記担当者は時給25〜40ドルで、データ入力と照合に月20〜40時間を費やす可能性があります。AI抽出ツールは中小企業向けプランで月9〜39ドルで、1年分の明細を数分で処理します。計算は単純です。最も安い簿記の人件費(25ドル/時間×20時間=月500ドル)でも、AI抽出の12〜55倍のコストになります。価値はコスト削減だけではありません。簿記担当者の20時間がデータ入力(分析的価値ゼロ)から分析・アドバイザリー業務(高価値)へと移行することです。自分で帳簿をつけている中小企業の経営者にとって、抽出は毎月の締め作業の中で最も時間がかかり、最も報われない部分を排除します。
銀行明細の抽出は、複数の銀行口座から月に複数の明細を処理する瞬間から、「あれば便利」ではなくなります。期首残高+貸方−借方=期末残高という検証式は、抽出が成功したかどうかを示すだけではありません。そのデータに基づくすべての下流の意思決定(照合、キャッシュフロー分析、税務申告、融資)が、実際に整合性の取れた基盤の上に構築されているかどうかを示します。スプレッドシートを渡す前に計算を検証するツールを選べば、データ自体が正しいかどうかの確認ではなく、データが可能にする意思決定に時間を費やせます。
特定銀行の明細をステップバイステップで抽出する
銀行ごとに明細の形式は異なります。Chaseは借方と貸方を別々の列に分け、HSBC UKは取引タイプコードシステムを追加し、Revolutは通貨ごとに独自の補助元帳を維持しています。以下のガイドでは、各銀行の独自レイアウトに合わせた抽出ワークフローを説明します。
- Wells Fargoの明細をExcelに抽出する:当座預金と普通預金の組み合わせ、「CHECK #1042」という説明、Way2Save送金。
- HSBC UKの明細をExcelに抽出する:Global Moneyの多通貨補助元帳と英国の取引タイプコードシステム。
- NatWestの明細をExcelに抽出する:RBSおよびUlster Bankと共通の6列の当座預金レイアウト。
- Revolutの多通貨明細をExcelに抽出する:GBP、EUR、USDの別々のPDFを、手動の通貨換算なしで1つのワークブックに統合。
- Capital Oneのクレジットカード明細をExcelに抽出する:リワード概要、APR詳細、カテゴリタグ付き取引。
- Chaseのクレジットカード明細をExcelに抽出する:特殊文字を含む加盟店の説明と複数カードの明細バッチ。
特定の銀行の明細書をExcelに変換する
これらのウォークスルーは、各銀行のPDF明細書を構造化されたスプレッドシートの行に変換することに焦点を当てており、一般的な変換ツールがつまずくフォーマットの癖も含めて解説します。
- Chaseの銀行明細書をExcelに変換する:累積残高の検証を含む当座預金・普通預金フォーマット。
- Citibankの明細書をExcelに変換する:ほとんどの抽出ツールを失敗させるAccount Analysisフォーマットも対応。
- Bank of Americaの明細書をExcelに取り込む:個人・法人向け、二列の小切手レイアウトも対応。
- Barclaysの明細書をExcelに変換する:英国の日付形式、残高の表記方法、BACSバッチ入力。
- Lloydsの明細書をExcelに変換する:DD/MM/YYYY形式の日付処理と英国の支払いコード列。
- Monzoの明細書をExcelに変換する:Pots、Coin Jarの端数丸め、Flex分割払い、絵文字で分類された取引。