Os Meses no Xero Antes do Feed Bancário
Ainda São um Trabalho de CSV
Conecte uma conta bancária ao Xero e o feed começa a baixar a partir desse dia em diante. Os meses anteriores à conexão não estão atrasados; eles nunca foram solicitados. Para um contador colocando um cliente em dia, isso deixa um trecho fixo de histórico que só pode vir dos PDFs de extratos, e transformar esses PDFs em um arquivo que o Xero realmente aceite é a etapa que a maioria dos guias de importação ignora.
Principais Conclusões
- Os meses que seu feed bancário pulou não são uma falha que você causou: um feed começa no dia em que você o conecta, e qualquer coisa anterior nunca foi solicitada.
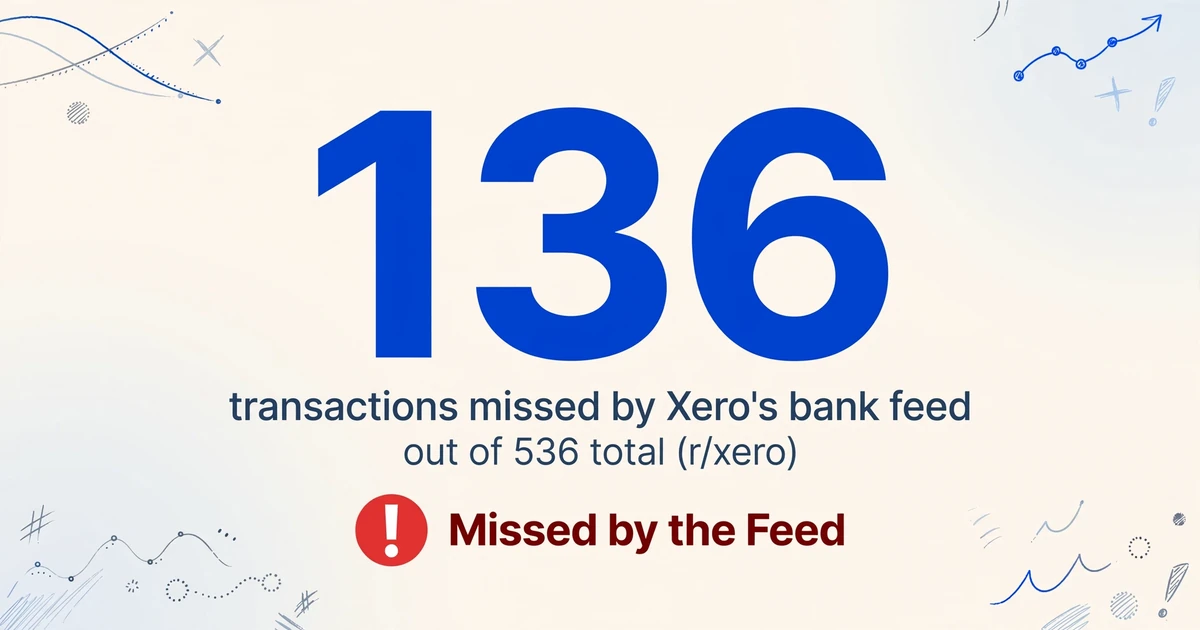
- Um contador viu o feed pular 136 das 536 transações de um cliente simplesmente porque estavam fora da janela que o feed atende.
- Então a solução é encontrar onde está a primeira linha do feed, nomear as colunas que o Xero espera e mesclar os extratos mais antigos em um único CSV pronto para importação.
Um Feed Bancário Registra o Presente e Silenciosamente Ignora o Passado
Um feed bancário responde bem a uma pergunta: o que foi lançado recentemente nesta conta. Ao conectar uma conta, o Xero pede ao banco todo o histórico que ele estiver disposto a fornecer, e a maioria dos bancos não vai muito longe. A Intuit torna essa mesma limitação explícita em seu próprio produto, e o comportamento é padrão entre os feeds: a conexão é um canal ao vivo, não um arquivo. Uma transação lançada antes de a conta ser conectada nunca foi entregue porque ninguém a solicitou.
O feed começa no dia em que você conecta, não no dia em que a conta foi aberta. Cada mês anterior a essa conexão é invisível para ele, não importa quantas vezes você clique em atualizar.
Os contadores veem esse resultado constantemente. No r/xero, um contador descreveu um cliente cuja conta tinha centenas de transações e descobriu que o feed simplesmente não tinha visto as mais antigas: "de 536 transações, o feed bancário do Xero não viu 136 delas, porque estou olhando dados antigos de mais de 90 dias e o Xero não quer saber." Nada está quebrado nessa conta. O feed está fazendo exatamente o que um feed faz.
Outras três coisas criam o mesmo tipo de lacuna. Transações pendentes nunca aparecem até o banco liquidá-las. Um feed que se desconecta e depois é reautorizado pode deixar de fora ou pular um trecho no meio. E uma conta que foi encerrada ou substituída para de alimentar completamente, deixando seu histórico onde os extratos estiverem. Apenas uma dessas é uma falha real. As demais são as bordas normais de uma conexão ao vivo, e todas levam à mesma conclusão: para o período anterior ao feed, o extrato é a fonte.
O que Envolve Colocar um Cliente Xero em Dia
Colocar em dia é um trabalho de reconstrução de dados com início e fim definidos, e a decisão mais importante é onde o histórico manual termina e o feed ao vivo começa. Se você errar esse limite, importará linhas que o Xero já possui, e é assim que duplicatas entram em uma conta.
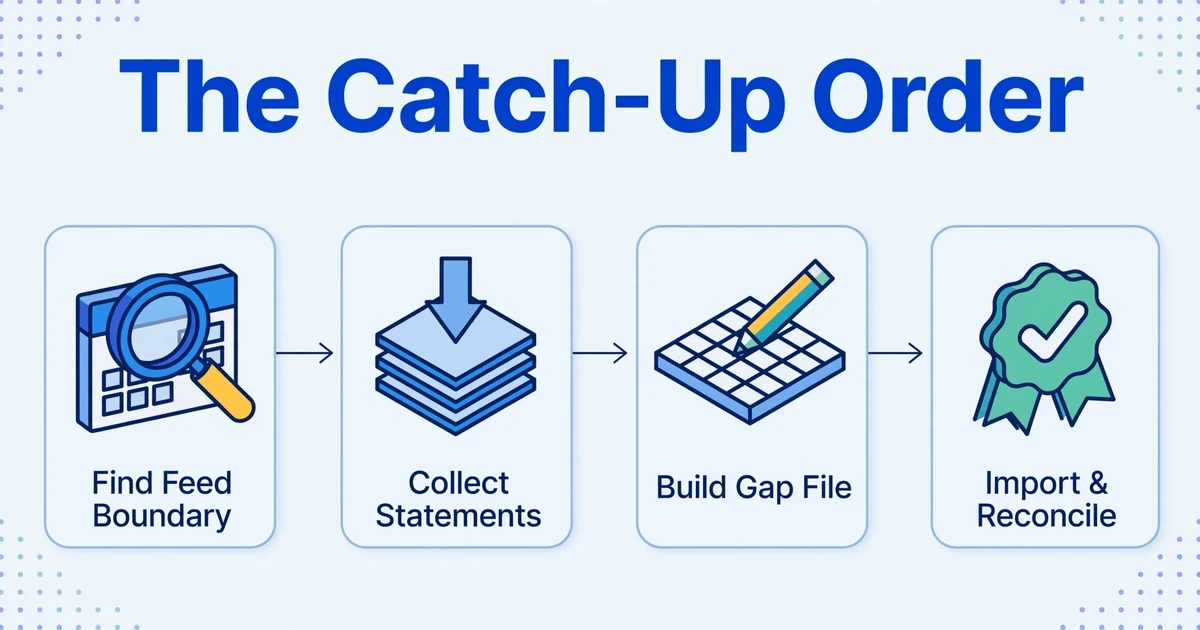
A ordem que mantém o limite limpo é a seguinte:
Encontre a linha mais antiga que o feed já entregou
Na conta bancária do Xero, identifique a primeira transação completa e confiável que veio pelo feed. Essa data é o seu limite, e também é o ponto de transição entre o histórico manual e o fluxo ao vivo.
Colete todos os extratos até onde você precisa que o histórico comece
Reúna os extratos de cada conta desde a data inicial necessária até o dia anterior ao limite. É aqui que os clientes costumam ficar quietos: bancos que não hospedam mais exportações antigas, ou contas que foram encerradas, deixam apenas PDFs, e às vezes digitalizados.
Construa o arquivo de importação apenas para a lacuna
Transforme os extratos em um único arquivo cobrindo o intervalo ausente, com cada transação como uma linha. Trabalhar conta por conta e ajustar o arquivo para que termine antes da primeira linha do feed é o que evita a sobreposição que cria duplicatas.
Importe e concilie período por período
Importe para a conta bancária correspondente no Xero e concilie cada mês com o extrato original antes de passar para o próximo. Conciliar conforme avança é como uma linha ausente ou mal lida aparece no mês a que pertence, em vez de no final do ano.
A divisão de papéis também importa. O contador é responsável pelo limite e pela importação; o cliente, ou o banco diretamente, é responsável por produzir os extratos; o banco é responsável pelos meses que ainda atenderá. Quando um cliente não consegue obter um arquivo limpo, é o contador quem precisa reconstruí-lo.
Nada disso é tarefa opcional. Os meses históricos fazem parte do registro legal, não uma conveniência. No Reino Unido, a HMRC exige que empresas limitadas mantenham registros comerciais e contábeis por seis anos a partir do final do último exercício financeiro a que se referem. Uma lacuna no livro-razão é uma lacuna no registro que a empresa é obrigada a manter.
Se o acúmulo de trabalho for maior do que uma única conta Xero, o mesmo padrão de reconstrução aparece quando um contador precisa digitalizar livros impressos para QuickBooks e Xero ou reunir doze meses de extratos em uma planilha de conciliação. A diferença aqui é apenas o que define o trecho ausente: a data de conexão de um feed em vez de um fim de ano.
Onde a Lacuna Quebra o Processo
Duas coisas dão errado quando os extratos são a fonte. A primeira é humana: digitar um extrato manualmente é lento e deixa erros fáceis de passar despercebidos. Um extrato de 150 linhas gera várias centenas de campos digitados, então um operador cuidadoso ainda deixa valores errados e datas trocadas em um único mês, e importar isso em várias contas agrava os erros.
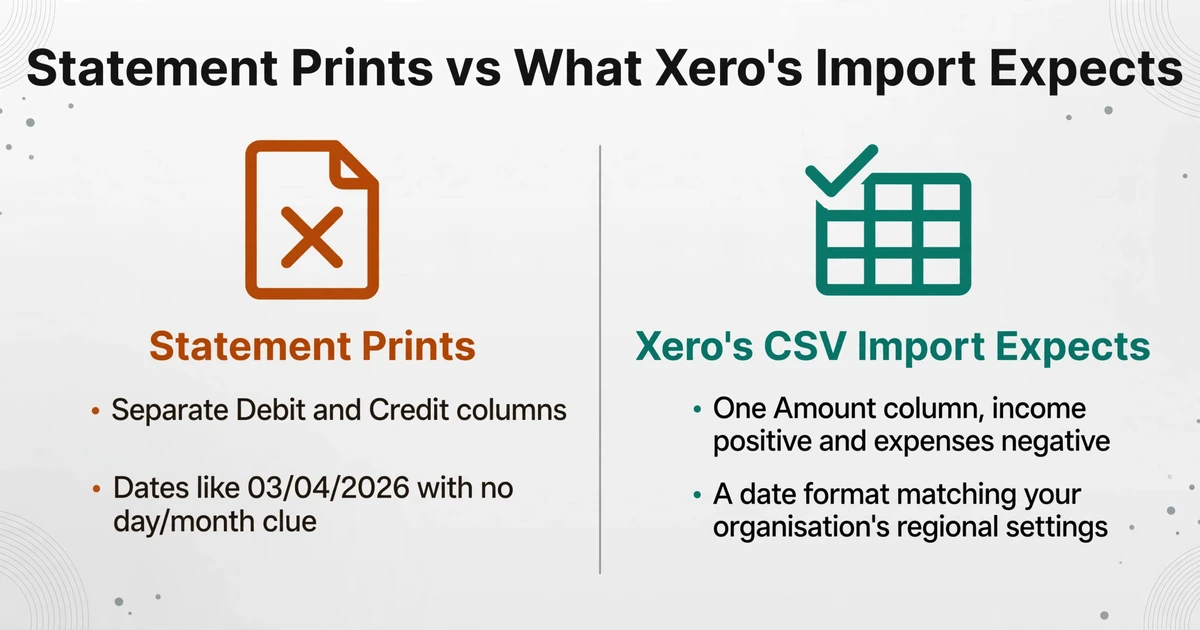
A segunda é o formato. Um conversor genérico de PDF para CSV copia o que vê, e o que ele vê raramente é o que a importação do Xero quer. O guia de importação do próprio Xero define um formato específico: Data e Valor são os campos obrigatórios, receitas e despesas devem ficar em uma única coluna de Valor com despesas negativas, vírgulas decimais não são permitidas, e a coluna Descrição aparece em Particulars dentro do Xero. Um conversor que espelha o extrato em vez do destino entrega duas colunas de valor onde o Xero precisa de uma, ou valores por extenso com símbolos de moeda e separadores de milhar.
| O que o extrato geralmente imprime | O que a importação CSV do Xero espera |
|---|---|
| Colunas separadas de Débito e Crédito | Uma coluna de Valor, receitas positivas e despesas negativas |
| Datas como 03/04/2026 sem indicação de dia/mês | Um formato de data compatível com a configuração regional da sua organização |
Valores como $1.234,56 | Apenas dígitos, sem símbolo de moeda e sem separador de milhar |
| Um nome de beneficiário próximo, mas não exato, ao contato do Xero | O nome exato do contato, ou o Xero cria um contato duplicado |
| Uma linha de saldo inicial e final | Deixadas de fora; não são transações |
Adicione o problema de limite e o quadro está completo. Um arquivo que alcança datas que o feed já cobre produz duplicatas, e a detecção de duplicatas do Xero em um CSV é útil, mas não é uma garantia. O trabalho de colocar um ano histórico no Xero depende menos da velocidade de conversão e mais de produzir linhas no formato certo, mantendo as erradas de fora.
Transformando os PDFs de Extrato no CSV que o Xero Espera
Os meses que o feed nunca viu ainda estão nos PDFs de extrato, e podem ser lidos em uma única tabela em vez de serem digitados linha por linha. O mecanismo que torna isso possível merece ser nomeado, pois não é o mesmo OCR de modelo que os conversores mais antigos usam. É a Extração de Colunas Personalizadas: você digita os nomes dos campos que deseja, e a IA localiza cada valor em qualquer lugar da página entendendo o que ele significa, em vez de corresponder a um layout fixo. Os nomes que você digita se tornam exatamente a linha de cabeçalho do arquivo de saída, o que permite que o resultado se alinhe ao mapeamento de importação do Xero em vez de chegar como colunas anônimas.
Nomeie as colunas que o Xero reconhece. Para um extrato bancário, o conjunto útil é Date, Amount, Payee, Description e Reference. Como Description aparece como Particulars dentro do Xero e Payee direciona a correspondência de contatos, manter a narrativa do banco no arquivo é o que acelera a conciliação depois. Nomeie uma única coluna Amount e a extração lê as posições de débito e crédito do extrato para preencher um único valor com sinal, que é o layout que o Xero exige. Se sua fonte imprimir débito e crédito como duas colunas e você preferir mantê-las até a revisão, nomeie essas em vez disso.
Colocar os números no formato de importação é uma etapa separada da leitura, e é onde a maior parte da limpeza manual costuma acontecer. As datas são padronizadas durante a extração em vez de copiadas como impressas, então a coluna corresponde ao formato que você confirma na etapa de importação, em vez de carregar uma renderização ambígua. Os valores saem como números reais, com símbolos de moeda e separadores de milhar removidos. Débitos e créditos se resolvem na única coluna com sinal que o Xero exige. Uma coluna calculada pode carregar a aritmética que seria feita em uma planilha, como derivar um valor das figuras extraídas, para que o arquivo seja moldado corretamente no ponto da extração em vez de depois.
Os extratos chegam em lotes, então o tratamento também deve ser em formato de lote. O Processamento Prioritário em Lote significa enviar todos os extratos de todas as contas de uma vez e mesclar os resultados em uma única planilha, em vez de baixar doze arquivos e empilhá-los manualmente. Quando o extrato de uma única conta se estende por várias páginas, a mesclagem de várias páginas dobra as páginas de volta nas linhas daquela conta, para que a página dois não vire uma tabela solta. Extratos protegidos por senha, que os bancos usam com frequência em PDFs mensais, podem ser desbloqueados automaticamente com uma senha armazenada, em vez de serem abertos um a um. A saída de tudo isso é o ponto a ser claro: é um CSV pronto para importação, e o trabalho desta ferramenta termina aí.
Os arquivos são processados com segurança e não são armazenados.
Se você quer os detalhes passo a passo da extração em si, eles estão cobertos em por que o OCR tradicional falha em extratos bancários e como a extração por IA corrige isso, e os fundamentos a nível de campo estão em o guia completo para extração de dados de extratos bancários. Se o seu destino é uma planilha que você vai conciliar em vez de uma importação contable, a mesma conversão alimenta um pipeline de conciliação construido em Google Sheets, e a página de conversão para transformar PDFs de extratos bancários em um CSV pronto para importação cobre o formato do arquivo em mais detalhe.
Como Avaliar uma Ferramenta para Esta Tarefa
A maioria dos contadores já possui uma ferramenta de captura. Hubdoc vem incluido em muitos planos de Xero, e Dext é comum em escritórios que processam recibos e faturas em volume. Ambas tocan extratos bancários, mas nenhuna está construida em torno da tarefa específica de reconstruir um período faltante, então a verdadeira questão não é qual marca escolher. É o que testar antes de confiar a uma ferramenta um ano de histórico de outra pessoa. Quatro coisas separan uma ferramenta que termina esta tarefa de uma que cria uma segunda limpieza.
| O que testar | Por que decide o resultado aqui |
|---|---|
| A saída já carrega os nomes de Xero, Date, Amount, Payee, Description, Reference? | Se as colunas já estão nomeadas do jeito que Xero as mapea, o passo de importação é uma confirmação. Se não, você renomea e reformatea antes de importar, que é onde se introducen erros de data e montante. |
| Puede verificar um valor contra a página sem reler o extrato? | Um lote histórico é exatamente onde uma linha perdida ou mal lida se esconde. Poder clicar em uma cifra extraída e ver o lugar de onde veio transforma uma releitura completa em uma verificação por muestreo. |
| O que cobra por extrato, não por mês? | Completar vários anos em várias contas é uma explosão de volume, não um goteo constante. A medição por página faz um extrato longo caro; uma assinatura pode ser mais barata para a explosão e desperdiciada depois. |
| O que acontece com o arquivo depois da conversão? | Você está entregando registros bancários. Se o documento é armazenado, retenido ou usado para treinar algo é uma razão legítima para irse. |
O ponto de custo é concreto. Em um fio de r/Bookkeeping comparando opções de PDF para CSV, um usuário notó que AutoEntry processa extratos bancários e de tarjetas de crédito a três créditos por página, o que faz que um histórico longo se acumule rápido; o mesmo fio señala que Hubdoc e Dext oferecen conversão de extratos mas com alguns problemas a contornar. Os modelos de precios genuinamente diferem, e qual é mais barato depende de se seu volume é uma atualização única ou um fluxo contínuo.
O ponto de manejo de dados é o que decide a busca. Uma ferramenta para esta tarefa devería dizer claramente o que faz com o arquivo, e não devería exigir que o extrato seja alimentado em um pipeline que você não pode inspeccionar.
O teste correto não é reconhecimento de marca. É se a ferramenta produz colunas com forma de Xero, permite verificar uma cifra contra a página, preza o estallido de volume de forma sensata, e é honesta sobre o que conserva.
O último critério é o menos discutido e o mais útil: a ferramenta para onde devería? Converter extratos e conciliar uma conta são trabalhos diferentes, e uma ferramenta que os difumina vai sobreprometer na parte que seu livro maior devería possuir. Se você quer a aritmética da entrada manual versus automática de extratos apresentada em termos de custo primeiro, a comparação de custo mensal coloca números nela.
O que esta abordagem não faz
Ser claro sobre os limites importa mais do que a lista de capacidades, porque uma reconstrução histórica é exatamente onde uma promessa inflada custa mais tempo.
Não há conexão com o Xero nem lançamentos
A saída é um CSV que você importa por conta própria. Nada é gravado automaticamente no Xero, nenhuma linha de extrato é criada para você e nenhum lançamento contábil é feito.
Não categoriza nem concilia
Mapear transações para o seu plano de contas, compará-las com o razão e conciliar cada período continua com você e com o Xero. A conversão termina nas linhas estruturadas.
Não consegue recuperar o que o banco não emite mais
Se o banco não fornecer um extrato antigo e ninguém o guardou, não há o que extrair. Extratos mais antigos às vezes precisam ser solicitados ao banco, e algumas instituições cobram por eles.
Sobreposição e localidade continuam sob seu controle
Limitar o arquivo para terminar antes da primeira linha do feed é uma disciplina manual, não automática, e a planilha ou ferramenta que abre o CSV ainda aplica suas próprias configurações regionais de data e decimais.
FAQ
Por que o feed bancário do Xero não mostra transações anteriores à conexão da conta?
Porque um feed só entrega o que o banco envia a partir do momento da conexão. Ao conectar uma conta pela primeira vez, o Xero solicita o histórico que o banco disponibiliza, que geralmente cobre apenas alguns meses, e qualquer coisa mais antiga nunca foi buscada. As transações não estão faltando no banco; elas simplesmente nunca foram enviadas ao Xero, então precisam ser importadas dos extratos.
Quais colunas o Xero exige em uma importação de extrato bancário em CSV?
Data e Valor são os campos obrigatórios, e Data e Valor devem ser mapeados na etapa de importação. Receitas e despesas ficam em uma única coluna de Valor, com despesas negativas, escritas como -30.00 ou (30.00). Beneficiário, Descrição, Referência e Número do Cheque são opcionais, mas recomendados; Descrição aparece como Particularidades no Xero, e Beneficiário deve corresponder exatamente a um contato existente para evitar duplicatas.
Posso importar vários anos de extratos no Xero em um único arquivo?
Você pode montar um arquivo a partir de vários extratos, mas é mais seguro importar conta por conta e período por período para que cada mês possa ser conciliado com o extrato original. Converter todos os PDFs primeiro e depois importar em ordem cronológica também é uma forma prática de identificar lacunas entre os meses antes que cheguem ao livro-razão.
O que acontece se eu importar um período que o feed bancário já cobriu?
Você terá duplicatas. O Xero sinaliza algumas duplicatas suspeitas durante a conciliação, mas não bloqueia a importação por completo. Portanto, a abordagem segura é localizar a linha mais antiga que o feed já entregou e garantir que o arquivo histórico termine antes dessa data. Se duplicatas entrarem, exclua as linhas sobrepostas do extrato antes de conciliá-las.
Qual é a precisão da extração de extratos em comparação com a digitação manual?
Extrair as linhas elimina os erros de digitação típicos da entrada manual, mas não elimina a necessidade de verificação: comparar o primeiro e o último saldo extraído com os valores de abertura e fechamento impressos no extrato é a forma mais rápida de detectar uma linha omitida ou lida incorretamente.
O Dext ou o Hubdoc fazem o backfill histórico para mim?
Ambos conseguem processar extratos bancários, mas são criados principalmente para capturar contas e recibos em um livro-razão, e o período histórico é uma rajada de volume de extratos, e não a carga de trabalho constante deles. Nenhum dos dois lançará as transações no Xero para você, e nenhum elimina a necessidade de definir o limite você mesmo. A pergunta útil é se uma ferramenta produz o formato de coluna do Xero, permite verificar um valor em relação à página e lida com uma sequência de extratos longos a um custo razoável.
O objetivo de reconstruir a partir de extratos não é fazer o feed parecer mais completo do que é. É aceitar que uma conexão ao vivo só mostra uma janela e fechar os meses que ela nunca viu com o único documento que os registra de ponta a ponta. O feed continua cuidando do presente; os extratos resolvem o passado.
Reúna os extratos dos meses que seu feed pulou, nomeie as colunas como o Xero espera e transforme a pasta inteira em um CSV pronto para importação. Veja como funciona com seus próprios extratos.