なぜドイツの契約条項レビューは、法務チームが予算化した時間よりも多くのアソシエイト時間を消費するのか
法務チームの予算超過の実態
30件のWerkverträge(仕事の完成を目的とする契約、BGB §631に基づく)のポートフォリオをレビューする法務デューデリジェンスチームは、契約レビューにアソシエイトの1週間分の時間を予算化しない。3日分を予算化する。チームの見積もりでは、各契約が平均35ページであることを考慮した上での余裕のあるマージンだ。暫定調査結果のメモの提出期限までに3日間しかない。しかしレビュー開始から3日後、チームは18件の契約から主要条項を抽出した。残りは12件、メモの提出期限は明日だ。時間は法的分析に費やされたわけではない。チームはまだ分析にほとんど着手していない。時間は、何百ページもの定型文、前文、相互参照の中から、重要な5つの条項を探すことに費やされた。条項はすべて、どの契約にも存在する。それを見つけることに1週間を費やしたのだ。
要点
- 30件のWerkverträgeを手動でレビューすると25~28時間の請求可能時間(丸1人週)を消費し、その時間の80%は条項の閲読や意味分析ではなく、35ページのPDF内での条項探しに費やされる。
- スキャン疲れは訓練不足の問題ではない。条項レビューを加速させる脳のテンプレート構築メカニズムこそが、レビュー担当者が§9で見つけると予想するGewährleistungsfristが§12に置かれている場合に検出を逃す原因であり、この影響はキューに追加される契約ごとに悪化する。
- 読解と分類を分離する — AIに全30件の契約から5つの対象条項を同時に探させ、レビュー担当者はゼロから表を作成するのではなく、入力済みのスプレッドシートを検証する。
手動条項レビューの構造:時間は実際どこで消えていくのか
デューデリジェンスで1件のWerkvertragをレビューする法務アソシエイトは、紙面上は効率的に見える一連の作業を行う。契約書PDFを開く。当事者——Auftraggeber(発注者)とAuftragnehmer(受注者)——を特定する。通常は1ページ目にある。Leistungsbeschreibung(業務範囲の記述)を探す。通常は§3または§4にあるが、§1から参照される付属書(Anlage)に記載されることもある。Vergütung(報酬。BGB §632に準拠)を§5または§6で見つける。Abnahme(検収。BGB §640に基づき保証期間の起算点となるマイルストーン)とGewährleistungsfrist(保証期間。BGB §634aに基づく)を§8から§10で見つける。Haftungsbeschränkung(責任制限)を§11または§12で特定する。各所見をレビュー用スプレッドシートに入力する——契約1件につき1行、5つの条項をそれぞれ列とする。契約書を閉じる。次の契約書を開く。
この一連の作業は機能する。1件目の契約は45分かかる——うち35分は条項の特定、10分は見出しが示す内容と一致するかを確認するための読解だ。5件目の契約は30分——レビュー担当者は当事者が1ページ目にあり、Vergütungが§6付近にあることを内面化している。10件目までには、レビューは1件あたり25分で完了する。アソシエイトは速くなっている——そしてまさにここで、彼女を速くする仕組みが、彼女を正確でなくし始める。
アソシエイトの仕事は標準からの逸脱を見つけることだ。しかし条項を見つけるのが速くなるプロセスとは、条項が同じ場所にあることを期待するようになるプロセスである——つまり、速度を向上させる仕組みと、期待した場所にない条項を見逃す原因となる仕組みは同一なのだ。これはトレーニングの問題ではない。手動レビューという方法の構造的特性である。
特定の問題と読解の問題
法務アソシエイトに契約レビューで最も時間がかかるのは何かと尋ねれば、反射的な答えは「読解」だ。それは間違いだが、示唆に富む理由で間違っている。脳は任意の瞬間に実行している活動を認識しており、「読解」はレビューの大半で意識の画面を満たす活動である。アソシエイトは§3の見出しを読み、最初の文を読み、定義をスクロールして通過し、実質条項を見つけ、注意深く読む。しかし§2を読んでから§3を読むまでの間に、目に見えないステップがある:§3を特定することだ。PDFをスクロールしなければならない。目次はあるかもしれないし、ないかもしれない。条項番号は十進法(3.1、3.1.1)かもしれないし、段落ベース(§3、Abs. 1、Satz 2)かもしれない。その条項は§2の終わりと同じページにあるかもしれないし、§2に長い定義ブロックが含まれていたために2ページ先にあるかもしれない。こうしたナビゲーション上の判断のひとつひとつが数秒を消費する——35ページの契約書の15の条項にわたって、秒は分に積み上がり、30件の契約にわたって、分は日に積み上がる。
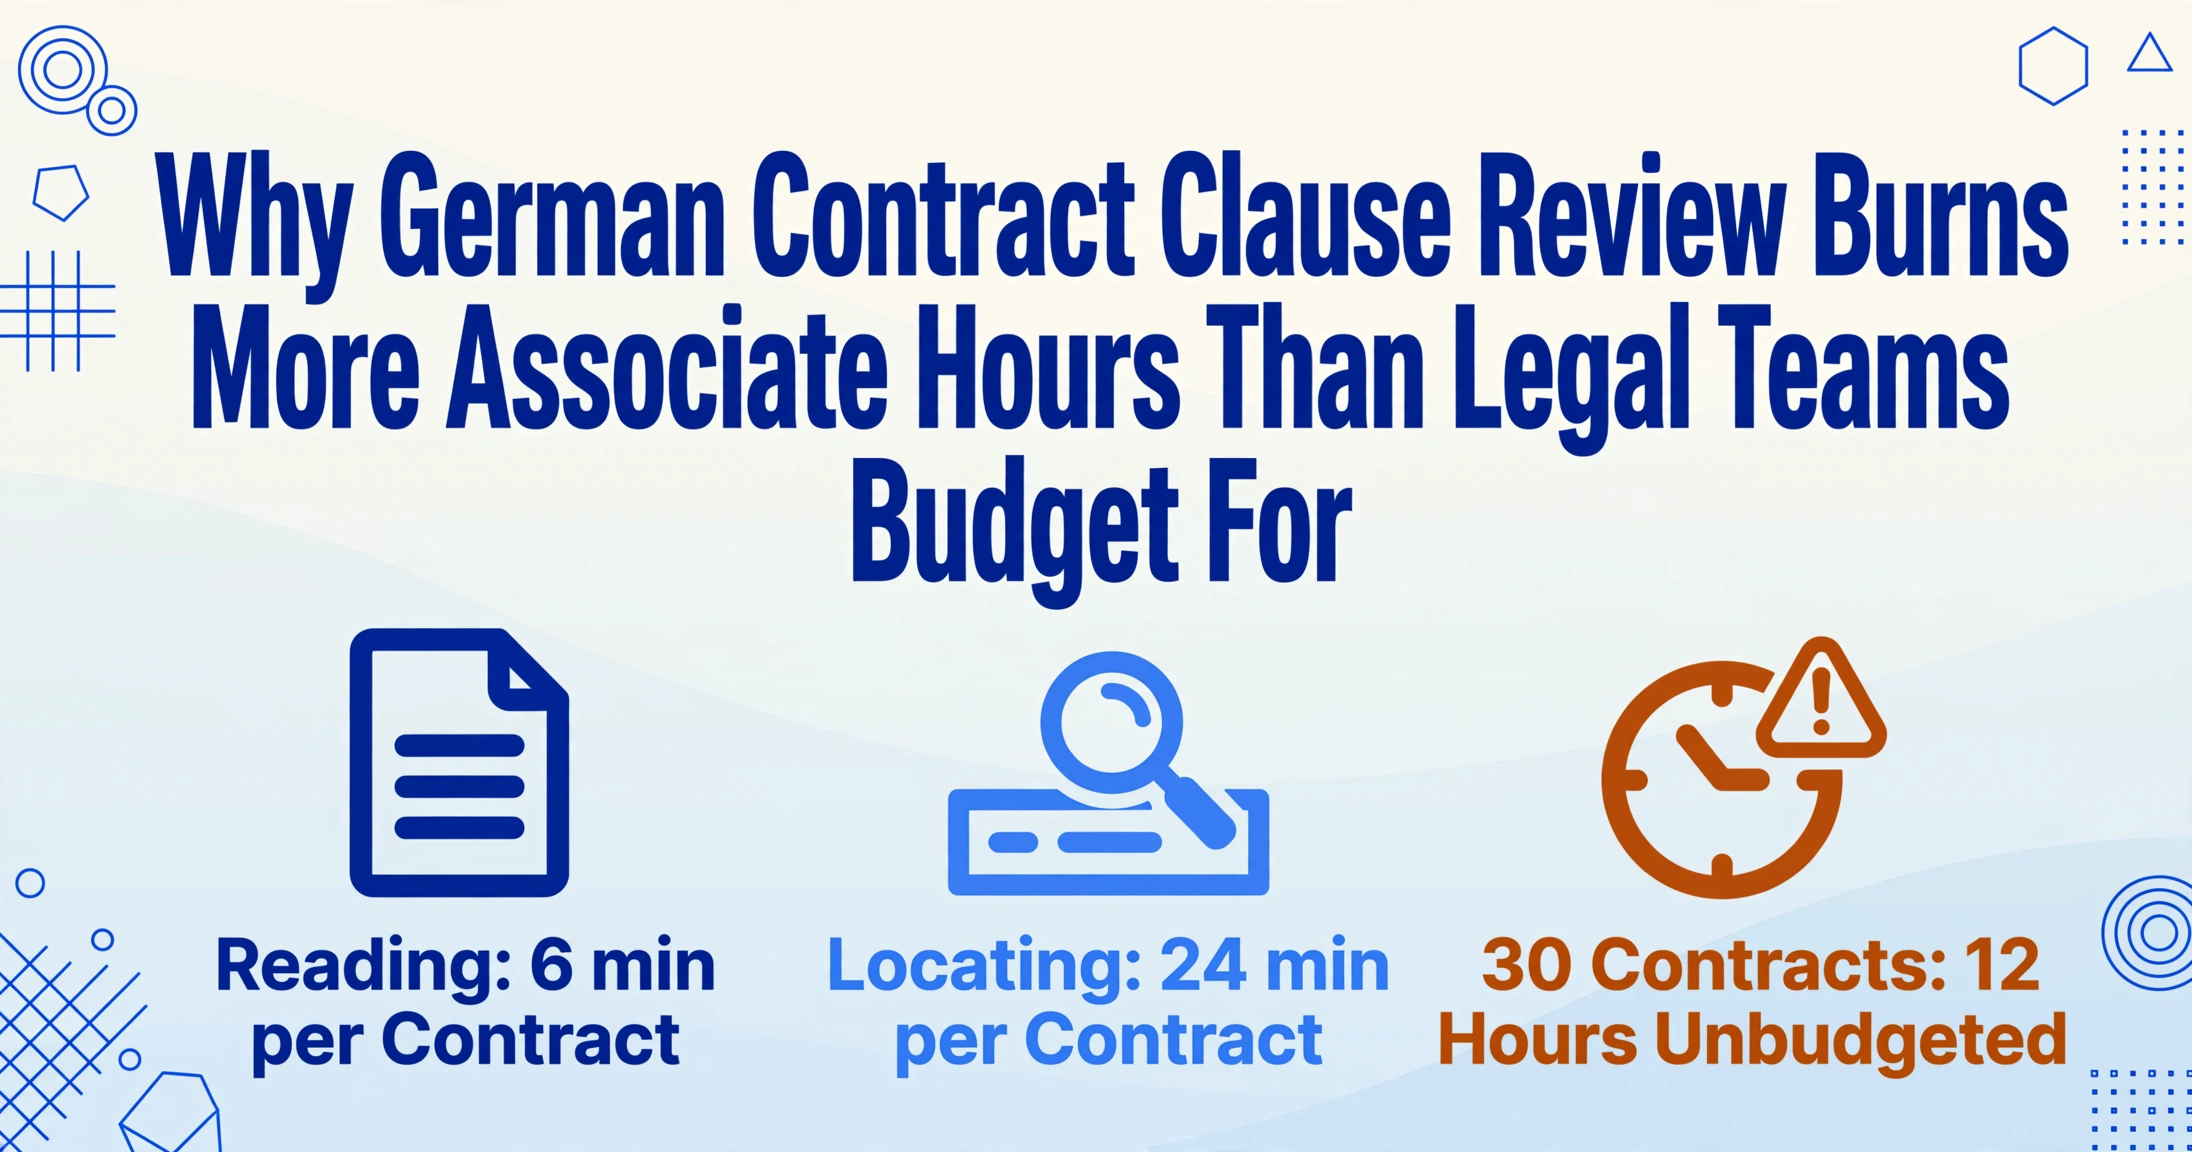
30分の契約レビューの正確な内訳は、その非対称性を明らかにする。対象となる5つの条項——実際に重要な法的内容——を読むのにはおよそ6分かかる。残りの24分は文書内でそれらの条項を特定することに費やされる:スクロール、目次の確認、Vergütungの条項が§6のあるべき場所になかったための引き返し、これが実際にHaftungsbeschränkungであり前文の一般的な免責条項ではないことを確認するための見出しの再読。読解と特定の比率はおよそ1:4——つまり手動レビュー時間の80%が、法的専門知識をまったく必要としない活動に費やされている。1年目の研修生も20年のベテランパートナーも、同じ速度でPDFを操作する。なぜならPDFのページ割り付けは法的な年功を尊重しないからだ。
この非対称性は、なぜ法務チームが契約レビューにかかる時間を一貫して過小評価するのかも説明している。パートナーが「契約書30件に3日」と見積もるとき、その頭の中のモデルは3日間の読書だ——1件あたり6分の読書時間なら、わずか3時間強で収まり、1日で簡単に収まる。その見積もりは、パートナーがアソシエイトと同様に、位置特定のオーバーヘッドを別個の活動として意識的に認識していないため、その分を考慮していない。位置特定は計画者には見えない。締め切りが近づき、時間が足りなくなって初めて見えてくるのだ。
スキャン疲れ:契約書17が契約書1よりも注目されない理由
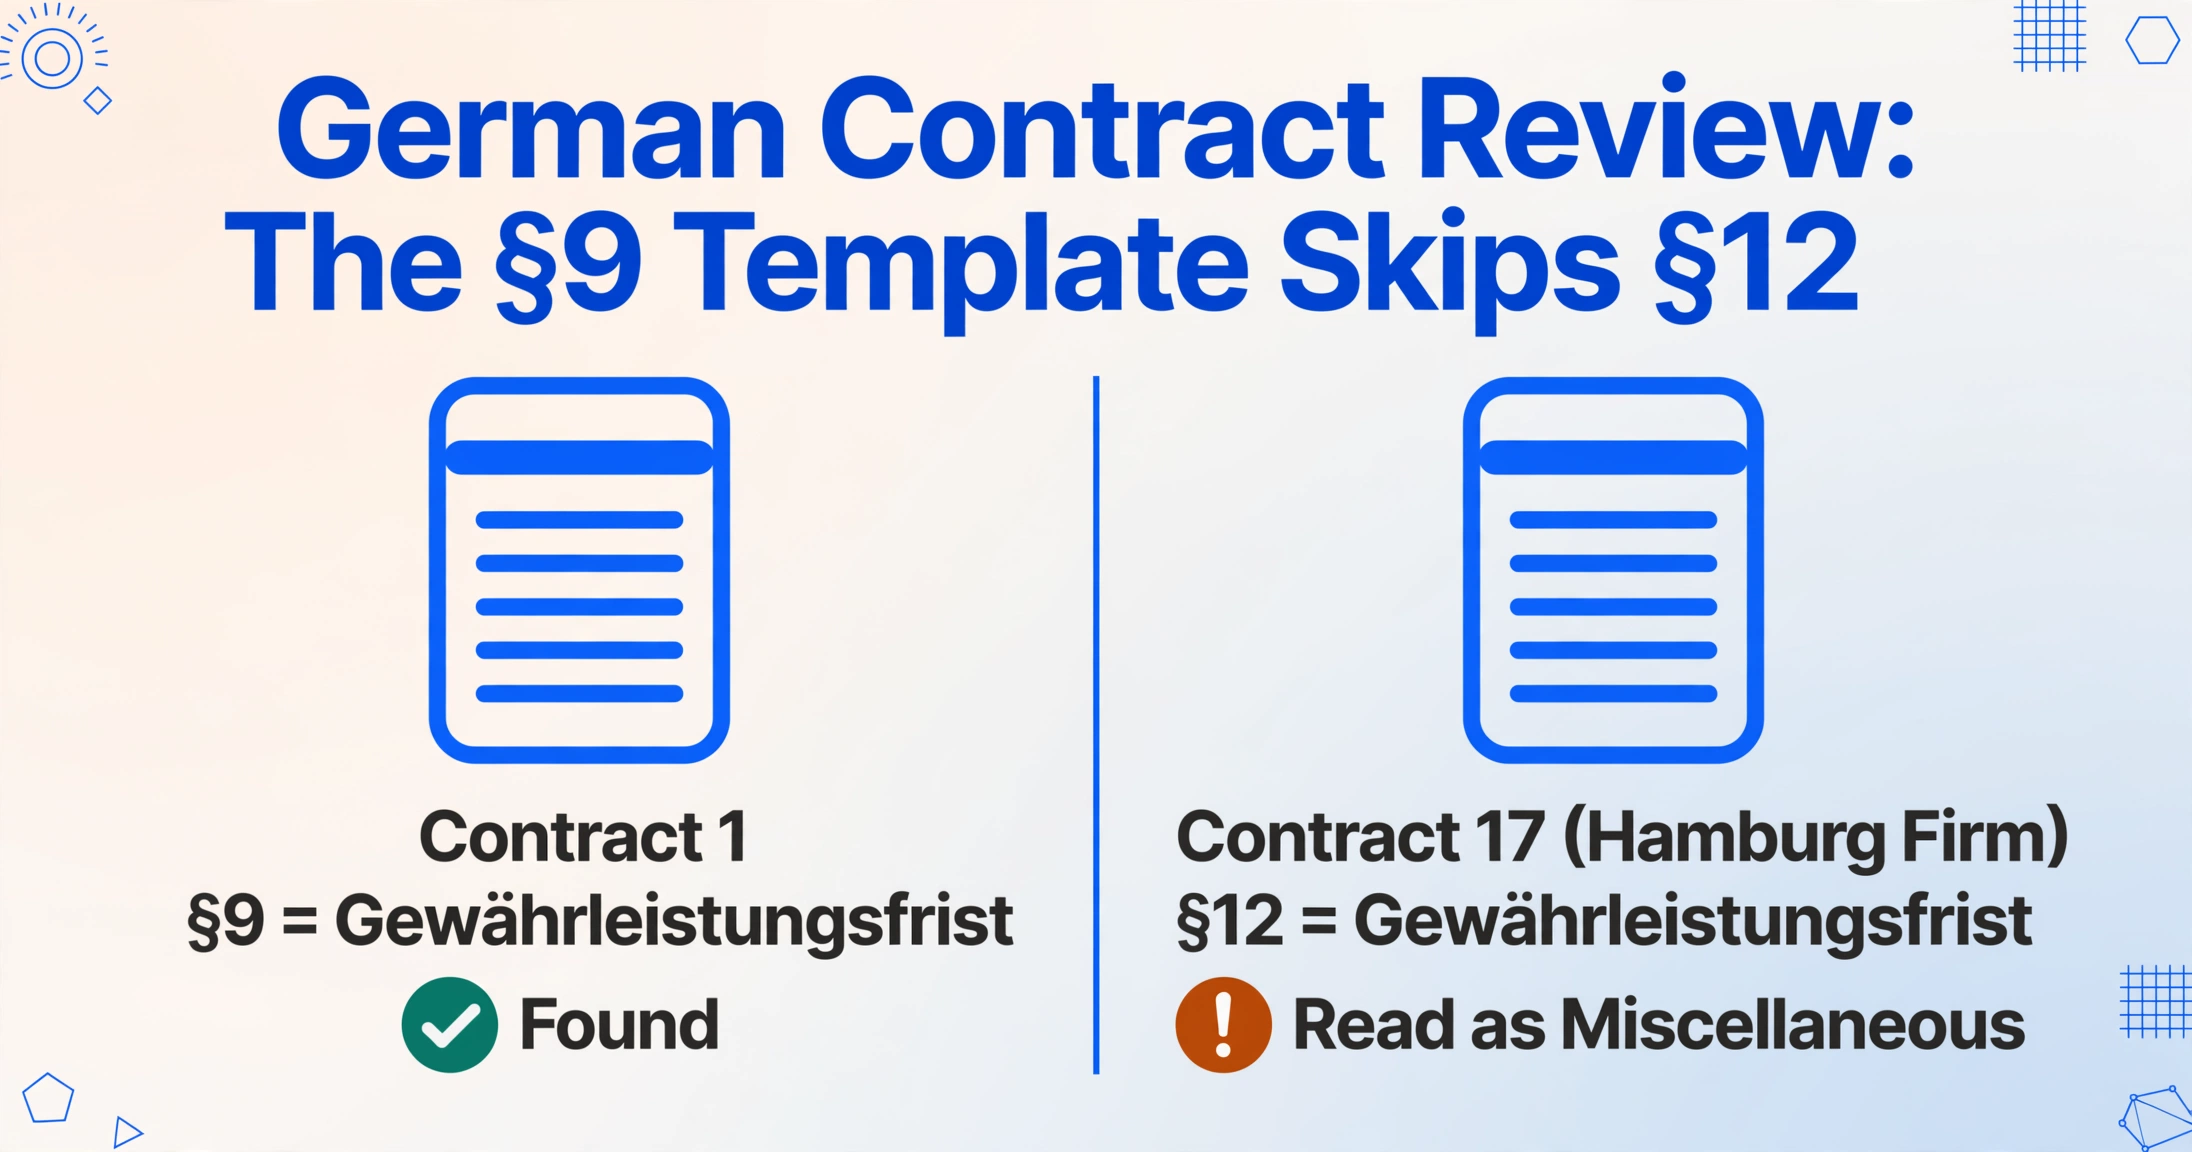
位置特定の問題には、量に比例して悪化する二次的な影響がある。それがスキャン疲れだ。同じデータルームから、ドイツの法律事務所が起草し、おおむね類似した構成に従ったWerkvertragを10件レビューした後、アソシエイトの脳はテンプレートを構築している。§3 = Leistungsbeschreibung。§6 = Vergütung。§9 = Gewährleistung。脳はこのテンプレートを使ってスキャンを加速させる。すべてのセクション見出しを読む代わりに、ページの視覚的構造をパターンマッチングして、期待される場所へジャンプするのだ。これは怠惰ではない——これは選択的注意の慣れと呼ばれる、十分に文書化された認知適応であり、脳が進化によって設計されたとおりのことをしているだけだ。すなわち、繰り返されるパターンを予測可能なものとして扱うことで、精神的エネルギーを節約しているのだ。
問題は、脳が契約レビューのために設計されていないことだ。契約書17がGewährleistungsfristを§9ではなく§12に置いている場合——ハンブルクの事務所が異なるセクション順序の慣行を用いて起草したため——アソシエイトの目は§12を素通りし、その見出しを「おそらく雑則だろう」と認識し、§9を探してスクロールを続ける。逸脱は文書内に存在する。レビュアーの脳はそれをフィルタリングしてしまったのだ。これは、訓練を受けていないレビュアーが犯し、経験豊富なレビュアーが回避するようなミスではない。経験豊富なレビュアーはより強固なテンプレートを構築する。つまり、彼らは逸脱をより効率的にスキップするのであって、そうでないわけではない。2,000件の契約書をレビューしてきた20年の経験を持つパートナーは、予期しないセクション位置にあるGewährleistung条項が文字通り彼女には見えないかもしれないほど強固なテンプレートを持っている——不注意だからではなく、彼女の専門知識が異常検出よりも速度を優先するように最適化されているからだ。
これが、レビューにおける最初の5件の契約書が最も徹底的な精査を受け、最後の5件が最も受けられない理由でもある——レビュアーの良心的かどうかに関係なく。注意力の予算は有限であり、それは早い段階で消費される。手動でレビューされた30件の契約書に基づくデューデリジェンスレポートは、構造的にレビューの前半で見えるリスクに偏り、後半に埋もれたリスクには目が行き届かない。その偏りは見えない——レポートには契約書ごとの信頼区間が付属していない——しかし、それは現実であり、未検出の逸脱を潜ませる可能性が最も高い契約書は、最後にレビューされるものだということを意味する。
分類オーバーヘッド:1つの脳を奪い合う2つの認知タスク
スキャン疲労と並行して働く2つ目の構造的問題があり、それはさらに見えにくいものです。それが分類オーバーヘッドです。アソシエイトがVergütung条項を読み、その値をスプレッドシートに入力するとき、彼女は認知的に異なる2つのタスクを同時に実行しています。1つ目は読解 — ドイツ語の法律散文の段落から報酬額を抽出すること。2つ目は分類 — その数値をスプレッドシートの正しい列にマッピングし、形式が一貫していることを確認し(EUR 120,000であって「€120k」や「120.000,00 EUR」ではない)、この値がVergütung列に属し、まだ作成していない別の「Nebenkosten」(付随費用)列には属さないことを頭の中で確認することです。
二重課題干渉は認知心理学における最も確立された知見の1つです。脳が同じ認知リソース — この場合は言語性ワーキングメモリ — を競合する2つのタスクを実行すると、両方のタスクが低下します。その低下は個々のケースでは劇的ではありません — タスクあたり2〜3%のエラー率 — しかし150回の抽出作業(5条項×30契約)全体では、2%のエラー率で存在すべきでない3つのエラーが発生します。アソシエイトは、契約書が実際には「EUR 120,000 zuzüglich der gesetzlichen Mehrwertsteuer」(法定付加価値税プラス)と記載していたのに、「EUR 120,000」をVergütung列に入力しました — そしてVATの扱いは買い手の財務モデルにとって重要です。あるいは、契約書が法定のデフォルト文言を使用していたため「5 Jahre」をGewährleistungsfrist列に入力しましたが、3段落後に「abweichend von Satz 1 beträgt die Gewährleistungsfrist 3 Jahre」(第1文から逸脱し、保証期間は3年)という文を見逃しました。エラーはスプレッドシートにあり、真実は契約書にあり、エラーが発見された頃には — もし発見されれば — デューデリジェンスレポートはすでにクライアントに提出されています。
これは英国SA100セルフアセスメント申告準備問題の分析で説明されているのと同じ認知メカニズムです。フリーランサーが銀行明細書、決済プラットフォームのエクスポート、領収書をHMRCのフォーム欄に変換する問題です。文書タイプは変わります — 英国の税務フォームではなくドイツの法的契約書 — しかし構造的な失敗は同一です。読解と分類を同時に行うことで両方のタスクが低下し、その低下は脳が自身の二重課題干渉にフラグを立てないため、実行している本人には見えません。間違った結果を生成して先に進むだけです。
スキャン疲労も分類オーバーヘッドも、より良いトレーニング、より注意深いアソシエイト、またはより厳格なレビュープロトコルでは解決できません。これらは勤勉さの欠如ではなく、1人の人間に2つの相容れない認知タスク(読解と分類)を、脳の持続的注意予算を超える量の資料に対して実行させるワークフローの構造的特性です。手動レビュー方式には、自身の失敗モードに対する防御策がありません。
誰も計算しないコスト:契約書30件につき担当者1週間分
数字で構造的な問題を具体的に示そう。ドイツ中堅企業のM&Aデータルームにある1件のWerkvertragは平均35ページ。法律アソシエイトが手作業でレビューする場合、1件あたり30〜45分かかる。その差は、契約書のセクション番号がレビュー担当者の頭の中のテンプレートとどれだけ一致しているかによる。1件あたり37分を中間値とすると、30件でアソシエイトの時間を18.5時間消費する。これは1日7.5時間の請求可能時間で約2.5営業日分に相当する。これは「探して読む」時間だ。
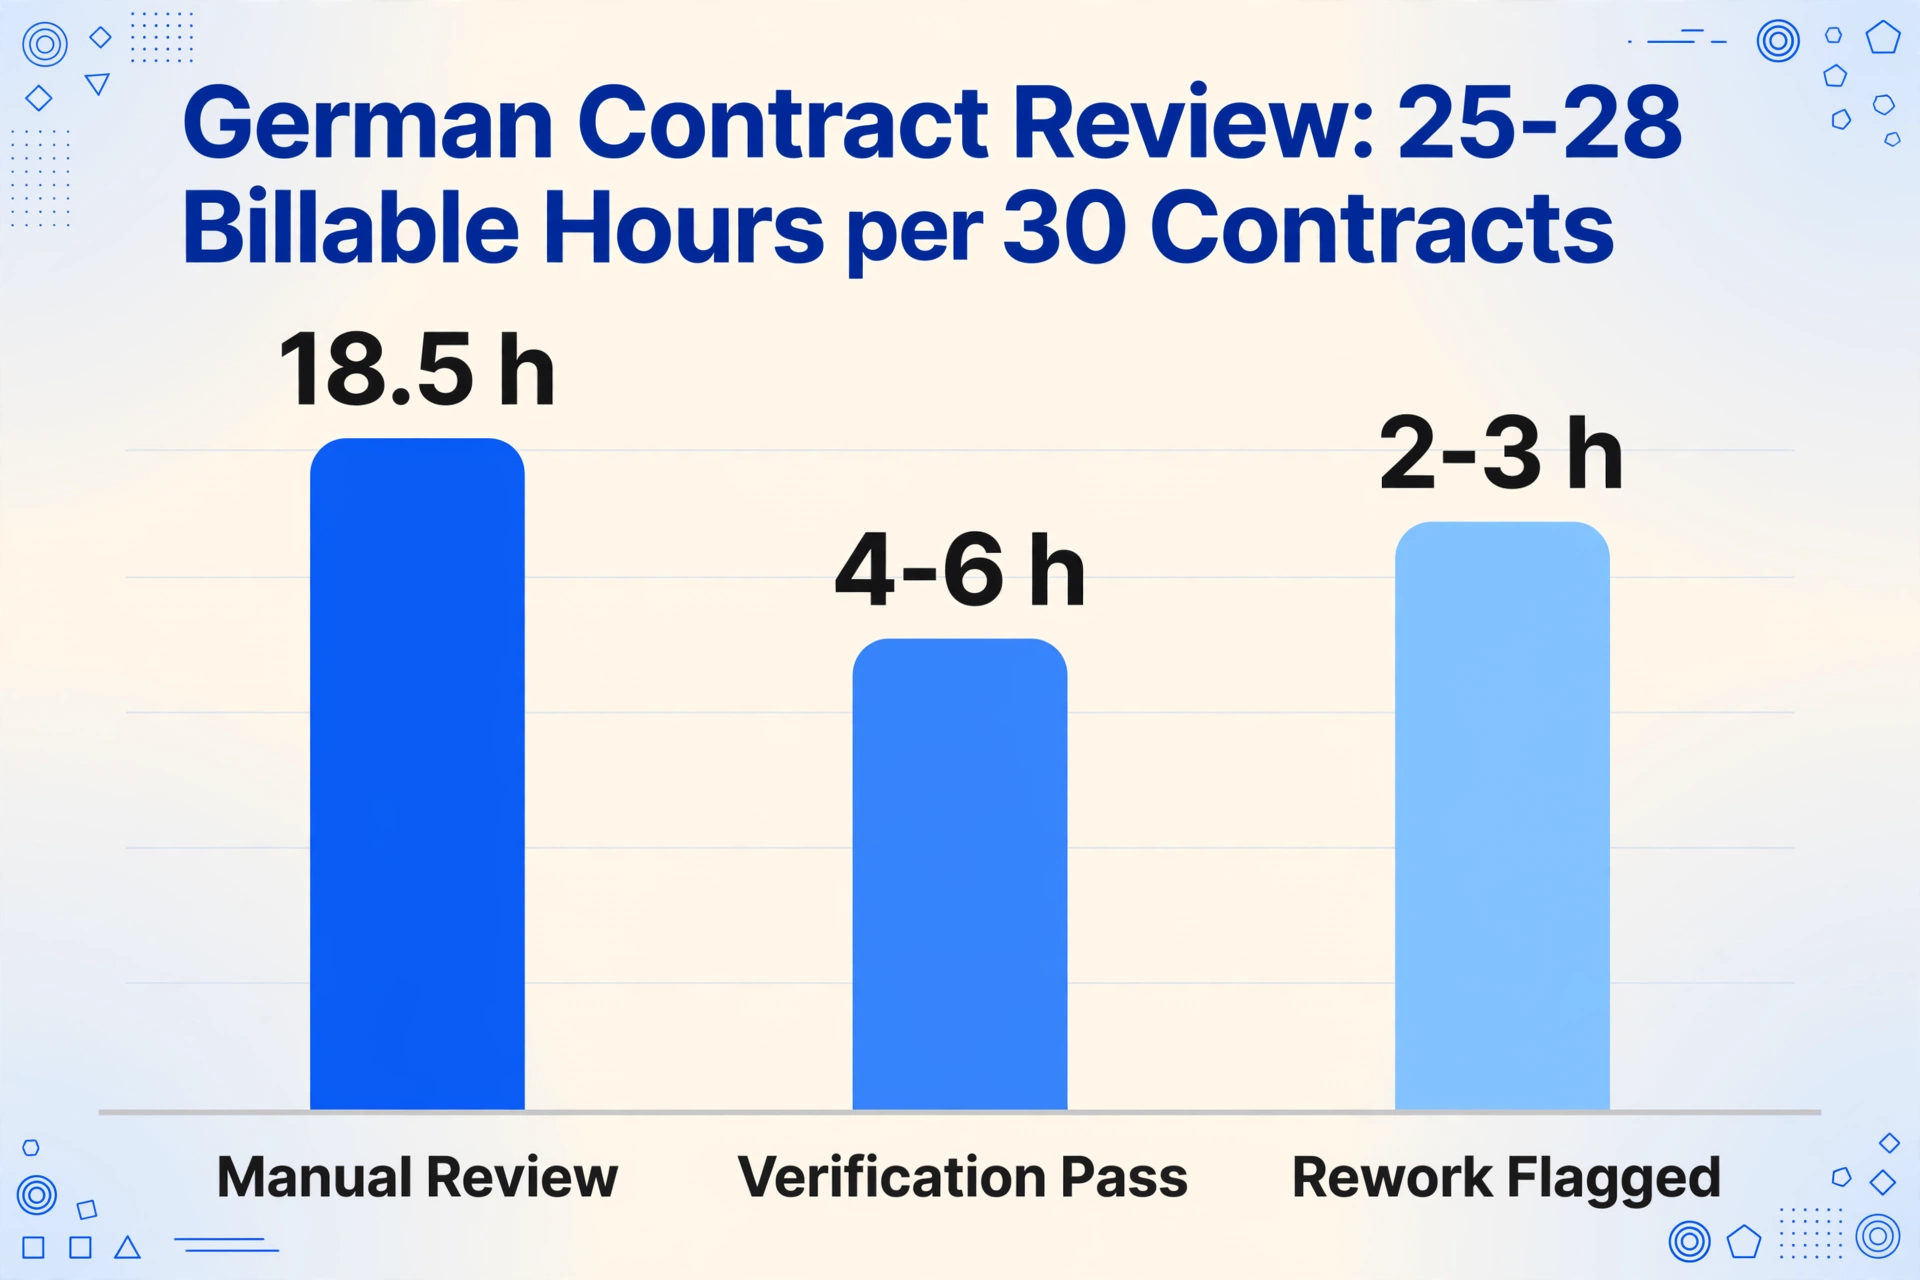
しかし、法律事務所の経済性にとって重要な数字は18.5時間ではない。重要なのは18.5時間の後に起こること、つまり検証ステップだ。シニアアソシエイトまたはパートナーは、ジュニアのスプレッドシートを元の契約書のサンプルと照合して、抽出された値が正しいことを確認しなければならない。この検証パス(5〜8件の契約書を読み、抽出されたすべての値を原本と照合する)にはさらに4〜6時間かかる。そして検証では必然的にエラーが見つかるため(転記ミスのVergütung、見落とされたGewährleistungsfristの逸脱、数値ではなくテキストとして入力されたHaftungsbeschränkungなど)、ジュニアはフラグが付いた契約書に戻って再確認する必要があり、さらに2〜3時間を消費する。
合計:30件の契約書をレビューして条項スプレッドシートを作成するのに、およそ25〜28時間の請求可能時間。これはアソシエイトとシニアの時間で丸1人週分に相当する。法的分析(クライアントが実際に費用を払っている部分、つまりどの保証期限が交渉上のレバレッジを生み、どの責任上限が商業的に不合理かという判断)はまだ始まっていない。その1人週分は契約データのスプレッドシートを買ったにすぎない。法的アドバイスはそこから始まり、調査結果メモの期限までの残り日数で行われる。
そしてこの計算は最も有利なシナリオを想定している:検索可能なPDF形式で、ドイツの法律事務所が一貫したセクション番号を使ってドイツ語で作成し、手書きの修正やスキャンされた添付資料、Vergütung条項がドイツ語でLeistungsbeschreibungの付録が英語という複数言語の契約書がない場合だ。実際のM&Aデータルーム(特に15年の事業歴があり、複数の法律アドバイザーから契約書が蓄積されたMittelstand企業が関与する場合)では、ばらつきははるかに大きい。2009年の契約書をスキャンしたPDFで、欄外に手書きのGewährleistungsfrist修正がある場合、判読性の問題だけでレビューに15分追加され、アソシエイトのスプレッドシートには「これを読める幸運を祈る」を記録する列はない。
なぜこれはスキルの問題ではないのか
法律事務所は、レビューが予算よりも長くかかった場合、まずアソシエイトの非効率性を疑う。より速いアソシエイトなら2日で完了できたのか?より経験豊富なレビュアーなら、スクロールの遅延なしにハンブルクの契約書の§12にあるGewährleistungを見つけられたのか?この直感はもっともらしい——法律事務所は請求可能時間の効率を最適化しており、アソシエイトのスピードは正当な業績指標である——しかし、これは問題を誤診している。
位置特定のオーバーヘッドはスキルでは削減できない。読むのが速い人は速く読み、スクロールが速い人は速くスクロールするが、PDFのレンダリング速度は全員にとって同じであり、セクション見出しは熟練度に応じて位置を変えることはない。1:4の読書対位置特定の比率は、レビュアーの能力の関数ではなく、メディアの関数である。フラットなPDFとして保存された契約書は、構造的に迅速な条項抽出に抵抗する。なぜなら、PDFは忠実な視覚的再現のために設計されており、構造化されたデータアクセスのためではないからだ。レビュアーに35ページのPDFから5つのデータポイントを抽出するよう求めることは、印刷された本から5つの文を見つけてExcelに入力するよう求めるのと同じである——ボトルネックは読書速度ではなく、線形のドキュメントをナビゲートして非線形のターゲットを見つけるという物理的行為である。
クロスマーケットの証拠は、この問題の構造的性質を裏付けている。英国のSA100 Self Assessment分析は、完全に異なる専門的コンテキスト——英国の個人事業主が納税申告のために源泉書類をまとめる作業——において、同一の位置特定・翻訳ボトルネックを示している。専門的役割(フリーランサー対法務アソシエイト)、ドキュメントタイプ(税務フォーム対契約書)、法制度(英国対ドイツ)、スキルレベル(法務訓練なし対法学部卒)はすべて異なる。構造的問題——それらを生み出すように設計されていないドキュメントから個別のデータポイントを抽出すること——は同じである。同じ失敗モードが役割、ドキュメント、法域を超えて現れるとき、失敗は方法にあり、それを使用する人々にはない。
読み取りと分類を分離すると何が変わるか
読み取ってから入力する方法に代わる選択肢は、「速く読む」ことでも「集中する」ことでもありません。それは、読み取りと分類という2つの認知タスクを分離し、それぞれ異なるエージェントに割り当てることです。AIが契約書を読み、弁護士が出力を分類します。これがWerkvertrag条項抽出メソッドの背後にあるパラダイムシフトです。レビュアーは5つの列(Auftraggeber、Leistungsbeschreibung、Vergütung、Gewährleistungsfrist、Haftungsbeschränkung)を定義し、30件の契約書を1つのバッチでアップロードし、入力済みのスプレッドシートを受け取ります。AIが位置特定(スクロール、セクション見出しの照合、「Vergütung」と「Honorar」の同義語解決)を行いました。レビュアーはその作業を一切行っていません。届くのは、各行が契約書、各セルが条項値であるスプレッドシートです。これは、アソシエイトが手作業で18.5時間かけて作成したであろう出力と同じものを、契約書1件を読むのにかかる時間で生成したものです。
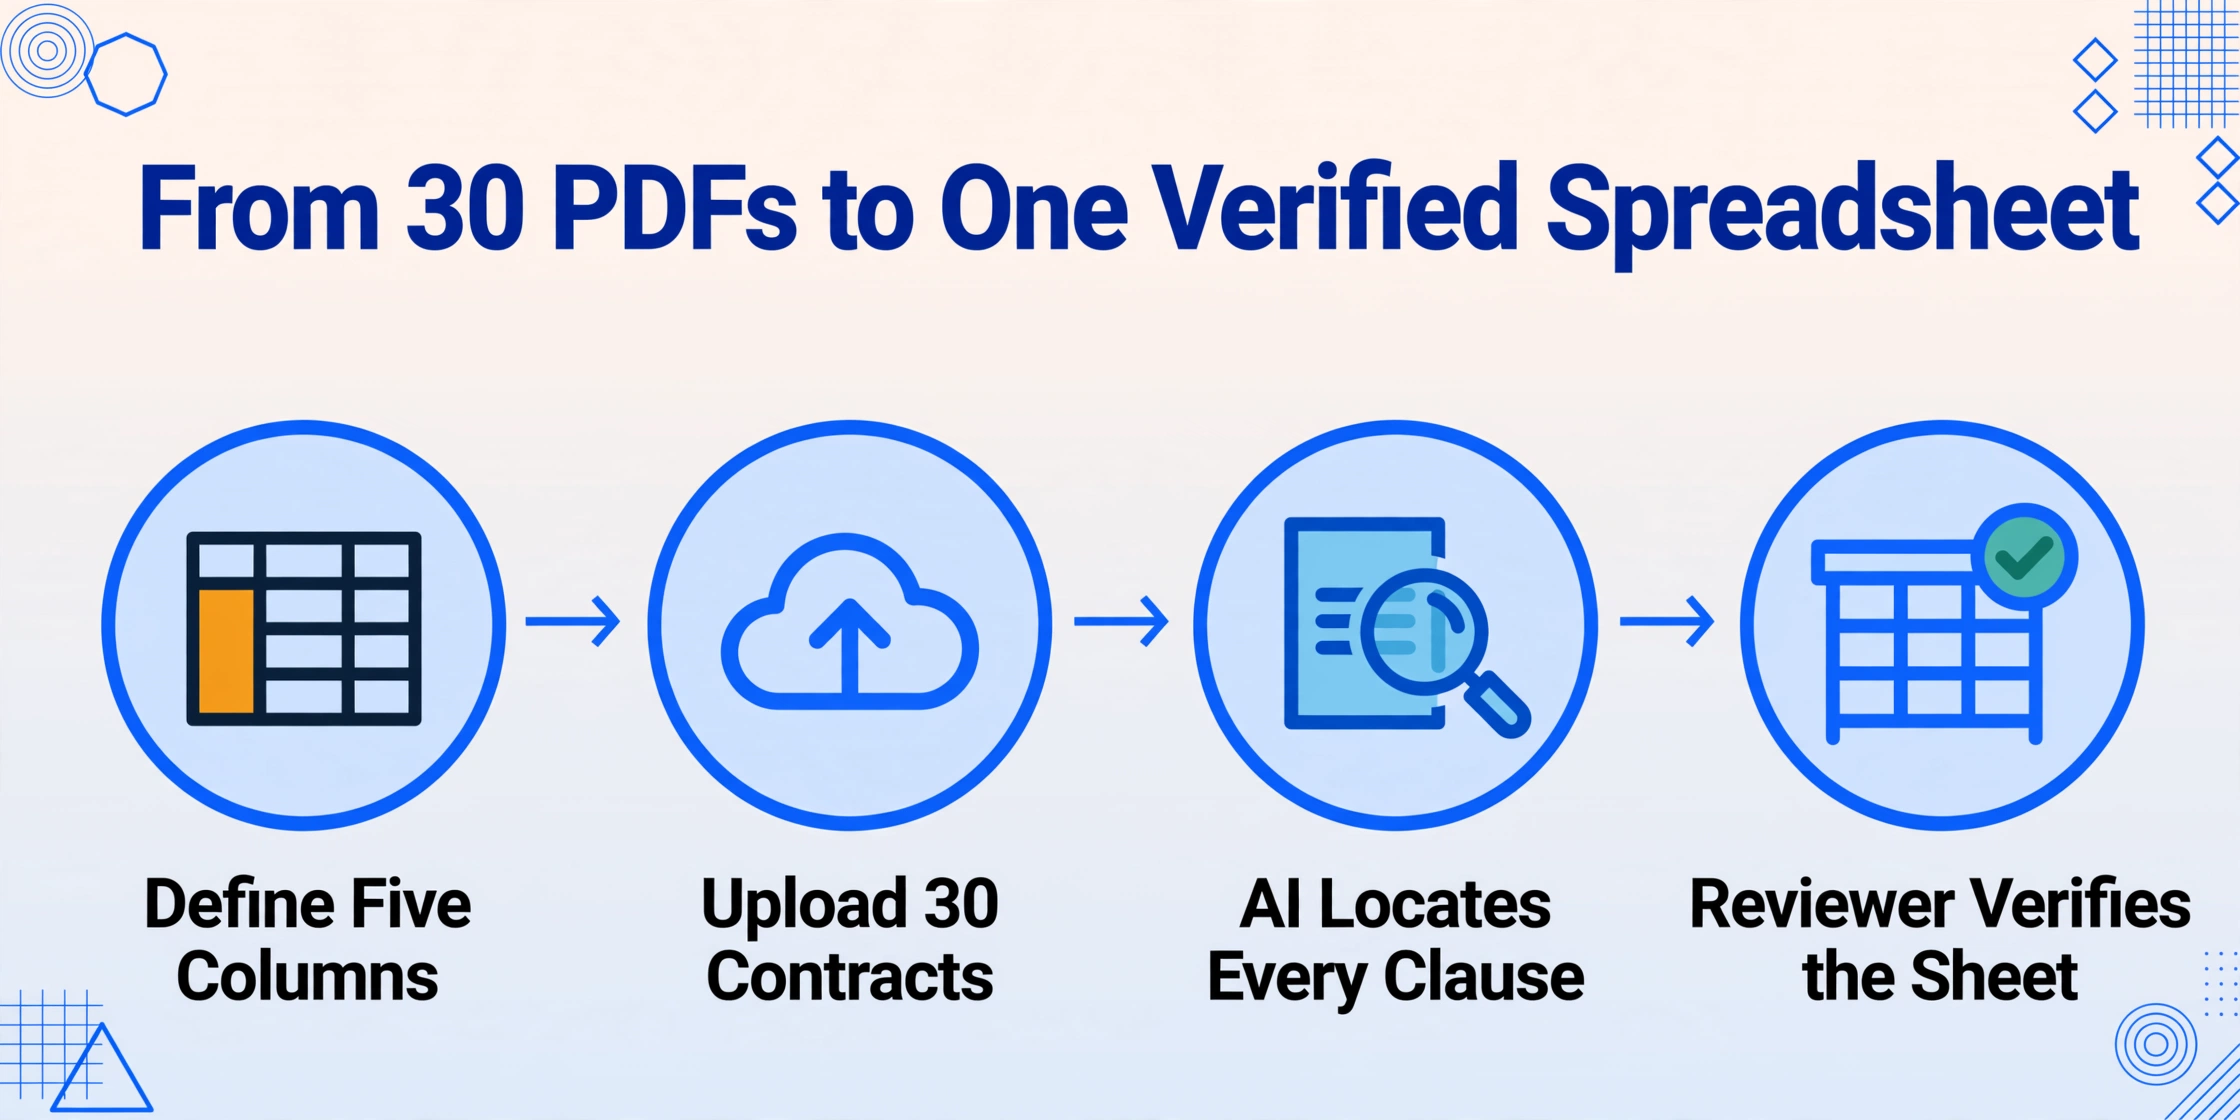
レビュアーの仕事は転記から検証へと変わります。30件の契約書を順番に読む代わりに、レビュアーはスプレッドシートを読みます。Gewährleistungsfrist列を昇順に並べ替えて、どの保証が満了に最も近いかを確認し、VergütungとHaftungsbeschränkungを比較して不均衡な責任上限を特定し、Vertragstyp列をフィルタリングして曖昧な契約分類を切り分けます。これらはバッチ契約条項レジストリガイドで説明されている分析パスであり、すべての契約書のデータが同じ形式で同時に届き、契約間比較が可能になったからこそ実現できます。
これにより、弁護士が契約書を読む必要性がなくなるわけではありません。検証ステップでは、スプレッドシートが異常としてフラグを立てた契約書を開く必要があります。5年のBauwerkデフォルトから逸脱するGewährleistung、€400,000の契約に対する€30,000の責任上限、「Vertragstyp: Unclear」と分類された契約書などです。しかし、レビュアーが開くのは30件ではなく5件で、しかも特定の質問を念頭に置いて開くのであって、ゼロから内容を発見するためではありません。18.5時間の位置特定オーバーヘッドはワークフローから削除されました。残りの時間は、法的専門知識を要する作業、つまり取引の文脈で逸脱が何を意味するかを解釈する作業に充てられます。
ファイルは安全に処理され、保存されません。
FAQ — ドイツ契約レビューのボトルネック
手動のWerkvertragレビューが、多くの法務チームの見積もりより時間がかかるのはなぜですか?
見積もりは読む時間だけを数え、探す時間を数えていないからです。対象の5つの条項 — Auftraggeber、Leistungsbeschreibung、Vergütung、Abnahme/Gewährleistungsfrist、Haftungsbeschränkung — を読むのにかかる時間は契約書1件あたり約6分です。しかし、35ページのPDF内でそれらの条項を探す — スクロール、見出しの確認、番号が想定と一致しない場合の戻り操作 — には契約書1件あたり24分かかります。読む時間と探す時間の1:4という比率は計画者には見えないため、見積もりは読む時間をカバーし、探す時間は予算化されないままになります。30件の契約書全体で、この計上されない探索のオーバーヘッドだけで約12時間分のアソシエイト労働時間を消費します。
スキャン疲れとは何ですか?なぜ最後の契約書に最も強く影響するのですか?
スキャン疲れとは、同様の構造の契約書を数件レビューした後、脳が予想される条項の位置のテンプレートを構築する認知的適応です。このテンプレートはナビゲーションを加速します — レビュー担当者はすべてのセクション見出しを読むのをやめ、視覚パターンで予想される位置に直接ジャンプします。しかし、契約書がテンプレートから逸脱している場合 — 例えば、別の法律事務所が作成したためGewährleistungsfristが§9ではなく§12にある場合 — レビュー担当者の脳は見出しを無関係と既に認識しているため、それを見過ごしてしまいます。疲れは累積的です:シーケンスの後半でレビューされる契約書ほど、レビュー担当者の誠実さに関係なく、前半のものより精査が甘くなります。つまり、未検出の逸脱が潜んでいる可能性が最も高い契約書は、体系的に最後にレビューされるものなのです。
30件のWerkvertrag契約書ポートフォリオは、実際に何時間かかるのか?
手動での条項特定・抽出に1件あたり30〜45分かかる場合、30件の契約書でアソシエイトの時間はおよそ18.5時間、つまり約2.5営業日を消費します。シニアレビューによる検証パス(4〜6時間)と、フラグが付いた不一致の再確認(2〜3時間)を加えると、合計で約25〜28請求可能時間——ほぼ1人週分に相当します。これはデータ抽出とスプレッドシートへの入力のみをカバーしています。法的分析——どの保証期限が交渉上のレバレッジになるか、どの責任上限が商業的に不合理か、どの契約タイプ分類が法的に重要か——の解釈は、この1週間が過ぎてから始まります。10営業日のデューデリジェンス期間がある一般的なM&Aタイムラインにおいて、法務作業が始まる前に丸1週間をデータ入力に費やすことは、最終報告書の品質に対する構造的な制約です。
検索可能なPDFやCtrl+Fを使えば、条項特定の問題は解決できるのか?
部分的に解決できます——ただしその限界こそが、この問題が技術的なものではなく構造的なものであることを示しています。キーワード検索(Ctrl+F)はドキュメント内の「Vergütung」という文字列を見つけます——しかし、それへのすべての相互参照(「§5 Vergütungに規定のとおり」)、それに言及するすべての定義、その語を使用するすべての定型条項も一緒に見つけてしまいます。レビュアーは依然として検索結果を読み込み、どれが実際のVergütung条項かを特定する必要があります。さらに重要なのは、契約書が異なる用語を使用している場合にキーワード検索が失敗することです。ある契約書の「Vergütung」は別の契約書では「Honorar」、3件目では「Auftragssumme」です。「Vergütung」のCtrl+F検索は2件目と3件目の契約書ではゼロ件になります——両方に報酬条項が含まれているにもかかわらずです。情報は存在するが、検索語が一致しないのです。フラットテキスト検索ツールは同義語を解決できず、異なるラベルで存在する条項を体系的に見落としてしまいます。
この問題はドイツの契約書に固有なのか、それとも契約レビュー全般に当てはまるのか?
条項特定の問題は、契約書がフラットなドキュメントとしてレビューされるどの法域でも存在します——つまり、すべての法域です。ドイツのWerkvertragで特に深刻なのは、BGB固有の法務用語の組み合わせ(§631のWerkvertragと§611のDienstleistungsvertragの違いは保証期間に実質的な影響を及ぼします)、契約書本文内での法令上の相互参照の広範な使用(§634a、§640、§307)、そして法律事務所間の構造的な不整合(ミュンヘンの事務所は通常、ハンブルクの事務所とは異なるセクション順序を使用します)にあります。しかし、同じ問題は他の文脈でも確認されています——英国SA100確定申告準備のボトルネックは、税務申告の文脈で同一の特定・翻訳の失敗モードを示しており、この問題は法域ではなく方法に起因することを裏付けています。
AIがアソシエイトの代わりに契約書を読むと、何が変わるのか?
アソシエイトは読み手ではなくなり、検証者になります。30件の契約書から5つの条項を探し出し、スプレッドシートに入力するのに18.5時間費やす代わりに、アソシエイトは入力済みのスプレッドシート(各契約書の主要条項が抽出・整形されたもの)を受け取り、ソース文書と照合して値を検証するのに4〜6時間を費やします。削減されるのは検証ステップ(依然として法的専門知識が必要)ではなく、探索ステップ(そもそも法的専門知識を必要としなかった)です。アソシエイトの時間は、読む対探索の1:4の比率から1:0の比率へと移行します。すべての読み取りはAIが行い、アソシエイトの時間はすべて、クライアントが支払っている法的判断に充てられます。抽出から検証までの完全なワークフローは、Werkvertrag条項抽出ガイドで詳しく説明しています。
法務チームが30件の契約から条項を見つけるために費やす1人週は、誰も計画していなかった予算項目であり、法的分析の進め方を変えることなく、午後1つ分に圧縮できる。契約は変わらない。誰が読むかが変わるだけだ。
契約書の条項を検索