QCラボレポートを
SPC用にExcelへ抽出する方法
手作業によるQCラボデータ入力の本当のコストは、タイピングそのものではありません。最後のテスト結果が機器から出力されてから、権限のある担当者がバッチを承認するまでの時間差です。一般的な製造工場では、この時間差は4〜8時間にもなります。テスト自体に時間がかかるからではなく、PDFレポートからスプレッドシートへのデータ転記、その後の監督者によるレビュー、さらにQAによる再チェックが必要で、ようやくリリース判断ができるからです。その間、生産は待機します。バッチが出荷可能になってからの1時間の遅延は、運転資本、倉庫スペース、顧客の納期に実質的なコストをもたらします。技術者が機器のプリントアウトからExcelに数値を打ち込む転記ステップこそ、誰も予算化していないボトルネックなのです。
重要なポイント
- 二重入力方式のQC記録の40%は、誰が入力してもエラーが含まれます。SPCワークブック内の転記ミスは不注意の問題ではなく、構造的に発生するものなのです。
- キー入力ミスによって引き起こされる見せかけの管理外シグナルは、オペレーターにSPCチャートを無視する習慣を植え付けます。狼少年状態が常態化すると、本当の品質シグナルはノイズに埋もれてしまいます。
- 技術者はテストを実行するために化学や工学を学んだのであって、数値を入力するためではありません。毎日90分の転記作業を10分の検証ゲートに置き換えれば、取り戻した時間を本来の科学業務に充てることができます。
手動ラボデータ転記の隠れたコスト
QCマネージャーにバッチリリースを遅らせる原因を尋ねると、「テスト結果待ち」と答えるでしょう。しかし、結果はサンプルが機器にセットされてから数分以内に得られます。実際に待っているのはデータ入力です。Shimadzu HPLCが分析を終えると、15の試験パラメータを含むPDFレポートを印刷(またはエクスポート)します。Mettler Toledo滴定装置が分析を完了し、別のPDFを生成します。Instron引張試験機も3つ目のPDFを出力します。誰かがこれらの各レポートから数値を読み取り、Excelワークブックに入力しなければなりません。この作業は通常、テスト自体よりも時間がかかり、下流に波及するエラーを引き起こします。
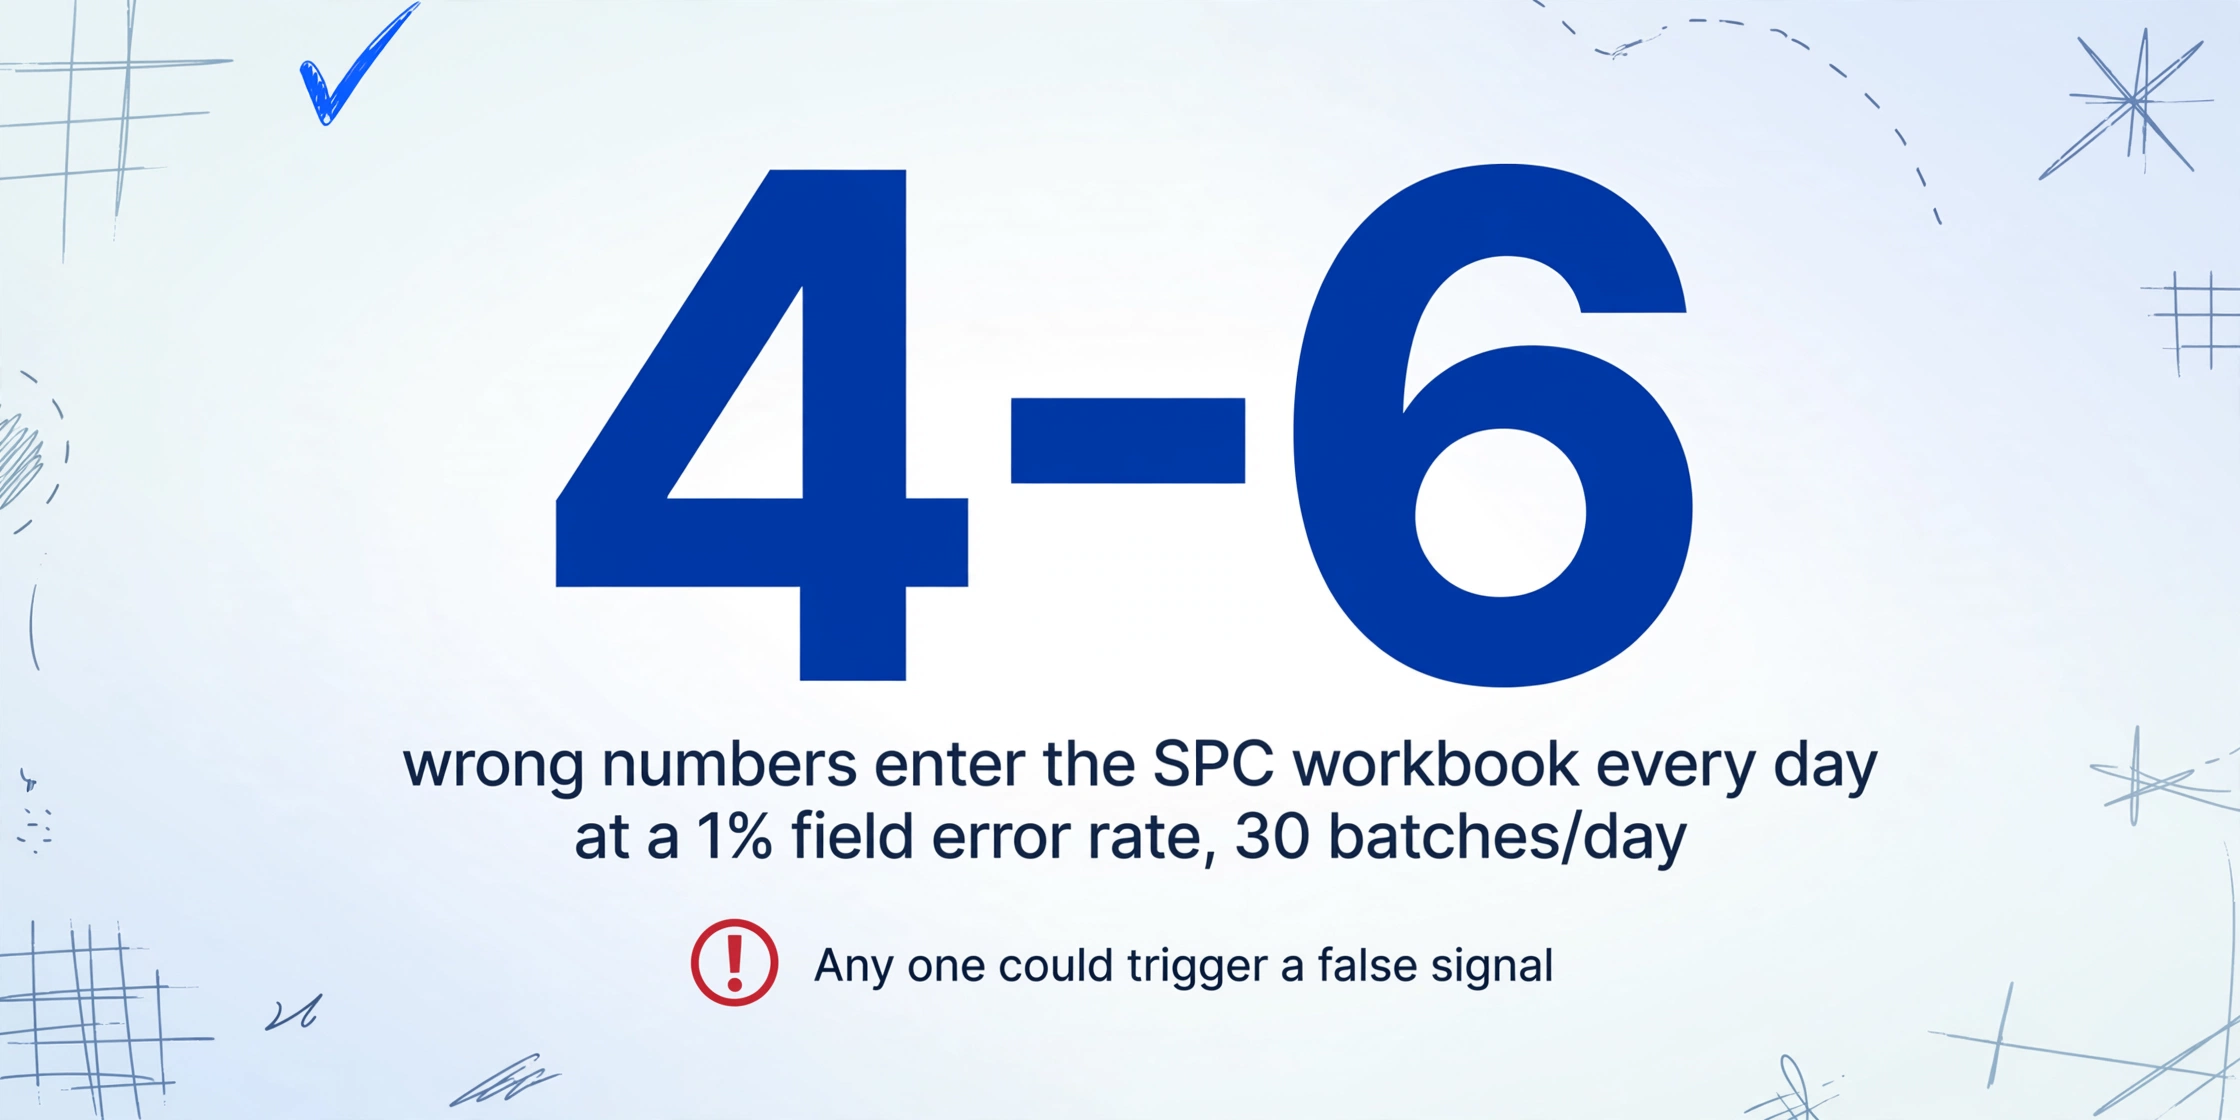
エラー率は十分に文書化されています。Quality Magazineが引用する研究によると、手動データ入力の基本エラー率はフィールドあたり約1%です。これは計算するまでは管理可能に思えます。完成品リリースレポートには15〜20の試験パラメータがあるかもしれません。ラボが1日30バッチを処理する場合、450〜600のフィールド入力になります。1%のフィールドエラー率は、毎日4〜6個の誤った数値がSPCワークブックに入力されることを意味し、そのうちのどれか1つでも管理外シグナル、不当なバッチ保留、または不合格にすべき材料のリリースを引き起こす可能性があります。
そして、これは楽観的なシナリオです。紙ベースのワークフローを採用する製造QCラボでは、2段階入力システムを運用しています。技術者が機器で測定値を紙に記録し、その後、誰か(多くの場合、同じ技術者または別の担当者)がその測定値をスプレッドシートまたはデータベースに転記します。Beamexによると、データが2つの手動入力ポイントを通過する場合、記録の約40%に少なくとも1つのエラーが含まれることになります。2段階入力で年間10,000件の校正または品質テストを実施する工場では、統計的に4,000件の欠陥データポイントが生成されます。
1日30件のバッチリリーステストを処理する単一のQCラボでは、1%のフィールドレベルエラー率は月間120〜180件の転記ミスを意味し、それぞれに調査、手直し、リリース判断の遅延が必要となります。
QCラボのレポートが機器からスプレッドシートに移行する現状
製造業のQCラボに入ると、そのワークフローは業界を問わず驚くほど一貫しています。製薬、自動車、食品加工、医療機器、化学。例えば島津HPLCやメトラー・トレドのカールフィッシャー水分計といった機器が分析を完了し、レポートを生成します。最新のラボでは、これは機器制御ソフトウェア(島津LabSolutions、メトラー・トレドLabX、アジレントOpenLab)からエクスポートされたPDFとして出力されます。古い施設では、サーマルプリンターで出力され、ログブックに貼り付けられます。いずれにせよ、データはクエリ、グラフ化、統計分析が不可能なドキュメントに閉じ込められています。
次のステップは転記です。QC技術者がレポートを読み取り、試験名、規格値、測定値、合格/不合格といった値をスプレッドシートに入力します。工場がSPCにMinitab、InfinityQS ProFicient、またはJMPを使用している場合、データはそれらのプラットフォームに直接送られる可能性があります。しかし、小規模な事業所(ほとんどの製造工場が該当)では、行き先は管理図テンプレートが組み込まれたExcelワークブックであり、多くの場合、数年前に退職した品質エンジニアが作成したものです。
この転記ステップは、データを生成するラボ機器と、それを消費するSPCプラットフォームという、相互に通信するようには設計されていない2つの品質システムの交点に位置します。両者の間には人間による橋渡しがあり、その橋渡しこそがエラーと遅延の集中箇所です。米国品質協会(ASQ)の推定によると、不良品質コスト(COPQ)は製造業者の総収益の15%から40%を消費し、そのかなりの部分は手動転記に起因するデータ完全性の失敗に由来します。
規制の枠組みも、これが重要である理由を強調しています。ISO 9001:2015 条項7.5は、組織が適合性の証拠として文書化された情報を保持することを要求しており、これにはリリースを承認した人物へのトレーサビリティも含まれます。ISO/IEC 17025:2017 セクション8.4は、試験所の記録が、可能な限り元の条件に近い状態で試験を再現するのに十分な情報を含むこと、および記録への修正は元の記入事項を不明瞭にしてはならないことを義務付けています。FDA 21 CFR Part 211 Subpart Jは、バッチ生産およびラボ管理記録が、バッチリリース前に品質管理部門によってレビューおよび承認されることを要求しています。データが手動で転記される場合、これらの要件のすべてを満たすことが難しくなります。トレーサビリティをチェックする監査人は、機器ログと転記されたスプレッドシートで異なる値を発見し、その差異に対する文書化された根拠がないことに気付くかもしれません。
これは単なる書類上の問題ではありません。Tulipによると、EYはQA業務の70%以上が文書レビューに費やされていると推定しています。調査やプロセス改善ではなく、単なる記録の確認です。バッチリリースの遅延は、医薬品製造におけるサプライチェーン混乱の上位3つの原因の1つです。データ検証を待ってバッチが保留状態で放置される1時間ごとに、運転資本が凍結されます。
セマンティック抽出がラボのデータ入力にもたらす変化
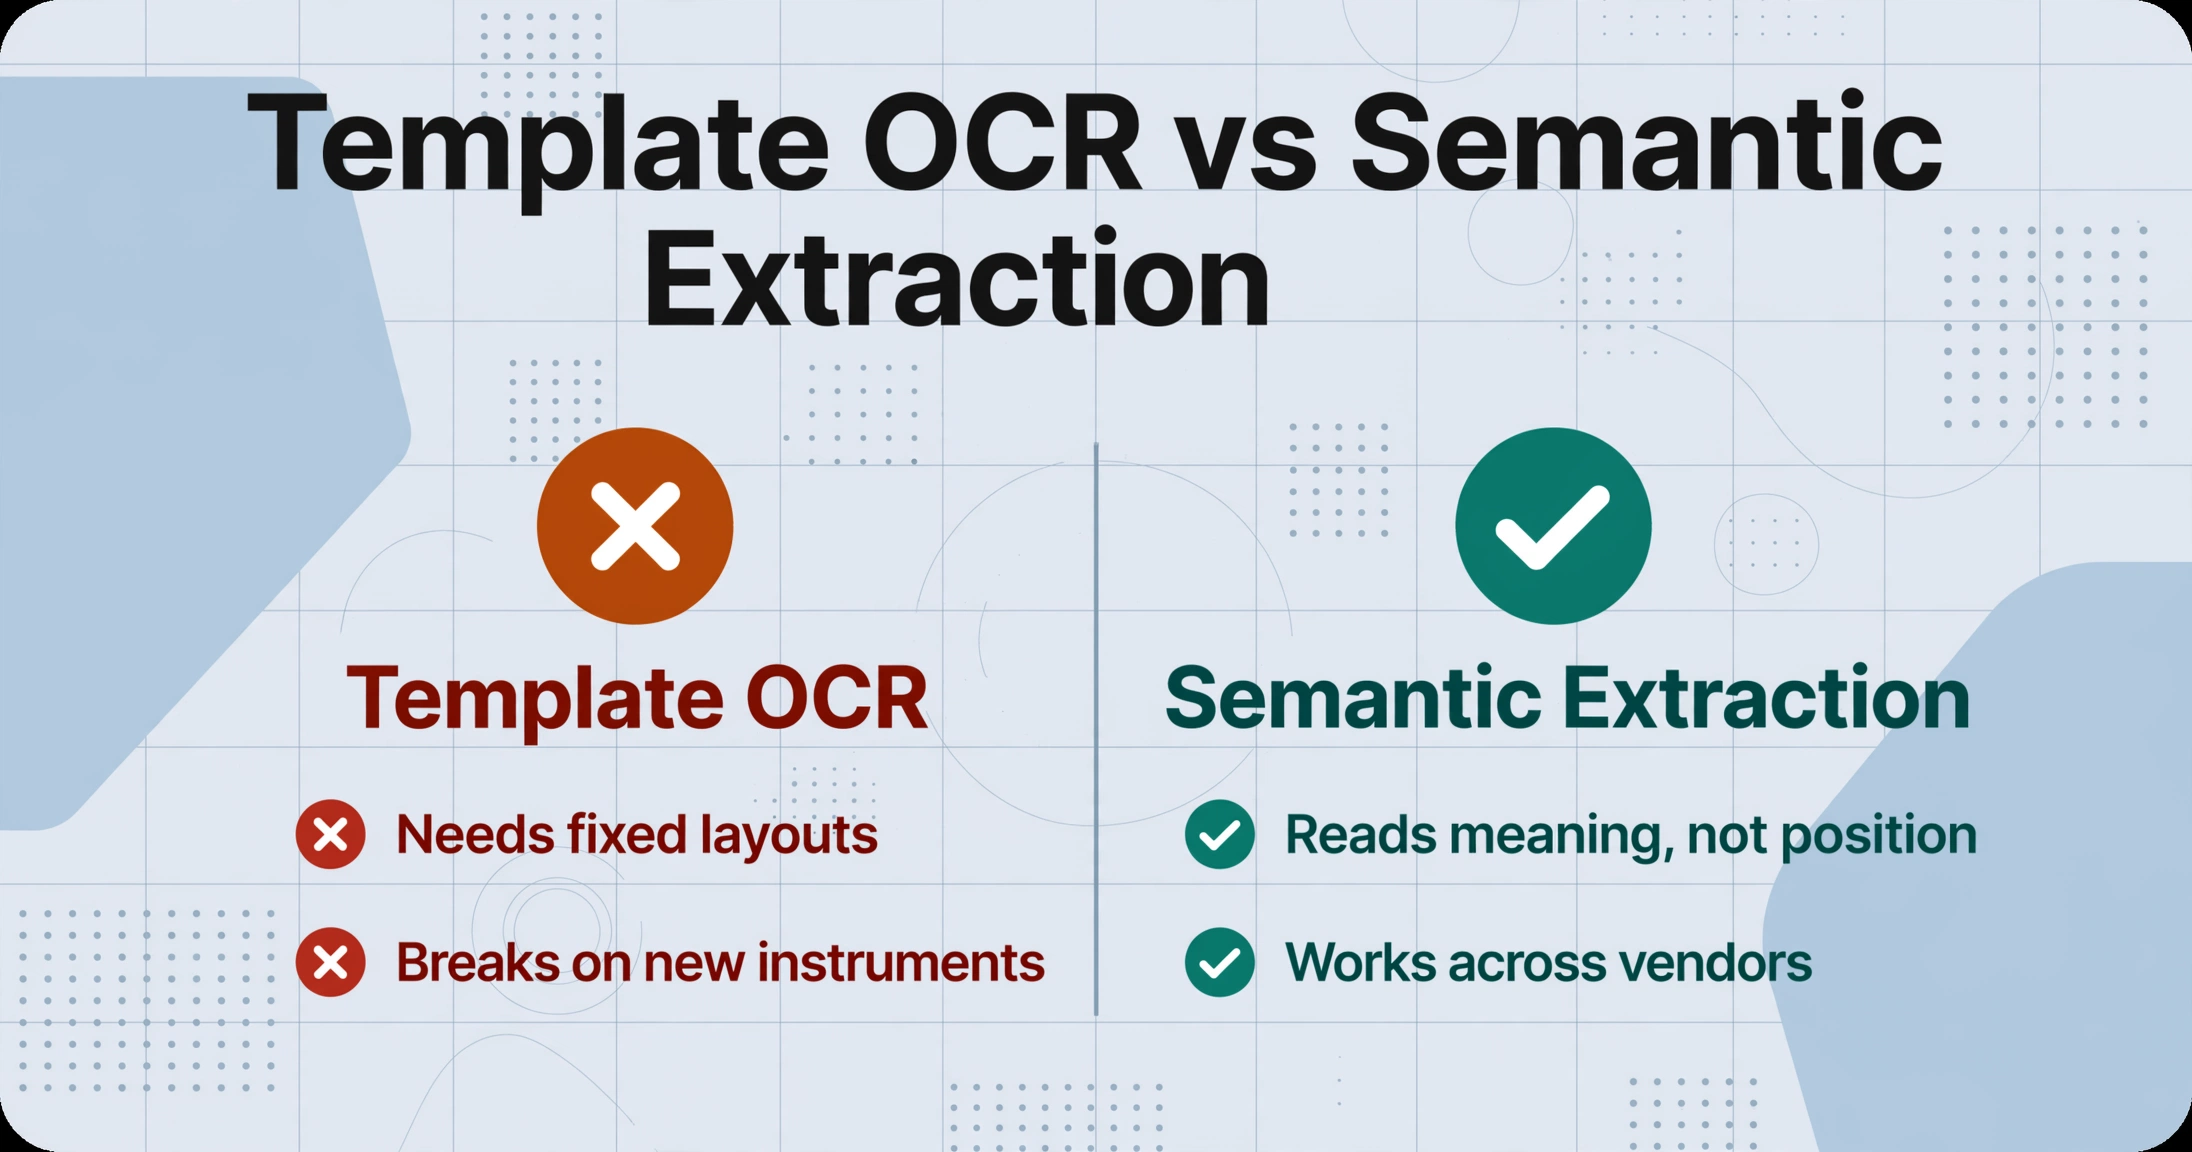
核心的なボトルネックは、QCレポートが読みにくいことではありません。自動化への従来のアプローチ、つまりテンプレートベースのOCRが、複数の機器を擁するラボの現実にそぐわないことが問題なのです。テンプレートは、すべてのドキュメントが同じ見た目である場合に機能します。しかし、ShimadzuのHPLCレポート、Mettler Toledoの滴定装置の出力、Instronの引張試験PDFは、根本的にレイアウトが異なります。列の位置、フィールドの命名規則、測定単位がそれぞれ違うのです。機器・モデル・レポートの組み合わせごとに解析テンプレートを作成・維持することは、それ自体がフルタイムの仕事であり、だからこそほとんどのラボは手間を避けて手動入力に留まっているのです。
セマンティック抽出は異なるアプローチを取ります。データがページ上のどこにあるか(3行目、2列目)を定義する代わりに、何を探しているのか(「pH」「引張強度」「含有量%」などの値)を指定します。AIは技術者が行うのと同じように、座標を照合するのではなく、文脈における単語の意味を理解してドキュメントを読み取ります。このアプローチはカスタム列抽出と呼ばれることもあります。列ヘッダーとして必要なフィールド名(「試験名」「規格限度」「測定値」「合格/不合格」)を入力すると、AIが各レポート上の対応する値を、それがどこに現れても特定します。
これはQCラボにとって重要です。レポートのレイアウトは機器ベンダー間だけでなく、同じ機器で実行される試験方法間でも異なるからです。Shimadzu HPLCレポートでも、含有量試験用と不純物プロファイリング用では列構造が異なります。両方が同じLabSolutionsソフトウェアから出力される場合でも同様です。テンプレートベースの抽出では、各バリエーションに専用のテンプレートが必要です。セマンティック抽出では、同じ列名のセットがすべてのバリエーションで機能します。AIが位置ではなく意味を照合するからです。
セマンティック抽出は、パラダイムを位置ベースから意味ベースへと転換します。出力したい内容を定義すれば、AIが各ドキュメントを読み取ってそれを見つけ出します。テンプレートの作成も、フォーマットごとのルールの維持も不要です。
これは理論上の能力ではありません。ImageToTable.aiは視覚言語モデル(VLM)を使用して、テンプレート不要の抽出を実行します。各機器のレポート形式に対応する解析テンプレートの作成や維持は不要です。また、ゼロセットアップです。サンプルレポートの収集、トレーニングデータのラベル付け、抽出ルールの設定も必要ありません。PDFをアップロードし、列に名前を付け、AIが値を抽出します。Agilentが来年ソフトウェアパッチでレポートレイアウトを更新しても、同じ列名が引き続き機能します。AIが座標ではなく意味で読み取るからです。(この技術がラボドキュメント全般にどのように適用されるかの詳細については、ラボレポートデータ抽出の完全ガイドをご覧ください。)
ステップ1: テストパラメータを抽出列として定義する
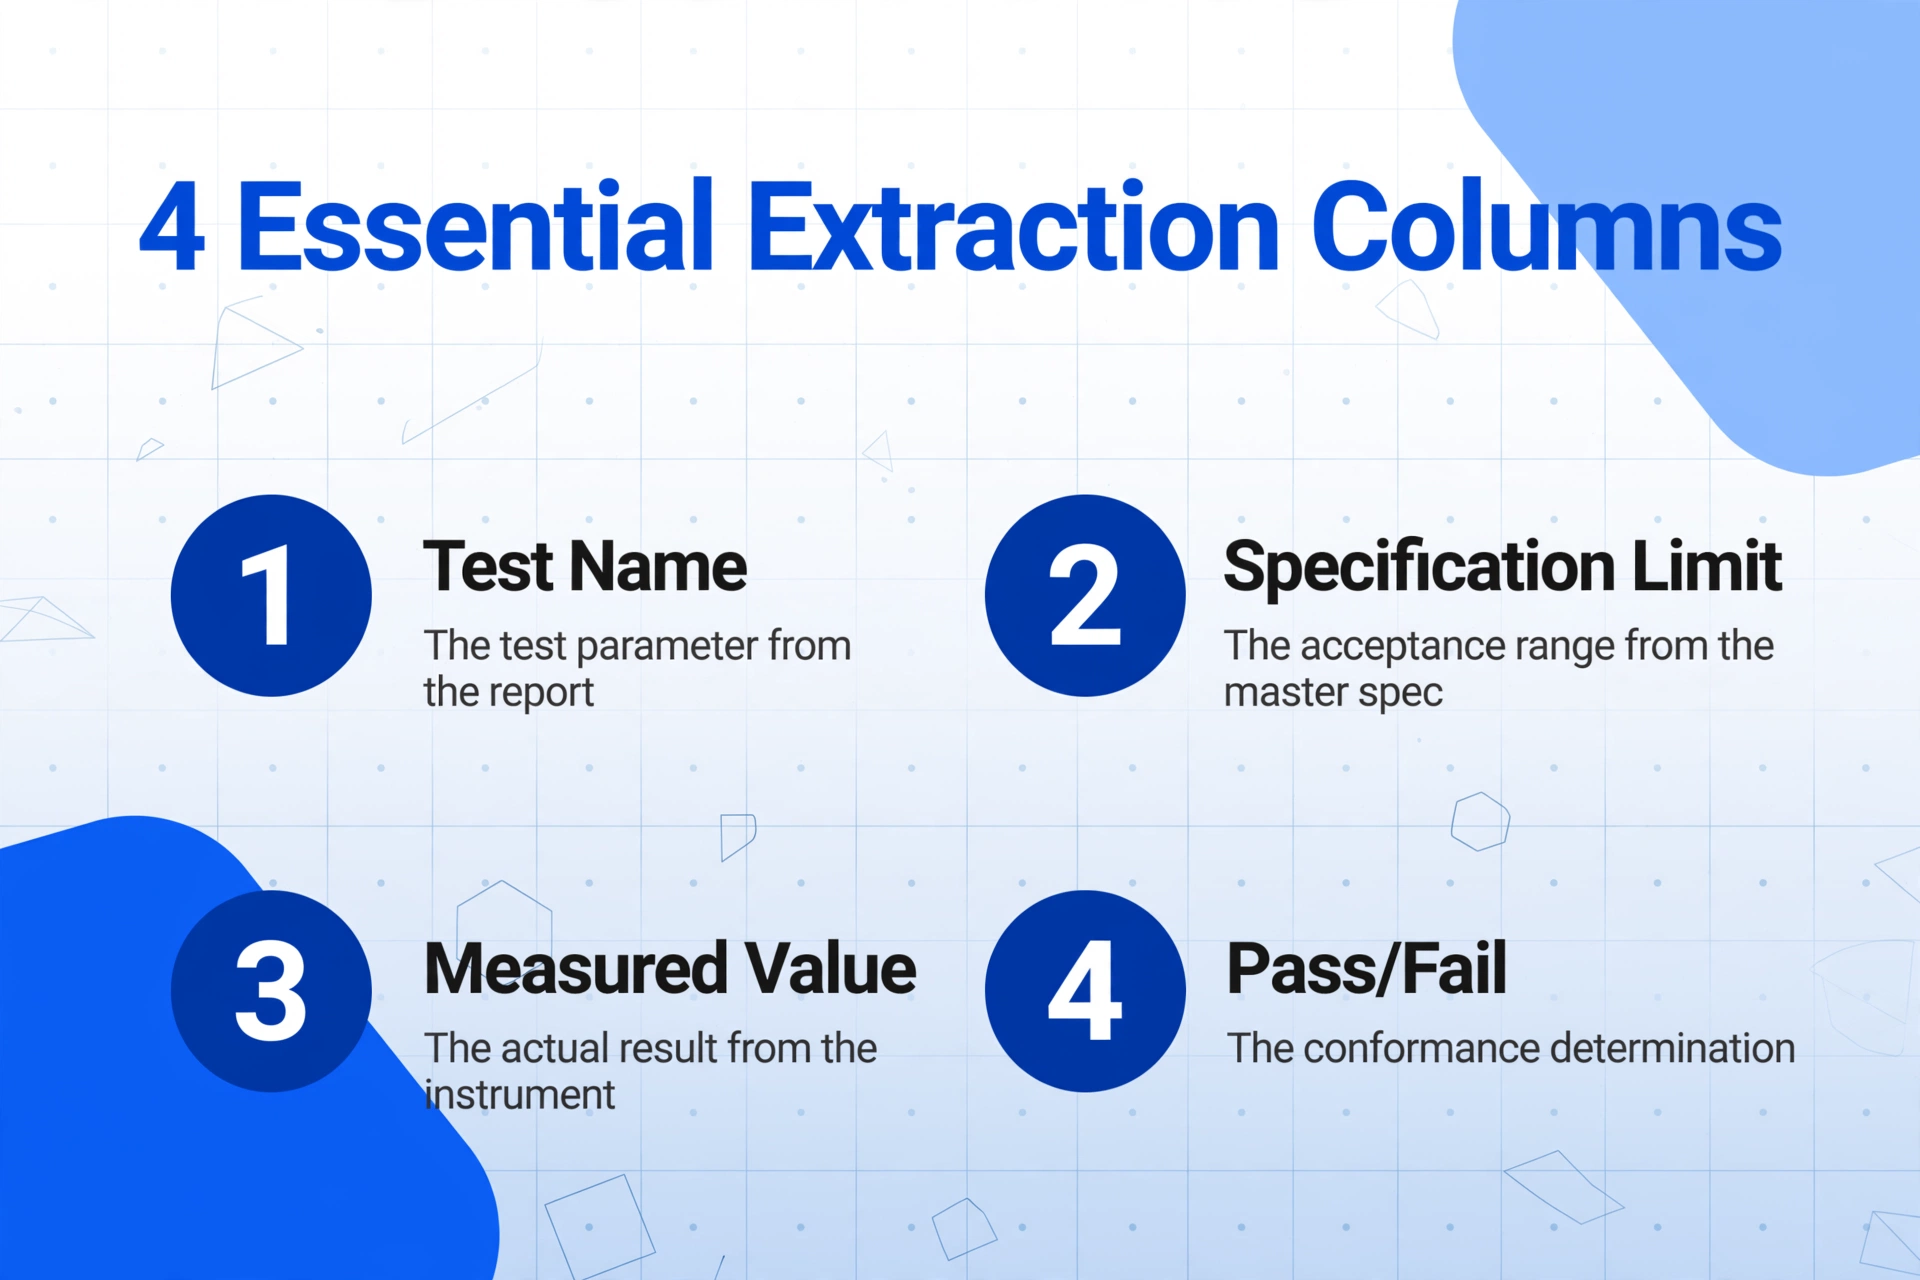
列に付けた名前がそのまま抽出される列になります。これはワークフロー全体で最も重要な設計上の決定です。これを正しく設定すれば、出力は再フォーマットなしでそのままSPCワークブックに取り込めます。
完成品のリリース試験レポートの場合、必須の列は次のとおりです。
| 列名 | 取得内容 | 値の例 |
|---|---|---|
| テスト名 | レポートからのテストパラメータ | pH、粘度、アッセイ、溶出 |
| 規格限界 | マスター仕様からの許容範囲 | 5.0~7.0、NLT 98.0% |
| 測定値 | 機器からの実際の結果 | 6.32、99.1% |
| 合格/不合格 | 適合判定 | 合格、不合格 |
工程内テストの場合は、「サンプルポイント」「ターゲット」「オペレーター」を追加することもできます。原材料の受入検査の場合は、「ロット番号」と「サプライヤー」を追加します。列名は自由形式です。Excelワークブックで列にラベルを付けるのと同じように記述すれば、AIが各レポートで見つけた内容に意味的に照合します。
測定可能な違いを生む実用的なヒントを2つ紹介します。
自動判定には計算列を使用します。 レポートから合格/不合格ステータスを抽出する代わりに(印刷されていない場合もあります)、それを計算列として定義します。AIが測定値を規格限界と比較し、「合格」または「不合格」を自動的に出力します。これにより、抽出ステップから判断の余地がなくなり、すべてのレポートでルールが一貫して適用されます。計算列は算術演算も処理できます。材料コンポーネントの場合は「ライン合計(数量×単価)」、工程内チェックの場合は「偏差(測定値-ターゲット)」として列を定義します。
テスト方法に合わせて有効数字を揃えます。 ASTM E29は、テストデータにおける有効数字の使用に関する標準的な慣行であり、報告される値はテスト方法の精度を反映し、規格限界と測定値は、誤解を招く精度の主張を避けるために同じ有効桁数で表現されるべきであると規定しています。溶出方法が小数点以下1桁で報告する場合、抽出列は(SPCチャートの表示も)小数点以下1桁で取得する必要があります。機器の生の出力が提供する小数点以下6桁ではありません。ルール形式機能(ログインユーザーが利用可能)を使用して、列ごとにフォーマット要件(小数点以下の桁数、単位規則、期待値範囲)を設定します。
ファイルは安全に処理され、保存されることはありません。
ステップ2:複数の機器からのレポートを一括処理する
最終製品のリリース判定は、単一のレポートに依存することはほとんどありません。QC部門には、HPLC分析、カールフィッシャー水分測定、溶出プロファイル、pH測定、目視検査記録が必要です。それぞれ異なる機器から得られ、それぞれ異なるPDF形式です。これらを手動でバッチごとに1行のスプレッドシートにまとめるのは、すべてが順調に進んでも面倒な作業です。機器が使用中のために1つのレポートが遅れると、照合作業は数時間に及ぶこともあります。
バッチ処理は、個々のドキュメントではなく、レポートのバッチを作業単位として扱うことでこの問題を解決します。特定のバッチのすべてのレポートを一度にアップロードします。Shimadzu LabSolutionsのエクスポートからのPDF、古い機器からのスキャンしたプリントアウト、スタンドアロンテスターの表示パネルの電話写真などもドラッグ&ドロップするだけで、システムがまとめて処理します。出力は、各行が1つのレポートに対応し、抽出されたデータで列が埋められた単一のテーブルです。2番目の出力シートは、すべてをバッチごとに1行にまとめ、テスト結果を列として表示します。
これは、一度に1つのファイルを処理する単一ドキュメント抽出ツールとは根本的に異なるワークフローです。バッチファースト設計では、複数ファイル処理がデフォルトであり、後付けではありません。20件のレポートをアップロードすると、1つのExcelファイルが返されます。20個の別々のファイルを取得して、マスタースプレッドシートにコピー&ペーストする必要はありません。(製造業におけるバッチドキュメント処理に関連するシナリオについては、製造原価管理のための原材料請求書のバッチ処理に関するガイドもご覧ください。)
実際のラボワークフロー:朝のシフトは午前7時から午前10時の間にすべてのリリーステストを実行します。10時15分までに、すべての機器レポートがPDFで利用可能になります。それらを1つのバッチでアップロードし、列名を一度指定すると、抽出はすべてのレポートで同時に実行されます。10時17分までに、検証用の統合Excelテーブルが準備完了です。タイピングに費やされていた時間は、今ではレビューに費やされています。これは、キーストロークではなく判断力を必要とするタスクです。
ステップ3:SPCチャートに反映する前に結果を検証する
AIによる抽出システムであれ、他の方法であれ、あらゆる文書に対して100%正確な抽出システムは存在しません。責任あるアプローチは、ワークフローに検証ゲートを組み込むことです。つまり、抽出とSPCアップロードの間に、AIが生成したすべての項目を1行ずつ再チェックするのではなく、迅速な人間によるレビューステップを設けるのです。
AIが注意を要する箇所を強調表示するため、検証ステップは迅速に完了します。測定値が規格限界を外れた場合、合否欄に「不合格」と表示され、その行が視覚的に強調されます。AIが特定のフィールドについて不確かな場合(かすれた印刷物や特殊なレイアウトの報告書からの低信頼度読み取り)、そのセルが手動検証用に強調表示されます。テーブル全体ではなく、例外のみをレビューします。これは、例外レビューの原則と同じです。この方法は、製薬のバッチリリースにおいて、QAがすべての適合フィールドをチェックするのではなく、フラグが立った逸脱に焦点を当てる方法として、ますます採用されています。
適切な検証ステップの内容は、規制環境によって異なります。ISO 17025認定ラボの場合、分析証明書(CoA)に反映されるすべての値は、元の機器データにトレーサブルである必要があり、抽出値の修正はすべて文書化されなければなりません。抽出システムの出力は、技術者が手入力するのと同様の初期データ取得として機能し、検証された値が正式な記録となります。非認定ラボの場合、行の10~20%のスポットチェックと、フラグが立ったすべての例外の完全レビューを組み合わせることで十分なことがよくあります。
規制環境における実用的なワークフローの一例:AI抽出データをエクスポートし、フラグが立った行をレビューし、必要な修正を加え、レビュー済みバージョンを管理記録として保存します。元の抽出出力は中間データ成果物として保持されます。これは公式記録ではありませんが、疑問が生じた場合の監査証跡の再構築に役立ちます。
ステップ4:クリーンデータをSPCプラットフォームに取り込む
ここが抽出ワークフローの真価を発揮する場面です。検証済みのExcel出力は構造化データです。列ヘッダーはSPCパラメータ名と一致し、行はバッチやサンプルに対応し、数値は一貫性があり適切にフォーマットされています。これを工場で使用しているSPCシステムに直接読み込むことができます。
Minitab Real-Time SPC(50年の統計手法に裏打ちされた業界標準)を使用している場合、エクスポートされたCSVまたはExcelファイルを管理図プロジェクトに直接インポートできます。サブグループを定義し、列を割り当てれば、Xbar-R管理図やI-MR管理図が新しいデータで更新されます。MinitabとSAP Digital Manufacturingの連携により、大規模な運用では、抽出からERP、SPCダッシュボードまでのデータフローを人手を介さずに行えます。
InfinityQS ProFicient(航空宇宙、自動車、医療機器製造で導入されているオンプレミスSPCのリーダー)を使用している場合、構造化データ形式はデータインポート仕様に適合します。ProFicientのデータ収集モジュールは区切りファイルを受け付けるため、抽出出力に変換は不要です。
QI Macros付きExcelや自作のXbar-Rテンプレート(多くの中小メーカーが使用)を使用している場合、抽出データをテンプレートのデータグリッドに直接貼り付けられます。管理図の数式はデータセルを参照し、新しい抽出出力が前のバッチの値を置き換えます。再入力、フォーマット修正、バッチ4267のpH結果がどのセルにあるかを探す手間は一切不要です。
異なる試験パネルを持つ複数の製品を扱うラボでは、製品ごとに個別の抽出列テンプレートを維持してください。列定義(どの試験、どの規格、どのフォーマットルールか)はバッチ間で一貫しており、変更されるのはレポートPDFのみです。これによりSPC管理図の連続性が保たれます。過去データから計算された管理限界は、データが毎回同じ構造で供給されるため、有効性を維持します。
転記なしでQCデータが流れると何が変わるか
転記工程をなくすことは、単にタイピング時間を節約するだけではありません。ラボ、QA、生産の関係性を再構築します。
バッチリリースが加速します。 試験データが機器からSPCワークブックに数分で移動すれば、QAレビューアはラボが次のバッチを処理している間に作業を開始できます。レビューは「誰かが正しく入力したか」から「このデータはバッチについて知るべきことを教えてくれるか」に変わります。週に20バッチをリリースする工場では、1バッチあたり2時間の短縮で、週40時間の生産能力が解放されます。これは、設備や人員を増やさずに追加シフト分の生産量を得ることに相当します。
SPCシグナルの信頼性が向上します。 管理図は、その背後にあるデータの質に依存します。転記ミスによりデータポイントが管理限界外になると、原因不明の異常調査が発生し、エンジニアリング時間を無駄にします。数ヶ月の運用で、これらの誤警報はオペレーターのSPCシステムへの信頼を損ないます。オペレーターが管理図は「いつもオオカミ少年だ」と信じると、本当のシグナルを無視します。機器からSPCチャートへの直接データフローは、誤った異常シグナルの最も一般的な原因である人間のキー入力エラーを排除します。
監査対応が緊急ではなくなります。 ISO 9001およびISO 17025の監査人はデータの完全性、すなわちALCOA+の原則(帰属可能性、判読可能性、同時性、原本性、正確性)を求めます。手動で転記されたスプレッドシートは、「同時性」(測定から数時間後に入力される可能性がある)と「原本性」(機器の生出力が原本であり、スプレッドシートはコピーである)に違反します。試験完了時にレポートを処理し、出力にタイムスタンプを付ける抽出ワークフローは、同時性があり帰属可能なデータトレイルを作成します。監査人が「3月のバッチ3267の生データを見せてください」と尋ねたとき、手動で入力された管理責任のないスプレッドシートではなく、元の機器PDFと抽出タイムスタンプを提示できます。
技術者の時間がより価値の高い作業に移行します。 QC技術者は、シフト中に数字を入力するために化学や工学を学んだわけではありません。転記から解放されれば、より多くの試験を実施し、境界線上の結果を調査し、機器を保守し、新しいメソッドのトレーニングを受けることができます。4~6人の技術者がそれぞれ毎日45~90分をデータ入力に費やすラボでは、週に15~27時間が回復します。これは、フルタイム従業員の約半分の生産能力に相当し、キー入力から科学へと振り向けられます。
成熟した品質管理システムを持つ企業は、ASQの調査によると、納期遵守率92%を達成しており、持たない企業の74%を上回ります。その差は、より速い機械ではなく、データがタイピングの速度ではなく、意思決定の速度で動くことにあります。
AIベースの抽出が製造環境における従来のアプローチとどのように比較されるかについては、製造業向け文書抽出ツールのまとめと、品質検査レポートデータをExcelに抽出する実践ガイドをご覧ください。
よくある質問:QCラボレポートのExcel抽出について
島津、アジレント、メトラー・トレドなど、異なるメーカーの機器レポートにも対応できますか?
はい。抽出は位置(ページ上の配置)ではなく意味(値の意味の理解)に基づくため、同じ列名が異なる機器のレポート間で機能します。メトラー・トレドのレポートの「pH」値と島津のレポートの「pH」値は、レイアウトがまったく異なっていても、どちらも取得されます。これが、複数機器のラボにおけるテンプレート不要抽出の実用的な利点です。
機器レポートがデジタルPDFではなく、スキャンした紙の印刷物の場合はどうなりますか?
本システムは、スキャン文書や写真をネイティブPDFと同様に処理します。サーマルプリンター出力のスマホ写真、手書きのログブックのスキャン、機器ソフトウェアからエクスポートしたPDFなど、すべて同じ抽出パイプラインを経由します。AIはソース形式に関係なく視覚的な内容を読み取ります。画質は重要です。鮮明で明るいスキャンや写真は、影があったり傾いたスナップ写真よりも信頼性の高い抽出結果をもたらします。
手書きの結果や修正が含まれるレポートはどう処理しますか?
印刷されたレポートに手書きの値が含まれることは、技術者が機器の出力に注釈を付ける(結果を丸で囲む、余白にメモを書く、欠落フィールドを記入する)ラボでは一般的です。視覚言語モデルは、印刷テキスト、手書き文字、および混在コンテンツの文書を読み取ることができます。手書き文字の認識精度は印刷テキストよりも低いため(人間の読者と同様)、手書きフィールドはレビュー工程での検証チェックが有効です。
GMP規制環境(21 CFR Part 211)でも機能しますか?
このツールはデータを処理するものであり、品質システムを代替するものではありません。GMP環境では、抽出出力は中間工程(技術者の手書きワークシートに類似)として扱う必要があります。バリデーションされ承認された記録は、バッチレコードやCoAに記載されるバージョンです。GMPラボにとっての価値提案はスピードです。技術者が転記に45分費やしてからでないとQAがレビューを開始できない代わりに、抽出は数秒で初期データセットを生成します。その後、QAがレビュー、検証、承認を行います。同じプロセスですが、手動入力ではなく機械生成の初稿から始まります。
同じバッチの試験報告書で合否結果が異なる場合はどうなりますか?
抽出システムは読み取った内容をそのまま報告します。矛盾する結果を調整することはありません。同じパラメータに対して報告書Aが「合格」、報告書Bが「不合格」と示した場合、両方の値が出力に表示されます。この矛盾は検証時に表面化しますが、それはまさに表面化すべきタイミングです。これは手動入力よりも優れた点です。手動入力では、技術者が矛盾に気づいて黙って「修正」し、監査証跡を削除してしまう可能性があります。抽出ワークフローは元のデータを保持します。解決(再試験、調査、逸脱報告)は人間の判断に委ねられます。
製品ファミリーごとに異なるカラムテンプレートを設定できますか?
はい。製品または製品ファミリーごとに独自のカラム定義セットを持つことができます。錠剤のリリース試験用、原材料検査用、工程内チェック用など、それぞれテンプレートを作成できます。テンプレートはアカウントに保存され、新しい処理バッチを開始する際に選択できます。これにより、多様な製品ポートフォリオを持つラボは、毎回カラムを再定義することなく、試験固有のSPC追跡を維持できます。
データ入力自動化のためにLIMSを購入するのと比べてどうですか?
LIMS(ラボ情報管理システム)は、サンプル追跡、試験スケジューリング、機器統合、コンプライアンスワークフローを管理する包括的なプラットフォームです。予算とITサポートがある大規模な規制対象ラボには適切なツールです。しかし、LIMSの導入には通常5万~20万ドル以上の費用がかかり、展開に6~18ヶ月を要します。中小規模のQCラボ(製造工場の大半)にとって、その価格と期間は法外です。抽出ベースの自動化は、本格的なLIMS移行のオーバーヘッドなしに、報告書からスプレッドシートへのデータ取得という特定の課題に対処します。多くのラボにとって、組織の混乱を伴わずに測定可能な改善をもたらす実用的なステップです。