So extrahieren Sie QC-Labberichte
in Excel für SPC
Die tatsächlichen Kosten der manuellen QC-Labordateneingabe liegen nicht im Tippen. Sie liegen in der Lücke zwischen dem Moment, in dem das letzte Testergebnis vom Gerät kommt, und dem Moment, in dem eine befugte Person die Charge freigibt. In einem typischen Fertigungswerk beträgt diese Lücke 4 bis 8 Stunden—nicht weil der Test lange dauert, sondern weil die Daten aus einem PDF-Bericht in eine Tabellenkalkulation übertragen, dann von einem Vorgesetzten geprüft und dann von der QA erneut kontrolliert werden müssen, bevor jemand eine Freigabeentscheidung treffen kann. In der Zwischenzeit wartet die Produktion. Jede Stunde Verzögerung, nachdem eine Charge versandbereit ist, kostet echtes Geld in Form von Betriebskapital, Lagerfläche und Kundenterminen. Der Übertragungsschritt—der Schritt, bei dem ein Techniker Zahlen aus einem Geräteausdruck in Excel tippt—ist der Engpass, den niemand einplant.
Wichtigste Erkenntnisse
- 40 % der QC-Datensätze mit Zwei-Personen-Eingabe enthalten Fehler, unabhängig davon, wer sie eingibt – die Übertragungsfehler in Ihrer SPC-Arbeitsmappe sind kein Problem der Nachlässigkeit, sondern eine strukturelle Garantie.
- Jedes Phantom-Außerkontrollsignal, das durch einen Tippfehler ausgelöst wird, trainiert Ihre Bediener, das SPC-Diagramm zu ignorieren – und sobald sie gelernt haben, dass es immer falschen Alarm schlägt, verschwinden die echten Qualitätssignale im Rauschen.
- Ihre Techniker haben Chemie und Ingenieurwesen studiert, um Tests durchzuführen, nicht um Zahlen zu tippen – ersetzen Sie 90 Minuten tägliche Übertragung durch ein 10-minütiges Validierungsgate, und die gewonnenen Stunden fließen zurück in die Wissenschaft.
Die versteckten Kosten der manuellen Labordatenerfassung
Fragen Sie einen QC-Manager, was die Chargenfreigabe verlangsamt, und er wird sagen: „Warten auf Testergebnisse.“ Doch die Ergebnisse liegen innerhalb von Minuten vor, nachdem die Probe das Gerät erreicht hat. Worauf sie wirklich warten, ist die Dateneingabe. Der Shimadzu-HPLC beendet seinen Lauf und druckt (oder exportiert) einen PDF-Bericht mit 15 Testparametern. Der Mettler-Toledo-Titrator schließt seine Analyse ab und erzeugt eine weitere PDF. Der Instron-Zugprüfer liefert eine dritte. Jemand muss nun die Zahlen aus jedem dieser Berichte ablesen und in eine Excel-Arbeitsmappe eintippen. Dieser Schritt dauert routinemäßig länger als die Tests selbst und führt zu Fehlern, die sich nachgelagert auswirken.
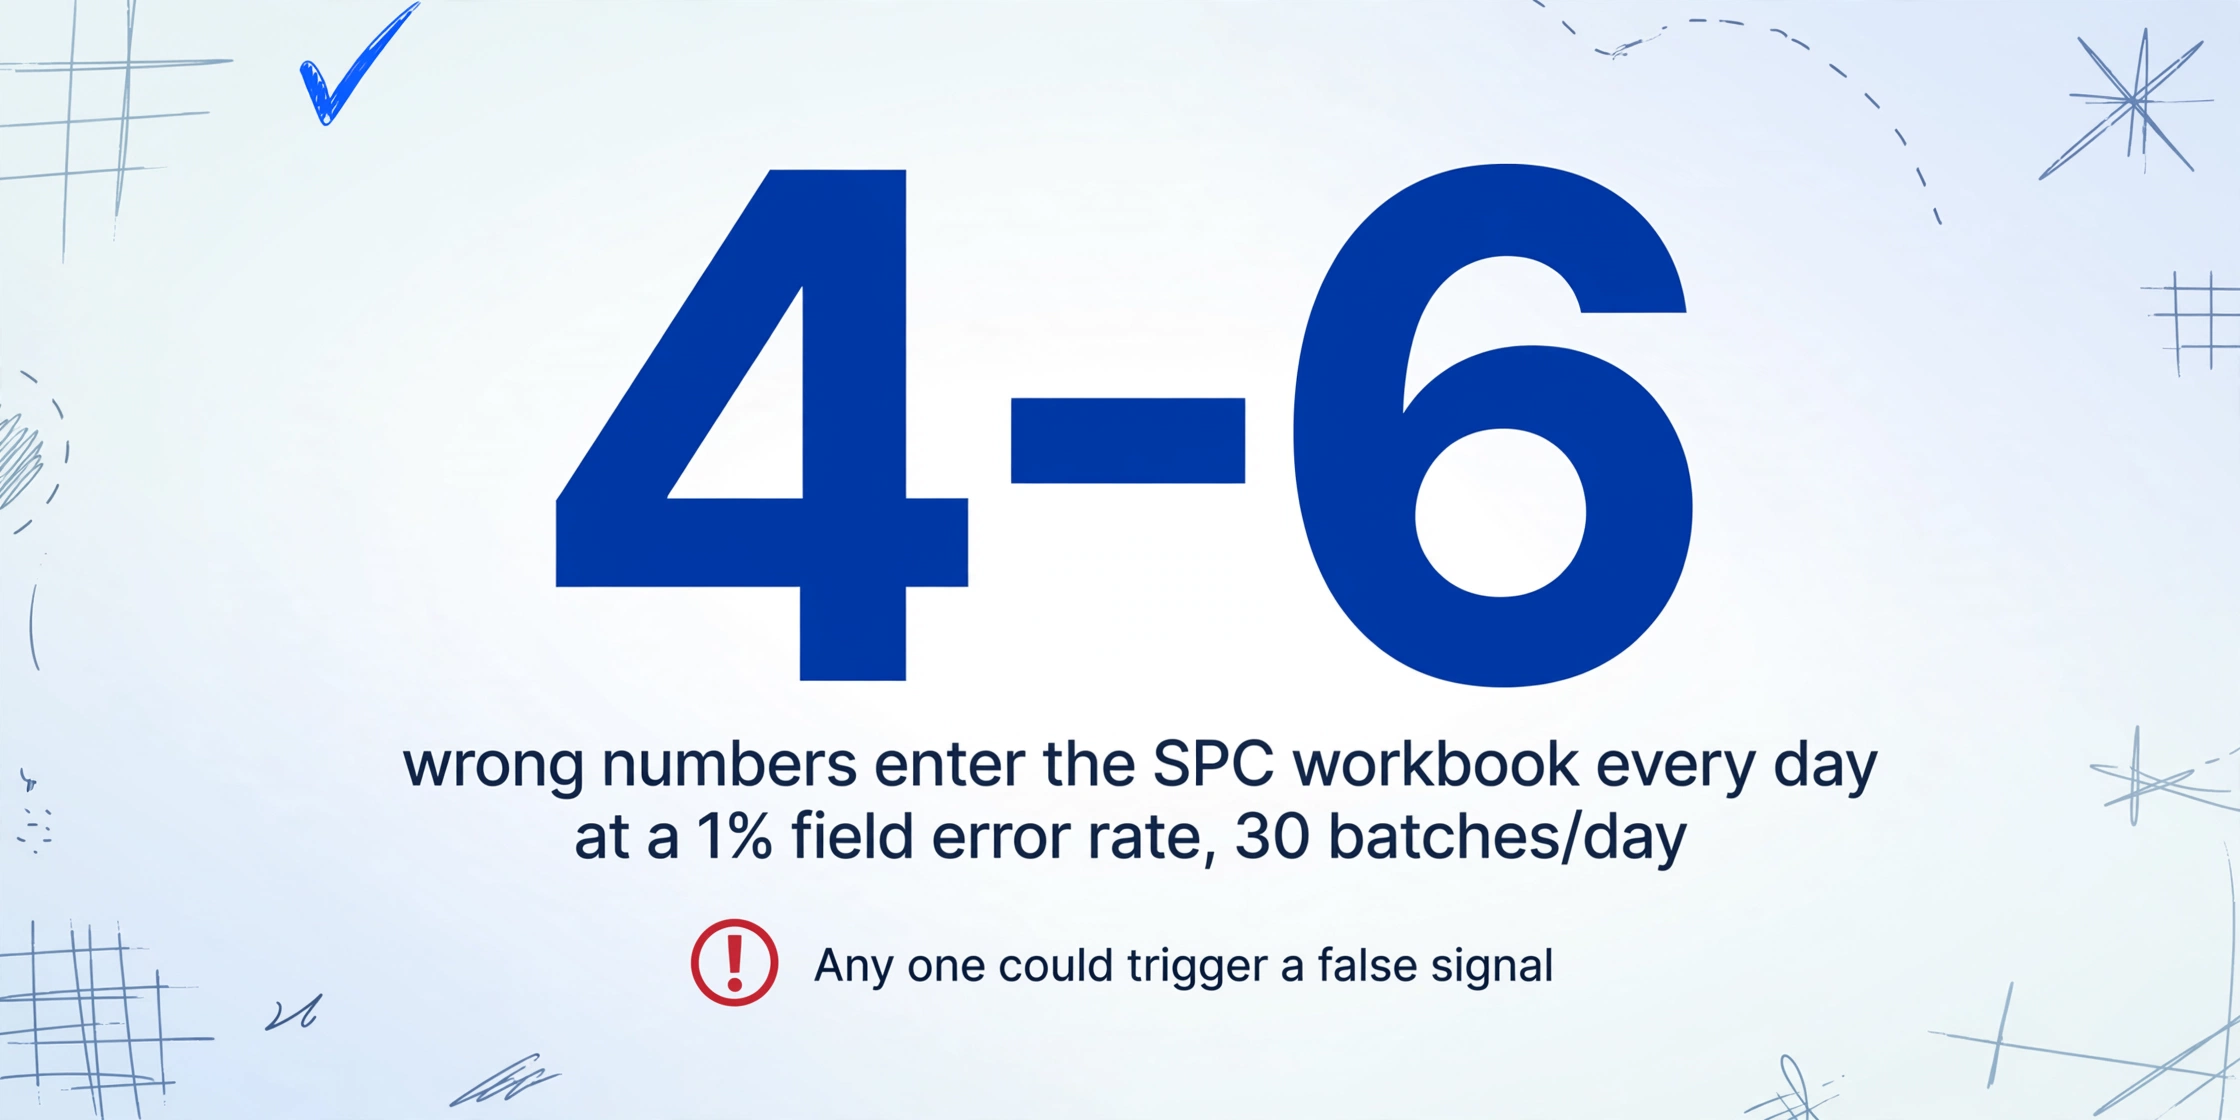
Die Fehlerraten sind gut dokumentiert. Eine von Quality Magazine zitierte Studie beziffert die grundlegende Fehlerrate bei manueller Dateneingabe auf etwa 1 % pro Feld. Das klingt beherrschbar, bis man die Rechnung aufmacht: Ein Freigabebericht für ein Endprodukt kann 15–20 Testparameter enthalten. Wenn ein Labor 30 Chargen pro Tag verarbeitet, sind das 450–600 Feldeinträge. Eine Feld-Fehlerrate von 1 % bedeutet 4–6 falsche Zahlen pro Tag, die in die SPC-Arbeitsmappe gelangen—jede einzelne davon könnte ein Out-of-Control-Signal auslösen, eine ungerechtfertigte Chargensperrung oder die Freigabe von Material, das hätte durchfallen müssen.
Und das ist das optimistische Szenario. Fertigungs-QC-Labore mit papierbasierten Arbeitsabläufen betreiben ein zweistufiges Eingabesystem: Der Techniker notiert einen Messwert auf Papier am Gerät, dann überträgt jemand—oft derselbe Techniker oder eine andere Person—diesen Messwert in die Tabellenkalkulation oder Datenbank. Laut Beamex enthalten bei zwei manuellen Eingabepunkten grob 40 % der Datensätze mindestens einen Fehler. Ein Werk, das 10.000 Kalibrierungen oder Qualitätstests pro Jahr mit zweistufiger Eingabe durchführt, erzeugt statistisch gesehen 4.000 fehlerhafte Datenpunkte.
Für ein einzelnes QC-Labor, das 30 Chargenfreigabetests pro Tag verarbeitet, bedeutet eine Feld-Fehlerrate von 1 % 120–180 Übertragungsfehler pro Monat—jeder davon erfordert Untersuchung, Nacharbeit und verzögerte Freigabeentscheidungen.
Wie QC-Laborberichte heute vom Gerät in die Tabelle gelangen
Betritt man ein QC-Labor in der Fertigung, ist der Arbeitsablauf branchenübergreifend bemerkenswert einheitlich – ob Pharma, Automobil, Lebensmittel, Medizintechnik oder Chemie. Ein Gerät wie ein Shimadzu HPLC oder ein Mettler Toledo Karl-Fischer-Titrator schließt seine Analyse ab und erstellt einen Bericht. In modernen Laboren kommt dieser als PDF aus der Gerätesoftware – Shimadzu LabSolutions, Mettler Toledo LabX oder Agilent OpenLab. In älteren Einrichtungen ist es ein Thermodruck, der in ein Logbuch geklebt wird. In beiden Fällen sind die Daten in einem Dokument eingeschlossen, das nicht abgefragt, grafisch dargestellt oder statistisch ausgewertet werden kann.
Der nächste Schritt ist die Übertragung. Ein QC-Techniker liest den Bericht und gibt die Werte in eine Tabelle ein: Prüfbezeichnung, Spezifikationsgrenze, Messwert, Bestanden/Nicht bestanden. Wenn das Werk Minitab, InfinityQS ProFicient oder JMP für SPC nutzt, gehen die Daten direkt in diese Plattformen. In kleineren Betrieben – also den meisten Fertigungsstätten – ist das Ziel jedoch eine Excel-Arbeitsmappe mit Regelkartenvorlagen, die oft vor Jahren von einem Qualitätsingenieur erstellt wurde, der das Unternehmen inzwischen verlassen hat.
Dieser Übertragungsschritt liegt an der Schnittstelle zweier Qualitätssysteme, die nie dafür ausgelegt waren, miteinander zu kommunizieren: den Labormessgeräten, die Daten erzeugen, und der SPC-Plattform, die sie verarbeitet. Dazwischen liegt eine menschliche Brücke – und genau dort konzentrieren sich Fehler und Verzögerungen. Die American Society for Quality (ASQ) schätzt, dass die Kosten schlechter Qualität (COPQ) 15 % bis 40 % des Gesamtumsatzes eines Herstellers ausmachen – und ein erheblicher Teil davon auf Datenintegritätsfehler zurückgeht, die auf manuelle Übertragung zurückzuführen sind.
Regulatorische Rahmenwerke unterstreichen die Bedeutung dessen. ISO 9001:2015 Klausel 7.5 verlangt, dass Organisationen dokumentierte Informationen als Nachweis der Konformität aufbewahren, einschließlich der Rückverfolgbarkeit zur freigebenden Person. ISO/IEC 17025:2017 Abschnitt 8.4 schreibt vor, dass Prüflaboraufzeichnungen genügend Informationen enthalten müssen, um eine Prüfung unter möglichst originalgetreuen Bedingungen zu wiederholen – und dass jede Korrektur einer Aufzeichnung den ursprünglichen Eintrag nicht verdecken darf. FDA 21 CFR Part 211 Subpart J verlangt, dass Chargenproduktions- und Laborprüfaufzeichnungen vor der Chargenfreigabe von einer Qualitätskontrolleinheit geprüft und genehmigt werden. Bei manueller Übertragung wird jede dieser Anforderungen schwerer zu erfüllen. Ein Prüfer, der die Rückverfolgbarkeit prüft, findet möglicherweise einen Wert im Gerätelog und einen anderen in der übertragenen Tabelle – ohne dokumentierte Begründung für die Abweichung.
Dies ist nicht nur ein Papierproblem. Laut Tulip schätzt EY, dass mehr als 70 % des QA-Aufwands für die Prüfung von Dokumentation aufgewendet werden – nicht für Untersuchungen, nicht für Prozessverbesserungen, sondern nur für die Überprüfung von Aufzeichnungen. Verzögerte Chargenfreigabe gehört zu den drei häufigsten Ursachen für Unterbrechungen der Lieferkette in der Pharmaproduktion. Jede Stunde, die eine Charge in Quarantäne auf die Datenverifizierung wartet, ist eine Stunde gebundenes Betriebskapital.
Was semantische Extraktion bei der Labordateneingabe verändert
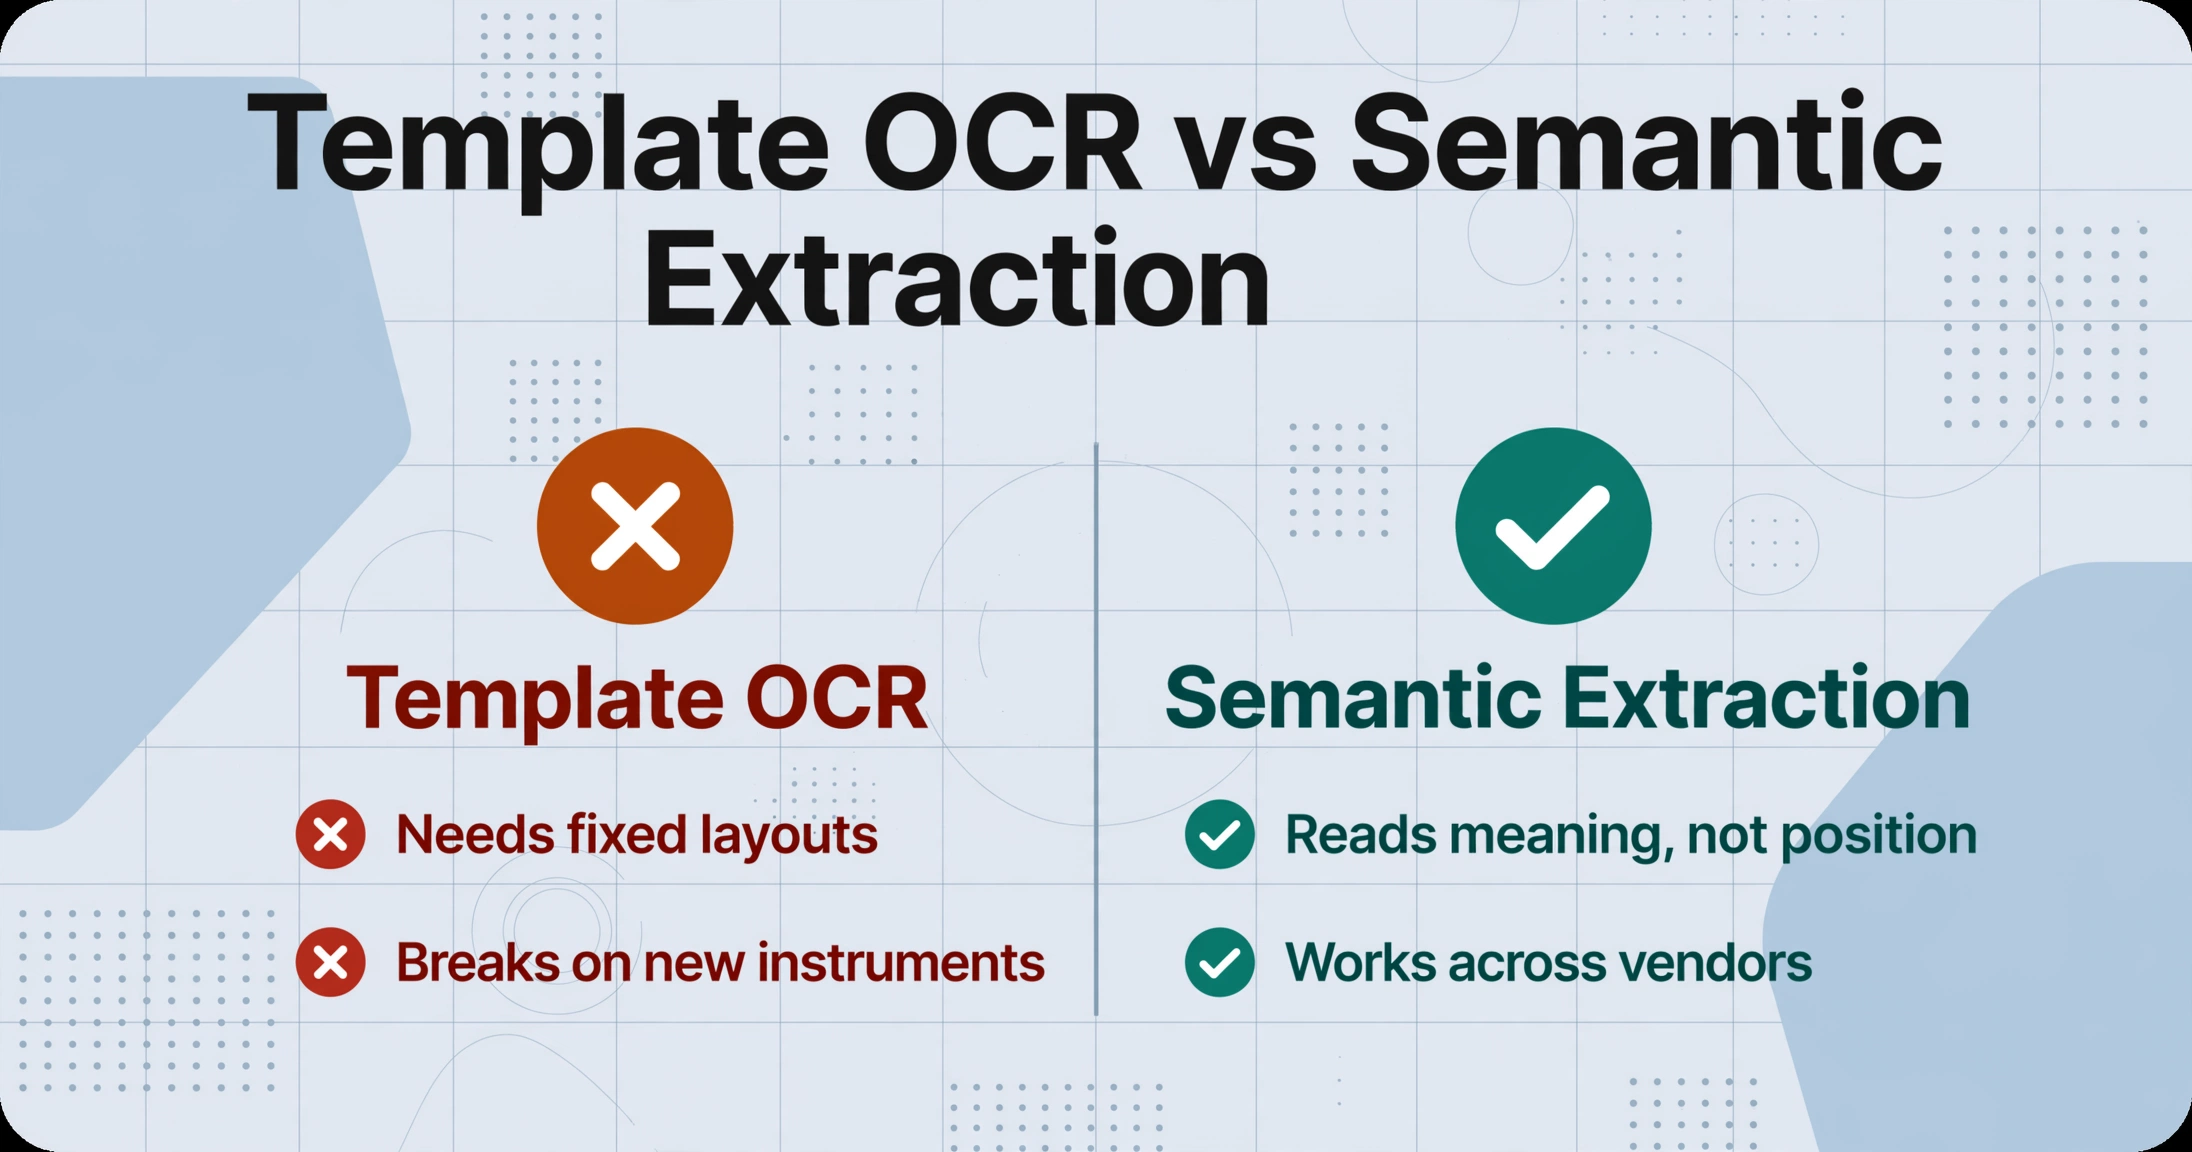
Der eigentliche Engpass liegt nicht darin, dass QC-Berichte schwer zu lesen sind. Sondern darin, dass der traditionelle Ansatz zu ihrer Automatisierung—templatebasierte OCR—schlecht zur Realität eines Labors mit mehreren Instrumenten passt. Vorlagen funktionieren, wenn jedes Dokument gleich aussieht. Aber ein Shimadzu-HPLC-Bericht, ein Mettler-Toledo-Titratorausdruck und ein Instron-Zugversuchs-PDF haben grundlegend unterschiedliche Layouts: unterschiedliche Spaltenpositionen, unterschiedliche Feldbenennungskonventionen, unterschiedliche Maßeinheiten. Das Erstellen und Pflegen einer Parsing-Vorlage für jede Instrument-Modell-Bericht-Kombination ist selbst eine Vollzeitaufgabe—weshalb die meisten Labore es nicht tun und bei der manuellen Eingabe bleiben.
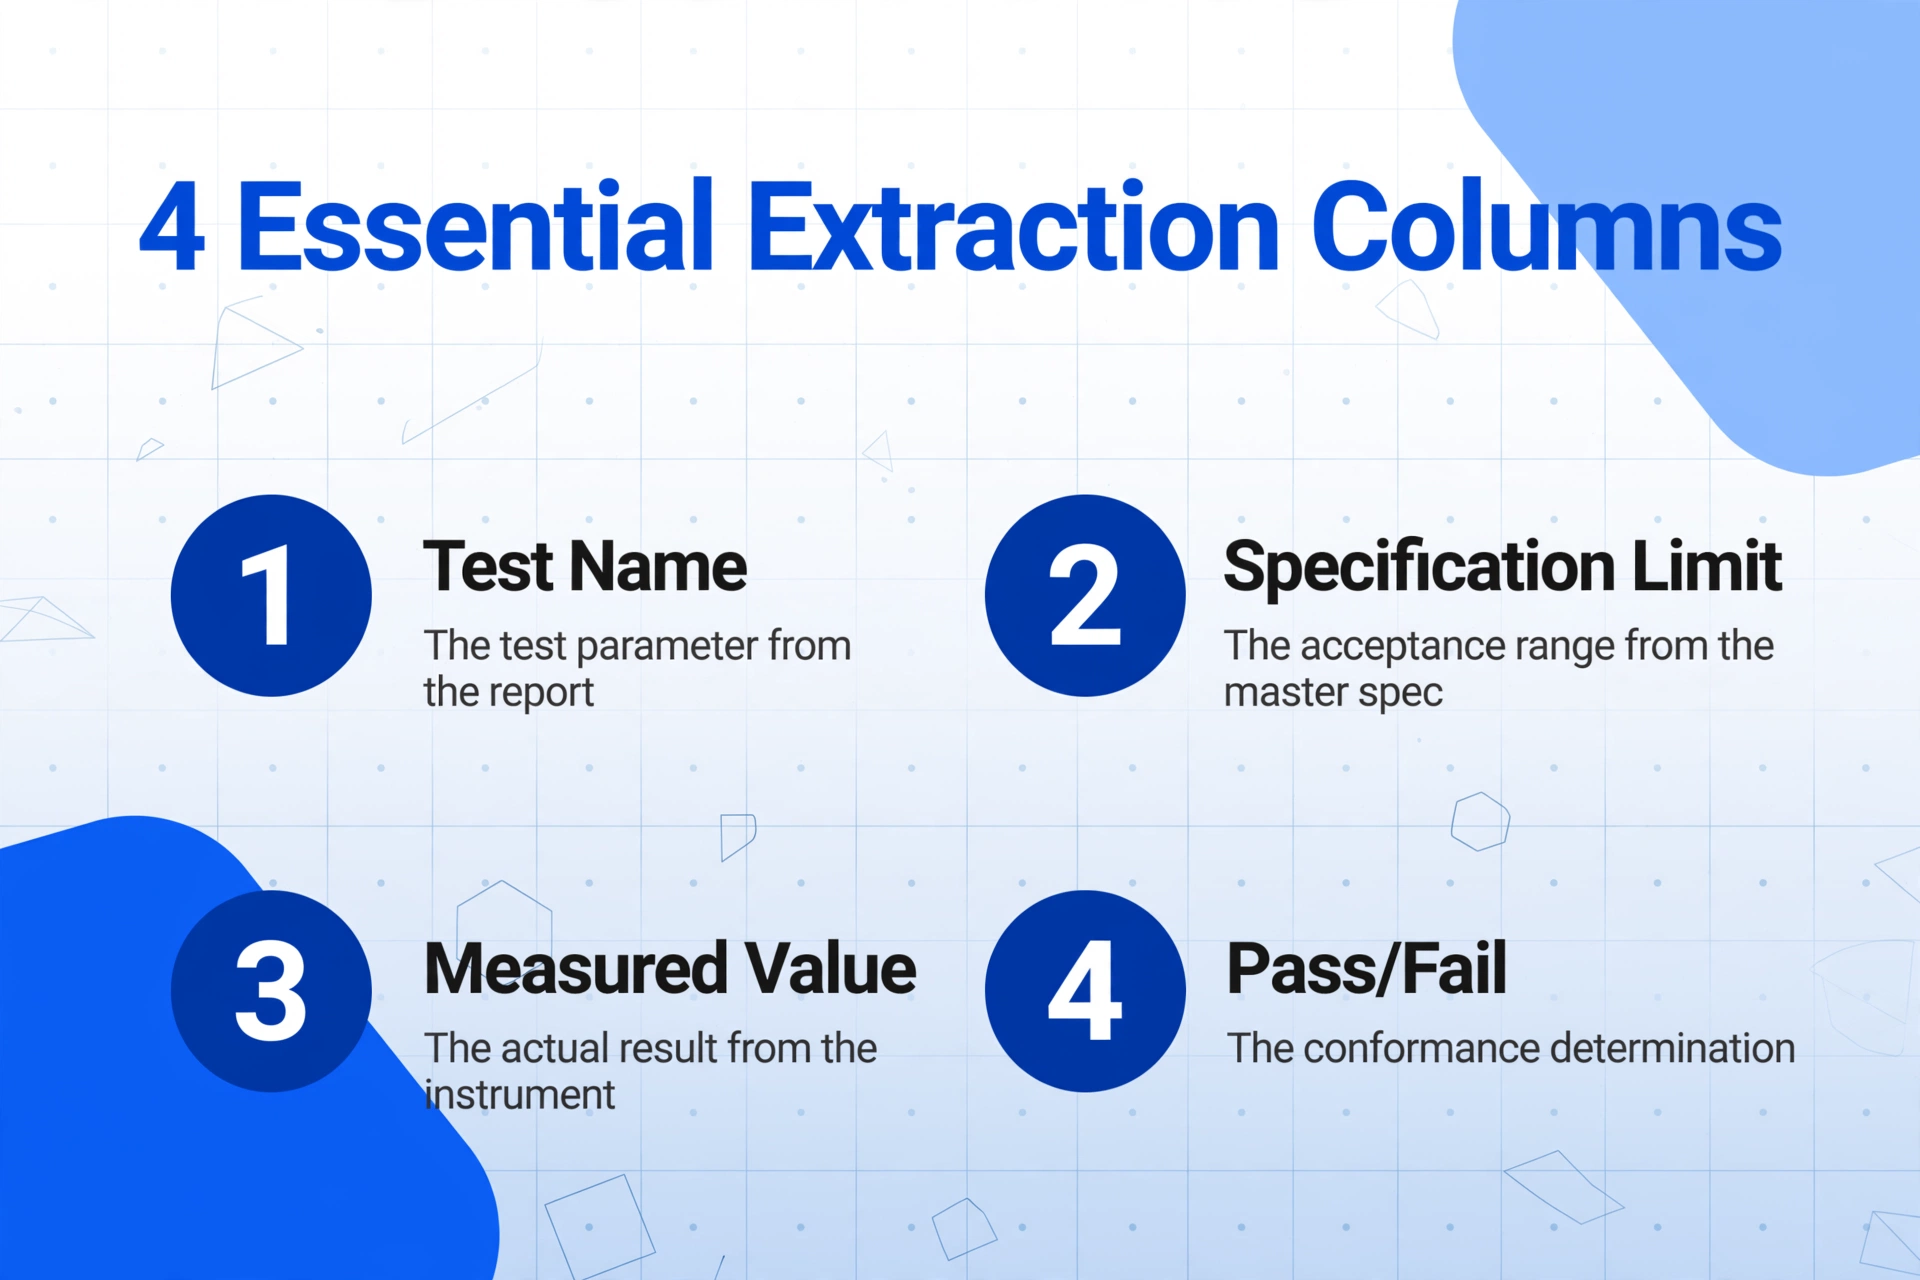
Semantische Extraktion verfolgt einen anderen Ansatz. Statt zu definieren, wo Daten auf einer Seite stehen (Zeile 3, Spalte 2), geben Sie an, was Sie suchen (einen Wert namens „pH" oder „Zugfestigkeit" oder „Assay %"). Die KI liest das Dokument so, wie es ein Techniker tun würde—indem sie versteht, was Wörter im Kontext bedeuten, nicht durch Koordinatenabgleich. Dieser Ansatz wird manchmal als Benutzerdefinierte Spaltenextraktion bezeichnet: Sie geben die Feldnamen, die Sie als Spaltenüberschriften möchten, ein—„Testname", „Spezifikationsgrenze", „Messwert", „Bestanden/Nicht bestanden"—und die KI lokalisiert die entsprechenden Werte in jedem Bericht, unabhängig davon, wo sie erscheinen.
Das ist für QC-Labore wichtig, weil sich Berichtslayouts nicht nur zwischen Instrumentenherstellern unterscheiden, sondern auch zwischen Testmethoden, die auf demselben Instrument ausgeführt werden. Ein Shimadzu-HPLC-Bericht für Assay-Tests hat eine andere Spaltenstruktur als einer für Verunreinigungsprofilierung, auch wenn beide aus derselben LabSolutions-Software stammen. Bei templatebasierter Extraktion benötigt jede Variante ihre eigene Vorlage. Bei semantischer Extraktion funktioniert derselbe Satz von Spaltennamen über alle hinweg—weil die KI Bedeutung abgleicht, nicht Position.
Semantische Extraktion verschiebt das Paradigma von positionsbasiert zu bedeutungsbasiert: Sie definieren, welche Ausgabe Sie möchten, und die KI liest jedes Dokument, um sie zu finden—keine Vorlagen zu erstellen, keine formatbezogenen Regeln zu pflegen.
Das ist keine theoretische Fähigkeit. ImageToTable.ai verwendet Vision-Language-Modelle (VLMs), um eine Extraktion durchzuführen, die ohne Vorlage ist: Sie müssen keine Parsing-Vorlagen für das Berichtsformat jedes Instruments erstellen oder pflegen. Und sie ist Zero-Setup: Sie müssen keine Beispielberichte sammeln, Trainingsdaten beschriften oder Extraktionsregeln konfigurieren. Laden Sie die PDFs hoch, benennen Sie Ihre Spalten, und die KI extrahiert die Werte. Wenn Agilent nächstes Jahr das Berichtslayout in einem Software-Update ändert, funktionieren dieselben Spaltennamen weiterhin—weil die KI nach Bedeutung liest, nicht nach Koordinaten. (Für einen breiteren Überblick darüber, wie diese Technologie auf Labordokumente angewendet wird, siehe den vollständigen Leitfaden zur Labordaten-Extraktion.)
Schritt 1: Definieren Sie Ihre Testparameter als Extraktionsspalten
Die Spalten, die Sie benennen, sind die Spalten, die Sie erhalten. Dies ist die wichtigste Designentscheidung im gesamten Workflow – wenn Sie es richtig machen, fließt die Ausgabe direkt in Ihre SPC-Arbeitsmappe, ohne dass eine Neuformatierung erforderlich ist.
Für einen Freigabeprüfbericht eines Fertigprodukts sind die wesentlichen Spalten:
| Spaltenname | Was erfasst wird | Beispielwert |
|---|---|---|
| Testname | Der Testparameter aus dem Bericht | pH, Viskosität, Gehalt, Auflösung |
| Spezifikationsgrenze | Der Akzeptanzbereich aus der Masterspezifikation | 5,0–7,0, NLT 98,0 % |
| Messwert | Das tatsächliche Ergebnis vom Instrument | 6,32, 99,1 % |
| Bestanden/Nicht bestanden | Die Konformitätsbewertung | Bestanden, Nicht bestanden |
Für In-Prozess-Prüfungen können Sie „Probenahmepunkt“, „Zielwert“ und „Bedienpersonal“ hinzufügen. Für die Rohstoffprüfung fügen Sie „Chargennummer“ und „Lieferant“ hinzu. Die Spaltennamen sind frei wählbar – Sie schreiben sie so, wie Sie Spalten in einer Excel-Arbeitsmappe beschriften würden, und die KI gleicht sie semantisch mit dem ab, was sie in jedem Bericht findet.
Zwei praktische Tipps, die einen messbaren Unterschied machen:
Verwenden Sie berechnete Spalten für die automatische Bewertung. Definieren Sie den Status „Bestanden/Nicht bestanden“ anstatt ihn aus dem Bericht zu extrahieren (der ihn möglicherweise nicht immer ausweist) als berechnete Spalte: Die KI vergleicht den Messwert mit der Spezifikationsgrenze und gibt automatisch „Bestanden“ oder „Nicht bestanden“ aus. Dadurch entfallen Ermessensentscheidungen im Extraktionsschritt – die Regel wird konsistent auf jeden Bericht angewendet. Berechnete Spalten können auch Arithmetik übernehmen: Definieren Sie eine Spalte als „Positionssumme (Menge × Einzelpreis)“ für Materialkomponenten oder „Abweichung (Messwert − Zielwert)“ für In-Prozess-Prüfungen.
Stimmen Sie die signifikanten Stellen mit Ihrer Prüfmethode ab. ASTM E29, die Standardpraxis für die Verwendung signifikanter Stellen in Prüfdaten, legt fest, dass gemeldete Werte die Präzision der Prüfmethode widerspiegeln sollten und dass Spezifikationsgrenzen und Messwerte mit derselben Anzahl signifikanter Stellen angegeben werden sollten, um irreführende Präzisionsangaben zu vermeiden. Wenn Ihre Auflösungsmethode auf eine Dezimalstelle genau berichtet, sollten Ihre Extraktionsspalten (und Ihre SPC-Diagramme) ebenfalls eine Dezimalstelle erfassen bzw. anzeigen – nicht die sechs Dezimalstellen, die die Rohausgabe des Instruments möglicherweise liefert. Verwenden Sie die Funktion Regelformat (für angemeldete Benutzer verfügbar), um Formatierungsanforderungen pro Spalte festzulegen: Anzahl der Dezimalstellen, Einheitenkonventionen und erwartete Wertebereiche.
Dateien werden sicher verarbeitet und nicht gespeichert.
Schritt 2: Verarbeiten Sie Berichte mehrerer Instrumente in einem Batch
Eine einzelne Freigabeentscheidung für ein Fertigprodukt hängt selten nur von einem Bericht ab. Die QC-Abteilung benötigt den HPLC-Assay, das Karl-Fischer-Feuchteergebnis, das Auflösungsprofil, den pH-Wert und den Sichtprüfungsbericht – jedes Ergebnis stammt wahrscheinlich von einem anderen Instrument und liegt in einem anderen PDF-Format vor. Das manuelle Zusammenstellen dieser Daten in einer Tabellenzeile pro Charge ist selbst dann mühsam, wenn alles reibungslos läuft. Wenn ein Bericht verspätet eintrifft, weil ein Instrument gerade verwendet wird, verteilt sich die Zusammenstellung über Stunden.
Die Batch-Verarbeitung löst dieses Problem, indem sie die Charge von Berichten – nicht einzelne Dokumente – als Arbeitseinheit behandelt. Laden Sie alle Berichte für eine bestimmte Charge auf einmal hoch – ziehen Sie PDFs aus Shimadzu LabSolutions-Exporten, gescannte Ausdrucke älterer Instrumente oder sogar Handyfotos von Anzeigetafeln eigenständiger Prüfgeräte per Drag & Drop – und das System verarbeitet sie gemeinsam. Die Ausgabe ist eine einzige Tabelle, in der jede Zeile einem Bericht entspricht, wobei die Spalten aus der Extraktion befüllt werden. Ein zweites Ausgabeblatt fasst alles in einer Zeile pro Charge zusammen, mit Testergebnissen als Spalten.
Dies ist ein grundlegend anderer Arbeitsablauf als bei Einzeldokument-Extraktionstools, die jeweils nur eine Datei verarbeiten. Bei einem Batch-First-Design ist die Verarbeitung mehrerer Dateien der Standard, kein nachträglicher Einfall. Wenn Sie 20 Berichte hochladen, erhalten Sie eine Excel-Datei zurück – nicht 20 separate Dateien, die Sie dann in eine Master-Tabelle kopieren und einfügen müssen. (Für verwandte Szenarien zur Batch-Dokumentenverarbeitung in der Fertigung finden Sie in unserem Leitfaden zu Batch-Rechnungsverarbeitung für Rohstoffe zur Kostenverfolgung in der Fertigung weitere Informationen.)
Realer Laborarbeitsablauf: Die Frühschicht führt alle Freigabetests zwischen 7:00 und 10:00 Uhr durch. Bis 10:15 Uhr liegen alle Instrumentenberichte als PDFs vor. Laden Sie sie in einem Batch hoch, geben Sie die Spaltennamen einmal an, und die Extraktion läuft gleichzeitig über alle Berichte. Bis 10:17 Uhr ist die konsolidierte Excel-Tabelle zur Validierung bereit. Die Zeit, die früher für das Abtippen aufgewendet wurde, wird nun für die Prüfung genutzt – eine Aufgabe, die Urteilsvermögen und nicht Tastendrücke erfordert.
Schritt 3: Ergebnisse validieren, bevor sie in Ihre SPC-Karte gelangen
Kein Extraktionssystem – ob KI oder nicht – ist bei 100 % der Dokumente zu 100 % genau. Der verantwortungsvolle Ansatz ist, ein Validierungsgate in den Workflow einzubauen: eine kurze manuelle Prüfung zwischen Extraktion und SPC-Upload, kein zeilenweises Nachprüfen aller KI-Ergebnisse.
Der Validierungsschritt sollte schnell sein, weil die KI hervorhebt, was Aufmerksamkeit erfordert. Wenn ein Messwert außerhalb der Spezifikationsgrenze liegt, enthält die Spalte „Bestanden/Nicht bestanden" den Wert „Nicht bestanden", und diese Zeile wird visuell markiert. Wenn die KI bei einem bestimmten Feld unsicher ist (niedrige Konfidenz bei verschmierter Druckausgabe oder ungewöhnlichem Berichtslayout), wird die Zelle zur manuellen Überprüfung hervorgehoben. Sie prüfen die Ausnahmen, nicht die gesamte Tabelle. Dies folgt dem Prinzip der Prüfung nach Ausnahme – eine Methode, die zunehmend in der pharmazeutischen Chargenfreigabe eingesetzt wird, wo sich die Qualitätssicherung auf markierte Abweichungen konzentriert, statt jedes konforme Feld zu prüfen.
Was einen angemessenen Validierungsschritt ausmacht, hängt von Ihrem regulatorischen Umfeld ab. Für ein nach ISO 17025 akkreditiertes Labor muss jeder Wert, der in ein Analysezertifikat (CoA) einfließt, auf die Rohdaten des Instruments rückverfolgbar sein, und jede Korrektur eines extrahierten Werts muss dokumentiert werden. Die Ausgabe des Extraktionssystems dient als erste Datenerfassung – analog zu dem, was ein Techniker eintippen würde – und die validierten Werte werden zum offiziellen Datensatz. Für nicht akkreditierte Labore reicht oft eine Stichprobenprüfung von 10–20 % der Zeilen, kombiniert mit einer vollständigen Prüfung aller markierten Ausnahmen.
Ein praktischer Workflow für regulierte Umgebungen: Exportieren Sie die KI-extrahierten Daten, prüfen Sie markierte Zeilen, nehmen Sie erforderliche Korrekturen vor und speichern Sie die geprüfte Version als kontrollierten Datensatz. Die ursprüngliche Extraktionsausgabe wird als intermediäres Datenartefakt aufbewahrt – nicht der offizielle Datensatz, aber nützlich für die Rekonstruktion des Prüfpfads, falls Fragen aufkommen.
Schritt 4: Bereinigte Daten in Ihre SPC-Plattform einspeisen
Hier zeigt der Extraktions-Workflow seinen Wert. Die validierte Excel-Ausgabe ist strukturierte Daten: Spaltenüberschriften entsprechen SPC-Parameternamen, Zeilen entsprechen Chargen oder Proben, und Zahlenwerte sind konsistent und formatiert. Sie kann direkt in jedes SPC-System geladen werden, das im Werk verwendet wird.
Wenn Sie Minitab Real-Time SPC nutzen (der Industriestandard mit 50 Jahren statistischer Methodik), kann die exportierte CSV- oder Excel-Datei direkt in ein Regelkarten-Projekt importiert werden. Definieren Sie Ihre Untergruppen, weisen Sie Spalten zu, und die Xbar-R- oder I-MR-Karten aktualisieren sich mit den neuen Daten. Minitabs Integration mit SAP Digital Manufacturing ermöglicht es, dass der Datenfluss bei größeren Betrieben von der Extraktion über ERP bis zum SPC-Dashboard ohne manuelle Eingriffe erfolgt.
Wenn Sie InfinityQS ProFicient nutzen (der Marktführer für On-Premise-SPC, eingesetzt in der Luftfahrt-, Automobil- und Medizingerätefertigung), entspricht das strukturierte Datenformat den Datenimportspezifikationen. Das Datenerfassungsmodul von ProFicient akzeptiert getrennte Dateien, sodass die Extraktionsausgabe keine Transformation erfordert.
Wenn Sie Excel mit QI Macros oder eine selbst erstellte Xbar-R-Vorlage verwenden – was viele kleine und mittlere Hersteller tun –, werden die extrahierten Daten direkt in das Datenraster der Vorlage eingefügt. Die Regelkartenformeln verweisen auf die Datenzellen; neue Extraktionsausgaben ersetzen die Werte der vorherigen Charge. Kein Neuabtippen, keine Formatkorrekturen, kein Suchen nach der Zelle mit dem pH-Wert von Charge 4267.
Für Labore, die mehrere Produkte mit unterschiedlichen Testpanels bearbeiten, pflegen Sie eine separate Extraktionsspaltenvorlage pro Produkt. Die Spaltendefinitionen (welche Tests, welche Spezifikationen, welche Formatregeln) bleiben von Charge zu Charge konsistent; nur die Berichts-PDFs ändern sich. Dies bewahrt die Kontinuität der SPC-Karte – aus historischen Daten berechnete Eingriffsgrenzen bleiben gültig, weil die eingespeisten Daten jedes Mal derselben Struktur folgen.
Was sich ändert, wenn QS-Daten ohne Transkription fließen
Der Wegfall des Transkriptionsschritts spart nicht nur Tipparbeit. Er gestaltet die Beziehung zwischen Labor, Qualitätssicherung und Produktion neu.
Chargenfreigabe wird schneller. Wenn Messdaten in Minuten statt Stunden vom Gerät ins SPC-Arbeitsblatt gelangen, kann der QS-Prüfer bereits arbeiten, während das Labor noch die nächste Charge fährt. Die Prüfung verschiebt sich von „Hat jemand das richtig abgetippt?" zu „Sagt uns dieser Datensatz, was wir über die Charge wissen müssen?". In einem Werk mit 20 Chargenfreigaben pro Woche bedeuten bereits 2 Stunden Einsparung pro Charge 40 Stunden freie Produktionskapazität – das Äquivalent einer zusätzlichen Schicht ohne zusätzliche Ausrüstung oder Personal.
SPC-Signale werden zuverlässiger. Regelkarten sind nur so gut wie die Daten dahinter. Wenn ein Transkriptionsfehler einen Datenpunkt außerhalb der Eingriffsgrenzen platziert, löst das eine Untersuchung aus, die nichts findet – Ingenieurszeit wird für ein Phantom-Signal verschwendet. Über Monate hinweg untergraben diese Fehlalarme das Vertrauen der Bediener in das SPC-System. Wenn Bediener glauben, die Regelkarte „schreie ständig Wolf", ignorieren sie echte Signale. Der direkte Datenfluss vom Gerät zur SPC-Karte eliminiert die häufigste Ursache für unechte Signale: menschliche Tippfehler.
Audit-Bereitschaft wird zur Routine. Prüfer nach ISO 9001 und ISO 17025 achten auf Datenintegrität – die ALCOA+-Prinzipien: Zurechenbar, Lesbar, Zeitgleich, Original, Genau. Eine manuell übertragene Tabelle verletzt „zeitgleich" (Werte werden möglicherweise Stunden nach der Messung eingegeben) und „original" (die Rohdaten des Geräts sind das Original, die Tabelle ist eine Kopie). Ein Extraktions-Workflow, der Berichte zum Zeitpunkt der Prüfung erstellt und mit Zeitstempel versieht, schafft eine zeitgleiche, zurechenbare Datenkette. Wenn der Prüfer fragt: „Zeigen Sie mir die Rohdaten für Charge 3267 vom März", können Sie das originale Geräte-PDF und den Extraktionszeitstempel vorlegen – nicht eine manuell getippte Tabelle ohne Nachweiskette.
Technikerzeit fließt in höherwertige Arbeit. QS-Techniker haben Chemie oder Ingenieurwesen nicht studiert, um ihre Schichten mit Zahleneintippen zu verbringen. Befreit von der Transkription können sie mehr Tests durchführen, Grenzfälle untersuchen, Geräte warten oder neue Methoden erlernen. In einem Labor mit 4–6 Technikern, die jeweils 45–90 Minuten täglich mit Dateneingabe verbringen, beträgt die gewonnene Zeit pro Woche 15–27 Stunden – etwa die Hälfte der Produktivität einer Vollzeitkraft, umgelenkt vom Tippen zur Wissenschaft.
Unternehmen mit ausgereiften Qualitätsmanagementsystemen erreichen laut ASQ-Studie eine pünktliche Lieferquote von 92 % gegenüber 74 % bei Unternehmen ohne solche Systeme. Der Unterschied liegt nicht in schnelleren Maschinen – sondern darin, dass Daten mit der Geschwindigkeit von Entscheidungen fließen, nicht mit der Geschwindigkeit des Tippens.
Für einen breiteren Überblick über KI-basierte Extraktion im Vergleich zu traditionellen Ansätzen in der Fertigung lesen Sie unsere Übersicht zu Dokumentextraktions-Tools für die Fertigung und unseren Praxisleitfaden zum Extrahieren von Qualitätsprüfberichten nach Excel.
FAQ: Extraktion von QC-Laborberichten in Excel
Funktioniert das mit Berichten verschiedener Gerätehersteller – Shimadzu, Agilent, Mettler Toledo?
Ja. Da die Extraktion semantisch (basierend auf dem Verständnis der Bedeutung eines Werts) und nicht positionsbasiert (basierend auf der Position auf der Seite) erfolgt, funktionieren dieselben Spaltennamen über Berichte verschiedener Geräte hinweg. Ein „pH“-Wert auf einem Mettler-Toledo-Bericht und ein „pH“-Wert auf einem Shimadzu-Bericht werden beide erfasst, obwohl die beiden Berichte völlig unterschiedliche Layouts haben. Dies ist der praktische Vorteil der vorlagenfreien Extraktion in einem Labor mit mehreren Geräten.
Was ist, wenn unsere Geräteberichte gescannte Papierausdrucke und keine digitalen PDFs sind?
Das System verarbeitet gescannte Dokumente und Fotos auf die gleiche Weise wie native PDFs. Ein Handyfoto eines Thermodrucker-Ausdrucks, ein Scan eines handschriftlichen Logbucheintrags oder ein aus einer Gerätesoftware exportiertes PDF – alle durchlaufen dieselbe Extraktionspipeline. Die KI liest den visuellen Inhalt unabhängig vom Quellformat. Die Bildqualität spielt eine Rolle: Ein sauberer, gut beleuchteter Scan oder ein gutes Foto liefert eine Extraktion mit höherer Zuverlässigkeit als ein schattiges, schiefes Schnappschuss.
Wie gehe ich mit Berichten um, die handschriftliche Ergebnisse oder Korrekturen enthalten?
Handschriftliche Werte auf ansonsten gedruckten Berichten sind in Laboren üblich, in denen Techniker Geräteausgaben annotieren – ein Ergebnis einkreisen, eine Notiz am Rand schreiben oder ein fehlendes Feld ausfüllen. Das Vision-Language-Modell kann gedruckten Text, Handschrift und Dokumente mit gemischtem Inhalt lesen. Die Erkennungsgenauigkeit für Handschrift ist geringer als für gedruckten Text (wie auch bei menschlichen Lesern), daher profitieren handschriftliche Felder von einer Validierungsprüfung während des Überprüfungsschritts.
Funktioniert das für GMP-regulierte Umgebungen (21 CFR Part 211)?
Das Tool verarbeitet Daten; es ersetzt nicht Ihr Qualitätssystem. In einer GMP-Umgebung sollte der Extraktionsoutput als Zwischenschritt behandelt werden – analog zu einem handschriftlichen Arbeitsblatt eines Technikers. Der validierte, freigegebene Datensatz bleibt die Version, die in Ihren Chargenbericht und Ihr CoA einfließt. Der Nutzen für GMP-Labore liegt in der Geschwindigkeit: Anstatt dass ein Techniker 45 Minuten mit dem Übertragen von Werten verbringt, bevor die QS mit ihrer Prüfung beginnen kann, erstellt die Extraktion den ersten Datensatz in Sekunden. Die QS prüft, verifiziert und genehmigt dann – derselbe Prozess, aber ausgehend von einem maschinell erstellten ersten Entwurf anstatt einem manuell getippten.
Was passiert, wenn zwei Prüfberichte derselben Charge unterschiedliche Bestanden/Nicht bestanden-Ergebnisse zeigen?
Das Extraktionssystem gibt das Gelesene wieder – es gleicht widersprüchliche Ergebnisse nicht ab. Wenn Bericht A für denselben Parameter „Bestanden" und Bericht B „Nicht bestanden" angibt, erscheinen beide Werte in der Ausgabe. Der Konflikt tritt bei der Validierung zutage – genau dann, wenn er auftauchen sollte. Das ist ein Vorteil gegenüber der manuellen Eingabe, bei der ein Techniker die Abweichung bemerken und stillschweigend „korrigieren" könnte, wodurch die Prüfspur verloren ginge. Der Extraktionsworkflow bewahrt die Originaldaten; die Lösung (Wiederholungsprüfung, Untersuchung, Abweichungsbericht) ist eine menschliche Entscheidung.
Kann ich für verschiedene Produktfamilien unterschiedliche Spaltenvorlagen einrichten?
Ja. Jedes Produkt oder jede Produktfamilie kann einen eigenen Satz von Spaltendefinitionen haben – eine Vorlage für die Tabletten-Freigabeprüfung, eine andere für die Rohstoffkontrolle, eine weitere für In-Prozess-Kontrollen. Vorlagen werden in Ihrem Konto gespeichert und können beim Start eines neuen Verarbeitungsdurchgangs ausgewählt werden. So können Labore mit einem vielfältigen Produktportfolio prüfspezifische SPC-Verfolgung betreiben, ohne die Spalten für jeden Durchlauf neu definieren zu müssen.
Wie ist das im Vergleich zum Kauf eines LIMS für die Automatisierung der Dateneingabe?
Ein LIMS (Laborinformations- und -managementsystem) ist eine umfassende Plattform, die Probenverfolgung, Prüfplanung, Geräteintegration und Compliance-Workflows verwaltet. Es ist das richtige Werkzeug für große, regulierte Labore mit Budget und IT-Support. Aber LIMS-Implementierungen kosten in der Regel 50.000–200.000+ $ und benötigen 6–18 Monate für die Bereitstellung. Für kleine und mittlere QC-Labore – die Mehrheit der Produktionsstätten – sind Preis und Zeitrahmen unerschwinglich. Die extraktionsbasierte Automatisierung adressiert den spezifischen Schmerzpunkt (Daten aus Berichten in Tabellenkalkulationen zu übertragen) ohne den Aufwand einer vollständigen LIMS-Migration. Für viele Labore ist es ein pragmatischer Schritt, der messbare Verbesserungen ohne organisatorische Umwälzungen bringt.